
Last chance! 50% off DataCamp Premium
Sale ends in
Se potessi consigliare una sola cosa da imparare a fondo per diventare un/una migliore data analyst o data scientist, sarebbe la regressione. E una parte fondamentale dell’apprendimento della regressione è capire esattamente che cos’è l’eteroschedasticità.
In questo articolo esamineremo il fenomeno dell’eteroschedasticità, vedremo perché è importante, come identificarla e i passaggi per gestirla. Sarò completo ma andrò dritto al punto. Quindi, che tu sia un/una analista esperto/a o alle prime armi, spero troverai qui qualcosa di interessante e utile. Per maggiori informazioni e per iniziare il percorso per diventare un/una esperto/a, segui il nostro corso Intro to Regression in R oppure Intro to Regression in Python. Ho anche un tutorial sulla regressione lineare semplice, se ti serve un rapido ripasso.
Allora, che cos’è, esattamente, l’eteroschedasticità? Togliamoci prima di mezzo le definizioni tecniche, poi guardiamo qualche esempio. Se inciampi sulla parola come succede a me, puoi dire “varianza non uniforme” e il senso è quello.
L’eteroschedasticità si riferisce a una situazione in cui la variabilità di una variabile dipendente è disuguale lungo l’intero intervallo dei valori di una variabile indipendente. Oppure, per una definizione più ancorata alla costruzione di modelli, potremmo dire che l’eteroschedasticità si verifica quando la dispersione dei residui non è costante, come a volte vediamo in un modello di regressione o in un modello di serie temporali.
In un certo senso preferisco questa seconda definizione perché ci ricorda che l’eteroschedasticità è in realtà un aspetto comune (anche se spesso problematico) della modellazione statistica. Ma, per essere chiari, sebbene l’eteroschedasticità sia più spesso discussa nel contesto di modelli come la regressione, può essere sia una caratteristica della specifica del modello sia una proprietà intrinseca dei dati.
Vediamo alcuni esempi usando R e scegliamo un ambito – ad esempio, le finanze domestiche. Per cominciare, mostrerò la classica forma a imbuto o a ventaglio, quella che personalmente mi viene in mente quando penso alla varianza non uniforme.
Questa versione dell’eteroschedasticità può verificarsi, per esempio, in dati con reddito vs spesa: le famiglie a basso reddito spesso hanno spese mensili costanti concentrate su beni essenziali come affitto e cibo, con bassa variabilità; le famiglie ad alto reddito, invece, possono mostrare più variabilità perché solo alcune scelgono acquisti discrezionali costosi, come vacanze o beni di lusso, mentre altre risparmiano. Quindi, in questo esempio, all’aumentare del reddito aumenta anche la variabilità delle spese mensili, da cui la forma a ventaglio.
y_funnel <- x + rnorm(length(x), mean = 0, sd = x * 0.5)y_inverse_funnel <- x + rnorm(length(x), mean = 0, sd = (1 / x) * 20)y_cyclical <- x + rnorm(length(x), mean = 0, sd = 10 * abs(sin(x / 5)))heteroscedasticity_data <- data.frame(x, y_funnel, y_inverse_funnel, y_cyclical)library(ggplot2)ggplot(heteroscedasticity_data, aes(x = x, y = y_funnel)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs( title = "Funnel Shape", x = "X Values", y = "Y Values" )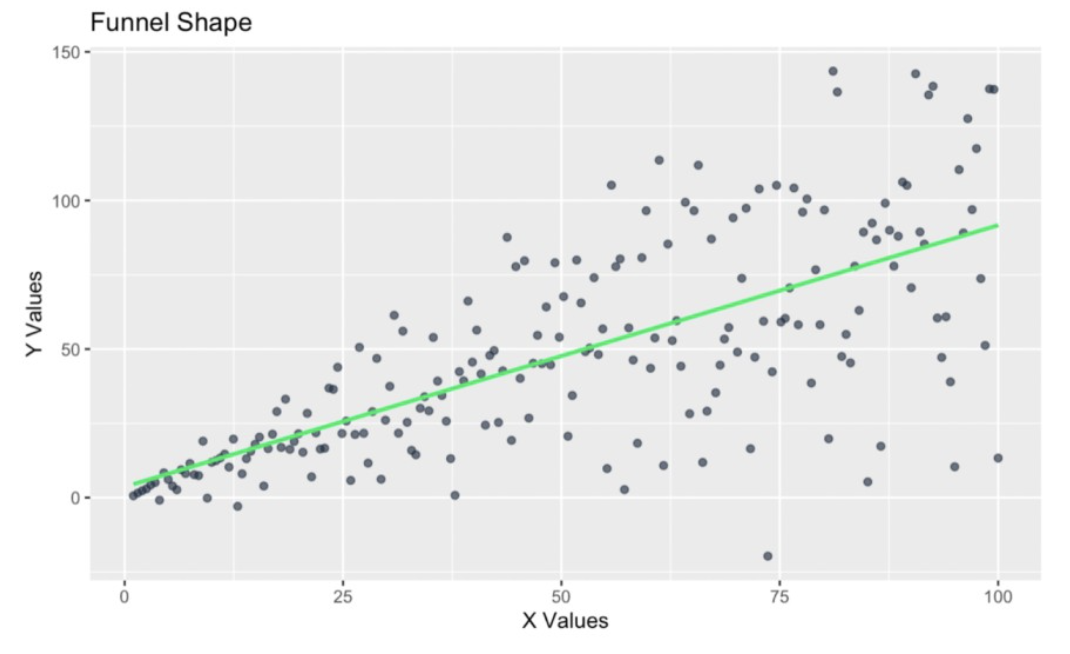
Forma a imbuto nei residui. Immagine dell’autore
Proviamo un altro esempio, sempre nel campo delle finanze domestiche. Immagina ora di creare un modello di regressione per mostrare la variabilità del risparmio rispetto all’età dei membri della famiglia.
Sospettiamo che questi dati mostreranno eteroschedasticità perché le famiglie più giovani potrebbero avere alta variabilità nel risparmio a causa di redditi irregolari, come lavori gig e tirocini, o spese impreviste, come prestiti studenteschi o l’avvio di una famiglia. Ma con l’età e la stabilizzazione finanziaria, il comportamento di risparmio diventa più coerente, creando una forma a imbuto inverso in cui la variabilità diminuisce con l’età.
ggplot(heteroscedasticity_data, aes(x = x, y = y_inverse_funnel)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs( title = "Inverse Funnel Shape", x = "X Values", y = "Y Values" )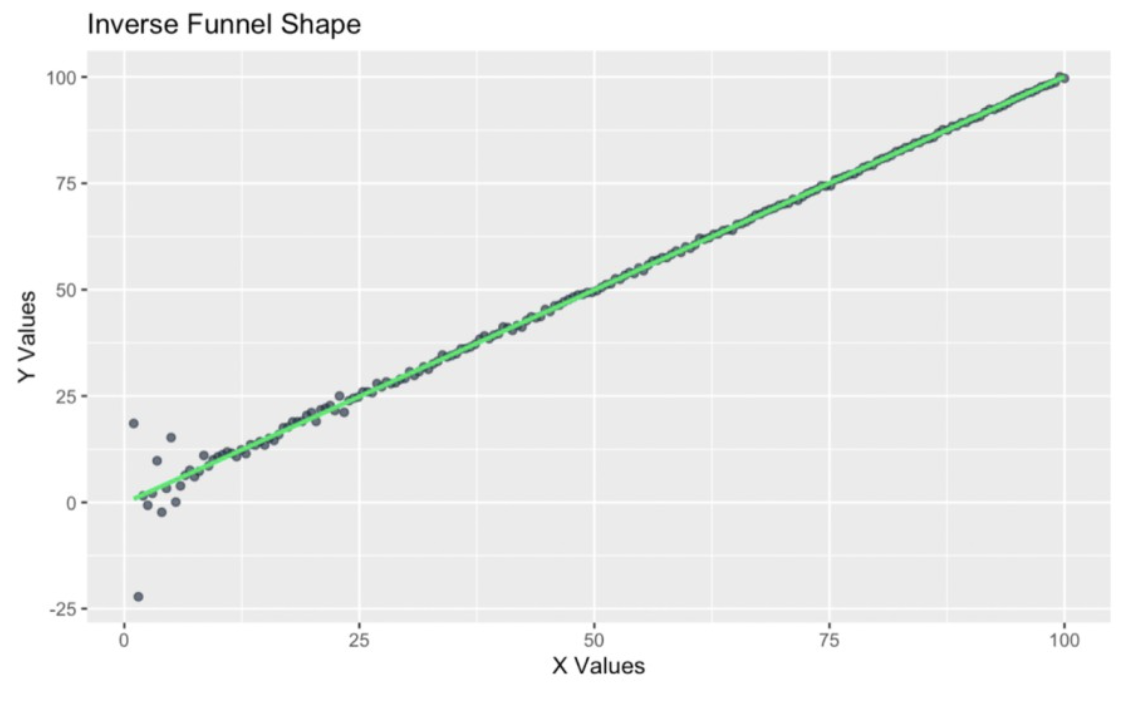
Forma a imbuto inverso nei residui. Immagine dell’autore
Guardiamo un ultimo esempio con i redditi familiari. Qui consideriamo una varianza ciclica, in particolare la varianza della spesa nelle diverse stagioni. Potresti riconoscere questo tipo di andamento se hai seguito uno dei nostri corsi di forecasting, come il popolarissimo Forecasting in R.
Sappiamo che la spesa delle famiglie spesso fluttua ciclicamente durante l’anno. Ad esempio, la varianza può aumentare durante le festività perché compriamo regali o viaggiamo per vedere la famiglia, e diminuire in altri mesi con meno festività, magari marzo o settembre. Il grafico seguente mostra eteroschedasticità ma in modo più articolato, aumentando e diminuendo in periodi diversi.
ggplot(heteroscedasticity_data, aes(x = x, y = y_cyclical)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs( title = "Cyclical Pattern", x = "X Values", y = "Y Values" )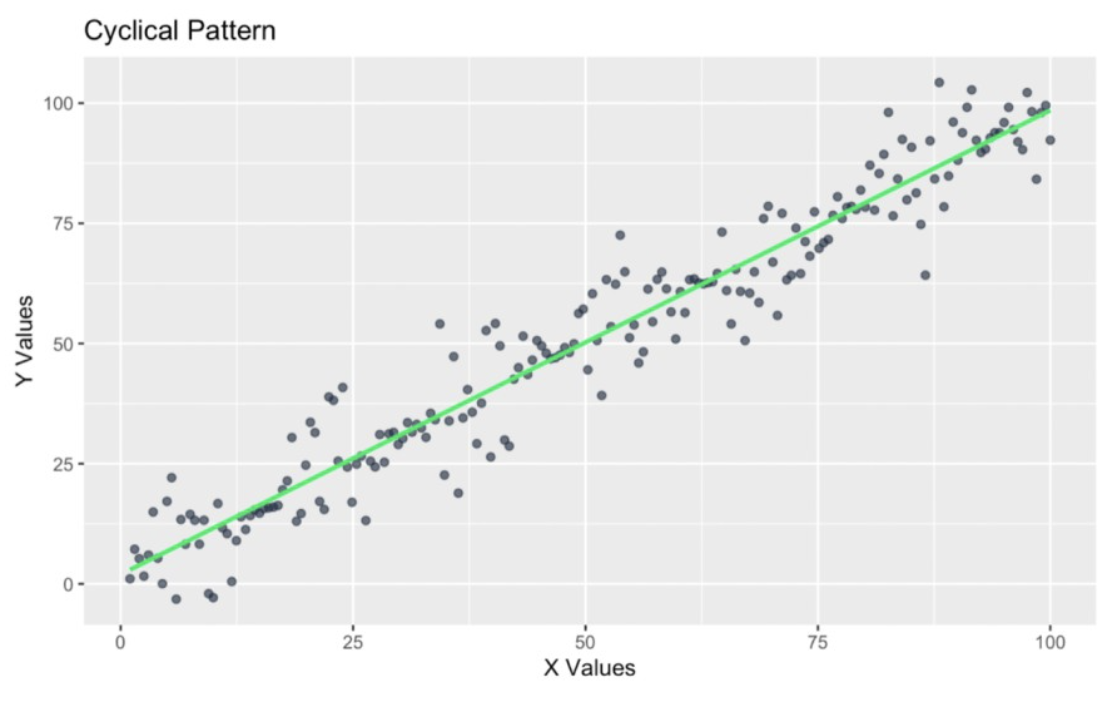
Andamento ciclico nei residui. Immagine dell’autore
Come vedi, l’eteroschedasticità può assumere diverse forme. Vediamo ora perché tutto questo è importante.
Direi che, in generale, non puoi fare regressioni in modo corretto senza capire qualcosa di eteroschedasticità, dato che è così comune e può avere un impatto così grande nel distorcere i risultati.
Probabilmente per questo motivo l’omoschedasticità – l’opposto dell’eteroschedasticità – è in realtà una delle principali assunzioni dei modelli di regressione, insieme a linearità, indipendenza degli errori, normalità dei residui e all’assenza di multicollinearità.
Queste assunzioni contano perché aiutano a garantire che le previsioni e le inferenze del modello siano significative. Quando vengono violate, l’affidabilità delle stime, inclusi errori standard e intervalli di confidenza, può degradarsi, e i nostri test d’ipotesi sono meno validi.
L’eteroschedasticità non spunta dal nulla. Le sue radici stanno spesso in come i dati vengono raccolti o trasformati. Vediamo sia i problemi di trasformazione dei dati sia quelli di raccolta.
A volte, i passaggi che facciamo per preparare i dati possono introdurre eteroschedasticità. Penso a come scalature improprie o trasformazioni non lineari possano creare variabilità indesiderata.
Per ragionarci, immaginiamo di studiare la relazione tra la dimensione di un appartamento e il suo affitto mensile. Normalmente, potremmo aspettarci una relazione lineare tra dimensione e affitto perché gli appartamenti più grandi costano di più, e la varianza dell’affitto potrebbe non aumentare necessariamente con la dimensione perché la relazione (potrebbe essere) proporzionale. Ecco come potrebbe apparire:
set.seed(1024)size <- runif(1000, 500, 2000) # Random sizes between 500 and 2000 sq ftrent <- 20 * size + rnorm(100, mean = 0, sd = 5000) # Linear relation with added noiseunequal_variance_df <- data.frame(size = size, rent = rent)ggplot(unequal_variance_df, aes(x = size, y = rent)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs(title = "Size vs. Rent", x = "Size (sq ft)", y = "Rent")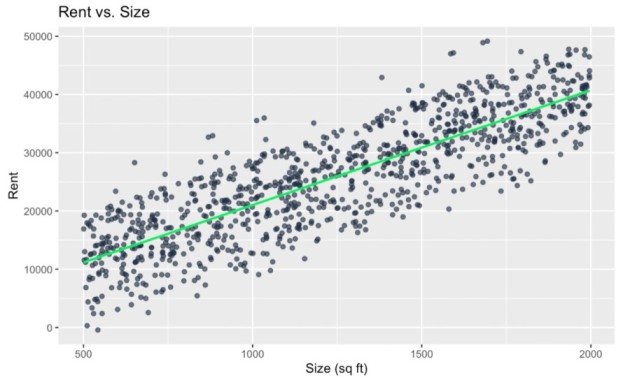
Nessuna eteroschedasticità. Immagine dell’autore
Se scaliamo l’affitto per la dimensione per calcolare il "canone per metro quadro", creiamo una nuova metrica. Se poi proviamo a prevedere il canone per metro quadro in funzione dell’affitto, potremmo vedere che questa trasformazione crea o accentua l’eteroschedasticità. Per essere chiari, in generale riconosco che non è una buona idea – dividere la variabile indipendente per la dipendente – perché creiamo una situazione in cui y è già influenzata da x e quindi introduciamo una correlazione spuriosa. Quindi, riconosco che questo comporta sfide concettuali e statistiche. Ma (abbi pazienza) lo uso come esempio per illustrare il punto:
unequal_variance_df$rent_per_sqft <- unequal_variance_df$rent / unequal_variance_df$sizeggplot(unequal_variance_df, aes(x = size, y = rent_per_sqft)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs(title = "Size vs. Rent per Square Foot", x = "Size (sq ft)", y = "Rent per Sq Ft")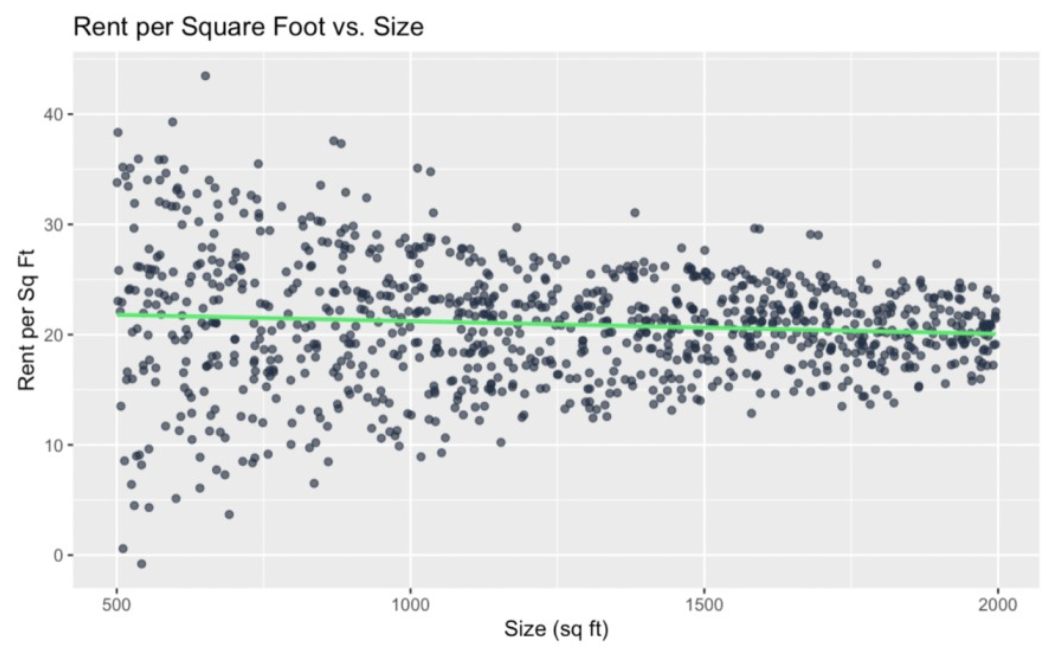
Eteroschedasticità indotta come risultato di dipendenza funzionale. Immagine dell’autore
Si vede una forma a imbuto in cui la variabilità del canone per metro quadro diminuisce all’aumentare della dimensione. Quindi abbiamo creato eteroschedasticità dal nulla. Per un altro esempio, possiamo elevare al quadrato entrambe le variabili:
unequal_variance_df$size_squared <- unequal_variance_df$size^2ggplot(unequal_variance_df, aes(x = size ^ 2, y = rent ^ 2)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs(title = "Size Squared vs. Rent Squared", x = "Size Squared", y = "Rent Squared")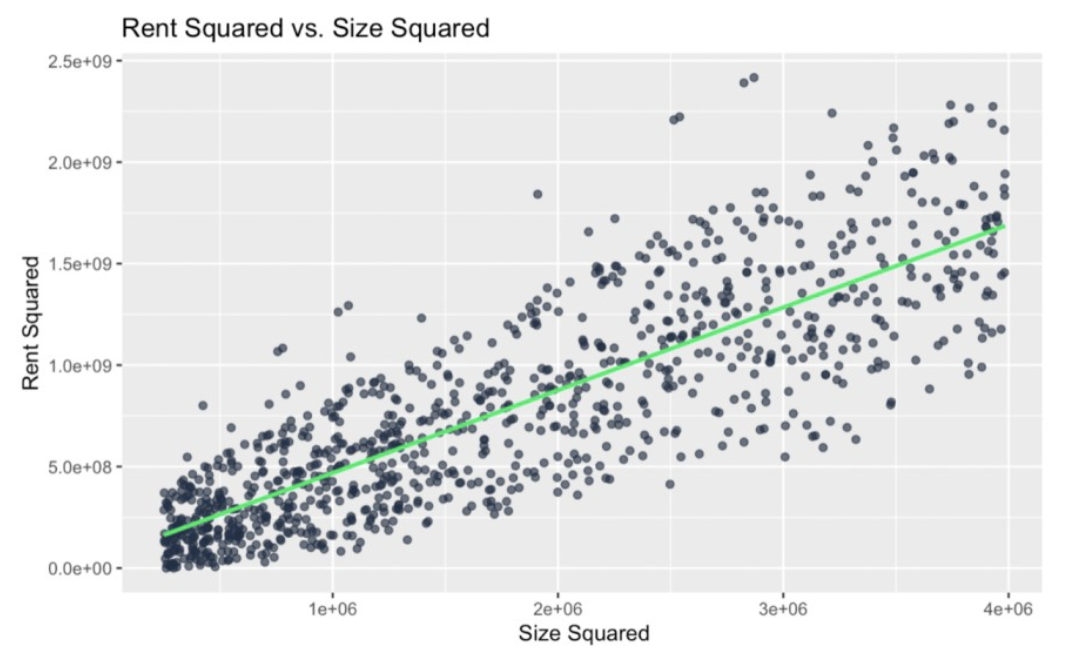
Eteroschedasticità indotta dall’elevazione al quadrato. Immagine dell’autore
Di nuovo, abbiamo creato eteroschedasticità dove prima non c’era perché abbiamo insistito nel elevare al quadrato sia x che y. In alcuni contesti andrebbe anche bene, ma qui sospettavo che farlo avrebbe creato eteroschedasticità perché pensavo che la trasformazione avrebbe amplificato le differenze di varianza all’aumentare dei valori delle variabili.
Anche questo secondo esempio è un po’ forzato perché non dovremmo costruire questo modello: sarebbe difficile da interpretare senza motivo. Ma, in un workflow reale di modellazione, le trasformazioni che creano inavvertitamente eteroschedasticità possono essere più sottili. Potresti non accorgertene se il processo coinvolge più passaggi.
Più precisamente, in questo caso, l’eteroschedasticità è risultata dal feature engineering con rapporti. Rapporti come “canone per metro quadro” sono infatti comuni nel feature engineering. Tuttavia, queste variabili possono introdurre eteroschedasticità se, in particolare, il denominatore varia molto tra le osservazioni. Trasformazioni logaritmiche o esponenziali sono spesso usate per stabilizzare la varianza o linearizzare le relazioni. Tuttavia, applicarle in modo incoerente può ritorcersi contro. Supponi di avere un modello in cui applichi il log al reddito ma non adatti le feature collegate, come le spese. Questo tipo di disallineamento è una fonte comune di eteroschedasticità, quindi assicurati che tutto sia allineato per non indurre dinamiche spurie.
L’eteroschedasticità può anche derivare da pratiche di raccolta dati incoerenti. Ad esempio, cambiare lo strumento di misurazione a metà di uno studio potrebbe introdurla. Avere gruppi di dimensioni diverse e, quindi, dimensioni del campione diverse in uno studio può anche crearla. Mantenere un approccio coerente è importante.
Rilevare l’eteroschedasticità è il primo passo per affrontarla e, per fortuna, ci sono strumenti sia visivi sia statistici che aiutano.
Gli scatter plot possono rivelare pattern nei dati che aiutano a individuare l’eteroschedasticità. Per questo mi piace il grafico valori adattati vs residui. Nota: un istogramma dei residui o un q-q plot dei residui non bastano per rilevarla perché questi due grafici sono davvero più adatti a testare la normalità.
y_funnel <- x + rnorm(length(x), mean = 0, sd = x * 0.5)heteroscedasticity_data <- data.frame(x, y_funnel)unequal_variance_model <- lm(y_funnel ~ x, heteroscedasticity_data)fitted_values_vs_residuals <- ggplot(data = unequal_variance_model, aes(x = .fitted, y = .resid)) + geom_point(color = '#203147') + geom_hline(yintercept = 0, linetype = "dashed", color = '#01ef63', size = 1) + xlab("fitted values") + ylab("residuals") + labs(title = "Heteroscedasticity Data") + labs(subtitle = "Fitted Values vs Residuals")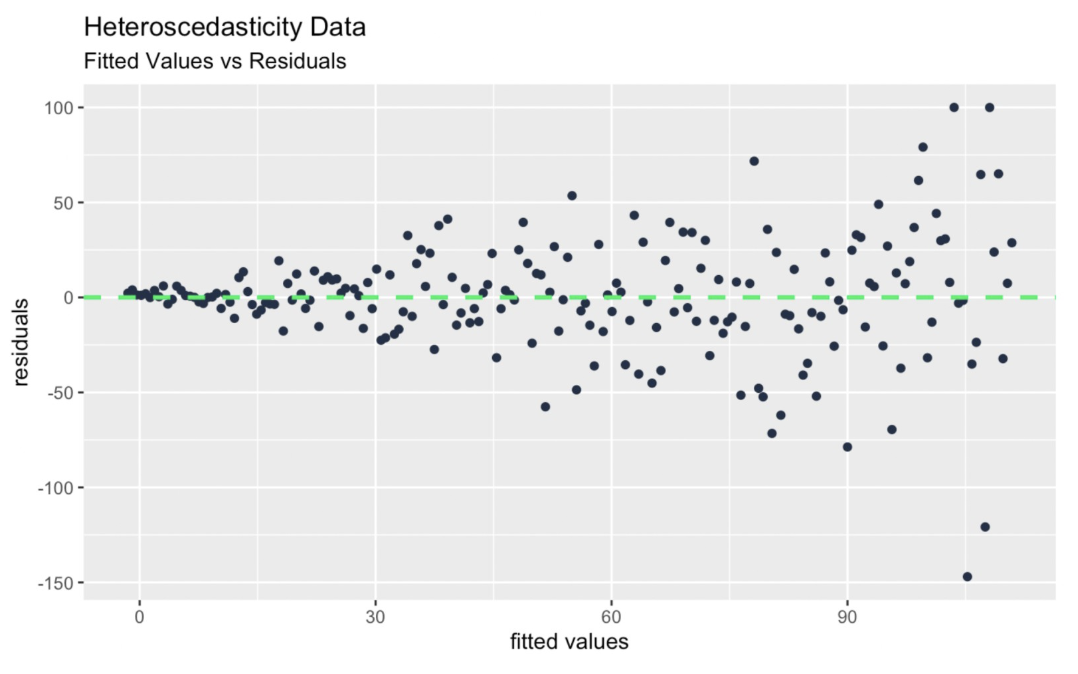 Grafico diagnostico valori adattati vs residui. Immagine dell’autore
Test statistici come il test di Breusch-Pagan offrono un approccio più quantitativo. Il Breusch-Pagan verifica se i residui al quadrato del modello sono correlati ai predittori. Per eseguire il test, stimiamo il modello e usiamo la funzione bptest() dalla libreria lmtest. Nota che il test assume residui normali.
library(lmtest)model <- lm(rent ~ size, data = unequal_variance_df)bp_test <- bptest(model)print(bp_test)Una volta identificata l’eteroschedasticità, il passo successivo è affrontarla con tecniche consolidate.
Trasformazioni semplici, come applicare i logaritmi, possono spesso ridurre o eliminare l’eteroschedasticità. Prima abbiamo preso un modello senza varianza disuguale, applicato trasformazioni e creato problemi, ma più spesso accade il contrario: usiamo trasformazioni come logaritmi, radici quadrate o reciproci per comprimere i valori più grandi ed espandere quelli più piccoli. Ad esempio, se l’affitto crescesse invece in modo esponenziale con la dimensione, fare il log dell’affitto appiattirebbe la crescita esponenziale e renderebbe la relazione lineare con (forse) varianza uniforme.
Inoltre, voglio sottolineare che quando prepariamo i dati pensiamo spesso a correggere l’asimmetria. Per esempio, se abbiamo dati asimmetrici a destra, potremmo usare una trasformazione a radice quadrata per rendere i dati gaussiani. Ma ciò che potremmo non apprezzare abbastanza è che nei dati asimmetrici, i valori più grandi tendono anche ad avere maggiore variabilità, che è anch’essa una violazione delle assunzioni di omoschedasticità.
Quando le trasformazioni non bastano, metodi di regressione robusta come le minime quadrate ponderate (WLS) possono aiutare. Le WLS sono particolarmente interessanti qui perché sono progettate per gestire problemi nei dati come eteroschedasticità e outlier. In particolare, WLS assegna pesi alle osservazioni in base alla loro varianza, riducendo l’influenza dei punti con maggiore variabilità e fornendo stime più stabili. Nota: con WLS si assume che i pesi siano ben noti o ben stimati.
Ignorare l’eteroschedasticità può sembrare innocuo, ma può portare a problemi.
L’eteroschedasticità può distorcere il modo in cui un modello interpreta l’importanza delle feature. Ad esempio, in un modello di spesa, feature come il reddito possono sembrare più importanti se collegate a gruppi con alta variabilità, come le famiglie ad alto reddito con acquisti discrezionali. Questa rappresentazione fuorviante può portarci a enfatizzare eccessivamente predittori meno affidabili, sottostimando quelli più consistenti, compromettendo l’utilità del modello.
L’eteroschedasticità può invalidare l’uso di test statistici comuni come t-test o F-test se stai assumendo varianza uniforme e questa assunzione non è rispettata. La varianza disuguale è problematica anche nei dati di serie temporali, dove i pattern di variabilità evolvono nel tempo, generando confusione nell’analisi di trend stagionali. Le eteroschedasticity-consistent standard errors (HCSE) possono essere utilizzate per abilitare inferenze statistiche più affidabili.
In questo articolo, abbiamo studiato la situazione in cui la varianza dei residui non è costante tra i livelli di una variabile indipendente in un modello. Qui voglio parlare brevemente di un’idea correlata, cioè l’eterogeneità della varianza a livello di gruppo, che si riferisce alla variabilità tra gruppi predefiniti: è meno un problema statistico legato alle assunzioni del modello e più un’osservazione descrittiva dei dati.
Mostro con un ultimo esempio. Qui uso una simulazione di dati di survey. Considero uno scenario in cui i dati sul reddito sono raccolti con due metodi diversi: survey e registri amministrativi. Questi metodi potrebbero avere livelli di precisione differenti (le survey non sono famose per essere impeccabili?). Si vede che la quantità di variazione all’interno di ciascun gruppo non è coerente, il che potrebbe essere un problema con qualcosa come l’ANOVA.
set.seed(1024)income_admin <- rnorm(500, mean = 50000, sd = 2000) spending_admin <- income_admin * 0.3 + rnorm(500, mean = 0, sd = 1000)income_survey <- rnorm(500, mean = 50000, sd = 8000) # Same mean, higher SDspending_survey <- income_survey * 0.3 + rnorm(500, mean = 0, sd = 5000)income <- c(income_admin, income_survey)spending <- c(spending_admin, spending_survey)method <- rep(c("Administrative Records", "Survey"), each = 500)survey_and_admin_data <- data.frame(income = income, spending = spending, method = method) # Plot the datacustom_colors <- c("Administrative Records" ='#01ef63', "Survey" = '#203147')ggplot(survey_and_admin_data, aes(x = income, y = spending, color = method)) + geom_point(alpha = 0.7) + labs( title = "Variability in Data Collection", x = "Income", y = "Spending")+ scale_color_manual(values = custom_colors)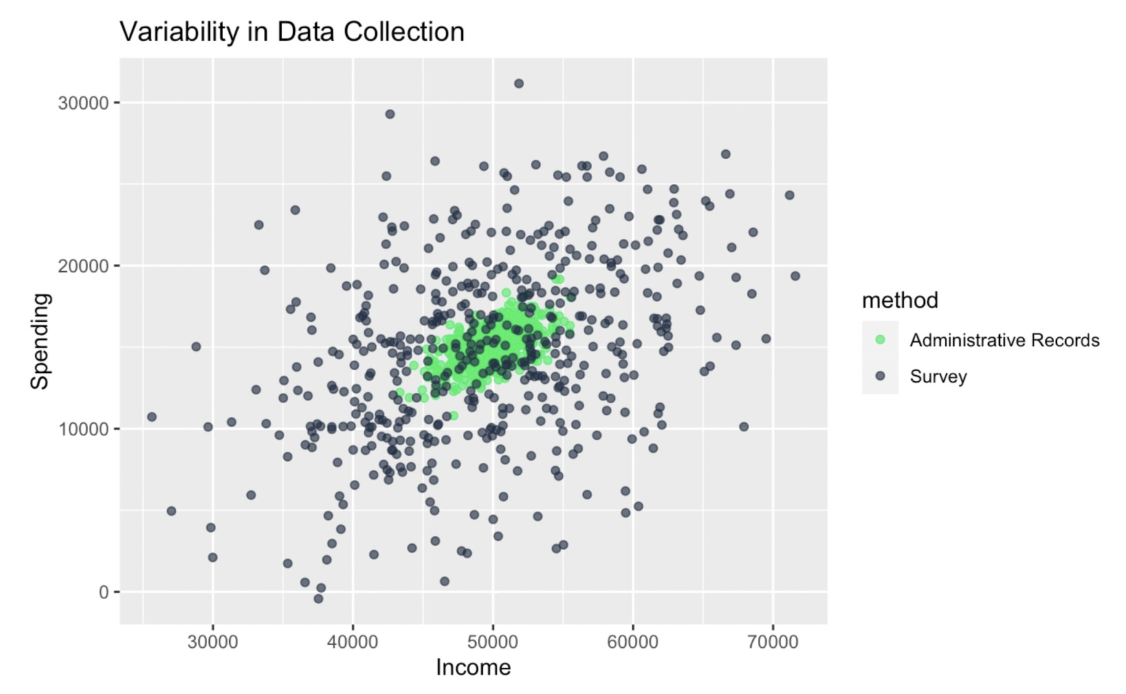
Eterogeneità della varianza a livello di gruppo. Immagine dell’autore
Affrontare l’eteroschedasticità non serve solo a migliorare il tuo modello di regressione. Serve a fare in modo che il tuo lavoro regga all’esame critico. Per continuare a imparare e diventare esperto/a, segui il percorso Statistical Inference in R e il corso Foundations of Inference in R. Penso anche che il percorso Statistician in R sia un’altra ottima opzione sia per l’apprendimento sia per la crescita professionale.
Impara la regressione con DataCamp
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min




