
Podman: l'alternativa a Docker senza demone
Podman rappresenta la sfida più diretta all'approccio architetturale di Docker.
Immagine 1 - Home page di Podman
Red Hat lo ha sviluppato specificamente per affrontare il modello di sicurezza basato su demone di Docker, mantenendo la compatibilità con i workflow esistenti.
>Se ti serve un confronto più approfondito tra Docker e Podman, il nostro articolo ti dirà quale piattaforma di containerizzazione fa per te.
Innovazione architetturale
La principale differenza di Podman rispetto a Docker è l'eliminazione totale del demone. Invece di instradare i comandi attraverso un servizio centrale, Podman usa un modello fork-exec in cui ogni container è un processo figlio diretto dell'utente che lo ha avviato. Significa nessun servizio in background persistente, nessun singolo punto di failure e nessun demone a livello root che gestisce i tuoi container.
Questa architettura si integra naturalmente con systemd, il gestore dei servizi standard di Linux. Puoi generare file unit di systemd direttamente dai container Podman, permettendo ai container di avviarsi automaticamente al boot, riavviarsi in caso di errore e integrarsi con i log di sistema. È un approccio molto più pulito rispetto al layer di orchestrazione separato di Docker.
Podman mantiene la piena conformità OCI, quindi esegue le stesse immagini dei container di Docker senza modifiche. Il runtime usa le stesse tecnologie sottostanti: runc per l'esecuzione dei container e vari driver di storage per la gestione delle immagini, ma le impacchetta in modo diverso.
Migliorie di sicurezza
L'operatività rootless è la funzionalità di sicurezza di spicco di Podman. Quando esegui container con Podman, girano sotto il tuo account utente invece di richiedere privilegi di root. Ciò avviene tramite il mapping dei namespace utente, dove l'utente root del container è mappato al tuo ID utente non privilegiato sul sistema host.
Questo elimina il vettore d'attacco per cui un'uscita dal container potrebbe compromettere l'intero host. Anche se un attaccante evade dal container, rimane confinato ai permessi del tuo utente invece di avere accesso root alla macchina.
Su sistemi Red Hat Enterprise Linux e Fedora, Podman si integra strettamente con SELinux (Security-Enhanced Linux). SELinux fornisce controlli di accesso obbligatori che limitano ciò a cui i container possono accedere sull'host, anche se compromessi. Si creano così più livelli di sicurezza: i namespace utente prevengono l'escalation dei privilegi, mentre SELinux impedisce accessi non autorizzati al filesystem.
Le implementazioni enterprise combinano spesso queste funzionalità con strumenti aggiuntivi di scansione della sicurezza e di enforcement delle policy per strategie di difesa in profondità.
Compatibilità operativa
Podman mantiene la compatibilità con la CLI di Docker tramite il comando podman, che accetta gli stessi argomenti di docker. Puoi creare un alias (alias docker=podman) e la maggior parte degli script esistenti funzionerà senza modifiche. Questo rende la migrazione da Docker molto più fluida rispetto al passaggio a toolchain completamente diverse.
La GUI Podman Desktop offre un'alternativa a Docker Desktop per gli sviluppatori che preferiscono interfacce grafiche. Include gestione dei container, funzionalità di build delle immagini e integrazione con Kubernetes per lo sviluppo locale. L'app desktop può connettersi a istanze Podman remote e fornisce funzionalità simili alla dashboard di Docker Desktop.
Per i workflow Kubernetes, Podman può generare manifest YAML di Kubernetes dai container in esecuzione e supporta la gestione dei pod, eseguendo più container che condividono rete e storage, in modo simile ai pod di Kubernetes.
Compromessi chiave
Il supporto Windows rimane la principale limitazione di Podman. Sebbene Podman Machine offra compatibilità con Windows tramite virtualizzazione, non è così lineare come l'integrazione WSL2 di Docker Desktop. Gli sviluppatori Windows potrebbero trovare la configurazione più complessa.
Il networking rootless ha implicazioni sulle performance. Senza privilegi di root, Podman non può creare direttamente bridge di rete, quindi utilizza il networking in modalità utente (slirp4netns), che aggiunge latenza. È raramente percepibile per i carichi di lavoro di sviluppo, ma le applicazioni di rete ad alto throughput potrebbero vedere performance ridotte.
La compatibilità con Docker Compose esiste tramite podman-compose, ma non è completa al 100%. I file Compose complessi potrebbero richiedere modifiche e alcune funzionalità avanzate di rete non sono supportate in modalità rootless. I team fortemente investiti nei workflow con Docker Compose dovrebbero testare accuratamente prima di migrare.
>In cosa differiscono Docker Compose e Kubernetes? Il nostro confronto dettagliato ti copre.
Runtime dell'ecosistema Kubernetes: CRI-O e Containerd
Mentre Podman punta alla compatibilità con Docker, CRI-O e containerd si concentrano specificamente sugli ambienti Kubernetes di produzione. Questi runtime eliminano le funzionalità non necessarie per ottimizzare i carichi di lavoro orchestrati.
>Ogni sviluppatore dovrebbe conoscere queste differenze tra Docker e Kubernetes.
CRI-O: runtime nativo per Kubernetes
CRI-O è stato costruito da zero per implementare la Container Runtime Interface (CRI) di Kubernetes.
Immagine 2 - Home page di CRI-O
Include solo ciò di cui Kubernetes ha bisogno: niente build di immagini, nessuna gestione dei volumi oltre a ciò che richiedono i pod e nessuna gestione di container standalone. Questo approccio mirato si traduce in un minore overhead di memoria e tempi di avvio più rapidi rispetto a Docker.
L'efficienza delle risorse del runtime deriva dal suo design minimale. CRI-O non mantiene un demone con API estese o servizi in background. Avvia i container, ne gestisce il ciclo di vita secondo le istruzioni di Kubernetes e si fa da parte. È ideale per ambienti con risorse limitate o distribuzioni su larga scala dove ogni megabyte di memoria conta.
CRI-O supporta qualsiasi runtime conforme a OCI come esecutore di basso livello. Sebbene di default usi runc, puoi sostituirlo con alternative come crun (scritto in C per prestazioni migliori) o gVisor (per un'isolamento maggiore) senza cambiare la configurazione di Kubernetes. Questa flessibilità ti permette di ottimizzare per requisiti specifici di sicurezza o performance a livello di runtime.
Il progetto mantiene una stretta compatibilità con i cicli di rilascio di Kubernetes, garantendo che nuove funzionalità e aggiornamenti di sicurezza siano allineati con le versioni del tuo cluster.
Containerd: runtime di livello produttivo
Containerd è nato come runtime sottostante di Docker prima di diventare un progetto standalone sotto la Cloud Native Computing Foundation.
Immagine 3 - Home page di Containerd
Docker usa ancora containerd internamente, ma puoi eseguirlo direttamente per eliminare i layer aggiuntivi e l'overhead di Docker.
L'architettura è incentrata su un'API shim che fornisce interfacce stabili per la gestione dei container. Ogni container ottiene un proprio processo shim, che gestisce in modo indipendente il ciclo di vita del container. Se il demone principale di containerd si riavvia, i container in esecuzione continuano senza interruzioni: una funzionalità cruciale per i carichi di lavoro di produzione che non possono tollerare downtime.
Questo design rende containerd estremamente stabile per applicazioni enterprise a lunga esecuzione. L'architettura a shim abilita anche funzionalità come la migrazione live e gli aggiornamenti senza downtime, in cui puoi aggiornare il runtime senza influire sui container in esecuzione.
Containerd include gestione integrata delle immagini, snapshot per uno storage efficiente dei layer e sistemi di plugin per estendere le funzionalità. I principali provider cloud come AWS EKS, Google GKE e Azure AKS usano containerd come runtime predefinito grazie a questa architettura collaudata in produzione.
Caratteristiche prestazionali
Ecco come questi runtime si confrontano per le distribuzioni Kubernetes in produzione:
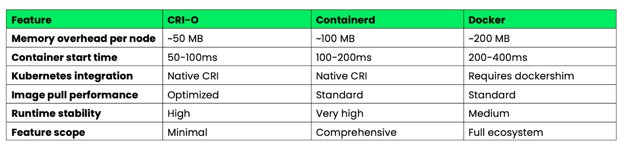
Immagine 4 - Caratteristiche prestazionali: Docker vs CRI-O vs Containerd
CRI-O vince in efficienza delle risorse e velocità di avvio grazie al suo design minimale. Containerd offre il miglior equilibrio tra funzionalità e stabilità per ambienti enterprise. Docker fornisce più funzionalità, ma con un overhead più elevato non necessario in ambienti Kubernetes.
Per i cluster Kubernetes di produzione, sia CRI-O che containerd eliminano il layer di compatibilità dockershim, riducendo la complessità e migliorando le performance rispetto a setup basati su Docker.
Runtime di basso livello: runC e Youki
Mentre i runtime di alto livello come Podman e containerd gestiscono la gestione delle immagini e le API, i runtime di basso livello si concentrano esclusivamente sull'esecuzione dei container. Questi strumenti rappresentano le fondamenta che alimentano la maggior parte delle piattaforme di containerizzazione.
runC: implementazione di riferimento OCI
runC funge da implementazione di riferimento della OCI Runtime Specification: è l'esempio canonico di come i container dovrebbero effettivamente girare. La maggior parte delle piattaforme di container usa runC come motore di esecuzione, inclusi Docker, containerd, CRI-O e Podman. Quando avvii un container con uno di questi strumenti, probabilmente runC gestisce la creazione e l'isolamento dei processi.
Il runtime implementa i primitivi core dei container: creazione di namespace Linux per l'isolamento, impostazione dei cgroup per i limiti di risorse e configurazione dei contesti di sicurezza. È scritto in Go ed è progettato per essere semplice, affidabile e conforme alle specifiche, più che ricco di funzionalità.
runC eccelle in sistemi embedded e stack di container personalizzati in cui servono comportamento prevedibile e dipendenze minime. Poiché gestisce solo l'esecuzione dei container, puoi costruire piattaforme specializzate intorno ad esso senza ereditare complessità non necessarie. Dispositivi IoT, piattaforme di edge computing e sistemi di orchestrazione custom usano spesso runC direttamente invece dei runtime di livello superiore.
Lo strumento opera come un'utility da riga di comando che legge specifiche di bundle OCI e crea i container di conseguenza. È perfetto per integrarsi in sistemi esistenti o per costruire strumenti di gestione dei container personalizzati.
Youki: performance basate su Rust
Youki reimplemmenta la OCI Runtime Specification in Rust, concentrandosi su sicurezza della memoria e performance. L'implementazione in Rust elimina intere classi di vulnerabilità di sicurezza che possono colpire i runtime in C e Go, migliorando al contempo i tempi di avvio dei container grazie a una migliore gestione della memoria e a un overhead ridotto.
I benchmark mostrano che Youki avvia i container più velocemente di runC in molti casi, anche se il miglioramento esatto varia in base al carico di lavoro. Questo miglioramento deriva dalle astrazioni a costo zero di Rust e da pattern di allocazione della memoria più efficienti. Per applicazioni che creano e distruggono molti container di breve durata, questi miglioramenti nei tempi di avvio possono essere significativi.
Youki mantiene la piena compatibilità con la OCI Runtime Specification, quindi funziona come sostituto drop-in di runC nella maggior parte delle piattaforme di container. Docker Engine, containerd e altri runtime di alto livello possono usare Youki senza modifiche alla loro configurazione o alle API.
Il runtime favorisce i carichi di lavoro critici per le performance come funzioni serverless, pipeline CI/CD con molte build di container e architetture a microservizi con frequenti eventi di scaling. I tempi di avvio più rapidi si traducono direttamente in una latenza di cold start ridotta e in un migliore utilizzo delle risorse in questi scenari.
Youki include anche funzionalità come l'ottimizzazione per cgroup v2 e un supporto migliorato ai container rootless che sfruttano il sistema di tipi di Rust per prevenire errori di configurazione in fase di compilazione.
Container di sistema: LXC/LXD vs container applicativi
Non tutta la containerizzazione deve concentrarsi su singole applicazioni: a volte serve eseguire interi sistemi operativi in container. LXC e LXD offrono una containerizzazione a livello di sistema fondamentalmente diversa dall'approccio focalizzato sulle applicazioni di Docker.
LXC: virtualizzazione a livello OS
LXC (Linux Containers) crea container che si comportano come sistemi Linux completi piuttosto che come processi applicativi isolati.
Immagine 5 - Home page di LXC
Ogni container LXC esegue il proprio sistema init, può ospitare più servizi e fornisce un ambiente userspace completo quasi indistinguibile da una macchina virtuale.
Questo approccio eccelle per carichi di lavoro legacy non progettati per la containerizzazione. Applicazioni che si aspettano di scrivere in /etc, eseguire servizi di sistema o interagire con l'intera gerarchia del filesystem funzionano senza problemi nei container LXC. Puoi migrare intere configurazioni di server in LXC senza rifattorizzare le applicazioni verso architetture a microservizi.
I container LXC condividono il kernel dell'host ma mantengono un'isolamento più forte rispetto ai container applicativi. Ogni container ottiene il proprio stack di rete, albero dei processi e namespace del filesystem, creando un isolamento simile a VM senza l'overhead della virtualizzazione hardware.
LXD, ora sotto Canonical, aggiunge un potente layer di gestione sopra LXC. LXD fornisce API REST, gestione delle immagini e funzionalità avanzate come la migrazione live tra host. Puoi spostare container in esecuzione tra macchine fisiche senza downtime, simile a VMware vMotion ma con i container.
Le funzionalità di passthrough dell'hardware permettono ai container LXD di accedere direttamente a GPU, dispositivi USB e altro hardware. È adatto a carichi di lavoro che necessitano di accesso a hardware specializzato mantenendo i vantaggi dei container come densità e provisioning rapido.
LXD supporta anche il clustering, permettendoti di gestire più host come un'unica unità logica con posizionamento automatizzato e funzionalità di failover.
Analisi comparativa
Ecco come i container di sistema si confrontano con i container applicativi su caratteristiche chiave:
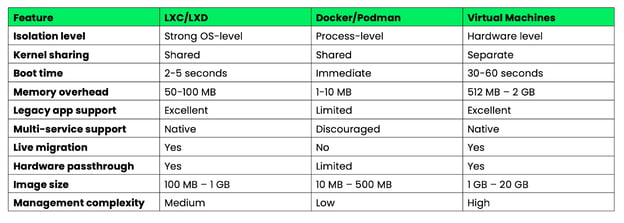
Immagine 6 - Panoramica delle caratteristiche chiave: Docker vs LXC vs macchine virtuali
I container di sistema colmano il divario tra i container applicativi leggeri e le macchine virtuali pesanti. Sono ideali quando servono capacità simili a VM con l'efficienza dei container, o quando si migrano applicazioni legacy che non possono essere facilmente scomposte in microservizi.
La scelta tra container di sistema e applicativi dipende dalle caratteristiche del carico di lavoro e dai requisiti operativi, non da una superiorità tecnica: risolvono problemi diversi nello spettro della containerizzazione.
Architetture di sicurezza nei runtime moderni
La sicurezza è passata da ripensamento a principio cardine di design nei runtime moderni dei container. Le piattaforme odierne implementano strategie di difesa in profondità che presuppongono la compromissione dei container e puntano a limitare il raggio d'azione degli attacchi.
Operatività rootless
I container rootless eliminano il rischio di sicurezza più grande nei deployment Docker tradizionali: il demone root. Podman ha aperto la strada eseguendo i container interamente con privilegi utente, usando i namespace utente Linux per mappare l'utente root del container a un ID utente non privilegiato sull'host.
L'implementazione si basa su intervalli subordinati di ID utente e gruppo (/etc/subuid e /etc/subgid) che consentono agli utenti non privilegiati di creare namespace isolati. Quando un processo nel container pensa di essere root (UID 0), il kernel lo mappa al tuo effettivo ID utente (ad esempio UID 1000) sull'host. Anche se un attaccante evade dal container, non può oltrepassare i permessi del tuo utente.
Containerd ha implementato funzionalità rootless simili tramite la sua modalità rootless, che utilizza le stesse tecniche di mapping dei namespace utente. Il runtime può avviare container, gestire immagini e gestire il networking senza richiedere privilegi di root sull'host.
Kubernetes ora supporta nativamente l'operatività rootless tramite il progetto Kubernetes-in-Rootless-Docker (KIND) e l'integrazione con containerd rootless. Ciò significa che interi cluster Kubernetes possono girare senza privilegi root, riducendo drasticamente la superficie d'attacco per ambienti multi-tenant e distribuzioni edge dove i modelli di sicurezza tradizionali non si applicano.
L'impatto sulla sicurezza va oltre la prevenzione dell'escalation di privilegi. I container rootless non possono associare porte privilegiate (sotto 1024), non possono accedere alla maggior parte dei filesystem /proc e /sys, e non possono eseguire operazioni che richiedono capacità del kernel. Questo crea confini naturali che contengono potenziali violazioni di sicurezza.
Integrazione Seccomp/BPF
I runtime moderni integrano eBPF (extended Berkeley Packet Filter) per l'enforcement in tempo reale delle policy di sicurezza che va oltre i controlli di accesso tradizionali. I programmi eBPF girano nello spazio kernel e possono monitorare, filtrare o modificare le system call mentre avvengono, offrendo visibilità e controllo senza precedenti sul comportamento dei container.
I profili Seccomp (Secure Computing) usano BPF per filtrare le system call a livello di kernel. Invece di consentire ai container l'accesso a tutte le oltre 300 system call di Linux, i profili seccomp definiscono esattamente quali chiamate sono permesse. Il profilo seccomp predefinito di Docker blocca system call potenzialmente pericolose, mentre i profili personalizzati possono essere ancora più restrittivi in base ai requisiti dell'applicazione.
L'integrazione avanzata con eBPF abilita il monitoraggio comportamentale in tempo reale. Strumenti come Falco usano programmi eBPF per rilevare comportamenti anomali dei container: connessioni di rete insolite, pattern di accesso ai file inattesi o tentativi di usare system call bloccate. Questi rilevamenti avvengono in tempo reale con overhead minimo sulle performance poiché il monitoraggio avviene nello spazio kernel.
L'enforcement delle policy di rete tramite eBPF fornisce un controllo granulare del traffico a livello di pacchetto. Cilium, una CNI Kubernetes popolare, usa eBPF per implementare policy di rete che possono filtrare il traffico in base ai protocolli del livello applicativo, non solo indirizzi IP e porte. Significa che puoi creare policy come "consentire richieste HTTP GET a /api/v1/users ma bloccare le POST" direttamente nel kernel.
La sicurezza basata su eBPF abilita anche un monitoraggio consapevole dei container che comprende la relazione tra processi, container e pod Kubernetes. Gli strumenti di monitoraggio tradizionali vedono processi individuali, ma i programmi eBPF possono correlare le system call con i metadati dei container per fornire insight di sicurezza contestuali.
Queste capacità trasformano la sicurezza da patch reattive a enforcement proattivo delle policy, dove i comportamenti sospetti vengono bloccati automaticamente prima che possano causare danni.
Strategie di ottimizzazione delle performance
Le performance dei container contano soprattutto quando esegui centinaia o migliaia di container nella tua infrastruttura. Esploriamo le strategie che minimizzano overhead di risorse e latenza di avvio.
Riduzione del cold start
Il tempo di cold start, ovvero il ritardo tra la richiesta di un container e il momento in cui è pronto a servire traffico, impatta direttamente l'esperienza utente e l'efficienza delle risorse. Sono emerse tecniche per minimizzare questi ritardi in diverse architetture di runtime.
Immagini pre-scaricate eliminano i tempi di download mantenendo in cache sui nodi le immagini di container usate frequentemente. I DaemonSet di Kubernetes possono pre-scaricare le immagini critiche, mentre registry come Harbor supportano la replica delle immagini verso sedi edge. Questa tecnica può ridurre il cold start da secondi a millisecondi per le immagini in cache.
Ottimizzazione dei layer delle immagini riduce la quantità di dati da trasferire ed estrarre. Le build multi-stage creano immagini finali più piccole, mentre strumenti come dive aiutano a individuare layer non necessari. Le immagini Distroless di Google eliminano gestori di pacchetti e shell, riducendo spesso significativamente le dimensioni delle immagini.
Lazy loading con progetti come Stargz consente ai container di avviarsi prima che l'intera immagine sia scaricata. Il runtime recupera solo i file necessari per l'avvio iniziale, scaricando i layer aggiuntivi on demand. Questo può ridurre i tempi di cold start da diversi secondi a meno di 1 secondo per immagini grandi.
Ottimizzazione del runtime varia a seconda dell'implementazione. L'implementazione in Rust di Youki mostra migliori performance di avvio rispetto a runC grazie a una gestione della memoria più efficiente. Crun, scritto in C, ottiene miglioramenti simili eliminando l'overhead del garbage collector di Go durante la creazione dei container.
Condivisione degli snapshot in containerd consente a più container di condividere snapshot di filesystem in sola lettura, riducendo sia lo storage sia l'overhead di memoria. Quando si avviano più container dalla stessa immagine, solo i layer scrivibili necessitano di allocazioni separate.
Ottimizzazione del processo init può ridurre i tempi di avvio usando init system leggeri come tini o progettando con cura le sequenze di avvio dell'applicazione per minimizzare il lavoro di inizializzazione.
Efficienza della memoria
L'overhead di memoria varia tra i runtime dei container, con differenze che diventano critiche in ambienti con risorse limitate o distribuzioni ad alta densità.
Overhead di base del runtime differisce in modo sostanziale:
- Docker Engine: richiede overhead del demone più overhead per container
- Podman: nessun overhead di demone grazie all'architettura senza demone, overhead per container minimo
- Containerd: overhead del demone moderato più overhead per container minimo
- CRI-O: overhead del demone basso più overhead per container minimo
Deduplicazione dei layer delle immagini consente di risparmiare memoria quando si eseguono più container da immagini correlate. I runtime dei container utilizzano filesystem copy-on-write in cui i layer condivisi consumano memoria una sola volta tra tutti i container. Un cluster che esegue molti container da immagini base simili può ottenere notevoli risparmi di memoria tramite deduplicazione.
Ottimizzazione del memory mapping nei runtime moderni riduce la memoria residente. Strumenti come crun mappano i file eseguibili direttamente dallo storage anziché caricarli in memoria, riducendo l'impronta di memoria per container con binari di grandi dimensioni.
Accounting della memoria con cgroup offre un controllo preciso sui limiti di memoria dei container, ma i diversi runtime gestiscono la pressione della memoria in modo differente. Alcuni runtime implementano un migliore recupero di memoria sotto pressione, mentre altri forniscono una reportistica sull'uso della memoria più accurata per decisioni di autoscaling.
Overhead della memoria in modalità rootless scambia un po' di efficienza con la sicurezza. I container rootless richiedono processi aggiuntivi per la gestione dei namespace utente e del networking, aggiungendo in genere overhead rispetto al funzionamento con privilegi di root.
La scelta tra runtime spesso si riduce al bilanciamento tra efficienza della memoria e requisiti funzionali. CRI-O offre un overhead ridotto per carichi di lavoro Kubernetes, mentre Podman sacrifica parte dell'efficienza per benefici di sicurezza e compatibilità.
Integrazione con il workflow di sviluppo
Il miglior runtime dei container è inutile se non si integra con il tuo workflow di sviluppo. Le alternative a Docker hanno implementato tool che spesso superano l'esperienza sviluppatore di Docker in scenari specifici.
Ambienti Kubernetes locali
Lo sviluppo Kubernetes locale è andato oltre l'approccio con macchina virtuale di minikube verso soluzioni più efficienti che si integrano direttamente con i runtime dei container. La scelta dell'ambiente locale impatta significativamente la velocità di sviluppo e il consumo di risorse.
Kind (Kubernetes in Docker) crea cluster Kubernetes usando nodi container invece di macchine virtuali. Il setup richiede in genere 1-2 minuti con overhead di memoria moderato per nodo. Kind funziona con qualsiasi runtime compatibile con Docker, quindi puoi usarlo con Podman (kind create cluster --runtime podman) per uno sviluppo Kubernetes rootless.
K3s offre un'opzione leggera, eseguendo una distribuzione Kubernetes completa con uso minimo di memoria. Si avvia rapidamente e include storage, networking e controller di ingress integrati. K3s funziona bene con containerd e può girare su macchine di sviluppo con risorse limitate.
MicroK8s di Canonical offre una via di mezzo con uso di memoria moderato e add-on modulari. Si integra bene con containerd e fornisce funzionalità simili alla produzione senza l'overhead delle macchine virtuali. Il tempo di avvio è ragionevole per un cluster completo.
Rancher Desktop combina K3s con backend containerd o Dockerd, offrendo un'alternativa a Docker Desktop che usa meno risorse. Include scansione immagini integrata e integrazione con la dashboard di Kubernetes.
I pod di Podman offrono un'alternativa unica: puoi sviluppare applicazioni multi-container usando il concetto di pod di Podman, che rispecchia il comportamento dei pod di Kubernetes. Genera YAML di Kubernetes direttamente dai pod in esecuzione con podman generate kube, creando un percorso senza soluzione di continuità dallo sviluppo locale al deployment in cluster.
Ottimizzazione delle pipeline CI/CD
Le pipeline CI/CD tradizionali basate su Docker presentano limitazioni in ambienti containerizzati in cui eseguire Docker-in-Docker crea sfide di sicurezza e performance. Le alternative moderne offrono soluzioni migliori per costruire e pubblicare immagini di container nei sistemi CI.
Buildah eccelle negli ambienti CI perché non richiede un demone né privilegi di root. Puoi creare immagini conformi a OCI usando script shell più verificabili dei Dockerfile. L'approccio a script di Buildah consente una costruzione dinamica delle immagini in base alle variabili CI, rendendolo ideale per processi di build complessi che necessitano di logica condizionale.
Immagine 7 - Home page di Buildah
Per confronto, i Dockerfile tradizionali usano istruzioni dichiarative:
FROM alpine:latest
RUN apk add --no-cache nodejs npm
COPY package.json /app/
WORKDIR /appBuildah usa comandi shell imperativi che possono includere variabili e logica condizionale:
# Buildah scripting approach with CI integration
buildah from alpine:latest
buildah run $container apk add --no-cache nodejs npm
buildah copy $container package.json /app/
buildah config --workingdir /app $container
buildah commit $container myapp:${CI_COMMIT_SHA}Questa flessibilità di scripting ti permette di scegliere dinamicamente le immagini base, installare pacchetti in modo condizionale in base ai nomi dei branch o modificare gli step di build in base alle variabili d'ambiente della CI: capacità che richiedono workaround complessi nei Dockerfile tradizionali.
Kaniko risolve il problema del Docker-in-Docker costruendo le immagini interamente nello userspace all'interno di un container. Gira in pod Kubernetes senza richiedere accesso privilegiato o un demone Docker. Kaniko è efficace nelle pipeline di GitLab CI e Jenkins X dove le policy di sicurezza impediscono container privilegiati.
Lo strumento estrae le immagini base, applica le istruzioni del Dockerfile in isolamento e invia i risultati direttamente ai registry. I tempi di build sono paragonabili a Docker ma con una postura di sicurezza molto migliore in ambienti orchestrati.
Nerdctl fornisce compatibilità con la CLI di Docker per containerd, il che lo rende un eccellente sostituto drop-in di Docker nei sistemi CI. Supporta gli stessi comandi di build, push e pull di Docker ma usa containerd come backend. Ciò elimina il demone Docker mantenendo workflow familiari.
Nerdctl include funzionalità avanzate come il lazy pulling e le immagini crittografate che possono migliorare le performance della CI. Per i team che usano containerd in produzione, nerdctl crea coerenza tra ambienti CI e runtime.
Confronto delle performance nelle pipeline CI:
- Docker: richiede un demone completo, potenziali problemi di sicurezza con container privilegiati
- Buildah: nessun demone, capace di operare rootless, sintassi diversa dai Dockerfile
- Kaniko: basato su container, sicuro by design, richiede ambiente Kubernetes
- Nerdctl: backend containerd, ideale per distribuzioni basate su containerd
La scelta dipende dai tuoi requisiti di sicurezza, dall'infrastruttura esistente e dalle necessità prestazionali. Kaniko funziona meglio in ambienti Kubernetes orientati alla sicurezza, mentre Buildah eccelle quando serve una logica di build complessa difficile da esprimere nei Dockerfile.
Considerazioni per le distribuzioni enterprise
Le distribuzioni di container in ambito enterprise richiedono più che la scelta del runtime giusto: servono piattaforme che gestiscano conformità, governance e operazioni multi-cluster su larga scala. Le alternative ai container che scegli devono integrarsi con gli strumenti di gestione enterprise e soddisfare i requisiti normativi.
Gestione multi-cluster
Gestire container tra più cluster, cloud e sedi edge richiede piattaforme di orchestrazione sofisticate che vadano oltre il Kubernetes di base. Le soluzioni enterprise forniscono gestione centralizzata, enforcement delle policy e coerenza operativa in ambienti eterogenei.
Red Hat OpenShift si basa su Kubernetes con scelte di runtime dei container adatte all'enterprise. OpenShift usa di default CRI-O per una migliore sicurezza ed efficienza delle risorse rispetto a distribuzioni basate su Docker. La piattaforma include scansione immagini integrata, enforcement delle policy e workflow per sviluppatori che funzionano in modo coerente su AWS, Azure o infrastrutture on-premise.
Immagine 8 - Home page di Red Hat OpenShift
La gestione multi-cluster di OpenShift si occupa di standardizzare i runtime tra gli ambienti. Puoi imporre che tutti i cluster usino CRI-O con policy di sicurezza specifiche, garantendo un comportamento coerente che i container girino in sviluppo, staging o produzione.
Rancher fornisce un'interfaccia unificata per gestire cluster Kubernetes indipendentemente dal runtime sottostante dei container. Rancher supporta cluster che eseguono Docker, containerd o CRI-O, consentendoti di migrare i runtime gradualmente senza interrompere le operazioni. La piattaforma include monitoraggio centralizzato, backup e scansione della sicurezza su tutti i cluster gestiti.
Immagine 9 - Home page di Rancher
L'approccio di Rancher è prezioso quando hai ambienti misti: alcuni cluster possono usare containerd per le performance mentre altri usano CRI-O per la conformità alla sicurezza. Il layer di gestione astrae queste differenze fornendo al contempo strumenti operativi consistenti.
Mirantis Kubernetes Engine si concentra su ambienti Docker enterprise ma supporta la migrazione verso distribuzioni basate su containerd. La piattaforma offre supporto enterprise, hardening della sicurezza e strumenti di conformità che funzionano su diversi runtime dei container.
Immagine 10 - Home page di Mirantis
Queste piattaforme risolvono la complessità operativa dell'esecuzione di diversi runtime dei container nella tua infrastruttura mantenendo policy di governance e sicurezza centralizzate.
Conformità normativa
Gli ambienti enterprise richiedono spesso la conformità a normative come FIPS 140-2, SOC 2 o GDPR, che impattano direttamente la scelta e la configurazione del runtime dei container. La conformità non riguarda solo il runtime in sé: si estende ai registry di immagini, alla scansione di sicurezza e al logging di audit.
Validazione FIPS (Federal Information Processing Standards) richiede moduli crittografici conformi agli standard governativi. Non tutti i runtime dei container supportano librerie crittografiche validate FIPS. Red Hat Enterprise Linux fornisce versioni conformi a FIPS di CRI-O e Podman, mentre le installazioni standard di Docker spesso richiedono configurazioni aggiuntive per raggiungere la conformità FIPS.
La conformità FIPS influisce sulla firma delle immagini, sulle comunicazioni TLS e sullo storage crittografato. Le piattaforme di container devono usare librerie crittografiche validate FIPS per tutte le operazioni di sicurezza, dal pull delle immagini all'instaurazione delle connessioni di rete tra container.
Conformità GDPR impatta il modo in cui le piattaforme di container gestiscono i dati personali nei log, nelle metriche e nei metadati delle immagini. Registry enterprise come Harbor, Quay e AWS ECR offrono funzionalità come controlli sulla residenza dei dati, audit logging e policy automatiche di conservazione dei dati.
I runtime dei container devono supportare funzionalità di conformità come:
- Audit logging che catturi tutte le operazioni sui container per report di conformità
- Tracciamento della provenienza delle immagini per dimostrare la fonte e il processo di build delle immagini dei container
- Crittografia a riposo per immagini dei container e dati di runtime
- Enforcement delle policy di rete per controllare i flussi di dati tra container e sistemi esterni
Conformità SOC 2 richiede controlli di sicurezza dimostrabili su gestione degli accessi, monitoraggio del sistema e protezione dei dati. Le piattaforme di container devono integrarsi con provider di identità enterprise, fornire trail di audit dettagliati e supportare l'enforcement automatico delle policy di sicurezza.
I runtime moderni come CRI-O e containerd forniscono fondamenta di conformità migliori rispetto a Docker perché offrono controlli di sicurezza più granulari, un audit logging migliore e una separazione più pulita tra componenti di runtime e interfacce di gestione.
La conformità si estende anche alla sicurezza della supply chain: garantire che le immagini dei container provengano da fonti affidabili e non siano state manomesse. Strumenti come Sigstore e in-toto forniscono verifica crittografica della provenienza delle immagini dei container, mentre gli admission controller possono imporre che nei cluster di produzione girino solo immagini firmate e scansionate.
Tendenze emergenti nella containerizzazione
Il panorama della containerizzazione continua a evolversi oltre i container Linux tradizionali verso nuovi modelli di esecuzione e paradigmi di osservabilità. Queste tecnologie emergenti promettono di affrontare limitazioni fondamentali nelle architetture attuali dei container.
Integrazione WebAssembly
WebAssembly (WASM) sta emergendo come alternativa interessante ai container OCI tradizionali per carichi di lavoro specifici. A differenza dei container che impacchettano un intero userspace del sistema operativo, WebAssembly fornisce un ambiente di esecuzione leggero e sandboxato che gira a velocità quasi native su diverse architetture.
I moduli WASM si avviano molto più velocemente dei container tradizionali, rendendoli ideali per funzioni serverless e edge computing, dove il tempo di cold start impatta direttamente l'esperienza utente. Un modulo WebAssembly può gestire significativamente più richieste di un container con tempi di inizializzazione più lenti.
Il modello di sicurezza differisce in modo fondamentale dai container. WebAssembly fornisce una sicurezza basata sulle capacità, in cui i moduli possono accedere solo alle risorse esplicitamente concesse. Non c'è una superficie condivisa del kernel come nei container tradizionali: i moduli WASM girano in un ambiente sandbox che previene molte classi di vulnerabilità di sicurezza.
I runtime dei container stanno iniziando a supportare i carichi di lavoro WebAssembly diretto. Wasmtime si integra con containerd come shim di runtime, permettendoti di distribuire moduli WASM usando YAML standard di Kubernetes. Ciò significa che puoi mescolare carichi di lavoro tradizionali in container e WebAssembly nello stesso cluster in base a requisiti di performance e sicurezza.
Il compromesso è la maturità dell'ecosistema. WebAssembly ha un supporto linguistico limitato rispetto ai container: Rust, C/C++ e AssemblyScript funzionano bene, mentre linguaggi come Python e Java richiedono layer di runtime aggiuntivi che riducono i benefici prestazionali.
WASM eccelle per carichi computazionali, funzioni serverless ed edge computing, ma non è pronto a sostituire i container per applicazioni complesse che necessitano di un'ampia integrazione con il sistema operativo.
Osservabilità abilitata da eBPF
eBPF (extended Berkeley Packet Filter) sta trasformando l'osservabilità dei container fornendo insight a livello di kernel senza richiedere modifiche alle applicazioni o container sidecar. A differenza del monitoraggio tradizionale che si basa su metriche esportate dalle applicazioni, i programmi eBPF osservano le system call, il traffico di rete e gli eventi del kernel in tempo reale.
Il monitoraggio consapevole dei container tramite eBPF correla eventi di sistema di basso livello con metadati di livello superiore di container e Kubernetes. Gli strumenti come Pixie e Cilium Hubble possono mostrarti esattamente quali richieste HTTP fluiscono tra pod specifici, includendo latenza delle richieste, ispezione del payload e tassi di errore, il tutto senza modificare le tue applicazioni.
Questo approccio fornisce una visibilità senza precedenti sui pattern di comunicazione dei microservizi. Puoi generare mappe dei servizi automaticamente osservando i flussi di rete reali invece di affidarti a configurazioni statiche. Quando un servizio inizia a comunicare con una nuova dipendenza, gli strumenti basati su eBPF lo rilevano immediatamente e aggiornano la topologia dei servizi in tempo reale.
Profilazione delle performance tramite eBPF identifica i colli di bottiglia a livello di container. Invece di indovinare perché un pod è lento, puoi vedere esattamente quali system call richiedono tempo, quali file vengono accessi e come la latenza di rete influisce sulle performance dell'applicazione. Questi dati sono raccolti continuamente con overhead minimo, in genere meno dell'1% di uso CPU.
Monitoraggio della sicurezza beneficia della capacità di eBPF di rilevare pattern di comportamento anomalo. Invece di analizzare i log dopo un incidente, i programmi eBPF possono rilevare in tempo reale system call sospette, connessioni di rete inattese o pattern di accesso ai file. Questo abilita un rilevamento delle minacce in tempo reale consapevole dei confini dei container e dell'identità dei workload Kubernetes.
L'integrazione tra eBPF e runtime dei container continua ad approfondirsi. Cilium fornisce networking basato su eBPF per Kubernetes più veloce e più osservabile dei plugin CNI tradizionali. Falco usa eBPF per un monitoraggio della sicurezza a runtime che comprende nativamente il contesto dei container.
Questa tendenza verso l'osservabilità a livello di kernel rappresenta un passaggio fondamentale dal monitoraggio "scatola nera" alla trasparenza completa del sistema, rendendo gli ambienti container più facilmente diagnosticabili e sicuri di default.
Riepilogo delle alternative a Docker
Scegliere l'alternativa giusta a Docker non significa trovare un singolo rimpiazzo, ma abbinare gli strumenti ai casi d'uso specifici nei tuoi ambienti di sviluppo e produzione. L'ecosistema della containerizzazione è maturato in una raccolta di soluzioni che eccellono in scenari diversi.
Per l'esperienza sviluppatore, Podman offre il percorso di migrazione più fluido grazie alla compatibilità con la CLI di Docker, fornendo al contempo una sicurezza superiore con l'operatività rootless. Se sei fortemente investito nei workflow di Docker Desktop, Rancher Desktop con containerd offre funzionalità simili con migliore efficienza delle risorse. I team che costruiscono pipeline CI/CD complesse beneficiano della flessibilità di scripting di Buildah o dell'approccio sicuro e senza demone di Kaniko.
Su scala produttiva, containerd e CRI-O offrono prestazioni e efficienza delle risorse migliori rispetto a Docker Engine. Containerd eccelle in ambienti enterprise che necessitano di stabilità e set di funzionalità estesi, mentre CRI-O fornisce l'opzione più efficiente per distribuzioni focalizzate su Kubernetes. Per edge computing o sistemi embedded, runtime leggeri come runC o Youki offrono l'overhead minimo richiesto in ambienti con risorse limitate.
Le organizzazioni attente alla sicurezza dovrebbero dare priorità a runtime rootless come Podman o containerd rootless. La combinazione di isolamento tramite namespace utente, monitoraggio basato su eBPF e ridotta superficie d'attacco offre una difesa in profondità che i deployment Docker tradizionali non possono eguagliare. Per i settori regolamentati, assicurati che il runtime scelto supporti la conformità FIPS e si integri con i sistemi enterprise di audit logging.
Un approccio ibrido spesso funziona meglio nella pratica. Usa Podman per lo sviluppo locale per beneficiare della sicurezza rootless e della compatibilità con Docker. Distribuisci i carichi di lavoro di produzione su containerd o CRI-O per un'integrazione e performance ottimali con Kubernetes. Tieni strumenti specializzati come Buildah per le pipeline CI/CD, dove sicurezza e flessibilità contano più della compatibilità.
>Cerchi idee per progetti su Docker e containerizzazione? Queste 10 ti metteranno in moto.
Guardando avanti, WebAssembly ed eBPF rappresentano la prossima evoluzione della containerizzazione. I tempi di avvio rapidi e le forti garanzie di sicurezza di WebAssembly probabilmente domineranno i carichi di lavoro serverless e di edge computing. L'osservabilità a livello di kernel di eBPF sta già trasformando il modo in cui monitoriamo e mettiamo in sicurezza le applicazioni containerizzate. Queste tecnologie non sostituiranno del tutto i container tradizionali, ma creeranno nuove categorie di carichi di lavoro dove le attuali limitazioni dei container non si applicano.
La chiave è rimanere flessibili man mano che queste tecnologie maturano e capire che la migliore strategia di containerizzazione combina più strumenti invece di dipendere da un'unica soluzione.
Se vuoi saperne di più su Docker, containerizzazione, virtualizzazione e Kubernetes, questi corsi sono il passo successivo perfetto:





Se vuoi ottimizzare il tuo workflow di containerizzazione, ecco la buona notizia: l'ecosistema si è evoluto ben oltre il design originale di Docker.
Docker ha rivoluzionato il deployment del software rendendo la containerizzazione uno standard, ma l'ecosistema è cresciuto per rispondere a casi d'uso specifici per cui Docker non era stato progettato all'inizio. Le alternative moderne come Podman, containerd e CRI-O offrono funzionalità specializzate come design senza demone, operazioni rootless e integrazione nativa con Kubernetes. Questi strumenti non offrono solo miglioramenti incrementali, ma rappresentano cambiamenti fondamentali nel modo in cui pensiamo alla sicurezza, alle performance e all'integrazione dei workflow dei container.
L'ecosistema dei container è maturato oltre l'approccio monolitico di Docker, con runtime specializzati ottimizzati per casi d'uso specifici. Che tu stia eseguendo microservizi in produzione, sviluppando in locale o gestendo carichi di lavoro enterprise, è probabile che esista uno strumento più adatto alle tue esigenze specifiche.
In questa guida ti mostrerò le alternative a Docker più promettenti nel 2026 e ti aiuterò a scegliere lo strumento giusto per le tue necessità.
>Nuovo a Docker e alla containerizzazione? Leggi la nostra guida pratica approfondita per principianti per iniziare.
L'evoluzione della containerizzazione oltre Docker
Capire come siamo arrivati fin qui aiuta a spiegare perché le alternative a Docker hanno guadagnato così tanta trazione.
Quando Docker è stato lanciato nel 2013, non ha inventato i container: li ha resi accessibili. I container Linux esistevano già tramite LXC (Linux Containers) dal 2008, ma l'offerta di Docker è stata impacchettare la tecnologia con una semplice API, un formato di immagine portabile e un workflow a misura di sviluppatore. Questa standardizzazione ha portato i container da una funzione di nicchia di Linux alle fondamenta del deployment moderno delle applicazioni.
Il successo di Docker ha portato alla nascita della Open Container Initiative (OCI) nel 2015, che ha standardizzato formati e runtime dei container. Ciò ha significato che i container non erano bloccati nell'ecosistema di Docker. Qualsiasi runtime conforme a OCI poteva eseguire immagini Docker, e qualsiasi immagine conforme a OCI poteva girare su diverse piattaforme di container.
Ma l'architettura monolitica di Docker ha iniziato a mostrare crepe man mano che la containerizzazione maturava. Il demone Docker gira come root, il che crea problemi di sicurezza. Il suo design tutto-in-uno accoppia build delle immagini, runtime dei container e orchestrazione in modi che non sempre hanno senso per gli ambienti di produzione. I team avevano bisogno di un controllo più granulare.
Questo ha portato all'emergere di alternative specializzate che affrontano problemi specifici per cui Docker non era stato progettato.
I runtime moderni dei container si differenziano da Docker in tre aree chiave:
Queste non sono solo migliorie tecniche: rappresentano filosofie diverse su come i container dovrebbero funzionare negli ambienti di produzione.
>Hai una comprensione teorica di Docker, ma non hai ancora containerizzato un'applicazione? Leggi la nostra guida pratica per cambiare le cose.