Corso
Introduzione a R
4 ore
3.1M
La regressione lineare è una delle tecniche statistiche più importanti e fondamentali. Padroneggiarla è essenziale per qualsiasi data analyst e data scientist perché, come vedrai, costituisce la base per molti metodi più avanzati.
Questo tutorial ti guiderà nel processo di esecuzione di una regressione lineare in R, un linguaggio di programmazione molto importante. Alla fine, saprai come implementare e interpretare modelli di regressione lineare, così da applicare più facilmente queste conoscenze alle tue analisi dei dati.
Se non conosci il linguaggio R, ti consiglio i nostri tutorial per iniziare: Analisi esplorativa dei dati in R per principianti assoluti e Padroneggiare le strutture dati nel linguaggio R.
La regressione lineare è un modello statistico che analizza la relazione tra una variabile di risposta (spesso chiamata y) e una o più variabili e le loro interazioni (spesso chiamate x o variabili esplicative). Fai questo tipo di collegamento mentalmente di continuo: ad esempio, quando stimi l'età di un bambino in base alla sua altezza, stai assumendo che più è grande, più sarà alto.
La regressione lineare è uno dei modelli statistici più basilari. I suoi risultati sono interpretabili quasi da chiunque, ed esiste dall'inizio del XIX secolo. È proprio questo a renderla così popolare: è semplice e ha resistito per centinaia di anni. Anche se non è sofisticata come altri algoritmi come le reti neurali artificiali o le random forest, secondo un sondaggio di KD Nuggets, la regressione è stata l'algoritmo più usato dai data scientist nel 2016 e nel 2017. Si prevede persino che verrà usata ancora nel 2118!
In questo tutorial sulla regressione lineare, vedremo come creare una regressione lineare in R, analizzando i passaggi da seguire con un esempio pratico su cui esercitarti.
Per eseguire facilmente tu stesso tutto il codice di esempio di questo tutorial, puoi creare gratuitamente un workbook DataLab con R preinstallato che contiene tutti i frammenti di codice. Per fare altra pratica con la regressione lineare, dai un'occhiata al nostro esercizio pratico su DataCamp.
Non tutti i problemi si risolvono con lo stesso algoritmo. La regressione lineare funziona bene quando c'è una relazione lineare tra risposta e variabili esplicative. In altre parole, la regressione lineare assume che esista una relazione lineare tra la variabile di risposta e le variabili esplicative. Nel caso di due variabili, significa che puoi adattare una retta tra le due. Tornando all'esempio dell'età del bambino, è chiaro che c'è una relazione tra età e altezza.
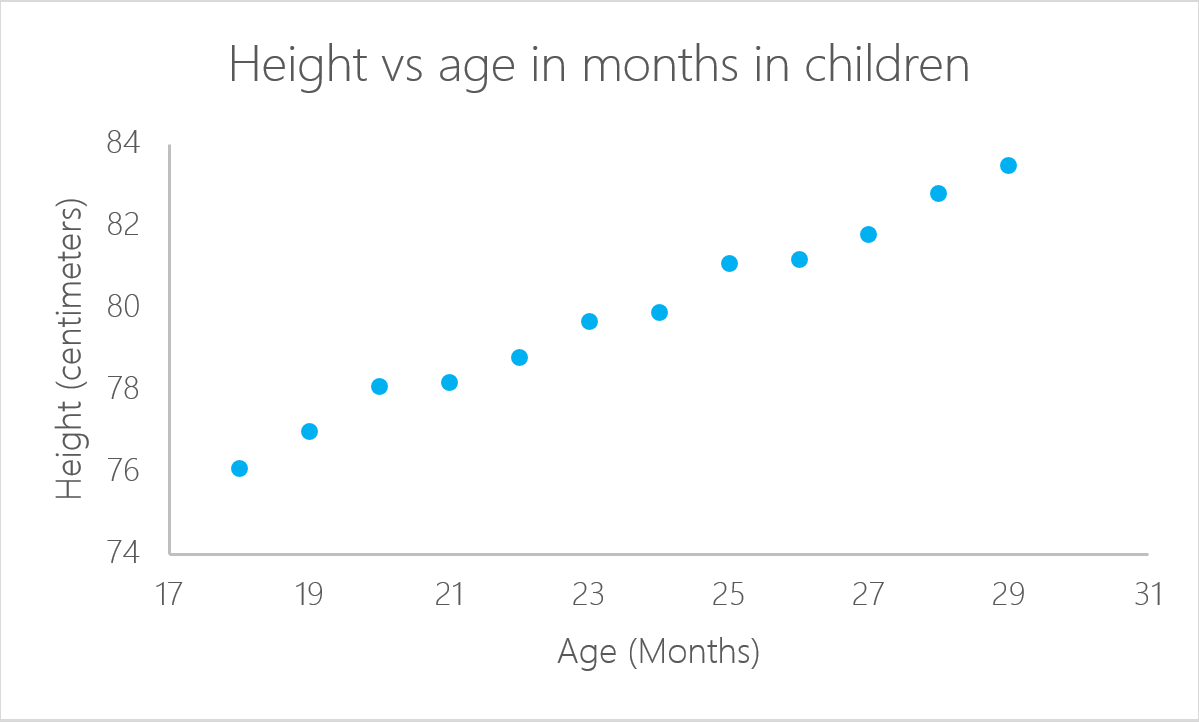
In questo esempio specifico, puoi calcolare l'altezza di una bambina se conosci la sua età:
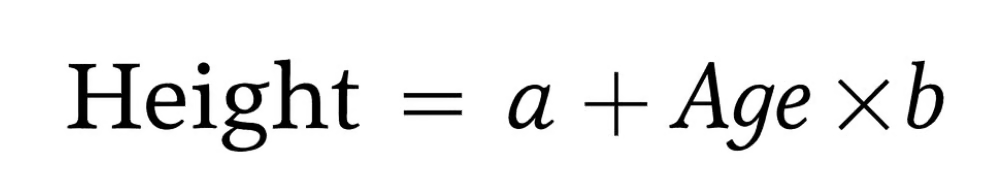
In questo caso, a e b sono chiamati rispettivamente intercetta e pendenza. Con lo stesso esempio, a, ossia l'intercetta, è il valore da cui inizi a misurare. I neonati di zero mesi non sono alti zero centimetri. Questa è la funzione dell'intercetta. La pendenza misura la variazione di altezza rispetto all'età in mesi. In generale, per ogni mese in più, l'altezza del bambino aumenterà di b.
Una regressione lineare può essere calcolata in R con il comando lm(). Nel prossimo esempio, usiamo questo comando per calcolare l'altezza stimata in base all'età del bambino.
Per prima cosa, importa la libreria readxl per leggere file Microsoft Excel. Il nostro corso Introduzione all'importazione dei dati in R è una risorsa ottima se non hai familiarità con l'importazione di file Excel o CSV in un ambiente R come RStudio.
Puoi scaricare i dati da usare per questo tutorial prima di iniziare. Scarica i dati in un oggetto chiamato ageandheight e poi crea la regressione lineare alla terza riga. La funzione lm() accetta le variabili nel formato:
lm([target] ~ [predictor], data = [data source])Nel codice seguente, usiamo la funzione lm() per creare un oggetto di modello lineare, che chiamiamo lmHeight. Poi usiamo la funzione summary() su lmHeight per vedere informazioni dettagliate sulle prestazioni del modello e sui coefficienti.
library(readxl)

ageandheight <- read_excel("ageandheight.xls", sheet = "Hoja2") #Upload the data

lmHeight = lm(height~age, data = ageandheight) #Create the linear regression

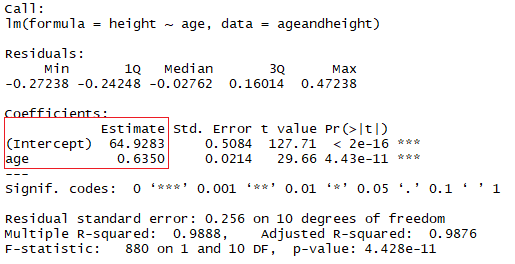
summary(lmHeight) #Review the resultsNel riquadro rosso puoi vedere i valori dell'intercetta (valore "a") e della pendenza (valore "b") per l'età. Questi valori "a" e "b" tracciano una retta tra tutti i punti dei dati. Quindi, in questo caso, se c'è un bambino di 20,5 mesi, a è 64,92 e b è 0,635, il modello prevede (in media) che la sua altezza in centimetri sia circa 64,92 + (0,635 * 20,5) = 77,93 cm.
Quando una regressione considera due o più predittori per creare la regressione lineare, si parla di regressione lineare multipla. Seguendo la stessa logica usata nell'esempio semplice precedente, l'altezza del bambino verrà misurata da:
Altezza = a + Età × b1 + (Numero di fratelli} × b2
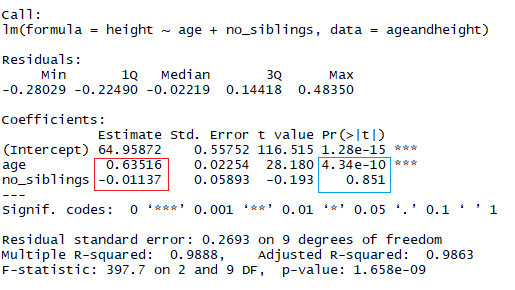
Ora stai considerando l'altezza come funzione dell'età in mesi e del numero di fratelli che il bambino ha. Nell'immagine sopra, il rettangolo rosso indica i coefficienti (b1 e b2). Puoi interpretare questi coefficienti nel modo seguente:
Confrontando bambini con lo stesso numero di fratelli, l'altezza media prevista aumenta di 0,63 cm per ogni mese in più. Allo stesso modo, confrontando bambini con la stessa età, l'altezza diminuisce (perché il coefficiente è negativo) di -0,01 cm per ogni aumento nel numero di fratelli.
In R, per aggiungere un altro coefficiente, aggiungi il simbolo "+" per ogni variabile aggiuntiva che vuoi inserire nel modello.
lmHeight2 = lm(height~age + no_siblings, data = ageandheight) #Create a linear regression with two variables
summary(lmHeight2) #Review the results
Come avrai già notato, guardare al numero di fratelli è un modo poco sensato per prevedere l'altezza di un bambino. Un altro aspetto a cui prestare attenzione nei modelli lineari è il p-value dei coefficienti. Nell'esempio precedente, il rettangolo blu indica i p-value per i coefficienti età e numero di fratelli. In parole semplici, un p-value indica se puoi rifiutare o accettare un'ipotesi. L'ipotesi, in questo caso, è che il predittore non sia significativo per il modello.
Un modo standard per testare se i predittori non sono significativi è verificare se i p-value sono inferiori a 0,05.
Un buon modo per valutare la qualità dell'adattamento del modello è guardare i residui, ossia le differenze tra i valori reali e quelli previsti. La linea retta nell'immagine sopra rappresenta i valori previsti. La linea verticale rossa dalla retta al valore osservato è il residuo.
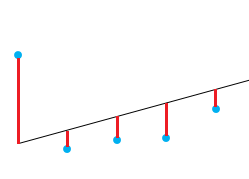
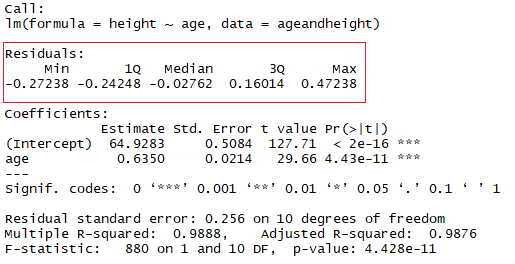
L'idea è che la somma dei residui sia approssimativamente zero o il più bassa possibile. Nella realtà, la maggior parte dei casi non segue una retta perfetta, quindi i residui sono attesi. Nel riepilogo R della funzione lm() puoi vedere statistiche descrittive sui residui del modello; seguendo lo stesso esempio, il riquadro rosso mostra come i residui siano approssimativamente zero.
Una misura molto usata per valutare la bontà del modello è il coefficiente di determinazione o R². Questa misura è definita dalla proporzione della variabilità totale spiegata dal modello di regressione.
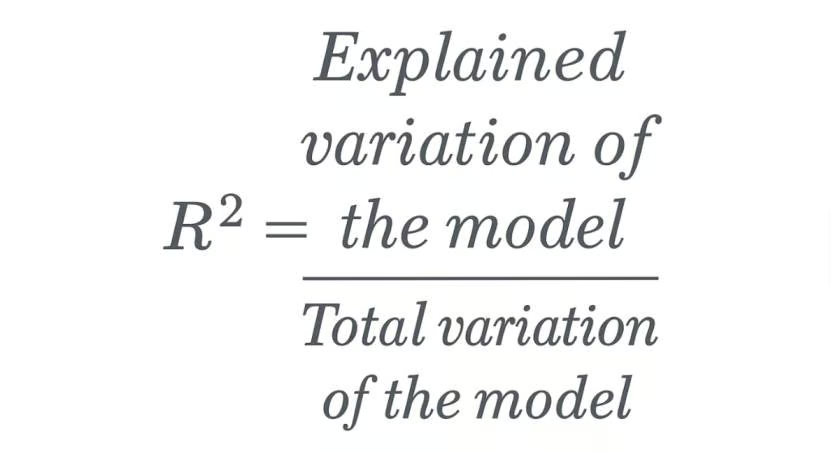
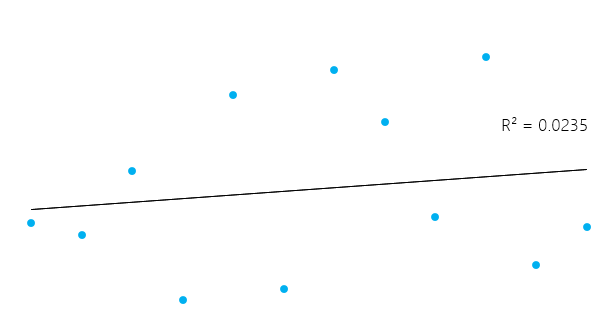
Può sembrare un po' complicato, ma in generale, per i modelli che si adattano bene ai dati, R² è vicino a 1. I modelli che si adattano male hanno R² vicino a 0. Negli esempi sotto, il primo ha un R² di 0,02; significa che il modello spiega solo il 2% della variabilità dei dati. Il secondo ha un R² di 0,99 e il modello riesce a spiegare il 99% della variabilità totale.**
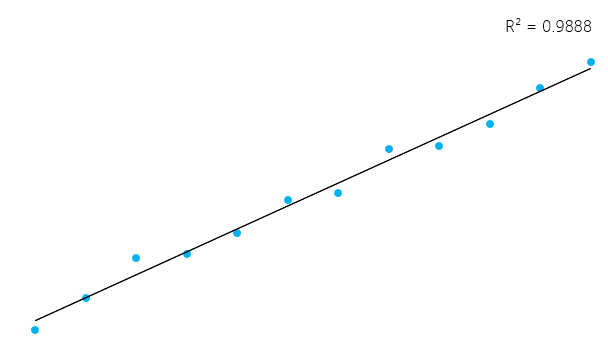
Tuttavia, è importante ricordare che a volte un R² alto non è necessariamente sempre positivo (vedi i grafici dei residui sotto) e un R² basso non è necessariamente sempre negativo. Nella realtà, gli eventi non seguono sempre una retta perfetta. Ad esempio, potresti avere nel tuo dataset bambini più alti o più bassi con la stessa età. In alcuni ambiti, un R² di 0,5 è considerato buono.
Con lo stesso esempio di prima, guarda il riepilogo del modello lineare per vederne l'R².
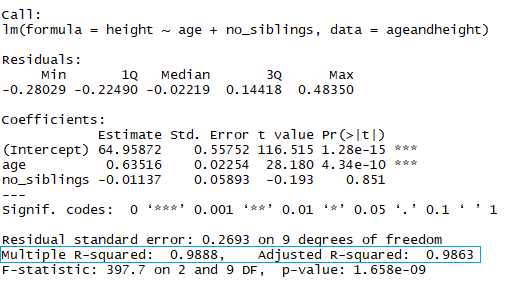
Nel rettangolo blu, nota che ci sono due R² diversi, uno multiplo e uno aggiustato. Il multiplo è l'R² che hai visto prima. Un problema con questo R² è che non può diminuire quando aggiungi più variabili indipendenti al modello: continuerà ad aumentare man mano che rendi il modello più complesso, anche se queste variabili non aggiungono nulla alle previsioni (come nell'esempio del numero di fratelli). Per questo motivo, l'R² aggiustato è probabilmente più indicato se stai aggiungendo più di una variabile al modello, perché aumenta solo se riduce l'errore complessivo delle previsioni.
Potresti avere un R² piuttosto buono nel tuo modello, ma non affrettiamo le conclusioni. Vediamo un esempio. Vuoi prevedere la pressione di un materiale in laboratorio in base alla sua temperatura.
Tracciamo i dati (con un semplice scatterplot) e aggiungiamo la retta costruita con il tuo modello lineare. In questo esempio, fai leggere prima i dati a R, di nuovo con il comando read_excel, per creare un dataframe con i dati, poi crea una regressione lineare con i nuovi dati. Il comando plot() accetta un data frame e ne traccia le variabili. In questo caso, traccia la pressione in funzione della temperatura del materiale. Poi aggiungi la retta della regressione con il comando abline.
pressure <- read_excel("pressure.xlsx") #Upload the data
lmTemp = lm(Pressure~Temperature, data = pressure) #Create the linear regression
plot(pressure, pch = 16, col = "blue") #Plot the results
abline(lmTemp) #Add a regression line
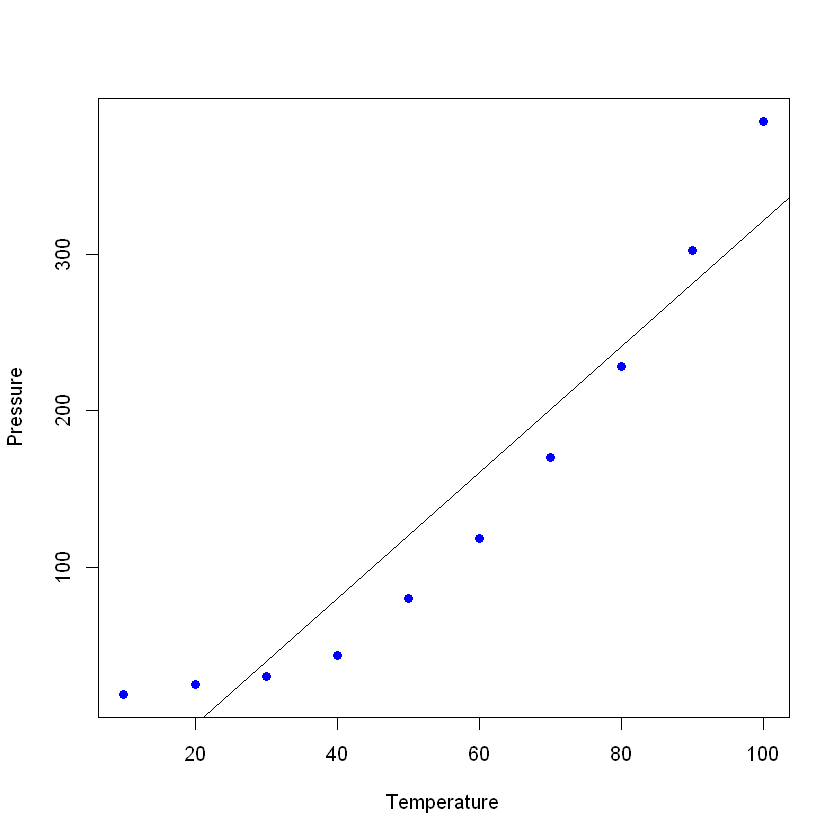
Se guardi il riepilogo del nuovo modello, puoi vedere che ha risultati piuttosto buoni (guarda R² e R² aggiustato)
summary(lmTemp)
Call:
lm(formula = Pressure ~ Temperature, data = pressure)

Residuals:
   Min     1Q Median     3Q    Max
-41.85 -34.72 -10.90  24.69  63.51

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept) -81.5000    29.1395  -2.797   0.0233 *
Temperature   4.0309     0.4696   8.583 2.62e-05 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 42.66 on 8 degrees of freedom
Multiple R-squared:  0.902,    Adjusted R-squared:  0.8898
F-statistic: 73.67 on 1 and 8 DF,  p-value: 2.622e-05
Idealmente, quando tracci i residui, dovrebbero sembrare casuali. Altrimenti potrebbe significare che c'è un pattern nascosto che il modello lineare non sta considerando. Per tracciare i residui, usa il comando plot(lmTemp$residuals).
plot(lmTemp$residuals, pch = 16, col = "red")
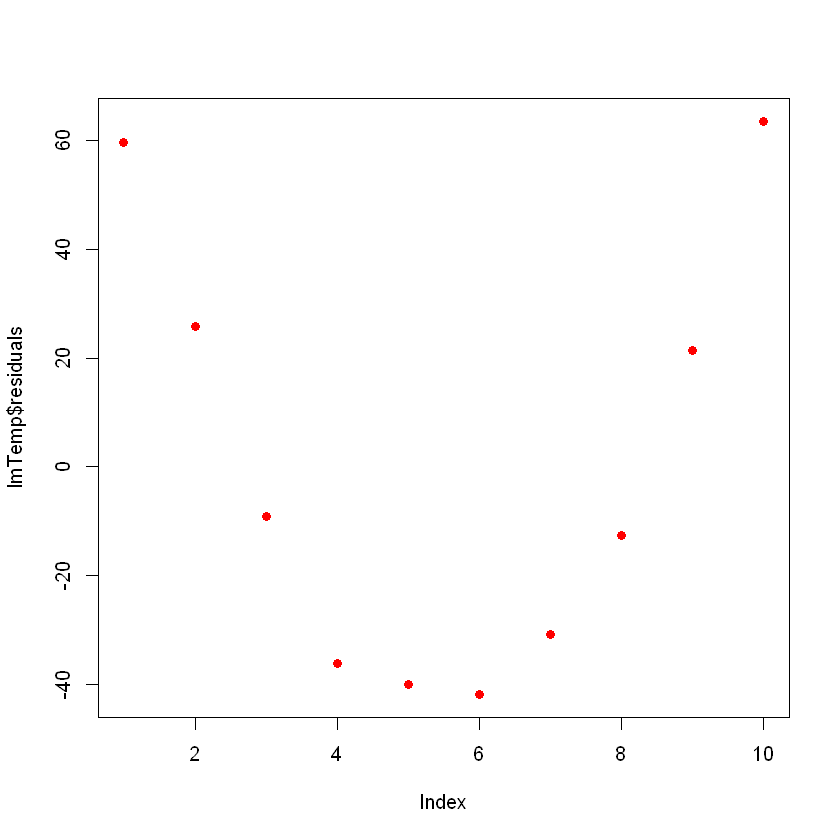
Questo può essere un problema. Se hai più dati, il tuo semplice modello lineare potrebbe non generalizzare bene. Nell'immagine precedente, nota che c'è un pattern (come una curva nei residui). Non è affatto casuale.
Quello che puoi fare è una trasformazione della variabile. Ci sono molte possibili trasformazioni da applicare ai tuoi dati, come aggiungere un termine quadratico (x2), un cubico (x3), o anche più complesse come ln(X), ln(X+1), sqrt(X), 1/x, Exp(X). La scelta della trasformazione corretta dipende dalla conoscenza delle funzioni algebriche, dall'esperienza e da tentativi.
Proviamo con un termine quadratico. Per questo, aggiungi il termine “I” ("I" maiuscola) prima della trasformazione; ad esempio, questa sarà la formula della normale regressione lineare:
lmTemp2 = lm(Pressure~Temperature + I(Temperature^2), data = pressure) #Create a linear regression with a quadratic coefficient
summary(lmTemp2) #Review the results
Call:
lm(formula = Pressure ~ Temperature + I(Temperature^2), data = pressure)

Residuals:
    Min      1Q  Median      3Q     Max
-4.6045 -1.6330  0.5545  1.1795  4.8273

Coefficients:
                  Estimate Std. Error t value Pr(>|t|)
(Intercept)      33.750000   3.615591   9.335 3.36e-05 ***
Temperature      -1.731591   0.151002 -11.467 8.62e-06 ***
I(Temperature^2)  0.052386   0.001338  39.158 1.84e-09 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 3.074 on 7 degrees of freedom
Multiple R-squared:  0.9996,    Adjusted R-squared:  0.9994
F-statistic:  7859 on 2 and 7 DF,  p-value: 1.861e-12
Nota che il modello è migliorato significativamente. Se tracci i residui del nuovo modello, appariranno così:
plot(lmTemp2$residuals, pch = 16, col = "red")
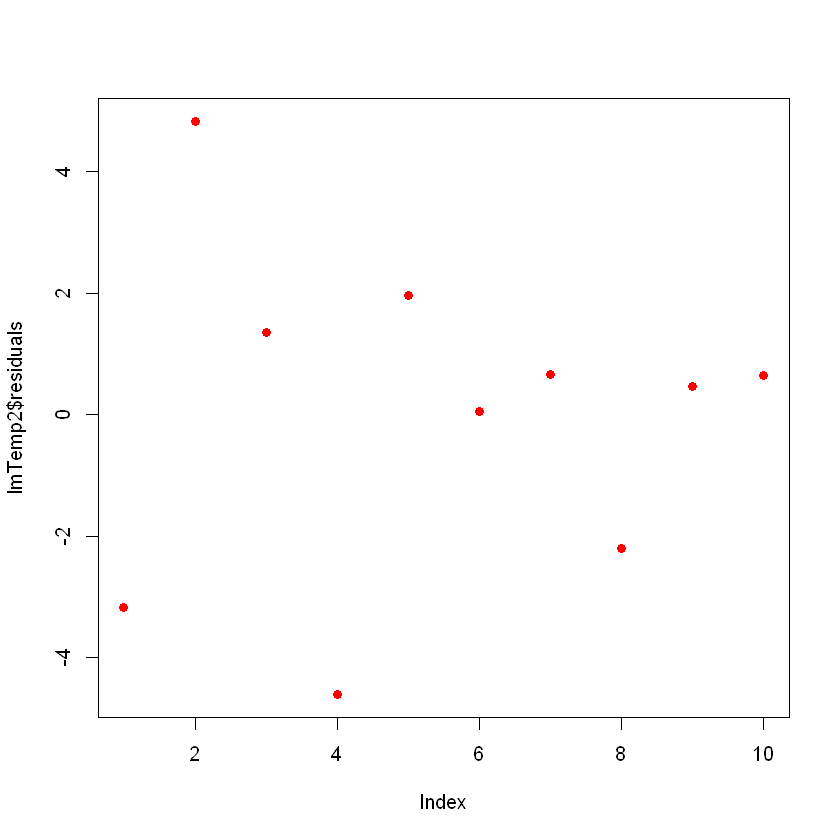
Ora non vedi più pattern evidenti nei residui, il che è un bene!
Nei tuoi dati potresti avere punti influenti che potrebbero distorcere il modello, a volte inutilmente. Pensa a un errore di inserimento: invece di scrivere “2.3” è stato inserito “23”. Il tipo più comune di punto influente sono gli outlier, ossia punti in cui la risposta osservata non sembra seguire il pattern stabilito dal resto dei dati.
Puoi individuare i punti influenti esaminando l'oggetto che contiene il modello lineare, usando la funzione cooks.distance() e poi tracciando queste distanze. Modifica intenzionalmente un valore per vedere come appare nel grafico di Cook's Distance. Per cambiare un valore specifico, puoi puntarlo direttamente con ageandheight[row number, column number] = [new value]. In questo caso, l'altezza del secondo esempio viene cambiata a 7,7:
ageandheight[2, 2] = 7.7
head(ageandheight)
| age | height | no_siblings |
|---|---|---|
| 18 | 76.1 | 0 |
| 19 | 7.7 | 2 |
| 20 | 78.1 | 0 |
| 21 | 78.2 | 3 |
| 22 | 78.8 | 4 |
| 23 | 79.7 | 1 |
Ricrea il modello e osserva come il riepilogo mostri un pessimo adattamento, quindi traccia le Cook's Distances. Per farlo, dopo aver creato la regressione lineare, usa il comando cooks.distance([linear model] e poi, se vuoi, puoi tracciare queste distanze con il comando plot().
lmHeight3 = lm(height~age, data = ageandheight)#Create the linear regression
summary(lmHeight3)#Review the results
plot(cooks.distance(lmHeight3), pch = 16, col = "blue") #Plot the Cooks Distances.
Call:
lm(formula = height ~ age, data = ageandheight)

Residuals:
    Min      1Q  Median      3Q     Max
-53.704  -2.584   3.609   9.503  17.512

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)    7.905     38.319   0.206    0.841
age            2.816      1.613   1.745    0.112

Residual standard error: 19.29 on 10 degrees of freedom
Multiple R-squared:  0.2335,    Adjusted R-squared:  0.1568
F-statistic: 3.046 on 1 and 10 DF,  p-value: 0.1115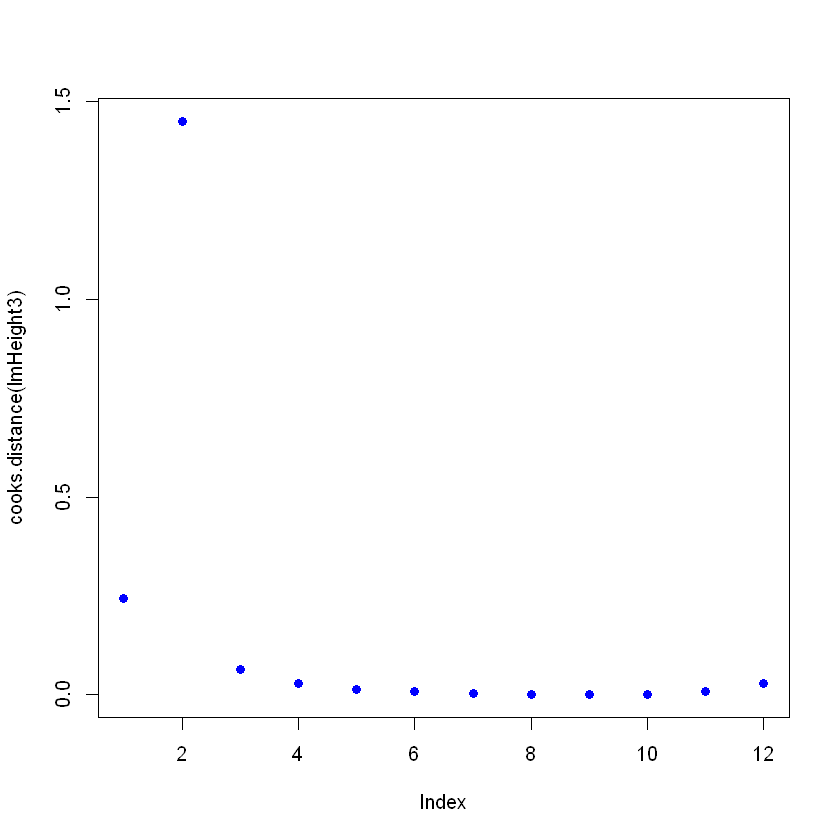
Nota che c'è un punto che non segue il pattern e potrebbe influenzare il modello. Qui puoi prendere decisioni su questo punto; in generale, ci sono tre motivi per cui un punto è così influente:
Se il caso è 1 o 2, allora puoi rimuovere il punto (o correggerlo). Se è il 3, non vale la pena eliminare un punto valido; magari puoi provare un modello non lineare invece di un modello lineare come la regressione lineare.
Attenzione: un punto influente può essere un dato valido; assicurati di verificare i dati e la loro origine prima di eliminarlo. Nei libri di statistica è comune trovare questa citazione: “A volte scartiamo dati perfettamente validi quando dovremmo scartare modelli discutibili”.
Sei arrivato alla fine! La regressione lineare è un argomento vasto ed è destinata a rimanere. Qui abbiamo presentato alcuni trucchi che possono aiutarti a mettere a punto e sfruttare al meglio un algoritmo tanto potente quanto semplice. Hai anche imparato a capire cosa c'è dietro questo semplice modello statistico e come puoi modificarlo in base alle tue esigenze. Puoi esplorare altre opzioni digitando ?lm nella console di R e guardando i diversi parametri non trattati qui. Dai un'occhiata al nostro Tutorial sulla regolarizzazione: Ridge, Lasso ed Elastic Net. Se ti interessa approfondire i modelli statistici, dai un'occhiata al corso su Statistical Modeling in R.
Dal momento che la regressione lineare è alla base di molte tecniche analitiche avanzate, garantire che il tuo team abbia una solida padronanza di questa e di altre competenze essenziali è cruciale per il successo a lungo termine.
DataCamp for Business offre una soluzione su misura per le organizzazioni che vogliono potenziare le competenze dei team in data science e analytics. Con percorsi di apprendimento personalizzati e corsi pratici e operativi che coprono un'ampia gamma di metodi statistici, inclusi regressione e predictive modeling, il tuo team potrà affrontare con sicurezza sfide dati complesse.
Richiedi una demo oggi stesso e investi nel futuro della tua organizzazione, consentendo al tuo team di restare al passo con gli strumenti e le tecniche più recenti per l'analisi dei dati.
Corsi R
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



