
Last chance! 50% off DataCamp Premium
Sale ends in
Hai mai sentito dire che, secondo dati raccolti negli Stati Uniti, il consumo di gelato è collegato agli attacchi di squali?
Per quanto possa sembrare assurdo, questo tipo di correlazione si verifica quando due variabili sembrano essere legate ma in realtà sono entrambe influenzate da una terza variabile. In questo caso, il fattore probabile è la temperatura. In estate, il consumo di gelato aumenta a causa del caldo. Allo stesso tempo, crescono anche gli attacchi di squali perché più persone fanno il bagno in mare.
Sebbene questo schema mostri una correlazione nei dati, non implica che uno causi l’altro. È qui che entra in gioco la Causal AI. Aiuta a identificare le vere relazioni di causa-effetto nei dati, evitandoci correlazioni spurie.
In questo articolo esploreremo il concetto di Causal AI, la sua importanza e come applicarla nella pratica.
La Causal AI è un ramo dell’Intelligenza Artificiale (AI) che si concentra sulla comprensione e la modellazione delle relazioni di causa ed effetto, invece di limitarsi a identificare pattern o correlazioni come fanno altri sistemi tradizionali di Machine Learning.
La Causal AI aiuta a migliorare l’affidabilità, la spiegabilità e la robustezza dei sistemi di AI, in particolare in scenari reali come sanità ed economia, che per natura sono più complessi.
A questo punto potresti chiederti:
Perché i metodi tradizionali di AI non tengono conto della causalità?
I sistemi di AI tradizionali si concentrano sull’identificazione di pattern, correlazioni e sulla realizzazione di previsioni basate sui dati. Per farlo si affidano a tecniche statistiche e di Machine Learning (ML) per trovare associazioni nei dati.
Infatti, durante l’addestramento, sono progettati per ottimizzare l’accuratezza della previsione usando grandi dataset. Questi dataset contengono correlazioni e gli algoritmi rileveranno tali correlazioni, ma le informazioni causali esplicite potrebbero non essere presenti.
Inoltre, ai sistemi di AI tradizionali viene spesso criticata la scarsa spiegabilità, motivo per cui vengono frequentemente definiti una “scatola nera”. In questo contesto, la Causal AI aiuta a costruire modelli più trasparenti e interpretabili ragionando esplicitamente su cause ed effetti.
Infine, pur avendo i metodi di AI tradizionali (non causali) numerose applicazioni, il punto chiave di questa sezione è: la correlazione non implica causalità.
Tornando all’esempio introduttivo sul gelato e gli attacchi di squali, vediamo che le vendite di gelato e gli incidenti con squali sono correlati (entrambi aumentano in estate), ma il gelato non causa gli attacchi di squali.
Come abbiamo visto, al cuore della Causal AI c’è l’obiettivo di stabilire relazioni di causa ed effetto tra variabili. Tuttavia, ci sono anche due concetti fondamentali essenziali per comprendere e manipolare queste relazioni all’interno di un sistema:
Il ragionamento controfattuale consiste nel considerare scenari ipotetici per capire come i cambiamenti di alcune variabili possano modificare gli esiti.
Mi piace vedere il Ragionamento Controfattuale come il porsi domande del tipo: “Cosa sarebbe successo se la variabile X avesse avuto un valore diverso?” È una domanda “What If”.
Nel nostro esempio gelato vs attacchi di squali potremmo chiederci: “E se le vendite di gelato fossero state più basse? Ci sarebbero stati meno attacchi di squali?”
In questo scenario controfattuale immaginiamo una versione alternativa della realtà in cui le vendite di gelato diminuiscono mentre tutto il resto resta uguale. Poiché sia le vendite di gelato sia gli attacchi di squali aumentano in estate a causa del clima più caldo (una causa comune), ridurre le vendite di gelato non influirebbe sugli attacchi di squali. Questo dimostra la correlazione, non la causalità.
Gli interventi si riferiscono alla manipolazione deliberata di variabili all’interno di un sistema per osservare i cambiamenti in altre variabili. In questo caso, gli interventi prevedono di modificare attivamente una variabile a un valore specifico, permettendoci di studiarne gli effetti diretti sul sistema.
Nel nostro esempio, un intervento potrebbe essere:
“Vietiamo la vendita di gelato nei giorni caldi (impostando le vendite di gelato a 0). Questo ridurrà gli attacchi di squali?”
Qui stiamo deliberatamente alterando il sistema eliminando le vendite di gelato. L’esito più probabile è nessun cambiamento negli attacchi di squali, dato che vietare il gelato non impedisce alle persone di nuotare. Questo semplice esempio illustra che intervenire sulle vendite di gelato non ha alcun effetto causale sugli attacchi di squali.
Prima di proseguire, se ti interessano altri aspetti fondamentali dell’AI, il percorso di competenze AI Fundamentals fa per te!
In questa sezione esploreremo tre modelli di Causal AI che ci aiuteranno a capire come lavorare con la causalità.
Partiamo dal modello più semplice per arrivare gradualmente a quelli più complessi.
I Grafi Aciclici Diretti (DAG) codificano le relazioni direzionali tra variabili senza cicli, cioè non ci sono loop in cui una variabile possa causare indirettamente sé stessa. Vengono usati per rappresentare relazioni causali in modo binario: o c’è una relazione causa-effetto tra due variabili, nel qual caso nel grafo esiste un arco diretto dalla causa all’effetto, oppure non c’è, e quindi non esiste alcun arco.
Per esempio, il DAG del nostro esempio originario su consumo di gelato e attacchi di squali mostra i seguenti percorsi causali:
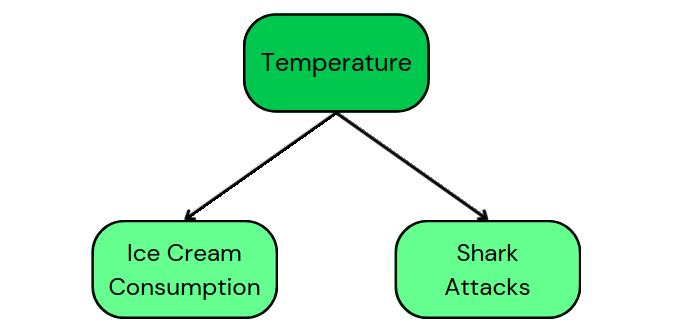
Questo DAG ci dice che la temperatura è una causa comune sia per il consumo di gelato sia per gli attacchi di squali. Inoltre mostra che non c’è causalità tra consumo di gelato e attacchi di squali.
I DAG sono rappresentazioni semplici, ma possono diventare più complessi aggiungendo più informazioni ai percorsi, come vedremo nelle sezioni seguenti.
I Modelli Causali Strutturali (SCM) includono equazioni che modellano come le variabili sono influenzate dalle altre. Per passare da un DAG a un SCM, dobbiamo specificare un sistema di equazioni strutturali che descriva quantitativamente come viene generata ciascuna variabile.
Concretamente, un’equazione strutturale in questo contesto è un’equazione matematica che esprime una variabile (esito) come funzione di una o più altre variabili (cause) più un termine di disturbo che rappresenta tutte le altre influenze su quell’esito. Nel nostro esempio:
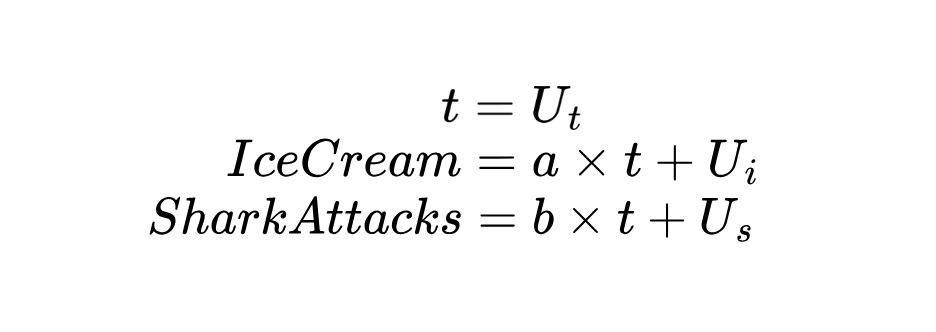
Poiché la temperatura (t) è una variabile esogena, cioè non è causata dalle altre due, assumiamo che sia determinata da fattori esterni.
Nelle equazioni sopra, sia il consumo di gelato sia gli attacchi di squali seguono un modello lineare sulla temperatura, mostrando come un cambiamento di temperatura si propaghi a entrambi gli esiti.
Possiamo fare un ulteriore passo avanti e aggiungere le probabilità al gioco!
Le Reti Bayesiane (BN) possono essere viste come una particolare istanziazione degli SCM in cui le equazioni strutturali sono espresse in modo probabilistico.
Una BN usa la stessa struttura causa-effetto, ma invece di scrivere formule esatte (come un modello lineare), descrive le probabilità o le chance dei diversi esiti. In altre parole, invece di avere un’equazione, esprimiamo la probabilità che Y si verifichi dato che X ha un certo valore: P(Y | X). Questa probabilità condizionata sostituisce un’equazione fissa in uno SCM con una descrizione dell’incertezza.
Nel contesto della Causal AI, l’Inferenza Causale si riferisce alle tecniche per individuare le relazioni di causa-effetto a partire dai dati. In questo caso, invece di concentrarci sui modelli per comprendere le relazioni, partiamo già da un insieme di dati e applichiamo diversi metodi per discernere tali relazioni. Li rivedremo applicando ciascun metodo al nostro esempio originario:
I Randomized Controlled Trials (RCT) aiutano a determinare le relazioni causali assegnando casualmente i partecipanti a gruppi diversi e confrontando i risultati.
Per esempio, per rispondere alla domanda “Mangiare gelato provoca più attacchi di squali?” assegneremmo casualmente le persone in due gruppi:
Poi confronteremmo i tassi di attacchi di squali tra i gruppi. Idealmente, non dovremmo trovare alcuna differenza significativa nei tassi di attacchi di squali, perché il consumo di gelato non causa gli attacchi. La vera causa in questo caso è probabilmente la temperatura, che non è stata manipolata nell’esperimento.
Più formalmente, diremmo che la randomizzazione isola l’effetto del consumo di gelato e, poiché non si trova alcun legame causale, ciò suggerisce che mangiare gelato non causa direttamente gli attacchi di squali.
Negli scenari in cui la randomizzazione non è possibile, possiamo affidarci a dati osservazionali e applicare il Propensity Score Matching (PSM).
Infatti, nelle situazioni reali, non possiamo applicare RCT e randomizzare il consumo di gelato perché le persone decidono se mangiarlo o meno. Tuttavia, possiamo usare dati osservazionali per inferire relazioni causali seguendo i passaggi del PSM:
Idealmente, i tassi di attacchi di squali dovrebbero essere simili per entrambi i gruppi, il che suggerirebbe che il consumo di gelato non è la causa degli attacchi di squali. Qualsiasi differenza osservata sarebbe probabilmente dovuta ad altri fattori, come la temperatura.
Supponiamo di sospettare che la temperatura sia una variabile nascosta (un confondente) che influenza sia il consumo di gelato sia gli attacchi di squali. La tecnica delle Variabili Strumentali (IV) aiuta a risolvere questo problema usando una variabile aggiuntiva (uno strumento) — come l’orario del furgone dei gelati — che influenza il consumo di gelato ma non è correlato agli attacchi di squali.
Se l’orario del furgone incide solo sulle vendite di gelato e non sul comportamento di chi nuota, allora possiamo usarlo come strumento per isolare l’effetto causale del consumo di gelato sugli attacchi di squali. Applicando IV, probabilmente scopriremmo che, una volta tenuto conto di questo strumento, il consumo di gelato non causa gli attacchi di squali e che la correlazione osservata era dovuta al confondente nascosto: la temperatura.
Se sei curioso di altri tipi di inferenze, dai un’occhiata all’articolo “What is Machine Learning Inference? An Introduction to Inference Approaches”.
In questa sezione esploreremo due diversi framework per lavorare con la Causal AI nella pratica usando Python.
DoWhy è uno strumento molto interessante perché fornisce un framework end-to-end per il ragionamento causale, con enfasi su trasparenza e interpretabilità.
È estremamente completo e offre un’ampia varietà di algoritmi per la stima degli effetti, l’analisi delle cause radice, gli interventi e i controfattuali. È particolarmente utile per workflow di inferenza causale basati su grafi. Non entrerò troppo nel dettaglio di questo strumento, perché su DataCamp è già disponibile un tutorial completo: Introduzione alla Causal AI con la libreria DoWhy.
Pyro è un framework di programmazione probabilistica il cui focus principale è sulla modellazione strutturale e bayesiana. Uno dei vantaggi chiave di Pyro è l’integrazione senza soluzione di continuità con PyTorch per l’accelerazione su GPU e le applicazioni di deep learning.
Se ti interessa, Pyro ha una documentazione ampia con molti esempi disponibili.
Se non vedi l’ora di iniziare a usare framework di AI come quelli discussi in questa sezione, ti consiglio il corso DataCamp su Developing AI Applications.
Finora abbiamo rivisto i fondamenti della Causal AI, i modelli alla base, diversi approcci di Inferenza Causale e due framework Python per lavorarci. Tuttavia, sappiamo tutti che immergersi in una nuova disciplina può essere impegnativo. Perciò, in questa sezione rivedremo i cinque passaggi chiave per implementare la Causal AI:
La qualità dei dati a disposizione è cruciale, poiché l’inferenza causale si basa fortemente su dati che rappresentano accuratamente il sistema studiato. È importante ricordare che qualsiasi tipo di errore, valore mancante o bias può distorcere le relazioni causali.
L’inferenza causale richiede anche dati ricchi, ad esempio assicurarsi che tutti i confondenti rilevanti siano osservati e inclusi nei dati, che gli interventi siano ben definiti e coerenti tra le osservazioni e che i gruppi siano comparabili quando si applicano tecniche che richiedono questa suddivisione.
Come ultimo consiglio, se puoi scegliere i tuoi dati, i dati temporali (serie storiche o longitudinali) sono spesso molto utili per stabilire la causalità, in quanto aiutano a determinare l’ordine degli eventi.
Questo passaggio prevede la creazione di un modello concettuale che rappresenti le relazioni tra variabili. Strumenti come DAG o SCM sono spesso utilizzati a questo punto per formalizzare le ipotesi sulla causalità.
Abbiamo visto che i confondenti sono possibili variabili nascoste che potrebbero influenzare le nostre variabili osservate. Ci sono anche altri due tipi di variabili:
È utile identificare questi tre tipi di variabili e le loro potenziali interazioni durante la modellazione e definire chiaramente la direzione della causalità.
L’obiettivo dell’identificazione è stabilire se l’effetto causale di interesse può essere stimato dai dati osservati, dato il modello. Pertanto, questo passaggio consiste nel verificare se l’effetto causale è identificabile usando metodi di Inferenza Causale come l’Identificazione delle Variabili.
Una volta identificato l’effetto causale, questo passaggio si concentra sul quantificarlo usando metodi statistici. Questo è un buon momento, per esempio, per applicare il Propensity Score Matching.
Questa fase verifica se le tue conclusioni causali reggono, mettendo in discussione le assunzioni ed esplorando spiegazioni alternative. I metodi in questo passaggio includono ragionamento controfattuale e interventi. Mentre i controfattuali esaminano se l’esito cambierebbe in condizioni diverse, gli interventi testano la robustezza delle relazioni causali modificando attivamente le variabili e osservandone gli effetti.
Ora che sappiamo come funziona la Causal AI, vediamo alcuni esempi di domini in cui possiamo applicarla.
Un buon esempio di sistema reale di Causal AI in azione è nel dominio sanitario, dove viene usata per determinare l’efficacia dei trattamenti stimando, per esempio, l’impatto causale delle interventi medici. Inoltre, le relazioni causali sono usate per adattare i trattamenti ai singoli pazienti in base alla loro situazione specifica.
Il marketing è un altro ambito che beneficia della Causal AI. Per esempio, la Causal AI aiuta a misurare il vero impatto delle campagne di marketing distinguendo tra correlazione e causalità. Fornisce insight più profondi su ciò che guida le decisioni dei clienti, consentendo strategie di marketing più mirate ed efficaci. Allo stesso modo, campi come l’economia, il business e la gestione della supply chain si basano anch’essi sulla comprensione della causalità.
In questo articolo abbiamo visto come la Causal AI ci aiuti ad andare oltre le semplici correlazioni nei dati per scoprire le vere relazioni di causa-effetto. Abbiamo esaminato come i Grafi Aciclici Diretti, i Modelli Causali Strutturali e le Reti Bayesiane fungano da strumenti di modellazione causale per rappresentare e ragionare su sistemi complessi.
Inoltre, abbiamo discusso come applicare la Causal AI ai dati, dove i Randomized Controlled Trials e il Propensity Score Matching aiutano nella stima degli effetti causali. Quando si sospetta confondimento non misurato, le Variabili Strumentali aiutano a identificare influenze nascoste.
Infine, abbiamo delineato i passaggi per implementare la Causal AI nella pratica, con particolare enfasi sul ragionamento controfattuale e sugli interventi come strumenti chiave nella fase di confutazione dell’analisi causale.
Man mano che la Causal AI evolve, avrà un ruolo sempre più vitale non solo nel distinguere tra semplice correlazione e causalità, ma anche nello sfruttare la causalità per prendere decisioni migliori.
Se vuoi saperne di più sulla Causal AI e su come aiuta le aziende a prendere decisioni migliori, ascolta il nostro episodio di DataFramed sulla Causal AI nel business. Puoi anche leggere la nostra guida pratica a Causal AI con la libreria DoWhy per un esempio pratico.
I migliori corsi DataCamp
Corso
Programma
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min




