
Cursus
Machine Learning voor Business
2 uur
47.7K
Heb je ooit gehoord dat, volgens gegevens uit de VS, het eten van ijs samenhangt met aanvallen door haaien?
Hoe absurd het ook klinkt, dit soort correlatie treedt op wanneer twee variabelen verwant lijken, maar in werkelijkheid allebei worden beïnvloed door een derde variabele. In dit geval is temperatuur de waarschijnlijke factor. In de zomer neemt de consumptie van ijs toe door de hitte. Tegelijkertijd stijgen ook haaienaanvallen, omdat er meer mensen in zee zwemmen.
Hoewel dit patroon een correlatie in de data laat zien, betekent dat niet dat het ene het andere veroorzaakt. Dit is waar Causal AI om de hoek komt kijken. Het helpt om echte oorzaak-gevolgrelaties in data te identificeren, zodat we schijncorrelaties vermijden.
In dit artikel verkennen we het concept van Causal AI, het belang ervan en hoe je het in de praktijk toepast.
Causal AI is een tak van Artificial Intelligence (AI) die zich richt op het begrijpen en modelleren van oorzaak-gevolgrelaties, in plaats van alleen patronen of correlaties te herkennen zoals traditionele Machine Learning-systemen doen.
Causal AI helpt de betrouwbaarheid, uitlegbaarheid en robuustheid van AI-systemen te verbeteren, vooral in realistische scenario’s zoals de gezondheidszorg en economie, die van nature complexer zijn.
Op dit punt vraag je je misschien af:
Waarom houden traditionele AI-methoden geen rekening met causaliteit?
Traditionele AI-systemen richten zich op het identificeren van patronen, correlaties en het doen van voorspellingen op basis van data. Daarbij vertrouwen ze op statistische en Machine Learning (ML)-technieken om verbanden in data te vinden.
Tijdens de training zijn ze inderdaad ontworpen om de nauwkeurigheid van de voorspelling te optimaliseren met grote datasets. Die datasets bevatten correlaties en de algoritmen zullen die correlaties opmerken, maar expliciete causale informatie is mogelijk niet aanwezig.
Daarnaast worden traditionele AI-systemen vaak bekritiseerd vanwege hun beperkte uitlegbaarheid en worden ze vaak aangeduid als een “black box”. In deze context helpt Causal AI om meer transparante en interpreteerbare modellen te bouwen door expliciet te redeneren over oorzaken en gevolgen.
Tot slot, hoewel traditionele (niet-causale) AI-methoden veel toepassingen hebben, is de belangrijkste les uit deze sectie: Correlatie impliceert geen causaliteit.
Terugkomend op het voorbeeld uit de inleiding van ijsconsumptie versus haaienaanvallen, zien we dat ijsverkoop en incidenten met haaienaanvallen correleren (beide nemen toe in de zomer), maar ijs veroorzaakt geen haaienaanvallen.
Zoals we hebben gezien, draait Causal AI in de kern om het vaststellen van oorzaak-gevolgrelaties tussen variabelen. Er zijn echter ook twee fundamentele concepten die essentieel zijn om deze relaties binnen een systeem te begrijpen en te manipuleren:
Contrafeitelijk redeneren houdt in dat je hypothetische scenario’s overweegt om te begrijpen hoe veranderingen in bepaalde variabelen uitkomsten kunnen beïnvloeden.
Ik zie Contrafeitelijk Redeneren graag als het stellen van vragen als: “Wat zou er zijn gebeurd als variabele X een andere waarde had aangenomen?” Dat is een “wat-als”-vraag.
In ons voorbeeld van ijsconsumptie versus haaienaanvallen kunnen we ons afvragen:“Wat als de ijsverkoop lager was geweest? Zouden er dan minder haaienaanvallen zijn geweest?”
In dit contrafeitelijke scenario stellen we ons een alternatieve versie van de realiteit voor waarin de ijsverkoop daalt terwijl al het andere hetzelfde blijft. Aangezien zowel ijsverkoop als haaienaanvallen in de zomer toenemen door warmer weer (een gemeenschappelijke oorzaak), zou een daling van de ijsverkoop geen invloed hebben op haaienaanvallen. Dit toont correlatie, geen causaliteit.
Interventies verwijzen naar het bewust manipuleren van variabelen binnen een systeem om veranderingen in andere variabelen te observeren. In dit geval houdt een interventie in dat we een variabele actief op een specifieke waarde zetten, zodat we het directe effect op het systeem kunnen bestuderen.
In ons voorbeeld zou een interventie kunnen zijn:
“Laten we op hete dagen de verkoop van ijs verbieden (we zetten de ijsverkoop op 0). Zal dit het aantal haaienaanvallen verminderen?”
Hier veranderen we het systeem bewust door de ijsverkoop weg te nemen. De meest waarschijnlijke uitkomst is geen verandering in haaienaanvallen, omdat het verbod op ijs mensen niet tegenhoudt om te gaan zwemmen. Dit eenvoudige voorbeeld laat zien dat ingrijpen in ijsverkoop geen causaal effect heeft op haaienaanvallen.
Voordat we verdergaan: als je geïnteresseerd bent in meer basisaspecten van AI, dan is de skill track AI Fundamentals iets voor jou!
In deze sectie verkennen we drie Causal AI-modellen die helpen begrijpen hoe je met causaliteit werkt.
We beginnen met het eenvoudigste model en gaan door naar complexere.
Directed Acyclic Graphs (DAG’s) coderen de directionele relaties tussen variabelen zonder cycli, wat betekent dat er geen lussen zijn waarbij een variabele indirect zichzelf kan veroorzaken. Ze worden gebruikt om causale relaties op een binaire manier weer te geven: Ofwel is er een oorzaak-gevolgrelatie tussen twee variabelen en is er in de graaf een gerichte rand van oorzaak naar gevolg, of er is geen relatie en dus ook geen rand.
Het DAG van ons oorspronkelijke voorbeeld van ijsconsumptie en haaienaanvallen toont bijvoorbeeld de volgende causale paden:
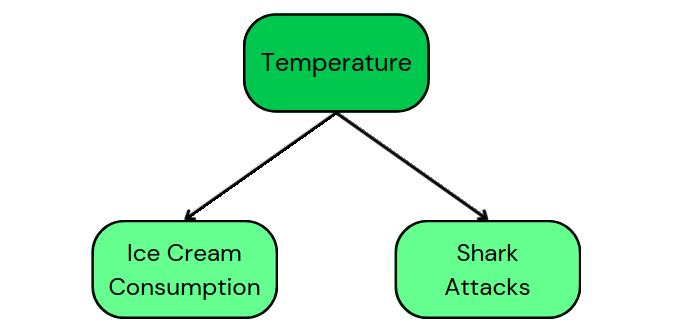
Dit DAG vertelt ons dat temperatuur een gemeenschappelijke oorzaak is van zowel ijsconsumptie als haaienaanvallen. Daarnaast laat het zien dat er geen causaliteit is tussen ijsconsumptie en haaienaanvallen.
DAG’s zijn eenvoudige representaties, maar ze kunnen complexer worden door meer informatie aan de paden toe te voegen, zoals we in de volgende secties zullen zien.
Structurele causale modellen (SCM’s) bevatten vergelijkingen die modelleren hoe variabelen door andere worden beïnvloed. Om van een DAG naar een SCM te gaan, moeten we een systeem van structurele vergelijkingen specificeren dat kwantitatief beschrijft hoe elke variabele wordt gegenereerd.
Concreet is een structurele vergelijking in deze context een wiskundige vergelijking die één variabele (uitkomst) uitdrukt als een functie van één of meer andere variabelen (oorzaken) plus een stoorterm die alle andere invloeden op die uitkomst vertegenwoordigt. In ons voorbeeld:
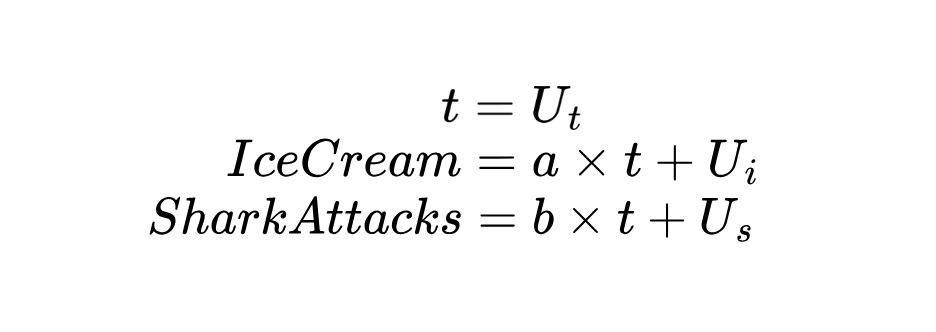
Omdat temperatuur (t) een exogene variabele is, wat betekent dat zij niet wordt veroorzaakt door de andere twee, nemen we aan dat zij wordt bepaald door externe factoren.
In de bovenstaande vergelijkingen volgen zowel ijsconsumptie als haaienaanvallen een lineair model op temperatuur, wat laat zien hoe een verandering in temperatuur doorwerkt naar beide uitkomsten.
We kunnen nog een stap verder gaan en waarschijnlijkheden toevoegen aan het spel!
Bayesiaanse netwerken (BN’s) kun je zien als een specifieke instantiatie van SCM’s waarin de structurele vergelijkingen probabilistisch worden uitgedrukt.
Een BN gebruikt dezelfde oorzaak-gevolgstructuur, maar in plaats van exacte formules uit te schrijven (zoals een lineair model), beschrijft het de kansen op verschillende uitkomsten. Met andere woorden, in plaats van een vergelijking te hebben, drukken we de kans uit dat Y gebeurt gegeven dat X een bepaalde waarde heeft: P(Y | X). Deze conditionele kans vervangt een vaste vergelijking in een SCM door een beschrijving van onzekerheid.
In de context van Causal AI verwijst Causale inferentie naar de technieken om oorzaak-gevolgrelaties uit data af te leiden. In dit geval richten we ons niet op de modellen om de relaties te begrijpen, maar beginnen we met een dataset en passen we verschillende methoden toe om die relaties te onderscheiden. We bekijken ze door elke methode toe te passen op ons oorspronkelijke voorbeeld:
Gerandomiseerde gecontroleerde proeven (RCT’s) helpen causale relaties vast te stellen door deelnemers willekeurig aan verschillende groepen toe te wijzen en de resultaten te vergelijken.
Bijvoorbeeld, om onze vraag te beantwoorden “Leidt het eten van ijs tot meer haaienaanvallen?” zouden we mensen willekeurig in twee groepen indelen:
Daarna zouden we de haaienaanvalpercentages tussen de groepen vergelijken. Idealiter vinden we geen significant verschil in het aantal haaienaanvallen, omdat ijsconsumptie geen haaienaanvallen veroorzaakt. De echte oorzaak is in dit geval waarschijnlijk de temperatuur, die in het experiment niet werd gemanipuleerd.
Formeler gezegd: randomisatie isoleert het effect van ijsconsumptie, en omdat er geen causale link wordt gevonden, suggereert dit dat het eten van ijs niet direct tot haaienaanvallen leidt.
In situaties waarin randomisatie niet mogelijk is, kunnen we vertrouwen op observationele data en Propensity Score Matching (PSM) toepassen.
In de echte wereld kunnen we namelijk geen RCT’s toepassen en ijsconsumptie randomiseren, omdat mensen zelf beslissen of ze het eten of niet. Toch kunnen we met observationele data causale relaties afleiden door de PSM-stappen te volgen:
Idealiter zouden de haaienaanvalpercentages vergelijkbaar moeten zijn voor beide groepen, wat zou suggereren dat ijsconsumptie niet de oorzaak is van haaienaanvallen. Elk waargenomen verschil is waarschijnlijk te wijten aan andere factoren, zoals temperatuur.
Stel dat we vermoeden dat temperatuur een verborgen variabele (een confounder) is die zowel ijsconsumptie als haaienaanvallen beïnvloedt. De techniek van instrumentele variabelen (IV) helpt dit op te lossen door een extra variabele (een instrument) te gebruiken — zoals het schema van de ijscoman — dat de ijsconsumptie beïnvloedt maar geen verband houdt met haaienaanvallen.
Als het schema van de ijscoman alleen de ijsverkoop beïnvloedt en niet het zwemgedrag van mensen, dan kunnen we het gebruiken als instrument om het causale effect van ijsconsumptie op haaienaanvallen te isoleren. Bij toepassing van IV zullen we waarschijnlijk merken dat, na rekening te hebben gehouden met dit instrument, ijsconsumptie geen haaienaanvallen veroorzaakt, en dat de waargenomen correlatie te wijten was aan de verborgen confounder: de temperatuur.
Ben je benieuwd naar andere soorten inferenties? Bekijk dan het artikel “What is Machine Learning Inference? An Introduction to Inference Approaches”.
In deze sectie bekijken we twee verschillende frameworks om in de praktijk met Causal AI te werken met Python.
DoWhy is een zeer interessante tool omdat het een end-to-end framework biedt voor causaal redeneren, met nadruk op transparantie en uitlegbaarheid.
Het is zeer compleet en biedt een breed scala aan algoritmen voor effectschatting, root cause-analyse, interventies en contrafeitelijkheden. Het is vooral nuttig voor grafiekgebaseerde workflows voor causale inferentie. Ik ga niet te diep in op deze tool, want er is al een complete tutorial beschikbaar op DataCamp: Introduction to Causal AI using the DoWhy Library.
Pyro is een probabilistisch programmeerframework met als kernfocus structurele en Bayesiaanse modellering. Een van de belangrijkste voordelen van Pyro is de naadloze integratie met PyTorch voor GPU-versnelling en deep learning-toepassingen.
Als je geïnteresseerd bent: Pyro heeft uitgebreide documentatie met veel voorbeelden.
Als je graag aan de slag wilt met AI-frameworks zoals die in deze sectie zijn besproken, raad ik de DataCamp-cursus Developing AI Applications aan.
Tot nu toe hebben we de fundamenten van Causal AI, de achterliggende modellen, verschillende benaderingen voor causale inferentie en twee Python-frameworks om ermee te werken doorgenomen. Toch weten we allemaal dat je verdiepen in een nieuwe discipline lastig kan zijn. Daarom bespreken we in deze sectie de vijf belangrijkste stappen voor het implementeren van Causal AI:
De kwaliteit van de data die we hebben is cruciaal, want causale inferentie leunt sterk op data die het bestudeerde systeem accuraat weergeven. Het is belangrijk te onthouden dat elk type fout, ontbrekende waarde of bias causale relaties kan vertekenen.
Causale inferentie vereist ook rijke data, zoals ervoor zorgen dat alle relevante confounders geobserveerd en opgenomen zijn in de data, dat interventies goed gedefinieerd en consistent zijn over observaties, en dat groepen vergelijkbaar zijn wanneer je technieken toepast die deze indeling vereisen.
Als laatste advies: als je je data kunt kiezen, zijn temporele data (tijdreeksen of longitudinale data) vaak erg nuttig om causaliteit vast te stellen, omdat ze helpen de volgorde van gebeurtenissen te bepalen.
Deze stap houdt in dat je een conceptueel model maakt dat de relaties tussen variabelen weergeeft. Tools zoals DAG’s of SCM’s worden vaak op dit punt gebruikt om aannames over causaliteit te formaliseren.
We hebben gezien dat confounders mogelijke verborgen variabelen zijn die onze geobserveerde variabelen kunnen beïnvloeden. Er zijn ook nog twee andere typen variabelen:
Het is zinvol om tijdens het modelleren deze drie typen variabelen en hun mogelijke interacties te identificeren en de richting van causaliteit duidelijk te definiëren.
Het doel van identificatie is bepalen of het causale effect van interesse kan worden geschat uit de geobserveerde data, gegeven het model. Deze stap houdt dus in dat je controleert of het causale effect identificeerbaar is met methoden voor causale inferentie, zoals variabele-identificatie.
Zodra het causale effect is geïdentificeerd, richt deze stap zich op het kwantificeren van het causale effect met statistische methoden. Dit is een goed moment om bijvoorbeeld Propensity Score Matching toe te passen.
Deze fase test of je causale conclusies standhouden door aannames ter discussie te stellen en alternatieve verklaringen te verkennen. Methoden in deze stap omvatten contrafeitelijk redeneren en interventies. Terwijl contrafeitelijkheden onderzoeken of de uitkomst zou veranderen onder andere omstandigheden, testen interventies de robuustheid van causale relaties door variabelen actief te veranderen en de effecten te observeren.
Nu we weten hoe Causal AI werkt, bekijken we enkele voorbeeldgebieden waarin we het kunnen toepassen.
Een goed voorbeeld van een causale AI-toepassing in de echte wereld is in de zorg, waar het wordt gebruikt om de effectiviteit van behandelingen te bepalen door bijvoorbeeld de causale impact van medische interventies te schatten. Daarnaast worden causale relaties gebruikt om behandelingen af te stemmen op individuele patiënten op basis van hun specifieke situatie.
Marketing is een ander gebied dat profiteert van Causal AI. Zo helpt Causal AI de echte impact van marketingcampagnes te meten door onderscheid te maken tussen correlatie en causaliteit. Het biedt diepere inzichten in wat klantbeslissingen drijft, waardoor gerichtere en effectievere marketingstrategieën mogelijk worden. Op vergelijkbare wijze vertrouwen ook domeinen zoals economie, business en supply chain management op het begrijpen van causaliteit.
In dit artikel hebben we onderzocht hoe Causal AI ons helpt verder te gaan dan eenvoudige correlaties in data om echte oorzaak-gevolgrelaties te ontdekken. We hebben bekeken hoe Directed Acyclic Graphs, Structurele Causale Modellen en Bayesiaanse Netwerken dienen als causale modelleringshulpmiddelen om complexe systemen te representeren en erover te redeneren.
Daarnaast hebben we besproken hoe je Causal AI op data toepast, waarbij gerandomiseerde gecontroleerde proeven en Propensity Score Matching helpen bij het schatten van causale effecten. Wanneer ongemeten confounding wordt vermoed, helpen instrumentele variabelen verborgen invloeden te identificeren.
Tot slot hebben we de stappen voor de praktische implementatie van Causal AI uiteengezet, met speciale nadruk op contrafeitelijk redeneren en interventies als sleutelinstrumenten in de weerlegfase van causale analyse.
Naarmate Causal AI zich blijft ontwikkelen, zal het een steeds belangrijkere rol spelen niet alleen bij het onderscheiden van eenvoudige correlatie en causaliteit, maar ook bij het benutten van causaliteit voor betere besluitvorming.
Wil je meer weten over Causal AI en hoe het bedrijven helpt betere beslissingen te nemen? Beluister dan onze DataFramed-aflevering over Causal AI in business. Je kunt ook onze praktische gids over Causal AI met de DoWhy-bibliotheek lezen voor een hands-on voorbeeld.
Topcursussen op DataCamp
Cursus
Leerpad
Cursus
blog
Adel Nehme
15 min

