
{count, plural, one {कोर्स} other {कोर्स}}
बिज़नेस के लिए मशीन लर्निंग
{hours} घंटा
47.8K
क्या आपने कभी सुना है कि U.S. में एकत्रित किए गए डेटा के अनुसार, आइसक्रीम खाने और शार्क हमलों के बीच संबंध पाया गया है?
यह जितना भी अजीब लगे, इस तरह का सह-संबंध तब दिखता है जब दो चर आपस में जुड़े हुए प्रतीत होते हैं, लेकिन वास्तव में दोनों पर किसी तीसरे चर का प्रभाव होता है। इस मामले में तापमान संभावित कारक है। गर्मियों में, गर्मी के कारण आइसक्रीम की खपत बढ़ जाती है। उसी समय, समुद्र में तैरने वाले लोगों की संख्या बढ़ने से शार्क हमले भी बढ़ जाते हैं।
हालाँकि यह पैटर्न डेटा में सह-संबंध दिखाता है, यह यह नहीं बताता कि एक दूसरे का कारण है। यही वह जगह है जहाँ Causal AI काम आती है। यह डेटा में वास्तविक कारण-और-प्रभाव संबंधों की पहचान करने में मदद करती है, जिससे हम भ्रामक सह-संबंधों से बच सकते हैं।
इस लेख में, हम Causal AI की अवधारणा, उसके महत्व, और उसे व्यवहार में कैसे लागू किया जाए, इन सबकी पड़ताल करेंगे।
Causal AI, Artificial Intelligence (AI) की वह शाखा है जो कारण-और-प्रभाव संबंधों को समझने और मॉडल करने पर केंद्रित होती है, न कि केवल पैटर्न या सह-संबंधों की पहचान पर, जैसा कि अन्य पारंपरिक मशीन लर्निंग सिस्टम करते हैं।
Causal AI वास्तविक दुनिया के जटिल परिदृश्यों—जैसे स्वास्थ्य सेवा और अर्थशास्त्र—में AI सिस्टम की विश्वसनीयता, व्याख्येयता और मजबूती में सुधार करने में मदद करती है।
इस बिंदु पर, आप शायद सोच रहे होंगे:
पारंपरिक AI तरीकों में कारणता को क्यों नहीं शामिल किया जाता?
पारंपरिक AI सिस्टम डेटा के आधार पर पैटर्न, सह-संबंधों की पहचान करने और पूर्वानुमान लगाने पर ध्यान केंद्रित करते हैं। ऐसा करने के लिए वे डेटा में सहसंबंध ढूँढ़ने हेतु सांख्यिकीय और मशीन लर्निंग (ML) तकनीकों पर निर्भर रहते हैं।
दरअसल, प्रशिक्षण के दौरान, उन्हें बड़े डेटासेट का उपयोग कर पूर्वानुमान की शुद्धता को अनुकूलित करने के लिए डिज़ाइन किया जाता है। ये डेटासेट सह-संबंध समेटे होते हैं और एल्गोरिदम उन सह-संबंधों को नोटिस कर लेते हैं, पर स्पष्ट कारणात्मक जानकारी मौजूद न भी हो सकती है।
इसके अलावा, पारंपरिक AI सिस्टमों की सीमित व्याख्येयता के लिए अक्सर आलोचना होती है और उन्हें अक्सर "ब्लैक बॉक्स" कहा जाता है। इस संदर्भ में, Causal AI कारणों और प्रभावों पर स्पष्ट रूप से तर्क करके अधिक पारदर्शी और व्याख्यायोग्य मॉडल बनाने में मदद करती है।
अंततः, जबकि पारंपरिक (गैर-कारणात्मक) AI तरीकों के कई उपयोग हैं, इस खंड से मुख्य सीख यह है: सह-संबंध का यह मतलब नहीं कि कारणता भी हो।
परिचय वाले आइसक्रीम बनाम शार्क हमलों के उदाहरण पर लौटते हुए, हम देखते हैं कि आइसक्रीम बिक्री और शार्क हमलों की घटनाएँ सह-संबद्ध हैं (दोनों गर्मियों में बढ़ते हैं), लेकिन आइसक्रीम शार्क हमलों का कारण नहीं है।
जैसा कि हमने देखा, Causal AI का मूल उद्देश्य चरों के बीच कारण-और-प्रभाव संबंध स्थापित करना है। हालाँकि, किसी सिस्टम के भीतर इन संबंधों को समझने और नियंत्रित करने के लिए दो बुनियादी अवधारणाएँ और भी आवश्यक हैं:
Counterfactual reasoning में काल्पनिक परिदृश्यों पर विचार करना शामिल है ताकि समझा जा सके कि कुछ चरों में बदलाव से परिणाम कैसे बदल सकते हैं।
मैं Counterfactual Reasoning को ऐसे प्रश्न पूछने के रूप में देखना पसंद करता/करती हूँ: "क्या होता अगर चर X ने कोई अलग मान लिया होता?" यह एक "What If" वाला प्रश्न है।
अपने आइसक्रीम बनाम शार्क हमलों के उदाहरण में, हम खुद से पूछ सकते हैं:"क्या होगा अगर आइसक्रीम की बिक्री कम होती? क्या शार्क हमले कम हो जाते?"
इस counterfactual परिदृश्य में, हम एक वैकल्पिक वास्तविकता की कल्पना करते हैं जहाँ आइसक्रीम बिक्री घटती है जबकि बाकी सब वही रहता है। चूँकि गर्म मौसम (एक सामान्य कारण) के कारण गर्मियों में आइसक्रीम बिक्री और शार्क हमले दोनों बढ़ते हैं, इसलिए आइसक्रीम बिक्री घटाने से शार्क हमलों पर असर नहीं पड़ेगा। यह सह-संबंध, न कि कारणता, को दर्शाता है।
Interventions का आशय सिस्टम के भीतर चरों का जानबूझकर हेरफेर करना ताकि अन्य चरों में होने वाले बदलाव देखे जा सकें। इस मामले में, हस्तक्षेप का अर्थ है किसी चर को किसी विशिष्ट मान पर सेट करके सक्रिय रूप से बदलना, जिससे उसके प्रत्यक्ष प्रभावों का अध्ययन हो सके।
हमारे उदाहरण में, एक हस्तक्षेप यह हो सकता है:
"आइए गर्म दिनों में आइसक्रीम बिक्री पर प्रतिबंध लगा दें (आइसक्रीम बिक्री को 0 पर सेट करना)। क्या इससे शार्क हमलों में कमी आएगी?"
यहाँ, हम आइसक्रीम बिक्री हटाकर सिस्टम को जानबूझकर बदल रहे हैं। सबसे संभावित परिणाम यह है कि शार्क हमलों में कोई बदलाव नहीं होगा क्योंकि आइसक्रीम पर प्रतिबंध लगाने से लोग तैरना बंद नहीं करेंगे। यह सरल उदाहरण दर्शाता है कि आइसक्रीम बिक्री में हस्तक्षेप का शार्क हमलों पर कोई कारणात्मक प्रभाव नहीं है।
आगे बढ़ने से पहले, यदि आप AI के और बुनियादी पहलुओं में रुचि रखते हैं, तो यह स्किल ट्रैक AI Fundamentals आपके लिए है!
इस खंड में, हम तीन कारणात्मक AI मॉडल देखेंगे जो हमें कारणता के साथ काम करना समझने में मदद करेंगे।
चलिए सबसे सरल मॉडल से शुरू करते हैं और धीरे-धीरे जटिल मॉडलों की ओर बढ़ते हैं।
Directed Acyclic Graphs (DAGs) चरों के बीच दिशात्मक संबंधों को चक्रीयता के बिना एन्कोड करते हैं, यानी इसमें ऐसे लूप नहीं होते जहाँ कोई चर अप्रत्यक्ष रूप से स्वयं का कारण बने। ये कारणात्मक संबंधों को द्विआधारी रूप में दर्शाने के लिए उपयोग होते हैं: या तो दो चरों के बीच कारण-प्रभाव संबंध है—तो ग्राफ में कारण से प्रभाव तक एक निर्देशित किनारा होगा—या नहीं है, तो कोई किनारा नहीं होगा।
उदाहरण के लिए, हमारे मूल आइसक्रीम खपत और शार्क हमलों के उदाहरण का DAG निम्नलिखित कारणात्मक मार्ग दिखाता है:
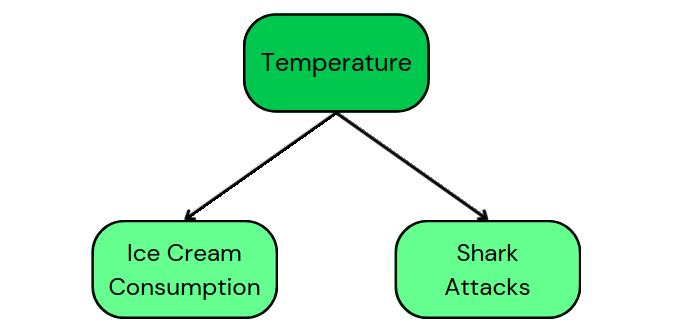
यह DAG हमें बताता है कि तापमान आइसक्रीम खपत और शार्क हमलों—दोनों का सामान्य कारण है। साथ ही, यह दर्शाता है कि आइसक्रीम खपत और शार्क हमलों के बीच कोई कारणता नहीं है।
DAGs सरल अभ्यावेदन हैं, पर मार्गों में अधिक जानकारी जोड़कर ये अधिक जटिल भी बन सकते हैं, जैसा कि हम आगे के खंडों में देखेंगे।
Structural Causal Models (SCMs) में वे समीकरण शामिल होते हैं जो दर्शाते हैं कि चरों पर अन्य चरों का कैसे प्रभाव पड़ता है। एक DAG से SCM तक जाने के लिए, हमें संरचनात्मक समीकरणों की ऐसी प्रणाली निर्दिष्ट करनी होती है जो परिमाणात्मक रूप से बताए कि प्रत्येक चर कैसे उत्पन्न होता है।
ठोस रूप से, इस संदर्भ में एक संरचनात्मक समीकरण वह गणितीय समीकरण है जो एक चर (परिणाम) को एक या अधिक अन्य चरों (कारणों) के फलन के रूप में व्यक्त करता है, साथ ही एक व्यवधान पद जो उस परिणाम पर अन्य सभी प्रभावों का प्रतिनिधित्व करता है। हमारे उदाहरण में:
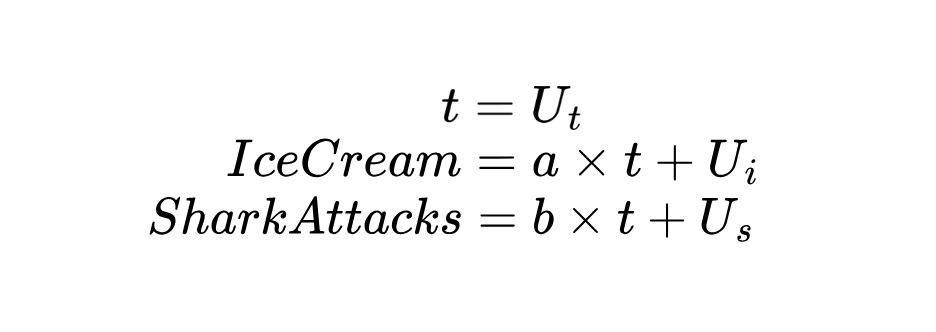
चूँकि तापमान (t) एक बाह्यजन्य चर है, यानी उस पर अन्य दो चरों का कारणात्मक प्रभाव नहीं है, हम मानते हैं कि यह बाहरी कारकों से निर्धारित होता है।
ऊपर की समीकरणों में, आइसक्रीम खपत और शार्क हमले—दोनों तापमान पर रैखिक मॉडल का अनुसरण करते हैं, जो दर्शाता है कि तापमान में बदलाव दोनों परिणामों तक कैसे प्रसारित होता है।
हम एक कदम और आगे जा सकते हैं और खेल में प्रायिकताएँ भी जोड़ सकते हैं!
Bayesian Networks (BNs) को SCMs के एक विशेष रूप के रूप में देखा जा सकता है जिसमें संरचनात्मक समीकरणों को प्रायिकतामूलक रूप में व्यक्त किया जाता है।
एक BN में वही कारण-और-प्रभाव संरचना होती है, लेकिन सटीक सूत्र (जैसे रैखिक मॉडल) लिखने के बजाय यह अलग-अलग परिणामों की प्रायिकता या संभावना का वर्णन करता है। दूसरे शब्दों में, किसी समीकरण के बजाय हम यह व्यक्त करते हैं कि Y के होने की प्रायिकता क्या है जब X का कोई निश्चित मान हो: P(Y | X)। यह सशर्त प्रायिकता एक SCM में निश्चित समीकरण की जगह अनिश्चितता का विवरण देती है।
Causal AI के संदर्भ में, Causal Inference का मतलब डेटा से कारण-और-प्रभाव संबंधों का पता लगाने की तकनीकें है। इस मामले में, संबंधों को समझने के लिए मॉडलों पर ध्यान देने के बजाय, हम डेटा के एक सेट से शुरू करके अलग-अलग तरीकों को लागू करते हैं ताकि उन संबंधों की पहचान की जा सके। हम प्रत्येक विधि को अपने मूल उदाहरण पर लागू करके उनकी समीक्षा करेंगे:
Randomized Controlled Trials (RCTs) प्रतिभागियों को यादृच्छिक रूप से अलग-अलग समूहों में बाँटकर और परिणामों की तुलना करके कारणात्मक संबंध निर्धारित करने में मदद करते हैं।
उदाहरण के लिए, हमारे प्रश्न का उत्तर देने में, "क्या आइसक्रीम खाने से शार्क हमले बढ़ते हैं?" हम लोगों को यादृच्छिक रूप से दो समूहों में बाँटेंगे:
फिर हम दोनों समूहों के बीच शार्क हमलों की दरों की तुलना करेंगे। आदर्श रूप से, हमें शार्क हमलों की दरों में कोई महत्वपूर्ण अंतर नहीं मिलना चाहिए क्योंकि आइसक्रीम का सेवन शार्क हमलों का कारण नहीं है। इस मामले में वास्तविक कारण संभवतः तापमान है, जिसे प्रयोग में बदला नहीं गया।
अधिक औपचारिक रूप से, हम कहेंगे कि यादृच्छिकीकरण आइसक्रीम सेवन के प्रभाव को अलग-थलग कर देता है, और चूँकि कोई कारणात्मक कड़ी नहीं मिलती, यह संकेत देता है कि आइसक्रीम खाना सीधे शार्क हमलों का कारण नहीं है।
जहाँ यादृच्छिकीकरण संभव नहीं होता, वहाँ हम प्रेक्षणात्मक डेटा पर निर्भर कर सकते हैं और Propensity Score Matching (PSM) लागू कर सकते हैं।
वास्तविक दुनिया में, हम RCT लागू नहीं कर सकते और आइसक्रीम सेवन को यादृच्छिक नहीं बना सकते क्योंकि लोग स्वयं तय करते हैं कि उसे खाना है या नहीं। फिर भी, हम प्रेक्षणात्मक डेटा का उपयोग करके कारणात्मक संबंधों का अनुमान लगा सकते हैं, PSM के चरणों का पालन करते हुए:
आदर्श रूप से, शार्क हमलों की दरें दोनों समूहों के लिए समान होनी चाहिए, जो यह सुझाव देगी कि आइसक्रीम सेवन शार्क हमलों का कारण नहीं है। कोई भी दिखाई देने वाला अंतर संभवतः अन्य कारकों, जैसे तापमान, के कारण होगा।
मान लीजिए हमें संदेह है कि तापमान एक छिपा हुआ चर (confounder) है जो आइसक्रीम खपत और शार्क हमलों—दोनों को प्रभावित कर रहा है। Instrumental Variables (IV) तकनीक इस समस्या को एक अतिरिक्त चर (एक instrument) — जैसे आइसक्रीम ट्रक का शेड्यूल — का उपयोग करके हल करती है, जो आइसक्रीम खपत को प्रभावित करता है लेकिन शार्क हमलों से असंबद्ध है।
यदि ट्रक का शेड्यूल केवल आइसक्रीम बिक्री को प्रभावित करता है और लोगों के तैरने के व्यवहार को नहीं, तो हम इसे एक instrument के रूप में उपयोग करके आइसक्रीम खपत का शार्क हमलों पर कारणात्मक प्रभाव अलग-थलग कर सकते हैं। IV लागू करने पर, संभावना है कि इस instrument का हिसाब लेने के बाद हमें पता चलेगा कि आइसक्रीम खपत शार्क हमलों का कारण नहीं है, और दिखाई देने वाला सह-संबंध छिपे हुए confounder—तापमान—के कारण था।
यदि आप अन्य प्रकार की inferencing के बारे में उत्सुक हैं, तो यह लेख देखें "What is Machine Learning Inference? An Introduction to Inference Approaches"।
इस खंड में, हम Python का उपयोग करके व्यवहार में Causal AI के साथ काम करने के लिए दो अलग-अलग फ्रेमवर्क देखेंगे।
DoWhy एक बहुत ही दिलचस्प टूल है क्योंकि यह कारणात्मक तर्क के लिए एंड-टू-एंड फ्रेमवर्क प्रदान करता है, जिसमें पारदर्शिता और व्याख्येयता पर जोर दिया गया है।
यह अत्यंत व्यापक है और प्रभाव अनुमान, मूल कारण विश्लेषण, हस्तक्षेप, और counterfactuals के लिए एल्गोरिदम की एक विस्तृत शृंखला प्रदान करता है। यह विशेष रूप से ग्राफ-आधारित कारणात्मक inference वर्कफ़्लो के लिए उपयोगी है। मैं इस टूल पर बहुत विस्तार में नहीं जाऊँगा/जाऊँगी, क्योंकि DataCamp पर पहले से ही एक संपूर्ण ट्यूटोरियल उपलब्ध है: Introduction to Causal AI using the DoWhy Library.
Pyro एक प्रायिकतात्मक प्रोग्रामिंग फ्रेमवर्क है जिसका मुख्य फोकस संरचनात्मक और Bayesian मॉडलिंग पर है। Pyro का एक प्रमुख लाभ यह है कि यह GPU त्वरण और डीप लर्निंग एप्लिकेशन के लिए PyTorch के साथ निर्बाध रूप से एकीकृत होता है।
यदि आप रुचि रखते हैं, तो Pyro के पास कई उदाहरणों के साथ विस्तृत प्रलेखन उपलब्ध है।
यदि आप इस खंड में चर्चा किए गए AI फ्रेमवर्क्स का उपयोग शुरू करने के लिए उत्सुक हैं, तो मैं DataCamp के इस कोर्स की सिफारिश करूँगा/करूँगी: Developing AI Applications.
अभी तक, हमने Causal AI की मूल बातें, उसके पीछे के मॉडल, Causal Inference के अलग-अलग दृष्टिकोण, और उसके साथ काम करने के लिए दो Python फ्रेमवर्क देखे हैं। फिर भी, हम सभी जानते हैं कि किसी नए अनुशासन में उतरना कठिन हो सकता है। इसलिए, इस खंड में हम Causal AI को लागू करने के पाँच प्रमुख चरणों की समीक्षा करेंगे:
हमारे पास मौजूद डेटा की गुणवत्ता अत्यंत महत्वपूर्ण है क्योंकि कारणात्मक अनुमान काफी हद तक उसी डेटा पर निर्भर करता है जो अध्ययन किए जा रहे सिस्टम का सटीक प्रतिनिधित्व करता हो। यह ध्यान रखना ज़रूरी है कि किसी भी प्रकार की त्रुटि, मिसिंग वैल्यू या पक्षपात कारणात्मक संबंधों को विकृत कर सकता है।
कारणात्मक अनुमान के लिए समृद्ध डेटा भी चाहिए—जैसे यह सुनिश्चित करना कि सभी प्रासंगिक confounders देखे गए और डेटा में शामिल हों, हस्तक्षेप स्पष्ट रूप से परिभाषित हों और प्रेक्षणों में सुसंगत हों, और जब तकनीकों के लिए समूह-विभाजन आवश्यक हो तो समूह तुलनीय हों।
अंतिम सलाह के रूप में, यदि आपको अपना डेटा चुनने का अवसर मिले, तो कालक्रमिक डेटा (टाइम-सीरीज़ या अनुदैर्ध्य डेटा) अक्सर कारणता स्थापित करने में बहुत उपयोगी होता है, क्योंकि यह घटनाओं के क्रम का निर्धारण करने में मदद करता है।
यह चरण चरों के बीच संबंधों का प्रतिनिधित्व करने वाला वैचारिक मॉडल बनाने से जुड़ा है। इस बिंदु पर कारणता के बारे में मान्यताओं को औपचारिक रूप देने के लिए DAGs या SCMs जैसे टूल्स का अक्सर उपयोग किया जाता है।
हमने देखा कि confounders संभावित छिपे हुए चर होते हैं जो हमारे देखे गए चरों को प्रभावित कर सकते हैं। दो अन्य प्रकार के चर भी होते हैं:
मॉडलिंग के दौरान इन तीन प्रकार के चरों और उनकी संभावित अंतःक्रियाओं की पहचान करना और कारणता की दिशा को स्पष्ट रूप से परिभाषित करना उपयोगी होता है।
पहचान का उद्देश्य यह निर्धारित करना है कि दिए गए मॉडल के अनुसार इच्छित कारणात्मक प्रभाव को देखे गए डेटा से अनुमानित किया जा सकता है या नहीं। इसलिए, यह चरण Variable Identification जैसी Causal Inference विधियों का उपयोग करके यह जाँचना शामिल करता है कि क्या कारणात्मक प्रभाव पहचानने योग्य है।
एक बार कारणात्मक प्रभाव की पहचान हो जाने पर, यह चरण सांख्यिकीय तरीकों का उपयोग करके कारणात्मक प्रभाव को परिमाणित करने पर केंद्रित होता है। उदाहरण के लिए, यह Propensity Score Matching लागू करने का अच्छा समय है।
यह चरण यह जाँचता है कि आपकी कारणात्मक निष्कर्ष धारणाओं को चुनौती देने और वैकल्पिक व्याख्याएँ तलाशने पर भी टिकते हैं या नहीं। इस चरण में counterfactual reasoning और interventions जैसी विधियाँ शामिल होती हैं। जहाँ counterfactuals यह जाँचते हैं कि अलग परिस्थितियों में परिणाम बदलता या नहीं, वहीं interventions चर को सक्रिय रूप से बदलकर और प्रभावों का अवलोकन करके कारणात्मक संबंधों की मजबूती परखते हैं।
अब जब हमें पता है कि Causal AI कैसे काम करती है, तो आइए कुछ ऐसे क्षेत्रों के उदाहरण देखें जहाँ इसे लागू किया जा सकता है।
वास्तविक दुनिया में Causal AI के काम करने का एक अच्छा उदाहरण स्वास्थ्य सेवा का क्षेत्र है, जहाँ उपचार की प्रभावशीलता निर्धारित करने के लिए—उदाहरण के लिए—चिकित्सीय हस्तक्षेपों के कारणात्मक प्रभाव का अनुमान लगाया जाता है। इसके अलावा, कारणात्मक संबंधों का उपयोग मरीजों की विशिष्ट स्थिति के आधार पर उपचारों को व्यक्तिगत करने के लिए किया जाता है।
मार्केटिंग एक और क्षेत्र है जो Causal AI से लाभान्वित होता है। उदाहरण के लिए, Causal AI, सह-संबंध और कारणता के बीच अंतर करके मार्केटिंग अभियानों के वास्तविक प्रभाव को मापने में मदद करती है। यह ग्राहकों के निर्णयों को प्रभावित करने वाले कारकों पर गहन अंतर्दृष्टि देती है, जिससे अधिक लक्षित और प्रभावी मार्केटिंग रणनीतियाँ संभव होती हैं। इसी तरह, अर्थशास्त्र, व्यवसाय और आपूर्ति शृंखला प्रबंधन जैसे क्षेत्रों में भी कारणता को समझना केंद्रीय है।
इस लेख में, हमने देखा कि Causal AI कैसे हमें डेटा में साधारण सह-संबंधों से आगे बढ़कर वास्तविक कारण-और-प्रभाव संबंधों का पता लगाने में मदद करती है। हमने यह भी परखा कि Directed Acyclic Graphs, Structural Causal Models और Bayesian Networks—जटिल प्रणालियों को दर्शाने और उन पर तर्क करने के लिए—कारणात्मक मॉडलिंग टूल के रूप में कैसे काम करते हैं।
साथ ही, हमने यह भी चर्चा की कि डेटा पर Causal AI कैसे लागू करें, जहाँ Randomized Controlled Trials और Propensity Score Matching कारणात्मक प्रभाव के अनुमान में मदद करते हैं। जब अप्रमेय confounding का संदेह हो, तो Instrumental Variables छिपे प्रभावों की पहचान करने में मदद करते हैं।
अंत में, हमने व्यवहार में Causal AI लागू करने के चरणों की रूपरेखा प्रस्तुत की, विशेष रूप से खंडन चरण में प्रमुख उपकरणों के रूप में counterfactual reasoning और हस्तक्षेपों पर जोर दिया।
जैसे-जैसे Causal AI विकसित होती जाएगी, यह भूमिका और भी महत्वपूर्ण होती जाएगी—न केवल साधारण सह-संबंध और कारणता में भेद करने के लिए, बल्कि बेहतर निर्णय-निर्माण के लिए कारणता का लाभ उठाने में भी।
यदि आप Causal AI और यह कैसे व्यवसायों को बेहतर निर्णय लेने में मदद करती है के बारे में और जानना चाहते हैं, तो हमारा DataFramed एपिसोड: व्यवसाय में Causal AI देखें। आप हमारा व्यावहारिक मार्गदर्शक भी पढ़ सकते हैं: Causal AI using the DoWhy Library—जिससे आपको हाथ-कलम का उदाहरण मिलेगा।
शीर्ष DataCamp कोर्स
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
{count, plural, one {कोर्स} other {कोर्स}}