Bạn đã từng nghe rằng, theo dữ liệu thu thập tại Hoa Kỳ, việc tiêu thụ kem có liên quan đến các vụ cá mập tấn công chưa?
Nghe có vẻ kỳ quặc, nhưng kiểu tương quan này xảy ra khi hai biến có vẻ liên quan với nhau nhưng thực ra đều bị chi phối bởi một biến thứ ba. Trong trường hợp này, nhiệt độ là yếu tố có khả năng nhất. Vào mùa hè, việc tiêu thụ kem tăng do trời nóng. Đồng thời, các vụ cá mập tấn công cũng tăng vì có nhiều người bơi ở biển hơn.
Mặc dù mô hình này cho thấy tương quan trong dữ liệu, nhưng không có nghĩa là cái này gây ra cái kia. Đây là lúc Causal AI xuất hiện. Nó giúp xác định các mối quan hệ nhân - quả thực sự trong dữ liệu, cho phép chúng ta tránh các tương quan giả.
Trong bài viết này, chúng ta sẽ khám phá khái niệm Causal AI, tầm quan trọng của nó và cách áp dụng trong thực tế.
Causal AI là gì?
Causal AI là một nhánh của Trí tuệ nhân tạo (AI) tập trung vào việc hiểu và mô hình hóa các mối quan hệ nhân - quả, thay vì chỉ nhận diện các mẫu hay tương quan như các hệ thống Machine Learning truyền thống khác.
Causal AI giúp cải thiện độ tin cậy, khả năng giải thích và độ vững của các hệ thống AI, đặc biệt trong các kịch bản thực tế như y tế và kinh tế, vốn phức tạp hơn theo bản chất.
Tại thời điểm này, bạn có thể tự hỏi:
Tại sao các phương pháp AI truyền thống không tính đến tính nhân quả?
Causal AI so với AI truyền thống: Khác biệt chính
Các hệ thống AI truyền thống tập trung vào việc nhận diện các mẫu, các tương quan và đưa ra dự đoán dựa trên dữ liệu. Để làm được điều đó, chúng dựa vào các kỹ thuật thống kê và Machine Learning (ML) để tìm các mối liên hệ trong dữ liệu.
Thật vậy, trong quá trình huấn luyện, chúng được thiết kế để tối ưu hóa độ chính xác của dự đoán bằng cách sử dụng các tập dữ liệu lớn. Những tập dữ liệu này chứa các tương quan và các thuật toán sẽ nhận thấy những tương quan đó, nhưng thông tin nhân quả tường minh có thể không hiện diện.
Ngoài ra, các hệ thống AI truyền thống thường bị chỉ trích vì khả năng giải thích hạn chế và thường được gọi là “hộp đen”. Trong bối cảnh này, Causal AI giúp xây dựng các mô hình minh bạch và có thể diễn giải hơn bằng cách suy luận tường minh về nguyên nhân và kết quả.
Cuối cùng, dù các phương pháp AI truyền thống (phi nhân quả) có rất nhiều ứng dụng, điểm mấu chốt của phần này là: Tương quan không hàm ý quan hệ nhân quả.
- Tương quan xảy ra khi hai biến cùng biến động, nhưng điều này không chứng minh rằng biến này gây ra biến kia.
- Nhân quả nghĩa là một biến tác động trực tiếp đến biến còn lại.
Quay lại ví dụ về kem và các vụ cá mập tấn công ở phần mở đầu, ta thấy doanh số bán kem và số vụ cá mập tấn công có tương quan (đều tăng vào mùa hè), nhưng kem không gây ra cá mập tấn công.
Các nguyên lý cơ bản của Causal AI
Như đã thấy, cốt lõi của Causal AI là mục tiêu xác lập các mối quan hệ nhân - quả giữa các biến. Tuy nhiên, cũng có hai khái niệm nền tảng thiết yếu để hiểu và thao tác các mối quan hệ này trong một hệ thống:
Suy luận phản sự kiện (Counterfactual)
Suy luận phản sự kiện liên quan đến việc xem xét các kịch bản giả định để hiểu cách các thay đổi ở một số biến có thể làm thay đổi kết quả.
Tôi thích xem Suy luận phản sự kiện như việc đặt các câu hỏi kiểu: “Điều gì sẽ xảy ra nếu biến X nhận một giá trị khác?” Đó là một câu hỏi kiểu “Nếu như”.
Trong ví dụ kem và cá mập tấn công, ta có thể tự hỏi:“Điều gì xảy ra nếu doanh số bán kem thấp hơn? Liệu sẽ có ít vụ cá mập tấn công hơn không?”
Trong kịch bản phản sự kiện này, ta tưởng tượng một phiên bản thay thế của thực tế nơi doanh số bán kem giảm trong khi mọi thứ khác giữ nguyên. Vì cả doanh số bán kem và các vụ cá mập tấn công đều tăng vào mùa hè do thời tiết ấm hơn (cùng một nguyên nhân), việc giảm doanh số bán kem sẽ không ảnh hưởng đến các vụ cá mập tấn công. Điều này cho thấy tương quan, không phải nhân quả.
Can thiệp (Interventions)
Can thiệp đề cập đến việc cố ý thao tác các biến trong một hệ thống để quan sát sự thay đổi ở các biến khác. Trong trường hợp này, can thiệp liên quan đến việc chủ động đặt một biến về một giá trị cụ thể, cho phép chúng ta nghiên cứu các tác động trực tiếp của nó lên hệ thống.
Trong ví dụ của chúng ta, một can thiệp có thể là:
“Hãy cấm bán kem vào những ngày nóng (đặt doanh số bán kem về 0). Liệu điều này có giảm các vụ cá mập tấn công không?”
Ở đây, chúng ta cố ý thay đổi hệ thống bằng cách loại bỏ việc bán kem. Kết quả có khả năng nhất là không có thay đổi đối với các vụ cá mập tấn công vì cấm bán kem không ngăn mọi người đi bơi. Ví dụ đơn giản này minh họa rằng can thiệp vào doanh số bán kem không có tác động nhân quả lên các vụ cá mập tấn công.
Trước khi tiếp tục, nếu bạn quan tâm đến các khía cạnh nền tảng hơn của AI, lộ trình kỹ năng AI Fundamentals là dành cho bạn!
Các mô hình Causal AI
Trong phần này, chúng ta sẽ khám phá ba mô hình Causal AI giúp hiểu cách làm việc với tính nhân quả.
Hãy bắt đầu với mô hình đơn giản nhất và tiến dần đến các mô hình phức tạp hơn.
Đồ thị có hướng không chu trình (DAG)
Đồ thị có hướng không chu trình (DAG) mã hóa các mối quan hệ có hướng giữa các biến mà không có chu trình, tức là không có vòng lặp nơi một biến có thể gián tiếp gây ra chính nó. Chúng được dùng để mô tả quan hệ nhân quả theo cách nhị phân: Hoặc có quan hệ nhân - quả giữa hai biến, khi đó có một cạnh có hướng từ nguyên nhân đến kết quả trong đồ thị, hoặc không có, và do đó cũng không có cạnh.
Ví dụ, DAG của ví dụ gốc về tiêu thụ kem và cá mập tấn công cho thấy các con đường nhân quả sau:
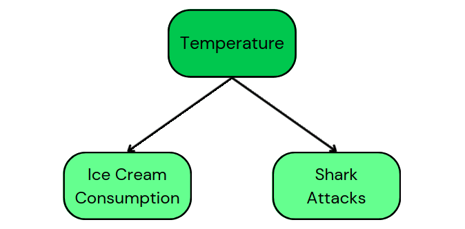
DAG này cho chúng ta biết rằng nhiệt độ là nguyên nhân chung của cả tiêu thụ kem và cá mập tấn công. Ngoài ra, nó cho thấy không có tính nhân quả giữa tiêu thụ kem và cá mập tấn công.
DAG là các biểu diễn đơn giản, nhưng có thể trở nên phức tạp hơn bằng cách thêm nhiều thông tin vào các con đường, như ta sẽ thấy ở các phần sau.
Mô hình nhân quả cấu trúc (SCM)
Mô hình nhân quả cấu trúc (SCM) bao gồm các phương trình mô tả cách các biến bị ảnh hưởng bởi các biến khác. Để chuyển từ DAG sang SCM, chúng ta cần xác định một hệ phương trình cấu trúc định lượng cách mỗi biến được sinh ra.
Cụ thể, một phương trình cấu trúc trong ngữ cảnh này là một phương trình toán học biểu diễn một biến (kết quả) như một hàm của một hoặc nhiều biến khác (nguyên nhân) cộng với một hạng nhiễu thể hiện mọi ảnh hưởng khác lên kết quả đó. Trong ví dụ của chúng ta:
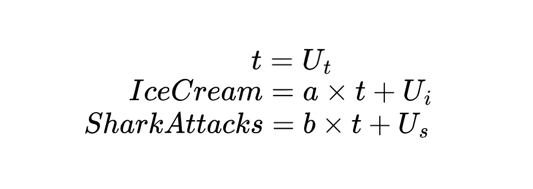
Vì nhiệt độ (t) là một biến ngoại sinh, nghĩa là không bị gây ra bởi hai biến còn lại, chúng ta giả định nó được quyết định bởi các yếu tố bên ngoài.
Trong các phương trình trên, cả tiêu thụ kem và cá mập tấn công đều tuân theo mô hình tuyến tính theo nhiệt độ, cho thấy cách một thay đổi về nhiệt độ lan truyền đến cả hai kết quả.
Chúng ta còn có thể tiến thêm một bước và đưa xác suất vào cuộc chơi!
Mạng Bayes (Bayesian Networks)
Mạng Bayes (BN) có thể được xem là một hiện thân cụ thể của SCM trong đó các phương trình cấu trúc được biểu diễn theo xác suất.
Một BN sử dụng cùng cấu trúc nhân - quả, nhưng thay vì viết ra các công thức chính xác (như mô hình tuyến tính), nó mô tả xác suất hay khả năng của các kết cục khác nhau. Nói cách khác, thay vì có một phương trình, ta biểu diễn xác suất Y xảy ra khi X có một giá trị nhất định: P(Y | X). Xác suất có điều kiện này thay thế một phương trình cố định trong SCM bằng mô tả về sự bất định.
Suy luận nhân quả (Causal Inference)
Trong bối cảnh Causal AI, Suy luận nhân quả đề cập đến các kỹ thuật để xác định các mối quan hệ nhân - quả từ dữ liệu. Ở đây, thay vì tập trung vào các mô hình để hiểu mối quan hệ, chúng ta bắt đầu với một tập dữ liệu và áp dụng các phương pháp khác nhau để phân định các quan hệ đó. Chúng ta sẽ xem xét chúng bằng cách áp dụng từng phương pháp vào ví dụ gốc:
Thử nghiệm ngẫu nhiên có đối chứng (RCT)
Thử nghiệm ngẫu nhiên có đối chứng (RCT) giúp xác định mối quan hệ nhân quả bằng cách phân ngẫu nhiên người tham gia vào các nhóm khác nhau và so sánh kết quả.
Ví dụ, để trả lời câu hỏi “Ăn kem có gây ra nhiều vụ cá mập tấn công hơn không?” chúng ta sẽ phân ngẫu nhiên mọi người vào hai nhóm:
- Nhóm A: Ăn kem.
- Nhóm B: Không ăn kem.
Sau đó, chúng ta so sánh tỷ lệ cá mập tấn công giữa các nhóm. Lý tưởng nhất là sẽ không thấy sự khác biệt đáng kể vì việc tiêu thụ kem không gây ra cá mập tấn công. Nguyên nhân thực sự trong trường hợp này có khả năng là nhiệt độ, yếu tố không bị thao tác trong thí nghiệm.
Nói một cách chính quy hơn, ta sẽ nói rằng ngẫu nhiên hóa cô lập tác động của việc tiêu thụ kem, và vì không tìm thấy mối liên hệ nhân quả nào, điều này gợi ý rằng ăn kem không trực tiếp gây ra cá mập tấn công.
Ghép điểm xu hướng (Propensity Score Matching)
Trong các tình huống không thể ngẫu nhiên hóa, chúng ta có thể dựa vào dữ liệu quan sát và áp dụng Ghép điểm xu hướng (PSM).
Thực tế, trong đời sống, chúng ta không thể áp dụng RCT và ngẫu nhiên hóa việc tiêu thụ kem vì mọi người tự quyết định có ăn hay không. Tuy nhiên, chúng ta có thể dùng dữ liệu quan sát để suy luận các mối quan hệ nhân quả theo các bước PSM:
- Tính điểm xu hướng (propensity score): Đây là xác suất một người ăn kem dựa trên các yếu tố như nhiệt độ, độ tuổi và các biến liên quan khác.
- Ghép người ăn kem với người không ăn có điểm xu hướng tương tự, nghĩa là có tính so sánh được.
- Đánh giá tỷ lệ cá mập tấn công cho cả hai nhóm (người ăn kem và không ăn).
Lý tưởng là tỷ lệ cá mập tấn công sẽ tương tự nhau ở cả hai nhóm, điều này gợi ý rằng việc tiêu thụ kem không phải là nguyên nhân của cá mập tấn công. Bất kỳ khác biệt quan sát được nào nhiều khả năng là do các yếu tố khác, như nhiệt độ.
Biến công cụ (Instrumental variables)
Giả sử chúng ta nghi ngờ nhiệt độ là một biến ẩn (biến gây nhiễu) ảnh hưởng đến cả tiêu thụ kem và cá mập tấn công. Kỹ thuật Biến công cụ (IV) giúp giải quyết vấn đề này bằng cách sử dụng thêm một biến (một công cụ) — chẳng hạn như lịch chạy của xe bán kem — tác động đến việc tiêu thụ kem nhưng không liên quan đến các vụ cá mập tấn công.
Nếu lịch trình của xe chỉ ảnh hưởng đến doanh số bán kem chứ không ảnh hưởng đến hành vi đi bơi, thì ta có thể dùng nó làm biến công cụ để cô lập tác động nhân quả của việc tiêu thụ kem lên các vụ cá mập tấn công. Khi áp dụng IV, nhiều khả năng ta sẽ thấy rằng sau khi tính đến biến công cụ này, tiêu thụ kem không gây ra cá mập tấn công, và tương quan quan sát được là do biến gây nhiễu ẩn: nhiệt độ.
Nếu bạn tò mò về các loại suy luận khác, hãy xem bài viết “Machine Learning Inference là gì? Giới thiệu các cách tiếp cận suy luận”.
Các khung công cụ triển khai Causal AI
Trong phần này, chúng ta sẽ khám phá hai khung làm việc khác nhau để áp dụng Causal AI trong thực tiễn bằng Python.
Thư viện DoWhy cho Python
DoWhy là một công cụ rất thú vị vì nó cung cấp một khung làm việc đầu-cuối cho suy luận nhân quả, nhấn mạnh tính minh bạch và khả năng diễn giải.
Nó rất toàn diện và cung cấp đa dạng thuật toán để ước lượng hiệu ứng, phân tích nguyên nhân gốc rễ, can thiệp và phản sự kiện. Công cụ này đặc biệt hữu ích cho các quy trình suy luận nhân quả dựa trên đồ thị. Tôi sẽ không đi sâu vào công cụ này vì đã có hướng dẫn đầy đủ trên DataCamp: Giới thiệu Causal AI với thư viện DoWhy.
Pyro trên nền tảng PyTorch
Pyro là một khung lập trình xác suất tập trung chủ đạo vào mô hình hóa cấu trúc và Bayes. Một lợi ích quan trọng của Pyro là tích hợp liền mạch với PyTorch để tăng tốc bằng GPU và các ứng dụng học sâu.
Nếu bạn quan tâm, Pyro có tài liệu rất phong phú với rất nhiều ví dụ sẵn có.
Nếu bạn nóng lòng muốn bắt đầu sử dụng các khung AI như đã nêu ở phần này, tôi khuyên bạn khóa học DataCamp về Phát triển Ứng dụng AI.
Triển khai kỹ thuật Causal AI
Đến đây, chúng ta đã điểm qua nền tảng của Causal AI, các mô hình phía sau nó, các cách tiếp cận cho Suy luận nhân quả và hai khung Python để làm việc với nó. Tuy nhiên, chúng ta đều biết việc dấn thân vào một lĩnh vực mới có thể khó khăn. Vì vậy, trong phần này, chúng ta sẽ xem xét năm bước then chốt để triển khai Causal AI:
1. Kiểm tra dữ liệu
Chất lượng dữ liệu là tối quan trọng vì suy luận nhân quả phụ thuộc rất nhiều vào dữ liệu phản ánh chính xác hệ thống được nghiên cứu. Cần ghi nhớ rằng mọi loại lỗi, giá trị thiếu hay sai lệch đều có thể làm méo mó các mối quan hệ nhân quả.
Suy luận nhân quả cũng đòi hỏi dữ liệu đủ phong phú, chẳng hạn đảm bảo mọi biến gây nhiễu liên quan đều được quan sát và đưa vào dữ liệu, các can thiệp được định nghĩa rõ và nhất quán giữa các quan sát, và các nhóm có thể so sánh được khi áp dụng các kỹ thuật yêu cầu phân nhóm.
Lời khuyên cuối cùng, nếu bạn có thể chọn dữ liệu, dữ liệu theo thời gian (chuỗi thời gian hoặc dọc) thường rất hữu ích để xác lập tính nhân quả, vì nó giúp xác định thứ tự sự kiện.
2. Lựa chọn mô hình
Bước này liên quan đến việc tạo một mô hình khái niệm đại diện cho các mối quan hệ giữa các biến. Các công cụ như DAG hoặc SCM thường được dùng ở giai đoạn này để chính thức hóa các giả định về tính nhân quả.
Chúng ta đã thấy biến gây nhiễu là các biến ẩn có thể ảnh hưởng đến các biến quan sát. Cũng có hai loại biến khác:
- Biến trung gian (Mediator): Các biến nằm trên con đường nhân quả.
- Biến va chạm (Collider): Các biến chịu ảnh hưởng từ hai biến khác.
Việc nhận diện ba loại biến này và các tương tác tiềm năng của chúng trong quá trình mô hình hóa, cũng như xác định rõ hướng nhân quả, là điều thú vị và quan trọng.
3. Nhận dạng (Identification)
Mục tiêu của nhận dạng là xác định liệu hiệu ứng nhân quả quan tâm có thể được ước lượng từ dữ liệu quan sát, với mô hình đã cho hay không. Do đó, bước này bao gồm việc kiểm tra xem hiệu ứng nhân quả có thể nhận dạng được bằng các phương pháp Suy luận nhân quả như Nhận dạng biến hay không.
4. Ước lượng
Khi hiệu ứng nhân quả đã được nhận dạng, bước này tập trung vào định lượng hiệu ứng nhân quả bằng các phương pháp thống kê. Đây là thời điểm tốt để áp dụng Ghép điểm xu hướng, chẳng hạn.
5. Bác bỏ (Refutation)
Giai đoạn này kiểm tra liệu các kết luận nhân quả của bạn có đứng vững không bằng cách thách thức các giả định và khám phá các diễn giải thay thế. Các phương pháp ở bước này gồm suy luận phản sự kiện và can thiệp. Trong khi phản sự kiện xem xét liệu kết quả có thay đổi dưới các điều kiện khác hay không, can thiệp kiểm tra độ vững của các mối quan hệ nhân quả bằng cách chủ động thay đổi các biến và quan sát tác động.
Ứng dụng của Causal AI
Giờ khi đã biết Causal AI vận hành như thế nào, hãy xem một số lĩnh vực có thể áp dụng nó.
Một ví dụ điển hình về hệ thống Causal AI trong thế giới thực là trong lĩnh vực y tế, nơi nó được dùng để xác định hiệu quả của các phương pháp điều trị bằng cách ước lượng, chẳng hạn, tác động nhân quả của các can thiệp y khoa. Ngoài ra, các mối quan hệ nhân quả được dùng để cá nhân hóa điều trị theo từng bệnh nhân dựa trên tình trạng cụ thể của họ.
Marketing là một lĩnh vực khác hưởng lợi từ Causal AI. Ví dụ, Causal AI giúp đo lường tác động thực sự của các chiến dịch marketing bằng cách phân biệt giữa tương quan và nhân quả. Nó mang lại hiểu biết sâu hơn về những gì thúc đẩy quyết định của khách hàng, cho phép xây dựng chiến lược marketing mục tiêu và hiệu quả hơn. Tương tự, các lĩnh vực như kinh tế, kinh doanh và quản trị chuỗi cung ứng cũng dựa vào việc hiểu tính nhân quả.
Lời kết
Trong bài viết này, chúng ta đã khám phá cách Causal AI giúp vượt lên trên các tương quan đơn thuần trong dữ liệu để khám phá các mối quan hệ nhân - quả thực sự. Chúng ta đã xem xét cách Đồ thị có hướng không chu trình, Mô hình nhân quả cấu trúc và Mạng Bayes đóng vai trò công cụ mô hình hóa nhân quả để biểu diễn và suy luận về các hệ thống phức tạp.
Bên cạnh đó, chúng ta đã thảo luận cách áp dụng Causal AI vào dữ liệu, nơi Thử nghiệm ngẫu nhiên có đối chứng và Ghép điểm xu hướng hỗ trợ ước lượng hiệu ứng nhân quả. Khi nghi ngờ có gây nhiễu không đo lường được, Biến công cụ giúp nhận diện các ảnh hưởng ẩn.
Cuối cùng, chúng ta đã phác thảo các bước triển khai Causal AI trong thực tế, với nhấn mạnh đặc biệt vào suy luận phản sự kiện và can thiệp như những công cụ then chốt trong giai đoạn bác bỏ của phân tích nhân quả.
Khi Causal AI tiếp tục phát triển, nó sẽ đóng vai trò ngày càng quan trọng không chỉ trong việc phân biệt giữa tương quan đơn thuần và nhân quả mà còn trong việc tận dụng tính nhân quả để ra quyết định tốt hơn.
Nếu bạn muốn tìm hiểu thêm về Causal AI và cách nó giúp doanh nghiệp ra quyết định tốt hơn, hãy xem tập DataFramed về Causal AI trong kinh doanh. Bạn cũng có thể đọc hướng dẫn thực hành về Causal AI sử dụng thư viện DoWhy để có ví dụ thực hành.


Bạn đã từng nghe rằng, theo dữ liệu thu thập tại Hoa Kỳ, việc tiêu thụ kem có liên quan đến các vụ cá mập tấn công chưa?
Nghe có vẻ kỳ quặc, nhưng kiểu tương quan này xảy ra khi hai biến có vẻ liên quan với nhau nhưng thực ra đều bị chi phối bởi một biến thứ ba. Trong trường hợp này, nhiệt độ là yếu tố có khả năng nhất. Vào mùa hè, việc tiêu thụ kem tăng do trời nóng. Đồng thời, các vụ cá mập tấn công cũng tăng vì có nhiều người bơi ở biển hơn.
Mặc dù mô hình này cho thấy tương quan trong dữ liệu, nhưng không có nghĩa là cái này gây ra cái kia. Đây là lúc Causal AI xuất hiện. Nó giúp xác định các mối quan hệ nhân - quả thực sự trong dữ liệu, cho phép chúng ta tránh các tương quan giả.
Trong bài viết này, chúng ta sẽ khám phá khái niệm Causal AI, tầm quan trọng của nó và cách áp dụng trong thực tế.
Causal AI là gì?
Causal AI là một nhánh của Trí tuệ nhân tạo (AI) tập trung vào việc hiểu và mô hình hóa các mối quan hệ nhân - quả, thay vì chỉ nhận diện các mẫu hay tương quan như các hệ thống Machine Learning truyền thống khác.
Causal AI giúp cải thiện độ tin cậy, khả năng giải thích và độ vững của các hệ thống AI, đặc biệt trong các kịch bản thực tế như y tế và kinh tế, vốn phức tạp hơn theo bản chất.
Tại thời điểm này, bạn có thể tự hỏi:
Tại sao các phương pháp AI truyền thống không tính đến tính nhân quả?
Causal AI so với AI truyền thống: Khác biệt chính
Các hệ thống AI truyền thống tập trung vào việc nhận diện các mẫu, các tương quan và đưa ra dự đoán dựa trên dữ liệu. Để làm được điều đó, chúng dựa vào các kỹ thuật thống kê và Machine Learning (ML) để tìm các mối liên hệ trong dữ liệu.
Thật vậy, trong quá trình huấn luyện, chúng được thiết kế để tối ưu hóa độ chính xác của dự đoán bằng cách sử dụng các tập dữ liệu lớn. Những tập dữ liệu này chứa các tương quan và các thuật toán sẽ nhận thấy những tương quan đó, nhưng thông tin nhân quả tường minh có thể không hiện diện.
Ngoài ra, các hệ thống AI truyền thống thường bị chỉ trích vì khả năng giải thích hạn chế và thường được gọi là “hộp đen”. Trong bối cảnh này, Causal AI giúp xây dựng các mô hình minh bạch và có thể diễn giải hơn bằng cách suy luận tường minh về nguyên nhân và kết quả.
Cuối cùng, dù các phương pháp AI truyền thống (phi nhân quả) có rất nhiều ứng dụng, điểm mấu chốt của phần này là: Tương quan không hàm ý quan hệ nhân quả.
Quay lại ví dụ về kem và các vụ cá mập tấn công ở phần mở đầu, ta thấy doanh số bán kem và số vụ cá mập tấn công có tương quan (đều tăng vào mùa hè), nhưng kem không gây ra cá mập tấn công.
Các nguyên lý cơ bản của Causal AI
Như đã thấy, cốt lõi của Causal AI là mục tiêu xác lập các mối quan hệ nhân - quả giữa các biến. Tuy nhiên, cũng có hai khái niệm nền tảng thiết yếu để hiểu và thao tác các mối quan hệ này trong một hệ thống:
Suy luận phản sự kiện (Counterfactual)
Suy luận phản sự kiện liên quan đến việc xem xét các kịch bản giả định để hiểu cách các thay đổi ở một số biến có thể làm thay đổi kết quả.
Tôi thích xem Suy luận phản sự kiện như việc đặt các câu hỏi kiểu: “Điều gì sẽ xảy ra nếu biến X nhận một giá trị khác?” Đó là một câu hỏi kiểu “Nếu như”.
Trong ví dụ kem và cá mập tấn công, ta có thể tự hỏi:“Điều gì xảy ra nếu doanh số bán kem thấp hơn? Liệu sẽ có ít vụ cá mập tấn công hơn không?”
Trong kịch bản phản sự kiện này, ta tưởng tượng một phiên bản thay thế của thực tế nơi doanh số bán kem giảm trong khi mọi thứ khác giữ nguyên. Vì cả doanh số bán kem và các vụ cá mập tấn công đều tăng vào mùa hè do thời tiết ấm hơn (cùng một nguyên nhân), việc giảm doanh số bán kem sẽ không ảnh hưởng đến các vụ cá mập tấn công. Điều này cho thấy tương quan, không phải nhân quả.
Can thiệp (Interventions)
Can thiệp đề cập đến việc cố ý thao tác các biến trong một hệ thống để quan sát sự thay đổi ở các biến khác. Trong trường hợp này, can thiệp liên quan đến việc chủ động đặt một biến về một giá trị cụ thể, cho phép chúng ta nghiên cứu các tác động trực tiếp của nó lên hệ thống.
Trong ví dụ của chúng ta, một can thiệp có thể là:
“Hãy cấm bán kem vào những ngày nóng (đặt doanh số bán kem về 0). Liệu điều này có giảm các vụ cá mập tấn công không?”
Ở đây, chúng ta cố ý thay đổi hệ thống bằng cách loại bỏ việc bán kem. Kết quả có khả năng nhất là không có thay đổi đối với các vụ cá mập tấn công vì cấm bán kem không ngăn mọi người đi bơi. Ví dụ đơn giản này minh họa rằng can thiệp vào doanh số bán kem không có tác động nhân quả lên các vụ cá mập tấn công.
Trước khi tiếp tục, nếu bạn quan tâm đến các khía cạnh nền tảng hơn của AI, lộ trình kỹ năng AI Fundamentals là dành cho bạn!
Các mô hình Causal AI
Trong phần này, chúng ta sẽ khám phá ba mô hình Causal AI giúp hiểu cách làm việc với tính nhân quả.
Hãy bắt đầu với mô hình đơn giản nhất và tiến dần đến các mô hình phức tạp hơn.
Đồ thị có hướng không chu trình (DAG)
Đồ thị có hướng không chu trình (DAG) mã hóa các mối quan hệ có hướng giữa các biến mà không có chu trình, tức là không có vòng lặp nơi một biến có thể gián tiếp gây ra chính nó. Chúng được dùng để mô tả quan hệ nhân quả theo cách nhị phân: Hoặc có quan hệ nhân - quả giữa hai biến, khi đó có một cạnh có hướng từ nguyên nhân đến kết quả trong đồ thị, hoặc không có, và do đó cũng không có cạnh.
Ví dụ, DAG của ví dụ gốc về tiêu thụ kem và cá mập tấn công cho thấy các con đường nhân quả sau:
DAG này cho chúng ta biết rằng nhiệt độ là nguyên nhân chung của cả tiêu thụ kem và cá mập tấn công. Ngoài ra, nó cho thấy không có tính nhân quả giữa tiêu thụ kem và cá mập tấn công.
DAG là các biểu diễn đơn giản, nhưng có thể trở nên phức tạp hơn bằng cách thêm nhiều thông tin vào các con đường, như ta sẽ thấy ở các phần sau.
Mô hình nhân quả cấu trúc (SCM)
Mô hình nhân quả cấu trúc (SCM) bao gồm các phương trình mô tả cách các biến bị ảnh hưởng bởi các biến khác. Để chuyển từ DAG sang SCM, chúng ta cần xác định một hệ phương trình cấu trúc định lượng cách mỗi biến được sinh ra.
Cụ thể, một phương trình cấu trúc trong ngữ cảnh này là một phương trình toán học biểu diễn một biến (kết quả) như một hàm của một hoặc nhiều biến khác (nguyên nhân) cộng với một hạng nhiễu thể hiện mọi ảnh hưởng khác lên kết quả đó. Trong ví dụ của chúng ta:
Vì nhiệt độ (t) là một biến ngoại sinh, nghĩa là không bị gây ra bởi hai biến còn lại, chúng ta giả định nó được quyết định bởi các yếu tố bên ngoài.
Trong các phương trình trên, cả tiêu thụ kem và cá mập tấn công đều tuân theo mô hình tuyến tính theo nhiệt độ, cho thấy cách một thay đổi về nhiệt độ lan truyền đến cả hai kết quả.
Chúng ta còn có thể tiến thêm một bước và đưa xác suất vào cuộc chơi!
Mạng Bayes (Bayesian Networks)
Mạng Bayes (BN) có thể được xem là một hiện thân cụ thể của SCM trong đó các phương trình cấu trúc được biểu diễn theo xác suất.
Một BN sử dụng cùng cấu trúc nhân - quả, nhưng thay vì viết ra các công thức chính xác (như mô hình tuyến tính), nó mô tả xác suất hay khả năng của các kết cục khác nhau. Nói cách khác, thay vì có một phương trình, ta biểu diễn xác suất Y xảy ra khi X có một giá trị nhất định: P(Y | X). Xác suất có điều kiện này thay thế một phương trình cố định trong SCM bằng mô tả về sự bất định.
Suy luận nhân quả (Causal Inference)
Trong bối cảnh Causal AI, Suy luận nhân quả đề cập đến các kỹ thuật để xác định các mối quan hệ nhân - quả từ dữ liệu. Ở đây, thay vì tập trung vào các mô hình để hiểu mối quan hệ, chúng ta bắt đầu với một tập dữ liệu và áp dụng các phương pháp khác nhau để phân định các quan hệ đó. Chúng ta sẽ xem xét chúng bằng cách áp dụng từng phương pháp vào ví dụ gốc:
Thử nghiệm ngẫu nhiên có đối chứng (RCT)
Thử nghiệm ngẫu nhiên có đối chứng (RCT) giúp xác định mối quan hệ nhân quả bằng cách phân ngẫu nhiên người tham gia vào các nhóm khác nhau và so sánh kết quả.
Ví dụ, để trả lời câu hỏi “Ăn kem có gây ra nhiều vụ cá mập tấn công hơn không?” chúng ta sẽ phân ngẫu nhiên mọi người vào hai nhóm:
Sau đó, chúng ta so sánh tỷ lệ cá mập tấn công giữa các nhóm. Lý tưởng nhất là sẽ không thấy sự khác biệt đáng kể vì việc tiêu thụ kem không gây ra cá mập tấn công. Nguyên nhân thực sự trong trường hợp này có khả năng là nhiệt độ, yếu tố không bị thao tác trong thí nghiệm.
Nói một cách chính quy hơn, ta sẽ nói rằng ngẫu nhiên hóa cô lập tác động của việc tiêu thụ kem, và vì không tìm thấy mối liên hệ nhân quả nào, điều này gợi ý rằng ăn kem không trực tiếp gây ra cá mập tấn công.
Ghép điểm xu hướng (Propensity Score Matching)
Trong các tình huống không thể ngẫu nhiên hóa, chúng ta có thể dựa vào dữ liệu quan sát và áp dụng Ghép điểm xu hướng (PSM).
Thực tế, trong đời sống, chúng ta không thể áp dụng RCT và ngẫu nhiên hóa việc tiêu thụ kem vì mọi người tự quyết định có ăn hay không. Tuy nhiên, chúng ta có thể dùng dữ liệu quan sát để suy luận các mối quan hệ nhân quả theo các bước PSM:
Lý tưởng là tỷ lệ cá mập tấn công sẽ tương tự nhau ở cả hai nhóm, điều này gợi ý rằng việc tiêu thụ kem không phải là nguyên nhân của cá mập tấn công. Bất kỳ khác biệt quan sát được nào nhiều khả năng là do các yếu tố khác, như nhiệt độ.
Biến công cụ (Instrumental variables)
Giả sử chúng ta nghi ngờ nhiệt độ là một biến ẩn (biến gây nhiễu) ảnh hưởng đến cả tiêu thụ kem và cá mập tấn công. Kỹ thuật Biến công cụ (IV) giúp giải quyết vấn đề này bằng cách sử dụng thêm một biến (một công cụ) — chẳng hạn như lịch chạy của xe bán kem — tác động đến việc tiêu thụ kem nhưng không liên quan đến các vụ cá mập tấn công.
Nếu lịch trình của xe chỉ ảnh hưởng đến doanh số bán kem chứ không ảnh hưởng đến hành vi đi bơi, thì ta có thể dùng nó làm biến công cụ để cô lập tác động nhân quả của việc tiêu thụ kem lên các vụ cá mập tấn công. Khi áp dụng IV, nhiều khả năng ta sẽ thấy rằng sau khi tính đến biến công cụ này, tiêu thụ kem không gây ra cá mập tấn công, và tương quan quan sát được là do biến gây nhiễu ẩn: nhiệt độ.
Nếu bạn tò mò về các loại suy luận khác, hãy xem bài viết “Machine Learning Inference là gì? Giới thiệu các cách tiếp cận suy luận”.
Các khung công cụ triển khai Causal AI
Trong phần này, chúng ta sẽ khám phá hai khung làm việc khác nhau để áp dụng Causal AI trong thực tiễn bằng Python.
Thư viện DoWhy cho Python
DoWhy là một công cụ rất thú vị vì nó cung cấp một khung làm việc đầu-cuối cho suy luận nhân quả, nhấn mạnh tính minh bạch và khả năng diễn giải.
Nó rất toàn diện và cung cấp đa dạng thuật toán để ước lượng hiệu ứng, phân tích nguyên nhân gốc rễ, can thiệp và phản sự kiện. Công cụ này đặc biệt hữu ích cho các quy trình suy luận nhân quả dựa trên đồ thị. Tôi sẽ không đi sâu vào công cụ này vì đã có hướng dẫn đầy đủ trên DataCamp: Giới thiệu Causal AI với thư viện DoWhy.
Pyro trên nền tảng PyTorch
Pyro là một khung lập trình xác suất tập trung chủ đạo vào mô hình hóa cấu trúc và Bayes. Một lợi ích quan trọng của Pyro là tích hợp liền mạch với PyTorch để tăng tốc bằng GPU và các ứng dụng học sâu.
Nếu bạn quan tâm, Pyro có tài liệu rất phong phú với rất nhiều ví dụ sẵn có.
Nếu bạn nóng lòng muốn bắt đầu sử dụng các khung AI như đã nêu ở phần này, tôi khuyên bạn khóa học DataCamp về Phát triển Ứng dụng AI.
Triển khai kỹ thuật Causal AI
Đến đây, chúng ta đã điểm qua nền tảng của Causal AI, các mô hình phía sau nó, các cách tiếp cận cho Suy luận nhân quả và hai khung Python để làm việc với nó. Tuy nhiên, chúng ta đều biết việc dấn thân vào một lĩnh vực mới có thể khó khăn. Vì vậy, trong phần này, chúng ta sẽ xem xét năm bước then chốt để triển khai Causal AI:
1. Kiểm tra dữ liệu
Chất lượng dữ liệu là tối quan trọng vì suy luận nhân quả phụ thuộc rất nhiều vào dữ liệu phản ánh chính xác hệ thống được nghiên cứu. Cần ghi nhớ rằng mọi loại lỗi, giá trị thiếu hay sai lệch đều có thể làm méo mó các mối quan hệ nhân quả.
Suy luận nhân quả cũng đòi hỏi dữ liệu đủ phong phú, chẳng hạn đảm bảo mọi biến gây nhiễu liên quan đều được quan sát và đưa vào dữ liệu, các can thiệp được định nghĩa rõ và nhất quán giữa các quan sát, và các nhóm có thể so sánh được khi áp dụng các kỹ thuật yêu cầu phân nhóm.
Lời khuyên cuối cùng, nếu bạn có thể chọn dữ liệu, dữ liệu theo thời gian (chuỗi thời gian hoặc dọc) thường rất hữu ích để xác lập tính nhân quả, vì nó giúp xác định thứ tự sự kiện.
2. Lựa chọn mô hình
Bước này liên quan đến việc tạo một mô hình khái niệm đại diện cho các mối quan hệ giữa các biến. Các công cụ như DAG hoặc SCM thường được dùng ở giai đoạn này để chính thức hóa các giả định về tính nhân quả.
Chúng ta đã thấy biến gây nhiễu là các biến ẩn có thể ảnh hưởng đến các biến quan sát. Cũng có hai loại biến khác:
Việc nhận diện ba loại biến này và các tương tác tiềm năng của chúng trong quá trình mô hình hóa, cũng như xác định rõ hướng nhân quả, là điều thú vị và quan trọng.
3. Nhận dạng (Identification)
Mục tiêu của nhận dạng là xác định liệu hiệu ứng nhân quả quan tâm có thể được ước lượng từ dữ liệu quan sát, với mô hình đã cho hay không. Do đó, bước này bao gồm việc kiểm tra xem hiệu ứng nhân quả có thể nhận dạng được bằng các phương pháp Suy luận nhân quả như Nhận dạng biến hay không.
4. Ước lượng
Khi hiệu ứng nhân quả đã được nhận dạng, bước này tập trung vào định lượng hiệu ứng nhân quả bằng các phương pháp thống kê. Đây là thời điểm tốt để áp dụng Ghép điểm xu hướng, chẳng hạn.
5. Bác bỏ (Refutation)
Giai đoạn này kiểm tra liệu các kết luận nhân quả của bạn có đứng vững không bằng cách thách thức các giả định và khám phá các diễn giải thay thế. Các phương pháp ở bước này gồm suy luận phản sự kiện và can thiệp. Trong khi phản sự kiện xem xét liệu kết quả có thay đổi dưới các điều kiện khác hay không, can thiệp kiểm tra độ vững của các mối quan hệ nhân quả bằng cách chủ động thay đổi các biến và quan sát tác động.
Ứng dụng của Causal AI
Giờ khi đã biết Causal AI vận hành như thế nào, hãy xem một số lĩnh vực có thể áp dụng nó.
Một ví dụ điển hình về hệ thống Causal AI trong thế giới thực là trong lĩnh vực y tế, nơi nó được dùng để xác định hiệu quả của các phương pháp điều trị bằng cách ước lượng, chẳng hạn, tác động nhân quả của các can thiệp y khoa. Ngoài ra, các mối quan hệ nhân quả được dùng để cá nhân hóa điều trị theo từng bệnh nhân dựa trên tình trạng cụ thể của họ.
Marketing là một lĩnh vực khác hưởng lợi từ Causal AI. Ví dụ, Causal AI giúp đo lường tác động thực sự của các chiến dịch marketing bằng cách phân biệt giữa tương quan và nhân quả. Nó mang lại hiểu biết sâu hơn về những gì thúc đẩy quyết định của khách hàng, cho phép xây dựng chiến lược marketing mục tiêu và hiệu quả hơn. Tương tự, các lĩnh vực như kinh tế, kinh doanh và quản trị chuỗi cung ứng cũng dựa vào việc hiểu tính nhân quả.
Lời kết
Trong bài viết này, chúng ta đã khám phá cách Causal AI giúp vượt lên trên các tương quan đơn thuần trong dữ liệu để khám phá các mối quan hệ nhân - quả thực sự. Chúng ta đã xem xét cách Đồ thị có hướng không chu trình, Mô hình nhân quả cấu trúc và Mạng Bayes đóng vai trò công cụ mô hình hóa nhân quả để biểu diễn và suy luận về các hệ thống phức tạp.
Bên cạnh đó, chúng ta đã thảo luận cách áp dụng Causal AI vào dữ liệu, nơi Thử nghiệm ngẫu nhiên có đối chứng và Ghép điểm xu hướng hỗ trợ ước lượng hiệu ứng nhân quả. Khi nghi ngờ có gây nhiễu không đo lường được, Biến công cụ giúp nhận diện các ảnh hưởng ẩn.
Cuối cùng, chúng ta đã phác thảo các bước triển khai Causal AI trong thực tế, với nhấn mạnh đặc biệt vào suy luận phản sự kiện và can thiệp như những công cụ then chốt trong giai đoạn bác bỏ của phân tích nhân quả.
Khi Causal AI tiếp tục phát triển, nó sẽ đóng vai trò ngày càng quan trọng không chỉ trong việc phân biệt giữa tương quan đơn thuần và nhân quả mà còn trong việc tận dụng tính nhân quả để ra quyết định tốt hơn.
Nếu bạn muốn tìm hiểu thêm về Causal AI và cách nó giúp doanh nghiệp ra quyết định tốt hơn, hãy xem tập DataFramed về Causal AI trong kinh doanh. Bạn cũng có thể đọc hướng dẫn thực hành về Causal AI sử dụng thư viện DoWhy để có ví dụ thực hành.