您是否听说过,在美国收集的数据中,冰淇淋消费与鲨鱼袭击有关联?
听起来再离奇,这类相关性会在两个变量看似相关、但实际上都受第三个变量影响时出现。在这个例子中,气温很可能是关键因素。夏季由于炎热,冰淇淋消费增加。与此同时,由于更多人下海游泳,鲨鱼袭击事件也会增多。
尽管这种模式在数据中显示了相关性,但并不意味着一者导致另一者。这正是因果 AI发挥作用的地方。它有助于识别数据中的真实因果关系,从而避免伪相关。
在本文中,我们将探讨因果 AI 的概念、其重要性,以及如何在实践中应用。
什么是因果 AI?
因果 AI 是人工智能(AI)的一个分支,侧重于理解与建模因果关系,而不仅仅像传统机器学习系统那样识别模式或相关性。
因果 AI 有助于提升 AI 系统在现实场景(如医疗与经济等天生更复杂的领域)中的可靠性、可解释性与稳健性。
此时,您也许会问:
为何传统 AI 方法没有将因果性纳入考量?
因果 AI 与传统 AI:关键差异
传统 AI 系统专注于识别模式、相关性,并基于数据进行预测。为此,它们依赖统计与机器学习(ML)技术来寻找数据中的关联。
确实,在训练过程中,它们被设计为利用大型数据集来优化预测准确性。这些数据集包含相关性,算法会注意到这些相关性,但其中可能并不包含显式的因果信息。
此外,传统 AI 系统常因可解释性有限而受到批评,经常被称为“黑箱”。在这种情况下,因果 AI 通过对因与果进行显式推理,帮助构建更透明、可解释的模型。
最后,虽然传统(非因果)AI 方法有众多应用,但本节的要点是: 相关性不代表因果性。
- 相关性指两个变量同向变化,但这无法证明一者导致另一者。
- 因果性意味着一个变量直接影响另一个变量。
回到引言中的冰淇淋与鲨鱼袭击的例子,我们可以看到冰淇淋销量与鲨鱼袭击事件是相关的(都在夏季上升),但冰淇淋并不会导致鲨鱼袭击。
因果 AI 基础
如我们所见,因果 AI 的核心目标是建立变量之间的因果关系。然而,还有两个基础概念对理解与操作系统内的这些关系至关重要:
反事实推理
反事实推理是指考虑假设情景,以理解对某些变量的改变如何会改变结果。
我喜欢把反事实推理看作提出这样的问题:“如果变量 X 取了另一个值,会发生什么?”这就是一个“如果……会怎样”的问题。
在我们的冰淇淋与鲨鱼袭击例子中,我们可以问:“如果冰淇淋销量更低,会不会就有更少的鲨鱼袭击?”
在这个反事实场景中,我们设想一个替代现实:冰淇淋销量下降,而其他一切保持不变。由于冰淇淋销量和鲨鱼袭击都因更温暖的天气(共同原因)在夏季上升,降低冰淇淋销量并不会影响鲨鱼袭击。这表明这是相关而非因果。
干预
干预是指在系统中有意操纵变量以观察其他变量的变化。在这种情况下,干预意味着主动将某个变量设为特定值,从而研究其对系统的直接影响。
在我们的例子中,一个干预可以是:
“让我们在炎热的日子禁止销售冰淇淋(将冰淇淋销量设为 0)。这会减少鲨鱼袭击吗?”
这里,我们通过取消冰淇淋销售来有意改变系统。最可能的结果是鲨鱼袭击不变,因为禁售冰淇淋并不会阻止人们游泳。这个简单示例说明,对冰淇淋销售进行干预并不会对鲨鱼袭击产生因果影响。
在继续之前,如果您对 AI 的更多基础知识感兴趣,技能路线AI Fundamentals 适合您!
因果 AI 模型
本节我们将探讨三种因果 AI 模型,帮助我们理解如何处理因果性。
让我们从最简单的模型开始,逐步过渡到更复杂的模型。
有向无环图
有向无环图(DAG) 编码变量之间的方向性关系且不存在环路,即不存在变量可以间接导致自身的回路。它们用于以二元方式刻画因果关系:要么两变量之间存在因果关系,此时图中从原因指向结果有一条有向边;要么不存在因果关系,因此也就没有边。
例如,我们最初关于冰淇淋消费与鲨鱼袭击的例子的 DAG 显示如下因果路径:
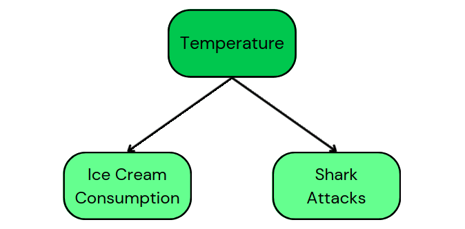
这个 DAG 告诉我们,气温是冰淇淋消费与鲨鱼袭击的共同原因。此外,它还表明冰淇淋消费与鲨鱼袭击之间不存在因果关系。
DAG 是简洁的表示方式,但通过在路径中加入更多信息,它们也可以变得更复杂,正如下文将要看到的。
结构因果模型
结构因果模型(SCM)包含建模变量如何受其他变量影响的方程。要从 DAG 过渡到 SCM,我们需要指定一组结构方程,定量描述每个变量如何被生成。
具体而言,此处的结构方程是用一个数学方程将某个变量(结果)表示为一个或多个其他变量(原因)的函数,并加上一个表示对该结果其他全部影响的扰动项。在我们的例子中:
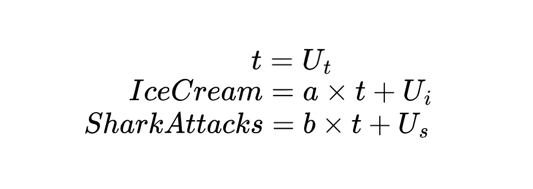
由于气温(t)是外生变量,意味着它不受另外两个变量的影响,我们假设它由外部因素决定。
在上述方程中,冰淇淋消费与鲨鱼袭击都对气温呈线性模型,展示了气温的变化如何传导到这两个结果上。
我们甚至可以更进一步,把概率引入进来!
贝叶斯网络
贝叶斯网络(BN)可以被视为 SCM 的一种特定实现形式,其中结构方程以概率的方式表达。
BN 使用同样的因果结构,但不是写出精确公式(如线性模型),而是描述不同结果发生的概率或机会。换言之,我们不是给出一个方程,而是表达在X 取某个值时Y 发生的概率:P(Y | X)。这种条件概率用不确定性的描述替代了 SCM 中的固定方程。
因果推断
在因果 AI 的语境下,因果推断指的是从数据中找出因果关系的技术。在这里,我们不是从模型出发去理解关系,而是从一组数据出发,应用不同方法来辨别这些关系。我们将通过将各方法应用到最初的例子来回顾它们:
随机对照试验
随机对照试验(RCT)通过将参与者随机分配到不同组别并比较结果,来帮助确定因果关系。
例如,为回答我们的提问,“吃冰淇淋会导致更多鲨鱼袭击吗?”我们会随机将人分为两组:
然后,我们比较两组的鲨鱼袭击率。理想情况下,我们不应发现显著差异,因为冰淇淋消费不会导致鲨鱼袭击。本例中的真正原因很可能是气温,而实验中并未操纵它。
更正式地说,随机化隔离了冰淇淋消费的效应,而由于未发现因果联系,这表明吃冰淇淋并不会直接导致鲨鱼袭击。
倾向得分匹配
在无法随机化的情境中,我们可以依赖观测数据并应用倾向得分匹配(PSM)。
事实上,在现实世界中,我们无法进行 RCT 来随机化冰淇淋消费,因为人们会自己决定是否食用。然而,我们可以使用观测数据来推断因果关系,遵循 PSM 的步骤:
- 计算倾向得分:即某人基于气温、年龄及其他相关变量而食用冰淇淋的可能性。
- 将吃冰淇淋者与不吃者进行匹配,使其倾向得分相近,即具可比性。
- 评估两组的鲨鱼袭击率(吃冰淇淋组与不吃组)。
理想情况下,两组的鲨鱼袭击率应当相似,这将表明冰淇淋消费并非鲨鱼袭击的原因。任何观察到的差异更可能由其他因素(如气温)引起。
工具变量
假设我们怀疑气温是一个隐藏变量(混杂因素),同时影响冰淇淋消费与鲨鱼袭击。工具变量(IV)技术通过使用一个额外变量(工具)——例如冰淇淋车的出车时间表——它会影响冰淇淋消费,但与鲨鱼袭击无关,来帮助解决这个问题。
如果冰淇淋车的时间表只影响冰淇淋销量,而不影响人们的游泳行为,那么我们就可以将其作为工具,来隔离冰淇淋消费对鲨鱼袭击的因果效应。应用 IV 后,我们很可能会发现,在考虑该工具后,冰淇淋消费并不会导致鲨鱼袭击,而观察到的相关性是由隐藏的混杂因素——气温——引起的。
如果您对其他类型的推断感兴趣,不妨阅读文章“什么是机器学习推理?推理方法概述”。
实施因果 AI 的框架
本节我们将使用 Python 探讨两种在实践中使用因果 AI 的框架。
DoWhy Python 库
DoWhy 是一个非常有趣的工具,因为它提供了端到端的因果推理框架,强调透明性与可解释性。
它功能十分全面,提供了用于效应估计、根因分析、干预与反事实的多种算法。它对基于图的因果推断流程尤其有用。关于该工具我不再展开细节,DataCamp 上已有完整教程: 使用 DoWhy 库入门因果 AI。
Pyro(PyTorch 框架)
Pyro 是一个概率编程框架,核心聚焦于结构与贝叶斯建模。其一大优势在于与 PyTorch 无缝集成,支持 GPU 加速与深度学习应用。
如果您感兴趣,Pyro 拥有详尽文档,其中包含大量示例可供参考。
如果您迫不及待想开始使用本节提到的 AI 框架,我推荐 DataCamp 的开发 AI 应用课程。
因果 AI 的技术实施
到目前为止,我们已经回顾了因果 AI 的基础、其背后的模型、不同的因果推断方法,以及两个可用于实践的 Python 框架。不过我们都知道,涉足一个全新领域并不容易。因此,本节将回顾实施因果 AI 的五个关键步骤:
1. 数据检查
我们所拥有的数据质量至关重要,因为因果推断高度依赖于能够准确反映被研究系统的数据。需要牢记,任何类型的错误、缺失值或偏差都可能扭曲因果关系。
因果推断还需要丰富的数据,例如确保所有相关混杂因素都被观测并包含在数据中,干预在各观测间定义明确且一致,以及在需要分组的技术中保证组间可比性。
最后给个建议:如果您可以选择数据,时间序列或纵向数据通常对建立因果关系非常有用,因为它有助于确定事件的先后顺序。
2. 模型选择
这一步涉及创建一个表示变量间关系的概念模型。此时常使用 DAG 或 SCM 等工具来形式化关于因果性的假设。
我们已经看到,混杂因素是可能影响观测变量的隐藏变量。还有另外两类变量:
- 中介变量:位于因果路径上的变量。
- 碰撞变量:由两个其他变量共同影响的变量。
在建模过程中识别这三类变量及其潜在交互,并清晰定义因果方向,是很有意义的。
3. 可识别性(识别)
识别的目标是根据模型判断感兴趣的因果效应是否可以从观测数据中估计。因此,这一步要检查是否可以使用变量识别等因果推断方法来识别该因果效应。
4. 估计
一旦因果效应被识别,此步骤将聚焦于使用统计方法对因果效应进行量化。例如,这是应用倾向得分匹配的好时机。
5. 反驳
此阶段通过质疑假设与探索替代性解释,来检验您的因果结论是否站得住脚。此步骤中的方法包括反事实推理与干预。反事实检验在不同条件下结果是否会改变;干预则通过主动改变变量并观察影响,来检验因果关系的稳健性。
因果 AI 的应用
既然我们已经了解了因果 AI 的工作原理,让我们看看可以应用它的一些领域示例。
一个很好的现实案例来自医疗健康领域,在该领域中,因果 AI 被用于确定治疗的有效性,例如估计医疗干预的因果影响。此外,还利用因果关系根据患者的具体情况来定制个体化治疗方案。
营销也是受益于因果 AI 的另一领域。 例如,因果 AI 有助于衡量营销活动的真实影响,区分相关与因果。它能更深入地洞察驱动客户决策的因素,从而实现更有针对性、更有效的营销策略。类似地,经济学、商业与供应链管理等领域也都依赖对因果性的理解。
结语
在本文中,我们探讨了因果 AI 如何帮助我们超越数据中的简单相关性,发掘真正的因果关系。我们审视了有向无环图、结构因果模型与贝叶斯网络如何作为因果建模工具来表示并推理复杂系统。
此外,我们讨论了如何将因果 AI 应用于数据,其中随机对照试验与倾向得分匹配有助于因果效应估计。当怀疑存在未测量的混杂时,工具变量可帮助识别隐藏影响。
最后,我们概述了在实践中实施因果 AI 的步骤,特别强调在因果分析的反驳阶段,反事实推理与干预是关键工具。
随着因果 AI 的不断发展,它将在不仅区分简单相关与因果,而且利用因果性做出更优决策方面发挥越来越重要的作用。
如果您想进一步了解因果 AI 以及它如何帮助企业做出更好决策,欢迎收听我们的DataFramed 关于商业中因果 AI 的节目。您也可以阅读我们的实用指南使用 DoWhy 库入门因果 AI,获取一个动手实践的示例。


您是否听说过,在美国收集的数据中,冰淇淋消费与鲨鱼袭击有关联?
听起来再离奇,这类相关性会在两个变量看似相关、但实际上都受第三个变量影响时出现。在这个例子中,气温很可能是关键因素。夏季由于炎热,冰淇淋消费增加。与此同时,由于更多人下海游泳,鲨鱼袭击事件也会增多。
尽管这种模式在数据中显示了相关性,但并不意味着一者导致另一者。这正是因果 AI发挥作用的地方。它有助于识别数据中的真实因果关系,从而避免伪相关。
在本文中,我们将探讨因果 AI 的概念、其重要性,以及如何在实践中应用。
什么是因果 AI?
因果 AI 是人工智能(AI)的一个分支,侧重于理解与建模因果关系,而不仅仅像传统机器学习系统那样识别模式或相关性。
因果 AI 有助于提升 AI 系统在现实场景(如医疗与经济等天生更复杂的领域)中的可靠性、可解释性与稳健性。
此时,您也许会问:
为何传统 AI 方法没有将因果性纳入考量?
因果 AI 与传统 AI:关键差异
传统 AI 系统专注于识别模式、相关性,并基于数据进行预测。为此,它们依赖统计与机器学习(ML)技术来寻找数据中的关联。
确实,在训练过程中,它们被设计为利用大型数据集来优化预测准确性。这些数据集包含相关性,算法会注意到这些相关性,但其中可能并不包含显式的因果信息。
此外,传统 AI 系统常因可解释性有限而受到批评,经常被称为“黑箱”。在这种情况下,因果 AI 通过对因与果进行显式推理,帮助构建更透明、可解释的模型。
最后,虽然传统(非因果)AI 方法有众多应用,但本节的要点是: 相关性不代表因果性。
回到引言中的冰淇淋与鲨鱼袭击的例子,我们可以看到冰淇淋销量与鲨鱼袭击事件是相关的(都在夏季上升),但冰淇淋并不会导致鲨鱼袭击。
因果 AI 基础
如我们所见,因果 AI 的核心目标是建立变量之间的因果关系。然而,还有两个基础概念对理解与操作系统内的这些关系至关重要:
反事实推理
反事实推理是指考虑假设情景,以理解对某些变量的改变如何会改变结果。
我喜欢把反事实推理看作提出这样的问题:“如果变量 X 取了另一个值,会发生什么?”这就是一个“如果……会怎样”的问题。
在我们的冰淇淋与鲨鱼袭击例子中,我们可以问:“如果冰淇淋销量更低,会不会就有更少的鲨鱼袭击?”
在这个反事实场景中,我们设想一个替代现实:冰淇淋销量下降,而其他一切保持不变。由于冰淇淋销量和鲨鱼袭击都因更温暖的天气(共同原因)在夏季上升,降低冰淇淋销量并不会影响鲨鱼袭击。这表明这是相关而非因果。
干预
干预是指在系统中有意操纵变量以观察其他变量的变化。在这种情况下,干预意味着主动将某个变量设为特定值,从而研究其对系统的直接影响。
在我们的例子中,一个干预可以是:
“让我们在炎热的日子禁止销售冰淇淋(将冰淇淋销量设为 0)。这会减少鲨鱼袭击吗?”
这里,我们通过取消冰淇淋销售来有意改变系统。最可能的结果是鲨鱼袭击不变,因为禁售冰淇淋并不会阻止人们游泳。这个简单示例说明,对冰淇淋销售进行干预并不会对鲨鱼袭击产生因果影响。
在继续之前,如果您对 AI 的更多基础知识感兴趣,技能路线AI Fundamentals 适合您!
因果 AI 模型
本节我们将探讨三种因果 AI 模型,帮助我们理解如何处理因果性。
让我们从最简单的模型开始,逐步过渡到更复杂的模型。
有向无环图
有向无环图(DAG) 编码变量之间的方向性关系且不存在环路,即不存在变量可以间接导致自身的回路。它们用于以二元方式刻画因果关系:要么两变量之间存在因果关系,此时图中从原因指向结果有一条有向边;要么不存在因果关系,因此也就没有边。
例如,我们最初关于冰淇淋消费与鲨鱼袭击的例子的 DAG 显示如下因果路径:
这个 DAG 告诉我们,气温是冰淇淋消费与鲨鱼袭击的共同原因。此外,它还表明冰淇淋消费与鲨鱼袭击之间不存在因果关系。
DAG 是简洁的表示方式,但通过在路径中加入更多信息,它们也可以变得更复杂,正如下文将要看到的。
结构因果模型
结构因果模型(SCM)包含建模变量如何受其他变量影响的方程。要从 DAG 过渡到 SCM,我们需要指定一组结构方程,定量描述每个变量如何被生成。
具体而言,此处的结构方程是用一个数学方程将某个变量(结果)表示为一个或多个其他变量(原因)的函数,并加上一个表示对该结果其他全部影响的扰动项。在我们的例子中:
由于气温(t)是外生变量,意味着它不受另外两个变量的影响,我们假设它由外部因素决定。
在上述方程中,冰淇淋消费与鲨鱼袭击都对气温呈线性模型,展示了气温的变化如何传导到这两个结果上。
我们甚至可以更进一步,把概率引入进来!
贝叶斯网络
贝叶斯网络(BN)可以被视为 SCM 的一种特定实现形式,其中结构方程以概率的方式表达。
BN 使用同样的因果结构,但不是写出精确公式(如线性模型),而是描述不同结果发生的概率或机会。换言之,我们不是给出一个方程,而是表达在X 取某个值时Y 发生的概率:P(Y | X)。这种条件概率用不确定性的描述替代了 SCM 中的固定方程。
因果推断
在因果 AI 的语境下,因果推断指的是从数据中找出因果关系的技术。在这里,我们不是从模型出发去理解关系,而是从一组数据出发,应用不同方法来辨别这些关系。我们将通过将各方法应用到最初的例子来回顾它们:
随机对照试验
随机对照试验(RCT)通过将参与者随机分配到不同组别并比较结果,来帮助确定因果关系。
例如,为回答我们的提问,“吃冰淇淋会导致更多鲨鱼袭击吗?”我们会随机将人分为两组:
然后,我们比较两组的鲨鱼袭击率。理想情况下,我们不应发现显著差异,因为冰淇淋消费不会导致鲨鱼袭击。本例中的真正原因很可能是气温,而实验中并未操纵它。
更正式地说,随机化隔离了冰淇淋消费的效应,而由于未发现因果联系,这表明吃冰淇淋并不会直接导致鲨鱼袭击。
倾向得分匹配
在无法随机化的情境中,我们可以依赖观测数据并应用倾向得分匹配(PSM)。
事实上,在现实世界中,我们无法进行 RCT 来随机化冰淇淋消费,因为人们会自己决定是否食用。然而,我们可以使用观测数据来推断因果关系,遵循 PSM 的步骤:
理想情况下,两组的鲨鱼袭击率应当相似,这将表明冰淇淋消费并非鲨鱼袭击的原因。任何观察到的差异更可能由其他因素(如气温)引起。
工具变量
假设我们怀疑气温是一个隐藏变量(混杂因素),同时影响冰淇淋消费与鲨鱼袭击。工具变量(IV)技术通过使用一个额外变量(工具)——例如冰淇淋车的出车时间表——它会影响冰淇淋消费,但与鲨鱼袭击无关,来帮助解决这个问题。
如果冰淇淋车的时间表只影响冰淇淋销量,而不影响人们的游泳行为,那么我们就可以将其作为工具,来隔离冰淇淋消费对鲨鱼袭击的因果效应。应用 IV 后,我们很可能会发现,在考虑该工具后,冰淇淋消费并不会导致鲨鱼袭击,而观察到的相关性是由隐藏的混杂因素——气温——引起的。
如果您对其他类型的推断感兴趣,不妨阅读文章“什么是机器学习推理?推理方法概述”。
实施因果 AI 的框架
本节我们将使用 Python 探讨两种在实践中使用因果 AI 的框架。
DoWhy Python 库
DoWhy 是一个非常有趣的工具,因为它提供了端到端的因果推理框架,强调透明性与可解释性。
它功能十分全面,提供了用于效应估计、根因分析、干预与反事实的多种算法。它对基于图的因果推断流程尤其有用。关于该工具我不再展开细节,DataCamp 上已有完整教程: 使用 DoWhy 库入门因果 AI。
Pyro(PyTorch 框架)
Pyro 是一个概率编程框架,核心聚焦于结构与贝叶斯建模。其一大优势在于与 PyTorch 无缝集成,支持 GPU 加速与深度学习应用。
如果您感兴趣,Pyro 拥有详尽文档,其中包含大量示例可供参考。
如果您迫不及待想开始使用本节提到的 AI 框架,我推荐 DataCamp 的开发 AI 应用课程。
因果 AI 的技术实施
到目前为止,我们已经回顾了因果 AI 的基础、其背后的模型、不同的因果推断方法,以及两个可用于实践的 Python 框架。不过我们都知道,涉足一个全新领域并不容易。因此,本节将回顾实施因果 AI 的五个关键步骤:
1. 数据检查
我们所拥有的数据质量至关重要,因为因果推断高度依赖于能够准确反映被研究系统的数据。需要牢记,任何类型的错误、缺失值或偏差都可能扭曲因果关系。
因果推断还需要丰富的数据,例如确保所有相关混杂因素都被观测并包含在数据中,干预在各观测间定义明确且一致,以及在需要分组的技术中保证组间可比性。
最后给个建议:如果您可以选择数据,时间序列或纵向数据通常对建立因果关系非常有用,因为它有助于确定事件的先后顺序。
2. 模型选择
这一步涉及创建一个表示变量间关系的概念模型。此时常使用 DAG 或 SCM 等工具来形式化关于因果性的假设。
我们已经看到,混杂因素是可能影响观测变量的隐藏变量。还有另外两类变量:
在建模过程中识别这三类变量及其潜在交互,并清晰定义因果方向,是很有意义的。
3. 可识别性(识别)
识别的目标是根据模型判断感兴趣的因果效应是否可以从观测数据中估计。因此,这一步要检查是否可以使用变量识别等因果推断方法来识别该因果效应。
4. 估计
一旦因果效应被识别,此步骤将聚焦于使用统计方法对因果效应进行量化。例如,这是应用倾向得分匹配的好时机。
5. 反驳
此阶段通过质疑假设与探索替代性解释,来检验您的因果结论是否站得住脚。此步骤中的方法包括反事实推理与干预。反事实检验在不同条件下结果是否会改变;干预则通过主动改变变量并观察影响,来检验因果关系的稳健性。
因果 AI 的应用
既然我们已经了解了因果 AI 的工作原理,让我们看看可以应用它的一些领域示例。
一个很好的现实案例来自医疗健康领域,在该领域中,因果 AI 被用于确定治疗的有效性,例如估计医疗干预的因果影响。此外,还利用因果关系根据患者的具体情况来定制个体化治疗方案。
营销也是受益于因果 AI 的另一领域。 例如,因果 AI 有助于衡量营销活动的真实影响,区分相关与因果。它能更深入地洞察驱动客户决策的因素,从而实现更有针对性、更有效的营销策略。类似地,经济学、商业与供应链管理等领域也都依赖对因果性的理解。
结语
在本文中,我们探讨了因果 AI 如何帮助我们超越数据中的简单相关性,发掘真正的因果关系。我们审视了有向无环图、结构因果模型与贝叶斯网络如何作为因果建模工具来表示并推理复杂系统。
此外,我们讨论了如何将因果 AI 应用于数据,其中随机对照试验与倾向得分匹配有助于因果效应估计。当怀疑存在未测量的混杂时,工具变量可帮助识别隐藏影响。
最后,我们概述了在实践中实施因果 AI 的步骤,特别强调在因果分析的反驳阶段,反事实推理与干预是关键工具。
随着因果 AI 的不断发展,它将在不仅区分简单相关与因果,而且利用因果性做出更优决策方面发挥越来越重要的作用。
如果您想进一步了解因果 AI 以及它如何帮助企业做出更好决策,欢迎收听我们的DataFramed 关于商业中因果 AI 的节目。您也可以阅读我们的实用指南使用 DoWhy 库入门因果 AI,获取一个动手实践的示例。