L’atomicità è un concetto fondamentale nei sistemi di database. Significa che una transazione deve riuscire completamente oppure non essere eseguita affatto. Se qualcosa fallisce a metà, l’intera operazione viene annullata come se non fosse mai avvenuta.
Perché è così importante, ti chiedi? Immagina di trasferire denaro da un conto bancario a un altro. Premi "Invia", l’app si carica per un secondo e poi qualcosa va storto. Il denaro sparisce dal tuo conto, ma non arriva mai sull’altro. Ora è semplicemente... sparito. È esattamente questo lo scenario che l’atomicità è pensata per prevenire.
Forse hai già sentito parlare di ACID. È un insieme di quattro proprietà chiave che i database usano per evitare che tutto vada in pezzi. L’atomicità è la prima della lista, e a ragione: senza di essa, le altre (Consistenza, Isolamento e Durabilità) contano ben poco.
In questo articolo esploreremo cosa significa atomicità, come funziona e perché è così cruciale nei sistemi di tutti i giorni come banking ed e‑commerce. Vedremo anche come i diversi database la implementano e come puoi progettare sistemi atomici in grado di gestire bene le situazioni quando, inevitabilmente, qualcosa va storto.
Cos’è l’atomicità?
Atomicità significa che una transazione in un database è indivisibile. O viene eseguita fino in fondo, con ogni singolo passaggio che va secondo i piani, oppure non viene eseguita affatto. Non ci sono vie di mezzo. Niente aggiornamenti a metà, niente dati salvati parzialmente, niente strani limbi in cui alcune cose riescono e altre no.
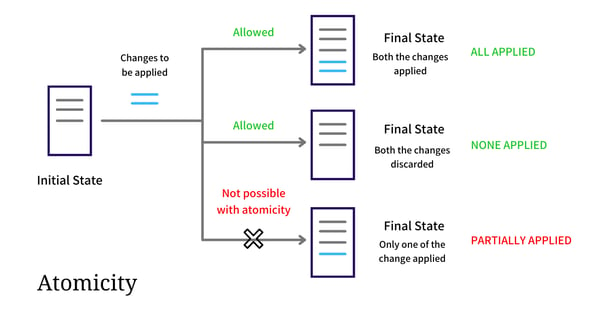
Atomicità nei DBMS. Fonte: Arpit Bhayani
Se una parte della transazione fallisce, l’intera operazione viene annullata come se non fosse mai avvenuta. È questo che rende l’atomicità una protezione così potente. Senza di essa, rischieresti continuamente di lasciare i tuoi dati in uno stato corrotto o incoerente, soprattutto in sistemi in cui più azioni devono avvenire in sequenza.
Vediamo alcuni scenari reali in cui l’atomicità fa (o disfa) il sistema:
Esempio 1: Bonifico bancario
Supponiamo che tu stia trasferendo 100 $ dal tuo conto corrente al tuo conto di risparmio.
La transazione ha due parti:
- Detrarre 100 $ dal conto corrente
- Aggiungere 100 $ al conto di risparmio
Senza atomicità, è possibile che il primo passaggio vada a buon fine e il secondo fallisca, magari per un problema di rete o un crash del server. Complimenti, i tuoi soldi sono appena svaniti nel nulla. L’atomicità garantisce che o entrambi i passaggi riescono, oppure nessuno dei due. Se qualcosa va storto, i 100 $ restano esattamente dove erano all’inizio.
Esempio 2: Inventario ed elaborazione ordini
Stai acquistando online l’ultimo vinile in edizione limitata. Il sistema deve:
- Ridurre l’inventario di un’unità
- Confermare il tuo ordine
Senza atomicità, potrebbe ridurre l’inventario ma bloccarsi prima che l’ordine venga confermato. Ora il negozio pensa di essere esaurito, ma nessuno riceve il disco.
Il numero di volte in cui mi succede quando compro qualcosa online è incredibile. Di solito chiudo la scheda e faccio un in bocca al lupo agli ingegneri, ma con ogni probabilità non proverò ad acquistare di nuovo da quel sito. Chissà come gestiranno i miei dati personali se non riescono a garantire l’affidabilità della funzionalità principale di acquisto?
Esempio 3: Sistema di prenotazione voli
Prenotare un volo di solito non è solo scegliere un posto. Il sistema deve:
- Assegnare il posto
- Aggiornare la disponibilità dei posti
- Addebitare la tua carta
Se il secondo passaggio fallisce e il terzo va a buon fine, hai pagato per un posto che non esiste. Non il massimo.
Esempio 4: Sincronizzazione tra database e indice di ricerca
Supponiamo che la tua app aggiorni la descrizione di un prodotto nel database principale. Allo stesso tempo, dovrebbe aggiornare l’indice di ricerca così che gli utenti possano trovare il prodotto con la nuova descrizione.
Se l’aggiornamento del database riesce ma quello dell’indice fallisce, gli utenti vedono risultati non aggiornati o non trovano affatto il prodotto.
Perché l’atomicità è importante
Perché l’atomicità è così importante?
Ci sono tantissimi motivi per cui una transazione può essere interrotta. Può esserci un blackout, un crash del server o un timeout di rete a metà. Se l’atomicità non è applicata, quella transazione potrebbe essere completata solo parzialmente. Ora il tuo database resta in uno stato scomodo: alcune modifiche sono andate a buon fine, altre no, e non hai un modo semplice per rimettere a posto il caos.
È qui che i bug sui dati diventano davvero subdoli. Gli utenti potrebbero non notare nulla di strano all’inizio, ma col tempo le cose non tornano più. Le tue analytics sembrano strane, gli ordini spariscono, i conti non tornano o i ticket di supporto schizzano perché le persone non trovano ciò che hanno appena salvato.
L’atomicità previene tutto questo garantendo che:
- Una transazione avvenga completamente o non avvenga affatto
- Il sistema possa riprendersi in modo pulito anche se qualcosa fallisce a metà
- I tuoi dati restino coerenti, anche durante crash di sistema o accessi concorrenti
È anche strettamente legata alle altre proprietà ACID. Senza atomicità, la consistenza va a farsi benedire perché non puoi far rispettare le regole se metà dei dati manca, e l’isolamento si rompe, poiché altri utenti potrebbero vedere dati parziali da una transazione incompleta.
È particolarmente importante se hai a che fare con:
- Transazioni multi‑step, in cui un’azione dipende da un’altra.
- Aggiornamenti su più righe o più tabelle, in cui i dati correlati devono restare sincronizzati.
- Sistemi distribuiti, in cui parti della transazione avvengono su macchine o database diversi.
Come funziona l’atomicità nella pratica
Dietro la semplicità del "tutto o niente" si nasconde un sistema sorprendentemente complesso. Quando un database esegue una transazione, traccia attivamente, prepara e protegge ogni passaggio.
Ecco una panoramica di alto livello di cosa succede:
Il ciclo di vita della transazione
- Begin transaction: Il sistema segna l’inizio di una transazione, isolando le modifiche imminenti dal resto del database.
- Execute operation: Include tutti i tuoi insert, update, delete, o qualunque magia SQL tu stia facendo.
- Commit o rollback: Se ogni operazione riesce, la transazione viene eseguita (commit) e le modifiche diventano permanenti. Se qualcosa fallisce, l’intera transazione viene annullata (rollback).
Logging e journaling
Per garantire l’atomicità, i database scrivono log di ciò che sta per accadere prima che accada davvero. Questi log sono archiviati separatamente e fungono da piano di backup.
Se il sistema si arresta a metà transazione, può consultare il log e annullare eventuali modifiche incomplete, riapplicare in sicurezza quelle completate e riportare il database a uno stato pulito e coerente.
Questo approccio è talvolta chiamato Write‑Ahead Logging (WAL) o journaling, ed è un elemento chiave del ripristino dopo un crash.
Rollback e ripristino
Quando una transazione fallisce, il database non si limita a mollare, ma annulla con cura le modifiche. Le righe modificate vengono ripristinate al loro stato originale, eventuali lock detenuti dalla transazione vengono rilasciati e i log vengono usati per invertire gli aggiornamenti parziali.
Nel caso di un crash, al riavvio entrano in azione le routine di ripristino. Riproducono i log, risolvono le transazioni non completate e assicurano che il database riparta esattamente da dove si era fermato, senza strani stati a metà.
Prestazioni vs. atomicità
Com’è prevedibile, tutto questo ha un costo. L’atomicità introduce:
- Locking: Per impedire ad altri di modificare gli stessi dati durante la transazione
- Overhead: Dovuto a logging e meccanismi di rollback
- Deadlock: Quando più transazioni aspettano che le altre rilascino risorse
Per questo è necessario progettare con cura le transazioni grandi. Se fai troppo in un colpo solo, potresti rallentare l’intero sistema o incorrere in problemi di concorrenza.
Atomicità nei sistemi di database più diffusi
L’atomicità è un concetto centrale in tutti i principali database, ma il modo in cui viene implementata può variare leggermente a seconda del motore di archiviazione sottostante e della filosofia di progettazione. Diamo un’occhiata a come PostgreSQL e MySQL (InnoDB) garantiscono il corretto funzionamento delle transazioni.
PostgreSQL
Prima che qualsiasi dato venga scritto in modo permanente, PostgreSQL crea un write‑ahead log (WAL), cioè il registro di ogni modifica prevista di cui abbiamo parlato in precedenza. Questo log è conservato in sicurezza e viene usato come piano di ripristino nel caso in cui qualcosa vada storto durante la transazione.
Quando una transazione viene eseguita (commit), PostgreSQL controlla il WAL, conferma che tutte le modifiche siano complete e valide, e poi finalizza gli aggiornamenti. Se qualcosa va in crash a metà, il database usa quel log per annullare il lavoro incompleto.
La cosa bella è che tutto questo avviene automaticamente dietro le quinte. Dal punto di vista di uno sviluppatore, è tutto trasparente: scrivi una transazione e PostgreSQL garantisce l’atomicità senza che tu debba gestire alcuna complessità.
Nessuna modifica è visibile ad altri utenti finché la transazione non è completamente confermata. Questo mantiene le cose coerenti ed evita qualsiasi stranezza da "salvataggio a metà" in ambienti multiutente.
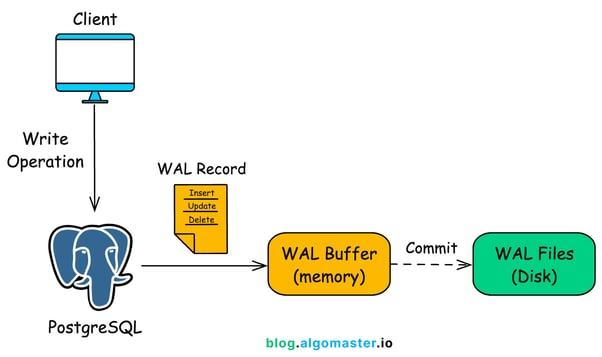
WAL in PostgreSQL. Fonte: AlgoMaster
Se vuoi metterti alla prova e creare i tuoi database per testare le transazioni, dai un’occhiata al nostro corso su PostgreSQL.
MySQL (InnoDB)
Anche il motore di archiviazione InnoDB di MySQL supporta transazioni atomiche, e il suo approccio è pensato sia per l’affidabilità sia per le prestazioni.
Come PostgreSQL, InnoDB usa un transaction log per tenere traccia delle modifiche prima di confermarle. Se qualcosa fallisce, il log viene usato per riportare tutto allo stato precedente alla transazione. Questo assicura che nessun aggiornamento parziale passi inosservato.
Una cosa che InnoDB fa particolarmente bene è raggruppare le scritture. Questo aiuta a ridurre l’I/O su disco e migliora le prestazioni, pur proteggendo l’atomicità. Usa anche gli undo log per invertire le modifiche durante un rollback e i redo log per il ripristino dopo un crash.
Proprio come in PostgreSQL, puoi contare sul database per gestire questi meccanismi per te. Non devi scrivere codice personalizzato per il rollback.
Punti chiave per ingegneri e data architect
Ci sono alcune cose da tenere a mente quando lavori con transazioni atomiche nei tuoi progetti. L’idea generale è trattare l’atomicità come predefinita, non come un lusso. Se stai costruendo sistemi che modificano dati in più punti contemporaneamente (cioè praticamente tutti), progettare con l’atomicità in mente ti farà risparmiare tempo, sanità mentale e, potenzialmente, una notifica di incidente alle 3 del mattino.
Scegli il database giusto per il lavoro
Non tutti i database gestiscono l’atomicità allo stesso modo e non tutti i motori di archiviazione sono uguali. Se l’atomicità è fondamentale per il tuo caso d’uso (ad esempio, finanza, logistica, gestione dello stato utente), assicurati che il tuo database supporti transazioni ACID complete. Questo è particolarmente rilevante se usi MySQL, dove la scelta del motore di archiviazione conta.
Progetta per il fallimento
Dai per scontato che qualcosa andrà storto, perché succederà. Incapsula le operazioni multi‑step in transazioni e gestisci correttamente gli errori. Sii esplicito con le istruzioni BEGIN, COMMIT, e ROLLBACK, oppure usa framework che le gestiscono in sicurezza sotto il cofano.
La maggior parte degli ORM moderni e dei livelli di accesso ai dati offre supporto integrato alle transazioni. Per esempio:
-
In Node.js, librerie come Prisma e TypeORM ti permettono di incapsulare la logica in una chiamata transaction() che gestisce commit/rollback dietro le quinte.
-
In Python, SQLAlchemy offre context manager (with session.begin():) che garantiscono commit e rollback sicuri.
-
In Java, framework come Spring ti permettono di annotare i metodi con @Transactional, così il database gestisce tutto in modo atomico, anche su più chiamate di funzione.
Questi strumenti rendono molto più facile costruire in sicurezza per impostazione predefinita. Riducano il rischio di dimenticare un rollback o gestire male la logica di commit, soprattutto quando la tua app diventa più complessa.
Bilancia prestazioni e affidabilità
L’atomicità comporta un certo overhead, soprattutto nelle transazioni grandi. Suddividi le operazioni massive quando possibile, evita di bloccare intere tabelle e mantieni le transazioni brevi e mirate. Le transazioni di lunga durata aumentano il rischio di contesa, deadlock e utenti insoddisfatti.
Comprendi dipendenze e isolamento
Come abbiamo visto, l’atomicità non esiste nel vuoto ma insieme a consistenza e isolamento. Assicurati che le modifiche correlate avvengano insieme e considera come le transazioni concorrenti potrebbero interagire. Usa livelli di isolamento adatti al tuo carico senza complicare troppo le cose.
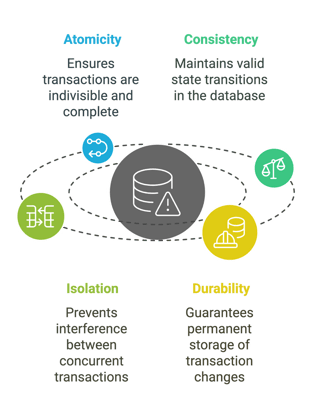
Proprietà ACID nei DBMS. Fonte: Datacamp
Testa con scenari realistici di errore
Non testare solo gli happy path. Simula cosa succede quando la tua app si arresta a metà transazione o quando una query va in timeout. Puoi usare failpoint o simulare errori del DB per vedere come si comporta il tuo sistema sotto pressione.
Conclusione
Se stai costruendo sistemi in cui più cose devono accadere insieme, l’atomicità non è opzionale: è essenziale. Che tu stia spostando denaro tra conti, aggiornando l’inventario o sincronizzando sistemi, l’atomicità assicura che i tuoi dati non finiscano in uno stato rotto o a metà.
Se vuoi approfondire, perché non seguire il nostro corso su Database Design? Imparerai a progettare database in SQL per elaborare, archiviare e organizzare i dati in modo più efficiente.
E se ti interessano articoli e tutorial più pratici sul design dei database, dai un’occhiata alla nostra serie sulla normalizzazione dei database:





L’atomicità è un concetto fondamentale nei sistemi di database. Significa che una transazione deve riuscire completamente oppure non essere eseguita affatto. Se qualcosa fallisce a metà, l’intera operazione viene annullata come se non fosse mai avvenuta.
Perché è così importante, ti chiedi? Immagina di trasferire denaro da un conto bancario a un altro. Premi "Invia", l’app si carica per un secondo e poi qualcosa va storto. Il denaro sparisce dal tuo conto, ma non arriva mai sull’altro. Ora è semplicemente... sparito. È esattamente questo lo scenario che l’atomicità è pensata per prevenire.
Forse hai già sentito parlare di ACID. È un insieme di quattro proprietà chiave che i database usano per evitare che tutto vada in pezzi. L’atomicità è la prima della lista, e a ragione: senza di essa, le altre (Consistenza, Isolamento e Durabilità) contano ben poco.
In questo articolo esploreremo cosa significa atomicità, come funziona e perché è così cruciale nei sistemi di tutti i giorni come banking ed e‑commerce. Vedremo anche come i diversi database la implementano e come puoi progettare sistemi atomici in grado di gestire bene le situazioni quando, inevitabilmente, qualcosa va storto.
Cos’è l’atomicità?
Atomicità significa che una transazione in un database è indivisibile. O viene eseguita fino in fondo, con ogni singolo passaggio che va secondo i piani, oppure non viene eseguita affatto. Non ci sono vie di mezzo. Niente aggiornamenti a metà, niente dati salvati parzialmente, niente strani limbi in cui alcune cose riescono e altre no.
Atomicità nei DBMS. Fonte: Arpit Bhayani
Se una parte della transazione fallisce, l’intera operazione viene annullata come se non fosse mai avvenuta. È questo che rende l’atomicità una protezione così potente. Senza di essa, rischieresti continuamente di lasciare i tuoi dati in uno stato corrotto o incoerente, soprattutto in sistemi in cui più azioni devono avvenire in sequenza.
Vediamo alcuni scenari reali in cui l’atomicità fa (o disfa) il sistema:
Esempio 1: Bonifico bancario
Supponiamo che tu stia trasferendo 100 $ dal tuo conto corrente al tuo conto di risparmio.
La transazione ha due parti:
Senza atomicità, è possibile che il primo passaggio vada a buon fine e il secondo fallisca, magari per un problema di rete o un crash del server. Complimenti, i tuoi soldi sono appena svaniti nel nulla. L’atomicità garantisce che o entrambi i passaggi riescono, oppure nessuno dei due. Se qualcosa va storto, i 100 $ restano esattamente dove erano all’inizio.
Esempio 2: Inventario ed elaborazione ordini
Stai acquistando online l’ultimo vinile in edizione limitata. Il sistema deve:
Senza atomicità, potrebbe ridurre l’inventario ma bloccarsi prima che l’ordine venga confermato. Ora il negozio pensa di essere esaurito, ma nessuno riceve il disco.
Il numero di volte in cui mi succede quando compro qualcosa online è incredibile. Di solito chiudo la scheda e faccio un in bocca al lupo agli ingegneri, ma con ogni probabilità non proverò ad acquistare di nuovo da quel sito. Chissà come gestiranno i miei dati personali se non riescono a garantire l’affidabilità della funzionalità principale di acquisto?
Esempio 3: Sistema di prenotazione voli
Prenotare un volo di solito non è solo scegliere un posto. Il sistema deve:
Se il secondo passaggio fallisce e il terzo va a buon fine, hai pagato per un posto che non esiste. Non il massimo.
Esempio 4: Sincronizzazione tra database e indice di ricerca
Supponiamo che la tua app aggiorni la descrizione di un prodotto nel database principale. Allo stesso tempo, dovrebbe aggiornare l’indice di ricerca così che gli utenti possano trovare il prodotto con la nuova descrizione.
Se l’aggiornamento del database riesce ma quello dell’indice fallisce, gli utenti vedono risultati non aggiornati o non trovano affatto il prodotto.
Perché l’atomicità è importante
Perché l’atomicità è così importante?
Ci sono tantissimi motivi per cui una transazione può essere interrotta. Può esserci un blackout, un crash del server o un timeout di rete a metà. Se l’atomicità non è applicata, quella transazione potrebbe essere completata solo parzialmente. Ora il tuo database resta in uno stato scomodo: alcune modifiche sono andate a buon fine, altre no, e non hai un modo semplice per rimettere a posto il caos.
È qui che i bug sui dati diventano davvero subdoli. Gli utenti potrebbero non notare nulla di strano all’inizio, ma col tempo le cose non tornano più. Le tue analytics sembrano strane, gli ordini spariscono, i conti non tornano o i ticket di supporto schizzano perché le persone non trovano ciò che hanno appena salvato.
L’atomicità previene tutto questo garantendo che:
È anche strettamente legata alle altre proprietà ACID. Senza atomicità, la consistenza va a farsi benedire perché non puoi far rispettare le regole se metà dei dati manca, e l’isolamento si rompe, poiché altri utenti potrebbero vedere dati parziali da una transazione incompleta.
È particolarmente importante se hai a che fare con:
Come funziona l’atomicità nella pratica
Dietro la semplicità del "tutto o niente" si nasconde un sistema sorprendentemente complesso. Quando un database esegue una transazione, traccia attivamente, prepara e protegge ogni passaggio.
Ecco una panoramica di alto livello di cosa succede:
Il ciclo di vita della transazione
Logging e journaling
Per garantire l’atomicità, i database scrivono log di ciò che sta per accadere prima che accada davvero. Questi log sono archiviati separatamente e fungono da piano di backup.
Se il sistema si arresta a metà transazione, può consultare il log e annullare eventuali modifiche incomplete, riapplicare in sicurezza quelle completate e riportare il database a uno stato pulito e coerente.
Questo approccio è talvolta chiamato Write‑Ahead Logging (WAL) o journaling, ed è un elemento chiave del ripristino dopo un crash.
Rollback e ripristino
Quando una transazione fallisce, il database non si limita a mollare, ma annulla con cura le modifiche. Le righe modificate vengono ripristinate al loro stato originale, eventuali lock detenuti dalla transazione vengono rilasciati e i log vengono usati per invertire gli aggiornamenti parziali.
Nel caso di un crash, al riavvio entrano in azione le routine di ripristino. Riproducono i log, risolvono le transazioni non completate e assicurano che il database riparta esattamente da dove si era fermato, senza strani stati a metà.
Prestazioni vs. atomicità
Com’è prevedibile, tutto questo ha un costo. L’atomicità introduce:
Per questo è necessario progettare con cura le transazioni grandi. Se fai troppo in un colpo solo, potresti rallentare l’intero sistema o incorrere in problemi di concorrenza.
Atomicità nei sistemi di database più diffusi
L’atomicità è un concetto centrale in tutti i principali database, ma il modo in cui viene implementata può variare leggermente a seconda del motore di archiviazione sottostante e della filosofia di progettazione. Diamo un’occhiata a come PostgreSQL e MySQL (InnoDB) garantiscono il corretto funzionamento delle transazioni.
PostgreSQL
Prima che qualsiasi dato venga scritto in modo permanente, PostgreSQL crea un write‑ahead log (WAL), cioè il registro di ogni modifica prevista di cui abbiamo parlato in precedenza. Questo log è conservato in sicurezza e viene usato come piano di ripristino nel caso in cui qualcosa vada storto durante la transazione.
Quando una transazione viene eseguita (commit), PostgreSQL controlla il WAL, conferma che tutte le modifiche siano complete e valide, e poi finalizza gli aggiornamenti. Se qualcosa va in crash a metà, il database usa quel log per annullare il lavoro incompleto.
La cosa bella è che tutto questo avviene automaticamente dietro le quinte. Dal punto di vista di uno sviluppatore, è tutto trasparente: scrivi una transazione e PostgreSQL garantisce l’atomicità senza che tu debba gestire alcuna complessità.
Nessuna modifica è visibile ad altri utenti finché la transazione non è completamente confermata. Questo mantiene le cose coerenti ed evita qualsiasi stranezza da "salvataggio a metà" in ambienti multiutente.
WAL in PostgreSQL. Fonte: AlgoMaster
Se vuoi metterti alla prova e creare i tuoi database per testare le transazioni, dai un’occhiata al nostro corso su PostgreSQL.
MySQL (InnoDB)
Anche il motore di archiviazione InnoDB di MySQL supporta transazioni atomiche, e il suo approccio è pensato sia per l’affidabilità sia per le prestazioni.
Come PostgreSQL, InnoDB usa un transaction log per tenere traccia delle modifiche prima di confermarle. Se qualcosa fallisce, il log viene usato per riportare tutto allo stato precedente alla transazione. Questo assicura che nessun aggiornamento parziale passi inosservato.
Una cosa che InnoDB fa particolarmente bene è raggruppare le scritture. Questo aiuta a ridurre l’I/O su disco e migliora le prestazioni, pur proteggendo l’atomicità. Usa anche gli undo log per invertire le modifiche durante un rollback e i redo log per il ripristino dopo un crash.
Proprio come in PostgreSQL, puoi contare sul database per gestire questi meccanismi per te. Non devi scrivere codice personalizzato per il rollback.
Punti chiave per ingegneri e data architect
Ci sono alcune cose da tenere a mente quando lavori con transazioni atomiche nei tuoi progetti. L’idea generale è trattare l’atomicità come predefinita, non come un lusso. Se stai costruendo sistemi che modificano dati in più punti contemporaneamente (cioè praticamente tutti), progettare con l’atomicità in mente ti farà risparmiare tempo, sanità mentale e, potenzialmente, una notifica di incidente alle 3 del mattino.
Scegli il database giusto per il lavoro
Non tutti i database gestiscono l’atomicità allo stesso modo e non tutti i motori di archiviazione sono uguali. Se l’atomicità è fondamentale per il tuo caso d’uso (ad esempio, finanza, logistica, gestione dello stato utente), assicurati che il tuo database supporti transazioni ACID complete. Questo è particolarmente rilevante se usi MySQL, dove la scelta del motore di archiviazione conta.
Progetta per il fallimento
Dai per scontato che qualcosa andrà storto, perché succederà. Incapsula le operazioni multi‑step in transazioni e gestisci correttamente gli errori. Sii esplicito con le istruzioni
BEGIN,COMMIT, eROLLBACK, oppure usa framework che le gestiscono in sicurezza sotto il cofano.La maggior parte degli ORM moderni e dei livelli di accesso ai dati offre supporto integrato alle transazioni. Per esempio:
In Node.js, librerie come Prisma e TypeORM ti permettono di incapsulare la logica in una chiamata
transaction()che gestisce commit/rollback dietro le quinte.In Python, SQLAlchemy offre context manager (with
session.begin():) che garantiscono commit e rollback sicuri.In Java, framework come Spring ti permettono di annotare i metodi con
@Transactional, così il database gestisce tutto in modo atomico, anche su più chiamate di funzione.Questi strumenti rendono molto più facile costruire in sicurezza per impostazione predefinita. Riducano il rischio di dimenticare un rollback o gestire male la logica di commit, soprattutto quando la tua app diventa più complessa.
Bilancia prestazioni e affidabilità
L’atomicità comporta un certo overhead, soprattutto nelle transazioni grandi. Suddividi le operazioni massive quando possibile, evita di bloccare intere tabelle e mantieni le transazioni brevi e mirate. Le transazioni di lunga durata aumentano il rischio di contesa, deadlock e utenti insoddisfatti.
Comprendi dipendenze e isolamento
Come abbiamo visto, l’atomicità non esiste nel vuoto ma insieme a consistenza e isolamento. Assicurati che le modifiche correlate avvengano insieme e considera come le transazioni concorrenti potrebbero interagire. Usa livelli di isolamento adatti al tuo carico senza complicare troppo le cose.
Proprietà ACID nei DBMS. Fonte: Datacamp
Testa con scenari realistici di errore
Non testare solo gli happy path. Simula cosa succede quando la tua app si arresta a metà transazione o quando una query va in timeout. Puoi usare failpoint o simulare errori del DB per vedere come si comporta il tuo sistema sotto pressione.
Conclusione
Se stai costruendo sistemi in cui più cose devono accadere insieme, l’atomicità non è opzionale: è essenziale. Che tu stia spostando denaro tra conti, aggiornando l’inventario o sincronizzando sistemi, l’atomicità assicura che i tuoi dati non finiscano in uno stato rotto o a metà.
Se vuoi approfondire, perché non seguire il nostro corso su Database Design? Imparerai a progettare database in SQL per elaborare, archiviare e organizzare i dati in modo più efficiente.
E se ti interessano articoli e tutorial più pratici sul design dei database, dai un’occhiata alla nostra serie sulla normalizzazione dei database: