
{count, plural, one {कोर्स} other {कोर्स}}
Databricks में डेटा मैनेजमेंट
{hours} घंटा
6.8K
एटॉमिकिटी डेटाबेस सिस्टम्स का एक मूलभूत सिद्धांत है। इसका मतलब है कि कोई भी ट्रांज़ैक्शन या तो पूरी तरह सफल होना चाहिए या फिर बिल्कुल नहीं चलना चाहिए। अगर बीच में कुछ भी असफल हो जाए, तो पूरी प्रक्रिया ऐसे वापस पलट दी जाती है जैसे वह हुई ही नहीं थी।
यह इतना महत्वपूर्ण क्यों है, आप पूछेंगे? कल्पना कीजिए कि आप एक बैंक खाते से दूसरे में पैसे ट्रांसफ़र कर रहे हैं। आप "Send" दबाते हैं, ऐप एक सेकंड लोड होता है, और फिर कुछ गड़बड़ हो जाती है। पैसे आपके खाते से निकल जाते हैं, लेकिन दूसरे खाते में कभी पहुँचते ही नहीं। अब वे बस... गायब। ठीक इसी स्थिति को रोकने के लिए एटॉमिकिटी बनाई गई है।
आपने पहले ACID के बारे में सुना होगा। यह चार प्रमुख गुणों का सेट है जिसका उपयोग डेटाबेस यह सुनिश्चित करने के लिए करते हैं कि चीजें बिखरें नहीं। एटॉमिकिटी इस सूची में सबसे पहले आती है, और वह भी अच्छे कारण से: इसके बिना बाकी (Consistency, Isolation और Durability) का महत्व काफी कम हो जाता है।
इस लेख में, हम देखेंगे कि एटॉमिकिटी का क्या अर्थ है, यह कैसे काम करती है, और बैंकिंग तथा ई-कॉमर्स जैसे रोज़मर्रा के सिस्टम्स में यह इतनी महत्वपूर्ण क्यों है। हम यह भी देखेंगे कि अलग-अलग डेटाबेस इसे कैसे लागू करते हैं, और आप ऐसे एटॉमिक सिस्टम कैसे डिज़ाइन कर सकते हैं जो गड़बड़ होने पर भी चीजों को ठीक से संभाल सकें।
एटॉमिकिटी का मतलब है कि डेटाबेस में एक ट्रांज़ैक्शन अविभाज्य होता है। यह या तो पूरी तरह चलकर पूरा होता है, जहाँ हर चरण योजना के मुताबिक होता है, या फिर बिल्कुल नहीं चलता। बीच का कोई रास्ता नहीं। न आधे-अधूरे अपडेट, न आंशिक डेटा सेव, न ऐसा अजीब लिंबो जहाँ कुछ चीजें सफल हों और कुछ न हों।
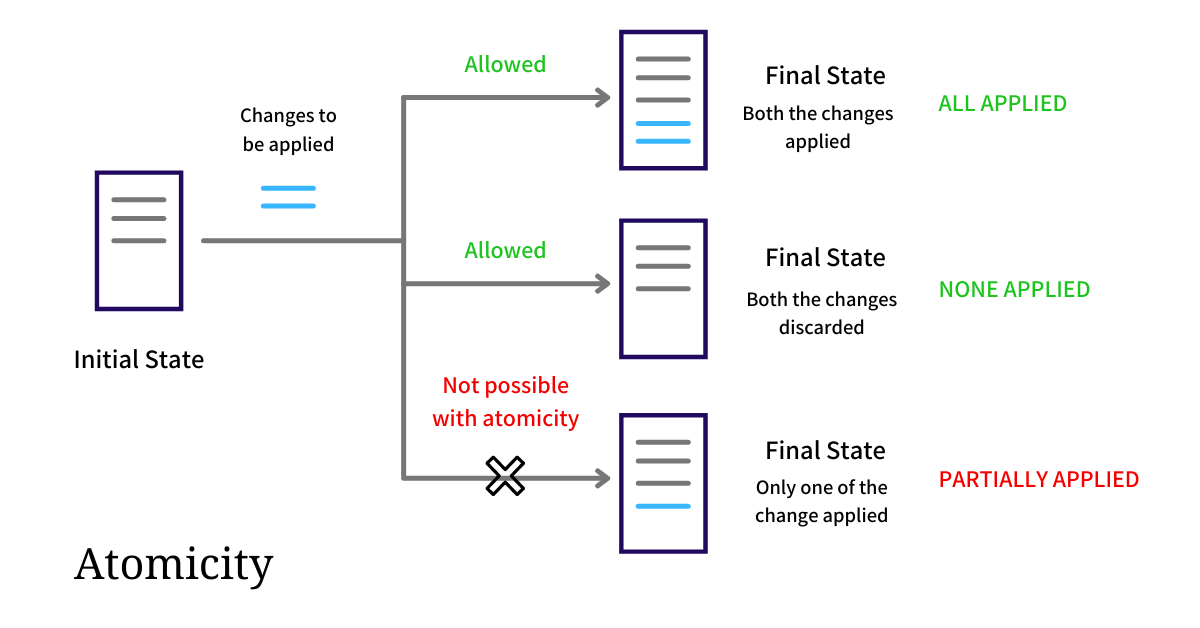
DBMS में एटॉमिकिटी। स्रोत: Arpit Bhayani
यदि ट्रांज़ैक्शन का कोई भाग विफल हो जाता है, तो पूरी प्रक्रिया ऐसे रोल बैक कर दी जाती है जैसे कुछ हुआ ही नहीं। यही एटॉमिकिटी को इतना शक्तिशाली सुरक्षा कवच बनाता है। इसके बिना, आपका डेटा बार-बार भ्रष्ट या असंगत स्थिति में रहने का जोखिम उठाता रहेगा, खासकर ऐसे सिस्टम्स में जहाँ कई चीजें क्रम से होनी होती हैं।
आइए कुछ वास्तविक जीवन की स्थितियाँ देखें जहाँ एटॉमिकिटी सिस्टम को बना या बिगाड़ सकती है:
मान लीजिए आप अपने चेकिंग अकाउंट से सेविंग्स अकाउंट में $100 ट्रांसफ़र कर रहे हैं।
ट्रांज़ैक्शन के दो भाग हैं:
एटॉमिकिटी के बिना, संभव है कि पहला चरण पूरा हो जाए और दूसरा विफल हो जाए, शायद नेटवर्क गड़बड़ी या सर्वर क्रैश की वजह से। बधाई हो, आपका पैसा शून्य में विलीन हो गया। एटॉमिकिटी यह सुनिश्चित करती है कि या तो दोनों चरण सफल हों, या दोनों न हों। अगर कुछ गलत होता है, तो $100 वहीं रहता है जहाँ शुरुआत में था।
आप ऑनलाइन आख़िरी लिमिटेड-एडिशन विनाइल रिकॉर्ड खरीद रहे हैं। सिस्टम को ये करना है:
एटॉमिकिटी न होने पर, इन्वेंट्री घट सकती है, लेकिन ऑर्डर कन्फर्म होने से पहले सिस्टम क्रैश हो सकता है। अब स्टोर को लगता है कि स्टॉक खत्म है, लेकिन किसी को रिकॉर्ड मिला ही नहीं।
मेरे साथ ऑनलाइन खरीदारी करते समय यह जितनी बार होता है, हैरान कर देने वाला है। मैं आमतौर पर टैब बंद कर देता/देती हूँ और उनके इंजीनियरों को शुभकामनाएँ देता/देती हूँ, लेकिन संभवतः भविष्य में उस वेबसाइट से फिर कोशिश नहीं करूँगा/करूँगी। अगर वे अपनी मुख्य ख़रीदारी सुविधा को भरोसेमंद नहीं बना सकते, तो कौन जाने वे मेरी निजी जानकारी को कैसे संभालेंगे?
फ़्लाइट बुक करना आमतौर पर सिर्फ़ सीट चुनना नहीं होता। सिस्टम को ये करना होता है:
अगर दूसरा चरण विफल हो जाए और तीसरा सफल हो जाए, तो आपने ऐसी सीट के लिए भुगतान कर दिया जो अस्तित्व में ही नहीं। आदर्श तो नहीं।
मान लीजिए आपकी ऐप मुख्य डेटाबेस में किसी प्रोडक्ट का विवरण अपडेट करती है। साथ ही, उसे सर्च इंडेक्स भी अपडेट करना चाहिए ताकि उपयोगकर्ता नए विवरण के साथ प्रोडक्ट ढूँढ़ सकें।
यदि डेटाबेस अपडेट सफल हो जाए लेकिन इंडेक्स अपडेट विफल हो जाए, तो उपयोगकर्ता पुराने नतीजे देखते हैं, या प्रोडक्ट मिल ही नहीं पाता।
तो एटॉमिकिटी इतनी बड़ी बात क्यों है?
ट्रांज़ैक्शन रुकने के असंख्य कारण हो सकते हैं। बिजली चली जाए, सर्वर क्रैश हो जाए, या बीच में नेटवर्क टाइमआउट हो जाए। अगर एटॉमिकिटी लागू नहीं होती, तो ट्रांज़ैक्शन केवल आंशिक रूप से पूरा हो सकता है। अब आपका डेटाबेस एक अटपटी स्थिति में रह जाता है: कुछ बदलाव लागू हो गए, कुछ नहीं हुए, और आपके पास गड़बड़ी को आसानी से उलटने का तरीका नहीं है।
यहीं से डेटा बग बहुत चालाकी से सामने आते हैं। उपयोगकर्ता शुरू में कुछ गलत महसूस नहीं करते, लेकिन समय के साथ चीजें मेल खाना बंद कर देती हैं। आपकी एनालिटिक्स अजीब लगती है, ऑर्डर गायब हो जाते हैं, खाते संतुलित नहीं रहते, या सपोर्ट टिकट बढ़ जाते हैं क्योंकि लोग वह नहीं ढूँढ़ पाते जो उन्होंने अभी-अभी सेव किया था।
एटॉमिकिटी यह सब रोकती है यह सुनिश्चित करके कि:
यह ACID के अन्य गुणों से भी गहराई से जुड़ी है। एटॉमिकिटी के बिना, consistency दरक जाती है क्योंकि आप नियम लागू नहीं कर सकते जब आधा डेटा गायब हो, और isolation टूट जाता है, क्योंकि अन्य उपयोगकर्ता अधूरे ट्रांज़ैक्शन से आंशिक डेटा देख सकते हैं।
यह विशेष रूप से महत्वपूर्ण है यदि आप निम्न से निपट रहे हैं:
"सब या कुछ नहीं" की सादगी के पीछे एक काफ़ी जटिल प्रणाली होती है। जब डेटाबेस कोई ट्रांज़ैक्शन निष्पादित करता है, तो वह हर चरण को सक्रिय रूप से ट्रैक, तैयार और सुरक्षित करता है।
यहाँ ऊपरी स्तर पर देखें तो क्या हो रहा है:
एटॉमिकिटी सुनिश्चित करने के लिए, डेटाबेस यह लिखते हैं कि क्या होने वाला है, वास्तविक रूप से होने से पहले। ये लॉग अलग से स्टोर किए जाते हैं और बैकअप प्लान की तरह काम करते हैं।
अगर सिस्टम ट्रांज़ैक्शन के बीच में क्रैश हो जाए, तो वह लॉग का संदर्भ लेकर किसी भी अधूरे बदलाव को रोल बैक कर सकता है, पूर्ण हुए परिवर्तनों को सुरक्षित रूप से फिर लागू कर सकता है, और डेटाबेस को साफ़-सुथरी, सुसंगत स्थिति में बहाल कर सकता है।
इस दृष्टिकोण को कभी-कभी Write-Ahead Logging (WAL) या जर्नलिंग कहा जाता है, और यह क्रैश रिकवरी का एक प्रमुख हिस्सा है।
जब कोई ट्रांज़ैक्शन विफल होता है, तो डेटाबेस हार मानकर नहीं बैठता, बल्कि सावधानी से बदलावों को उलटता है। संशोधित पंक्तियाँ अपनी मूल स्थिति में लौटाई जाती हैं, ट्रांज़ैक्शन द्वारा पकड़े गए किसी भी लॉक को रिलीज़ किया जाता है, और आंशिक अपडेट को उलटने के लिए लॉग्स का उपयोग होता है।
क्रैश के मामले में, रिस्टार्ट के समय रिकवरी रूटीन सक्रिय हो जाते हैं। वे लॉग्स को रीप्ले करते हैं, अधूरे ट्रांज़ैक्शंस का निपटारा करते हैं, और सुनिश्चित करते हैं कि डेटाबेस वहीं से आगे बढ़े जहाँ से वह रुका था, बिना किसी अजीब आधी-अधूरी स्थिति के।
हैरानी नहीं कि इसका एक मूल्य भी है। एटॉमिकिटी निम्न बातें लाती है:
इसीलिए बड़े ट्रांज़ैक्शंस को सोच-समझकर डिज़ाइन करने की ज़रूरत होती है। यदि आप एक ही बार में बहुत कुछ कर देते हैं, तो आप पूरे सिस्टम को धीमा कर सकते हैं या concurrency संबंधी समस्याओं में फँस सकते हैं।
एटॉमिकिटी सभी प्रमुख डेटाबेस में एक मुख्य सिद्धांत है, लेकिन इसे लागू करने का तरीका अंतर्निहित स्टोरेज इंजन और डिज़ाइन फिलॉसफ़ी पर थोड़ा-बहुत निर्भर करता है। आइए देखें कि PostgreSQL और MySQL (InnoDB) यह कैसे सुनिश्चित करते हैं कि ट्रांज़ैक्शंस सही तरह से काम करें।
किसी भी डेटा को स्थायी रूप से लिखने से पहले, PostgreSQL एक write-ahead log (WAL) बनाता है—हर प्रस्तावित परिवर्तन का रिकॉर्ड, जिसके बारे में हमने पहले बात की। यह लॉग सुरक्षित रूप से स्टोर होता है और ट्रांज़ैक्शन के दौरान कुछ भी गलत होने पर रिकवरी प्लान के रूप में काम आता है।
जब ट्रांज़ैक्शन कमिट होता है, PostgreSQL WAL की जाँच करता है, पक्का करता है कि सभी बदलाव पूरे और वैध हैं, और फिर अपडेट्स को अंतिम रूप देता है। अगर बीच में कुछ क्रैश हो जाए, तो डेटाबेस उसी लॉग का उपयोग करके अधूरे काम को रोल बैक करता है।
अच्छी बात यह है कि यह सब पर्दे के पीछे अपने-आप होता है। डेवलपर के नज़रिये से यह सहज है: आप ट्रांज़ैक्शन लिखते हैं, और PostgreSQL एटॉमिकिटी की गारंटी देता है, बिना यह जटिलता आपको सँभालनी पड़े।
ट्रांज़ैक्शन के पूर्ण रूप से कमिट होने तक दूसरे उपयोगकर्ताओं को कोई बदलाव दिखता नहीं। इससे चीज़ें सुसंगत रहती हैं और मल्टी-यूज़र माहौल में "आधा-सेव" जैसी अटपटी स्थितियाँ नहीं बनतीं।
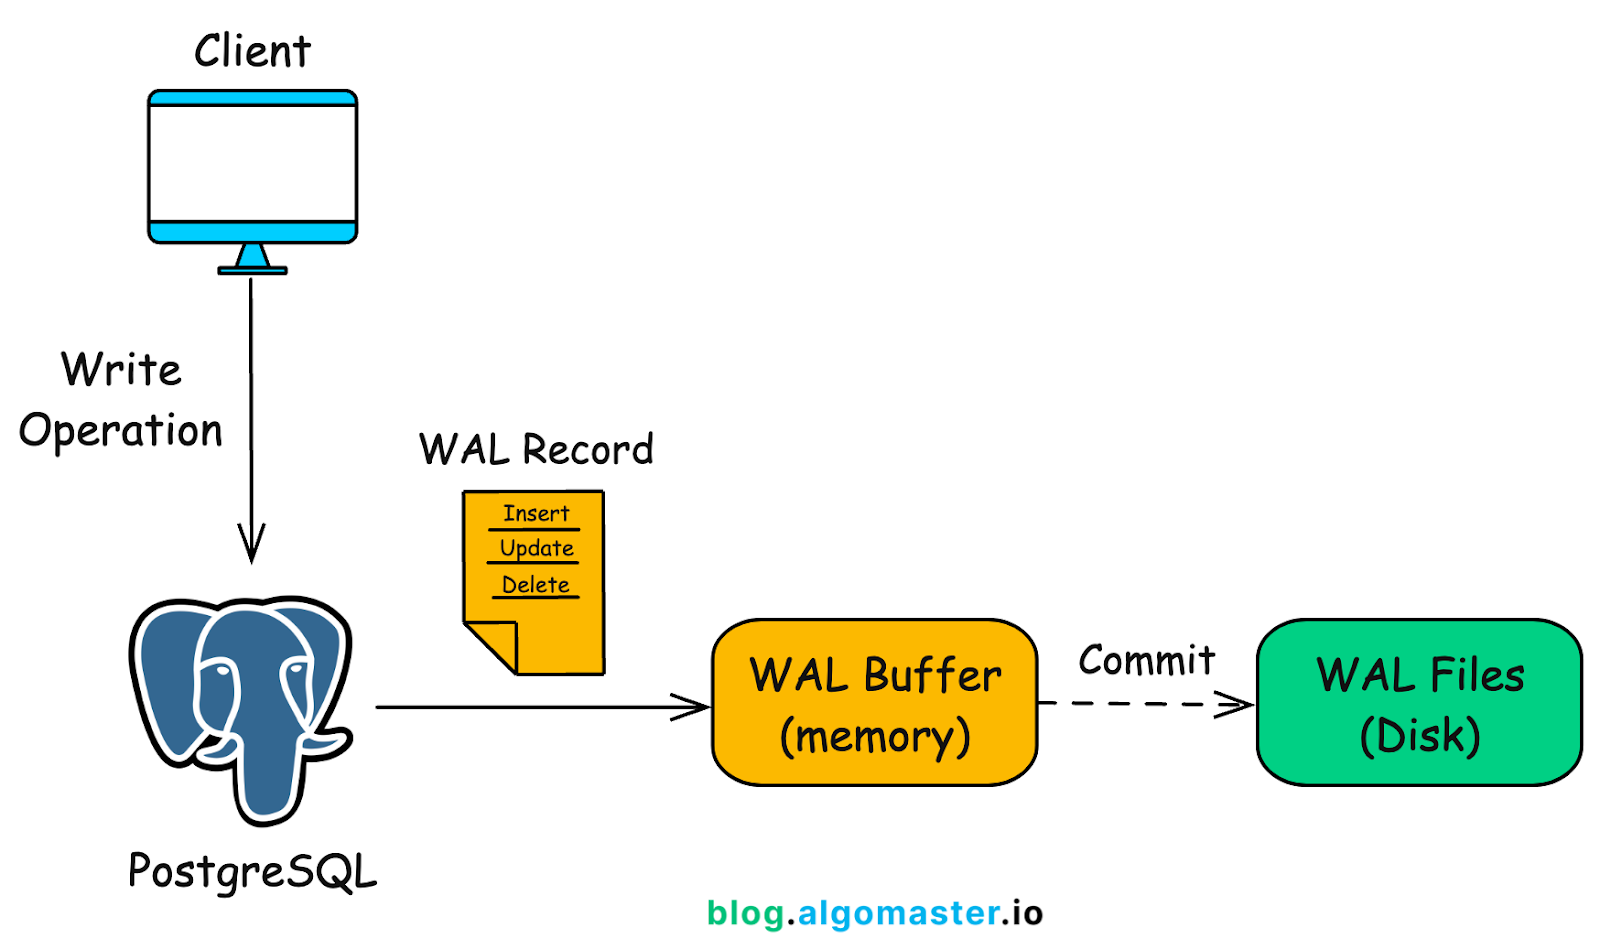
PostgreSQL WAL. स्रोत: AlgoMaster
यदि आप स्वयं हाथ गंदे कर के ट्रांज़ैक्शंस को परखने के लिए अपने डेटाबेस बनाना चाहते हैं, तो हमारे PostgreSQL कोर्स पर नज़र डालें।
MySQL का InnoDB स्टोरेज इंजन भी एटॉमिक ट्रांज़ैक्शंस को सपोर्ट करता है, और इसका दृष्टिकोण विश्वसनीयता व प्रदर्शन—दोनों के लिए बनाया गया है।
PostgreSQL की तरह, InnoDB भी कमिट करने से पहले परिवर्तनों को ट्रैक करने के लिए ट्रांज़ैक्शन लॉग का इस्तेमाल करता है। अगर कुछ विफल हो जाए, तो लॉग का उपयोग करके सबकुछ ट्रांज़ैक्शन-पूर्व स्थिति में रोल बैक कर दिया जाता है। इससे कोई आंशिक अपडेट दबे-पाँव अंदर नहीं घुस पाता।
InnoDB एक काम खास तौर पर अच्छा करता है—लिखावटों को समूहित करना। इससे डिस्क I/O कम होता है और प्रदर्शन बेहतर होता है, जबकि एटॉमिकिटी भी सुरक्षित रहती है। यह रोल बैक के दौरान बदलाव उलटने के लिए undo logs और क्रैश रिकवरी के लिए redo logs का भी इस्तेमाल करता है।
PostgreSQL की ही तरह, आप इन तंत्रों को सँभालने के लिए डेटाबेस पर भरोसा कर सकते हैं। आपको कोई कस्टम रोल बैक कोड लिखने की ज़रूरत नहीं।
अपने प्रोजेक्ट्स में एटॉमिक ट्रांज़ैक्शंस के साथ काम करते समय कुछ बातें ध्यान में रखना ज़रूरी है। व्यापक विचार यह है कि एटॉमिकिटी को डिफ़ॉल्ट मानें, विलासिता नहीं। यदि आप ऐसे सिस्टम बना रहे हैं जो एक समय में एक से अधिक स्थानों पर डेटा संशोधित करते हैं (यानी लगभग सभी), तो एटॉमिकिटी को ध्यान में रखकर डिज़ाइन करना आपका समय, धैर्य और संभवतः 3 बजे रात का इन्सिडेंट अलर्ट—सब बचा देगा।
सभी डेटाबेस एटॉमिकिटी को एक ही तरह से नहीं संभालते, और सभी स्टोरेज इंजन समान नहीं होते। यदि आपके उपयोग-प्रकरण में एटॉमिकिटी अत्यावश्यक है (उदा., वित्त, लॉजिस्टिक्स, यूज़र स्टेट मैनेजमेंट), तो सुनिश्चित करें कि आपका डेटाबेस पूर्ण ACID ट्रांज़ैक्शंस को सपोर्ट करता है। यह विशेष रूप से तब प्रासंगिक है जब आप MySQL का उपयोग कर रहे हैं, जहाँ स्टोरेज इंजन का चुनाव मायने रखता है।
मानकर चलें कि चीजें गलत होंगी—क्योंकि होंगी। बहु-चरणीय ऑपरेशंस को ट्रांज़ैक्शंस में लपेटें और त्रुटियों को सही तरह संभालें। अपने BEGIN, COMMIT, और ROLLBACK स्टेटमेंट्स के साथ स्पष्ट रहें, या ऐसे फ्रेमवर्क का उपयोग करें जो इन्हें सुरक्षित रूप से पर्दे के पीछे सँभालते हैं।
अधिकांश आधुनिक ORM और डेटा एक्सेस लेयर में ट्रांज़ैक्शन सपोर्ट बिल्ट-इन होता है। उदाहरण के लिए:
Node.js में, Prisma और TypeORM जैसी लाइब्रेरीज़ आपको लॉजिक को transaction() कॉल में रैप करने देती हैं, जो पर्दे के पीछे कमिट/रोल बैक सँभालती है।
Python में, SQLAlchemy कॉन्टेक्स्ट मैनेजर्स (with session.begin():) देता है जो सुरक्षित कमिट्स और रोल बैक्स सुनिश्चित करते हैं।
Java में, Spring जैसे फ्रेमवर्क आपको मेथड्स को @Transactional से एनोटेट करने देते हैं, ताकि डेटाबेस सबकुछ एटॉमिक रूप से संभाले—यहाँ तक कि कई फ़ंक्शन कॉल्स में भी।
ये टूल्स डिफ़ॉल्ट रूप से सुरक्षित निर्माण करना बहुत आसान बना देते हैं। वे रोल बैक भूल जाने या कमिट लॉजिक गलत सँभालने के जोखिम को कम करते हैं, खासकर जब आपकी ऐप अधिक जटिल हो जाती है।
एटॉमिकिटी कुछ ओवरहेड के साथ आती है, विशेषकर बड़े ट्रांज़ैक्शंस में। जहाँ संभव हो, अत्यधिक बड़े ऑपरेशंस को तोड़ें, पूरी टेबल्स को लॉक करने से बचें, और ट्रांज़ैक्शंस को छोटा और केंद्रित रखें। लंबे समय तक चलने वाले ट्रांज़ैक्शंस से contention, deadlocks, और असंतुष्ट उपयोगकर्ताओं का जोखिम बढ़ता है।
जैसा कि हमने देखा, एटॉमिकिटी शून्य में नहीं, बल्कि consistency और isolation के साथ मिलकर काम करती है। सुनिश्चित करें कि संबंधित बदलाव साथ-साथ हों, और यह भी सोचें कि समवर्ती ट्रांज़ैक्शंस कैसे परस्पर क्रिया कर सकते हैं। ऐसे isolation स्तरों का उपयोग करें जो आपके वर्कलोड के अनुकूल हों, बिना चीजों को अनावश्यक रूप से जटिल बनाए।
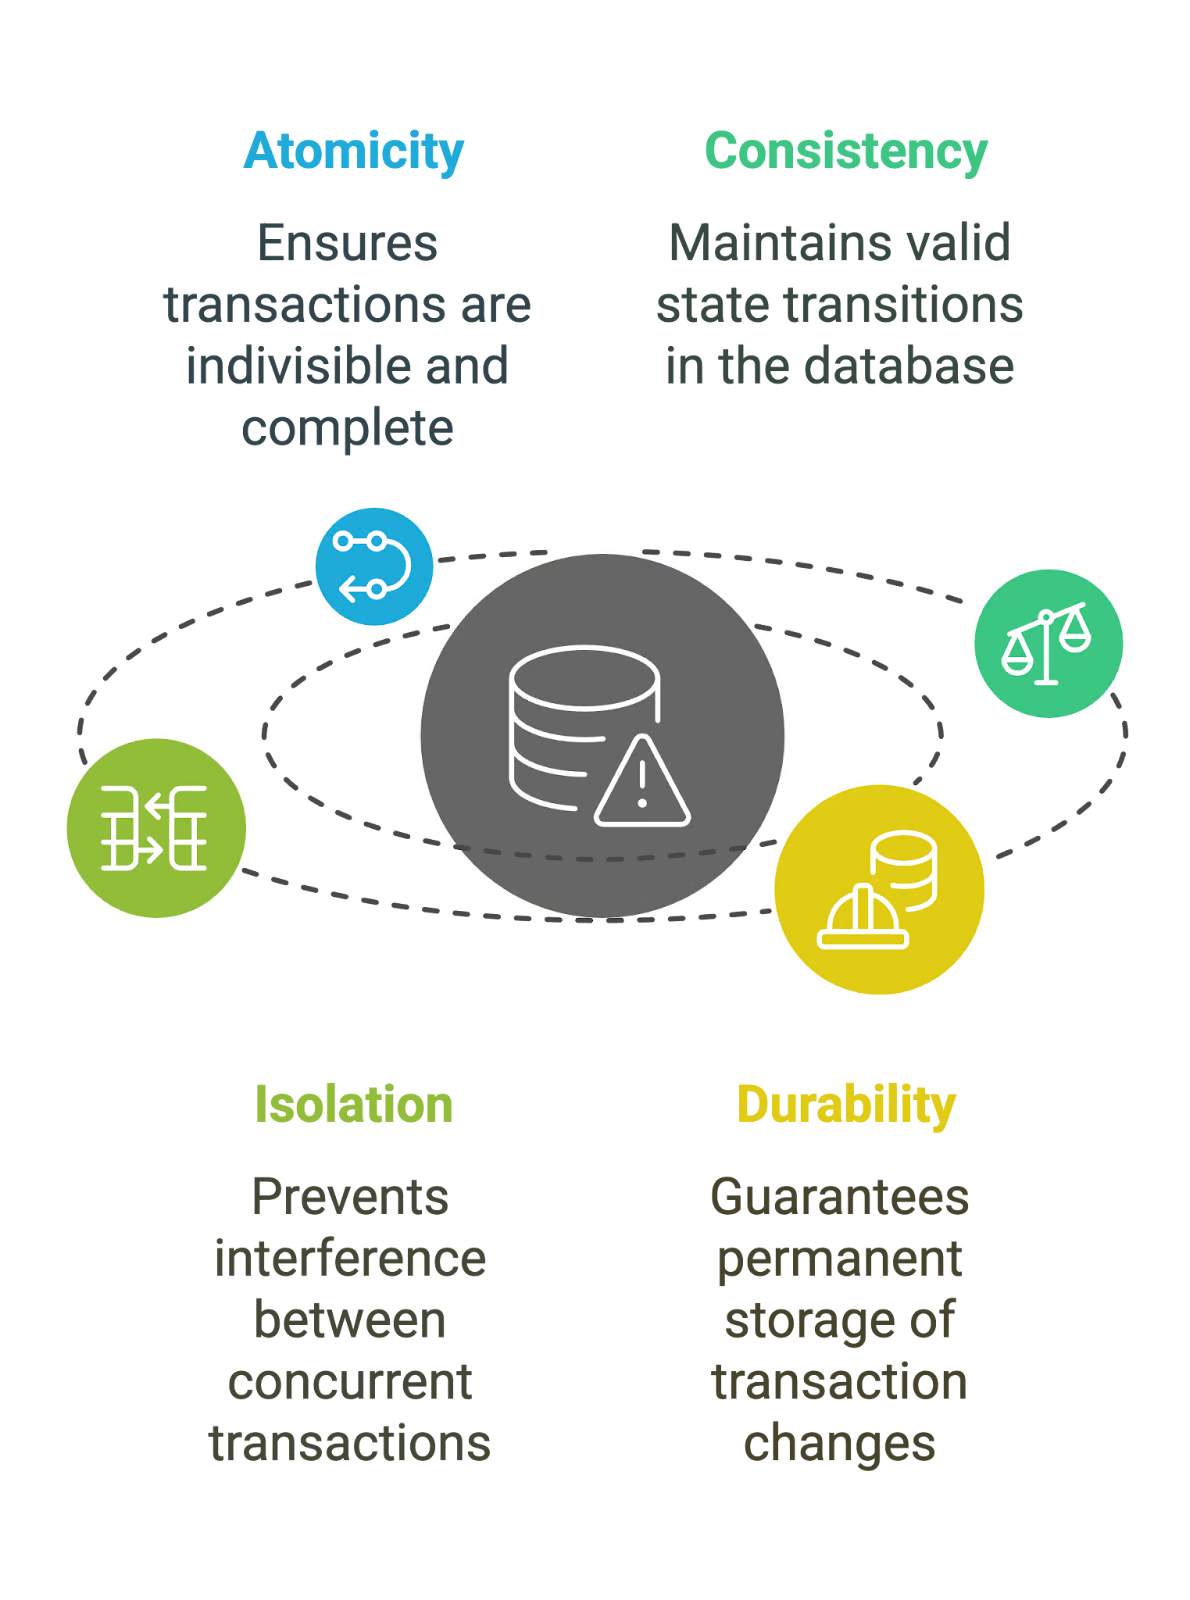
DBMS में ACID गुण। स्रोत: Datacamp
सिर्फ़ खुशहाल रास्तों का परीक्षण न करें। यह सिम्युलेट करें कि आपकी ऐप ट्रांज़ैक्शन के बीच में क्रैश हो जाए तो क्या होता है, या जब कोई क्वेरी टाइमआउट हो जाए तो क्या होता है। आप फेलपॉइंट्स का उपयोग कर सकते हैं या DB विफलताओं को मॉक कर सकते हैं ताकि देखें कि दबाव में आपका सिस्टम कैसा व्यवहार करता है।
यदि आप ऐसे सिस्टम बना रहे हैं जहाँ कई चीजें साथ में होनी होती हैं, तो एटॉमिकिटी वैकल्पिक नहीं, अनिवार्य है। चाहे आप खातों के बीच धनांतरित कर रहे हों, इन्वेंट्री अपडेट कर रहे हों, या सिस्टम्स को सिंक कर रहे हों—एटॉमिकिटी यह सुनिश्चित करती है कि आपका डेटा टूटी-फूटी या आधी-अधूरी स्थिति में न पहुँचे।
यदि आप और गहराई में जाना चाहते हैं, तो हमारा Database Design कोर्स क्यों न करें? आप SQL में डेटाबेस डिज़ाइन करना सीखेंगे ताकि डेटा को अधिक कुशल तरीके से प्रोसेस, स्टोर और ऑर्गनाइज़ किया जा सके।
और यदि आप अधिक व्यावहारिक डेटाबेस डिज़ाइन लेखों और ट्यूटोरियल्स में रुचि रखते हैं, तो हमारी डेटाबेस नॉर्मलाइज़ेशन श्रृंखला देखें:
DataCamp के साथ डेटा इंजीनियरिंग सीखें
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}