
Last chance! 50% off DataCamp Premium
Sale ends in
Sincronizzare i repository locali con i rispettivi remoti è un aspetto fondamentale del lavoro con Git.
Due comandi spesso confusi quando si accede al codice in remoto sono git fetch e git pull. Anche se sembrano simili, le loro differenze hanno implicazioni significative per il code review, la gestione dei branch e la produttività complessiva del team.
In questo articolo vedremo cosa fa ciascuna funzione, alcuni esempi e anche alcune best practice per usarle. Se stai ancora imparando Git, ti consiglio di dare un'occhiata al nostro percorso di competenze Git Fundamentals.
Pur essendo correlati, i comandi differiscono sia nel comportamento sia nell'intento.
Confrontiamoli nella tabella qui sotto:
|
Differenze |
Git Fetch |
Git Pull |
|
Scopo |
Aggiorna solo i branch di tracciamento remoto |
Aggiorna i branch di tracciamento remoto e integra nel branch corrente |
|
Effetto sulla working directory |
Nessuna modifica ai file |
Le modifiche vengono applicate subito ai file nel branch di lavoro |
|
Sicurezza |
Sicuro; le modifiche non vengono unite automaticamente |
Meno sicuro; può generare conflitti di merge immediatamente |
|
Controllo |
Dà all'utente pieno controllo su quando e come fare il merge |
Automatizza l'integrazione; meno decisioni manuali |
|
Impatto sulla storia |
Mantiene la storia pulita finché il merge non è eseguito |
Può aggiungere commit di merge (con merge) o riscrivere la cronologia locale (con rebase) |
|
Casi d'uso comuni |
Code review, pianificazione dell'integrazione, sincronizzazione sicura |
Aggiornamenti rapidi, pipeline CI/CD, ambienti affidabili |
Come vedi, i comandi differiscono sia nel comportamento sia nell'intento:
git fetch aggiorna solo i riferimenti di tracciamento remoto, lasciando intatto il tuo branch di lavoro.git pull aggiorna i riferimenti di tracciamento remoto e li integra subito nel branch corrente.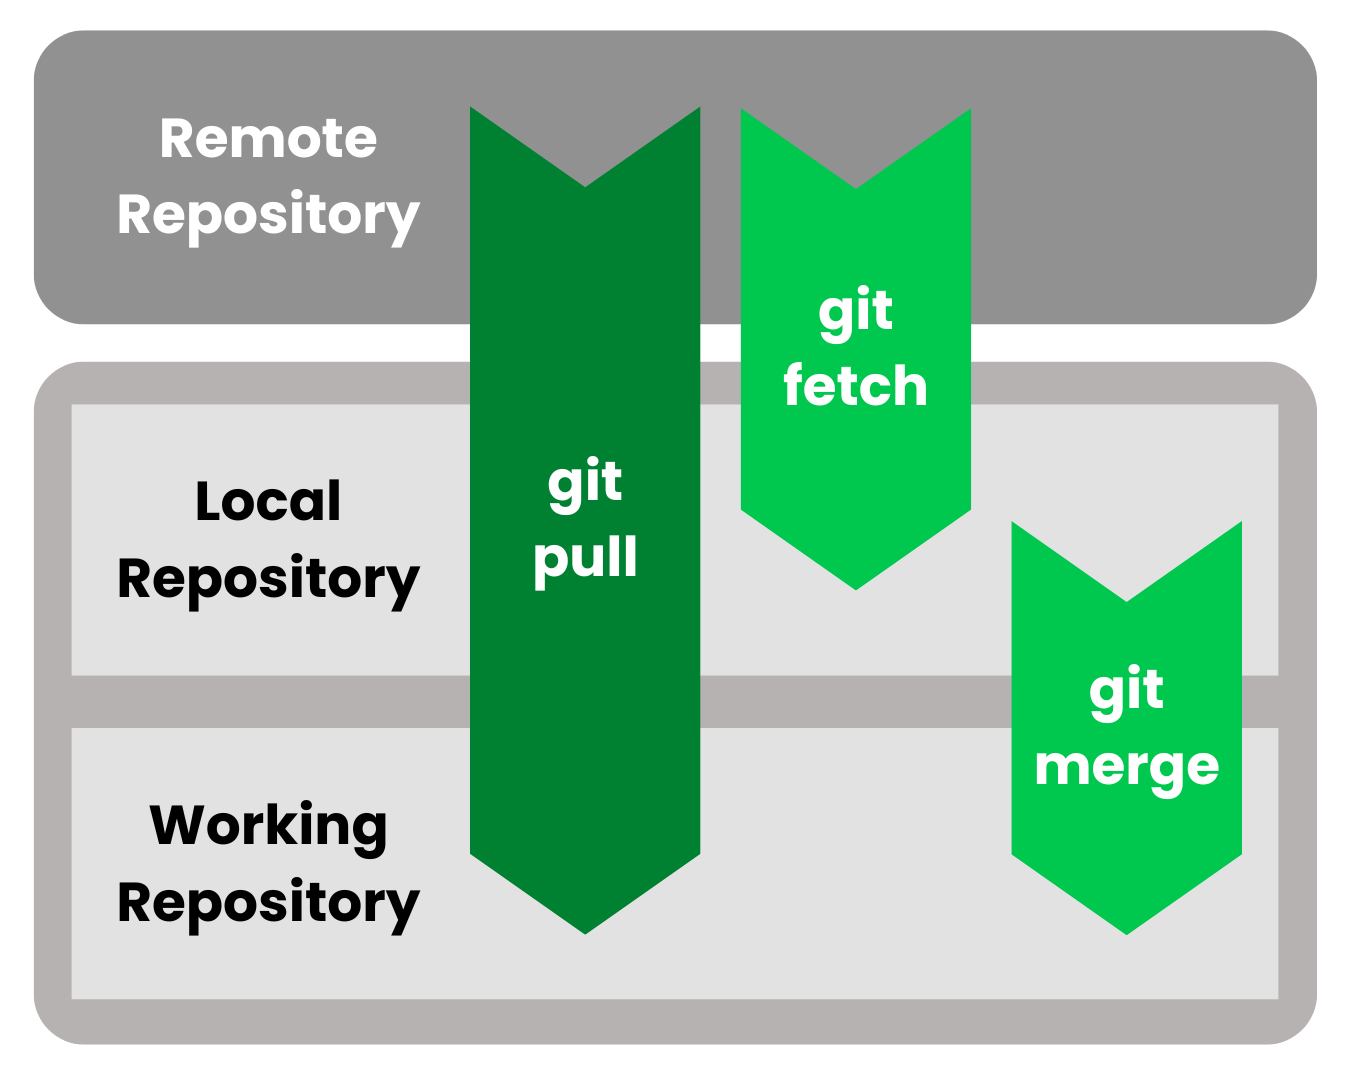
Come mostrato nel flusso visivo sopra, le differenze tra fetch e pull riguardano dove fluisce il tuo codice.
In sintesi:
origin/main). Il tuo main locale resta invariato, dandoti visibilità sugli aggiornamenti senza interruzioni.Per apprezzare appieno git fetch e git pull, dobbiamo comprendere la struttura interna di Git e i livelli in gioco.
Git è fondamentalmente un sistema di controllo versione distribuito, il che significa che ogni sviluppatore ha una copia completa del repository, inclusi cronologia, branch e tag.
Questa architettura consente di lavorare in modo indipendente da un server centrale, rendendo comandi come fetch e pull i ponti che mantengono sincronizzati gli ambienti distribuiti.
I repository Git operano su più livelli:
.git che contiene il database di tutti i commit, i branch, i tag e la configurazione. È interamente locale e non cambia a meno che tu non faccia commit o sincronizzi esplicitamente.Questi livelli funzionano in modo indipendente, il che significa che la sincronizzazione con un remoto non influisce immediatamente sulla tua working directory.
Le modifiche si propagano invece gradualmente in quest'ordine:
remote → branch di tracciamento remoto → repository locale → working directory.
I branch di tracciamento remoto sono riferimenti speciali che rappresentano lo stato dei branch nel repository remoto.
Per esempio, origin/main indica dove si trovava il branch main sul remoto origin l'ultima volta che hai eseguito fetch.
Funzionano come segnalibri, permettendoti di:
git fetch, Git aggiorna questi branch di tracciamento remoto.Questa separazione significa che puoi osservare e analizzare gli aggiornamenti prima che influenzino il tuo lavoro di sviluppo reale. Puoi saperne di più nel nostro tutorial su Git remote.
git fetch recupera commit, branch e tag da un repository remoto e aggiorna i tuoi branch di tracciamento remoto senza alterare il branch corrente o i file di lavoro.
Pensalo come "scaricare la mappa più aggiornata del repository remoto" senza entrare nel nuovo territorio.
È particolarmente utile per chi vuole visibilità sull'attività remota senza rischiare modifiche indesiderate al proprio lavoro.
Il comando si usa nel terminale bash o nell'interfaccia a riga di comando (CLI). Ecco alcuni dettagli di sintassi a cui fare attenzione:
Comandi fetch comuni:
# Fetch all remotes
git fetch --all

# Fetch only one branch
git fetch origin main

# Fetch and prune stale references
git fetch --prune

# Fetch a specific tag
git fetch origin tag v1.2.0
Ecco la spiegazione di ciascun comando e delle rispettive opzioni:
--all fa sì che vengano aggiornati tutti i remoti configurati, utile in setup con più remoti.git fetch origin main è efficiente se ti interessa solo un flusso di lavoro.--prune rimuove i branch di tracciamento remoto obsoleti che non esistono più sul server, mantenendo pulito l'ambiente.git fetch origin tag è utile nei workflow di rilascio in cui i commit taggati contano più dei branch completi.Gli sviluppatori usano git fetch in vari scenari in cui contano visibilità e controllo. Per esempio:
origin/main con il tuo branch locale per preparare merge o rebase.git pull è più aggressivo di fetch perché scarica le modifiche e tenta subito di integrarle nel tuo branch corrente.
Questo significa che il comando git pull è una combinazione dei comandi git fetch e git merge.
Per impostazione predefinita, l'integrazione è un merge, ma può essere configurata per usare il rebase. Comodo, questo comando presuppone che tu voglia applicare subito gli aggiornamenti remoti.
È il comando di riferimento per chi privilegia velocità e sincronizzazione immediata.
Vediamo ora la sintassi di utilizzo di questo comando.
Ecco alcuni esempi:
# Default fetch + merge
git pull origin main

# Fetch + rebase for cleaner history
git pull --rebase origin main

# Pull all changes from default remote
git pull

# Pull with fast-forward only (avoids merge commits)
git pull --ff-only
Ecco la spiegazione del codice sopra:
--rebase, Git riapplica i tuoi commit locali sopra il branch remoto, creando una storia più pulita e lineare.--ff-only garantisce l'avanzamento fast-forward del branch senza merge non necessari, spesso desiderabile per workflow puliti.In Git, "fast-forward" si riferisce a un tipo specifico di operazione di merge che si verifica quando il branch in cui stai facendo il merge non è divergente rispetto al branch da cui stai facendo il merge.
Questo significa che non ci sono nuovi commit sul branch di destinazione (quello su cui ti trovi) che non siano presenti anche nel branch di origine (quello che stai unendo).
In sostanza, il fast-forward è un processo di merge semplificato che rende più lineare la cronologia quando si mantiene una progressione lineare dei commit tra i branch.
Questo comando può essere usato in vari casi per controllare il codice in sviluppo, ad esempio:
Il comando git pull può comportare alcune criticità. Ecco alcuni aspetti di sicurezza da considerare:
La scelta tra fetch e pull dipende dal workflow e dai requisiti del progetto.
La cultura del team e il tipo di progetto vanno considerati quando si decide quale approccio adottare.
In generale, puoi adottare due strategie diverse.
Quando si lavora con i due comandi, gli sviluppatori tendono ad adottare alcune best practice per prevenire modifiche inattese al codice.
Ecco alcuni consigli da considerare:
git pull --rebase aiuta a evitare storie disordinate.Oltre all'accesso ai repository remoti, Git può essere usato anche per altri scopi per garantire un buon controllo di versione.
Ecco alcuni comandi comuni correlati:
git diff HEAD..origin/main: confronta locale e remoto.git branch -a: ispeziona tutti i branch, locali e remoti.git clone: il punto di partenza per la sincronizzazione, crea una copia del repository remoto sulla tua macchina locale.Altri comandi Git nella cheat sheet qui sotto.
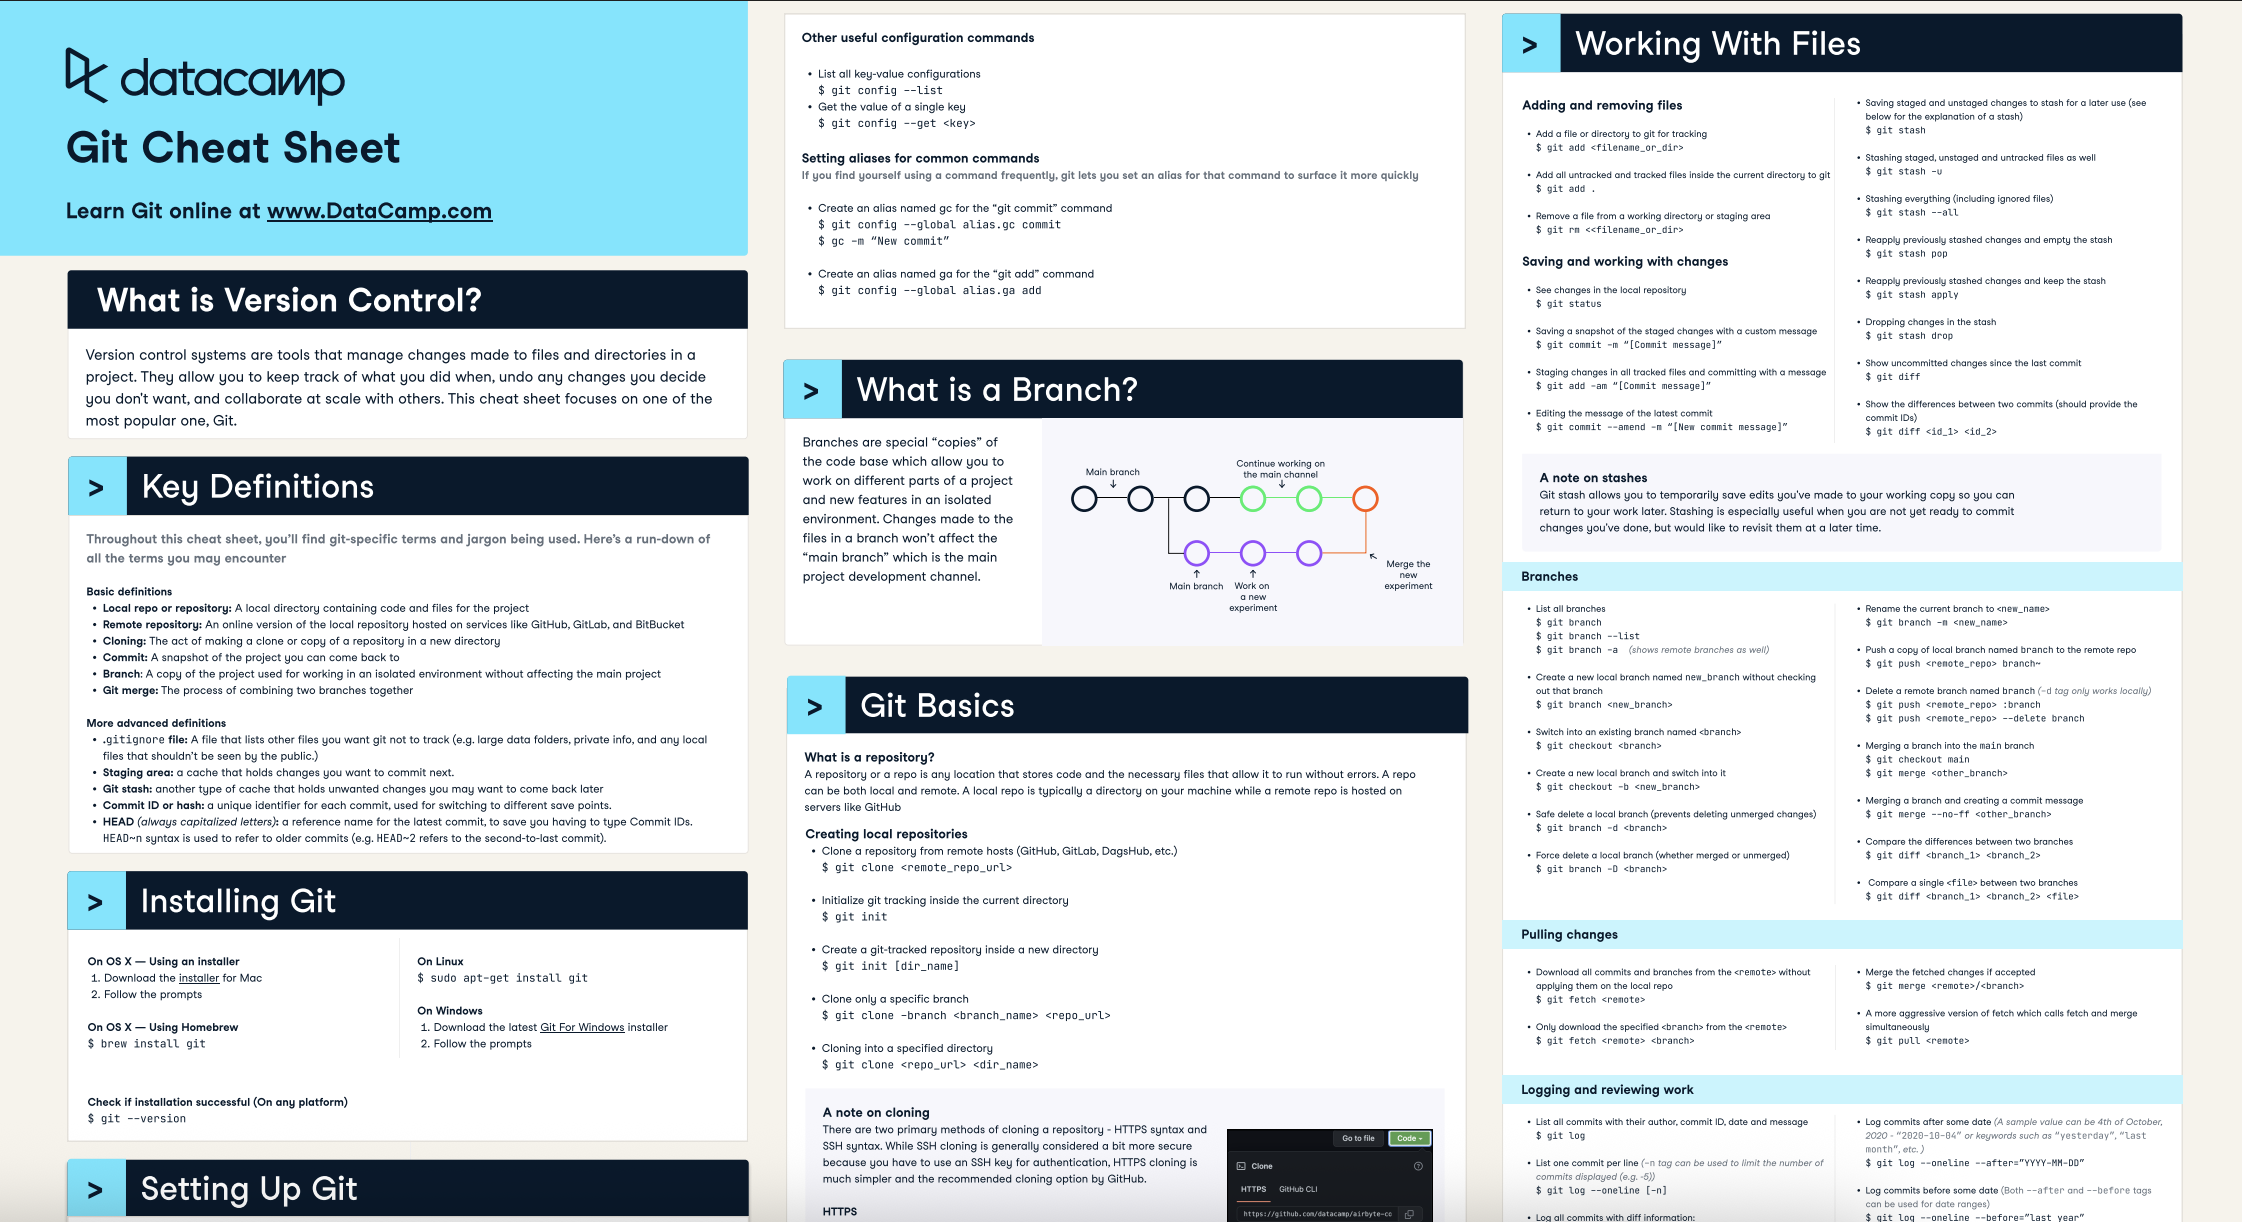
Fonte: DataCamp Git Cheat Sheet
Negli ambienti CI/CD, usare fetch e pull è comune.
L'automazione può essere abilitata tramite questi esempi:
I comandi Git sono potenti quando usati per gestire i workflow di sviluppo.
Possono quindi essere utilizzati al meglio nei seguenti casi d'uso:
Entrambi i comandi sono essenziali ma servono a scopi diversi. git fetch privilegia sicurezza, visibilità e integrazione controllata, mentre git pull privilegia velocità e comodità. La scelta tra i due dipende dal contesto: dimensione del progetto, cultura del team e bilanciamento tra stabilità e agilità.
I team dovrebbero trovare il giusto equilibrio tra l'uso di fetch per una revisione accurata e di pull per aggiornamenti rapidi. In questo modo potrai prevenire conflitti inutili, semplificare la collaborazione e mantenere repository più sani.
Vuoi saperne di più su come usare Git per il controllo di versione? Dai un'occhiata al nostro GitHub Foundations track o al nostro corso GitHub Concepts. Vuoi leggere altro su Git? Allora potrebbero esserti utili i nostri tutorial Git Push and Pull e Git Remote.
Migliori corsi DataCamp
Programma
Programma
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



