courses
Google ADK로 AI 에이전트 만들기
1
7.5K
이번 달의 승부처는 보이스입니다. Artificial Analysis의 Speech to Speech Index에서 OpenAI의 GPT-Live-1 Astra와 SpaceXAI의 Grok Voice Think Fast 2.0이 최상단에서 0.2점 차로 경쟁했고, OpenAI는 9월 초에 GPT-6 Astra를 출시했습니다. 9월 15일, Google은 두 가지 새로운 음성-대-음성 모델인 Gemini 3.8 Live와 Gemini 3.8 Live Extended Thinking으로 응답했습니다.
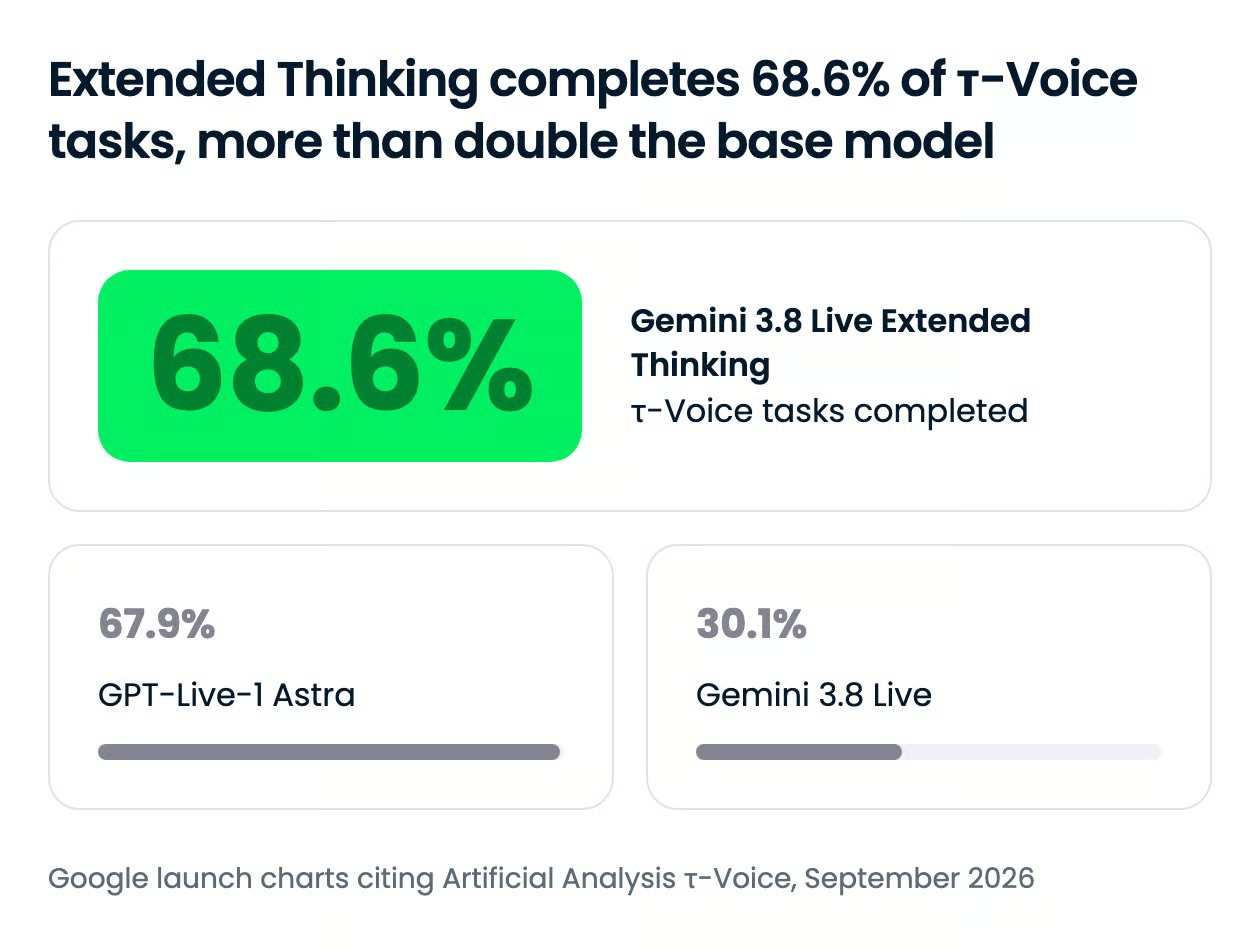
Extended Thinking은 해당 지수에서 82.6점으로 1위를 차지하고, τ-Voice 에이전틱 벤치마크에서도 68.6%로 선두에 섰습니다. 기본형 3.8 Live 모델은 저가형입니다. Artificial Analysis의 비용 테스트에서 입력 오디오 1시간을 $0.84에 처리해, Google이 표에 올린 모델 중 최저가를 기록했습니다. 두 모델 모두 오늘부터 Gemini API에서 전반적으로 사용할 수 있으며, 전세대인 Gemini 3.1 Flash Live와 동일한 가격입니다.
이 글에서는 Gemini 3.8 Live의 새로운 점을 기능, 벤치마크, 두 변형 간의 차이, 운영 비용 관점에서 정리합니다. 또한 Gemini Live API 시작 가이드와 GPT-Live-1로 음성 비서 만들기도 참고하세요.
Gemini 3.8 Live는 실시간 음성 에이전트를 위한 Google의 네이티브 음성-대-음성 모델로, 2026년 9월 15일에 더 높은 추론 능력의 형제 모델인 Gemini 3.8 Live Extended Thinking과 함께 출시되었습니다. 두 모델 모두 WebSocket 연결을 통한 Gemini Live API로 구동되며, 오디오, 비디오, 이미지, 텍스트를 입력으로 받고 오디오를 반환합니다. Google은 3.8 Live를 저지연 대화의 기본값으로, Extended Thinking을 복잡한 다단계 작업용으로 제시합니다.
Gemini 3.1 Flash Live 대비 세대 교체의 핵심은 모델이 말하기 외의 작업을 처리하는 방식입니다. 이제 도구 및 API 호출이 기본 설정으로 백그라운드에서 실행되며, 모델은 대화를 계속 이어갑니다. Extended Thinking은 여기에 구성 가능한 백그라운드 추론을 추가합니다. Google은 이 두 모델을 이전 라이브 모델 대비 도약이며, 음성-텍스트 변환, LLM, 텍스트-음성 변환을 연결하는 캐스케이드 파이프라인의 대체품으로 설명합니다.
Google은 새 모델의 다섯 가지 역량을 제시하며, 보이스 에이전트를 만드는 이들에게 가장 중요한 것은 대화 루프를 바꾸는 두 가지, 즉 비동기 도구 호출과 백그라운드 추론입니다.
두 모델 모두 함수 호출과 API 요청을 백그라운드에서 실행하면서 사용자에게 오디오를 스트리밍합니다. Gemini 3.8 Live에서는 비동기 실행이 이제 기본 함수 호출 모드입니다. 여전히 도구 선언에서 behavior: BLOCKING을 설정해 이전의 동기식 동작을 강제할 수 있고, SILENT, WHEN_IDLE, INTERRUPTED 옵션으로 결과를 언제 발화할지 결정하는 함수 스케줄링도 지원합니다.
Extended Thinking은 한 걸음 더 나아갑니다. 블로킹 도구를 허용하지 않으며, 이를 선언하면 하드 에러를 반환합니다. 실무적으로는, 예약 변경을 요청한 발신자가 즉시 확인 응답을 듣고, 이어서 진행 상황 업데이트, 그리고 최종 결과를 차례로 듣게 됩니다. 이는 API 대기 동안 침묵이 길어지는 캐스케이드 파이프라인과 대조적입니다. Gemini 3.1 Flash Live에서는 함수 호출이 순차적이기만 했고, 도구 결과를 다시 보내기 전까지 모델이 응답을 시작하지 않았습니다.
Gemini 3.8 Live Extended Thinking은 동시에 추론하고 발화합니다. Google의 문서에 따르면 모델은 "확인해볼게요"와 같은 초기 언어적 신호로 프롬프트를 수신했음을 알리고, 다단계 백그라운드 작업이 완료되는 동안 진행 상황을 설명합니다. thinking_level을 low, medium, high로 설정해 깊이를 제어할 수 있으며, 3.1 Flash Live에 있던 MINIMAL 레벨은 사라졌습니다.
이는 프로토콜을 바꾸는 요소로, 이번 릴리스에서 가장 중요한 마이그레이션 디테일이라고 봅니다. 모델이 한 요청 중에도 여러 차례 말할 수 있으므로, turnComplete: true가 더 이상 유휴 상태를 의미하지 않습니다.
클라이언트는 새 interaction_status 필드를 모니터링해야 합니다. 이는 추론이나 도구가 실행 중이면 IN_PROGRESS, 전체 작업이 끝나면 IDLE을 보고합니다. 이를 생략하면, 모델이 여전히 작업 중인데도 UI가 "청취 중"으로 돌아가버릴 수 있습니다.
Gemini 3.8 Live는 실시간 시각 입력에 기반해 대화를 전개합니다. 비디오 프레임을 준실시간으로 처리해, 사용자가 보고 있는 것과 말하는 것 모두에 반응할 수 있게 합니다. Google의 데모에는 라이브 체스 경기와 화면의 내용을 바탕으로 질문에 답하는 직원 온보딩 안내가 포함됩니다.
다만 비디오는 무료가 아닙니다. 현재 턴 커버리지는 오디오 활동과 모든 비디오 프레임을 기본으로 모델에 전송합니다. 따라서 비전이 필요 없는 앱이라면 맥락 예산과 비용을 위해 프레임을 유용할 때만 보내는 것이 좋습니다. 오디오+비디오 세션은 세션 관리를 통해 연장하기 전까지 2분으로 제한되며, 오디오 전용 세션은 15분입니다.
Google은 이를 "영숫자 정밀도"라고 부릅니다. 확인 코드, 클레임 번호, 기술 식별자와 같은 문자열을 음성으로 들었을 때 정확하게 파싱하는 능력입니다. 지원이나 물류용 음성 에이전트를 만들어본 이라면, 캐스케이드 스택이 여기서 자주 무너진다는 것을 압니다. 초기에 음성-텍스트 변환에서 오류가 나면 이후 단계에서 복구가 불가능하기 때문입니다. 발화를 전체 맥락으로 듣는 네이티브 음성 모델은 구조적으로 유리합니다.
Gemini 3.8 Live는 대화 중 97개 지원 언어를 감지하고 전환하며, Google은 언어 간 억양 일관성을 제공한다고 설명합니다. 두 모델 모두 Google이 말하는 증분 콘텐츠 업데이트를 지원합니다. 명시적인 user 또는 model 역할로 구조화된 데이터를 세션 중 아무 때나 보낼 수 있으며, 모델은 이를 라이브 오디오와 병합합니다. 진행 중인 통화의 흐름을 깨뜨리지 않고 고객 레코드나 주문 상태를 주입하는 방식입니다.
기존 코드에 영향을 주는 더 작은 변화도 있습니다. 모델이 자신에게 향하지 않은 발화에는 응답하지 않기로 판단할 수 있는 Proactive audio는 이제 항상 켜져 있으며, 이를 false로 설정하면 에러를 반환합니다. 감성 대화(Affective dialogue)는 API에서 완전히 제거되었으므로, 모든 enable_affective_dialog 구성은 삭제해야 합니다.
Extended Thinking은 Google이 공개한 모든 품질 및 에이전틱 보드에서 선두지만, OpenAI의 GPT-Live-1 Astra와는 근소한 차이입니다. 반면 기본형 3.8 Live 모델은 비용에서는 큰 격차로 우승하나 에이전틱 작업에서는 밀립니다.
아래의 Index, τ-Voice, Big Bench Audio, 비용 수치는 모두 Artificial Analysis의 공개 리더보드에서 가져온 것으로, 벤더 자체 보고가 아닌 독립 측정입니다. τ³-Banking 수치는 Google의 출시 차트에 인용된 Sierra 출처로, Sierra 보드에 동일 수치가 반영되기 전까지는 벤더 보고로 간주해야 합니다.
Artificial Analysis가 측정한 Sierra의 τ-Voice(도구를 사용해 다단계 작업을 완수하는지 평가)에서 Gemini 3.8 Live Extended Thinking이 선두를 달립니다. GPT-Live-1 Astra가 바짝 뒤쫓고, 나머지는 격차가 큽니다.
놀라운 점은 기본형 모델의 τ-Voice 점수가 전세대보다 낮다는 것입니다. Google은 3.8 Live가 복잡한 워크플로우보다는 확장성과 비용 효율을 위해 설계되었다고 명시하지만, 두 변형 간 38포인트 이상의 격차는 등급 선택이 미묘한 문제가 아님을 보여줍니다. 에이전트가 도구를 연쇄적으로 사용한다면, 기본 모델은 잘못된 기본값입니다.
Sierra의 τ³-Banking 리더보드(은행 업무 워크플로우를 기반으로 한 더 어려운 고객 서비스 벤치마크)에서는 Extended Thinking이 35.1%이며, GPT-Live-1 Astra가 32.0%, SpaceXAI의 Grok Voice Think Fast 2.0이 16.5%, Gemini 3.1 Flash Live가 11.3%, GPT-Realtime 2가 10.3%입니다. 이 보드의 모든 모델이 대다수에서 실패한다는 사실은 음성 에이전트가 아직 무감독 은행 업무에서 얼마나 먼지를 말해주지만, 이전 Gemini 세대 대비 3배 수준의 향상은 분명한 진전입니다.
Speech to Speech Index에서도 Extended Thinking이 근소하게 앞섭니다.
OpenAI 대비 1.1점의 리드는 리드이긴 하지만, 구매 결정을 좌우할 정도는 아닙니다.
구어 입력에 대한 순수 추론에서는, Google이 Extended Thinking의 Big Bench Audio 97.7%를 보고합니다. 또한 두 모델 모두 ServiceNow의 EVA-Bench에서 음성 에이전트의 파레토 전선을 확장(정확도와 대화 품질의 균형)했다고 하나, 해당 평가는 공용 API가 아닌 Gemini Enterprise Agent Platform을 통한 Live API로 수행되었습니다.
Google이 가장 보여주고 싶어 하는 차트입니다. Artificial Analysis의 Big Bench Audio 서브셋 비용 테스트에서, Gemini 3.8 Live는 입력 오디오 1시간을 $0.84에 처리합니다.
Extended Thinking은 동일 1시간에 $3.50, Grok Voice Think Fast 2.0은 $4.80, GPT-Live-1 Astra는 $5.83이 듭니다. Gemini 3.1 Flash Live는 추론 레벨에 따라 $1.50 또는 $1.75였습니다.
두 Gemini 막대를 함께 보면 제품 전략이 분명합니다. 기본형은 보드의 모든 모델보다 큰 폭으로 저렴하고, OpenAI와 품질에서 맞붙는 추론형조차 입력 1시간당 비용이 40% 저렴합니다. 추론형은 높은 thinking level에서 더 많은 토큰을 소모하므로, 동일 가격표를 공유해도 형제 모델 대비 약 4배 비용이 드는 이유가 됩니다.
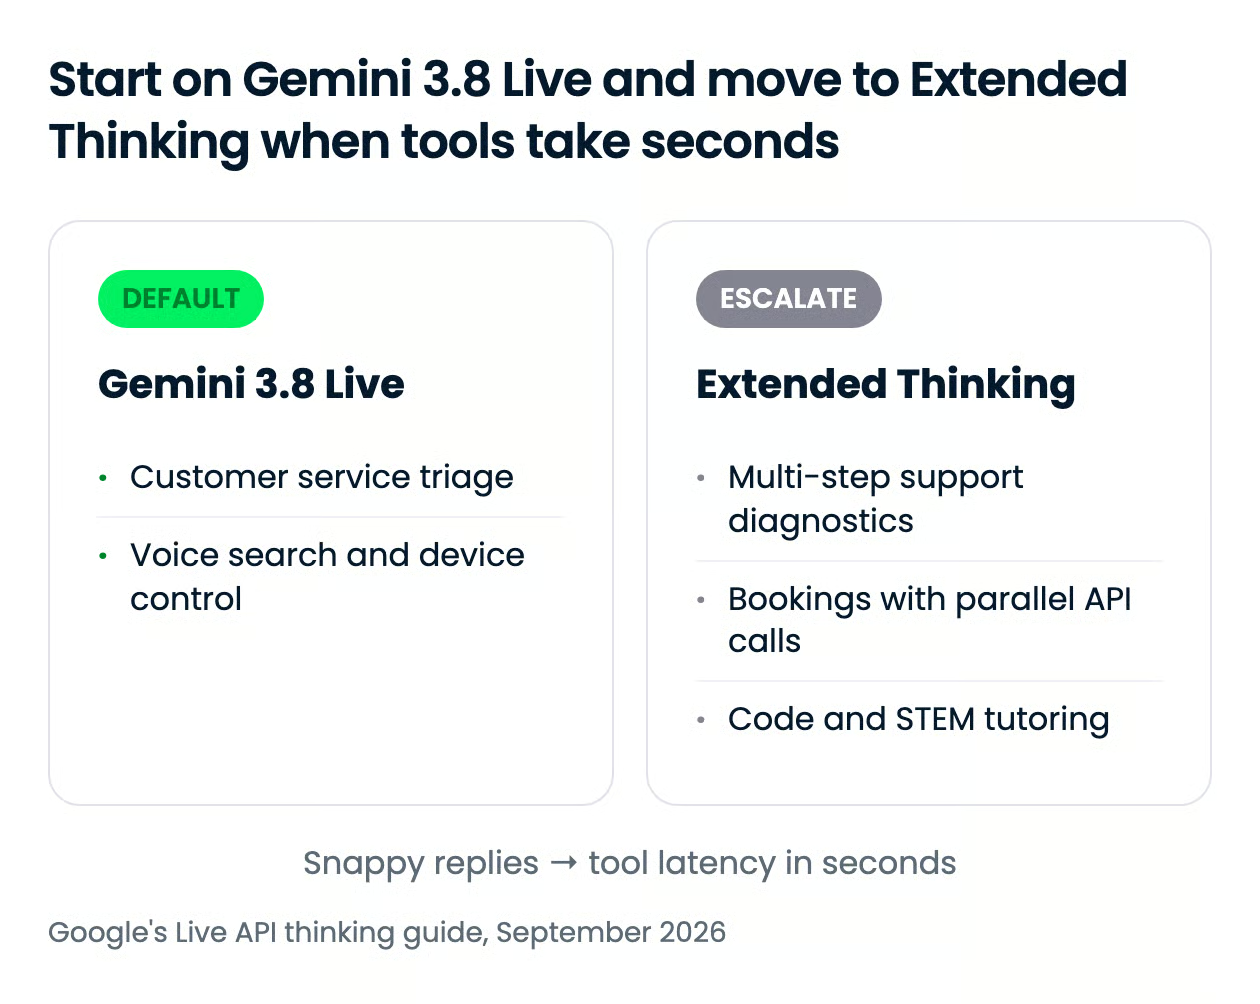
대부분의 음성 에이전트에는 Gemini 3.8 Live가 기본값으로 적합하고, 에이전트가 계획·비교를 하거나 느린 도구를 기다려야 할 때만 Extended Thinking의 추가 토큰 소모가 가치 있습니다. Google의 가이드도 경계를 도구 지연에 둡니다. 함수가 밀리초 단위로 반환된다면 기본 모델을 사용하세요.
두 변형은 동일한 가격표(아래 참조), 131,072 입력 및 65,536 출력 토큰 한도, 동일한 WebSocket 엔드포인트를 공유합니다. 차이를 만드는 것은 추론 아키텍처입니다.
Gemini 3.8 Live는 고정 지연 프로파일의 인터리브드 추론을 사용하며 thinking_level 설정이 아예 없습니다. Extended Thinking은 low, medium, high 백그라운드 추론을 노출하고, 작업 중 대화 필러를 스트리밍하며, 비동기 도구를 필수로 요구합니다. 이번 릴리스에서 노력(리소스) 제어는 이 thinking level뿐입니다.
| 사용 사례 | 선택 | 이유 |
|---|---|---|
| 고객 서비스 트리아지, 음성 검색, 언어 학습 | Gemini 3.8 Live | 즉각적인 턴테이킹이 깊이보다 중요하고, 사용자 턴당 응답은 한 번이면 충분 |
| 스마트 기기 제어, 센서 값 읽기 | Gemini 3.8 Live | 도구가 밀리초 내 반환하므로 가릴(마스킹할) 것이 없음 |
| 로그·에러 코드·설정 점검을 아우르는 기술 지원 | Extended Thinking | 다단계 진단에는 발화 사이의 백그라운드 추론이 필요 |
| 항공편·호텔을 병렬 조회하는 여행·예약 에이전트 | Extended Thinking | 침묵 대신 진행 상황을 말해주는 병렬 비동기 호출 |
| STEM 및 코딩 튜터링 | Extended Thinking | 설명을 말하기 전에 수식을 검증하거나 코드를 디버깅 |
또 하나 고려할 점은 클라이언트 복잡도입니다. Extended Thinking으로 이동하면 interaction_status 중심으로 상태 처리를 다시 작성해야 합니다. 따라서 이미 동작 중인 3.1 Flash Live 앱이 있다면 기본 모델이 드롭인 업그레이드이고, 추론형은 소규모 리팩터가 필요합니다.
두 모델은 Gemini 3.1 Flash Live Preview 가격표를 공유하므로 업그레이드는 무료입니다. 유료 티어에서 오디오 입력은 100만 토큰당 $3.00(분당 약 $0.005), 오디오 출력은 추론 토큰 포함 100만 토큰당 $12.00(분당 약 $0.018)입니다. 추론 토큰은 출력 요율로 과금되며, 이것이 Extended Thinking의 운영 비용이 더 높은 이유입니다.
| 모달리티 | 유료 티어(100만 토큰당) | 분당 추정 |
|---|---|---|
| 텍스트 입력 | $0.75 | 해당 없음 |
| 오디오 입력 | $3.00 | $0.005/분 |
| 이미지 및 비디오 입력 | $1.00 | $0.002/분 |
| 텍스트 출력 | $4.50 | 해당 없음 |
| 오디오 출력(추론 토큰 포함) | $12.00 | $0.018/분 |
무료 티어는 두 모델 모두 입력과 출력을 무상으로 제공합니다. 단, 무료 티어 데이터는 Google 제품 개선에 사용되며, 유료 티어 데이터는 그렇게 사용되지 않습니다.
Google Search로의 그라운딩은 두 티어에서 모두 지원됩니다. 월 5,000건의 무료 검색 요청이 Gemini 3.x 모델 전체에 공유되며, 이후에는 1,000건당 $14입니다. 이 모델에 특화된 레이트 리밋은 공개되지 않았으므로, 출시 계획 전 Gemini API 레이트 리밋 페이지에서 본인 티어의 한도를 확인하세요.
제공 현황은 세 갈래로 나뉩니다.
두 모델의 모든 오디오 출력에는 SynthID 워터마크가 포함됩니다. 또한 Google의 모델 카드는 한계를 솔직히 밝힙니다. 모델이 여전히 환각을 일으킬 수 있고, 탈옥 방어는 개선 중이며, 간헐적 지연이나 타임아웃이 있을 수 있습니다. 고객 앞에 두기 전 이 주의 사항을 읽어볼 가치가 있습니다.
모델 ID는 gemini-3.8-live와 gemini-3.8-live-extended-thinking이며, 둘 다 프리뷰 접미사 없는 안정 문자열입니다.
google-genai Python 또는 JavaScript SDK를 사용한 Gemini Live API, 원시 WebSocket, Google AI Studio의 Stream 보기에서 인터랙티브하게 접근할 수 있습니다. 또한 Google은 미디어 스트리밍 계층을 처리하는 통합 파트너로 Agora, Fishjam, LiveKit, LangChain, Pipecat, Vercel, Vision Agents를 제시하며, 이미 ADK를 사용 중이라면 Agent Development Kit의 스트리밍 경로도 있습니다.
아래 최소 Python 세션은 연결을 열고, 텍스트 턴을 보내며, 모델이 말한 내용을 읽을 수 있도록 출력 전사를 켭니다.
import asyncio
from google import genai

client = genai.Client()
config = {"response_modalities": ["AUDIO"], "output_audio_transcription": {}}

async def main():
    async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
        await session.send_client_content(
            turns={"role": "user", "parts": [{"text": "Read back the claim number 7Q-4418-B."}]},
            turn_complete=True,
        )
        async for response in session.receive():
            if response.server_content and response.server_content.output_transcription:
                print(response.server_content.output_transcription.text)

asyncio.run(main())gemini-3.1-flash-live-preview에서 마이그레이션하는 경우, 모델 문자열을 바꾸고 세션 설정에서 thinking_level과 thinking_config를 제거하세요. 턴 라이프사이클은 그 외에는 동일합니다. Live API는 기본적으로 서버-투-서버이므로, 브라우저와 모바일 클라이언트는 임시 토큰이 필요합니다.
오디오 캡처, 재생, 세션 관리 전체 과정은 Gemini Live API 튜토리얼을, 같은 제품군의 텍스트 측면은 Gemini 3.8 Flash API 튜토리얼에서 Python 기반의 thinking level과 함수 호출을 확인하세요.
Google은 순수 품질보다 가격으로 메시지를 던지고 있습니다. Extended Thinking이 GPT-Live-1 Astra 대비 모든 보드에서 1~2점가량 앞서지만, Gemini 3.8 Live는 입력 오디오 1시간당 $0.84로 OpenAI 모델보다 거의 7배 저렴합니다. 이는 운영 트래픽의 향배를 좌우하는 숫자입니다.
제 의견: Gemini 3.1 Flash Live를 쓰고 있다면 이번 주에 업그레이드하세요. 가격이 같고, 비동기 도구 호출만으로도 충분한 가치가 있습니다. OpenAI 실시간 스택을 쓰는 경우, 기본형은 트리아지와 검색 플로우에 시험 운용할 가치가 있고, 도구가 초 단위로 걸리는 곳에는 Extended Thinking을 시험해볼 만합니다. 기본형의 τ-Voice 30.1%는 에이전틱 용도로 쓰지 말아야 할 이유입니다.
음성 에이전트의 도구 호출 측을 제대로 구축하고 싶다면, 도구·가드레일·위임을 갖춘 고객 지원 에이전트를 Gemini로 연결하는 우리의 Building AI Agents with Google ADK 과정을 추천합니다.
DataCamp와 함께 에이전틱 AI를 배우세요!
courses
courses
courses