course
Bygg AI-agenter med Google ADK
1 timmar
7.5K
Röst är månadens stridsfråga. På Artificial Analysis Speech to Speech Index låg OpenAI:s GPT-Live-1 Astra och SpaceXAI:s Grok Voice Think Fast 2.0 0,2 poäng ifrån varandra i toppen, och OpenAI skeppade GPT-6 Astra i början av september. Den 15 september svarade Google med två nya tal-till-tal-modeller: Gemini 3.8 Live och Gemini 3.8 Live Extended Thinking.
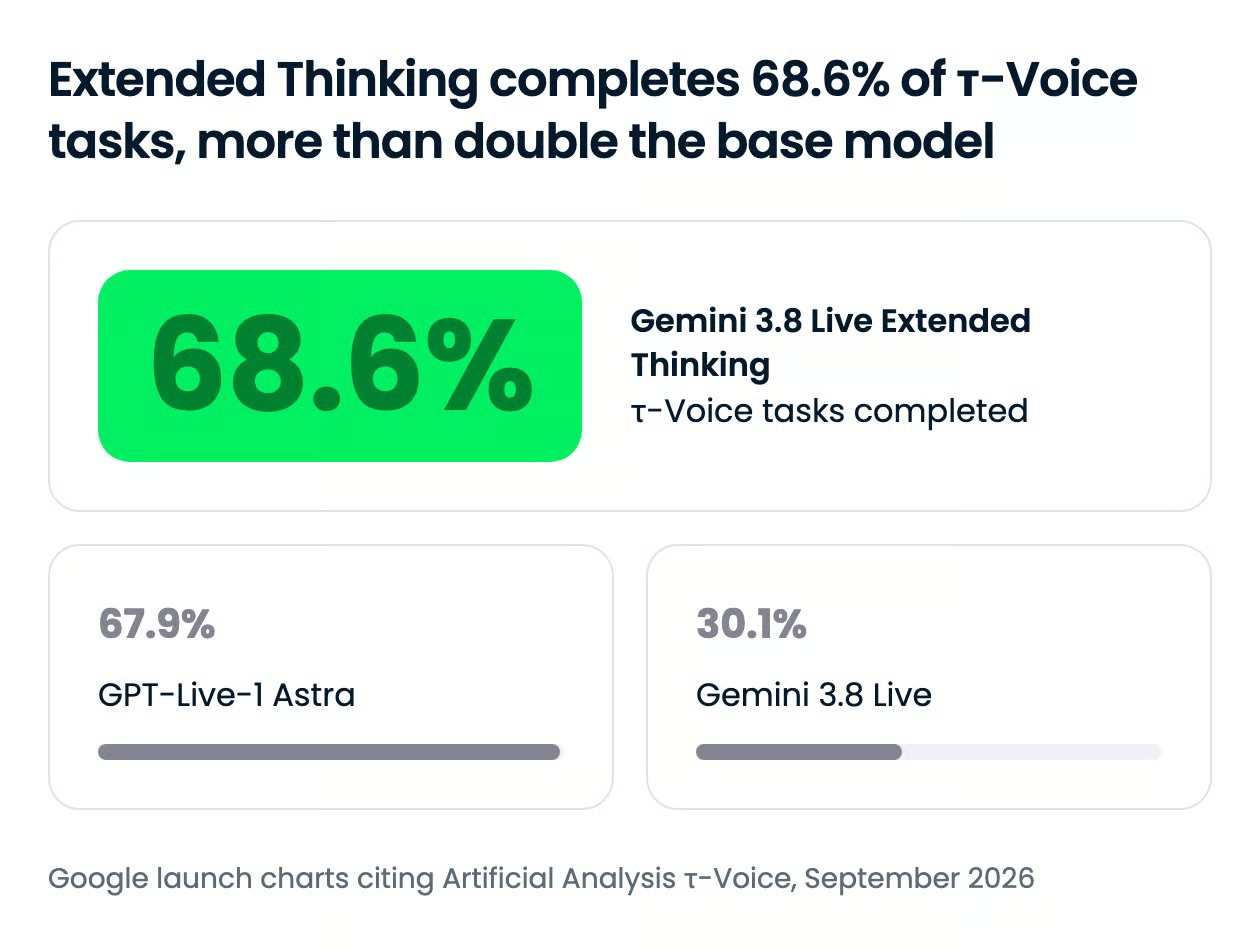
Extended Thinking tar förstaplatsen på det indexet med en poäng på 82,6 och leder τ-Voice agent-benchmarket med 68,6 %. Basmodellen 3.8 Live är den billiga: i Artificial Analysis kostnadstest bearbetar den en timmes inmatat ljud för 0,84 USD, lägst av alla modeller Google redovisade. Båda är allmänt tillgängliga i Gemini API i dag till samma pris som sin föregångare, Gemini 3.1 Flash Live.
I den här artikeln går jag igenom allt som är nytt med Gemini 3.8 Live: funktionerna, benchmarkresultaten, skillnaden mellan de två varianterna och vad det kostar att köra dem. Du kan också läsa våra guider till att komma igång med Gemini Live API och att bygga en röstassistent med GPT-Live-1.
Gemini 3.8 Live är Googles inhemska tal-till-tal-modell för röstagenter i realtid, släppt den 15 september 2026 tillsammans med ett syskon med högre resonemangsförmåga, Gemini 3.8 Live Extended Thinking. Båda körs via Gemini Live API över en WebSocket-anslutning, tar ljud, video, bilder och text som indata och returnerar ljud. Google positionerar 3.8 Live som standardvalet för dialog med låg latens och Extended Thinking som valet för komplexa, flerstegsuppgifter.
Generationsskiftet jämfört med Gemini 3.1 Flash Live ligger i hur modellen hanterar arbete som inte är själva talandet. Verktygs- och API-anrop körs nu i bakgrunden som standard medan modellen fortsätter samtalet, och Extended Thinking lägger till konfigurerbart bakgrundsresonemang ovanpå. Google beskriver paret som ett steg bort från tidigare live-modeller och som en ersättning för kaskad-pipelines som kedjar tal-till-text, en LLM och text-till-tal.
Google listar fem förmågor för de nya modellerna, och de som betyder mest för alla som bygger en röstagent är de två som förändrar konversationsloopen: asynkrona verktygsanrop och bakgrundsresonemang.
Båda modellerna kör funktionsanrop och API-förfrågningar i bakgrunden medan de strömmar ljud tillbaka till användaren. På Gemini 3.8 Live är asynkron exekvering nu standardläget för funktionsanrop. Du kan fortfarande tvinga fram det gamla synkrona beteendet genom att sätta behavior: BLOCKING på en verktygsdeklaration, och modellen stöder funktionsschemaläggning med alternativen SILENT, WHEN_IDLE och INTERRUPTED som avgör när ett resultat ska talas ut.
Extended Thinking går längre: den kräver icke-blockerande verktyg och returnerar ett hårt fel om du deklarerar ett blockerande. Den praktiska effekten är att den som ringer och vill ändra en bokning hör ett bekräftande direkt, sedan en statusuppdatering och därefter resultatet, i stället för tystnaden som en kaskad-pipeline ger medan den väntar på ett API. På Gemini 3.1 Flash Live var funktionsanrop endast sekventiella, och modellen började inte svara förrän du skickade tillbaka verktygsresultatet.
Gemini 3.8 Live Extended Thinking resonerar och talar samtidigt. Googles dokumentation beskriver att modellen använder tidiga verbala signaler som ”Låt mig kolla det” för att bekräfta en uppmaning, och sedan berättar om framsteg medan flerstegsarbete i bakgrunden slutförs. Du styr djupet med thinking_level satt till low, medium eller high; nivån MINIMAL som fanns på 3.1 Flash Live är borta.
Detta förändrar protokollet och jag tycker att det är den viktigaste migreringsdetaljen i releasen. Eftersom modellen kan tala flera gånger under en begäran betyder turnComplete: true inte längre att den är overksam.
Din klient måste bevaka ett nytt fält, interaction_status, som rapporterar IN_PROGRESS medan resonemang eller verktyg körs och IDLE när hela uppgiften är klar. Hoppar du över det kommer din UI att slå om till ”lyssnar” medan modellen fortfarande är mitt i en uppgift.
Gemini 3.8 Live förankrar dialog i live visuellt inflöde, bearbetar videoramar nästan i realtid så att en agent kan svara på vad en användare tittar på såväl som vad de säger. Googles demo inkluderar ett live schackparti och en onboardinggenomgång där modellen svarar på frågor om det som syns på skärmen.
Video är dock inte gratis. Täckningen per tur skickar nu som standard ljudaktivitet plus alla videoramar till modellen, så om din app inte behöver syn, bör du bara skicka ramar när de är användbara, både för kontextbudget och kostnad. Sessioner med ljud plus video är också begränsade till 2 minuter innan du behöver sessionshantering för att förlänga dem, jämfört med 15 minuter för ljud-only-sessioner.
Google kallar detta ”alfanumerisk precision”: att korrekt tolka strängar som bekräftelsekoder, ärendenummer och tekniska identifierare som uttalas högt. Alla som har byggt en röstagent för support eller logistik vet att det är här kaskadstackar fallerar, eftersom ett tidigt tal-till-text-fel i kedjan inte går att återställa nedströms. En inhemsk talmodell som hör hela yttrandet i sitt sammanhang har en strukturell fördel här.
Gemini 3.8 Live känner igen och växlar mellan 97 stödda språk under ett samtal, med vad Google kallar accent-konsistens över dem. Båda modellerna stöder även det Google kallar inkrementella innehållsuppdateringar: du kan skicka strukturerad data in i sessionen när som helst, med en explicit rollen user eller model, och modellen sammanfogar det med det livea ljudet. Det är så du matar in en kundpost eller en orderstatus i ett pågående samtal utan att bryta flödet.
Två mindre förändringar påverkar befintlig kod. Proaktivt ljud, där modellen kan välja att inte svara på tal som inte är riktat till den, är nu permanent på, och att ställa in den på false ger ett fel. Affektiv dialog har tagits bort helt från API:et, så all konfiguration enable_affective_dialog måste bort.
Extended Thinking leder alla kvalitets- och agenttavlor som Google publicerade, men med små marginaler över OpenAI:s GPT-Live-1 Astra, medan basmodellen 3.8 Live vinner stort på kostnad men förlorar på agentuppgifter.
Indexet, τ-Voice, Big Bench Audio och kostnadssiffrorna nedan finns alla på Artificial Analysis öppna topplista, så de är oberoende uppmätta snarare än leverantörrapporterade. τ³-Banking-siffrorna kommer från Googles lanseringsgraf som hänvisar till Sierra, så betrakta den raden som leverantörrapporterad tills Sierras topplista visar samma.
Gemini 3.8 Live Extended Thinking leder på τ-Voice, Sierras benchmark för om en röstagent slutför flerstegsuppgifter med verktyg, mätt av Artificial Analysis. GPT-Live-1 Astra är strax bakom, med resten av konkurrensen längre ner:
Siffran som förvånade mig är att basmodellens poäng på τ-Voice ligger under dess egen föregångare. Google är tydligt med att 3.8 Live är byggd för skala och kostnadseffektivitet snarare än för komplexa arbetsflöden, men ett gap på mer än 38 poäng mellan de två varianterna betyder att valet av nivå inte är en nyansfråga. Om din agent kedjar verktyg är basmodellen fel standardval.
På Sierras τ³-Banking-topplista, ett svårare kundservice-benchmark byggt kring bankflöden, får Extended Thinking 35,1 % mot 32,0 % för GPT-Live-1 Astra, 16,5 % för SpaceXAI:s Grok Voice Think Fast 2.0, 11,3 % för Gemini 3.1 Flash Live och 10,3 % för GPT-Realtime 2. Varje modell på den tavlan misslyckas för det mesta, vilket visar hur långt röstagenter fortfarande är från osuperviserat bankarbete, men en tredubbling över föregående Gemini-generation är ett verkligt steg.
På Speech to Speech Index kniper Extended Thinking också förstaplatsen:
Ett försprång på 1,1 poäng över OpenAI är ett försprång, men jag skulle inte basera ett inköpsbeslut på det.
För rent resonemang över talad indata rapporterar Google 97,7 % på Big Bench Audio för Extended Thinking. Google rapporterar också att båda modellerna driver Paretofronten på ServiceNows EVA-Bench för röstagenter, balanserar noggrannhet mot samtalskvalitet, även om den körningen gjordes på Live API via Gemini Enterprise Agent Platform snarare än det offentliga API:et.
Detta är grafen Google helst vill att du ser. I Artificial Analysis kostnadstest på Big Bench Audio-delmängden bearbetar Gemini 3.8 Live en timmes inmatat ljud för 0,84 USD.
Extended Thinking kostar 3,50 USD för samma timme, Grok Voice Think Fast 2.0 kostar 4,80 USD och GPT-Live-1 Astra kostar 5,83 USD. Gemini 3.1 Flash Live låg på 1,50 USD respektive 1,75 USD beroende på thinking-nivå.
Läs de två Gemini-staplarna tillsammans, så blir produktstrategin tydlig. Basmodellen underprissätter allt på tavlan med bred marginal, och resonemangsmodellen som matchar OpenAI i kvalitet kostar fortfarande 40 % mindre per timme indata. Notera att resonemangsmodellen bränner fler token på högre thinking-nivåer, vilket är skälet till att den kostar ungefär fyra gånger så mycket som sitt syskon trots att de delar pristabell.
Gemini 3.8 Live är rätt standardval för de flesta röstagenter, och Extended Thinking är värd sin högre tokenförbrukning bara när agenten måste planera, jämföra eller vänta på långsamma verktyg. Googles egen vägledning drar gränsen vid verktygs-latens: om dina funktioner returnerar på millisekunder, stanna på basmodellen.
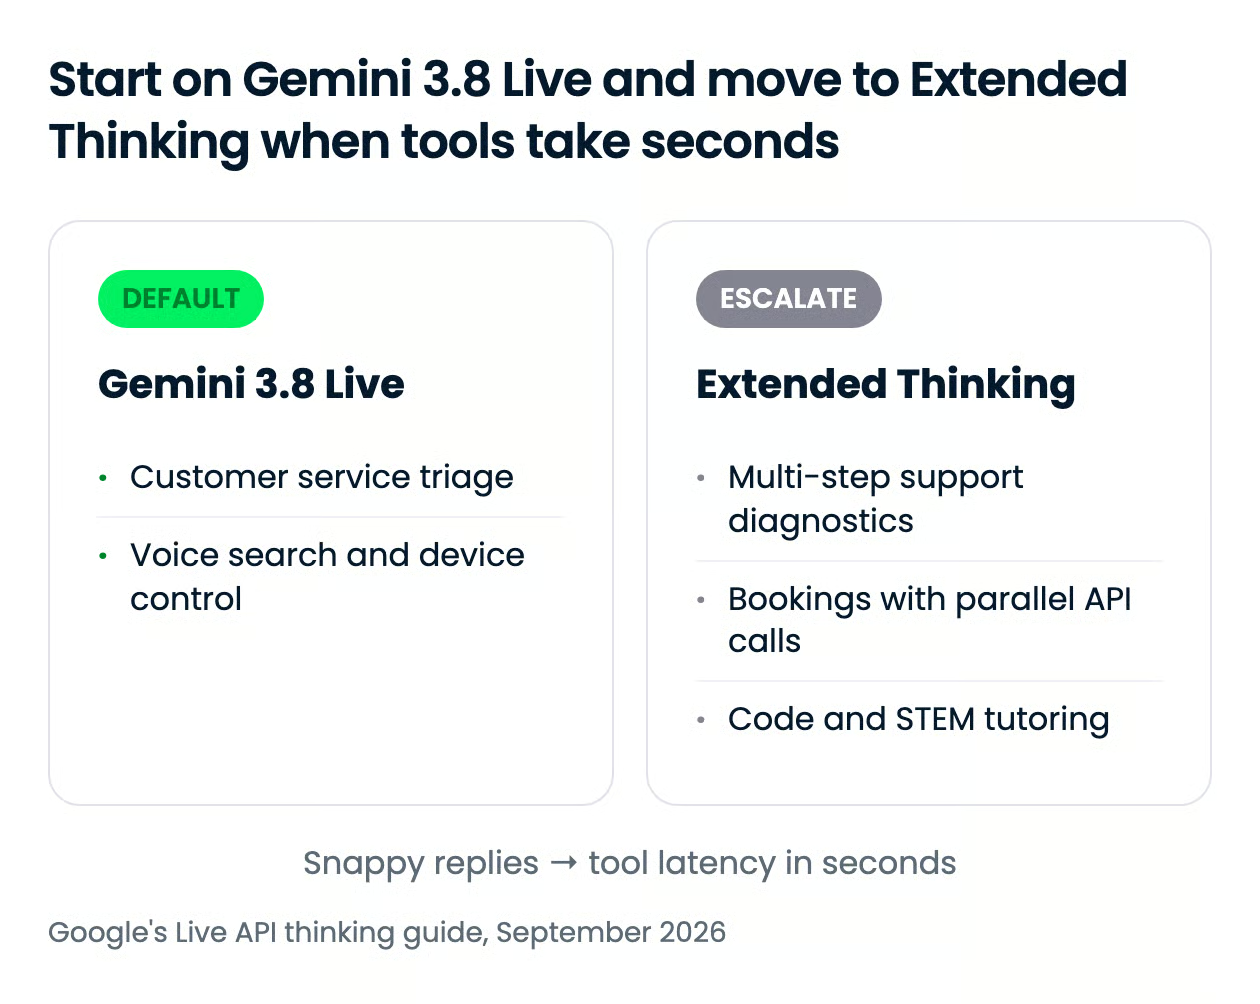
De två varianterna delar en pristabell (som jag går igenom nedan), token-gränser på 131 072 in och 65 536 ut, och samma WebSocket-endpoint. Det som skiljer dem är resonemangsarkitekturen.
Gemini 3.8 Live använder interleaved reasoning med en fast latensprofil och ingen thinking_level-inställning alls. Extended Thinking exponerar low, medium och high bakgrundsresonemang, strömmar utfyllnadsfraser medan den arbetar och kräver asynkrona verktyg. Dessa thinking-nivåer är de enda ansträngningsreglagen i releasen.
| Användningsfall | Val | Varför |
|---|---|---|
| Kundservice-triage, röst-sök, språkpraktik | Gemini 3.8 Live | Omedelbara turbyten är viktigare än djup, och varje användartur får ett svar |
| Styrning av smarta enheter, avläsning av sensorvärden | Gemini 3.8 Live | Verktyg returnerar på millisekunder, så det finns inget att maskera |
| Teknisk support över loggar, felkoder och konfig-kontroller | Extended Thinking | En flerstegsdiagnos kräver bakgrundsresonemang mellan yttranden |
| Rese- och bokningsagenter som frågar på flyg och hotell parallellt | Extended Thinking | Parallella asynkrona anrop med talade statusuppdateringar i stället för tystnad |
| STEM- och kodhandledning | Extended Thinking | Modellen verifierar formler eller felsöker kod innan den talar en förklaring |
En sak till att beakta: klientkomplexitet. Att gå till Extended Thinking innebär att skriva om din tillståndshantering kring interaction_status, så om du har en fungerande 3.1 Flash Live-app är basmodellen uppgraderingen du kan lägga in direkt, och resonemangsmodellen en liten refaktorering.
Båda modellerna delar pristabellen för Gemini 3.1 Flash Live Preview, så uppgraderingen är gratis. På den betalda nivån kostar ljudinmatning 3,00 USD per 1 miljon token, vilket Google uppskattar till 0,005 USD per minut, och ljudutmatning kostar 12,00 USD per 1 miljon token, cirka 0,018 USD per minut. Thinking-token debiteras till utdatahastigheten, vilket är där Extended Thinkings högre driftkostnad kommer ifrån.
| Modalitet | Betald nivå, per 1M token | Per-minut-estimat |
|---|---|---|
| Textinmatning | $0,75 | n/a |
| Ljudinmatning | $3,00 | $0,005/min |
| Bild- och videoinmatning | $1,00 | $0,002/min |
| Textutmatning | $4,50 | n/a |
| Ljudutmatning (inklusive thinking-token) | $12,00 | $0,018/min |
Den fria nivån täcker båda modellerna utan kostnad för in- och utdata, med den vanliga brasklappen att Google använder data från fria nivån för att förbättra sina produkter; data från betald nivå används inte på det sättet.
Förankring med Google Sök stöds på båda nivåerna, med 5 000 kostnadsfria sökförfrågningar per månad delade över alla Gemini 3.x-modeller och 14 USD per 1 000 förfrågningar efter det. Google har inte publicerat hastighetsbegränsningar specifika för dessa modeller, så kolla sidan med hastighetsbegränsningar för Gemini API för din nivå innan du planerar en lansering.
Tillgängligheten är uppdelad på tre sätt:
Varje ljudutmatning från båda modellerna bär en SynthID-vattenstämpel, och Googles modellkort är öppet med begränsningarna: modellerna kan fortfarande hallucinera, motståndskraften mot jailbreak förbättras fortfarande, och det kan förekomma tillfällig långsamhet eller timeouts. Dessa förbehåll är värda att läsa innan du sätter någon av modellerna framför kunder.
Modell-ID:na är gemini-3.8-live och gemini-3.8-live-extended-thinking, båda stabila strängar utan förhandsvisningssuffix.
Du når dem via Gemini Live API med google-genai SDK för Python eller JavaScript, via råa WebSockets, eller interaktivt i Google AI Studios Stream-vy. Google listar också Agora, Fishjam, LiveKit, LangChain, Pipecat, Vercel och Vision Agents som integrationspartners som hanterar medieströmningslagret, och det finns en Agent Development Kit-strömningsväg om du redan bygger på ADK.
Den minimala Python-sessionen nedan öppnar en anslutning, skickar en texttur och slår på en utdata-transkription så att du kan läsa vad modellen sa:
import asyncio
from google import genai

client = genai.Client()
config = {"response_modalities": ["AUDIO"], "output_audio_transcription": {}}

async def main():
    async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
        await session.send_client_content(
            turns={"role": "user", "parts": [{"text": "Read back the claim number 7Q-4418-B."}]},
            turn_complete=True,
        )
        async for response in session.receive():
            if response.server_content and response.server_content.output_transcription:
                print(response.server_content.output_transcription.text)

asyncio.run(main())
Om du migrerar från gemini-3.1-flash-live-preview, ändra modellsträngen och ta bort eventuell thinking_level eller thinking_config från din setup; tur-livscykeln är annars identisk. Live API är server-till-server som standard, så webbläsar- och mobilklienter behöver efemära token.
För en fullständig genomgång av ljudinsamling, uppspelning och sessionshantering, se vår Gemini Live API-handledning, och för textsidan i samma familj täcker vår Gemini 3.8 Flash API-handledning thinking-nivåer och funktionsanrop i Python.
Google markerar på pris snarare än på rå kvalitet. Extended Thinkings försprång över GPT-Live-1 Astra är en poäng eller två på varje tavla, men Gemini 3.8 Live på 0,84 USD per timme inmatat ljud underprissätter OpenAI:s modell med nästan sju gånger, och det är siffran som avgör var produktionstrafik för röst hamnar.
Min syn: om du kör något på Gemini 3.1 Flash Live, uppgradera den här veckan, eftersom priset är detsamma och de asynkrona verktygsanropen ensamt är värt det. Om du kör OpenAI:s realtidsstack är basmodellen värd ett test för triage- och sökflöden, och Extended Thinking är värd ett där dina verktyg tar sekunder. Basmodellens 30,1 % på τ-Voice är skälet att inte använda den för något agentiskt.
Om du vill bygga verktygsanropsdelen av en röstagent på rätt sätt rekommenderar jag vår kurs Building AI Agents with Google ADK, som kopplar in Gemini i en kundsupportagent med verktyg, skyddsräcken och delegering.
Lär dig agentisk AI med DataCamp!
course
course
course