
Cours
Créer des agents IA avec Google ADK
1 h
7.5K
La voix est le terrain de jeu du moment. Sur le Speech to Speech Index d’Artificial Analysis, GPT-Live-1 Astra d’OpenAI et Grok Voice Think Fast 2.0 de SpaceXAI se tenaient en tête à 0,2 point d’écart, et OpenAI a lancé GPT-6 Astra début septembre. Le 15 septembre, Google a répondu avec deux nouveaux modèles speech-to-speech : Gemini 3.8 Live et Gemini 3.8 Live Extended Thinking.
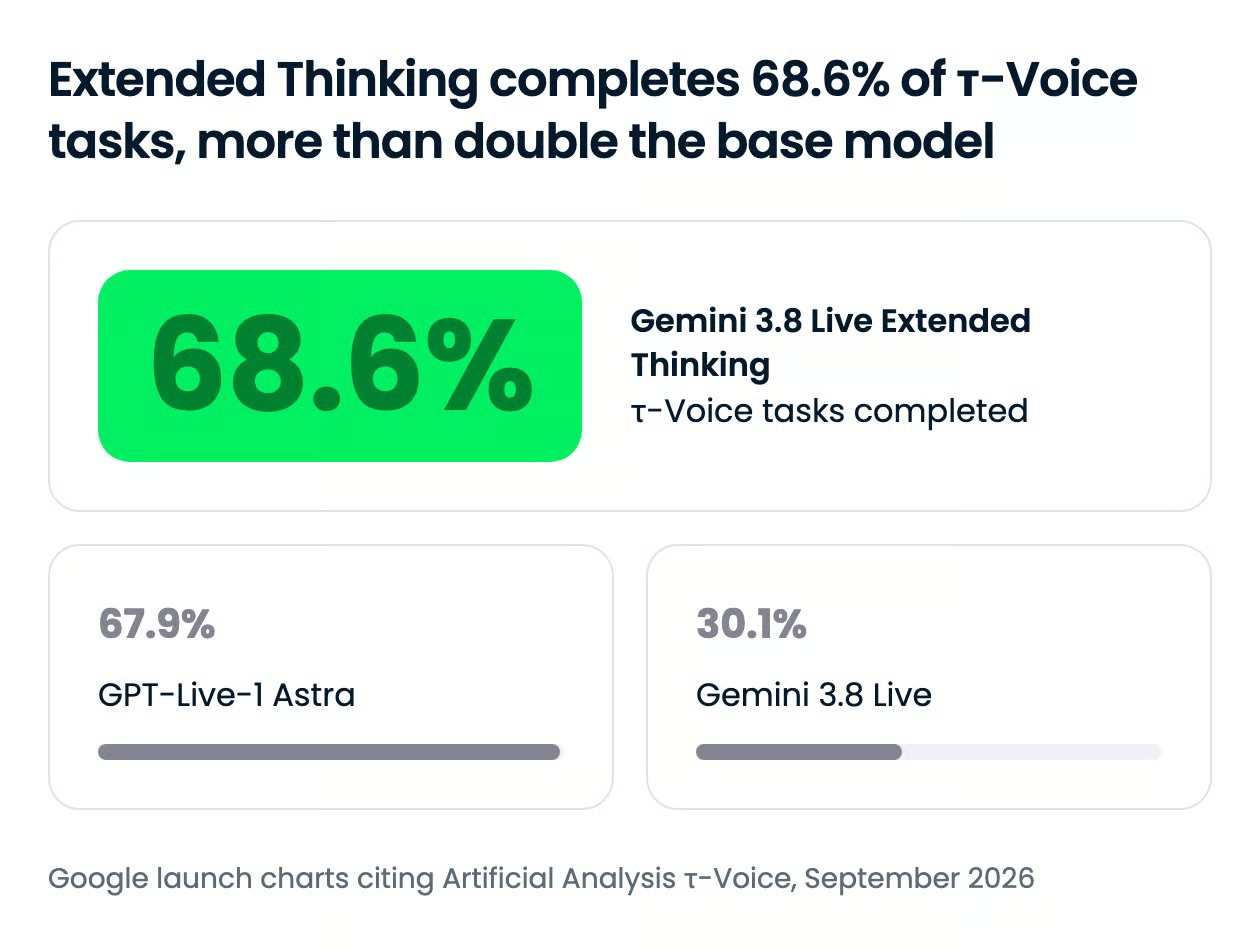
Extended Thinking prend la première place de cet index avec un score de 82,6 et mène le benchmark agentique τ-Voice à 68,6 %. Le modèle 3.8 Live de base est le plus économique : dans le test de coût d’Artificial Analysis, il traite une heure d’audio en entrée pour 0,84 $, le plus bas de tous les modèles chartés par Google. Les deux sont disponibles dès aujourd’hui dans l’API Gemini, au même prix que leur prédécesseur, Gemini 3.1 Flash Live.
Dans cet article, nous passons en revue toutes les nouveautés de Gemini 3.8 Live : fonctionnalités, benchmarks, différences entre variantes et coûts d’exécution. Consultez aussi nos guides pour bien démarrer avec l’API Gemini Live et créer un assistant vocal avec GPT-Live-1.
Gemini 3.8 Live est le modèle speech-to-speech natif de Google pour agents vocaux en temps réel, sorti le 15 septembre 2026 aux côtés d’un jumeau plus performant en raisonnement, Gemini 3.8 Live Extended Thinking. Les deux fonctionnent via l’API Gemini Live sur WebSocket, acceptent audio, vidéo, images et texte en entrée, et renvoient de l’audio. Google positionne 3.8 Live comme le choix par défaut pour le dialogue à faible latence et Extended Thinking pour les tâches complexes et multi-étapes.
Le saut générationnel par rapport à Gemini 3.1 Flash Live concerne la gestion du « travail qui n’est pas de la parole ». Les appels d’outils et d’API s’exécutent désormais en arrière-plan par défaut pendant que le modèle poursuit la conversation, et Extended Thinking ajoute par-dessus un raisonnement de fond configurable. Google présente ce duo comme une rupture par rapport à ses précédents modèles live et comme un remplacement des pipelines en cascade qui enchaînent reconnaissance vocale, LLM et synthèse vocale.
Google met en avant cinq capacités pour les nouveaux modèles, et les deux qui comptent le plus pour quiconque construit un agent vocal sont celles qui modifient la boucle conversationnelle : les appels d’outils asynchrones et le raisonnement en arrière-plan.
Les deux modèles exécutent des appels de fonctions et des requêtes d’API en arrière-plan tout en diffusant l’audio à l’utilisateur. Sur Gemini 3.8 Live, l’exécution asynchrone est désormais le mode par défaut pour l’appel de fonctions. Vous pouvez toujours forcer l’ancien comportement synchrone avec behavior: BLOCKING sur une déclaration d’outil, et le modèle prend en charge la planification de fonctions avec les options SILENT, WHEN_IDLE et INTERRUPTED qui déterminent quand un résultat est énoncé.
Extended Thinking va plus loin : il exige des outils non bloquants et renvoie une erreur si vous en déclarez un bloquant. Concrètement, un appelant qui demande une modification de réservation entend d’abord un accusé de réception, puis une mise à jour d’avancement, puis le résultat, au lieu du silence que produit un pipeline en cascade pendant l’attente d’une API. Sur Gemini 3.1 Flash Live, l’appel de fonctions n’était qu’en séquentiel, et le modèle ne commençait pas à répondre avant que vous ne renvoyiez le résultat de l’outil.
Gemini 3.8 Live Extended Thinking raisonne et parle en même temps. La documentation de Google décrit le modèle utilisant des signaux verbaux précoces comme « Laissez-moi vérifier » pour accuser réception, puis narrant la progression à mesure que le travail de fond multi-étapes s’exécute. Vous contrôlez la profondeur avec thinking_level à low, medium ou high ; le niveau MINIMAL présent sur 3.1 Flash Live disparaît.
Cela change le protocole, et c’est selon moi le point de migration le plus important de la version. Parce que le modèle peut parler plusieurs fois pendant une même requête, turnComplete: true ne signifie plus qu’il est au repos.
Votre client doit surveiller un nouveau champ interaction_status, qui indique IN_PROGRESS tant que le raisonnement ou les outils tournent et IDLE quand la tâche est entièrement terminée. Sans cela, votre interface repassera en mode « écoute » alors que le modèle est encore en plein travail.
Gemini 3.8 Live ancre le dialogue dans l’entrée visuelle en direct, en traitant des images vidéo quasi en temps réel pour qu’un agent réagisse à ce que l’utilisateur regarde autant qu’à ce qu’il dit. Les démonstrations de Google incluent une partie d’échecs en direct et un onboarding employé où le modèle répond aux questions sur ce qui s’affiche à l’écran.
La vidéo n’est pas gratuite pour autant. La couverture d’un tour envoie désormais par défaut l’activité audio plus toutes les images vidéo au modèle ; si votre application n’a pas besoin de vision, envoyez des frames seulement lorsqu’elles sont utiles, pour le budget de contexte comme pour le coût. Les sessions audio+vidéo sont aussi limitées à 2 minutes avant d’avoir besoin de gestion de session pour les prolonger, contre 15 minutes pour les sessions audio seules.
Google appelle cela la « précision alphanumérique » : analyser correctement des chaînes comme des codes de confirmation, numéros de dossier ou identifiants techniques dictés à voix haute. Qiconque a déjà construit un agent vocal pour le support ou la logistique sait que c’est là que les piles en cascade trébuchent : une erreur de reconnaissance vocale au début est irrécupérable en aval. Un modèle vocal natif qui entend l’énoncé complet en contexte a ici un avantage structurel.
Gemini 3.8 Live détecte et bascule entre 97 langues prises en charge au cours d’une conversation, avec ce que Google appelle une cohérence d’accent. Les deux modèles prennent aussi en charge ce que Google nomme des mises à jour de contenu incrémentales : vous pouvez injecter des données structurées dans la session à tout moment, avec un rôle explicite user ou model, et le modèle les fusionne avec l’audio en direct. C’est ainsi que vous injectez une fiche client ou un statut de commande dans un appel en cours sans casser le flux.
Deux petits changements affectent le code existant. L’audio proactif, où le modèle peut décider de ne pas répondre à une parole qui ne lui est pas destinée, est désormais activé en permanence, et le régler à false renvoie une erreur. Le dialogue affectif a été entièrement retiré de l’API ; toute configuration enable_affective_dialog doit être supprimée.
Extended Thinking mène tous les tableaux de qualité et d’agentique publiés par Google, mais de peu devant GPT-Live-1 Astra d’OpenAI, tandis que le modèle 3.8 Live de base l’emporte largement sur le coût mais perd sur les tâches agentiques.
L’index, τ-Voice, Big Bench Audio et les chiffres de coût ci-dessous proviennent tous du leaderboard public d’Artificial Analysis, donc mesurés indépendamment et non déclarés par les vendeurs. Les chiffres τ³-Banking viennent du graphique de lancement de Google citant Sierra : considérez cette ligne comme déclarée par le fournisseur jusqu’à ce que le tableau de Sierra reflète les mêmes résultats.
Gemini 3.8 Live Extended Thinking est en tête sur τ-Voice, le benchmark de Sierra qui mesure si un agent vocal mène à bien des tâches multi-étapes avec des outils, tel que mesuré par Artificial Analysis. GPT-Live-1 Astra suit de près, le reste du peloton décroche :
Le chiffre surprenant est que le score du modèle de base sur τ-Voice est inférieur à celui de son propre prédécesseur. Google est clair : 3.8 Live est conçu pour l’échelle et l’efficacité des coûts plutôt que pour des workflows complexes, mais un écart de plus de 38 points entre les deux variantes signifie que le choix de palier n’est pas une nuance. Si votre agent enchaîne des outils, le modèle de base n’est pas le bon défaut.
Sur le leaderboard τ³-Banking de Sierra, un benchmark service client plus ardu centré sur des workflows bancaires, Extended Thinking obtient 35,1 % contre 32,0 % pour GPT-Live-1 Astra, 16,5 % pour Grok Voice Think Fast 2.0 de SpaceXAI, 11,3 % pour Gemini 3.1 Flash Live et 10,3 % pour GPT-Realtime 2. Tous les modèles de ce tableau échouent la plupart du temps, signe de la distance qui reste avant un agent vocal autonome en banque, mais tripler le score de la génération Gemini précédente est un vrai progrès.
Sur le Speech to Speech Index, Extended Thinking devance lui aussi la concurrence :
Un avantage de 1,1 point sur OpenAI reste un avantage, mais je ne fonderais pas une décision d’achat uniquement dessus.
Pour le raisonnement pur sur entrée parlée, Google annonce 97,7 % sur Big Bench Audio pour Extended Thinking. Google indique aussi que les deux modèles repoussent la frontière de Pareto sur EVA-Bench de ServiceNow pour les agents vocaux, en équilibrant précision et qualité conversationnelle, même si ce test a été réalisé via l’API Live à travers la Gemini Enterprise Agent Platform plutôt que l’API publique.
C’est le graphique que Google veut surtout vous montrer. Dans le test de coût d’Artificial Analysis sur un sous-ensemble de Big Bench Audio, Gemini 3.8 Live traite une heure d’audio en entrée pour 0,84 $.
Extended Thinking coûte 3,50 $ pour la même heure, Grok Voice Think Fast 2.0 coûte 4,80 $, et GPT-Live-1 Astra 5,83 $. Gemini 3.1 Flash Live se situait à 1,50 $ et 1,75 $ selon le niveau de « thinking ».
En lisant les deux barres Gemini ensemble, la stratégie produit saute aux yeux. Le modèle de base écrase tous les autres sur le prix, et le modèle de raisonnement qui rivalise avec OpenAI en qualité coûte encore 40 % de moins par heure d’entrée. Notez que le modèle de raisonnement consomme plus de tokens aux niveaux de thinking plus élevés, d’où un coût environ 4 fois supérieur à son jumeau malgré une grille tarifaire commune.
Gemini 3.8 Live est le bon défaut pour la plupart des agents vocaux, et Extended Thinking ne justifie sa consommation de tokens plus élevée que lorsque l’agent doit planifier, comparer ou attendre des outils lents. Les recommandations de Google tracent la frontière sur la latence des outils : si vos fonctions répondent en millisecondes, restez sur le modèle de base.
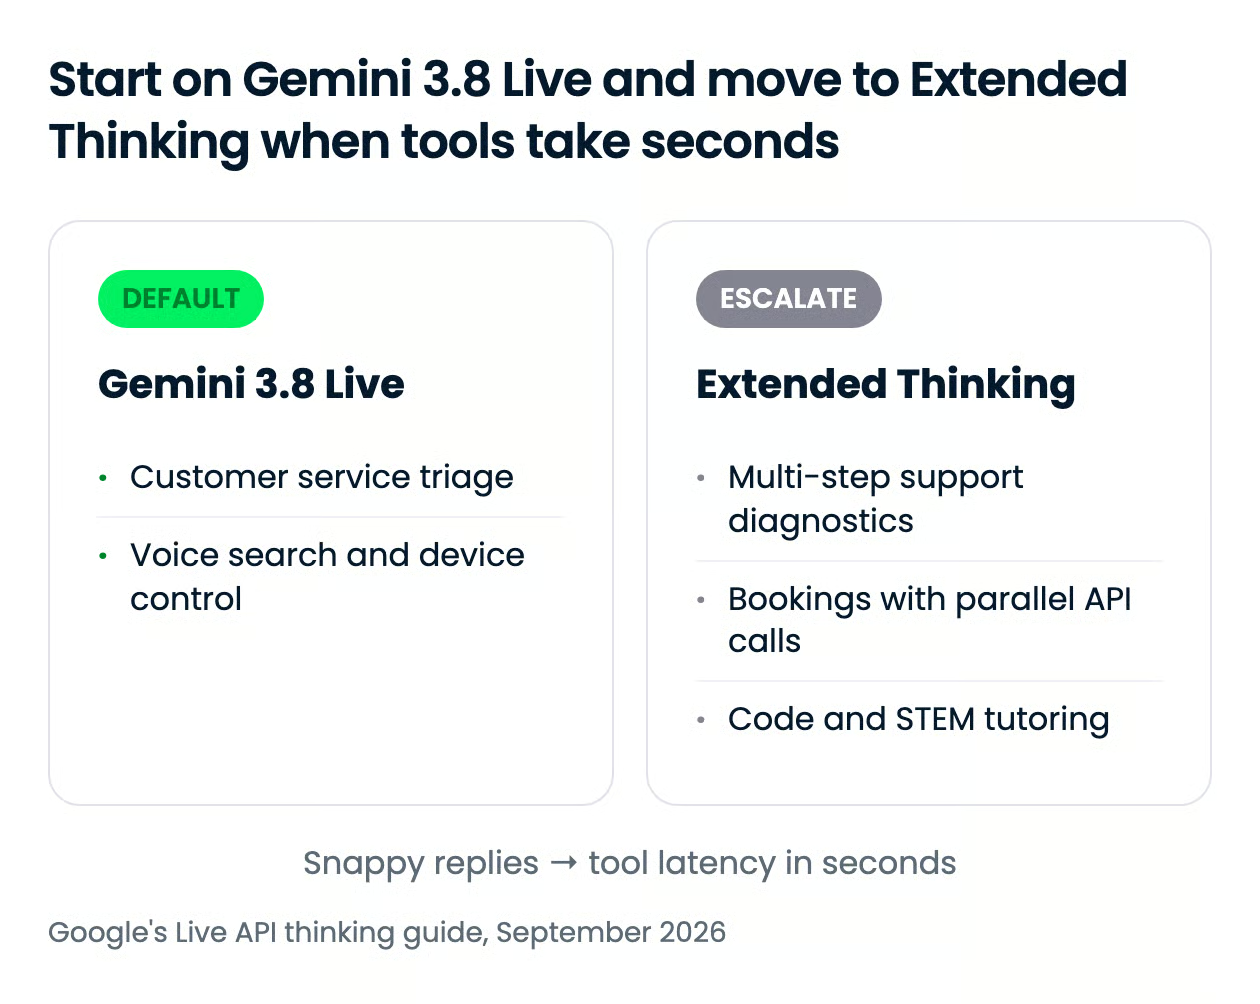
Les deux variantes partagent la même grille tarifaire (voir ci-dessous), des limites de tokens de 131 072 en entrée et 65 536 en sortie, et le même endpoint WebSocket. Ce qui les distingue, c’est l’architecture de raisonnement.
Gemini 3.8 Live utilise un raisonnement entrelacé avec une latence fixe et aucun réglage thinking_level. Extended Thinking expose des niveaux de raisonnement de fond low, medium et high, diffuse des « remplissages » conversationnels pendant qu’il travaille et exige des outils asynchrones. Ces niveaux de thinking sont le seul levier d’effort de cette version.
| Cas d’usage | Choix | Pourquoi |
|---|---|---|
| Tri en service client, recherche vocale, pratique des langues | Gemini 3.8 Live | L’échange immédiat compte plus que la profondeur, et chaque tour utilisateur appelle une unique réponse |
| Contrôle d’objets connectés, lecture de capteurs | Gemini 3.8 Live | Les outils répondent en millisecondes, rien à masquer |
| Support technique sur logs, codes d’erreur et vérifs de configuration | Extended Thinking | Un diagnostic multi-étapes nécessite du raisonnement de fond entre les énoncés |
| Voyage et réservation interrogeant vols et hôtels en parallèle | Extended Thinking | Appels asynchrones parallèles avec retours d’avancement parlés plutôt que du silence |
| Accompagnement STEM et code | Extended Thinking | Le modèle vérifie des formules ou débugge du code avant d’énoncer une explication |
Dernier point : la complexité côté client. Passer à Extended Thinking implique de réécrire votre gestion d’état autour de interaction_status ; si vous avez une appli 3.1 Flash Live fonctionnelle, le modèle de base est la mise à niveau à l’identique, et le modèle de raisonnement requiert un petit refactoring.
Les deux modèles partagent la grille de prix de Gemini 3.1 Flash Live Preview, donc la mise à niveau est gratuite. Sur l’offre payante, l’audio en entrée coûte 3,00 $ par million de tokens (Google l’estime à 0,005 $ la minute) et l’audio en sortie 12,00 $ par million de tokens, tokens de thinking inclus (environ 0,018 $ la minute). Les tokens de thinking sont facturés au tarif de sortie, ce qui explique le coût d’exécution plus élevé d’Extended Thinking.
| Modalité | Offre payante, par 1 M de tokens | Estimation par minute |
|---|---|---|
| Texte en entrée | 0,75 $ | n/a |
| Audio en entrée | 3,00 $ | 0,005 $/min |
| Image et vidéo en entrée | 1,00 $ | 0,002 $/min |
| Texte en sortie | 4,50 $ | n/a |
| Audio en sortie (tokens de thinking inclus) | 12,00 $ | 0,018 $/min |
L’offre gratuite couvre les deux modèles sans frais pour l’entrée et la sortie, avec la réserve habituelle : Google utilise les données du palier gratuit pour améliorer ses produits ; celles du palier payant ne sont pas utilisées à cet effet.
Le grounding avec Google Search est pris en charge sur les deux paliers, avec 5 000 requêtes de recherche gratuites par mois partagées sur tous les modèles Gemini 3.x, puis 14 $ par 1 000 requêtes. Google n’a pas publié de limites de débit spécifiques à ces modèles ; vérifiez la page des limites de l’API Gemini pour votre offre avant de planifier un lancement.
La disponibilité se décline en trois volets :
Toutes les sorties audio des deux modèles portent un filigrane SynthID, et la fiche modèle de Google est transparente sur les limites : les modèles peuvent encore halluciner, la résistance aux jailbreaks est en amélioration, et il peut y avoir des lenteurs ou timeouts ponctuels. À lire avant de mettre un modèle devant des clients.
Les identifiants de modèle sont gemini-3.8-live et gemini-3.8-live-extended-thinking, deux chaînes stables sans suffixe preview.
Vous pouvez y accéder via l’API Gemini Live avec le SDK google-genai pour Python ou JavaScript, via des WebSockets bruts, ou en interaction dans la vue Stream de Google AI Studio. Google liste également Agora, Fishjam, LiveKit, LangChain, Pipecat, Vercel et Vision Agents comme partenaires d’intégration gérant la couche de streaming média, et un chemin de streaming via l’Agent Development Kit si vous construisez déjà sur ADK.
La session Python minimale ci-dessous ouvre une connexion, envoie un tour en texte et active une transcription de sortie pour lire ce que le modèle a dit :
import asyncio
from google import genai

client = genai.Client()
config = {"response_modalities": ["AUDIO"], "output_audio_transcription": {}}

async def main():
    async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
        await session.send_client_content(
            turns={"role": "user", "parts": [{"text": "Read back the claim number 7Q-4418-B."}]},
            turn_complete=True,
        )
        async for response in session.receive():
            if response.server_content and response.server_content.output_transcription:
                print(response.server_content.output_transcription.text)

asyncio.run(main())
Si vous migrez depuis gemini-3.1-flash-live-preview, changez l’identifiant de modèle et supprimez tout thinking_level ou thinking_config de votre configuration ; le cycle d’un tour reste sinon identique. L’API Live est par défaut serveur-à-serveur ; les clients navigateur et mobile nécessitent des jetons éphémères.
Pour un pas-à-pas complet sur la capture audio, la lecture et la gestion de session, consultez notre tutoriel Gemini Live API, et pour la partie texte de la même famille, notre tutoriel Gemini 3.8 Flash API couvre les niveaux de thinking et l’appel de fonctions en Python.
Google mise sur le prix plus que sur la qualité brute. Extended Thinking devance GPT-Live-1 Astra d’un ou deux points sur chaque tableau, mais Gemini 3.8 Live à 0,84 $ par heure d’audio en entrée coûte près de 7 fois moins que le modèle d’OpenAI, et c’est ce chiffre qui oriente le trafic voix en production.
Mon avis : si vous faites tourner quoi que ce soit sur Gemini 3.1 Flash Live, mettez à jour cette semaine : le prix est identique et l’appel d’outils asynchrone vaut à lui seul la bascule. Si vous êtes sur la pile temps réel d’OpenAI, le modèle de base mérite un essai pour les flux de tri et de recherche, et Extended Thinking en mérite un partout où vos outils prennent des secondes. Les 30,1 % du modèle de base sur τ-Voice sont la raison de ne pas l’utiliser pour de l’agentique.
Pour construire correctement la partie appel d’outils d’un agent vocal, nous recommandons notre cours Building AI Agents with Google ADK, qui connecte Gemini à un agent de support client avec outils, garde-fous et délégation.
Formez-vous à l’IA agentique avec DataCamp !
Cours
Cours
Cours