
Corso
Creare agenti AI con Google ADK
1 h
7.5K
La voce è la sfida del mese. Nell’indice Speech to Speech di Artificial Analysis, GPT-Live-1 Astra di OpenAI e Grok Voice Think Fast 2.0 di SpaceXAI erano distanziati di 0,2 punti in cima alla classifica, e OpenAI ha rilasciato GPT-6 Astra a inizio settembre. Il 15 settembre, Google ha risposto con due nuovi modelli speech-to-speech: Gemini 3.8 Live e Gemini 3.8 Live Extended Thinking.
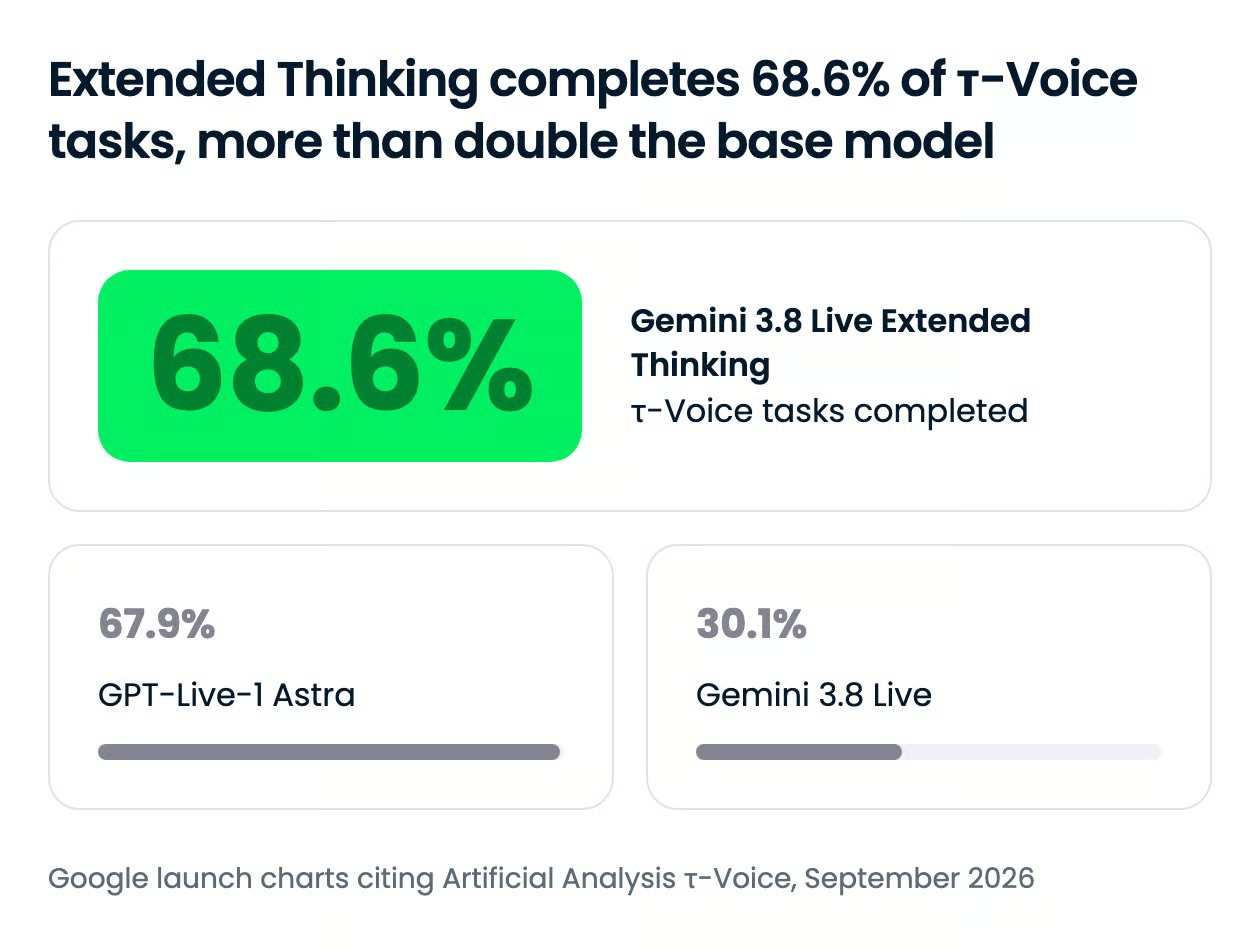
Extended Thinking conquista il primo posto in quell’indice con un punteggio di 82,6 e guida il benchmark agentico τ-Voice al 68,6%. Il modello base 3.8 Live è quello economico: nel test dei costi di Artificial Analysis elabora un’ora di audio in input per 0,84 $, il valore più basso tra i modelli riportati da Google. Entrambi sono generalmente disponibili oggi nella Gemini API allo stesso prezzo del loro predecessore, Gemini 3.1 Flash Live.
In questo articolo, vedremo tutte le novità di Gemini 3.8 Live: funzionalità, benchmark, differenze tra le due varianti e costi operativi. Puoi anche consultare le nostre guide per iniziare con la Gemini Live API e per costruire un assistente vocale con GPT-Live-1.
Gemini 3.8 Live è il modello speech-to-speech nativo di Google per agenti vocali in tempo reale, rilasciato il 15 settembre 2026 insieme a un fratello con maggiori capacità di ragionamento, Gemini 3.8 Live Extended Thinking. Entrambi funzionano tramite la Gemini Live API su connessione WebSocket, accettano audio, video, immagini e testo in input e restituiscono audio. Google posiziona 3.8 Live come impostazione predefinita per dialoghi a bassa latenza ed Extended Thinking come scelta per attività complesse e multi-step.
Il salto generazionale rispetto a Gemini 3.1 Flash Live riguarda il modo in cui il modello gestisce il lavoro che non è parlare. Le chiamate a strumenti e API ora vengono eseguite in background per impostazione predefinita mentre il modello continua la conversazione, ed Extended Thinking aggiunge sopra un ragionamento in background configurabile. Google descrive la coppia come un cambio di passo rispetto ai precedenti modelli live e come sostituzione delle pipeline a cascata che concatenano speech-to-text, un LLM e text-to-speech.
Google elenca cinque capacità per i nuovi modelli, e quelle che contano di più per chiunque stia costruendo un agente vocale sono le due che cambiano il ciclo conversazionale: chiamate a strumenti asincrone e ragionamento in background.
Entrambi i modelli eseguono chiamate di funzione e richieste API in background mentre trasmettono audio all’utente. Su Gemini 3.8 Live, l’esecuzione asincrona è ora la modalità predefinita per le chiamate di funzione. Puoi comunque forzare il vecchio comportamento sincrono impostando behavior: BLOCKING su una dichiarazione di strumento, e il modello supporta la pianificazione delle funzioni con le opzioni SILENT, WHEN_IDLE e INTERRUPTED che decidono quando un risultato viene pronunciato.
Extended Thinking va oltre: richiede strumenti non bloccanti e restituisce un errore se dichiari uno strumento bloccante. L’effetto pratico è che chi chiede di modificare una prenotazione sente subito un’acknowledgment, poi un aggiornamento di avanzamento, quindi il risultato, invece del silenzio che una pipeline a cascata produce mentre attende un’API. Su Gemini 3.1 Flash Live, le chiamate a funzione erano solo sequenziali e il modello non iniziava a rispondere finché non rimandavi indietro il risultato dello strumento.
Gemini 3.8 Live Extended Thinking ragiona e parla allo stesso tempo. La documentazione di Google descrive il modello che usa indizi verbali iniziali come "Lascia che controlli" per riconoscere il prompt, quindi narra i progressi mentre il lavoro multi-step in background viene completato. Controlli la profondità con thinking_level impostato su low, medium o high; il livello MINIMAL presente su 3.1 Flash Live non c’è più.
Questo cambia il protocollo, ed è a mio avviso il dettaglio di migrazione più importante del rilascio. Poiché il modello può parlare più volte durante una richiesta, turnComplete: true non significa più che sia inattivo.
Il tuo client deve osservare un nuovo campo interaction_status, che riporta IN_PROGRESS mentre sono in esecuzione ragionamenti o strumenti e IDLE quando l’intero compito è concluso. Se lo ignori, la tua UI tornerà a "ascolto" mentre il modello è ancora a metà del compito.
Gemini 3.8 Live ancora il dialogo all’input visivo live, elaborando frame video quasi in tempo reale così che un agente possa rispondere a ciò che l’utente guarda oltre che a ciò che dice. Le demo di Google includono una partita di scacchi in diretta e un onboarding aziendale in cui il modello risponde a domande su ciò che è sullo schermo.
Il video però non è gratis. La copertura del turno ora predefinisce l’invio al modello dell’attività audio più tutti i frame video, quindi se la tua app non ha bisogno della visione, dovresti inviare i frame solo quando sono utili, sia per il budget di contesto sia per il costo. Le sessioni audio+video sono inoltre limitate a 2 minuti prima di doverle estendere con gestione sessioni, contro i 15 minuti delle sessioni solo audio.
Google chiama questo "precisione alfanumerica": l’analisi accurata di stringhe come codici di conferma, numeri di pratica e identificatori tecnici pronunciati a voce. Chiunque abbia costruito un agente vocale per supporto o logistica sa che qui gli stack a cascata crollano, perché un errore di speech-to-text all’inizio della catena è irrecuperabile a valle. Un modello speech nativo che ascolta l’intera frase nel contesto ha un vantaggio strutturale qui.
Gemini 3.8 Live rileva e passa tra 97 lingue supportate durante una conversazione, con quella che Google chiama coerenza d’accento tra le lingue. Entrambi i modelli supportano anche quelli che Google definisce aggiornamenti incrementali dei contenuti: puoi inviare dati strutturati nella sessione in qualsiasi momento, con un ruolo esplicito user o model, e il modello li unisce all’audio live. È così che inserisci una scheda cliente o lo stato di un ordine in una chiamata in corso senza interrompere il flusso.
Due cambiamenti minori influiscono sul codice esistente. L’audio proattivo, in cui il modello può decidere di non rispondere a discorsi non a lui diretti, è ora sempre attivo, e impostarlo a false restituisce un errore. Il dialogo affettivo è stato rimosso completamente dall’API, quindi qualsiasi configurazione enable_affective_dialog va eliminata.
Extended Thinking è in testa a tutte le classifiche di qualità e agentiche pubblicate da Google, ma con margini ridotti su GPT-Live-1 Astra di OpenAI, mentre il modello base 3.8 Live vince nettamente sui costi ma perde nei compiti agentici.
L’indice, τ-Voice, Big Bench Audio e le cifre sui costi qui sotto sono tutte sulla leaderboard pubblica di Artificial Analysis, quindi misurate in modo indipendente e non riportate dal fornitore. I numeri di τ³-Banking provengono dal grafico di lancio di Google che cita Sierra, quindi considera quella riga come riportata dal fornitore finché la classifica di Sierra non mostrerà lo stesso.
Gemini 3.8 Live Extended Thinking guida su τ-Voice, il benchmark di Sierra che misura se un agente vocale completa compiti multi-step con strumenti, come rilevato da Artificial Analysis. GPT-Live-1 Astra è poco dietro, con il resto della concorrenza staccato:
Il numero che mi ha sorpreso è che il punteggio del modello base su τ-Voice sia sotto quello del suo stesso predecessore. Google è esplicita: 3.8 Live è costruito per scalabilità ed efficienza dei costi più che per workflow complessi, ma un divario di oltre 38 punti tra le due varianti significa che la scelta del livello non è una sottigliezza. Se il tuo agente concatena strumenti, il modello base è la scelta sbagliata.
Sulla leaderboard τ³-Banking di Sierra, un benchmark di assistenza clienti più difficile basato su workflow bancari, Extended Thinking ottiene il 35,1% contro il 32,0% di GPT-Live-1 Astra, il 16,5% di Grok Voice Think Fast 2.0 di SpaceXAI, l’11,3% di Gemini 3.1 Flash Live e il 10,3% di GPT-Realtime 2. Ogni modello in quella classifica fallisce la maggior parte delle volte, il che indica quanto gli agenti vocali siano ancora lontani dal lavoro bancario non supervisionato, ma un triplicamento rispetto alla generazione Gemini precedente è un vero passo avanti.
Nello Speech to Speech Index, anche qui Extended Thinking supera di poco la concorrenza:
Un vantaggio di 1,1 punti su OpenAI è pur sempre un vantaggio, ma non ci baserei una decisione d’acquisto.
Per il puro ragionamento su input parlato, Google riporta il 97,7% su Big Bench Audio per Extended Thinking. Google riporta anche che entrambi i modelli spingono la frontiera di Pareto su EVA-Bench di ServiceNow per agenti vocali, bilanciando accuratezza e qualità conversazionale, anche se quell’esecuzione è stata fatta sulla Live API tramite la Gemini Enterprise Agent Platform e non tramite l’API pubblica.
Questo è il grafico che Google vuole farti vedere. Nel test dei costi di Artificial Analysis sul sottoinsieme Big Bench Audio, Gemini 3.8 Live elabora un’ora di audio in input per 0,84 $.
Extended Thinking costa 3,50 $ per la stessa ora, Grok Voice Think Fast 2.0 costa 4,80 $ e GPT-Live-1 Astra costa 5,83 $. Gemini 3.1 Flash Live era a 1,50 $ e 1,75 $ a seconda del livello di thinking.
Leggendo insieme le due barre di Gemini, la strategia di prodotto è evidente. Il modello base batte tutto il resto in classifica con ampio margine, e il modello di ragionamento che eguaglia OpenAI in qualità costa comunque il 40% in meno per ora di input. Nota che il modello di ragionamento consuma più token ai livelli di thinking più alti, motivo per cui costa circa 4 volte il suo fratello nonostante condividano il listino.
Gemini 3.8 Live è la scelta predefinita giusta per la maggior parte degli agenti vocali, ed Extended Thinking vale il maggior consumo di token solo quando l’agente deve pianificare, confrontare o attendere strumenti lenti. Le linee guida di Google tracciano il confine sulla latenza degli strumenti: se le tue funzioni rispondono in millisecondi, resta sul modello base.
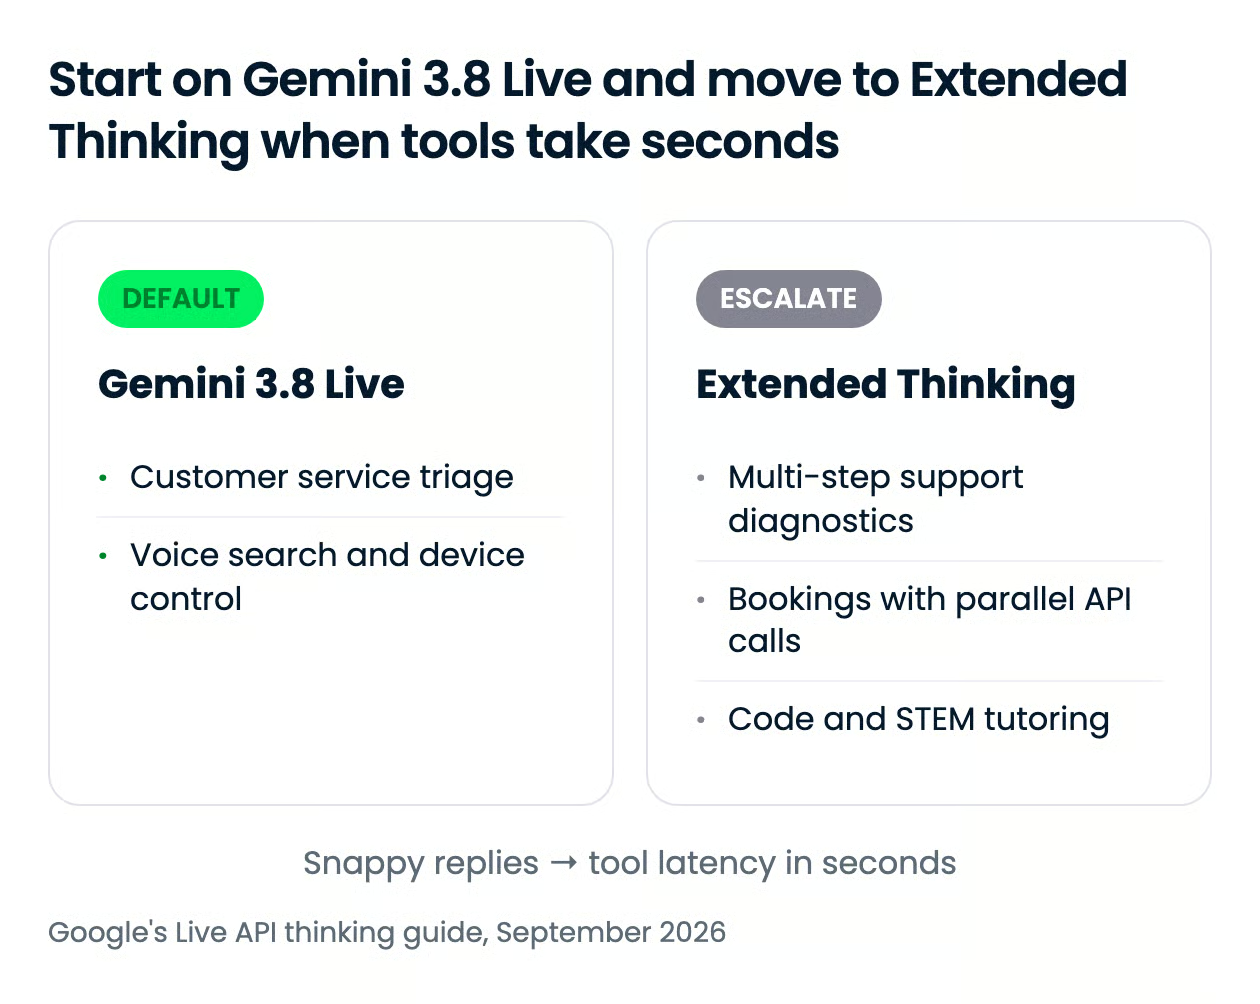
Le due varianti condividono il listino prezzi (che vedremo sotto), i limiti di token di 131.072 in input e 65.536 in output e lo stesso endpoint WebSocket. Ciò che le distingue è l’architettura di ragionamento.
Gemini 3.8 Live usa ragionamento interleaved con un profilo di latenza fisso e senza alcuna impostazione di thinking_level. Extended Thinking espone ragionamento in background low, medium e high, trasmette riempitivi conversazionali mentre lavora e richiede strumenti asincroni. Quei livelli di thinking sono l’unico controllo dello sforzo nel rilascio.
| Caso d’uso | Scelta | Perché |
|---|---|---|
| Triaging del supporto clienti, ricerca vocale, pratica linguistica | Gemini 3.8 Live | Il turn-taking immediato conta più della profondità, e ogni turno dell’utente ottiene una risposta |
| Controllo dispositivi smart, lettura valori sensori | Gemini 3.8 Live | Gli strumenti rispondono in millisecondi, quindi non c’è nulla da mascherare |
| Supporto tecnico su log, codici di errore e verifiche di configurazione | Extended Thinking | Una diagnosi multi-step richiede ragionamento in background tra le frasi |
| Agenti viaggio e prenotazioni che interrogano voli e hotel in parallelo | Extended Thinking | Chiamate asincrone in parallelo con aggiornamenti vocali di avanzamento invece del silenzio |
| Tutoraggio STEM e codice | Extended Thinking | Il modello verifica formule o fa il debug del codice prima di pronunciare la spiegazione |
Un’ulteriore considerazione: la complessità del client. Passare a Extended Thinking significa riscrivere la gestione dello stato attorno a interaction_status, quindi se hai un’app 3.1 Flash Live funzionante, il modello base è l’upgrade drop-in, mentre il modello di ragionamento richiede un piccolo refactor.
Entrambi i modelli condividono il listino della Gemini 3.1 Flash Live Preview, quindi l’upgrade è gratuito. Nel piano a pagamento, l’input audio costa 3,00 $ per 1 milione di token (Google stima 0,005 $ al minuto) e l’output audio costa 12,00 $ per 1 milione di token, inclusi i thinking token (circa 0,018 $ al minuto). I thinking token sono fatturati alla tariffa dell’output, da cui deriva il costo operativo più alto di Extended Thinking.
| Modalità | Piano a pagamento, per 1M token | Stima al minuto |
|---|---|---|
| Input testo | $0.75 | n/d |
| Input audio | $3.00 | $0.005/min |
| Input immagine e video | $1.00 | $0.002/min |
| Output testo | $4.50 | n/d |
| Output audio (inclusi thinking token) | $12.00 | $0.018/min |
Il piano gratuito copre entrambi i modelli senza addebiti per input e output, con la solita avvertenza che Google usa i dati del piano gratuito per migliorare i suoi prodotti; i dati del piano a pagamento non vengono usati a questo scopo.
L’ancoraggio a Google Search è supportato in entrambi i piani, con 5.000 richieste di ricerca gratuite al mese condivise tra tutti i modelli Gemini 3.x e 14 $ per 1.000 richieste oltre tale soglia. Google non ha pubblicato limiti di velocità specifici per questi modelli, quindi controlla la pagina dei rate limit della Gemini API per il tuo piano prima di pianificare un lancio.
La disponibilità è divisa in tre:
Ogni output audio di entrambi i modelli porta una filigrana SynthID, e la scheda del modello di Google è trasparente sui limiti: i modelli possono ancora allucinare, la resistenza ai jailbreak è ancora in miglioramento e possono verificarsi occasionali lentezze o timeout. Queste avvertenze valgono la pena di essere lette prima di mettere uno dei due modelli davanti ai clienti.
Gli ID dei modelli sono gemini-3.8-live e gemini-3.8-live-extended-thinking, entrambi stringhe stabili senza suffisso preview.
Puoi raggiungerli tramite la Gemini Live API con l’SDK google-genai per Python o JavaScript, tramite WebSocket grezzi o in modo interattivo nella vista Stream di Google AI Studio. Google elenca anche Agora, Fishjam, LiveKit, LangChain, Pipecat, Vercel e Vision Agents come partner di integrazione che gestiscono il layer di streaming multimediale, e c’è un percorso di streaming dell’Agent Development Kit se stai già costruendo su ADK.
La sessione Python minima qui sotto apre una connessione, invia un turno di testo e attiva una trascrizione in output così da poter leggere cosa ha detto il modello:
import asyncio
from google import genai

client = genai.Client()
config = {"response_modalities": ["AUDIO"], "output_audio_transcription": {}}

async def main():
    async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
        await session.send_client_content(
            turns={"role": "user", "parts": [{"text": "Read back the claim number 7Q-4418-B."}]},
            turn_complete=True,
        )
        async for response in session.receive():
            if response.server_content and response.server_content.output_transcription:
                print(response.server_content.output_transcription.text)

asyncio.run(main())
Se stai migrando da gemini-3.1-flash-live-preview, cambia la stringa del modello ed elimina qualsiasi thinking_level o thinking_config dalla tua configurazione; il ciclo di vita del turno è altrimenti identico. La Live API è server-to-server per impostazione predefinita, quindi i client browser e mobile hanno bisogno di token effimeri.
Per una guida completa su acquisizione audio, riproduzione e gestione sessioni, vedi il nostro tutorial sulla Gemini Live API, e per il lato testuale della stessa famiglia, il nostro tutorial sulla Gemini 3.8 Flash API copre livelli di thinking e function calling in Python.
Google fa una dichiarazione sul prezzo più che sulla qualità pura. Il vantaggio di Extended Thinking su GPT-Live-1 Astra è di un punto o due in ogni classifica, ma Gemini 3.8 Live a 0,84 $ per ora di audio in input costa quasi 7 volte meno del modello di OpenAI, e questo è il numero che decide dove va il traffico vocale in produzione.
La mia opinione: se esegui qualcosa su Gemini 3.1 Flash Live, aggiorna questa settimana, dato che il prezzo è lo stesso e il solo tool calling asincrono vale il cambiamento. Se usi lo stack realtime di OpenAI, il modello base vale una prova per i flussi di triage e ricerca, ed Extended Thinking vale una prova ovunque i tuoi strumenti impieghino secondi. Il 30,1% del modello base su τ-Voice è il motivo per non usarlo per nulla di agentico.
Se vuoi costruire correttamente il lato tool-calling di un agente vocale, ti consiglio il nostro corso Building AI Agents with Google ADK, che collega Gemini a un agente di supporto clienti con strumenti, guardrail e delega.
Impara l’Agentic AI con DataCamp!
Corso
Corso
Corso