course
Construirea agenților AI cu Google ADK
1 oră
7.5K
Vocea e tema lunii. În Speech to Speech Index al Artificial Analysis, GPT-Live-1 Astra de la OpenAI și Grok Voice Think Fast 2.0 de la SpaceXAI erau despărțite de 0,2 puncte în top, iar OpenAI a lansat GPT-6 Astra la începutul lui septembrie. Pe 15 septembrie, Google a răspuns cu două noi modele speech-to-speech: Gemini 3.8 Live și Gemini 3.8 Live Extended Thinking.
Extended Thinking a urcat pe primul loc în acel index cu un scor de 82,6 și conduce benchmarkul agentic τ-Voice cu 68,6%. Modelul de bază 3.8 Live e cel ieftin: în testul de cost al Artificial Analysis procesează o oră de audio de intrare pentru 0,84 $, cel mai mic dintre toate modelele Google din grafic. Ambele sunt disponibile în general în Gemini API de azi, la același preț ca predecesorul lor, Gemini 3.1 Flash Live.
În acest articol, acopăr tot ce e nou la Gemini 3.8 Live: funcțiile, benchmarkurile, diferențele dintre cele două variante și cât costă să rulezi modelul. Poți vedea și ghidurile noastre pentru primele pași cu Gemini Live API și cum construiești un asistent vocal cu GPT-Live-1.
Gemini 3.8 Live este modelul nativ speech-to-speech al Google pentru agenți vocali în timp real, lansat pe 15 septembrie 2026 alături de un frate cu raționament mai avansat, Gemini 3.8 Live Extended Thinking. Ambele rulează prin Gemini Live API peste o conexiune WebSocket, acceptă audio, video, imagini și text ca intrare și returnează audio. Google poziționează 3.8 Live ca implicit pentru dialog cu latență redusă, iar Extended Thinking ca alegerea pentru sarcini complexe, în mai mulți pași.
Schimbarea generațională față de Gemini 3.1 Flash Live ține de modul în care modelul gestionează munca ce nu înseamnă vorbit. Apelurile de unelte și API rulează acum în fundal în mod implicit, în timp ce modelul continuă conversația, iar Extended Thinking adaugă deasupra un raționament în fundal configurabil. Google descrie perechea ca un salt față de modelele sale live anterioare și ca un înlocuitor pentru pipeline-urile în cascadă care leagă speech-to-text, un LLM și text-to-speech.
Google enumeră cinci capabilități pentru noile modele, iar cele mai importante pentru oricine construiește un agent vocal sunt cele două care schimbă bucla conversațională: apeluri de unelte asincrone și raționament în fundal.
Ambele modele execută apeluri de funcții și cereri API în fundal, în timp ce trimit audio înapoi către utilizator. Pe Gemini 3.8 Live, execuția asincronă este acum modul implicit pentru apelarea funcțiilor. Poți forța în continuare vechiul comportament sincron setând behavior: BLOCKING pe o declarație de unealtă, iar modelul acceptă programarea funcțiilor cu opțiunile SILENT, WHEN_IDLE și INTERRUPTED, care decid când este rostit rezultatul.
Extended Thinking merge mai departe: necesită unelte non-blocante și returnează o eroare clară dacă declari una blocantă. Efectul practic este că un apelant care cere schimbarea unei rezervări aude imediat o confirmare, apoi un update de progres, apoi rezultatul, în loc de tăcerea pe care o produce un pipeline în cascadă cât timp așteaptă un API. Pe Gemini 3.1 Flash Live, apelarea funcțiilor era doar secvențială, iar modelul nu începea să răspundă până nu îi trimiteai înapoi rezultatul uneltei.
Gemini 3.8 Live Extended Thinking face raționament și vorbește în același timp. Documentația Google descrie modelul folosind indicii verbale timpurii precum „Lasă-mă să verific asta” pentru a confirma promptul, apoi narațiunea progresului pe măsură ce munca în fundal, cu mai mulți pași, se finalizează. Controlezi profunzimea cu thinking_level setat la low, medium sau high; nivelul MINIMAL existent pe 3.1 Flash Live a dispărut.
Asta schimbă protocolul și, cred, este cel mai important detaliu de migrare din lansare. Pentru că modelul poate vorbi de mai multe ori în cadrul aceleiași cereri, turnComplete: true nu mai înseamnă că e în repaus.
Clientul tău trebuie să urmărească un nou câmp, interaction_status, care raportează IN_PROGRESS cât timp rulează raționamentul sau uneltele și IDLE când întregul task s-a încheiat. Dacă sari peste asta, UI-ul tău va reveni la „ascultă” în timp ce modelul este încă la mijlocul sarcinii.
Gemini 3.8 Live ancorează dialogul în intrare vizuală live, procesând cadre video aproape în timp real, astfel încât un agent poate răspunde la ceea ce utilizatorul privește, nu doar la ce spune. Demo-urile Google includ un joc de șah live și un onboarding de angajați în care modelul răspunde la întrebări despre ce e pe ecran.
Video-ul nu e gratuit, însă. Acoperirea unui tur implică acum trimiterea activității audio plus a tuturor cadrelor video către model, așa că, dacă aplicația ta nu are nevoie de vedere, ar trebui să trimiți cadre doar când sunt utile, atât pentru bugetul de context, cât și pentru cost. Sesiunile audio-plus-video sunt, de asemenea, limitate la 2 minute înainte să ai nevoie de managementul sesiunii pentru a le extinde, față de 15 minute pentru sesiunile doar audio.
Google numește asta „precizie alfanumerică”: parsarea corectă a șirurilor precum coduri de confirmare, numere de cerere și identificatori tehnici rostite cu voce tare. Oricine a construit un agent vocal pentru suport sau logistică știe că aici se împiedică stack-urile în cascadă, deoarece o eroare de speech-to-text devreme în lanț e nerecuperabilă ulterior. Un model speech nativ care aude întreaga propoziție în context are aici un avantaj structural.
Gemini 3.8 Live detectează și comută între 97 de limbi acceptate în timpul unei conversații, cu ceea ce Google numește consistență a accentului între ele. Ambele modele acceptă și ceea ce Google numește actualizări incrementale de conținut: poți trimite date structurate în sesiune în orice moment, cu un rol explicit user sau model, iar modelul le unește cu audio-ul live. Așa introduci o fișă de client sau un status de comandă într-un apel în curs fără să întrerupi fluxul.
Două schimbări mai mici afectează codul existent. Audio proactiv, unde modelul poate decide să nu răspundă la vorbirea care nu i se adresează, este acum permanent activ, iar setarea lui la false returnează o eroare. Dialogul afectiv a fost eliminat complet din API, deci orice configurare enable_affective_dialog trebuie scoasă.
Extended Thinking conduce toate graficele de calitate și agentice publicate de Google, dar la diferențe mici față de GPT-Live-1 Astra de la OpenAI, în timp ce modelul 3.8 Live de bază câștigă clar la cost, dar pierde la sarcini agentice.
Indexul, τ-Voice, Big Bench Audio și cifrele de cost de mai jos sunt toate pe leaderboardul public al Artificial Analysis, deci sunt măsurate independent, nu raportate de furnizori. Valorile τ³-Banking vin din graficul de lansare al Google, citând Sierra, deci tratează acel rând ca raportat de furnizor până când boardul Sierra arată același lucru.
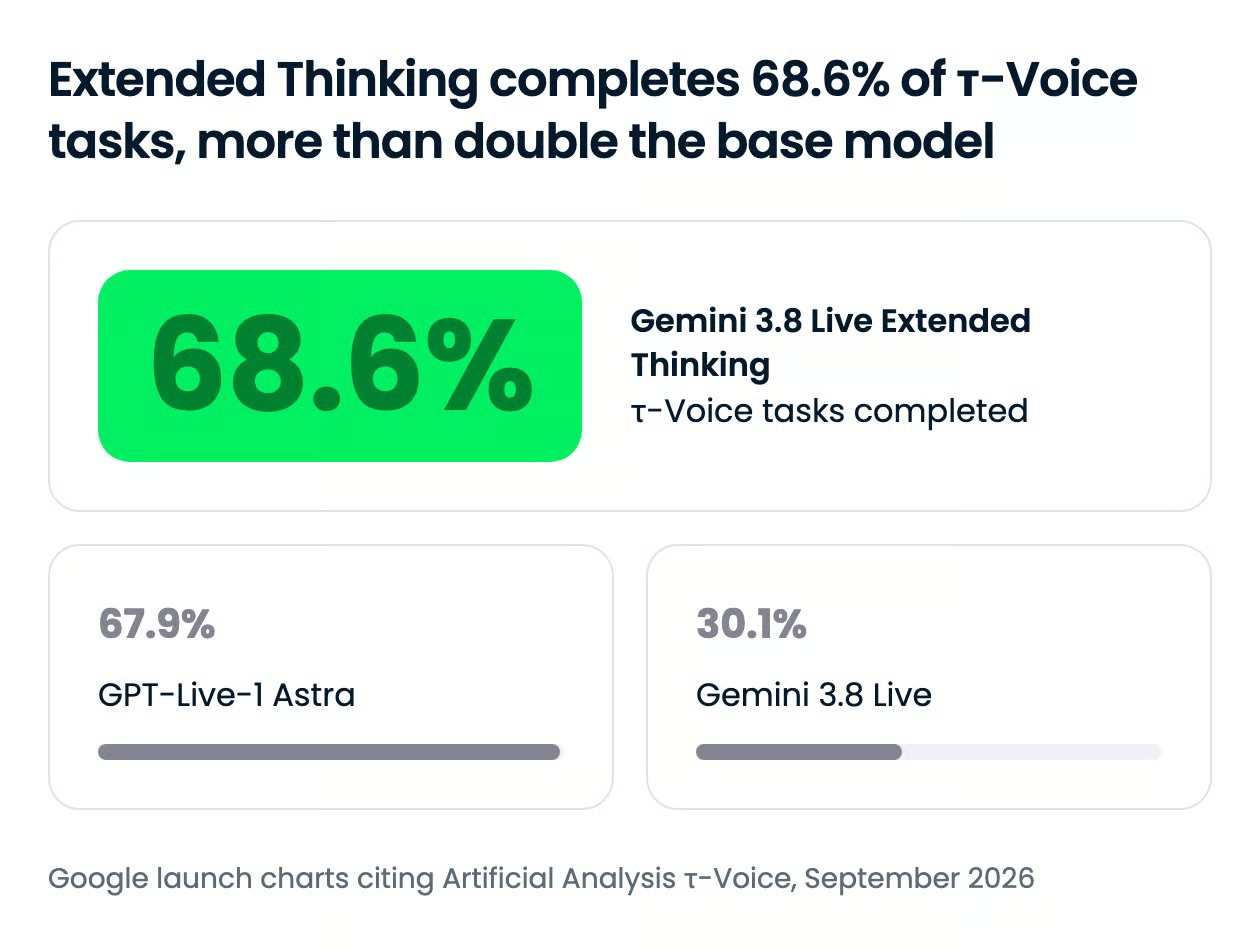
Gemini 3.8 Live Extended Thinking conduce pe τ-Voice, benchmarkul Sierra pentru dacă un agent vocal finalizează sarcini multi-pas cu unelte, așa cum este măsurat de Artificial Analysis. GPT-Live-1 Astra e aproape, restul competiției rămâne în urmă:
Numărul care m-a surprins este că scorul modelului de bază pe τ-Voice stă sub propriul său predecesor. Google spune explicit că 3.8 Live este construit pentru scală și eficiență a costurilor, nu pentru fluxuri complexe, dar un ecart de peste 38 de puncte între cele două variante înseamnă că alegerea nivelului nu e o nuanță. Dacă agentul tău leagă unelte, modelul de bază este defaultul greșit.
Pe leaderboardul τ³-Banking al Sierra, un benchmark mai greu de customer service, construit în jurul fluxurilor bancare, Extended Thinking obține 35,1% față de 32,0% pentru GPT-Live-1 Astra, 16,5% pentru Grok Voice Think Fast 2.0 de la SpaceXAI, 11,3% pentru Gemini 3.1 Flash Live și 10,3% pentru GPT-Realtime 2. Fiecare model de pe acel board eșuează de cele mai multe ori, ceea ce îți spune cât de departe sunt agenții vocali de munca bancară nesupravegheată, dar o triplare față de generația anterioară de Gemini e un pas real.
În Speech to Speech Index, Extended Thinking depășește competiția, de asemenea:
Un avans de 1,1 puncte față de OpenAI e tot un avans, dar nu mi-aș baza o decizie de achiziție pe el.
Pentru raționament pur pe intrare vorbită, Google raportează 97,7% pe Big Bench Audio pentru Extended Thinking. Google mai raportează că ambele modele împing frontiera Pareto pe EVA-Bench de la ServiceNow pentru agenți vocali, echilibrând acuratețea cu calitatea conversației, deși acea rulare a fost făcută pe Live API prin Gemini Enterprise Agent Platform, nu prin API-ul public.
Acesta e graficul pe care Google vrea cel mai mult să-l vezi. În testul de cost al Artificial Analysis pe subsetul Big Bench Audio, Gemini 3.8 Live procesează o oră de audio de intrare pentru 0,84 $.
Extended Thinking costă 3,50 $ pentru aceeași oră, Grok Voice Think Fast 2.0 costă 4,80 $, iar GPT-Live-1 Astra costă 5,83 $. Gemini 3.1 Flash Live era la 1,50 $ și 1,75 $ în funcție de nivelul de gândire.
Privește cele două bare Gemini împreună și strategia de produs e clară. Modelul de bază subcotă tot ce e pe grafic la o diferență mare, iar modelul de raționament care se potrivește cu OpenAI la calitate tot costă cu 40% mai puțin pe oră de intrare. Reține că modelul de raționament arde mai mulți tokeni la niveluri de gândire mai înalte, motiv pentru care costă cam de 4 ori cât fratele său, deși împart aceeași grilă de prețuri.
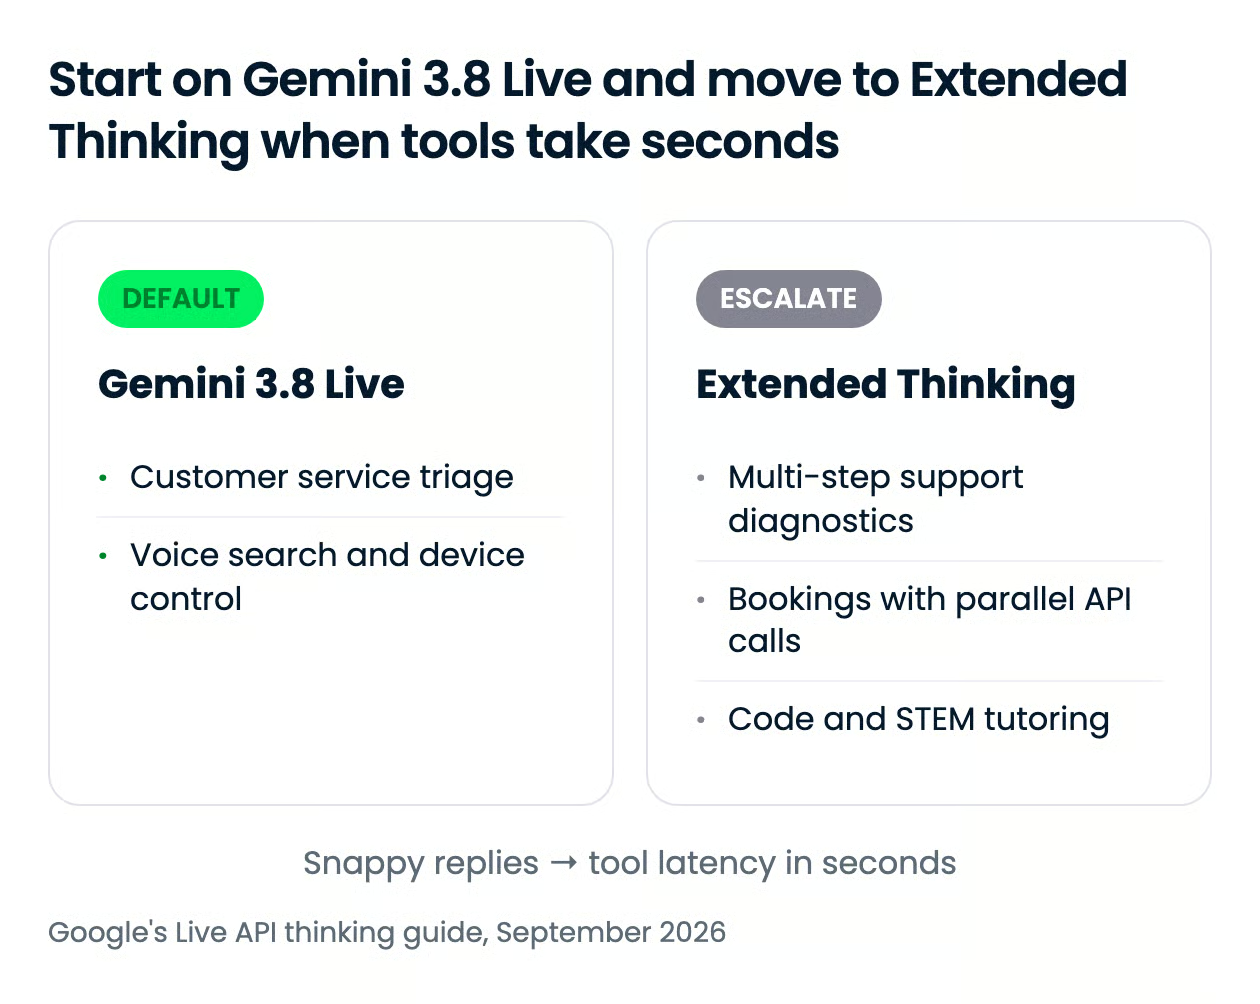
Gemini 3.8 Live e defaultul potrivit pentru majoritatea agenților vocali, iar Extended Thinking își merită consumul mai mare de tokeni doar când agentul trebuie să planifice, să compare sau să aștepte unelte lente. Ghidajul Google trasează linia la latența uneltelor: dacă funcțiile tale răspund în milisecunde, rămâi pe modelul de bază.
Cele două variante împart o grilă de prețuri (pe care o detaliez mai jos), limite de tokeni de 131.072 la intrare și 65.536 la ieșire și același endpoint WebSocket. Ce le separă e arhitectura de raționament.
Gemini 3.8 Live folosește raționament intercalat cu un profil de latență fix și fără setare thinking_level. Extended Thinking expune raționament în fundal low, medium și high, transmite umpluturi conversaționale cât timp lucrează și necesită unelte asincrone. Aceste niveluri de gândire sunt singurul control al efortului din lansare.
| Caz de utilizare | Alegere | De ce |
|---|---|---|
| Triere pentru customer service, căutare vocală, practică de limbă | Gemini 3.8 Live | Schimbul imediat de replici contează mai mult decât profunzimea, iar fiecare tur al utilizatorului primește un răspuns |
| Control dispozitive inteligente, citire valori senzori | Gemini 3.8 Live | Uneltele răspund în milisecunde, deci nu e nimic de mascat |
| Suport tehnic pe loguri, coduri de eroare și verificări de configurare | Extended Thinking | Un diagnostic multi-pas are nevoie de raționament în fundal între replici |
| Agenți de călătorii și rezervări care interoghează zboruri și hoteluri în paralel | Extended Thinking | Apeluri asincrone paralele cu update-uri de progres rostite în loc de tăcere |
| Tutorat STEM și programare | Extended Thinking | Modelul verifică formulele sau face debugging înainte să rostească explicația |
Încă un aspect: complexitatea pe client. Trecerea la Extended Thinking înseamnă rescrierea gestionării stării în jurul interaction_status, așa că, dacă ai o aplicație 3.1 Flash Live funcțională, modelul de bază e upgrade-ul drop-in, iar modelul cu raționament cere un mic refactor.
Ambele modele împart grila de prețuri Gemini 3.1 Flash Live Preview, deci upgrade-ul e gratuit. Pe nivelul plătit, intrarea audio costă 3,00 $ per 1 milion de tokeni, ceea ce Google estimează la 0,005 $ pe minut, iar ieșirea audio costă 12,00 $ per 1 milion de tokeni, adică aproximativ 0,018 $ pe minut. Tokenii de „thinking” se facturează la rata de ieșire, ceea ce explică de unde vine costul de rulare mai mare pentru Extended Thinking.
| Modalitate | Plan plătit, per 1M tokeni | Estimare pe minut |
|---|---|---|
| Text input | $0.75 | n/a |
| Audio input | $3.00 | $0.005/min |
| Image și video input | $1.00 | $0.002/min |
| Text output | $4.50 | n/a |
| Audio output (inclusiv tokeni de thinking) | $12.00 | $0.018/min |
Planul gratuit acoperă ambele modele fără cost pentru intrare și ieșire, cu obișnuita mențiune că Google folosește datele din planul gratuit pentru a-și îmbunătăți produsele; datele din planul plătit nu sunt folosite astfel.
Grounding cu Google Search este acceptat pe ambele planuri, cu 5.000 de cereri de căutare gratuite pe lună împărțite între toate modelele Gemini 3.x și 14 $ per 1.000 de cereri după aceea. Google nu a publicat limite de rată specifice acestor modele, așa că verifică pagina de rate-limits pentru Gemini API pentru planul tău înainte de a planifica o lansare.
Disponibilitatea e împărțită în trei:
Fiecare ieșire audio din ambele modele poartă un filigran SynthID, iar fișa de model a Google e sinceră despre limite: modelele pot încă să halucineze, rezistența la jailbreak încă se îmbunătățește și pot apărea uneori încetiniri sau time-out-uri. Merită citite aceste avertismente înainte să pui vreunul dintre modele în fața clienților.
ID-urile de model sunt gemini-3.8-live și gemini-3.8-live-extended-thinking, ambele șiruri stabile fără sufix de preview.
Poți ajunge la ele prin Gemini Live API cu SDK-ul google-genai pentru Python sau JavaScript, prin WebSocketuri brute sau interactiv în vizualizarea Stream din Google AI Studio. Google mai listează Agora, Fishjam, LiveKit, LangChain, Pipecat, Vercel și Vision Agents ca parteneri de integrare care gestionează stratul de streaming media, și există o cale de streaming prin Agent Development Kit dacă deja construiești pe ADK.
Python minim de mai jos deschide o conexiune, trimite un tur de text și pornește o transcriere de ieșire ca să poți citi ce a spus modelul:
import asyncio
from google import genai

client = genai.Client()
config = {"response_modalities": ["AUDIO"], "output_audio_transcription": {}}

async def main():
    async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
        await session.send_client_content(
            turns={"role": "user", "parts": [{"text": "Read back the claim number 7Q-4418-B."}]},
            turn_complete=True,
        )
        async for response in session.receive():
            if response.server_content and response.server_content.output_transcription:
                print(response.server_content.output_transcription.text)

asyncio.run(main())
Dacă migrezi de la gemini-3.1-flash-live-preview, schimbă șirul de model și șterge orice thinking_level sau thinking_config din configurare; ciclul de tur e altfel identic. Live API este implicit server-to-server, așa că browserele și clienții mobili au nevoie de tokenuri efemere.
Pentru un walkthrough complet al capturii audio, redării și managementului sesiunii, vezi tutorialul Gemini Live API, iar pentru partea pe text din aceeași familie, tutorialul Gemini 3.8 Flash API acoperă nivelurile de gândire și apelarea funcțiilor în Python.
Google face o declarație prin preț, nu prin calitatea brută. Avansul lui Extended Thinking față de GPT-Live-1 Astra e de un punct sau două pe fiecare grafic, dar Gemini 3.8 Live la 0,84 $ pe oră de audio de intrare este de aproape 7 ori mai ieftin decât modelul OpenAI, iar acesta este numărul care decide unde merge traficul vocal de producție.
Părerea mea: dacă rulezi ceva pe Gemini 3.1 Flash Live, fă upgrade săptămâna asta, din moment ce prețul e același și apelarea asincronă a uneltelor singură merită. Dacă rulezi pe stiva realtime a OpenAI, modelul de bază merită un test pentru fluxurile de triere și căutare, iar Extended Thinking merită unul oriunde uneltele tale durează secunde. Scorul de 30,1% al modelului de bază pe τ-Voice e motivul să nu-l folosești pentru nimic agentic.
Dacă vrei să construiești corect partea de apelare a uneltelor într-un agent vocal, îți recomand cursul nostru Building AI Agents with Google ADK, care conectează Gemini într-un agent de suport clienți cu unelte, garduri de protecție și delegare.
Învață Agentic AI cu DataCamp!
course
course
course