
Kurs
KI-Agenten mit dem Google ADK entwickeln
1 Std.
7.5K
Voice ist das Thema des Monats. Auf dem Speech to Speech Index von Artificial Analysis lagen OpenAIs GPT-Live-1 Astra und SpaceXAIs Grok Voice Think Fast 2.0 an der Spitze nur 0,2 Punkte auseinander, und OpenAI hat Anfang September GPT-6 Astra ausgeliefert. Am 15. September antwortete Google mit zwei neuen Speech-to-Speech-Modellen: Gemini 3.8 Live und Gemini 3.8 Live Extended Thinking.
Extended Thinking übernimmt mit 82,6 Punkten Platz eins in diesem Index und führt das τ-Voice-Agenten-Benchmark mit 68,6% an. Das Basis-Modell 3.8 Live ist das günstige: Im Kostenvergleich von Artificial Analysis verarbeitet es eine Stunde Eingabeaudio für 0,84 $, der niedrigste Wert aller von Google gecharteten Modelle. Beide sind ab sofort allgemein über die Gemini API verfügbar – zum gleichen Preis wie ihr Vorgänger Gemini 3.1 Flash Live.
In diesem Artikel erfährst du alles Neue rund um Gemini 3.8 Live: Features, Benchmarks, die Unterschiede zwischen den beiden Varianten und die Betriebskosten. Sieh dir auch unsere Anleitungen zum Einstieg in die Gemini Live API und zum Bau eines Voice-Assistenten mit GPT-Live-1 an.
Gemini 3.8 Live ist Googles natives Speech-to-Speech-Modell für Echtzeit-Voice-Agents, veröffentlicht am 15. September 2026 zusammen mit dem stärker auf Schlussfolgern ausgelegten Geschwistermodell Gemini 3.8 Live Extended Thinking. Beide laufen über die Gemini Live API per WebSocket, nehmen Audio, Video, Bilder und Text als Input und liefern Audio zurück. Google positioniert 3.8 Live als Standard für latenzarme Dialoge und Extended Thinking als Wahl für komplexe, mehrstufige Aufgaben.
Die Generationendifferenz zu Gemini 3.1 Flash Live liegt darin, wie das Modell Nicht-Sprech-Arbeit handhabt. Tool- und API-Calls laufen jetzt standardmäßig im Hintergrund, während das Modell das Gespräch fortsetzt. Extended Thinking ergänzt darauf aufbauend konfigurierbares Hintergrund-Reasoning. Google beschreibt das Duo als Sprung gegenüber den bisherigen Live-Modellen und als Ersatz für kaskadierte Pipelines aus Speech-to-Text, LLM und Text-to-Speech.
Google nennt fünf Hauptfähigkeiten der neuen Modelle. Für den Bau von Voice-Agents zählen besonders die zwei, die die Gesprächsschleife verändern: asynchrone Tool-Calls und Hintergrund-Reasoning.
Beide Modelle führen Function-Calls und API-Requests im Hintergrund aus, während sie Audio an die Nutzerin oder den Nutzer streamen. Bei Gemini 3.8 Live ist asynchrone Ausführung jetzt der Standardmodus für Function-Calling. Du kannst das alte synchrone Verhalten weiterhin erzwingen, indem du bei einer Tool-Definition behavior: BLOCKING setzt. Das Modell unterstützt außerdem Funktionsplanung mit den Optionen SILENT, WHEN_IDLE und INTERRUPTED, die festlegen, wann ein Ergebnis ausgesprochen wird.
Extended Thinking geht weiter: Es verlangt nicht-blockierende Tools und gibt einen harten Fehler zurück, wenn du ein blockierendes deklarierst. Praktisch heißt das: Wer eine Buchung ändern will, hört sofort eine Bestätigung, dann ein Progress-Update und schließlich das Ergebnis – statt der Stille, die eine kaskadierte Pipeline produziert, während sie auf eine API wartet. Bei Gemini 3.1 Flash Live war Function-Calling nur sequentiell: Das Modell begann erst zu antworten, wenn du das Tool-Ergebnis zurückgeschickt hattest.
Gemini 3.8 Live Extended Thinking denkt und spricht gleichzeitig. Laut Googles Doku nutzt das Modell frühe verbale Signale wie „Ich prüfe das mal“, um eine Eingabe zu bestätigen, und kommentiert dann den Fortschritt, während mehrstufige Hintergrundarbeit läuft. Die Tiefe steuerst du mit thinking_level auf low, medium oder high; das MINIMAL-Level aus 3.1 Flash Live entfällt.
Das ändert das Protokoll und ist für mich der wichtigste Migrationspunkt. Weil das Modell in einer Anfrage mehrfach sprechen kann, bedeutet turnComplete: true nicht mehr, dass es untätig ist.
Dein Client muss ein neues Feld interaction_status beobachten, das IN_PROGRESS meldet, solange Reasoning oder Tools laufen, und IDLE, wenn die gesamte Aufgabe abgeschlossen ist. Lässt du das weg, springt dein UI zurück auf „Zuhören“, obwohl das Modell noch mitten in der Aufgabe steckt.
Gemini 3.8 Live erdet Dialoge in Live-Videoeingaben, verarbeitet Videoframes nahezu in Echtzeit und kann so auch auf das reagieren, was jemand sieht – nicht nur auf das Gesagte. In Googles Demos sieht man unter anderem eine Live-Schachpartie und ein Onboarding, bei dem das Modell Fragen zu den Bildschirminhalten beantwortet.
Video ist allerdings nicht kostenlos. Turn-Coverage sendet jetzt standardmäßig Audioaktivität plus alle Videoframes an das Modell. Wenn deine App keine Vision braucht, solltest du Frames nur senden, wenn sie nützlich sind – für Kontextbudget und Kosten. Audio-plus-Video-Sessions sind auf 2 Minuten begrenzt und müssen danach per Session-Management verlängert werden; Audio-only-Sessions laufen bis zu 15 Minuten.
Google nennt das „alphanumerische Präzision“: das akkurate Parsen von Zeichenketten wie Bestätigungs-Codes, Schadennummern oder technischen Kennungen, die laut ausgesprochen werden. Wer schon Voice-Agents für Support oder Logistik gebaut hat, weiß: Hier stolpern kaskadierte Stacks, weil ein früher Speech-to-Text-Fehler downstream nicht mehr korrigierbar ist. Ein natives Sprachmodell, das die gesamte Äußerung im Kontext hört, hat hier strukturelle Vorteile.
Gemini 3.8 Live erkennt und wechselt zwischen 97 unterstützten Sprachen innerhalb eines Gesprächs – mit dem, was Google konsistente Akzente nennt. Beide Modelle unterstützen zudem „incremental content updates“: Du kannst jederzeit strukturierte Daten mit expliziter user- oder model-Rolle in die Session schicken, und das Modell führt sie mit dem Live-Audio zusammen. So schleust du z. B. einen Kundenstamm oder Bestellstatus in einen laufenden Call ein, ohne den Flow zu brechen.
Zwei kleinere Änderungen betreffen bestehenden Code. Proactive Audio – also die Fähigkeit, nicht auf nicht adressierte Sprache zu reagieren – ist jetzt permanent aktiv; false führt zu einem Fehler. Affective Dialogue wurde komplett aus der API entfernt, jede enable_affective_dialog-Konfiguration muss raus.
Extended Thinking führt in allen Qualitäts- und Agentik-Tabellen, die Google veröffentlicht hat – allerdings mit geringem Abstand zu OpenAIs GPT-Live-1 Astra. Das Basismodell 3.8 Live gewinnt die Kostenwertung deutlich, verliert aber bei agentischen Aufgaben.
Die unten genannten Werte für Index, τ-Voice, Big Bench Audio und Kosten stammen alle vom öffentlichen Leaderboard von Artificial Analysis, sind also unabhängig gemessen und nicht vendor-reported. Die τ³-Banking-Zahlen kommen aus Googles Launch-Chart mit Verweis auf Sierra – bis Sierras Board sie bestätigt, gelten sie als vendor-reported.
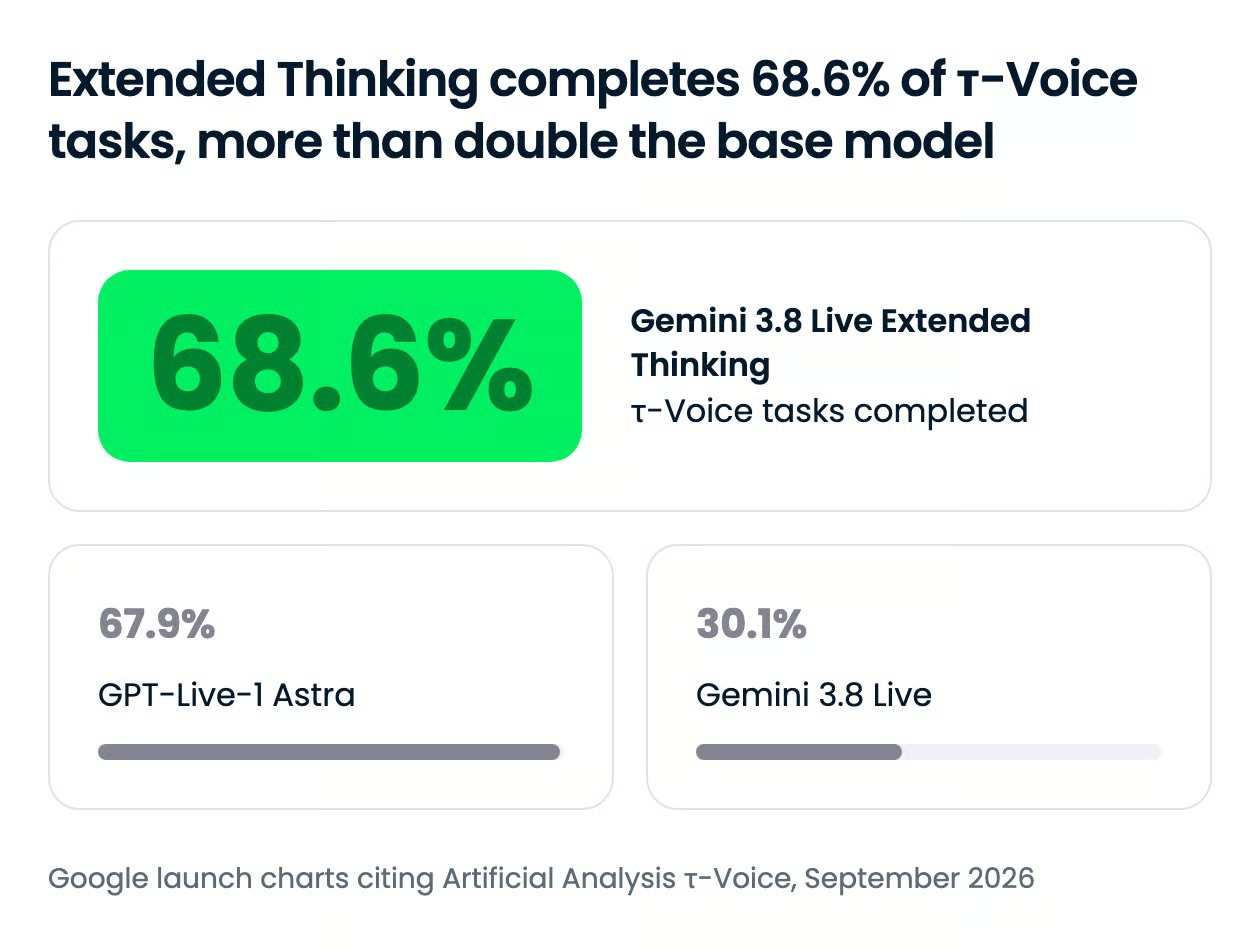
Gemini 3.8 Live Extended Thinking liegt auf τ-Voice, Sierras Benchmark für die erfolgreiche Erledigung mehrstufiger Tool-Aufgaben durch Voice-Agents, vorne – gemessen von Artificial Analysis. GPT-Live-1 Astra folgt knapp dahinter, der Rest fällt stärker ab:
Überrascht hat mich der Wert des Basismodells: Auf τ-Voice liegt es unter seinem eigenen Vorgänger. Google betont, dass 3.8 Live auf Skalierung und Kosteneffizienz getrimmt ist – nicht auf komplexe Workflows. Aber mehr als 38 Punkte Differenz zwischen den Varianten heißt: Die Tiers sind keine Nuance. Wenn dein Agent Tools kettet, ist das Basismodell die falsche Wahl.
Auf Sierras τ³-Banking-Leaderboard, einem härteren Customer-Service-Benchmark auf Basis von Bank-Workflows, erzielt Extended Thinking 35,1% gegenüber 32,0% für GPT-Live-1 Astra, 16,5% für SpaceXAIs Grok Voice Think Fast 2.0, 11,3% für Gemini 3.1 Flash Live und 10,3% für GPT-Realtime 2. Jedes Modell scheitert dort meist – ein Hinweis, wie weit Voice-Agents von unbeaufsichtigter Bankarbeit entfernt sind. Dennoch: Eine Verdreifachung gegenüber der vorherigen Gemini-Generation ist ein echter Schritt.
Auf dem Speech to Speech Index liegt Extended Thinking ebenfalls knapp vorn:
Ein Vorsprung von 1,1 Punkten gegenüber OpenAI ist ein Vorsprung – aber darauf allein würde ich keine Kaufentscheidung stützen.
Für reines Reasoning über gesprochene Eingaben meldet Google 97,7% auf Big Bench Audio für Extended Thinking. Zudem berichtet Google, dass beide Modelle auf ServiceNows EVA-Bench für Voice-Agents die Pareto-Grenze verschieben, also Genauigkeit und Gesprächsqualität besser austarieren – dieser Lauf erfolgte allerdings über die Live API via Gemini Enterprise Agent Platform und nicht über die öffentliche API.
Das ist die Grafik, die Google am liebsten zeigt. Im Kostentest von Artificial Analysis auf dem Big-Bench-Audio-Subset verarbeitet Gemini 3.8 Live eine Stunde Eingabeaudio für 0,84 $.
Extended Thinking kostet für die gleiche Stunde 3,50 $, Grok Voice Think Fast 2.0 liegt bei 4,80 $, und GPT-Live-1 Astra bei 5,83 $. Gemini 3.1 Flash Live lag je nach Thinking-Level bei 1,50 $ bzw. 1,75 $.
Liest man die zwei Gemini-Balken zusammen, ist die Produktstrategie klar. Das Basismodell unterbietet alles auf der Tafel deutlich, und das Reasoning-Modell, das bei der Qualität mit OpenAI mithält, kostet pro Stunde Eingabe noch immer rund 40% weniger. Beachte: Das Reasoning-Modell verbraucht bei höheren Thinking-Levels mehr Tokens, weshalb es trotz gleicher Preistabelle etwa viermal so teuer läuft wie sein Geschwister.
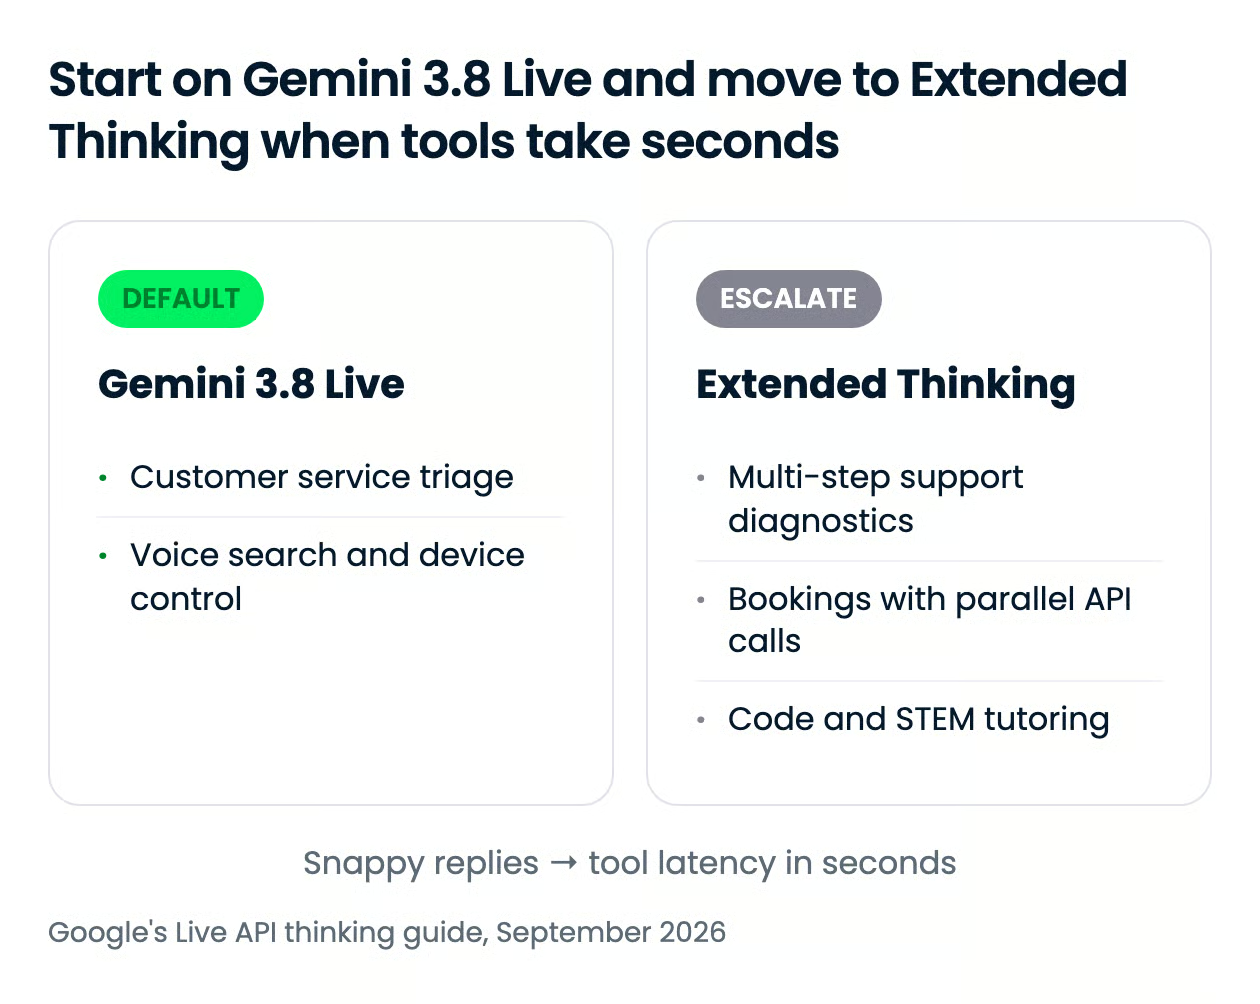
Gemini 3.8 Live ist für die meisten Voice-Agents die richtige Voreinstellung. Extended Thinking lohnt sich mit seinem höheren Tokenverbrauch nur, wenn der Agent planen, vergleichen oder auf langsame Tools warten muss. Googles eigene Leitlinie zieht die Grenze bei der Tool-Latenz: Wenn deine Funktionen in Millisekunden zurückkommen, bleib beim Basismodell.
Die beiden Varianten teilen sich eine Preistabelle (siehe unten), Tokenlimits von 131.072 für Input und 65.536 für Output sowie denselben WebSocket-Endpunkt. Der Unterschied liegt in der Reasoning-Architektur.
Gemini 3.8 Live nutzt interleaved Reasoning mit festem Latenzprofil und ohne thinking_level-Einstellung. Extended Thinking bietet low-, medium- und high-Hintergrund-Reasoning, streamt sprachliche Füller während der Arbeit und verlangt asynchrone Tools. Diese Thinking-Levels sind die einzige Stellschraube im Release.
| Anwendungsfall | Empfehlung | Begründung |
|---|---|---|
| Customer-Service-Triage, Sprachsuche, Sprachpraxis | Gemini 3.8 Live | Sofortiges Turn-Taking ist wichtiger als Tiefe, und jeder Turn bekommt genau eine Antwort |
| Smart-Device-Steuerung, Sensordaten auslesen | Gemini 3.8 Live | Tools antworten in Millisekunden – es gibt nichts zu überbrücken |
| Technischer Support über Logs, Fehlercodes und Config-Checks | Extended Thinking | Eine mehrstufige Diagnose braucht Hintergrund-Reasoning zwischen den Äußerungen |
| Reise- und Buchungs-Agents, die Flüge und Hotels parallel abfragen | Extended Thinking | Parallele Async-Calls mit gesprochenen Fortschritts-Updates statt Stille |
| STEM- und Code-Tutoring | Extended Thinking | Das Modell prüft Formeln oder debuggt Code, bevor es die Erklärung ausspricht |
Noch ein Punkt: Client-Komplexität. Der Wechsel zu Extended Thinking erfordert ein Redesign deines State-Handlings rund um interaction_status. Wenn du eine funktionierende 3.1-Flash-Live-App hast, ist das Basismodell das Drop-in-Upgrade; das Reasoning-Modell erfordert einen kleinen Refactor.
Beide Modelle nutzen die Preistabelle von Gemini 3.1 Flash Live Preview – das Upgrade ist kostenlos. Im Paid-Tier kostet Audio-Input 3,00 $ pro 1 Mio. Tokens (Google schätzt ca. 0,005 $ pro Minute), Audio-Output 12,00 $ pro 1 Mio. Tokens inkl. Thinking-Tokens (etwa 0,018 $ pro Minute). Thinking-Tokens werden zum Output-Tarif abgerechnet – daher die höheren Laufkosten von Extended Thinking.
| Modalität | Paid-Tier, pro 1 Mio. Tokens | Pro-Minute-Schätzung |
|---|---|---|
| Text-Input | 0,75 $ | n/a |
| Audio-Input | 3,00 $ | 0,005 $/Min |
| Bild- und Video-Input | 1,00 $ | 0,002 $/Min |
| Text-Output | 4,50 $ | n/a |
| Audio-Output (inkl. Thinking-Tokens) | 12,00 $ | 0,018 $/Min |
Das Free-Tier deckt beide Modelle für Input und Output kostenlos ab – mit dem üblichen Hinweis, dass Google Free-Tier-Daten zur Produktverbesserung nutzt; Paid-Tier-Daten werden dafür nicht verwendet.
Grounding mit Google Search wird in beiden Tiers unterstützt: 5.000 Suchanfragen pro Monat kostenlos, geteilt über alle Gemini-3.x-Modelle, danach 14 $ pro 1.000 Anfragen. Google hat keine spezifischen Rate-Limits für diese Modelle veröffentlicht – prüfe vor dem Launch die Rate-Limits der Gemini API für dein Tier.
Die Verfügbarkeit teilt sich wie folgt:
Jeder Audio-Output beider Modelle trägt ein SynthID-Wasserzeichen. Googles Model Card benennt die Grenzen offen: Die Modelle können weiterhin halluzinieren, die Jailbreak-Resistenz wird noch verbessert, und es kann gelegentlich zu Langsamkeit oder Timeouts kommen. Diese Hinweise solltest du lesen, bevor du eines der Modelle vor Kundinnen und Kunden setzt.
Die Modell-IDs lauten gemini-3.8-live und gemini-3.8-live-extended-thinking – beide sind stabile Strings ohne Preview-Suffix.
Du erreichst sie über die Gemini Live API mit dem google-genai SDK für Python oder JavaScript, über Raw-WebSockets oder interaktiv in der Stream-Ansicht von Google AI Studio. Als Integrationspartner für die Medien-Streaming-Schicht listet Google außerdem Agora, Fishjam, LiveKit, LangChain, Pipecat, Vercel und Vision Agents. Wenn du bereits auf ADK baust, gibt es einen Agent Development Kit Streaming-Pfad.
Die minimale Python-Session unten öffnet eine Verbindung, sendet einen Text-Turn und aktiviert ein Output-Transkript, damit du lesen kannst, was das Modell gesagt hat:
import asyncio
from google import genai

client = genai.Client()
config = {"response_modalities": ["AUDIO"], "output_audio_transcription": {}}

async def main():
    async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
        await session.send_client_content(
            turns={"role": "user", "parts": [{"text": "Read back the claim number 7Q-4418-B."}]},
            turn_complete=True,
        )
        async for response in session.receive():
            if response.server_content and response.server_content.output_transcription:
                print(response.server_content.output_transcription.text)

asyncio.run(main())
Wenn du von gemini-3.1-flash-live-preview migrierst, ändere den Modell-String und entferne thinking_level bzw. thinking_config aus deinem Setup; der Turn-Lifecycle ist ansonsten identisch. Die Live API ist standardmäßig serverseitig – Browser- und Mobile-Clients brauchen also flüchtige Tokens.
Für einen vollständigen Walkthrough zu Audio-Capture, Playback und Session-Management sieh dir unser Gemini Live API Tutorial an. Für die Text-Seite der gleichen Familie erklärt unser Gemini 3.8 Flash API Tutorial Thinking-Levels und Function-Calling in Python.
Google setzt ein Preissignal statt eines reinen Qualitätsstatements. Extended Thinking liegt gegenüber GPT-Live-1 Astra jeweils ein, zwei Punkte vorn, aber Gemini 3.8 Live mit 0,84 $ pro Stunde Eingabeaudio unterbietet OpenAIs Modell fast um den Faktor sieben – und das entscheidet, wohin produktiver Voice-Traffic wandert.
Meine Einschätzung: Wenn du irgendetwas auf Gemini 3.1 Flash Live betreibst, upgrade diese Woche – der Preis ist gleich, und allein asynchrones Tool-Calling lohnt sich. Wenn du auf OpenAIs Realtime-Stack bist, ist das Basismodell einen Test für Triage- und Suchflows wert; Extended Thinking überall dort, wo deine Tools Sekunden brauchen. Die 30,1% des Basismodells auf τ-Voice sind der Grund, es nicht für Agenten-Arbeit zu nutzen.
Wenn du die Tool-Calling-Seite eines Voice-Agents sauber aufbauen willst, empfehle ich unseren Kurs Building AI Agents with Google ADK, der Gemini in einen Customer-Support-Agenten mit Tools, Guardrails und Delegation integriert.
Lerne Agentische KI mit DataCamp!
Kurs
Kurs
Kurs