
Curso
Criando agentes de IA com o Google ADK
1 h
7.5K
Voz é o assunto do mês. No Speech to Speech Index da Artificial Analysis, o GPT-Live-1 Astra da OpenAI e o Grok Voice Think Fast 2.0 da SpaceXAI ficaram separados por 0,2 ponto no topo, e a OpenAI lançou o GPT-6 Astra no início de setembro. Em 15 de setembro, o Google respondeu com dois novos modelos de fala a fala: Gemini 3.8 Live e Gemini 3.8 Live Extended Thinking.
O Extended Thinking assumiu a primeira posição nesse índice com 82,6 pontos e lidera o benchmark τ-Voice para agentes, com 68,6%. O 3.8 Live base é o barato: no teste de custo da Artificial Analysis, ele processa uma hora de áudio de entrada por US$ 0,84, o menor valor entre os modelos do gráfico do Google. Ambos estão disponíveis na API do Gemini hoje, pelo mesmo preço do antecessor, Gemini 3.1 Flash Live.
Neste artigo, eu cubro tudo que há de novo no Gemini 3.8 Live: os recursos, os benchmarks, as diferenças entre as duas variantes e quanto custa rodar. Você também pode ver nossos guias para começar com a Gemini Live API e para construir um assistente de voz com o GPT-Live-1.
O Gemini 3.8 Live é o modelo nativo de fala a fala do Google para agentes de voz em tempo real, lançado em 15 de setembro de 2026 junto com um irmão de raciocínio mais avançado, o Gemini 3.8 Live Extended Thinking. Ambos rodam pela Gemini Live API via WebSocket, aceitam áudio, vídeo, imagens e texto como entrada e retornam áudio. O Google posiciona o 3.8 Live como padrão para diálogos de baixa latência e o Extended Thinking como a escolha para tarefas complexas e de múltiplas etapas.
A mudança geracional em relação ao Gemini 3.1 Flash Live está em como o modelo lida com trabalho que não é fala. Chamadas de ferramentas e APIs agora rodam em segundo plano por padrão enquanto o modelo segue conversando, e o Extended Thinking adiciona um raciocínio em segundo plano configurável. O Google descreve a dupla como um salto em relação aos modelos live anteriores e como substituta de pipelines em cascata que encadeavam reconhecimento de fala, um LLM e síntese de voz.
O Google lista cinco capacidades para os novos modelos, e as que mais importam para quem constrói um agente de voz são as duas que mudam o loop da conversa: chamadas assíncronas de ferramentas e raciocínio em segundo plano.
Ambos os modelos executam function calls e requisições de API em segundo plano enquanto fazem streaming de áudio para o usuário. No Gemini 3.8 Live, a execução assíncrona agora é o modo padrão de function calling. Você ainda pode forçar o comportamento síncrono antigo definindo behavior: BLOCKING na declaração da ferramenta, e o modelo oferece agendamento de funções com opções SILENT, WHEN_IDLE e INTERRUPTED para decidir quando um resultado será falado.
O Extended Thinking vai além: ele exige ferramentas não bloqueantes e retorna erro se você declarar uma bloqueante. Na prática, quem pede para alterar uma reserva ouve um reconhecimento imediato, depois um status de progresso e, por fim, o resultado — em vez do silêncio que um pipeline em cascata produz enquanto espera a API. No Gemini 3.1 Flash Live, as function calls eram apenas sequenciais, e o modelo não começava a responder até você enviar de volta o resultado da ferramenta.
O Gemini 3.8 Live Extended Thinking raciocina e fala ao mesmo tempo. A documentação do Google descreve o modelo usando pistas verbais iniciais como "Deixe eu verificar isso" para acusar o recebimento do pedido e narrando o progresso enquanto o trabalho de múltiplas etapas em segundo plano se conclui. Você controla a profundidade com thinking_level ajustado para low, medium ou high; o nível MINIMAL que existia no 3.1 Flash Live foi removido.
Isso muda o protocolo e, para mim, é o detalhe de migração mais importante deste lançamento. Como o modelo pode falar várias vezes durante uma mesma solicitação, turnComplete: true não significa mais que ele está ocioso.
Seu cliente precisa observar um novo campo, interaction_status, que reporta IN_PROGRESS enquanto o raciocínio ou as ferramentas estão rodando e IDLE quando toda a tarefa termina. Se você ignorar isso, sua interface volta para "ouvindo" enquanto o modelo ainda está no meio da tarefa.
O Gemini 3.8 Live ancora o diálogo em entrada visual ao vivo, processando quadros de vídeo quase em tempo real para que um agente responda ao que o usuário está vendo, além do que ele diz. Os exemplos do Google incluem uma partida de xadrez ao vivo e um onboarding de funcionário em que o modelo responde a perguntas sobre o que está na tela.
Mas vídeo não sai de graça. A cobertura de cada turno agora envia por padrão a atividade de áudio mais todos os quadros de vídeo para o modelo, então, se seu app não precisa de visão, envie quadros apenas quando forem úteis — tanto para o orçamento de contexto quanto para o custo. Sessões com áudio e vídeo também são limitadas a 2 minutos antes de exigirem gerenciamento de sessão para estendê-las, contra 15 minutos para sessões só de áudio.
O Google chama isso de "precisão alfanumérica": interpretar corretamente strings como códigos de confirmação, números de protocolo e identificadores técnicos falados em voz alta. Quem já construiu agente de voz para suporte ou logística sabe que é aí que stacks em cascata tropeçam, porque um erro de reconhecimento de fala no início da cadeia é irrecuperável depois. Um modelo nativo de fala que ouve toda a frase no contexto tem vantagem estrutural aqui.
O Gemini 3.8 Live detecta e alterna entre 97 idiomas durante a conversa, com o que o Google chama de consistência de sotaque entre eles. Ambos os modelos também suportam o que o Google chama de atualizações incrementais de conteúdo: você pode enviar dados estruturados para a sessão a qualquer momento, com papel explícito de user ou model, e o modelo funde isso ao áudio ao vivo. É assim que você injeta um cadastro de cliente ou o status de um pedido em uma ligação em andamento sem quebrar o fluxo.
Duas mudanças menores afetam códigos existentes. Áudio proativo, em que o modelo pode decidir não responder a fala que não é dirigida a ele, agora fica ligado permanentemente, e definir false retorna erro. Diálogo afetivo foi removido da API por completo, então qualquer configuração enable_affective_dialog precisa sair.
O Extended Thinking lidera todos os quadros de qualidade e de agente publicados pelo Google, mas por margens estreitas sobre o GPT-Live-1 Astra da OpenAI, enquanto o 3.8 Live base vence de longe em custo, porém perde em tarefas agentic.
O índice, o τ-Voice, o Big Bench Audio e os custos abaixo estão todos no leaderboard público da Artificial Analysis, então são medidos de forma independente, não reportados por fornecedor. Os números de τ³-Banking vêm do gráfico de lançamento do Google citando a Sierra, então trate essa linha como reportada pelo fornecedor até o board da Sierra mostrar o mesmo.
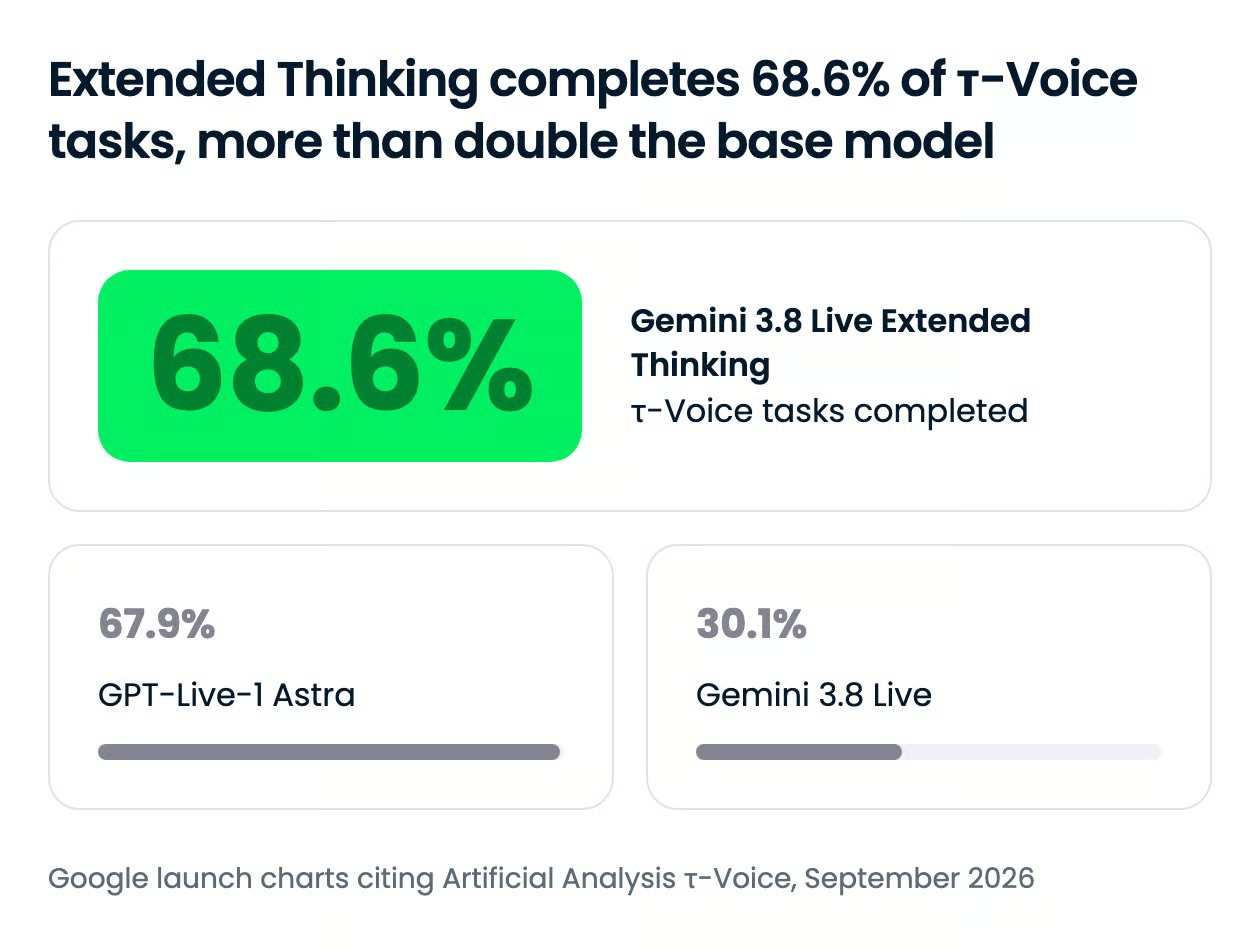
O Gemini 3.8 Live Extended Thinking lidera no τ-Voice, o benchmark da Sierra para verificar se um agente de voz conclui tarefas de múltiplas etapas com ferramentas, conforme medição da Artificial Analysis. O GPT-Live-1 Astra vem logo atrás, e os demais ficam mais distantes:
O número que me surpreendeu é que a pontuação do modelo base no τ-Voice fica abaixo da do próprio antecessor. O Google é claro ao dizer que o 3.8 Live é feito para escala e eficiência de custo, não para fluxos complexos, mas um abismo de mais de 38 pontos entre as duas variantes significa que a escolha do nível não é detalhe. Se seu agente encadeia ferramentas, o modelo base é a escolha errada por padrão.
No leaderboard τ³-Banking da Sierra, um benchmark de atendimento mais difícil baseado em fluxos bancários, o Extended Thinking marca 35,1% contra 32,0% do GPT-Live-1 Astra, 16,5% do Grok Voice Think Fast 2.0 da SpaceXAI, 11,3% do Gemini 3.1 Flash Live e 10,3% do GPT-Realtime 2. Todo modelo nesse board falha na maioria das vezes, o que mostra o quanto agentes de voz ainda estão longe de trabalho bancário sem supervisão — mas triplicar o desempenho em relação à geração anterior do Gemini é um avanço real.
No Speech to Speech Index, o Extended Thinking também supera por pouco a concorrência:
Uma vantagem de 1,1 ponto sobre a OpenAI é vantagem, mas eu não basearia uma decisão de compra só nisso.
Para raciocínio puro sobre entrada falada, o Google reporta 97,7% no Big Bench Audio para o Extended Thinking. O Google também reporta que ambos os modelos avançam a fronteira de Pareto no EVA-Bench da ServiceNow para agentes de voz, equilibrando acurácia e qualidade de conversa, embora esse teste tenha sido feito na Live API via Gemini Enterprise Agent Platform, não na API pública.
Este é o gráfico que o Google mais quer que você veja. No teste de custo da Artificial Analysis no subconjunto do Big Bench Audio, o Gemini 3.8 Live processa uma hora de áudio de entrada por US$ 0,84.
O Extended Thinking custa US$ 3,50 pela mesma hora, o Grok Voice Think Fast 2.0 sai por US$ 4,80 e o GPT-Live-1 Astra por US$ 5,83. O Gemini 3.1 Flash Live ficava em US$ 1,50 e US$ 1,75 dependendo do nível de thinking.
Lendo as duas barras do Gemini juntas, a estratégia de produto fica óbvia. O modelo base fica muito abaixo de todo mundo no custo, e o modelo de raciocínio que iguala a OpenAI em qualidade ainda custa 40% menos por hora de entrada. Note que o modelo de raciocínio consome mais tokens em níveis mais altos de thinking, por isso ele custa cerca de 4 vezes mais que o irmão apesar de compartilharem a mesma tabela de preço.
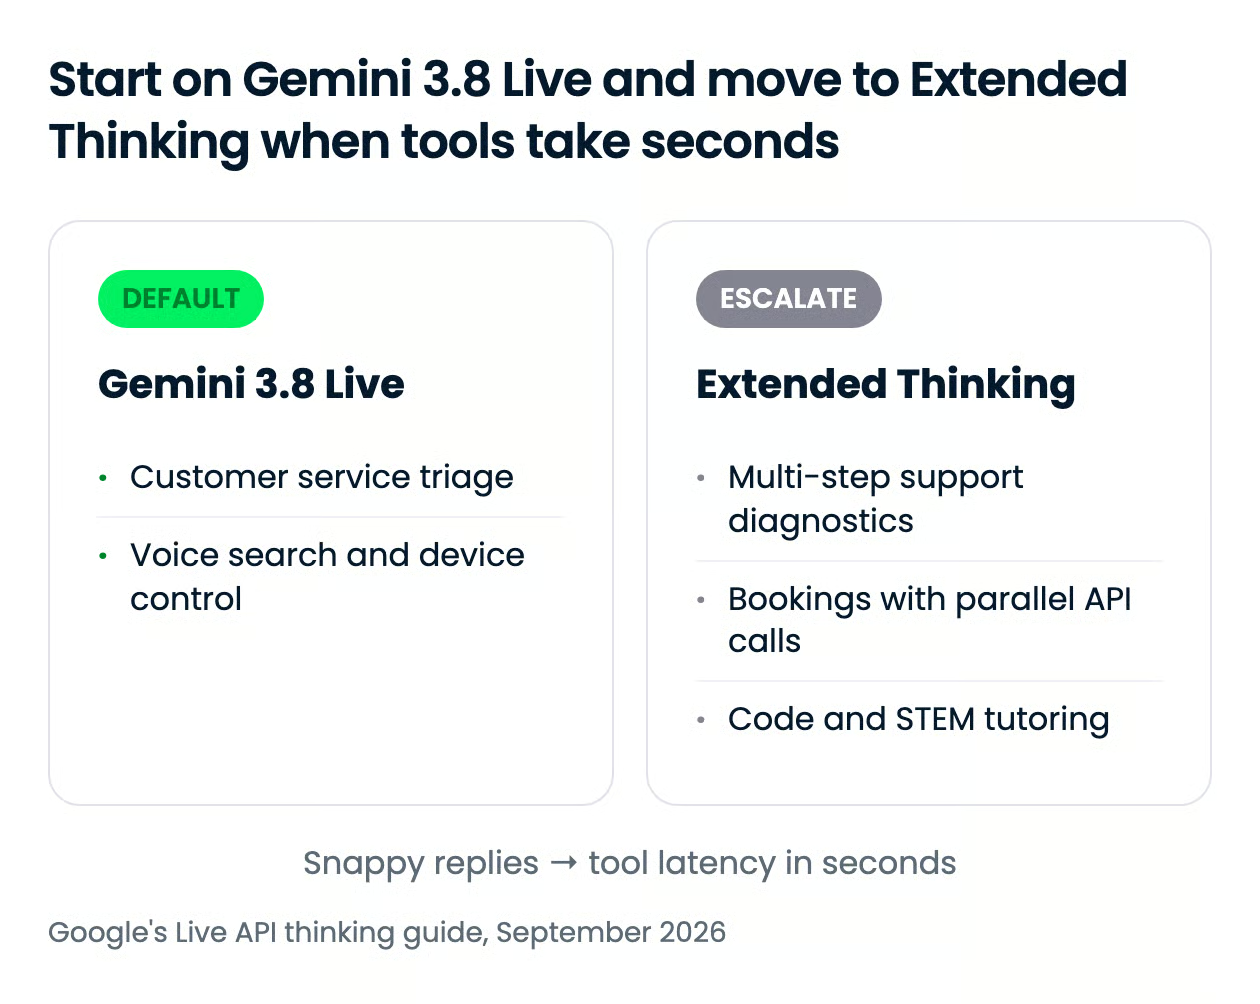
O Gemini 3.8 Live é o padrão certo para a maioria dos agentes de voz, e o Extended Thinking só vale o maior consumo de tokens quando o agente precisa planejar, comparar ou esperar por ferramentas lentas. A própria orientação do Google traça a linha na latência das ferramentas: se suas funções retornam em milissegundos, fique no modelo base.
As duas variantes compartilham a mesma tabela de preço (que eu cubro abaixo), limites de tokens de 131.072 para entrada e 65.536 para saída e o mesmo endpoint WebSocket. O que as separa é a arquitetura de raciocínio.
O Gemini 3.8 Live usa raciocínio intercalado com um perfil de latência fixo e sem configuração de thinking_level. O Extended Thinking expõe raciocínio em segundo plano low, medium e high, transmite muletas conversacionais enquanto trabalha e exige ferramentas assíncronas. Esses níveis de thinking são o único controle de esforço no lançamento.
| Uso | Escolha | Por quê |
|---|---|---|
| Triagem de atendimento, busca por voz, prática de idiomas | Gemini 3.8 Live | A troca rápida de turnos importa mais que profundidade, e cada turno do usuário recebe uma resposta |
| Controle de dispositivos inteligentes, leitura de sensores | Gemini 3.8 Live | Ferramentas retornam em milissegundos, então não há o que mascarar |
| Suporte técnico com logs, códigos de erro e checagens de config | Extended Thinking | Um diagnóstico de múltiplas etapas precisa de raciocínio em segundo plano entre as falas |
| Agentes de viagem e reservas consultando voos e hotéis em paralelo | Extended Thinking | Chamadas assíncronas em paralelo com atualizações faladas de progresso em vez de silêncio |
| Tutoria em STEM e código | Extended Thinking | O modelo verifica fórmulas ou depura código antes de falar a explicação |
Mais uma consideração: complexidade no cliente. Migrar para o Extended Thinking significa reescrever o tratamento de estado em torno do interaction_status; então, se você tem um app funcionando no 3.1 Flash Live, o modelo base é o upgrade plug-and-play, e o modelo de raciocínio pede um pequeno refactor.
Ambos os modelos compartilham a tabela de preço do Gemini 3.1 Flash Live Preview, então o upgrade é gratuito. No nível pago, áudio de entrada custa US$ 3,00 por 1 milhão de tokens (o Google estima em US$ 0,005 por minuto), e áudio de saída custa US$ 12,00 por 1 milhão de tokens (cerca de US$ 0,018 por minuto), incluindo tokens de thinking. Tokens de thinking são cobrados à taxa de saída — por isso o custo de execução do Extended Thinking é maior.
| Modalidade | Nível pago, por 1M tokens | Estimativa por minuto |
|---|---|---|
| Texto de entrada | US$ 0,75 | n/d |
| Áudio de entrada | US$ 3,00 | US$ 0,005/min |
| Imagem e vídeo de entrada | US$ 1,00 | US$ 0,002/min |
| Texto de saída | US$ 4,50 | n/d |
| Áudio de saída (inclui tokens de thinking) | US$ 12,00 | US$ 0,018/min |
O nível gratuito cobre ambos os modelos sem cobrança por entrada e saída, com a ressalva de sempre: dados do nível gratuito são usados pelo Google para melhorar seus produtos; dados do nível pago não são usados dessa forma.
Grounding com o Google Search é suportado nos dois níveis, com 5.000 buscas gratuitas por mês compartilhadas entre todos os modelos Gemini 3.x e US$ 14 por 1.000 requisições depois disso. O Google não publicou limites de taxa específicos para esses modelos, então verifique a página de rate limits da Gemini API para o seu nível antes de planejar um lançamento.
A disponibilidade está dividida em três frentes:
Toda saída de áudio de ambos os modelos carrega a marca d’água SynthID, e a model card do Google é franca sobre os limites: os modelos ainda podem alucinar, a resistência a jailbreaks ainda está em melhoria e pode haver lentidão ou timeouts ocasionais. Vale ler esses avisos antes de colocar qualquer um dos modelos na frente de clientes.
Os IDs dos modelos são gemini-3.8-live e gemini-3.8-live-extended-thinking, ambas strings estáveis sem sufixo de preview.
Você pode acessá-los pela Gemini Live API com o SDK google-genai para Python ou JavaScript, via WebSockets brutos ou de forma interativa no modo Stream do Google AI Studio. O Google também lista Agora, Fishjam, LiveKit, LangChain, Pipecat, Vercel e Vision Agents como parceiros de integração que cuidam da camada de streaming de mídia, e há um caminho de streaming pelo Agent Development Kit se você já estiver construindo no ADK.
A sessão mínima em Python abaixo abre uma conexão, envia um turno de texto e ativa a transcrição de saída para você ler o que o modelo disse:
import asyncio
from google import genai

client = genai.Client()
config = {"response_modalities": ["AUDIO"], "output_audio_transcription": {}}

async def main():
    async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
        await session.send_client_content(
            turns={"role": "user", "parts": [{"text": "Read back the claim number 7Q-4418-B."}]},
            turn_complete=True,
        )
        async for response in session.receive():
            if response.server_content and response.server_content.output_transcription:
                print(response.server_content.output_transcription.text)

asyncio.run(main())
Se você está migrando do gemini-3.1-flash-live-preview, troque a string do modelo e remova qualquer thinking_level ou thinking_config da sua configuração; o ciclo de cada turno permanece igual. A Live API é server-to-server por padrão, então clientes web e mobile precisam de tokens efêmeros.
Para um passo a passo completo de captura de áudio, reprodução e gerenciamento de sessão, veja nosso tutorial da Gemini Live API; e, no lado de texto da mesma família, nosso tutorial da Gemini 3.8 Flash API cobre níveis de thinking e function calling em Python.
O Google está fazendo uma aposta no preço, não em qualidade bruta. A vantagem do Extended Thinking sobre o GPT-Live-1 Astra é de um ou dois pontos em cada quadro, mas o Gemini 3.8 Live, a US$ 0,84 por hora de áudio de entrada, custa quase 7 vezes menos que o modelo da OpenAI — e esse é o número que decide para onde vai o tráfego de voz em produção.
Minha visão: se você roda qualquer coisa no Gemini 3.1 Flash Live, faça o upgrade nesta semana — o preço é o mesmo e só o calling assíncrono de ferramentas já vale. Se você usa o stack de tempo real da OpenAI, o modelo base vale um teste para fluxos de triagem e busca, e o Extended Thinking vale onde suas ferramentas levam segundos. Os 30,1% do modelo base no τ-Voice são o motivo para não usá-lo em tarefas agentic.
Se você quer construir do jeito certo a parte de chamadas de ferramentas em um agente de voz, recomendo nosso curso Building AI Agents with Google ADK, que integra o Gemini a um agente de suporte ao cliente com ferramentas, guardrails e delegação.
Aprenda IA agentic com a DataCamp!
Curso
Curso
Curso