
Curso
Creación de agentes de IA con Google ADK
1 h
7.5K
La voz es la batalla del mes. En el Speech to Speech Index de Artificial Analysis, GPT-Live-1 Astra de OpenAI y Grok Voice Think Fast 2.0 de SpaceXAI estaban separados por 0,2 puntos en lo más alto, y OpenAI lanzó GPT-6 Astra a inicios de septiembre. El 15 de septiembre, Google respondió con dos nuevos modelos de voz a voz: Gemini 3.8 Live y Gemini 3.8 Live Extended Thinking.
Extended Thinking se coloca en el número uno de ese índice con una puntuación de 82,6 y lidera el benchmark τ-Voice para agentes con un 68,6%. El modelo base 3.8 Live es el barato: en la prueba de costes de Artificial Analysis procesa una hora de audio de entrada por 0,84 $, el más bajo de cualquier modelo que Google haya graficado. Ambos están disponibles de forma general en la API de Gemini desde hoy al mismo precio que su predecesor, Gemini 3.1 Flash Live.
En este artículo, repaso todas las novedades de Gemini 3.8 Live: sus funciones, los benchmarks, las diferencias entre variantes y cuánto cuesta ponerlo a correr. También puedes ver nuestras guías para empezar con la Gemini Live API y para crear un asistente de voz con GPT-Live-1.
Gemini 3.8 Live es el modelo nativo de voz a voz de Google para agentes de voz en tiempo real, lanzado el 15 de septiembre de 2026 junto a su hermano de mayor capacidad de razonamiento, Gemini 3.8 Live Extended Thinking. Ambos funcionan a través de la Gemini Live API sobre una conexión WebSocket, aceptan audio, vídeo, imágenes y texto como entrada, y devuelven audio. Google posiciona 3.8 Live como la opción por defecto para diálogos de baja latencia y Extended Thinking como la elección para tareas complejas y de varios pasos.
El salto generacional respecto a Gemini 3.1 Flash Live está en cómo el modelo gestiona el trabajo que no es hablar. Las llamadas a herramientas y APIs ahora se ejecutan en segundo plano por defecto mientras el modelo continúa la conversación, y Extended Thinking añade razonamiento en segundo plano configurable por encima. Google describe este dúo como un cambio de nivel respecto a sus anteriores modelos en vivo y como sustituto de canalizaciones en cascada que encadenan voz a texto, un LLM y texto a voz.
Google destaca cinco capacidades en los nuevos modelos, y las más relevantes para quienes construyen un agente de voz son las dos que cambian el bucle conversacional: llamadas a herramientas asíncronas y razonamiento en segundo plano.
Ambos modelos ejecutan llamadas a funciones y solicitudes a APIs en segundo plano mientras transmiten audio al usuario. En Gemini 3.8 Live, la ejecución asíncrona es ahora el modo por defecto de llamadas a funciones. Aun así, puedes forzar el comportamiento síncrono anterior configurando behavior: BLOCKING en la declaración de una herramienta, y el modelo admite planificación de funciones con opciones SILENT, WHEN_IDLE e INTERRUPTED que deciden cuándo se pronuncia un resultado.
Extended Thinking va más allá: requiere herramientas no bloqueantes y devuelve un error si declaras una bloqueante. En la práctica, si alguien pide cambiar una reserva, oye un acuse de recibo al instante, luego un estado de progreso y, después, el resultado; en lugar del silencio que produce una canalización en cascada mientras espera una API. En Gemini 3.1 Flash Live, las llamadas a funciones eran solo secuenciales y el modelo no empezaba a responder hasta que le enviabas el resultado de la herramienta.
Gemini 3.8 Live Extended Thinking razona y habla a la vez. La documentación de Google describe que el modelo usa señales verbales iniciales como "Déjame comprobarlo" para reconocer una petición y luego narra el progreso mientras se completa el trabajo en segundo plano de varios pasos. Controlas la profundidad con thinking_level en low, medium o high; el nivel MINIMAL que existía en 3.1 Flash Live desaparece.
Esto cambia el protocolo, y para mí es el detalle de migración más importante del lanzamiento. Como el modelo puede hablar varias veces durante una misma solicitud, turnComplete: true ya no significa que esté inactivo.
Tu cliente debe vigilar un nuevo campo interaction_status, que informa IN_PROGRESS mientras el razonamiento o las herramientas están en marcha y IDLE cuando toda la tarea termina. Si lo ignoras, tu interfaz volverá a "escuchando" mientras el modelo sigue a mitad de tarea.
Gemini 3.8 Live ancla el diálogo en la entrada visual en vivo, procesando fotogramas de vídeo casi en tiempo real para que un agente responda a lo que el usuario está viendo además de a lo que dice. Las demos de Google incluyen una partida de ajedrez en directo y una incorporación de empleados donde el modelo responde preguntas sobre lo que hay en pantalla.
El vídeo no sale gratis. Por defecto, cada turno envía al modelo la actividad de audio más todos los fotogramas de vídeo, así que si tu app no necesita visión, envía fotogramas solo cuando aporten valor, tanto por presupuesto de contexto como por coste. Las sesiones de audio más vídeo también se limitan a 2 minutos antes de requerir gestión de sesión para ampliarlas, frente a 15 minutos para sesiones solo de audio.
Google lo llama "precisión alfanumérica": interpretar con precisión cadenas como códigos de confirmación, números de expediente e identificadores técnicos pronunciados en voz alta. Quien haya construido un agente de voz para soporte o logística sabe que aquí es donde se caen las pilas en cascada: un error de voz a texto al inicio es irrecuperable después. Un modelo nativo de voz que oye todo el enunciado en contexto tiene una ventaja estructural.
Gemini 3.8 Live detecta y alterna entre 97 idiomas compatibles durante una conversación, con lo que Google llama coherencia de acento entre ellos. Ambos modelos también admiten lo que Google denomina actualizaciones incrementales de contenido: puedes enviar datos estructurados a la sesión en cualquier momento, con un rol explícito user o model, y el modelo los fusiona con el audio en vivo. Así es como inyectas una ficha de cliente o el estado de un pedido en una llamada en curso sin romper el flujo.
Dos cambios menores afectan al código existente. El audio proactivo, donde el modelo puede decidir no responder a un habla que no va dirigido a él, está ahora activado permanentemente, y ponerlo en false devuelve un error. El diálogo afectivo se ha eliminado por completo de la API, así que cualquier configuración enable_affective_dialog debe desaparecer.
Extended Thinking lidera todas las tablas de calidad y capacidad agentica que publicó Google, aunque por márgenes estrechos sobre GPT-Live-1 Astra de OpenAI, mientras que el modelo base 3.8 Live gana claramente en coste pero pierde en tareas agenticas.
El índice, τ-Voice, Big Bench Audio y las cifras de coste que siguen están en el leaderboard público de Artificial Analysis, así que son mediciones independientes, no reportadas por el proveedor. Los números de τ³-Banking provienen del gráfico de lanzamiento de Google citando a Sierra, así que trata esa fila como reportada por el proveedor hasta que el tablero de Sierra muestre lo mismo.
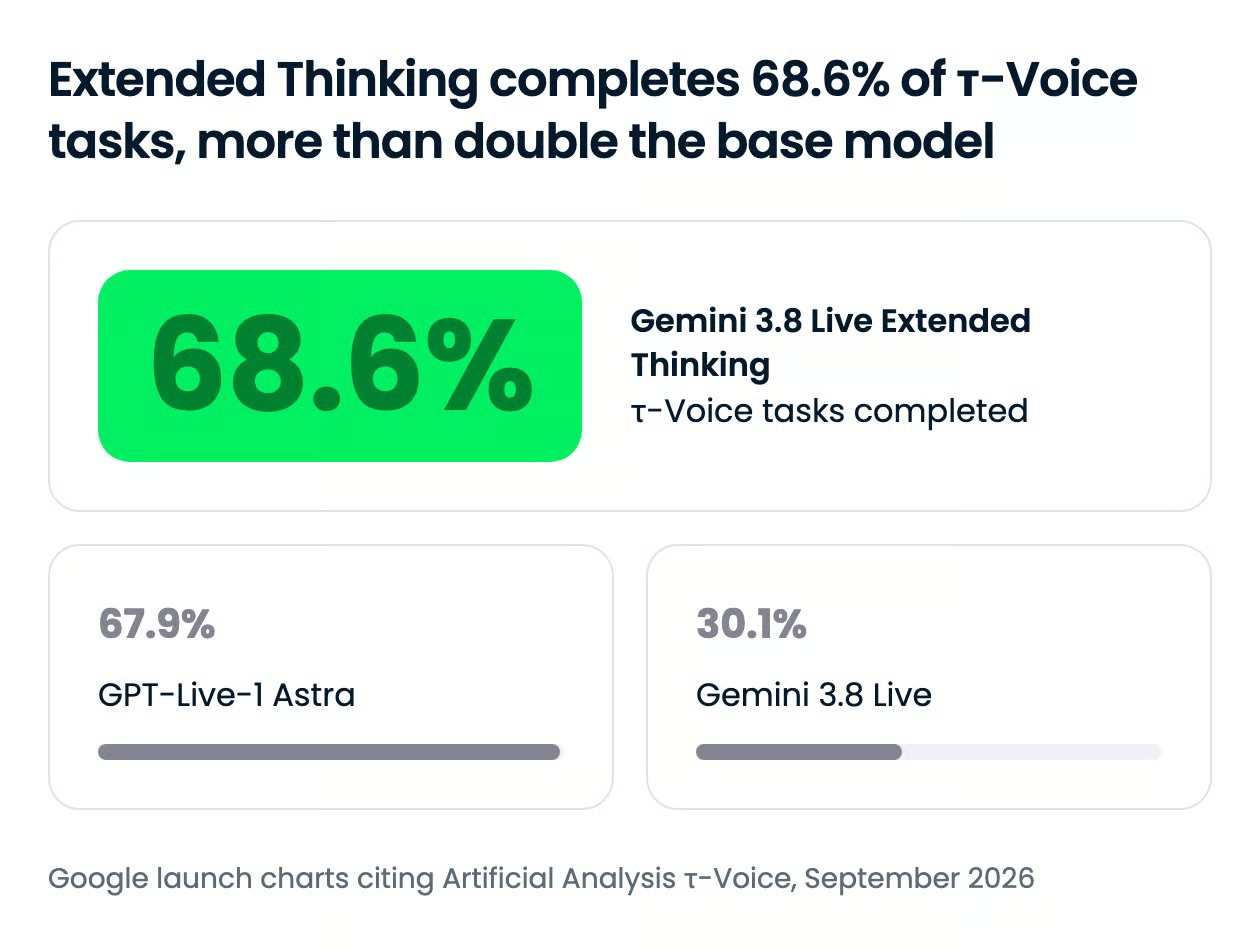
Gemini 3.8 Live Extended Thinking lidera en τ-Voice, el benchmark de Sierra que mide si un agente de voz completa tareas de varios pasos con herramientas, según Artificial Analysis. GPT-Live-1 Astra queda muy cerca, con el resto por detrás:
El dato que me sorprendió es que la puntuación del modelo base en τ-Voice queda por debajo de su propio predecesor. Google es explícito: 3.8 Live está diseñado para escalar y ser eficiente en coste, no para flujos complejos; pero una brecha de más de 38 puntos entre las dos variantes significa que la elección de nivel no es un matiz. Si tu agente encadena herramientas, el modelo base no es el por defecto adecuado.
En el leaderboard τ³-Banking de Sierra, un benchmark más duro de atención al cliente en banca, Extended Thinking logra un 35,1% frente a 32,0% de GPT-Live-1 Astra, 16,5% de Grok Voice Think Fast 2.0 de SpaceXAI, 11,3% de Gemini 3.1 Flash Live y 10,3% de GPT-Realtime 2. Todos los modelos de esa tabla fallan la mayoría de las veces, lo que muestra lo lejos que están los agentes de voz del trabajo bancario sin supervisión, pero triplicar a la generación anterior de Gemini es un avance real.
En el Speech to Speech Index, Extended Thinking también supera por poco a la competencia:
Una ventaja de 1,1 puntos sobre OpenAI es una ventaja, pero yo no la usaría como base única de compra.
Para razonamiento puro sobre entrada hablada, Google reporta un 97,7% en Big Bench Audio para Extended Thinking. Google también afirma que ambos modelos empujan la frontera de Pareto en EVA-Bench de ServiceNow para agentes de voz, equilibrando precisión y calidad conversacional, aunque esa prueba se hizo en la Live API a través de Gemini Enterprise Agent Platform y no en la API pública.
Este es el gráfico que Google más quiere que veas. En la prueba de coste de Artificial Analysis sobre el subconjunto de Big Bench Audio, Gemini 3.8 Live procesa una hora de audio de entrada por 0,84 $.
Extended Thinking cuesta 3,50 $ por la misma hora, Grok Voice Think Fast 2.0 cuesta 4,80 $, y GPT-Live-1 Astra cuesta 5,83 $. Gemini 3.1 Flash Live estaba en 1,50 $ y 1,75 $ según el nivel de pensamiento.
Lee las dos barras de Gemini juntas y se ve clara la estrategia de producto. El modelo base recorta a todo lo de la tabla por un amplio margen, y el modelo de razonamiento que iguala a OpenAI en calidad sigue costando un 40% menos por hora de entrada. Ten en cuenta que el modelo de razonamiento quema más tokens a niveles de thinking más altos, por eso cuesta unas 4 veces más que su hermano pese a compartir tabla de precios.
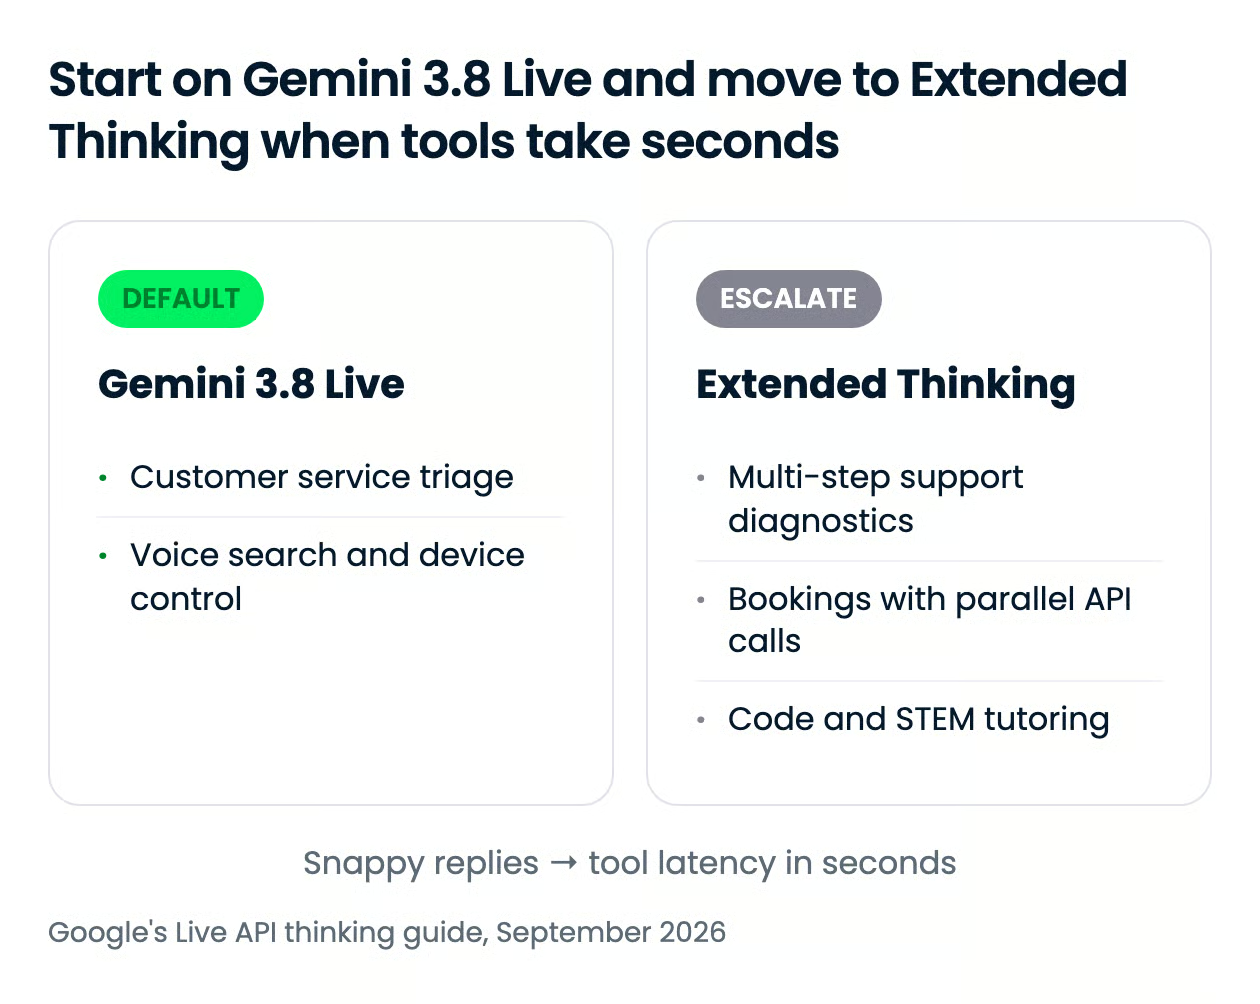
Gemini 3.8 Live es el mejor por defecto para la mayoría de agentes de voz, y Extended Thinking justifica su mayor consumo de tokens solo cuando el agente tiene que planificar, comparar o esperar a herramientas lentas. La propia guía de Google traza la línea en la latencia de herramientas: si tus funciones devuelven en milisegundos, quédate con el modelo base.
Las dos variantes comparten tabla de precios (que detallo más abajo), límites de 131.072 tokens de entrada y 65.536 de salida, y el mismo endpoint WebSocket. Lo que las separa es la arquitectura de razonamiento.
Gemini 3.8 Live usa razonamiento intercalado con un perfil de latencia fijo y sin ajuste thinking_level. Extended Thinking expone razonamiento en segundo plano low, medium y high, emite muletillas conversacionales mientras trabaja y requiere herramientas asíncronas. Esos niveles de thinking son el único control de esfuerzo en este lanzamiento.
| Uso | Elige | Por qué |
|---|---|---|
| Triaje en atención al cliente, búsqueda por voz, práctica de idiomas | Gemini 3.8 Live | Importa más el intercambio inmediato que la profundidad, y cada turno del usuario recibe una respuesta |
| Control de dispositivos inteligentes, lectura de sensores | Gemini 3.8 Live | Las herramientas responden en milisegundos, así que no hay nada que enmascarar |
| Soporte técnico entre logs, códigos de error y comprobaciones de configuración | Extended Thinking | Un diagnóstico de varios pasos necesita razonamiento en segundo plano entre enunciados |
| Agentes de viajes y reservas consultando vuelos y hoteles en paralelo | Extended Thinking | Llamadas asíncronas en paralelo con actualizaciones habladas de progreso en lugar de silencio |
| Tutoría en STEM y código | Extended Thinking | El modelo verifica fórmulas o depura código antes de hablar la explicación |
Un punto más: la complejidad del cliente. Pasar a Extended Thinking implica reescribir la gestión de estado alrededor de interaction_status; si ya tienes una app sobre 3.1 Flash Live funcionando, el modelo base es la actualización directa y el de razonamiento requiere un pequeño refactor.
Ambos modelos comparten la tabla de precios de Gemini 3.1 Flash Live Preview, así que la actualización es gratuita. En el plan de pago, la entrada de audio cuesta 3,00 $ por 1 millón de tokens (Google lo estima en 0,005 $ por minuto) y la salida de audio cuesta 12,00 $ por 1 millón de tokens, incluyendo tokens de thinking (unos 0,018 $ por minuto). Los tokens de thinking se facturan a la tarifa de salida, de ahí el mayor coste de Extended Thinking en ejecución.
| Modalidad | Plan de pago, por 1 M de tokens | Estimación por minuto |
|---|---|---|
| Entrada de texto | 0,75 $ | n/a |
| Entrada de audio | 3,00 $ | 0,005 $/min |
| Entrada de imagen y vídeo | 1,00 $ | 0,002 $/min |
| Salida de texto | 4,50 $ | n/a |
| Salida de audio (incluye tokens de thinking) | 12,00 $ | 0,018 $/min |
El plan gratuito cubre ambos modelos sin coste de entrada ni salida, con la salvedad habitual: Google usa los datos del plan gratuito para mejorar sus productos; los del plan de pago no se usan así.
El anclaje con Google Search está disponible en ambos planes, con 5.000 búsquedas gratis al mes compartidas entre todos los modelos Gemini 3.x y 14 $ por 1.000 solicitudes a partir de ahí. Google no ha publicado límites de tasa específicos para estos modelos, así que consulta la página de rate limits de la Gemini API para tu plan antes de planear un lanzamiento.
La disponibilidad se reparte en tres frentes:
Todo el audio de salida de ambos modelos lleva una marca de agua SynthID, y la ficha del modelo de Google es clara con los límites: los modelos aún pueden alucinar, la resistencia a jailbreaks sigue mejorándose y puede haber lentitud ocasional o timeouts. Conviene leer esas advertencias antes de poner cualquiera de los modelos delante de clientes.
Los IDs de los modelos son gemini-3.8-live y gemini-3.8-live-extended-thinking, ambas cadenas estables sin sufijo de preview.
Puedes usarlos a través de la Gemini Live API con el SDK google-genai para Python o JavaScript, vía WebSockets en crudo o de forma interactiva en la vista Stream de Google AI Studio. Google también lista a Agora, Fishjam, LiveKit, LangChain, Pipecat, Vercel y Vision Agents como partners de integración que gestionan la capa de streaming de medios, y hay una vía de streaming con Agent Development Kit si ya construyes sobre ADK.
La sesión mínima en Python de abajo abre una conexión, envía un turno de texto y activa la transcripción de salida para que puedas leer lo que dijo el modelo:
import asyncio
from google import genai

client = genai.Client()
config = {"response_modalities": ["AUDIO"], "output_audio_transcription": {}}

async def main():
    async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
        await session.send_client_content(
            turns={"role": "user", "parts": [{"text": "Read back the claim number 7Q-4418-B."}]},
            turn_complete=True,
        )
        async for response in session.receive():
            if response.server_content and response.server_content.output_transcription:
                print(response.server_content.output_transcription.text)

asyncio.run(main())
Si migras desde gemini-3.1-flash-live-preview, cambia la cadena del modelo y elimina cualquier thinking_level o thinking_config de tu configuración; el ciclo de turnos es por lo demás idéntico. La Live API es server-to-server por defecto, así que los clientes en navegador y móvil necesitan tokens efímeros.
Para un recorrido completo de captura de audio, reproducción y gestión de sesiones, consulta nuestro tutorial de Gemini Live API, y para la parte de texto de la misma familia, nuestro tutorial de la Gemini 3.8 Flash API cubre niveles de thinking y llamadas a funciones en Python.
Google lanza un mensaje en precio más que en calidad bruta. La ventaja de Extended Thinking sobre GPT-Live-1 Astra es de uno o dos puntos en cada tabla, pero Gemini 3.8 Live a 0,84 $ por hora de audio de entrada es casi 7 veces más barato que el modelo de OpenAI, y ese es el número que decide dónde va el tráfico de voz en producción.
Mi recomendación: si ejecutas algo en Gemini 3.1 Flash Live, actualiza esta semana; el precio es el mismo y solo por las llamadas asíncronas a herramientas ya compensa. Si trabajas con la pila en tiempo real de OpenAI, el modelo base merece una prueba para flujos de triaje y búsqueda, y Extended Thinking merece otra donde tus herramientas tarden segundos. El 30,1% del modelo base en τ-Voice es el motivo para no usarlo en tareas agenticas.
Si quieres construir bien la parte de llamadas a herramientas de un agente de voz, te recomendamos nuestro curso Building AI Agents with Google ADK, que conecta Gemini a un agente de soporte con herramientas, guardarraíles y delegación.
¡Aprende IA agentica con DataCamp!
Curso
Curso
Curso