Courses
การสร้าง AI Agent ด้วย Google ADK
1 ชม.
7.5K
สงครามด้านเสียงคือประเด็นร้อนประจำเดือน บนดัชนี Speech to Speech ของ Artificial Analysis รุ่น GPT-Live-1 Astra ของ OpenAI และ Grok Voice Think Fast 2.0 ของ SpaceXAI นำฝูงห่างกันเพียง 0.2 คะแนน และ OpenAI ปล่อย GPT-6 Astra ช่วงต้นกันยายน วันที่ 15 กันยายน Google ตอบโต้ด้วยโมเดล speech-to-speech ใหม่สองรุ่น: Gemini 3.8 Live และ Gemini 3.8 Live Extended Thinking.
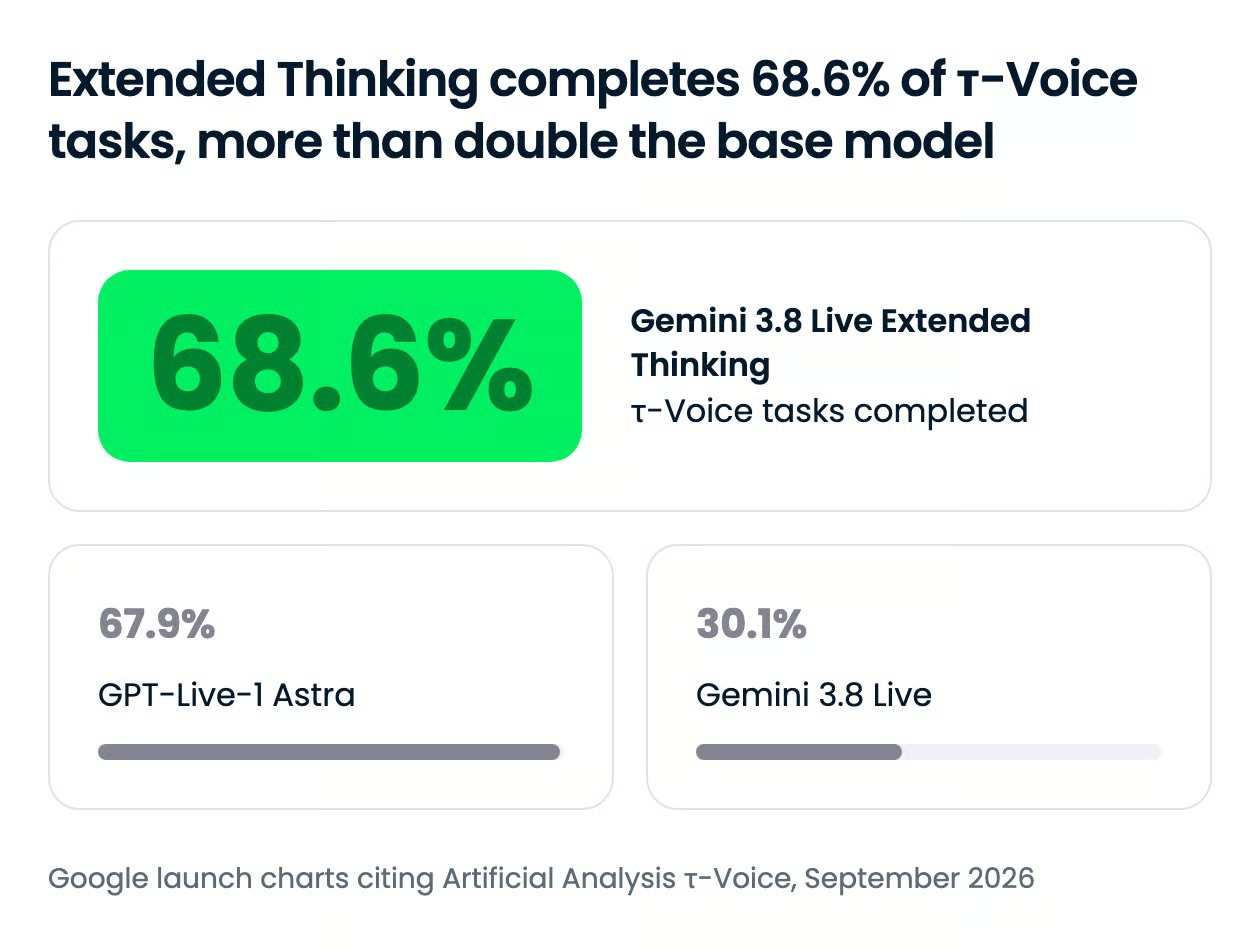
Extended Thinking ขึ้นอันดับหนึ่งของดัชนีนั้นด้วยคะแนน 82.6 และนำหน้าเกณฑ์วัดตัวแทน τ-Voice ที่ 68.6% ขณะที่รุ่นฐาน 3.8 Live เป็นตัวถูก: ในการทดสอบต้นทุนของ Artificial Analysis มันประมวลผลเสียงขาเข้า 1 ชั่วโมงที่ $0.84 ต่ำสุดในบรรดาโมเดลที่ Google นำมาเปรียบเทียบ ทั้งสองรุ่นพร้อมใช้งานทั่วไปผ่าน Gemini API วันนี้ ในราคาชุดเดียวกับรุ่นก่อนหน้า Gemini 3.1 Flash Live
บทความนี้สรุปทุกอย่างใหม่ใน Gemini 3.8 Live ครอบคลุมฟีเจอร์ เกณฑ์วัดผล ความแตกต่างของสองสายผลิตภัณฑ์ และต้นทุนในการรัน ทั้งยังมีคู่มือ เริ่มต้นใช้งาน Gemini Live API และ สร้างผู้ช่วยเสียงด้วย GPT-Live-1 ให้ด้วย
Gemini 3.8 Live คือโมเดล speech-to-speech เนทีฟของ Google สำหรับเอเจนต์เสียงเรียลไทม์ เปิดตัววันที่ 15 กันยายน 2026 คู่กับรุ่นพี่ที่ให้เหตุผลเก่งกว่า Gemini 3.8 Live Extended Thinking ทั้งสองทำงานผ่าน Gemini Live API บนการเชื่อมต่อ WebSocket รับอินพุตแบบเสียง วิดีโอ รูปภาพ และข้อความ และส่งออกเป็นเสียง Google วางตำแหน่ง 3.8 Live เป็นดีฟอลต์สำหรับบทสนทนาหน่วงต่ำ และ Extended Thinking สำหรับงานซับซ้อนหลายขั้นตอน
การเปลี่ยนรุ่นจาก Gemini 3.1 Flash Live อยู่ที่วิธีจัดการงานที่ไม่ใช่การพูด การเรียกใช้เครื่องมือและ API ตอนนี้ทำงานเบื้องหลังโดยดีฟอลต์ ในขณะที่โมเดลดำเนินบทสนทนาต่อ และ Extended Thinking เพิ่มการให้เหตุผลเบื้องหลังแบบกำหนดระดับได้บนฐานนั้น Google อธิบายคู่นี้ว่าเป็นการก้าวกระโดดจากโมเดลไลฟ์ก่อนหน้า และมาแทนที่พายป์ไลน์ลูกโซ่ที่ต้องต่อ speech-to-text, LLM และ text-to-speech เข้าด้วยกัน
Google ระบุความสามารถหลักห้าข้อสำหรับรุ่นใหม่ และสิ่งที่สำคัญที่สุดสำหรับผู้พัฒนาเอเจนต์เสียงคือสองอย่างที่เปลี่ยนลูปบทสนทนา: การเรียกเครื่องมือแบบอะซิงก์ และการให้เหตุผลเบื้องหลัง
ทั้งสองรุ่นเรียกใช้ฟังก์ชันและ API เบื้องหลัง พร้อมสตรีมเสียงกลับไปยังผู้ใช้ บน Gemini 3.8 Live โหมดการเรียกฟังก์ชันแบบอะซิงก์เป็นดีฟอลต์แล้ว ยังสามารถบังคับพฤติกรรมซิงก์แบบเก่าได้โดยตั้งค่า behavior: BLOCKING ในการประกาศเครื่องมือ และโมเดลรองรับการจัดตารางฟังก์ชันด้วยตัวเลือก SILENT, WHEN_IDLE และ INTERRUPTED เพื่อกำหนดว่าผลลัพธ์จะถูกพูดเมื่อใด
Extended Thinking ไปไกลกว่านั้น: บังคับใช้เครื่องมือแบบไม่บล็อก และจะส่งข้อผิดพลาดทันทีถ้าคุณประกาศแบบบล็อก ผลลัพธ์ในทางปฏิบัติคือ ผู้โทรที่ขอเปลี่ยนการจองจะได้ยินการรับทราบทันที จากนั้นอัปเดตความคืบหน้า แล้วจึงผลลัพธ์ แทนความเงียบของพายป์ไลน์ลูกโซ่ที่รอ API บน Gemini 3.1 Flash Live การเรียกฟังก์ชันทำได้แบบลำดับเท่านั้น และโมเดลจะยังไม่เริ่มตอบจนกว่าจะส่งผลลัพธ์เครื่องมือกลับไป
Gemini 3.8 Live Extended Thinking ให้เหตุผลและพูดไปพร้อมกัน เอกสารของ Google อธิบายว่าโมเดลใช้สัญญาณคำพูดแรก ๆ เช่น "ขอดูข้อมูลก่อน" เพื่อรับทราบคำสั่ง แล้วบรรยายความคืบหน้าระหว่างที่งานหลายขั้นตอนในพื้นหลังเสร็จสิ้น สามารถควบคุมความลึกด้วย thinking_level เป็น low, medium หรือ high; ระดับ MINIMAL ที่มีใน 3.1 Flash Live ถูกถอดออกแล้ว
นี่เปลี่ยนโปรโตคอล และเป็นรายละเอียดการย้ายรุ่นที่สำคัญที่สุด เพราะโมเดลสามารถพูดหลายครั้งภายในการร้องขอครั้งเดียว turnComplete: true จึงไม่หมายความว่ามันว่างงานอีกต่อไป
ไคลเอนต์ต้องเฝ้าดูฟิลด์ใหม่ interaction_status ซึ่งรายงาน IN_PROGRESS ระหว่างให้เหตุผลหรือขณะเครื่องมือทำงาน และเป็น IDLE เมื่องานทั้งหมดเสร็จสิ้น ถ้าข้ามจุดนี้ UI จะสลับกลับไปที่โหมด "กำลังฟัง" ทั้งที่โมเดลยังทำงานอยู่กลางคัน
Gemini 3.8 Live ยึดบทสนทนากับอินพุตภาพแบบสด ประมวลผลเฟรมวิดีโอเกือบเรียลไทม์ ทำให้เอเจนต์ตอบสนองต่อสิ่งที่ผู้ใช้กำลังมองเห็นได้ควบคู่กับสิ่งที่พูด เดโมของ Google รวมถึงเกมหมากรุกสด และเวิร์กธรูออนบอร์ดดิ้งพนักงานที่โมเดลตอบคำถามเกี่ยวกับสิ่งที่อยู่บนหน้าจอ
อย่างไรก็ดี วิดีโอไม่ฟรี ตอนนี้ค่าเริ่มต้นของการครอบคลุมหนึ่งเทิร์นคือส่งกิจกรรมเสียงพร้อมเฟรมวิดีโอทั้งหมดไปยังโมเดล ดังนั้นถ้าแอปไม่ต้องใช้วิชั่น ควรส่งเฟรมเฉพาะเมื่อจำเป็น ทั้งเพื่อบริหารงบคอนเท็กซ์และเพื่อลดค่าใช้จ่าย นอกจากนี้ เซสชันเสียงพร้อมวิดีโอจำกัดที่ 2 นาที ก่อนต้องใช้การจัดการเซสชันเพื่อขยาย ขณะที่เซสชันเสียงอย่างเดียวได้ 15 นาที
Google เรียกว่า "alphanumeric precision": การแยกวิเคราะห์สตริงอย่างโค้ดยืนยัน หมายเลขเคลม และตัวระบุทางเทคนิคที่พูดออกมาได้อย่างแม่นยำ ใครที่เคยสร้างเอเจนต์เสียงสำหรับซัพพอร์ตหรือโลจิสติกส์ย่อมรู้ว่าสแต็กแบบลูกโซ่มักพังตรงนี้ เพราะความผิดพลาดของ speech-to-text ช่วงต้นไม่อาจแก้ไขได้ในขั้นถัดไป โมเดลเสียงเนทีฟที่ได้ยินวลีทั้งหมดในบริบทจึงได้เปรียบเชิงโครงสร้าง
Gemini 3.8 Live ตรวจจับและสลับระหว่าง 97 ภาษาที่รองรับระหว่างบทสนทนา โดย Google ระบุว่ารักษาสำเนียงให้คงเส้นคงวาข้ามภาษาได้ ทั้งสองรุ่นรองรับสิ่งที่ Google เรียกว่า incremental content updates: สามารถส่งข้อมูลเชิงโครงสร้างเข้าสู่เซสชันได้ตลอดเวลา พร้อมกำหนดบทบาท user หรือ model ชัดเจน และโมเดลจะผสานมันกับเสียงสด นี่คือวิธีป้อนข้อมูลลูกค้าหรือสถานะคำสั่งซื้อเข้าไปกลางสายโดยไม่สะดุด
มีการเปลี่ยนแปลงเล็ก ๆ สองข้อที่กระทบโค้ดเดิม โหมดเสียงเชิงรุก ที่ให้โมเดลเลือกไม่ตอบต่อคำพูดที่ไม่ถูกกล่าวกับมัน โดยถาวรเปิดไว้แล้ว และการตั้งค่าเป็น false จะทำให้เกิดข้อผิดพลาด ส่วนบทสนทนาแนวอารมณ์ถูกถอดออกจาก API ไปแล้ว ดังนั้นต้องลบการตั้งค่า enable_affective_dialog ใด ๆ
Extended Thinking นำทุกตารางคุณภาพและเอเจนต์ที่ Google เผยแพร่ แต่ทิ้งห่าง GPT-Live-1 Astra ของ OpenAI ไม่มาก ขณะที่รุ่นฐาน 3.8 Live ชนะขาดด้านต้นทุน แต่แพ้ในงานเอเจนต์
ค่าดัชนี τ-Voice, Big Bench Audio และต้นทุนด้านล่างมาจากกระดานสาธารณะของ Artificial Analysis จึงเป็นการวัดอิสระไม่ใช่ตัวเลขจากผู้ขาย ตัวเลข τ³-Banking มาจากชาร์ตเปิดตัวของ Google อ้างอิง Sierra จึงควรถือว่าเป็นตัวเลขจากผู้ขายจนกว่ากระดานของ Sierra จะให้ผลตรงกัน
Gemini 3.8 Live Extended Thinking นำหน้าใน τ-Voice เกณฑ์ของ Sierra สำหรับตรวจว่เอเจนต์เสียงทำงานหลายขั้นตอนที่ต้องใช้เครื่องมือสำเร็จหรือไม่ โดยวัดโดย Artificial Analysis GPT-Live-1 Astra ตามมาติด ๆ ส่วนที่เหลือตามหลัง:
ตัวเลขที่ชวนประหลาดใจคือคะแนนของรุ่นฐานบน τ-Voice ต่ำกว่ารุ่นก่อนของตัวเอง Google ระบุชัดว่า 3.8 Live ถูกสร้างมาเพื่อรองรับสเกลและประสิทธิภาพต้นทุน ไม่ใช่เวิร์กโฟลว์ซับซ้อน แต่ช่องว่างกว่า 38 คะแนนระหว่างสองรุ่นย่อยหมายความว่าการเลือกสายผลิตภัณฑ์ไม่ใช่เรื่องละเมียด ถ้าเอเจนต์ของคุณเชื่อมเครื่องมือเป็นทอด ๆ รุ่นฐานไม่ใช่ดีฟอลต์ที่ถูกต้อง
บนกระดาน τ³-Banking ของ Sierra ซึ่งเป็นเกณฑ์ซัพพอร์ตลูกค้าที่เข้มขึ้นสร้างจากเวิร์กโฟลว์ธนาคาร Extended Thinking ได้ 35.1% เทียบกับ 32.0% ของ GPT-Live-1 Astra, 16.5% ของ Grok Voice Think Fast 2.0 ของ SpaceXAI, 11.3% ของ Gemini 3.1 Flash Live และ 10.3% ของ GPT-Realtime 2 ทุกโมเดลบนกระดานนี้ล้มเหลวเป็นส่วนใหญ่ ซึ่งบอกว่าผู้ช่วยเสียงยังไกลจากงานธนาคารแบบไร้ผู้ควบคุม แต่การทำได้เพิ่มขึ้นสามเท่าจากเจเนอเรชันก่อนหน้าของ Gemini ก็ถือว่าเป็นก้าวสำคัญ
บนดัชนี Speech to Speech Extended Thinking ก็นำคู่แข่งเช่นกัน:
การนำ OpenAI 1.1 คะแนนก็คือการนำ แต่คงไม่ใช่ตัวตัดสินใจซื้อเพียงอย่างเดียว
สำหรับการให้เหตุผลจากอินพุตเสียงเพียว ๆ Google รายงาน 97.7% บน Big Bench Audio สำหรับ Extended Thinking และรายงานว่าทั้งสองรุ่นดันพาเรโตฟรอนเทียร์บน EVA-Bench ของ ServiceNow สำหรับเอเจนต์เสียง โดยบาลานซ์ความแม่นยำกับคุณภาพบทสนทนา แม้การทดสอบนั้นจะทำผ่าน Live API บน Gemini Enterprise Agent Platform ไม่ใช่ API สาธารณะ
นี่คือชาร์ตที่ Google อยากให้เห็นที่สุด ในการทดสอบต้นทุนของ Artificial Analysis บนชุดย่อย Big Bench Audio Gemini 3.8 Live ประมวลผลเสียงขาเข้า 1 ชั่วโมงที่ $0.84
Extended Thinking ราคา $3.50 ต่อชั่วโมงเดียวกัน Grok Voice Think Fast 2.0 ราคา $4.80 และ GPT-Live-1 Astra ราคา $5.83 ส่วน Gemini 3.1 Flash Live อยู่ที่ $1.50 และ $1.75 ตามระดับการคิด
อ่านสองแท่งของ Gemini คู่กัน จะเห็นกลยุทธ์สินค้า ชัด รุ่นฐานตัดราคาทุกตัวบนกระดานแบบทิ้งห่าง และรุ่นให้เหตุผลที่คุณภาพสูสีกับ OpenAI ก็ยังถูกกว่าต่อชั่วโมงอินพุตถึงราว 40% โปรดสังเกตว่ารุ่นให้เหตุผลเผาโทเค็นมากขึ้นเมื่อใช้ระดับการคิดที่สูงขึ้น จึงมีต้นทุนรันไทม์ราว 4 เท่าของพี่น้อง ทั้งที่แชร์ตารางราคาเดียวกัน
Gemini 3.8 Live เหมาะเป็นดีฟอลต์สำหรับเอเจนต์เสียงส่วนใหญ่ และ Extended Thinking คุ้มกับโทเค็นที่เผาเพิ่มก็ต่อเมื่อเอเจนต์ต้องวางแผน เปรียบเทียบ หรือรอเครื่องมือที่ช้า แนวทางของ Google ขีดเส้นที่เวลาแฝงของเครื่องมือ: ถ้าฟังก์ชันของคุณตอบกลับในมิลลิวินาที ให้คงอยู่กับรุ่นฐาน
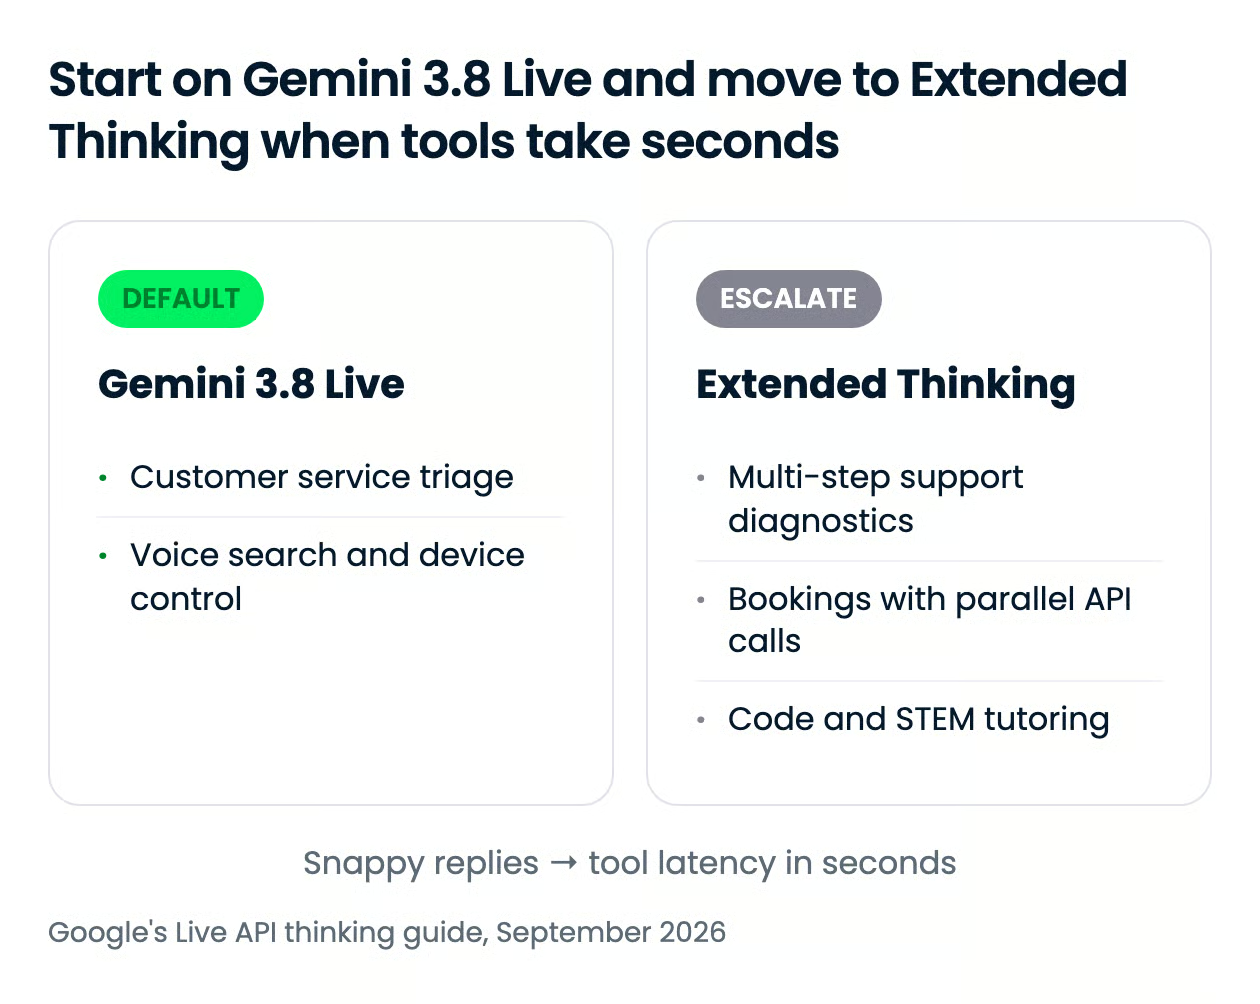
สองรุ่นย่อยแชร์ตารางราคา (กล่าวต่อด้านล่าง) ขีดจำกัดโทเค็นอินพุต 131,072 และเอาต์พุต 65,536 และใช้เอ็นด์พอยต์ WebSocket เดียวกัน สิ่งที่ต่างคือสถาปัตยกรรมการให้เหตุผล
Gemini 3.8 Live ใช้การให้เหตุผลแบบสลับกับการพูด ด้วยโปรไฟล์หน่วงคงที่ และไม่มีการตั้งค่า thinking_level เลย Extended Thinking เปิดให้ตั้งค่าการให้เหตุผลเบื้องหลัง low, medium, และ high สตรีมคำเชื่อมบทสนทนาในระหว่างทำงาน และบังคับใช้เครื่องมือแบบอะซิงก์ ระดับการคิดเหล่านี้คือคันบังคับความพยายามเพียงอย่างเดียวในรุ่นนี้
| Use case | Pick | Why |
|---|---|---|
| คัดกรองงานซัพพอร์ต ค้นหาด้วยเสียง ฝึกภาษา | Gemini 3.8 Live | การโต้ตอบทันทีสำคัญกว่าความลึก และหนึ่งเทิร์นของผู้ใช้ได้คำตอบเดียว |
| ควบคุมอุปกรณ์อัจฉริยะ อ่านค่าจากเซนเซอร์ | Gemini 3.8 Live | เครื่องมือใช้เวลาตอบกลับระดับมิลลิวินาที จึงไม่ต้องมีอะไรกลบ |
| ซัพพอร์ตเชิงเทคนิคที่ต้องดูล็อก รหัสผิดพลาด และเช็กคอนฟิก | Extended Thinking | การวินิจฉัยหลายขั้นตอนต้องให้เหตุผลเบื้องหลังระหว่างคำพูด |
| เอเจนต์ท่องเที่ยวและจองตั๋ว ที่คิวรีไฟลต์และโรงแรมแบบขนาน | Extended Thinking | เรียกแบบอะซิงก์ขนาน พร้อมรายงานความคืบหน้าออกเสียง แทนความเงียบ |
| ติวเตอร์สาย STEM และโค้ด | Extended Thinking | โมเดลตรวจสูตรหรือดีบักโค้ดก่อนอธิบายออกเสียง |
อีกข้อที่ต้องคิด: ความซับซ้อนไคลเอนต์ การย้ายไป Extended Thinking หมายถึงต้องเขียนการจัดการสถานะใหม่รอบ ๆ interaction_status ดังนั้นถ้ามีแอป 3.1 Flash Live ที่ทำงานอยู่ รุ่นฐานคืออัปเกรดแบบเสียบแทน ส่วนรุ่นให้เหตุผลคือการรีแฟคเตอร์เล็กน้อย
ทั้งสองรุ่นใช้ตารางราคาเดียวกับ Gemini 3.1 Flash Live Preview ดังนั้นอัปเกรดฟรี บนชั้นแบบชำระเงิน อินพุตเสียงคิด $3.00 ต่อโทเค็น 1 ล้านโทเค็น ซึ่ง Google ประเมินราว $0.005 ต่อนาที และเอาต์พุตเสียงคิด $12.00 ต่อ 1 ล้านโทเค็น หรือราว $0.018 ต่อนาที โทเค็นสำหรับการคิดคิดราคาเท่าเอาต์พุต นี่คือต้นเหตุที่ Extended Thinking มีต้นทุนรันสูงกว่า
| Modality | Paid tier, per 1M tokens | Per-minute estimate |
|---|---|---|
| Text input | $0.75 | n/a |
| Audio input | $3.00 | $0.005/min |
| Image and video input | $1.00 | $0.002/min |
| Text output | $4.50 | n/a |
| Audio output (including thinking tokens) | $12.00 | $0.018/min |
ชั้นใช้ฟรีครอบคลุมทั้งสองรุ่นโดยไม่คิดค่าอินพุตและเอาต์พุต โดยมีข้อแม้ตามปกติว่า Google จะใช้ข้อมูลจากชั้นใช้ฟรีเพื่อปรับปรุงผลิตภัณฑ์ ข้อมูลจากชั้นชำระเงินจะไม่ถูกใช้แบบนั้น
การยึดโยงกับ Google Search รองรับทั้งสองชั้น โดยให้คำขอค้นหาใช้ฟรี 5,000 ครั้งต่อเดือนร่วมกันในทุกโมเดล Gemini 3.x และ $14 ต่อ 1,000 คำขอหลังจากนั้น Google ยังไม่เผยแพร่ลิมิตอัตราเฉพาะสำหรับโมเดลเหล่านี้ จึงควรตรวจหน้าลิมิตอัตราของ Gemini API สำหรับชั้นของคุณก่อนวางแผนเปิดตัว
ความพร้อมใช้งานแบ่งเป็นสามกลุ่ม:
เอาต์พุตเสียงทุกชิ้นจากทั้งสองรุ่นฝังลายน้ำ SynthID และเอกสารโมเดลของ Google ก็ตรงไปตรงมาเรื่องขีดจำกัด: โมเดลยังอาจเกิด hallucination ความทนทานต่อการเจลเบรกยังอยู่ระหว่างปรับปรุง และอาจมีอาการช้าเป็นครั้งคราวหรือหมดเวลา ควรอ่านข้อควรระวังเหล่านี้ก่อนนำรุ่นใดรุ่นหนึ่งไปอยู่หน้าลูกค้า
รหัสโมเดลคือ gemini-3.8-live และ gemini-3.8-live-extended-thinking ทั้งคู่เป็นสตริงเสถียรไม่มีคำต่อท้าย preview
เข้าถึงได้ผ่าน Gemini Live API ด้วย SDK google-genai สำหรับ Python หรือ JavaScript ผ่าน WebSocket ดิบ หรือใช้งานแบบอินเทอร์แอ็กทีฟในมุมมอง Stream ของ Google AI Studio นอกจากนี้ Google ยังระบุ Agora, Fishjam, LiveKit, LangChain, Pipecat, Vercel และ Vision Agents เป็นพาร์ตเนอร์อินทิเกรชันที่ดูแลชั้นสตรีมมีเดีย และมีเส้นทางสตรีมผ่าน Agent Development Kit หากกำลังพัฒนาบน ADK อยู่แล้ว
ตัวอย่างเซสชัน Python ขั้นต่ำด้านล่างเปิดการเชื่อมต่อ ส่งข้อความแบบข้อความหนึ่งเทิร์น และเปิดทรานสคริปต์เอาต์พุตเพื่ออ่านสิ่งที่โมเดลพูด:
import asyncio
from google import genai

client = genai.Client()
config = {"response_modalities": ["AUDIO"], "output_audio_transcription": {}}

async def main():
    async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
        await session.send_client_content(
            turns={"role": "user", "parts": [{"text": "Read back the claim number 7Q-4418-B."}]},
            turn_complete=True,
        )
        async for response in session.receive():
            if response.server_content and response.server_content.output_transcription:
                print(response.server_content.output_transcription.text)

asyncio.run(main())
หากย้ายมาจาก gemini-3.1-flash-live-preview ให้เปลี่ยนสตริงโมเดล และลบ thinking_level หรือ thinking_config ออกจากการตั้งค่า เซสชัน ที่เหลือวงจรเทิร์นเหมือนเดิม Live API เป็นแบบเซิร์ฟเวอร์ต่อเซิร์ฟเวอร์โดยดีฟอลต์ ดังนั้นไคลเอนต์เบราว์เซอร์และมือถือจำเป็นต้องใช้โทเค็นชั่วคราว
สำหรับเวิร์กธรูเต็มรูปแบบของการจับเสียง การเล่นกลับ และการจัดการเซสชัน ดู บทเรียน Gemini Live API และสำหรับฝั่งข้อความในตระกูลเดียวกัน บทเรียน Gemini 3.8 Flash API ครอบคลุมระดับการคิดและการเรียกฟังก์ชันใน Python
Google กำลังประกาศจุดยืนด้านราคา มากกว่าคุณภาพดิบ Extended Thinking นำ GPT-Live-1 Astra อยู่แต้มสองบนทุกตาราง แต่ Gemini 3.8 Live ที่ $0.84 ต่อชั่วโมงอินพุตเสียงถูกกว่ารุ่นของ OpenAI เกือบ 7 เท่า และนั่นคือตัวเลขที่ชี้ชะตาทราฟฟิกเสียงในโปรดักชันจะไปที่ไหน
ความเห็นคือ: ถ้าใช้อะไรบน Gemini 3.1 Flash Live ให้อัปเกรดสัปดาห์นี้ เพราะราคาเท่าเดิมและแค่การเรียกเครื่องมือแบบอะซิงก์ก็คุ้มแล้ว ถ้าใช้สแต็กเรียลไทม์ของ OpenAI รุ่นฐานคุ้มลองสำหรับโฟลว์คัดกรองและค้นหา และ Extended Thinking ควรลองทุกที่ที่เครื่องมือใช้เวลาหลายวินาที คะแนน 30.1% บน τ-Voice ของรุ่นฐานคือเหตุผลที่ไม่ควรใช้มันสำหรับงานเอเจนต์จริงจัง
ถ้าอยากสร้างฝั่งการเรียกเครื่องมือของเอเจนต์เสียงให้ถูกต้อง แนะนำคอร์ส Building AI Agents with Google ADK ซึ่งเดินสาย Gemini เข้ากับเอเจนต์ซัพพอร์ตลูกค้าพร้อมเครื่องมือ การ์ดเรล และการมอบหมายงาน
เรียนรู้ Agentic AI กับ DataCamp!
Courses
Courses
Courses