course
Tworzenie agentów AI z Google ADK
1 godz.
7.5K
Głos to temat miesiąca. W indeksie Speech to Speech Artificial Analysis, GPT-Live-1 Astra od OpenAI i Grok Voice Think Fast 2.0 od SpaceXAI dzieliło 0,2 punktu na szczycie, a OpenAI wypuściło GPT-6 Astra na początku września. 15 września Google odpowiedziało dwoma nowymi modelami mowa–mowa: Gemini 3.8 Live i Gemini 3.8 Live Extended Thinking.
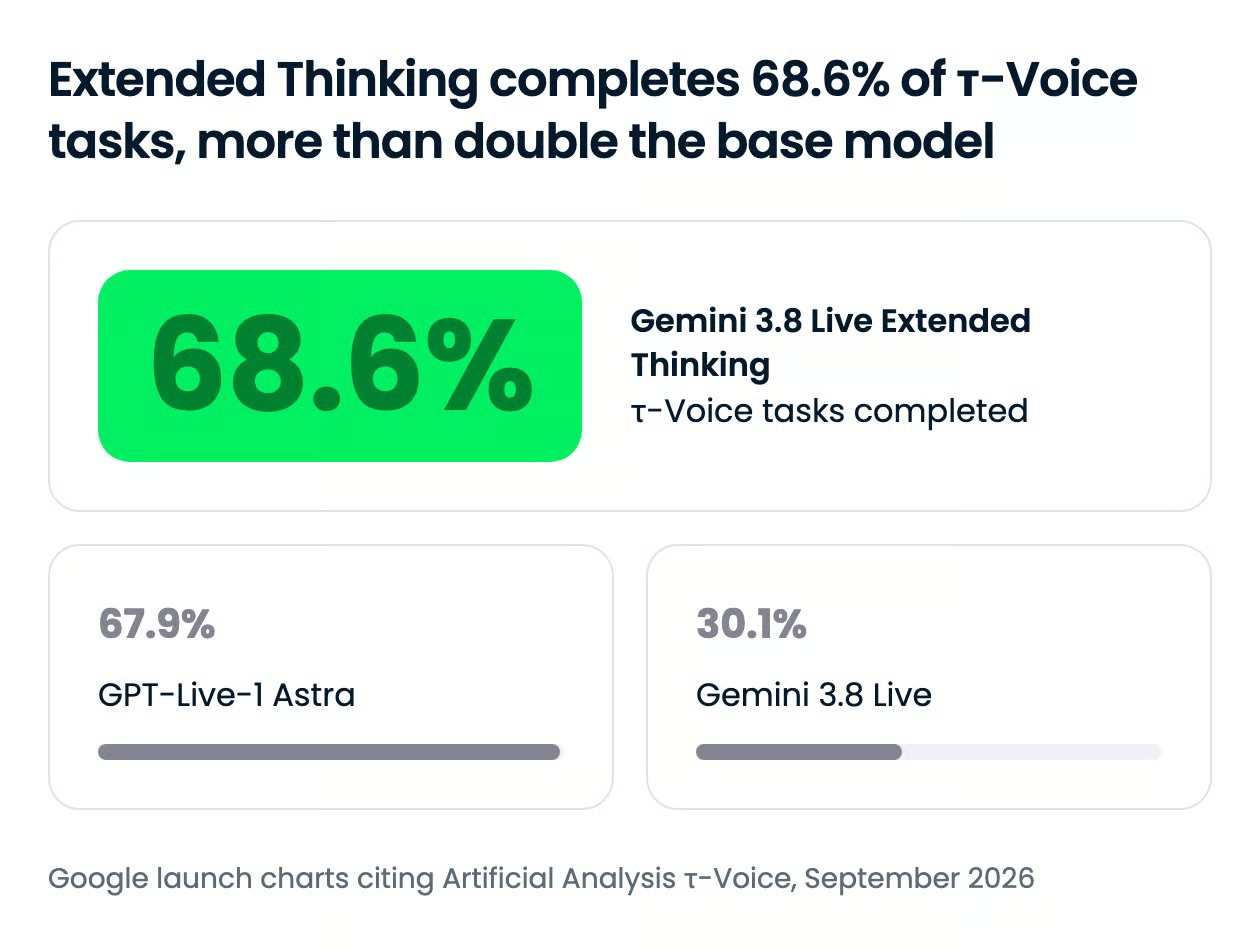
Extended Thinking wskakuje na pierwsze miejsce tego indeksu ze wynikiem 82,6 i prowadzi w benchmarku agentowym τ-Voice z wynikiem 68,6%. Bazowy 3.8 Live to wersja tania: w teście kosztów Artificial Analysis przetwarza godzinę wejściowego audio za 0,84 USD, najniżej spośród modeli ujętych przez Google. Oba są dziś ogólnie dostępne w Gemini API w tej samej cenie co poprzednik, Gemini 3.1 Flash Live.
W tym artykule omawiam wszystko, co nowego w Gemini 3.8 Live: funkcje, benchmarki, podział na dwa warianty i koszty uruchomienia. Zobacz też nasze przewodniki: jak zacząć z Gemini Live API oraz jak zbudować asystenta głosowego z GPT-Live-1.
Gemini 3.8 Live to natywny model Google mowa–mowa dla czasu rzeczywistego w agentach głosowych, wydany 15 września 2026 wraz z „mądrzejszym” rodzeństwem, Gemini 3.8 Live Extended Thinking. Oba działają przez Gemini Live API po połączeniu WebSocket, przyjmują jako wejście audio, wideo, obrazy i tekst, a zwracają audio. Google pozycjonuje 3.8 Live jako domyślny dla dialogu o niskiej latencji, a Extended Thinking jako wybór do złożonych, wieloetapowych zadań.
Zmiana pokoleniowa względem Gemini 3.1 Flash Live dotyczy tego, jak model obsługuje pracę inną niż mówienie. Wywołania narzędzi i API teraz domyślnie działają w tle, podczas gdy model kontynuuje rozmowę, a Extended Thinking dodaje na to konfigurowalne tło rozumowania. Google opisuje ten duet jako jakościowy skok względem wcześniejszych modeli live i jako zamiennik kaskadowych potoków łączących rozpoznawanie mowy, LLM i syntezę mowy.
Google wymienia pięć możliwości nowych modeli, a najważniejsze dla twórców agentów głosowych są te dwie, które zmieniają pętlę konwersacji: asynchroniczne wywołania narzędzi i rozumowanie w tle.
Oba modele wykonują wywołania funkcji i żądania API w tle, jednocześnie strumieniując audio do użytkownika. W Gemini 3.8 Live asynchroniczne wykonanie jest teraz domyślnym trybem wywoływania funkcji. Nadal możesz wymusić stary, synchroniczny tryb, ustawiając behavior: BLOCKING przy deklaracji narzędzia, a model obsługuje planowanie funkcji opcjami SILENT, WHEN_IDLE i INTERRUPTED, które decydują, kiedy wynik zostanie wypowiedziany.
Extended Thinking idzie dalej: wymaga narzędzi nieblokujących i zwraca twardy błąd, jeśli zadeklarujesz blokujące. W praktyce, dzwoniący proszący o zmianę rezerwacji słyszy od razu potwierdzenie, potem informację o postępie, a następnie wynik — zamiast ciszy, którą daje kaskadowy potok czekający na API. W Gemini 3.1 Flash Live wywoływanie funkcji było tylko sekwencyjne, a model nie zaczynał odpowiadać, dopóki nie odesłałeś wyniku narzędzia.
Gemini 3.8 Live Extended Thinking rozumuje i mówi jednocześnie. Dokumentacja Google opisuje używanie wczesnych werbalnych sygnałów typu „Już to sprawdzam”, by potwierdzić komendę, a następnie narrację postępów w miarę kończenia pracy wieloetapowej w tle. Głębokość kontrolujesz parametrem thinking_level ustawionym na low, medium lub high; poziom MINIMAL z 3.1 Flash Live zniknął.
To zmienia protokół i moim zdaniem to najważniejszy detal migracyjny w tym wydaniu. Ponieważ model może mówić kilka razy w ramach jednego żądania, turnComplete: true nie oznacza już bezczynności.
Klient musi obserwować nowe pole interaction_status, które raportuje IN_PROGRESS, gdy rozumowanie lub narzędzia wciąż działają, i IDLE, gdy całe zadanie jest zakończone. Jeśli to pominiesz, UI wróci do „słuchania”, gdy model nadal jest w trakcie zadania.
Gemini 3.8 Live ugruntowuje dialog w bieżącym wejściu wizualnym, przetwarzając klatki wideo niemal w czasie rzeczywistym, aby agent mógł reagować na to, co użytkownik widzi, a nie tylko na to, co mówi. W demach Google znalazły się m.in. partia szachów na żywo i onboarding pracownika, gdzie model odpowiada na pytania o to, co jest na ekranie.
Wideo nie jest jednak darmowe. Domyślnie zasięg tury obejmuje wysyłanie do modelu aktywności audio oraz wszystkich klatek wideo, więc jeśli twoja aplikacja nie potrzebuje wizji, wysyłaj klatki tylko wtedy, gdy są przydatne — ze względu na budżet kontekstu i koszt. Sesje audio+video są też ograniczone do 2 minut przed koniecznością wydłużenia ich zarządzaniem sesją, podczas gdy sesje tylko audio trwają do 15 minut.
Google nazywa to „precyzją alfanumeryczną”: dokładnym parsowaniem na głos podawanych ciągów takich jak kody potwierdzeń, numery spraw i identyfikatory techniczne. Każdy, kto budował agenta głosowego do wsparcia czy logistyki, wie, że na tym potykają się kaskadowe stosy — błąd ASR na początku łańcucha jest dalej nie do odrobienia. Natywny model mowy, który słyszy całe wypowiedzi w kontekście, ma tu strukturalną przewagę.
Gemini 3.8 Live wykrywa i przełącza się między 97 obsługiwanymi językami w trakcie rozmowy, z tym, co Google nazywa spójnością akcentu pomiędzy nimi. Oba modele wspierają też tzw. przyrostowe aktualizacje treści: możesz w dowolnym momencie wysłać do sesji ustrukturyzowane dane z jawną rolą user lub model, a model scala je z żywym audio. Tak wprowadzasz kartę klienta czy status zamówienia do trwającej rozmowy bez przerywania flow.
Dwie drobniejsze zmiany wpływają na istniejący kod. Proaktywne audio, gdzie model może zdecydować, by nie odpowiadać na mowę nienakierowaną na niego, jest teraz trwale włączone, a ustawienie false zwróci błąd. Dialog afektywny został całkowicie usunięty z API, więc każdą konfigurację enable_affective_dialog trzeba usunąć.
Extended Thinking prowadzi na wszystkich tablicach jakości i agentowych, które opublikowało Google, ale niewielką przewagą nad GPT-Live-1 Astra od OpenAI, podczas gdy bazowy 3.8 Live wygrywa zdecydowanie kosztami, lecz przegrywa w zadaniach agentowych.
Indeks, τ-Voice, Big Bench Audio i koszty poniżej pochodzą z publicznej tablicy Artificial Analysis, więc są mierzone niezależnie, a nie raportowane przez dostawców. Liczby τ³-Banking pochodzą z wykresu startowego Google cytującego Sierrę, więc traktuj ten wiersz jako dostawczy, dopóki tablica Sierry tego nie potwierdzi.
Gemini 3.8 Live Extended Thinking prowadzi w τ-Voice, benchmarku Sierry oceniającym, czy agent głosowy realizuje wieloetapowe zadania z użyciem narzędzi, mierzonego przez Artificial Analysis. GPT-Live-1 Astra depcze mu po piętach, a reszta stawki odstaje:
Zaskoczyło mnie, że wynik modelu bazowego w τ-Voice jest niższy niż u jego poprzednika. Google jasno mówi, że 3.8 Live zbudowano pod skalę i efektywność kosztową, a nie złożone workflowy, ale różnica ponad 38 punktów między wariantami oznacza, że wybór poziomu to nie niuans. Jeśli twój agent łączy narzędzia, model bazowy to zły domyślny wybór.
Na tablicy τ³-Banking Sierry, trudniejszym benchmarku obsługi klienta wokół procesów bankowych, Extended Thinking uzyskuje 35,1% wobec 32,0% dla GPT-Live-1 Astra, 16,5% dla Grok Voice Think Fast 2.0 od SpaceXAI, 11,3% dla Gemini 3.1 Flash Live i 10,3% dla GPT-Realtime 2. Każdy model na tej tablicy częściej zawodzi niż działa, co pokazuje, jak daleko agentom głosowym do niesuperwizowanej bankowości, ale potrojenie wyniku względem poprzedniej generacji Gemini to realny krok.
W Speech to Speech Index Extended Thinking również minimalnie wyprzedza konkurencję:
Przewaga 1,1 punktu nad OpenAI to przewaga, ale nie budowałbym na niej decyzji zakupowej.
Dla czystego rozumowania na mowie Google raportuje 97,7% na Big Bench Audio dla Extended Thinking. Google podaje też, że oba modele przesuwają granicę Pareto na EVA-Bench ServiceNow dla agentów głosowych, równoważąc trafność z jakością rozmowy, choć ten przebieg wykonano przez Live API w Gemini Enterprise Agent Platform, a nie w publicznym API.
To wykres, który Google najchętniej ci pokaże. W teście kosztów Artificial Analysis na podzbiorze Big Bench Audio Gemini 3.8 Live przetwarza godzinę wejściowego audio za 0,84 USD.
Extended Thinking kosztuje 3,50 USD za tę samą godzinę, Grok Voice Think Fast 2.0 — 4,80 USD, a GPT-Live-1 Astra — 5,83 USD. Gemini 3.1 Flash Live mieścił się między 1,50 a 1,75 USD w zależności od poziomu „thinking”.
Patrząc na oba słupki Gemini razem, strategia produktowa jest oczywista. Model bazowy mocno podcina wszystkich na wykresie ceną, a model rozumujący, który dorównuje OpenAI jakością, nadal kosztuje o 40% mniej za godzinę wejścia. Zwróć uwagę, że model rozumujący spala więcej tokenów przy wyższych poziomach thinking, stąd około 4× wyższy koszt działania mimo wspólnej tabeli cen.
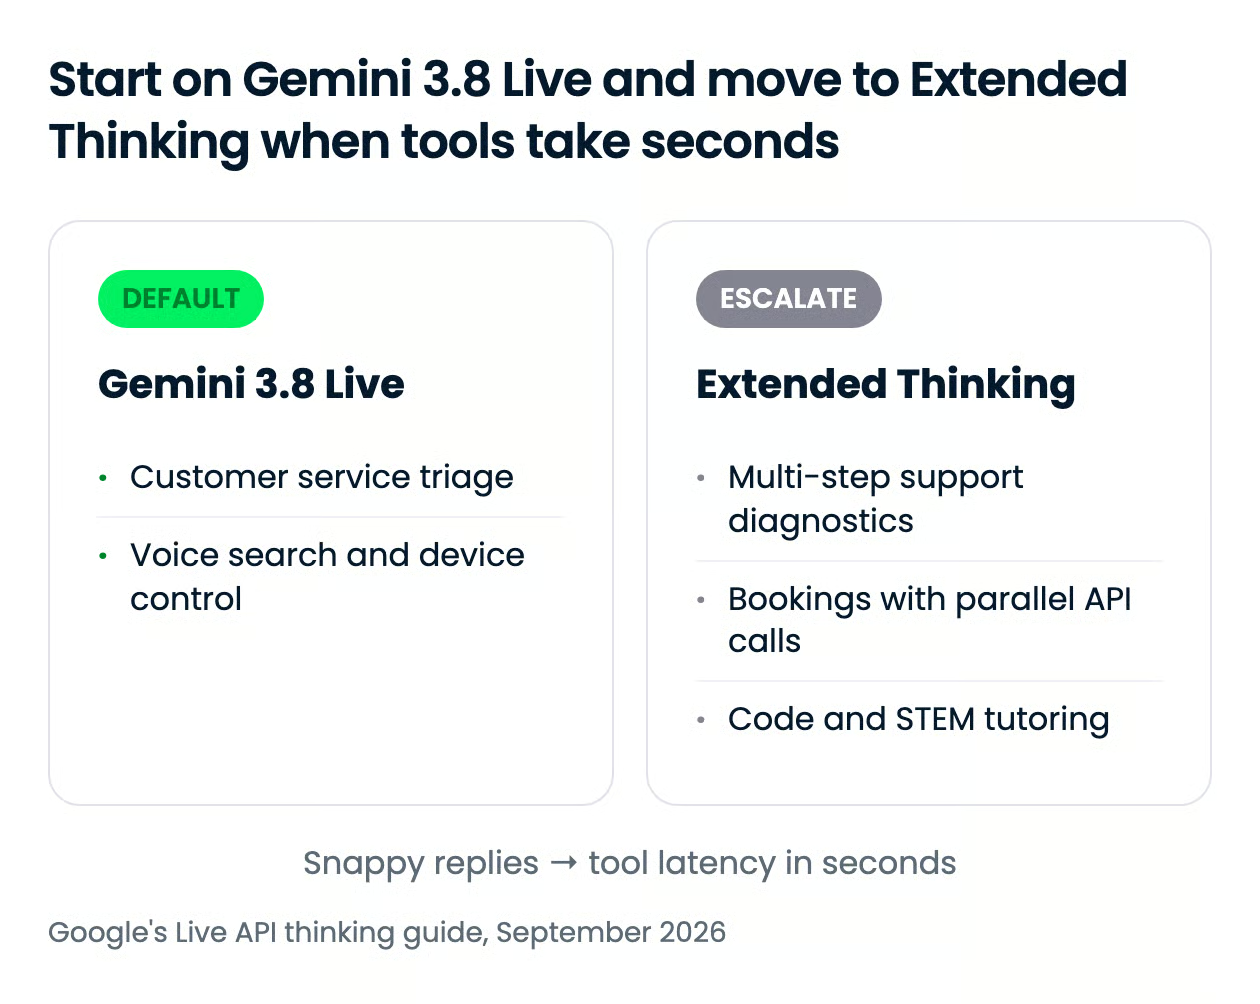
Gemini 3.8 Live to właściwy domyślny wybór dla większości agentów głosowych, a Extended Thinking jest wart wyższego spalania tokenów tylko wtedy, gdy agent musi planować, porównywać lub czekać na wolne narzędzia. Wskazówka Google wyznacza granicę na latencji narzędzi: jeśli twoje funkcje zwracają wyniki w milisekundach, zostań przy modelu bazowym.
Oba warianty dzielą tabelę cen (omówię ją poniżej), limity 131 072 tokenów wejścia i 65 536 wyjścia oraz ten sam endpoint WebSocket. Różni je architektura rozumowania.
Gemini 3.8 Live używa przeplatanego rozumowania z ustalonym profilem latencji i bez ustawienia thinking_level. Extended Thinking udostępnia rozumowanie w tle low, medium i high, strumieniuje wypełniacze konwersacyjne podczas pracy i wymaga asynchronicznych narzędzi. Te poziomy thinking to jedyna dźwignia wysiłku w tym wydaniu.
| Use case | Pick | Why |
|---|---|---|
| Wstępna obsługa klienta, wyszukiwanie głosowe, nauka języków | Gemini 3.8 Live | Natychmiastowe przekazywanie tury jest ważniejsze niż głębia, a jedna tura użytkownika dostaje jedną odpowiedź |
| Sterowanie urządzeniami smart, odczyt wartości czujników | Gemini 3.8 Live | Narzędzia zwracają wyniki w milisekundach, więc nie ma czego maskować |
| Wsparcie techniczne: logi, kody błędów, sprawdzenia konfiguracji | Extended Thinking | Wieloetapowa diagnoza potrzebuje rozumowania w tle między wypowiedziami |
| Agenci podróży: równoległe zapytania o loty i hotele | Extended Thinking | Równoległe wywołania async z mówionymi aktualizacjami postępu zamiast ciszy |
| Nauczanie STEM i kodowania | Extended Thinking | Model weryfikuje wzory lub debugguje kod, zanim wypowie wyjaśnienie |
Jeszcze jedna kwestia: złożoność klienta. Przejście na Extended Thinking oznacza przepisanie obsługi stanu wokół interaction_status, więc jeśli masz działającą aplikację na 3.1 Flash Live, model bazowy to upgrade „plug-and-play”, a wariant z rozumowaniem to mały refaktor.
Oba modele współdzielą tabelę cen Gemini 3.1 Flash Live Preview, więc upgrade jest darmowy. W płatnym progu wejście audio kosztuje 3,00 USD za 1 milion tokenów (Google szacuje to na 0,005 USD za minutę), a wyjście audio 12,00 USD za 1 milion tokenów (około 0,018 USD za minutę). Tokeny „thinking” są rozliczane jak wyjście, stąd wyższy koszt działania Extended Thinking.
| Modality | Paid tier, per 1M tokens | Per-minute estimate |
|---|---|---|
| Wejście tekstowe | $0.75 | n/d |
| Wejście audio | $3.00 | $0.005/min |
| Wejście obrazu i wideo | $1.00 | $0.002/min |
| Wyjście tekstowe | $4.50 | n/d |
| Wyjście audio (w tym tokeny thinking) | $12.00 | $0.018/min |
Darmowy próg obejmuje oba modele bez opłat za wejście i wyjście, z typowym zastrzeżeniem, że Google wykorzystuje dane z darmowego progu do ulepszania swoich produktów; danych z płatnego — nie.
Ugruntowanie w Google Search jest wspierane w obu progach, z 5 000 darmowych zapytań wyszukiwania miesięcznie współdzielonych przez wszystkie modele Gemini 3.x i 14 USD za 1 000 zapytań po przekroczeniu. Google nie opublikowało limitów szybkości specyficznych dla tych modeli, więc przed startem sprawdź stronę limitów Gemini API dla twojego progu.
Dostępność jest podzielona trójtorowo:
Każde wyjście audio z obu modeli ma znak wodny SynthID, a karta modelu Google szczerze opisuje ograniczenia: modele mogą nadal halucynować, odporność na jailbreaki jest wciąż ulepszana, a sporadycznie mogą wystąpić spowolnienia lub timeouty. Warto przeczytać te zastrzeżenia, zanim postawisz którykolwiek model przed klientami.
Identyfikatory modeli to gemini-3.8-live i gemini-3.8-live-extended-thinking, oba stabilne, bez sufiksu „preview”.
Dostaniesz się do nich przez Gemini Live API z SDK google-genai dla Pythona lub JavaScriptu, przez surowe WebSockety albo interaktywnie w widoku Stream Google AI Studio. Google wymienia też Agora, Fishjam, LiveKit, LangChain, Pipecat, Vercel i Vision Agents jako partnerów integracyjnych obsługujących warstwę strumieniowania mediów, a jeśli już budujesz na ADK, jest ścieżka streamingu w Agent Development Kit.
Minimalna sesja w Pythonie poniżej otwiera połączenie, wysyła tekstową turę i włącza transkrypcję wyjścia, żebyś mógł przeczytać, co powiedział model:
import asyncio
from google import genai

client = genai.Client()
config = {"response_modalities": ["AUDIO"], "output_audio_transcription": {}}

async def main():
    async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
        await session.send_client_content(
            turns={"role": "user", "parts": [{"text": "Read back the claim number 7Q-4418-B."}]},
            turn_complete=True,
        )
        async for response in session.receive():
            if response.server_content and response.server_content.output_transcription:
                print(response.server_content.output_transcription.text)

asyncio.run(main())
Jeśli migrujesz z gemini-3.1-flash-live-preview, zmień nazwę modelu i usuń z konfiguracji wszelkie thinking_level lub thinking_config; cykl tury jest poza tym identyczny. Live API jest domyślnie server-to-server, więc klienci przeglądarkowi i mobilni potrzebują tokenów efemerycznych.
Pełny walkthrough przechwytywania audio, odtwarzania i zarządzania sesją znajdziesz w naszym tutorialu Gemini Live API, a po stronie tekstowej tej samej rodziny nasz tutorial Gemini 3.8 Flash API obejmuje poziomy thinking i wywoływanie funkcji w Pythonie.
Google stawia na cenę, nie na gołą jakość. Przewaga Extended Thinking nad GPT-Live-1 Astra to punkt czy dwa na każdej tablicy, ale Gemini 3.8 Live z kosztem 0,84 USD za godzinę wejściowego audio jest blisko siedem razy tańszy od modelu OpenAI — i to ta liczba decyduje, gdzie trafi ruch produkcyjny.
Moje zdanie: jeśli cokolwiek uruchamiasz na Gemini 3.1 Flash Live, zaktualizuj w tym tygodniu — cena ta sama, a samo async wywoływanie narzędzi jest tego warte. Jeśli korzystasz ze stosu realtime OpenAI, model bazowy warto przetestować w triage i wyszukiwaniu, a Extended Thinking — tam, gdzie twoje narzędzia działają po kilka sekund. Wynik 30,1% w τ-Voice to powód, by nie używać bazowego wariantu do pracy agentowej.
Jeśli chcesz porządnie zbudować stronę wywoływania narzędzi w agencie głosowym, polecam nasz kurs Building AI Agents with Google ADK, który spina Gemini w agenta wsparcia z narzędziami, guardrailami i delegowaniem.
Naucz się Agentic AI z DataCamp!
course
course
course