

실험과 하니스 설계
제 구현에서는 Claude를 네 개의 파이썬 함수(도구)와 짝지었습니다. 데이터셋 이후에 코드를 보여드리겠습니다. 완전한 코드와 선택형 Streamlit 인터페이스는 GitHub 저장소에 있습니다.
네 가지 냉각 모델 정의
뉴턴의 냉각 법칙은 물체와 실내 온도의 차이가 클수록 더 빨리 식고, 차이가 줄수록 느려진다고 말합니다. 식은 T(t) = Ta + (T0 - Ta) * exp(-k * t) 입니다. 여기서 T0는 시작 온도, Ta는 실내 온도, k는 분당 냉각률입니다.
에이전트가 선택할 수 있도록 네 가지 모델 계열을 작성했습니다:
-
단일 속도: 전체 구간에서 하나의
k, 기준선으로 사용 -
시간 변화: 모든 실행에서 동일한 경과 시점에 전환되는 두 속도
-
온도 임계값: 공통 온도에서 전환되는 두 속도(실행마다 전환 시점이 다름)
-
센서 오프셋: 하나의 실제 속도 + 중간부터 시작해 증가하는 탐침 오차
가시 측정치와 숨겨진 진실 분리
Claude는 세 개의 냉각 시계열과 도구가 반환하는 것만 봅니다. 실제 속도, 임계값, 데이터 설정, 확인용 측정치는 도구 접근 범위 밖에 둡니다.
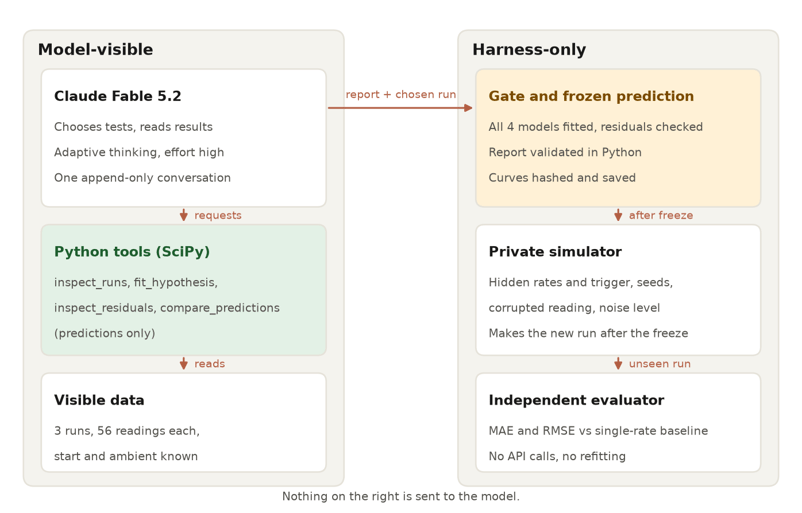
Claude는 도구에 접근하지만, 진실은 숨겨집니다. 이미지: 작성자.
Claude 주위의 모든 파이썬 구성 요소가 에이전트 하니스를 이룹니다. 도구 실행 외에도 요청 수, 시간, 비용 상한을 둡니다. 도구 루프에서 설명하겠습니다.
첫 API 호출 전에 후보 모델, 매개변수 경계, 한계, 새 실험의 통과 규칙을 고정했습니다: RMSE가 최대 1.0 °C이면서 단일 속도 기준선의 절반 이하일 것. 이 규칙은 끝까지 고정입니다.
파이썬에서 Claude Fable 5.2 설정
설정에는 가상 환경과 API 키가 필요합니다. claude-fable-5-2 모델은 프롬프트와 대화 이력을 최대 100만 토큰까지 읽고, 최대 12만8천 토큰을 출력할 수 있습니다.
모델이 답변 전에 얼마나 추론할지 스스로 결정하는 적응형 사고는 항상 켜져 있으며, API 기본값은 높은 노력입니다. Claude API 가격은 입력 100만 토큰당 $8, 출력 100만 토큰당 $40이며, 5분 프롬프트 캐시 쓰기는 $10, 캐시 읽기는 $0.20입니다.
필요한 항목:
-
Python 3.12+ (NumPy 2.5.4와 SciPy 1.18.1이 요구, Anthropic 패키지 자체는 3.10 지원)
-
claude-fable-5-2접근 권한이 있는 API 키 -
모델 ID를 추가한 릴리스인
anthropic2.7.0
프로젝트를 클론하고 고정 의존성을 설치하세요. macOS나 Linux에서는 python3.12 -m venv .venv로 환경을 만들고, source .venv/bin/activate로 활성화하며, Copy-Item은 cp로 바꾸세요.
git clone https://github.com/KhalidAbdelaty/claude-fable-5-2-api.git
cd claude-fable-5-2-api
py -3.12 -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env # then paste your key after ANTHROPIC_API_KEY=코드는 API 키를 환경에서 로드하고, 이를 출력하지 않습니다. 저장소의 README에 전체 실험을 위한 명령이 있으며, 그중 API를 호출하는 것은 두 개뿐입니다. 일반적인 키와 과금은 Claude API 가이드를 참고하세요.
Fable 5.2에 첫 API 요청 보내기
이미 파이썬에서 Claude를 호출해보셨다면 이 섹션은 건너뛰세요. 이 요청은 두 가설을 가르는 증거에 초점을 맞춥니다.
import anthropic
from dotenv import load_dotenv
load_dotenv(".env", override=True)
client = anthropic.Anthropic() # reads ANTHROPIC_API_KEY
response = client.messages.create(
model="claude-fable-5-2",
max_tokens=4096,
output_config={"effort": "high"},
messages=[{"role": "user", "content": (
"Three cooling runs start at 80, 95, and 110 C. Each seems to slow down partway through. "
"In three short bullets: what pattern across the runs would point to a change after a fixed "
"time, what pattern would point to a change at a fixed temperature, and what the data alone "
"cannot tell us.")}],
)
print("block types:", [block.type for block in response.content])
print("stop reason:", response.stop_reason)
print("".join(block.text for block in response.content if block.type == "text"))Claude는 형식이 지정된 콘텐츠 블록의 리스트를 반환하므로, 텍스트는 블록 유형으로 판독하세요. content[0]가 사고(thinking) 블록일 수 있습니다. 첫 응답은 다음과 같습니다:
block types: ['thinking', 'text']
stop reason: end_turn
- **Fixed time:** the slowdown appears at the same elapsed time in all three runs but at different temperatures, with the hotter-start runs still hotter when it happens.
- **Fixed temperature:** the slowdown appears at the same temperature in all three runs but at different elapsed times, with the hotter-start runs reaching it later.
- **What the data cannot tell us:** the cause. A matching pattern shows what the change tracks, not why it happens (for example a phase change, a setup artifact, or a shift in the surroundings). Since cooling naturally slows as it nears room temperature, the data also cannot show on its own that there is a distinct change rather than a smooth curve.thinking과 text 블록이 모두 나타났습니다. 사고 토큰은 출력 토큰으로 계산되므로 비용 추정 시 포함해야 합니다. Claude Fable 5.2 마이그레이션 가이드에는 budget_tokens, 사고 disabled, temperature, top_p, top_k가 400 오류를 반환한다고 명시되어 있습니다.
데이터 누출 없이 냉각 데이터셋 만들기
데이터는 모델 적합이 필요할 만큼 충분히 지저분해야 하고, 정답은 Claude의 손이 닿지 않는 곳에 있어야 합니다.
세 개의 냉각 실행 시뮬레이션
저는 숨겨진 연속적 냉각 변화가 있는 뉴턴 냉각 법칙으로 세 실행을 시뮬레이션했습니다. 실행 A는 21.0 °C 실내에서 80 °C, B는 24.0 °C에서 95 °C, C는 22.5 °C에서 110
C에서 시작합니다. 고정된 NumPy 난수 발생기로 가우시안 잡음을 추가하고, 일부러 한 측정값에 추가 오류를 넣었습니다.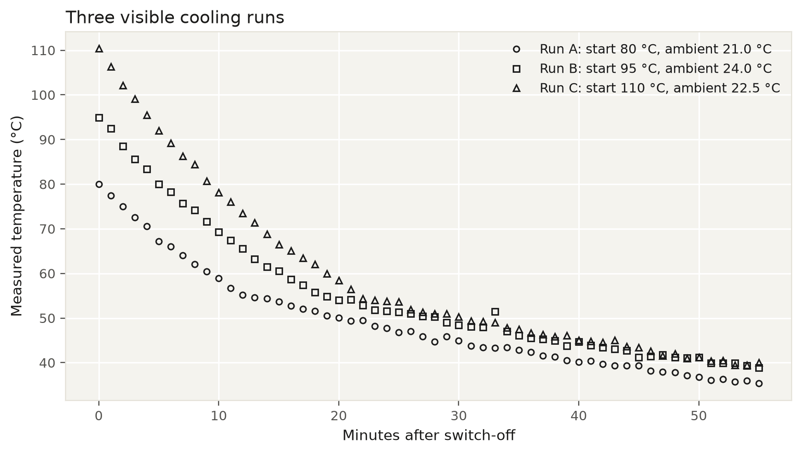
세 개의 잡음 실행에는 이상치 하나가 포함됩니다. 이미지: 작성자.
실행 A는 초반에 더 빨리 식고 후반에 더 느립니다. 이 패턴만으로는 불연속 변화가 있다고 말할 수 없습니다. 어떤 지수 곡선도 실내 온도에 가까워지면 자연히 느려지기 때문입니다.
실행 B에는 약 4 °C의 단발성 점프가 있으며, 다른 곳의 인접 간격은 1.2 °C 이하에 머뭅니다. 각 굴곡은 여러 잡음 분에 걸쳐 분산되어, 눈으로만은 시간·임계값 모델을 구분하기 어렵습니다.
파이썬 도구로 냉각 가설 검정
파이썬은 동일 규칙하에 각 냉각 후보를 적합해 매개변수와 오차를 반환합니다. Claude는 적합 코드 자체는 보지 못하고, 각 도구가 반환하는 결과만 봅니다.
이상치 하나에 끌려가지 않게 공유 매개변수 적합
적합이란, 예측 곡선이 각 측정값에 가깝도록 매개변수를 선택하는 것입니다. 저는 소프트 L1 손실을 사용합니다. 큰 오차의 영향력을 줄이되 해당 측정을 삭제하지는 않기 때문입니다.
모든 실행은 적합된 매개변수를 공유하고, 각 실행은 시작 온도와 실내 온도를 개별적으로 유지합니다. 임계값 모델에서는 실행마다 전환 시간이 달라지며, 식은 ln((T0 - Ta) / (threshold - Ta)) / k_above입니다.
SciPy의 least_squares()는 최적 적합 매개변수를 찾고, 매개변수 경계는 실행 전 고정한 범위 안에 속도와 전환점을 유지합니다.
아래 발췌는 해법 호출과 수렴 확인을 보여줍니다. 잔차 함수와 그 주변의 그리드 스캔은 저장소에 있습니다.
from scipy.optimize import least_squares
def _solve(hypothesis, names, x0, lo, hi, runs):
# soft L1: residuals under f_scale count roughly squared, larger ones roughly linearly
return least_squares(_residuals, x0, bounds=(lo, hi), method="trf",
loss="soft_l1", f_scale=0.5, args=(hypothesis, names, runs))
# scan the change point in 0.5 steps with the rates fitted at each step, then refine all three
res = _solve(hypothesis, names, best_grid_point, lo, hi, runs)
converged = bool(res.success and res.status > 0 and np.all(np.isfinite(res.x)))
at_bound = [n for n, v, a, b in zip(names, res.x, lo, hi) if min(v - a, b - v) < 1e-4 * (b - a)]f_scale은 실행 전에 0.5 °C로 설정했습니다. 그보다 큰 잔차는 소프트 L1에서 영향력이 줄어듭니다. 전환점에 대한 그리드 스캔은 해법에 합리적인 시작값을 제공합니다.
실행 하나씩 제외해 모델 검증
MAE는 평균 빗나감(°C)입니다. RMSE는 먼저 오차를 제곱해 큰 오차의 비중을 키웁니다.
훈련 오차는 매개변수가 많은 모델에 유리합니다. 교차 검증은 제외 데이터를 회전시켜 홀드아웃 오차를 추정합니다. 여기서는 LORO(Leave-One-Run-Out)로 두 실행으로 적합하고 세 번째를 예측합니다.
Claude 도구 호출 스키마 정의
도구 스키마는 파이썬 함수와 Claude가 보낼 수 있는 인자를 JSON으로 기술한 것입니다. 엄격한 도구 사용은 파이썬이 함수를 실행하기 전 그 모양을 API가 검사하게 합니다.
Claude는 네 가지 도구를 요청할 수 있습니다:
-
inspect_runs: 가시 측정치와 단순 기울기 요약을 반환 -
fit_hypothesis: 냉각 모델 하나를 적합하고 매개변수와 홀드아웃 오차를 반환 -
inspect_residuals: 관측 온도와 모델 예측의 차이를 보여줌 -
compare_predictions: 제안된 실험 조건에서 적합된 모델들을 비교
compare_predictions 스키마는 확인 측정치를 도구 밖에 둡니다:
{"name": "compare_predictions", "strict": True,
"description": "Predict a new run from existing fits under proposed conditions and report how far the "
"predictions differ. initial_temp_c must be 75 to 115 and ambient_temp_c 20 to 25. "
"Returns predictions only; no new measurements are generated.",
"input_schema": {"type": "object", "additionalProperties": False,
"properties": {"initial_temp_c": {"type": "number"},
"ambient_temp_c": {"type": "number"},
"fit_ids": {"type": "array", "items": {"type": "string"}}},
"required": ["initial_temp_c", "ambient_temp_c", "fit_ids"]}}fit_ids 값은 같은 조사에서 이전에 적합된 모델을 가리킵니다. 엄격 스키마는 minimum이나 maximum을 허용하지 않으므로, 온도 범위는 파이썬이 직접 검사합니다. tool_choice는 자동으로 두세요. Fable 5.2에서는 도구를 강제하면 400 오류가 납니다.
Claude 도구 루프 구성
애플리케이션은 한 사이클을 반복합니다. 대화를 Claude에 보내고, 요청된 파이썬 도구를 실행해 결과를 반환합니다. 필요한 비교가 끝나면, 고정 형식의 최종 보고서를 요청합니다.
가설 검정을 위한 프롬프트 작성
시스템 프롬프트는 답을 암시하지 않고 방법을 설명합니다. 핵심 프롬프트는 다음과 같습니다:
SYSTEM = """You are a scientific investigator working on a controlled cooling experiment. You decide which
checks to run and how to read the results. Python tools do every numerical calculation.
How to work:
- Look at the measurements before you choose a model.
- Fit every candidate model with fit_hypothesis. Compare them on leave-one-run-out error as well as
training error, because a model with more parameters always fits the training runs at least as well.
- Use inspect_residuals to look for systematic patterns and to decide whether any single reading is
an outlier.
- Use only numbers that a tool returned. Do not invent measurements, parameters, or errors.
- Keep observed evidence separate from assumptions. The data can show which mathematical model fits
best; it cannot show the physical cause of a change.
- If the evidence does not separate the candidates, say so and treat the result as inconclusive.
..."""저는 마지막 항목을 가장 중시합니다. 없으면, 오차가 막상 막하여도 모델은 억지로 승자를 골라야 하거든요.
도구 루프는 추가만 하고 수정하지 않기
모든 호출은 동일한 system과 tools를 보내고, 각 응답은 손대지 않은 채로 되돌립니다. 아래 발췌는 메시지 처리만 보여주며, 중단 처리까지 포함한 전체 루프는 저장소에 있습니다.
resp = client.messages.create(
model="claude-fable-5-2",
max_tokens=20_000,
system=SYSTEM,
tools=TOOLS, # all four, declared on the first request
thinking={"type": "adaptive", "display": "summarized"},
output_config={"effort": "high"},
cache_control={"type": "ephemeral"}, # automatic prompt caching
messages=messages,
)
messages.append({"role": "assistant", "content": resp.content}) # unchanged, thinking included
if resp.stop_reason == "tool_use":
results = []
for block in resp.content:
if block.type == "tool_use":
out, is_error = box.run(block.name, dict(block.input))
results.append({"type": "tool_result", "tool_use_id": block.id,
"content": out, "is_error": is_error})
messages.append({"role": "user", "content": results})보존된 사고를 통해, system, tools, 이전 메시지가 바뀌지 않는 한 Claude는 앞선 추론을 회차 간 유지합니다. Fable 5.2에서는 이들 중 하나라도 수정하면 기본적으로 400 오류가 납니다.
output_config, tool_choice, max_tokens는 호출 간 바꿀 수 있지만, 새로운 출력 형식은 프롬프트 캐시를 활용하지 못합니다. 위 루프처럼 병렬 도구 결과는 하나의 사용자 메시지로 묶어 보내세요.
요청 수, 시간, 비용 한도 설정
파이썬은 요청 수, 도구 호출 수, 경과 시간, 비용을 집계하고, 한도에 도달하면 새 작업을 시작하지 않습니다. 이미 진행 중인 요청은 시간·비용 한도를 넘길 수 있으므로, 이 둘은 소프트 한도로 취급하세요.
최종 답변을 수락하기 전, 파이썬은 Claude가 모든 후보를 적합하고, 잔차를 점검했으며, 확인 설계를 비교했는지를 확인합니다. 도구 요청이나 정상 종료 외의 이유로 Claude가 멈추면, 조사는 결론 불가로 끝납니다. max_tokens는 사고와 답변을 모두 담을 만큼 충분히 크게 설정하세요.
구조화된 보고서 반환
검사가 통과되면, 같은 이력에 대해 구조화된 출력을 요청해, 최종 보고서를 검증된 파이썬 객체로 받습니다:
messages.append({"role": "user", "content": REPORT_PROMPT})
resp = client.messages.parse(
model="claude-fable-5-2", max_tokens=20_000, system=SYSTEM, tools=TOOLS,
thinking={"type": "adaptive", "display": "summarized"},
output_config={"effort": "high"},
output_format=InvestigationReport, # the SDK sends this as output_config.format
tool_choice={"type": "none"}, # tools stay declared, so the prefix check passes
messages=messages,
)
problems = validate(resp.parsed_output, box.fits) # fit IDs exist, all four covered, ranges holdPydantic이 보고서의 형태를 검사하고, validate()는 인용된 모든 적합 결과가 존재하며 조건이 허용 범위 안에 있음을 확인합니다. 그 이후에는 모델 선택과 조건이 최종 확정됩니다.
Fable 5.2가 온도 임계값 모델을 선택
high 노력 수준에서 한 번 조사했습니다. Claude가 답에 도달한 과정은 다음과 같습니다.
Claude의 테스트 순서 추적
Claude는 먼저 측정값을 살폈습니다. 아무것도 적합하기 전에 요약은 이렇게 썼습니다: “변화는 모든 실행에서 약 55 °C에서 나타납니다. A에서는 12분, B에서는 19분, C에서는 22분입니다. 이는 임계값을 가리키므로, 네 가지 모두를 적합하겠습니다.”
저는 이를 앵커링으로 보겠습니다. Claude는 검증 전에 답을 정했습니다. 이후 적합 결과도 분 12, 18, 22 부근에서 전환으로 일치했습니다. 터미널 추적은 남은 점검의 순서를 보여줍니다.
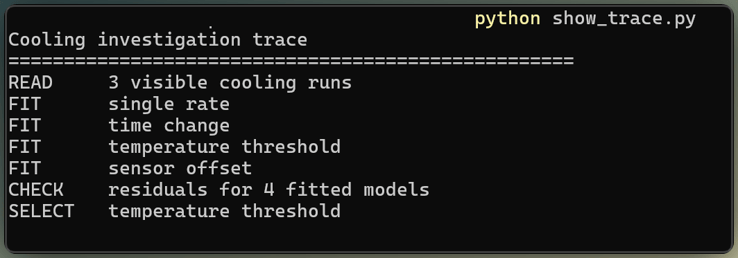
터미널 추적에 Claude의 점검 순서가 나타납니다. 이미지: 작성자.
네 모델의 홀드아웃 오차 비교
훈련 RMSE는 세 실행 전체에서 각 적합을 측정합니다. 홀드아웃 열은 세 번의 LORO 테스트를 평균한 값입니다.
|
후보 |
주요 가정 |
훈련 RMSE (°C) |
홀드아웃 MAE (°C) |
홀드아웃 RMSE (°C) |
|
단일 속도 |
전체 구간 하나의 속도 |
4.08 |
3.90 |
4.60 |
|
시간 변화 |
공유 전환, 약 19분 |
1.92 |
2.17 |
2.63 |
|
온도 임계값 |
공유 전환, 약 55 °C |
0.49 |
0.32 |
0.48 |
|
센서 오프셋 |
증가하는 측정 드리프트 |
1.49 |
1.45 |
1.87 |
임계값 모델은 훈련과 홀드아웃 오차가 가깝습니다. 적합이 실행 간에 잘 이어진다는 뜻이지만, 일반적으로 세 실행만으로 오버피팅을 배제할 수는 없습니다. 아래 잔차 플롯은 관측 온도에서 각 모델의 예측을 뺀 값입니다.
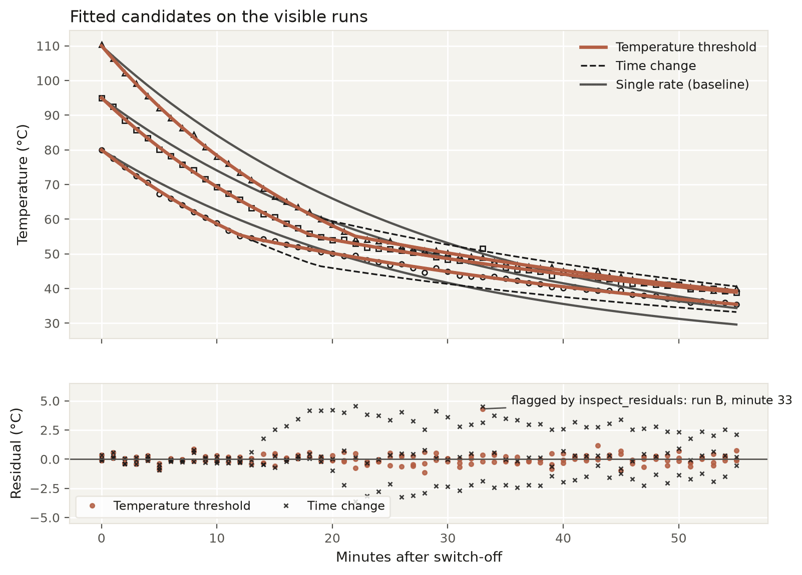
임계값 모델의 잔차는 체계적 패턴이 없습니다. 이미지: 작성자.
시간 변화 적합은 실행 B에는 맞지만, 전환 후 실행 A에서 약 +2.5~+3.5 °C, 실행 C에서 -1.5~-2.8 °C 정도 빗나갑니다.
저는 순위만큼 부호 변화가 유익하다고 봅니다. 전환이 A에서는 더 이르고 C에서는 더 늦다는 뜻으로, 온도 트리거의 예측과 맞아떨어집니다. 센서 오프셋 모델은 드리프트를 더해 일부 오차를 줄이지만, 홀드아웃 오차는 여전히 더 큽니다.
오염된 측정 확인
에이전트는 제가 어느 측정을 오염시켰는지 몰랐습니다. 실행 B 33분 지점에서 약 +4.3 °C 잔차를 찾았습니다. 전형적 잔차 분포로부터의 거리를 재는 강건한 z-점수는 12를 넘었습니다.
소프트 L1이 이미 끌림을 제한하므로 Claude는 그 측정을 남겨두었습니다. 그 선택을 확인하기 위해, 해당 점을 제거하고 네 모델 전부를 다시 적합했습니다. 임계값 모델은 여전히 큰 차이로 1위를 유지했고, 임계값 추정도 거의 변하지 않았습니다.
확인 실험 설계
에이전트는 몇 가지 시작 온도와 실내 온도에서 후보 예측을 비교한 뒤, 새로운 측정을 전혀 보지 않은 채 조건을 선택했습니다.
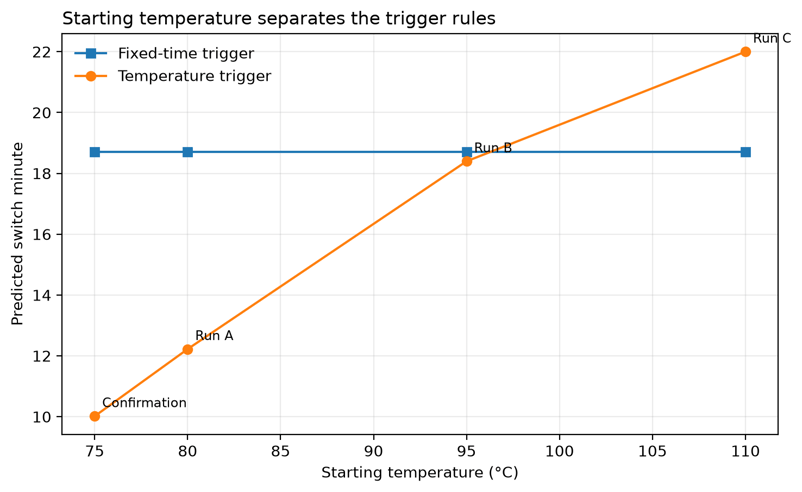
시작 온도가 각 트리거 규칙을 드러냅니다. 이미지: 작성자.
모델을 가르는 조건 선택
요약에서 언급했듯, 에이전트는 시작 75 °C와 실내 20 °C를 선택했습니다. 임계값 모델은 약 10분, 시간 모델은 약 19분에 전환합니다. 센서 오프셋 곡선도 임계값 예측과 분리됩니다.
실행 B에 가까운 중간 영역 설정은 임계값·시간 모델의 차이를 약 0.6 °C로만 벌립니다. 선택된 조건은 테스트 범위를 약간 벗어나며, Claude는 이를 보고서에 표시했습니다.
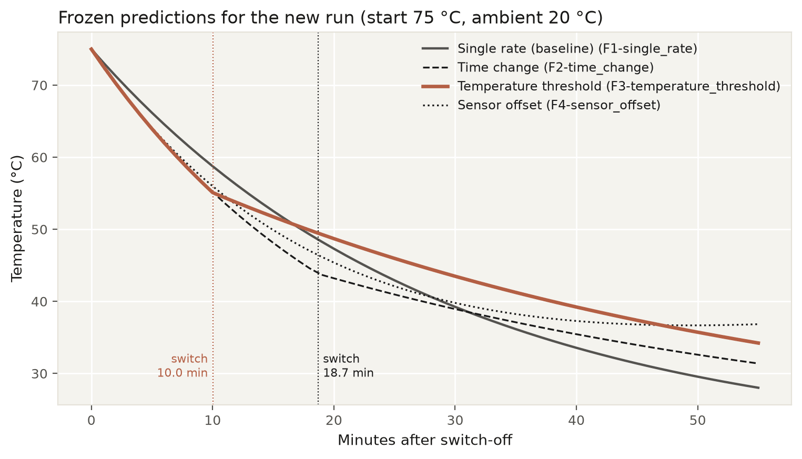
선택된 실행에 대한 후보 예측. 이미지: 작성자.
데이터 생성 전 예측 동결
새 측정을 생성하기 전에, 선택된 조건, 적합 매개변수, 각 후보의 예측을 모두 동결했습니다. 에이전트는 확인 측정치를 받지 못했으며, 결과를 보고 나서 답을 수정할 수 없었습니다.
확인 측정은 동일한 가우시안 잡음 모델과 별도의 고정 시드를 사용하며, 추가 이상치는 없습니다.
보지 못한 실행 채점
분리된 파이썬 코드가 동결 예측을 채점했습니다. API를 호출하지 않으므로 Claude는 자신의 답을 채점하는 데 관여하지 않습니다.
독립 파이썬으로 예측 채점
임계값 예측은 사전 설정한 두 테스트를 모두 통과했습니다. 보지 못한 실행에서 MAE 0.27 °C, RMSE 0.32 °C였습니다. 고정 시간은 RMSE 3.67 °C, 센서 오프셋 2.35 °C, 단일 속도 4.28 °C였습니다.
확인 실행에는 의도적 이상치가 없으므로, LORO 결과 대비 오류가 더 낮은 이유 중 하나가 됩니다. 다른 난수 샘플도 기여했을 수 있습니다.
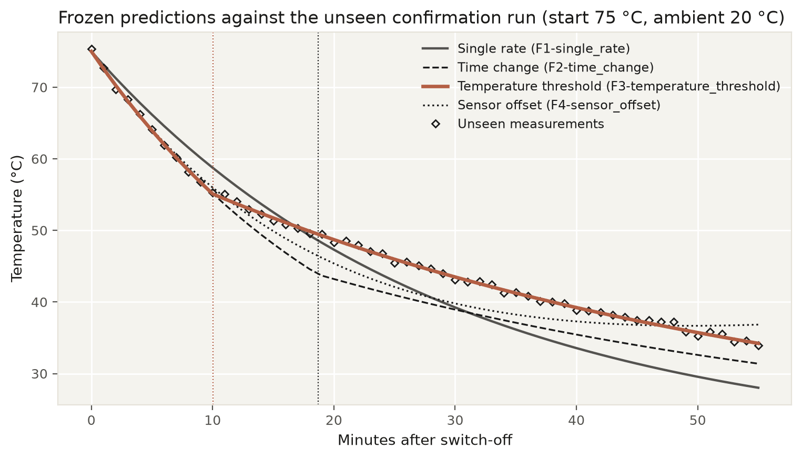
동결 예측이 보지 못한 측정과 잘 맞습니다. 이미지: 작성자.
적합 매개변수와 숨겨진 진실 비교
채점 후, 적합 매개변수를 숨겨진 생성 값과 비교합니다:
import numpy as np
def true_curve(t0, ta, minutes, truth):
"""Newton cooling whose rate drops when the temperature crosses a threshold. Continuous at the switch."""
t = np.asarray(minutes, dtype=float)
k1, k2, th = truth["k_above"], truth["k_below"], truth["threshold_c"]
if t0 <= th:
return ta + (t0 - ta) * np.exp(-k2 * t)
t_cross = np.log((t0 - ta) / (th - ta)) / k1
fast = ta + (t0 - ta) * np.exp(-k1 * t)
slow = ta + (th - ta) * np.exp(-k2 * (t - t_cross)) # restarts from the threshold
return np.where(t <= t_cross, fast, slow)시뮬레이터는 이 곡선을 중심으로 시드된 가우시안 잡음을 더합니다.
숨겨진 규칙은 55 °C 임계값과 분당 0.045, 0.020의 속도, 그리고 0.35 °C의 잡음 표준편차였습니다.
적합된 속도는 소수점 셋째 자리까지 일치했고, 임계값은 0.1 °C 이내, 전환 예측은 0.1분 이내였습니다.
데이터는 시뮬레이터가 사용한 수학적 규칙을 식별합니다. 실제 장치가 55 °C 부근에서 느려지는 이유가 상변화인지, 팬 주기인지, 다른 물리적 원인인지는 보여줄 수 없습니다.
에이전트의 결론 도출 과정 검토
보고서는 증거로 적합 ID와 도구 번호를 인용했고, 세 실행만으로는 입증할 수 없는 부분도 명시했습니다. 약점은 앞서 언급한 초기 추측입니다. 단일 조사는 그런 추측이 얼마나 자주 빗나가는지 보여주지 못합니다.
Streamlit에서 조사 과정 보기
영상에서는 라이브 실행을 시작해 도구 로그를 따라가고, 채점 후 Report, Curves, Confirmation, Cost 탭을 엽니다.
Streamlit 인터페이스는 한 번의 조사를 보여줍니다. 영상: 작성자.
Claude Fable 5.2 API 비용 측정
조사(최종 보고서 포함) 비용은 약 $0.49, 소요 시간은 1분 조금 넘었습니다. SciPy는 로컬에서 실행되므로 API 요금에 영향을 주지 않습니다.
보고서 요청 하나가 비용과 시간의 거의 절반을 차지했습니다. 도구 루프 섹션에서 언급했듯, 새로운 출력 형식은 프롬프트 캐시를 활용하지 못하므로 마지막 요청이 긴 보고서를 쓰기 전 대화를 전부 다시 처리했습니다. 캐시 미적용 입력, 캐시 쓰기, 캐시 읽기, 출력은 각각 가격이 다르니 별도로 추적하세요.
한계와 실무 고려사항
여기서 중요한 한계는 두 가지입니다. 실험이 보여줄 수 있는 것과, 코드를 서비스로 돌리기 전에 필요한 것.
과학적 한계
시뮬레이터와 임계값 후보는 같은 식을 사용합니다. 실제 장치의 점진적 전환도 다른 곡선을 따르며 이 모델에 들어맞을 수 있습니다.
진짜 규칙이 후보에 없었다면, 에이전트는 inconclusive라 답하기보다 제공된 것 중 가장 가까운 모델을 고를 수 있습니다. 잡음이 더 크거나 임계값을 간신히 넘는 경우, 오차가 너무 비슷해 구분이 어려울 수 있습니다. 다른 실행에서는 도구 순서가 달라질 수도 있습니다.
프로덕션 전 체크리스트
도구 루프의 한계는 로컬에서 단일 조사를 다룹니다. 프로덕션 서비스에는 더 많은 것이 필요합니다:
- SDK 재시도와 요청 타임아웃을 서비스에 설정
- 모든 도구 입력과 출력을 파이썬에서 유효성 검사
- 요청마다 모델, SDK 버전, 중단 사유, 토큰, 지연 시간, 비용 로깅
- 모델·SDK 버전을 고정하고, 숨겨진 테스트를 재실행하며, 업그레이드 전 30일 보존 정책 확인
이 패턴이 맞는 경우
여러 설명이 들어맞고, 파이썬으로 검정 가능하며, 숨겨진 실험으로 선택을 채점할 수 있을 때 이 패턴을 사용하세요. 특히 다음 실험의 비용이 API 호출보다 클 때 적합합니다.
모델 계열을 알고 있다면 순수 파이썬을 쓰세요. Anthropic의 Fable 5.2 모델 가이드는 먼저 Opus를 시도하고, Opus가 요구사항을 놓칠 때 Fable을 시험해보라고 권장합니다.
마무리
우리는 네 가지 냉각 모델을 비교하고, 온도 임계값을 선택하며, 확인 실행을 설계하고, 보지 못한 측정을 예측하는 에이전트를 만들었습니다. 이 합성 장치에서는, 서두의 질문에 대한 답이 “그렇다”입니다.
이를 실제 장비나 개방형 발견으로 확대해 해석하지는 않겠습니다. 한계에서 다뤘듯, 후보에는 시뮬레이터의 식이 포함되어 있었고, 에이전트는 한 번만 실행했습니다.
전이 가능한 것은 방법론입니다. 진실을 숨기고, 첫 요청 전에 채점 규칙을 정하며, 예측을 동결하고, 별도의 평가자를 사용하세요. 다음 유용한 테스트는 점진 전환 모델을 추가하고, 서로 다른 잡음 수준에서 조사를 반복하는 것입니다.
모델 선택에 대해서는 Introduction to Claude Models 강의에서 Claude 제품군과 트레이드오프를 다룹니다.
FAQs
Claude Fable 5.2에서 사고(thinking)를 끄거나 사고 예산을 설정할 수 있나요?
아니요. 적응형 사고는 항상 켜져 있으며, thinking: {type: "disabled"}와 budget_tokens는 400 오류를 반환합니다. 대신 effort 매개변수(기본값은 high)로 사고 분량을 제어하세요. 사고 토큰은 출력으로 과금되며 max_tokens에 포함됩니다.
이전 메시지를 수정한 뒤 Claude Fable 5.2가 400 오류를 반환하는 이유는 무엇인가요?
각 사고 블록은 그 이전의 시스템 프롬프트, 도구, 메시지에만 유효하며, Fable 5.2는 이를 매 호출마다 검사합니다. 대화는 추가만 하고(append-only), 세션 동안 system과 tools는 고정하세요. 임시 방편으로, 베타 헤더에서 prefix_mismatch_behavior를 "drop_block"으로 설정하면 실패 대신 해당 블록을 버립니다.
특정 도구 호출을 Claude Fable 5.2에 강제할 수 있나요?
안 됩니다. tool_choice를 any나 특정 도구 이름으로 설정하면 400 오류가 납니다. auto와 none만 동작합니다. 지시문에 도구 이름을 명시하고 strict: true를 설정해 호출이 스키마와 일치하도록 하세요. 호출이 필수라면 대화 중간의 시스템 메시지를 사용하세요.
Claude Fable 5.2가 요청을 거부하면 어떻게 되나요?
응답은 stop_reason: "refusal"과 함께 오며, stop_details.category에 어떤 세이프가드가 트리거되었는지 표시됩니다. 다른 모델로 직접 재시도할 수 있고, 또는 서버 측 폴백 베타인 fallbacks: "default"에 참여해 Claude Opus 4.8 또는 Claude Opus 5로 재시도할 수 있습니다. 폴백 모델은 Fable 5.2의 사고 블록을 받지 못합니다.
제로 데이터 보존으로 Claude Fable 5.2를 사용할 수 있나요?
기본적으로는 안 됩니다. Fable 5.2는 30일 데이터 보존이 필요하며, 이 설정이 없는 조직/워크스페이스의 API 요청은 400 오류를 반환합니다. ZDR 합의하에서는 워크스페이스에 30일 보존을 활성화하거나 Anthropic 계정 팀에 문의하세요.
배치 API로 이 실험의 도구 루프를 대체할 수 있나요?
아니요. 각 도구 단계는 이전 응답을 필요로 하므로, 배치 API로 이 루프를 그대로 대체할 수 없습니다. 해당 50% 할인은 독립 요청이나 병렬 평가에 적합합니다.
LLM은 마치 추론을 통해 답을 도출한 것처럼 말하는 데 능합니다. 실제로 그렇게 했는지 확인하는 일은 더 어렵습니다. 대부분의 작업에서는 모델이 과거에 유사한 답을 본 적이 있거나, 아니면 아무도 답을 검증할 수 없습니다. 그래서 저는 답이 끝까지 숨겨지는 테스트를 만들었습니다.
Claude Fable 5.2는 전원이 꺼진 뒤 식어가는 장치를 시뮬레이션해 잡음이 있는 측정을 받고, 중간에 냉각이 느려지는 이유에 대한 4가지 가능한 설명을 함께 받습니다. 모델은 이 중 하나를 고르고, 후속 실험을 설계한 다음, 새로운 측정을 단 하나도 보기 전에 예측을 확정해야 합니다. 별도의 파이썬 코드가 그 예측을 채점하며, Claude는 그 코드에 전혀 손댈 수 없습니다.
냉각 장치는 단지 테스트 사례일 뿐입니다. 중요한 것은 설정입니다. 진실을 모델로부터 숨기고, 첫 API 호출 전에 점수 규칙을 고정하고, 예측을 동결한 뒤, 모델이 볼 수 없는 코드로 채점하세요. 이 설정은 원인 분석부터 A/B 테스트 판독까지, “어느 설명이 맞는가?” 유형의 어떤 문제에도 재사용할 수 있습니다.
이 튜토리얼에서는 그 에이전트를 파이썬으로 만듭니다. 수학 계산은 SciPy가 맡고, 어떤 검사를 다음에 실행하고 무엇을 결론낼지는 Claude가 결정합니다. 파이썬 함수와 API 요청에 익숙하시다면 따라오실 수 있고, 냉각 수학은 처음 등장할 때 설명합니다. 다음 내용을 다룹니다:
우리의 Claude Fable 5.2 개요는 출시와 벤치마크를 다룹니다. 여기서는 API와 냉각 테스트에 집중합니다. 저는 출시 다음 날 실험을 실행했습니다.
요약
저는 Fable 5.2에 중간에 냉각이 느려지는 시뮬레이션 장치의 잡음 데이터와 4가지 가능한 설명을 제공했습니다. 모델은 하나를 고르고, 새로운 실험을 설계하고, 보지 못한 결과를 먼저 예측해야 했습니다.