

Experiment und Harness entwerfen
Meine Implementierung koppelt Claude mit vier Python-Funktionen (Tools), die ich nach dem Datensatz zeige. Der vollständige Code und die optionale Streamlit-Oberfläche stehen im GitHub-Repository.
Die vier Kühl-Modelle definieren
Newtons Abkühlungsgesetz sagt: Ein Objekt kühlt schneller, wenn es deutlich heißer ist als der Raum, und langsamer, wenn sich die Temperaturdifferenz verringert. Die Gleichung lautet T(t) = Ta + (T0 - Ta) * exp(-k * t). Dabei ist T0 die Starttemperatur, Ta die Raumtemperatur und k die Abkühlrate pro Minute.
Ich habe vier Modellfamilien zur Auswahl implementiert:
-
Einzelne Rate: Ein
küber die gesamte Zeit, als Baseline -
Zeitwechsel: Zwei Raten, umschaltend zur gleichen Minute in jedem Lauf
-
Temperaturschwelle: Zwei Raten, umschaltend bei einer gemeinsamen Temperatur – also zu unterschiedlichen Minuten je Lauf
-
Sensorversatz: Eine wahre Rate plus ein Messfühlerfehler, der später einsetzt und anwächst
Sichtbare Messungen von verborgener Wahrheit trennen
Claude sieht drei Kühlreihen und alles, was die Tools zurückgeben. Die wahren Raten, die Schwelle, Datensatz-Settings und Bestätigungs-Messungen bleiben außerhalb des Tool-Zugriffs.
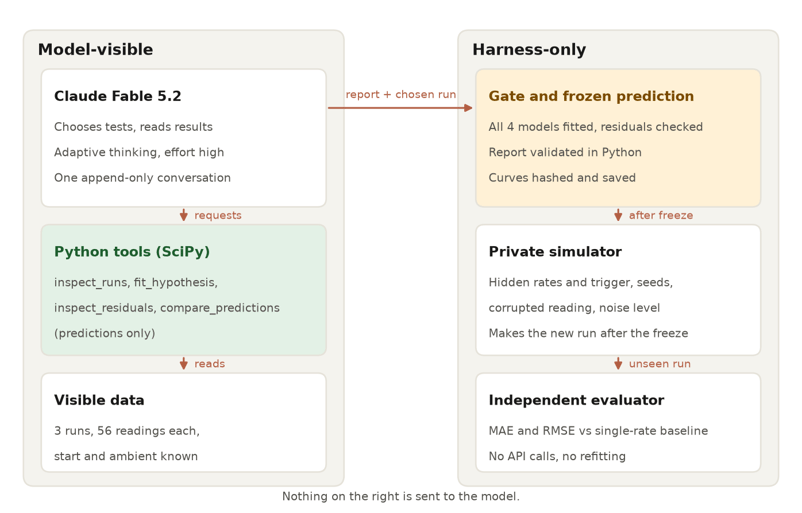
Claude nutzt Tools; die Wahrheit bleibt verborgen. Bild: Autor.
Alles rund um Claude in Python bildet das Agent-Harness. Es führt nicht nur die Tools aus, sondern begrenzt auch Requests, Zeit und Kosten – dazu gleich mehr im Tool-Loop.
Vor dem ersten API-Call habe ich Kandidaten-Modelle, Parametergrenzen, Limits und die Bestehensregel für das neue Experiment fixiert: ein RMSE von höchstens 1,0 °C und nicht mehr als die Hälfte der Baseline mit Einzelrate. Diese Regeln blieben unverändert.
Claude Fable 5.2 in Python einrichten
Für das Setup brauchst du eine virtuelle Umgebung und einen API-Schlüssel. Das claude-fable-5-2-Modell kann bis zu 1 Mio. Token an Prompt und Verlauf lesen und bis zu 128K Ausgabe-Token liefern.
Adaptives Denken, also dass das Modell selbst entscheidet, wie viel es vor der Antwort „überlegt“, ist immer aktiv; die API ist standardmäßig auf hohen Aufwand gestellt. Claude-API-Preise liegen bei $8 pro Million Input-Token und $40 pro Million Output-Token, mit fünfminütigen Prompt-Cache-Writes für $10 und Cache-Reads für $0,20.
Du brauchst:
-
Python 3.12+, da NumPy 2.5.4 und SciPy 1.18.1 es erfordern (das Anthropic-Paket selbst unterstützt 3.10)
-
Einen API-Key mit Zugriff auf
claude-fable-5-2 -
anthropic2.7.0, das Release mit der neuen Model-ID
Klon das Projekt und installiere die gepinnten Abhängigkeiten. Unter macOS oder Linux erstellst du die Umgebung mit python3.12 -m venv .venv, aktivierst sie mit source .venv/bin/activate und ersetzt Copy-Item durch cp.
git clone https://github.com/KhalidAbdelaty/claude-fable-5-2-api.git
cd claude-fable-5-2-api
py -3.12 -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env # then paste your key after ANTHROPIC_API_KEY=Der Code lädt den API-Key aus der Umgebung, ohne ihn zu drucken. Das README im Repo listet die Kommandos für den kompletten Lauf, und nur zwei davon rufen die API. Unser Claude-API-Guide erklärt Keys und Abrechnung allgemein.
Deinen ersten Fable-5.2-API-Request senden
Überspringe diesen Abschnitt, wenn du Claude schon aus Python aufgerufen hast. Dieser Request fokussiert die Evidenz, die die beiden Hypothesen trennt.
import anthropic
from dotenv import load_dotenv
load_dotenv(".env", override=True)
client = anthropic.Anthropic() # reads ANTHROPIC_API_KEY
response = client.messages.create(
model="claude-fable-5-2",
max_tokens=4096,
output_config={"effort": "high"},
messages=[{"role": "user", "content": (
"Three cooling runs start at 80, 95, and 110 C. Each seems to slow down partway through. "
"In three short bullets: what pattern across the runs would point to a change after a fixed "
"time, what pattern would point to a change at a fixed temperature, and what the data alone "
"cannot tell us.")}],
)
print("block types:", [block.type for block in response.content])
print("stop reason:", response.stop_reason)
print("".join(block.text for block in response.content if block.type == "text"))Claude liefert eine Liste typisierter Inhaltsblöcke; lies Text also nach Blocktyp – content[0] kann ein Denkblock sein. Hier ist die erste Antwort:
block types: ['thinking', 'text']
stop reason: end_turn
- **Fixed time:** the slowdown appears at the same elapsed time in all three runs but at different temperatures, with the hotter-start runs still hotter when it happens.
- **Fixed temperature:** the slowdown appears at the same temperature in all three runs but at different elapsed times, with the hotter-start runs reaching it later.
- **What the data cannot tell us:** the cause. A matching pattern shows what the change tracks, not why it happens (for example a phase change, a setup artifact, or a shift in the surroundings). Since cooling naturally slows as it nears room temperature, the data also cannot show on its own that there is a distinct change rather than a smooth curve.Es erschienen sowohl thinking als auch text-Blöcke. Thinking-Token zählen als Output-Token, also berücksichtige sie bei den Kosten. Die Claude Fable 5.2 Migration Guide erwähnt, dass budget_tokens, Thinking disabled, temperature, top_p und top_k einen 400-Fehler liefern.
Einen Kühl-Datensatz ohne Daten-Leakage erstellen
Die Daten müssen so unordentlich sein, dass sich Model-Fits lohnen – und die Lösung muss außerhalb von Claudes Reichweite bleiben.
Drei Kühl-Läufe simulieren
Ich habe drei Läufe nach Newton mit einer verborgenen, kontinuierlichen Änderung in der Abkühlung simuliert. Lauf A startet bei 80 °C in einem 21,0 °C-Raum, B bei 95 °C in 24,0 °C und C bei 110 °C in 22,5 °C. Ein fester NumPy-Zufallsgenerator fügt Gaußsches Rauschen hinzu, und eine Messung bekommt absichtlich einen Extra-Fehler.
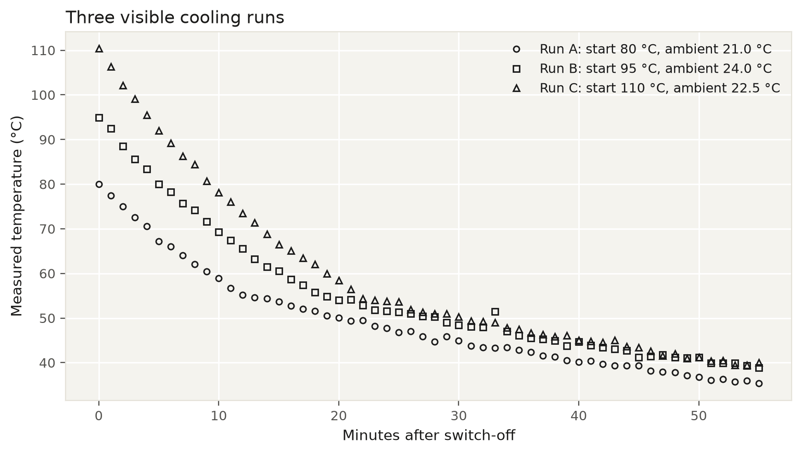
Drei verrauschte Läufe mit einem Ausreißer. Bild: Autor.
Lauf A kühlt anfangs schneller als später. Dieses Muster allein belegt keinen diskreten Wechsel, denn jede Exponentialkurve flacht nahe Raumtemperatur ab.
Lauf B enthält einen isolierten Sprung von etwa 4 °C, während benachbarte Abstände sonst unter 1,2 °C bleiben. Jede Biegung verteilt sich über mehrere verrauschte Minuten – rein visuell lassen sich Zeit- und Schwellenmodell nicht trennen.
Kühl-Hypothesen mit Python-Tools testen
Python fitted jeden Kandidaten unter denselben Regeln und liefert Parameter und Fehler zurück. Claude sieht nie den Fit-Code – nur die Tool-Ausgaben.
Geteilte Parameter fitten, ohne dass ein Ausreißer dominiert
Fitting heißt, Parameter zu wählen, die die Vorhersagekurve nahe an den Messwerten halten. Ich nutze Soft-L1-Loss, weil dadurch große Fehler weniger Gewicht haben, ohne die Messung zu verwerfen.
Alle Läufe teilen sich die gefitteten Parameter, während jeder Lauf seine eigene Start- und Raumtemperatur behält. Beim Schwellenmodell bekommt jeder Lauf so seine eigene Umschaltminute, ln((T0 - Ta) / (threshold - Ta)) / k_above.
SciPys least_squares() sucht die besten Parameter, während Parametergrenzen Raten und Umschaltpunkte in den vorab fixierten Bereichen halten.
Der Auszug unten zeigt den Solver-Call und Konvergenzchecks. Die Residualfunktion und die Grid-Suche drumherum findest du im Repo.
from scipy.optimize import least_squares
def _solve(hypothesis, names, x0, lo, hi, runs):
# soft L1: residuals under f_scale count roughly squared, larger ones roughly linearly
return least_squares(_residuals, x0, bounds=(lo, hi), method="trf",
loss="soft_l1", f_scale=0.5, args=(hypothesis, names, runs))
# scan the change point in 0.5 steps with the rates fitted at each step, then refine all three
res = _solve(hypothesis, names, best_grid_point, lo, hi, runs)
converged = bool(res.success and res.status > 0 and np.all(np.isfinite(res.x)))
at_bound = [n for n, v, a, b in zip(names, res.x, lo, hi) if min(v - a, b - v) < 1e-4 * (b - a)]Ich habe f_scale vorab auf 0,5 °C gesetzt. Residuen darüber verlieren unter Soft L1 an Einfluss. Eine Grid-Suche über den Umschaltpunkt gibt dem Solver einen sinnvollen Startwert.
Modelle mit Leave-One-Run-Out testen
MAE ist der durchschnittliche Fehler in °C. RMSE quadriert Fehler zuerst, große Fehler zählen stärker.
Trainingsfehler bevorteilen Modelle mit mehr Parametern. Cross-Validation schätzt Held-out-Fehler, indem die ausgeschlossenen Daten rotieren. Hier passt Leave-One-Run-Out (LORO): auf zwei Läufen fitten, den dritten vorhersagen.
Claude-Tool-Schemas definieren
Ein Tool-Schema ist eine JSON-Beschreibung einer Python-Funktion und der Argumente, die Claude senden darf. Strict Tool Use lässt die API diese Form prüfen, bevor Python läuft.
Claude kann vier Tools anfordern:
-
inspect_runs: Liefert die sichtbaren Messungen und einfache Steigungs-Zusammenfassungen. -
fit_hypothesis: Fittet ein Kühlmodell und gibt Parameter und Held-out-Fehler zurück. -
inspect_residuals: Zeigt, wo beobachtete Temperaturen von Modellvorhersagen abweichen. -
compare_predictions: Vergleicht gefittete Modelle unter vorgeschlagenen Versuchsbedingungen.
Das compare_predictions-Schema hält die Bestätigungs-Messungen außerhalb des Tools:
{"name": "compare_predictions", "strict": True,
"description": "Predict a new run from existing fits under proposed conditions and report how far the "
"predictions differ. initial_temp_c must be 75 to 115 and ambient_temp_c 20 to 25. "
"Returns predictions only; no new measurements are generated.",
"input_schema": {"type": "object", "additionalProperties": False,
"properties": {"initial_temp_c": {"type": "number"},
"ambient_temp_c": {"type": "number"},
"fit_ids": {"type": "array", "items": {"type": "string"}}},
"required": ["initial_temp_c", "ambient_temp_c", "fit_ids"]}}Die Werte in fit_ids verweisen auf Modelle, die zuvor in derselben Untersuchung gefittet wurden. Strikte Schemata akzeptieren kein minimum oder maximum, daher prüft Python die Temperaturbereiche selbst. Lass tool_choice auf auto, da erzwungene Tools bei Fable 5.2 einen 400-Fehler liefern.
Den Claude-Tool-Loop bauen
Die Anwendung wiederholt einen Zyklus: Konversation an Claude senden, angeforderte Python-Tools ausführen und ihre Ergebnisse zurückgeben. Das läuft, bis die nötigen Vergleiche abgeschlossen sind; dann fordert die App von Claude einen Abschlussbericht in festem Format an.
Einen Prompt für Hypothesentests schreiben
Der System-Prompt beschreibt die Methode, ohne eine Antwort vorzugeben. Der Kern-Prompt ist:
SYSTEM = """You are a scientific investigator working on a controlled cooling experiment. You decide which
checks to run and how to read the results. Python tools do every numerical calculation.
How to work:
- Look at the measurements before you choose a model.
- Fit every candidate model with fit_hypothesis. Compare them on leave-one-run-out error as well as
training error, because a model with more parameters always fits the training runs at least as well.
- Use inspect_residuals to look for systematic patterns and to decide whether any single reading is
an outlier.
- Use only numbers that a tool returned. Do not invent measurements, parameters, or errors.
- Keep observed evidence separate from assumptions. The data can show which mathematical model fits
best; it cannot show the physical cause of a change.
- If the evidence does not separate the candidates, say so and treat the result as inconclusive.
..."""Am wichtigsten ist mir der letzte Punkt. Ohne ihn müsste das Modell immer einen Sieger nennen – selbst wenn die Fehler zu nah beieinander liegen.
Den Tool-Loop append-only halten
Jeder Call sendet dasselbe system und dieselben tools, und jede Antwort geht unverändert zurück. Dieser Auszug zeigt das Message-Handling; der vollständige Loop mit Stop-Handling ist im Repo.
resp = client.messages.create(
model="claude-fable-5-2",
max_tokens=20_000,
system=SYSTEM,
tools=TOOLS, # all four, declared on the first request
thinking={"type": "adaptive", "display": "summarized"},
output_config={"effort": "high"},
cache_control={"type": "ephemeral"}, # automatic prompt caching
messages=messages,
)
messages.append({"role": "assistant", "content": resp.content}) # unchanged, thinking included
if resp.stop_reason == "tool_use":
results = []
for block in resp.content:
if block.type == "tool_use":
out, is_error = box.run(block.name, dict(block.input))
results.append({"type": "tool_result", "tool_use_id": block.id,
"content": out, "is_error": is_error})
messages.append({"role": "user", "content": results})Preserved Thinking erlaubt Claude, frühere Überlegungen über Turns hinweg zu behalten, solange system, tools und die bisherigen Nachrichten unverändert bleiben. Bei Fable 5.2 führt das Editieren eines dieser Teile standardmäßig zu einem 400-Fehler.
Du kannst output_config, tool_choice und max_tokens zwischen Calls ändern, allerdings verpasst ein neues Output-Format den Prompt-Cache. Fasse parallele Tool-Ergebnisse in einer einzelnen User-Nachricht zusammen – wie im Loop oben.
Limits für Requests, Zeit und Kosten setzen
Python zählt Requests, Tool-Calls, verstrichene Zeit und Kosten und startet keine neue Arbeit, sobald ein Limit erreicht ist. Ein bereits laufender Request kann Zeit- oder Kostenlimit noch überschreiten – behandle diese zwei daher als weiche Grenzen.
Bevor eine finale Antwort akzeptiert wird, prüft Python auch, dass Claude alle Kandidaten gefittet, Residuen inspiziert und Bestätigungs-Designs verglichen hat. Wenn Claude aus einem anderen Grund stoppt als Tool-Anfrage oder abgeschlossenem Turn, endet die Untersuchung als nicht schlüssig. Setze max_tokens hoch genug für Denken plus Antwort.
Einen strukturierten Bericht zurückgeben
Sobald die Checks bestanden sind, stellt ein weiterer Request auf Structured Outputs um – bei gleicher History –, sodass der Abschlussbericht als validiertes Python-Objekt ankommt:
messages.append({"role": "user", "content": REPORT_PROMPT})
resp = client.messages.parse(
model="claude-fable-5-2", max_tokens=20_000, system=SYSTEM, tools=TOOLS,
thinking={"type": "adaptive", "display": "summarized"},
output_config={"effort": "high"},
output_format=InvestigationReport, # the SDK sends this as output_config.format
tool_choice={"type": "none"}, # tools stay declared, so the prefix check passes
messages=messages,
)
problems = validate(resp.parsed_output, box.fits) # fit IDs exist, all four covered, ranges holdPydantic prüft die Form des Berichts, und validate() bestätigt, dass jeder zitierte Fit existiert und die Bedingungen im erlaubten Bereich liegen. Danach sind Modellwahl und Bedingungen final.
Fable 5.2 wählt das Temperaturschwellen-Modell
Ich habe eine Untersuchung mit high-Effort gefahren. So kam Claude zur Antwort.
Claudes Testsequenz nachvollziehen
Claude startete mit der Sichtung der Messwerte. Noch vor jedem Fit lautete die Zusammenfassung: „Die Änderung zeigt sich in jedem Lauf um etwa 55 °C: in A bei Minute 12, in B bei Minute 19, in C bei Minute 22. Das spricht für eine Schwelle – ich fitte alle vier.“
Ich nenne das Anchoring: Claude legte sich früh fest, bevor es testete. Der spätere Fit stimmte zu, mit Umschaltpunkten nahe Minute 12, 18 und 22. Der Terminal-Trace zeigt die Reihenfolge der restlichen Checks.
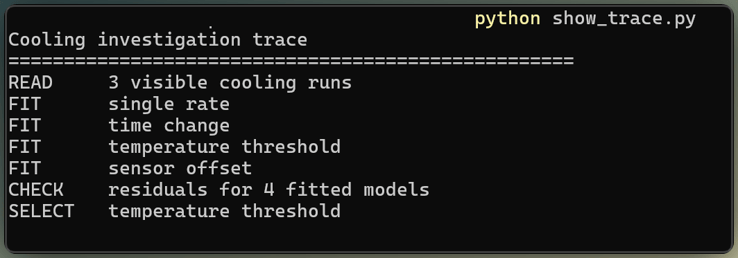
Terminal-Trace mit Claudes Testreihenfolge. Bild: Autor.
Held-out-Fehler über vier Modelle vergleichen
Train-RMSE misst den Fit über alle drei Läufe. Die Held-out-Spalten mitteln die drei LORO-Tests.
|
Kandidat |
Hauptannahme |
Train-RMSE (°C) |
Held-out-MAE (°C) |
Held-out-RMSE (°C) |
|
Einzelne Rate |
Eine Rate über die gesamte Zeit |
4.08 |
3.90 |
4.60 |
|
Zeitwechsel |
Gemeinsamer Wechsel nahe Minute 19 |
1.92 |
2.17 |
2.63 |
|
Temperaturschwelle |
Gemeinsamer Wechsel nahe 55 °C |
0.49 |
0.32 |
0.48 |
|
Sensorversatz |
Wachsender Messdrift |
1.49 |
1.45 |
1.87 |
Beim Schwellenmodell liegen Trainings- und Held-out-Fehler nah beieinander – der Fit überträgt sich also zwischen Läufen, auch wenn drei Läufe Overfitting nicht grundsätzlich ausschließen. Das Residuen-Plot unten zeigt gemessene Temperatur minus Modellvorhersage.
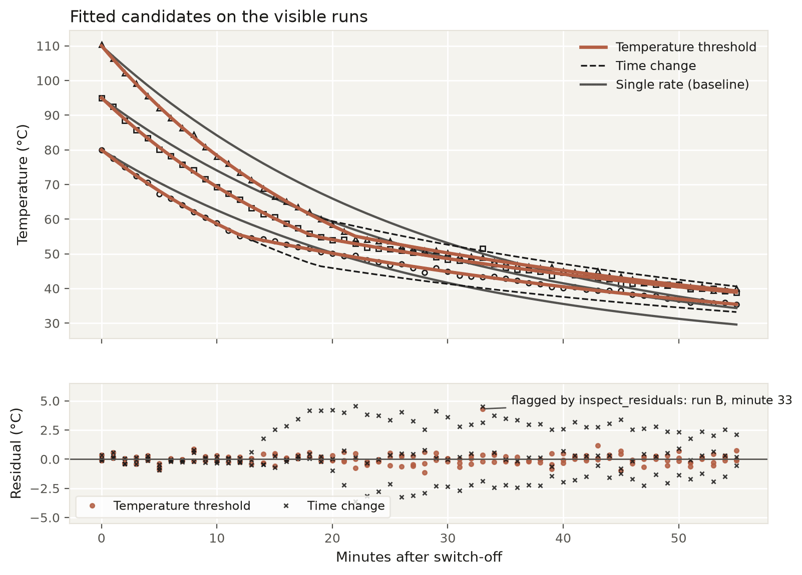
Schwellen-Residuen zeigen kein systematisches Muster. Bild: Autor.
Der Zeitwechsel-Fit passt zu Lauf B. Nach dem Wechsel verfehlt er Lauf A um ca. +2,5 bis +3,5 °C und Lauf C um -1,5 bis -2,8 °C.
Nützlicher als die Rangliste finde ich das Vorzeichen: Es zeigt, dass der Wechsel in A früher und in C später kommt – wie es ein Temperatur-Trigger vorhersagt. Das Sensorversatzmodell reduziert einige Fehler per Drift, bleibt Held-out aber größer.
Die korrumpierte Messung prüfen
Der Agent wusste nicht, welche Messung ich verfälscht hatte. Er fand Lauf B, Minute 33, mit einem Residuum von etwa +4,3 °C. Sein robuster Z-Score – die Distanz zur typischen Residuenstreuung – lag über 12.
Claude ließ die Messung drin, da Soft L1 ihren Einfluss ohnehin begrenzt. Zur Kontrolle habe ich alle vier Modelle ohne sie neu gefittet. Das Schwellenmodell blieb klar auf Platz eins, und die Schwellen-Schätzung änderte sich kaum.
Ein Bestätigungsexperiment entwerfen
Der Agent verglich Kandidatenvorhersagen über mehrere Start- und Raumtemperaturen und wählte dann Bedingungen – ohne neue Messungen zu sehen.
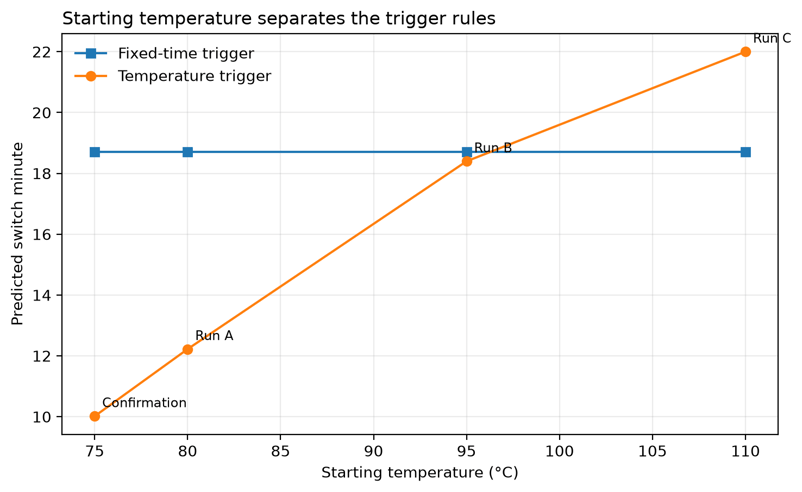
Starttemperaturen legen die Trigger-Regeln offen. Bild: Autor.
Bedingungen wählen, die Modelle trennen
Wie im TL;DR erwähnt, wählte der Agent 75 °C Start und 20 °C Raum. Das Schwellenmodell schaltet nahe Minute 10, das Zeitmodell nahe Minute 19. Auch die Sensorversatz-Kurve bleibt klar getrennt von der Schwellenvorhersage.
Ein Setup im Mittelfeld nahe Lauf B würde Schwellen- und Zeitmodell nur um etwa 0,6 °C trennen. Die gewählten Bedingungen liegen leicht außerhalb des getesteten Bereichs – Claude hat das im Bericht markiert.
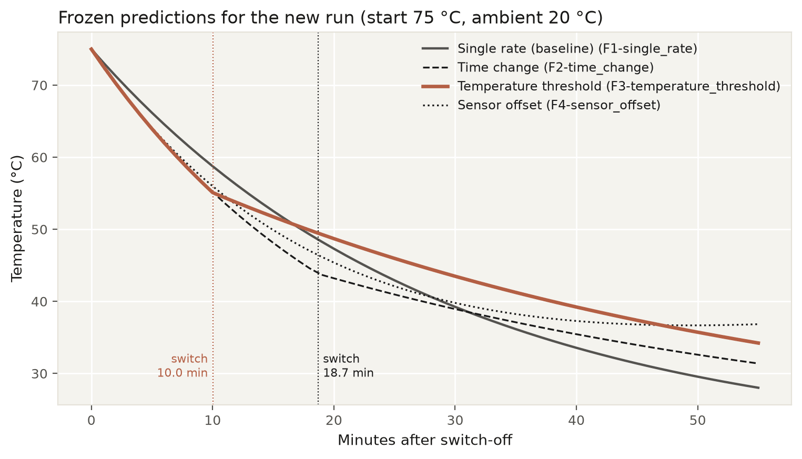
Eingefrorene Kandidatenvorhersagen für den gewählten Lauf. Bild: Autor.
Vorhersagen vor der Datengenerierung einfrieren
Ich habe Bedingungen, gefittete Parameter und die Vorhersagen aller Kandidaten eingefroren, bevor neue Messungen erzeugt wurden. Der Agent erhielt die Bestätigungsdaten nicht und konnte seine Antwort nach dem Ergebnis nicht anpassen.
Die Bestätigungs-Messungen nutzen dasselbe Gauß-Rauschmodell, einen separaten festen Seed und keinen zusätzlichen Ausreißer.
Den unsichtbaren Lauf bewerten
Separater Python-Code bewertete die eingefrorenen Vorhersagen. Er ruft die API nicht auf – Claude bewertet seine Antwort nicht selbst.
Vorhersagen mit unabhängigem Python scoren
Die Schwellenvorhersage bestand beide vorab gesetzten Tests. Auf dem unsichtbaren Lauf erreichte sie 0,27 °C MAE und 0,32 °C RMSE. Fixed-Time lag bei 3,67 °C RMSE, Sensorversatz bei 2,35 °C, Einzelrate bei 4,28 °C.
Der Bestätigungslauf enthält keinen gesetzten Ausreißer – das erklärt die niedrigeren Fehler gegenüber den Leave-One-Run-Out-Ergebnissen teilweise. Auch ein anderes Rausch-Sample kann beitragen.
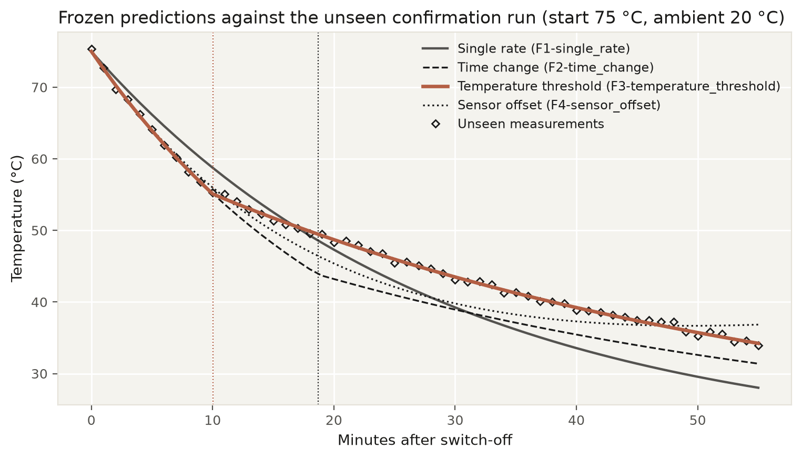
Eingefrorene Vorhersagen treffen die unsichtbaren Messungen. Bild: Autor.
Gefittete Parameter mit der verborgenen Wahrheit vergleichen
Nach dem Scoring werden die gefitteten Parameter mit den verborgenen Generierungswerten verglichen:
import numpy as np
def true_curve(t0, ta, minutes, truth):
"""Newton cooling whose rate drops when the temperature crosses a threshold. Continuous at the switch."""
t = np.asarray(minutes, dtype=float)
k1, k2, th = truth["k_above"], truth["k_below"], truth["threshold_c"]
if t0 <= th:
return ta + (t0 - ta) * np.exp(-k2 * t)
t_cross = np.log((t0 - ta) / (th - ta)) / k1
fast = ta + (t0 - ta) * np.exp(-k1 * t)
slow = ta + (th - ta) * np.exp(-k2 * (t - t_cross)) # restarts from the threshold
return np.where(t <= t_cross, fast, slow)Der Simulator addiert dazu gesaatetes Gauß-Rauschen um diese Kurve.
Die verborgene Regel war eine Temperaturschwelle bei 55 °C mit Raten 0,045 und 0,020 pro Minute und einer Rausch-Standardabweichung von 0,35 °C.
Die gefitteten Raten stimmen auf drei Dezimalstellen, die Schwelle liegt innerhalb von 0,1 °C, der vorhergesagte Umschaltzeitpunkt innerhalb von 0,1 Minute.
Die Daten identifizieren die mathematische Regel des Simulators. Sie zeigen nicht, ob ein reales Gerät nahe 55 °C wegen Phasenwechsel, Lüfterzyklus oder anderer physischer Ursachen langsamer wird.
Nachvollziehen, wie der Agent zur Antwort kam
Der Bericht nannte Fit-IDs und Tool-Nummern als Evidenz und benannte, was drei Läufe nicht belegen können. Schwachpunkt ist die frühe Vermutung – wie oft die schiefgeht, zeigt eine einzelne Untersuchung nicht.
Die Untersuchung in Streamlit ansehen
Im Video starte ich einen Live-Lauf, folge dem Tool-Log und öffne nach dem Scoring die Tabs Report, Curves, Confirmation und Cost.
Die Streamlit-Oberfläche zeigt eine Untersuchung. Video: Autor.
Claude Fable 5.2 API-Kosten messen
Die Untersuchung inklusive Abschlussbericht kostete etwa $0,49 und dauerte etwas über eine Minute. SciPy läuft lokal und schlägt nicht auf die API-Rechnung.
Allein die Berichtsanfrage verursachte fast die Hälfte von Kosten und Zeit. Wie im Tool-Loop-Abschnitt erwähnt, verpasst ein neues Ausgabeformat den Prompt-Cache, sodass der letzte Request die gesamte Konversation erneut verarbeiten musste, bevor er einen langen Bericht schrieb. Tracke un-gecachten Input, Cache-Writes, Cache-Reads und Output getrennt – jede Komponente hat ihren eigenen Preis.
Grenzen und Praxis
Zwei Arten Grenzen sind hier wichtig: was das Experiment zeigen kann – und was der Code braucht, bevor er als Service läuft.
Wissenschaftliche Grenzen
Simulator und Schwellenkandidat nutzen dieselbe Gleichung. Ein gradueller Wechsel in einem realen Gerät könnte weiterhin in dieses Modell passen, aber einer anderen Kurve folgen.
Wäre die wahre Regel nicht dabei, könnte der Agent dennoch das nächstpassende angebotene Modell wählen statt inconclusive zu antworten. Mehr Rauschen oder eine kaum erreichte Schwelle könnten die Fehler zu ähnlich machen. Ein anderer Lauf kann eine andere Toolreihenfolge nehmen.
Vor dem Einsatz in Produktion
Die Limits im Tool-Loop decken eine Untersuchung auf deiner Maschine ab. Ein Produktionsservice braucht mehr:
- Setze SDK-Retries und Request-Timeouts für den Service.
- Validiere jeden Tool-Input und -Output in Python.
- Logge Modell, SDK-Version, Stop-Reason, Token, Latenz und Kosten je Request.
- Pinne Modell- und SDK-Versionen, führe den verborgenen Test erneut aus und bestätige die 30-Tage-Retention-Policy vor einem Upgrade.
Wann dieses Muster passt
Nutze dieses Muster, wenn mehrere Erklärungen passen, Python sie testen kann und ein verborgenes Experiment die Wahl bewerten kann – besonders, wenn das nächste Experiment teurer ist als der API-Call.
Nutze pures Python, wenn du die Modellfamilie kennst. Anthropics Fable-5.2-Modellempfehlungen raten, zuerst Opus zu testen und Fable zu prüfen, wenn Opus die Anforderung verfehlt.
Abschließende Gedanken
Wir haben einen Agenten gebaut, der vier Kühlmodelle verglich, eine Temperaturschwelle wählte, einen Bestätigungslauf entwarf und Messungen vorhersagte, die er nie gesehen hatte. Für dieses synthetische Gerät lautet die Antwort auf meine Eingangsfrage: ja.
Ich würde das nicht auf reale Geräte oder offene Exploration strecken. Wie in den Grenzen beschrieben, enthielten die Kandidaten die Gleichung des Simulators, und ich habe den Agenten einmal laufen lassen.
Übertragbar ist die Methode: Verberge die Wahrheit, setze die Bewertungsregeln vor dem ersten Request, friere Vorhersagen ein und nutze einen separaten Evaluator. Ein sinnvoller nächster Test würde ein Modell mit graduellem Übergang ergänzen und die Untersuchung bei verschiedenen Rauschpegeln wiederholen.
Für Modellauswahl deckt unser Introduction to Claude Models-Kurs das Claude-Lineup und seine Trade-offs ab.
FAQs
Kann ich Thinking ausschalten oder ein Thinking-Budget für Claude Fable 5.2 setzen?
Nein. Adaptives Denken ist immer aktiv, und sowohl thinking: {type: "disabled"} als auch budget_tokens liefern einen 400-Fehler. Steuere den Denkaufwand stattdessen über den Effort-Parameter, der standardmäßig auf high steht. Thinking-Token werden als Output berechnet und zählen zu max_tokens.
Warum gibt Claude Fable 5.2 nach dem Editieren früherer Nachrichten einen 400-Fehler zurück?
Jeder Denkblock ist nur gültig für den System-Prompt, die Tools und Nachrichten davor – und Fable 5.2 prüft das pro Account. Halte die Konversation append-only und friere system und tools für die Session ein. Übergangsweise kann prefix_mismatch_behavior mit "drop_block" im Beta-Header betroffene Blöcke verwerfen statt fehlschlagen.
Kann ich Claude Fable 5.2 zwingen, ein bestimmtes Tool aufzurufen?
Nein. tool_choice auf any oder auf einen Tool-Namen zu setzen, liefert einen 400-Fehler; nur auto und none funktionieren. Nenne das Tool in deiner Instruktion und setze strict: true, damit der Call zu deinem Schema passt. Wenn der Call zwingend ist, nutze eine System-Nachricht mitten im Verlauf.
Was passiert, wenn Claude Fable 5.2 eine Anfrage ablehnt?
Die Antwort kommt mit stop_reason: "refusal", und stop_details.category zeigt, welche Schutzmaßnahme griff. Du kannst selbst auf ein anderes Modell retryn oder serverseitiges Fallback mit fallbacks: "default" (Beta) aktivieren – dann wird auf Claude Opus 4.8 oder Claude Opus 5 gewechselt. Das Fallback-Modell erhält keine Thinking-Blöcke von Fable 5.2.
Kann ich Claude Fable 5.2 mit Zero Data Retention nutzen?
Nicht standardmäßig. Fable 5.2 verlangt 30 Tage Datenaufbewahrung; API-Requests aus einer Organisation oder einem Workspace ohne diese Einstellung liefern einen 400-Fehler. Unter einer ZDR-Vereinbarung aktiviere 30 Tage Aufbewahrung für einen Workspace oder kontaktiere dein Anthropic-Account-Team.
Kann die Batch API den Tool-Loop aus diesem Experiment ersetzen?
Nein. Jeder Tool-Schritt baut auf der vorherigen Antwort auf, daher kann die Batch API diese Schleife nicht direkt ersetzen. Ihr 50%-Rabatt passt zu unabhängigen Requests oder parallelen Auswertungen.

Ich bin Dateningenieur und Community-Builder und arbeite mit Datenpipelines, Cloud- und KI-Tools. Außerdem schreibe ich praktische, super nützliche Tutorials für DataCamp und angehende Entwickler.




LLMs klingen oft so, als hätten sie sich logisch bis zur Antwort vorgearbeitet. Ob sie das wirklich tun, ist schwerer zu prüfen. Meist hat das Modell entweder schon etwas Ähnliches gesehen – oder niemand kann die Antwort verifizieren. Also habe ich einen Test gebaut, bei dem die Lösung verborgen bleibt.
Claude Fable 5.2 erhält verrauschte Messwerte von einem simulierten Gerät, das nach dem Ausschalten abkühlt, sowie vier mögliche Erklärungen dafür, warum die Abkühlung zwischendurch langsamer wird. Es muss eine Hypothese wählen, ein Folgeexperiment entwerfen und sich auf eine Vorhersage festlegen, bevor auch nur eine neue Messung sichtbar wird. Separater Python-Code bewertet die Vorhersage – Claude hat keinen Zugriff darauf.
Das Kühlgerät ist nur der Testfall. Entscheidend ist das Setup: Verberge die Wahrheit vor dem Modell, lege die Bewertungsregeln vor dem ersten API-Call fest, friere die Vorhersagen ein und bewerte sie mit Code, den das Modell nicht sieht. Dieses Muster passt auf jedes „Welche Erklärung trifft zu?“-Problem – von Root-Cause-Analysen bis zur Auswertung eines A/B-Tests.
In diesem Tutorial baust du den Agenten in Python. SciPy übernimmt die Mathematik; Claude entscheidet, welche Prüfung als Nächstes kommt und was sie bedeutet. Wenn du dich mit Python-Funktionen und API-Requests wohlfühlst, kannst du mitgehen; die Kühl-Gleichungen erkläre ich beim ersten Auftauchen. Wir behandeln:
Unsere Übersicht zu Claude Fable 5.2 deckt den Launch und Benchmarks ab, daher konzentriere ich mich hier auf die API und den Kühltest. Ich habe das Experiment am Tag nach dem Launch durchgeführt.
TL;DR
Ich gab Fable 5.2 verrauschte Daten eines simulierten Geräts, dessen Abkühlung unterwegs langsamer wird, plus vier Erklärungen. Es musste eine wählen, ein neues Experiment entwerfen und das Ergebnis vorhersagen, bevor es die Daten sah.