

Ontwerp het experiment en de harness
Mijn implementatie koppelt Claude aan vier Python-functies, tools genoemd, die ik na de dataset laat zien. De compleete code en optionele Streamlit-interface staan in de GitHub-repository.
Definieer de vier koelmodellen
De wet van Newton over afkoeling zegt dat een object sneller afkoelt wanneer het veel heter is dan de kamer, en daarna vertraagt naarmate het temperatuurverschil kleiner wordt. De vergelijking is T(t) = Ta + (T0 - Ta) * exp(-k * t). Hierbij is T0 de begintemperatuur, Ta de kamertemperatuur, en k de afkoelsnelheid per minuut.
Ik heb vier modelfamilies geschreven waaruit de agent kan kiezen:
-
Enkele snelheid: één
kgedurende de hele run, gebruikt als baseline -
Tijdsverandering: twee snelheden, omschakeling op hetzelfde verstreken minuutpunt in elke run
-
Temperatuurdrempel: twee snelheden, omschakeling bij een gedeelde temperatuur, dus op een ander minuutpunt per run
-
Sensorkalibratie: één werkelijke snelheid, plus een probesfout die halverwege start en toeneemt
Scheid zichtbare metingen van verborgen waarheid
Claude ziet drie afkoelreeksen en alles wat de tools teruggeven. De werkelijke snelheden, drempel, data-instellingen en bevestigingsmetingen blijven buiten zijn tooltoegang.
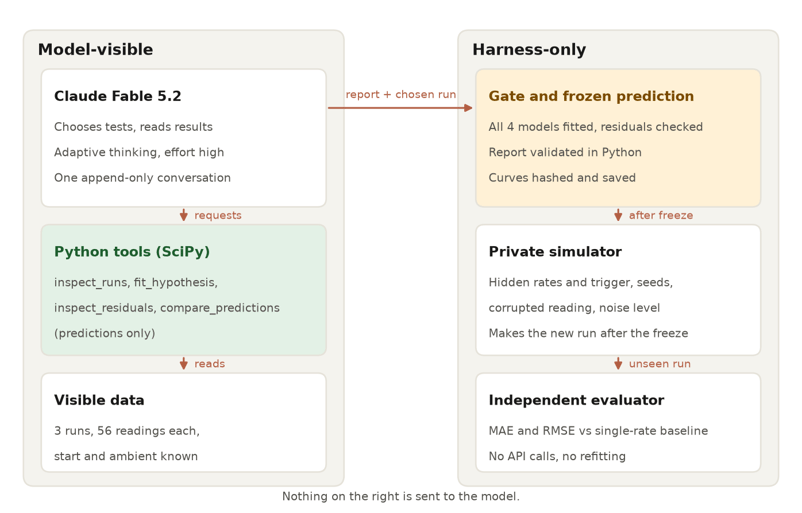
Claude heeft toegang tot tools; de waarheid blijft verborgen. Afbeelding door de auteur.
Alles in Python rond Claude maakt de agent harness uit. Naast het draaien van de tools, begrenst het aanvragen, tijd en kosten, zoals ik bij de toollus behandel.
Voor de eerste API-call heb ik de kandidatenmodellen, parametergrenzen, limieten en de slaagregel voor het nieuwe experiment vastgezet: een RMSE van maximaal 1,0 °C en niet meer dan de helft van de baseline met enkele snelheid. Die regels bleven vaststaan.
Claude Fable 5.2 instellen in Python
Voor de setup heb je een virtuele omgeving en een API-sleutel nodig. Het claude-fable-5-2-model kan tot 1M tokens aan prompt en gespreksgeschiedenis lezen en vervolgens tot 128K outputtokens teruggeven.
Adaptief redeneren, waarbij het model beslist hoeveel het redeneert voordat het antwoordt, staat altijd aan, en de API staat standaard op hoge inspanning. Claude API-prijzen zijn $8 per miljoen inputtokens en $40 per miljoen outputtokens, met vijf minuten prompt-cachewrites voor $10 en cachereads voor $0,20.
Je hebt nodig:
-
Python 3.12+, omdat NumPy 2.5.4 en SciPy 1.18.1 dat vereisen (het Anthropic-pakket zelf ondersteunt 3.10)
-
Een API-sleutel met toegang tot
claude-fable-5-2 -
anthropic2.7.0, de release die de model-ID toevoegde
Clone het project en installeer de gepinde dependencies. Op macOS of Linux maak je de omgeving met python3.12 -m venv .venv, activeer je deze met source .venv/bin/activate, en vervang je Copy-Item door cp.
git clone https://github.com/KhalidAbdelaty/claude-fable-5-2-api.git
cd claude-fable-5-2-api
py -3.12 -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env # then paste your key after ANTHROPIC_API_KEY=De code laadt de API-sleutel uit de omgeving zonder deze te printen. De README van de repository somt de commando's op voor het volledige experiment, en slechts twee daarvan roepen de API aan. Onze Claude API-gids behandelt sleutels en facturatie in het algemeen.
Doe je eerste Fable 5.2 API-verzoek
Sla deze sectie over als je Claude al eerder vanuit Python hebt aangeroepen. Dit verzoek focust op het bewijs dat de twee hypothesen uit elkaar houdt.
import anthropic
from dotenv import load_dotenv
load_dotenv(".env", override=True)
client = anthropic.Anthropic() # reads ANTHROPIC_API_KEY
response = client.messages.create(
model="claude-fable-5-2",
max_tokens=4096,
output_config={"effort": "high"},
messages=[{"role": "user", "content": (
"Three cooling runs start at 80, 95, and 110 C. Each seems to slow down partway through. "
"In three short bullets: what pattern across the runs would point to a change after a fixed "
"time, what pattern would point to a change at a fixed temperature, and what the data alone "
"cannot tell us.")}],
)
print("block types:", [block.type for block in response.content])
print("stop reason:", response.stop_reason)
print("".join(block.text for block in response.content if block.type == "text"))Claude retourneert een lijst met getypte contentblokken, dus lees tekst per bloktype; content[0] kan een thinking-blok zijn. Hier is de eerste reactie:
block types: ['thinking', 'text']
stop reason: end_turn
- **Fixed time:** the slowdown appears at the same elapsed time in all three runs but at different temperatures, with the hotter-start runs still hotter when it happens.
- **Fixed temperature:** the slowdown appears at the same temperature in all three runs but at different elapsed times, with the hotter-start runs reaching it later.
- **What the data cannot tell us:** the cause. A matching pattern shows what the change tracks, not why it happens (for example a phase change, a setup artifact, or a shift in the surroundings). Since cooling naturally slows as it nears room temperature, the data also cannot show on its own that there is a distinct change rather than a smooth curve.Zowel thinking als text-blokken verschenen. Thinking-tokens tellen mee als outputtokens, dus neem ze mee in de kosteninschatting. De Claude Fable 5.2 migratiegids vermeldt dat budget_tokens, thinking disabled, temperature, top_p en top_k een 400-fout geven.
Maak een afkoeldataset zonder datalekken
De data moet rommelig genoeg zijn om modelpassing nodig te hebben, en het antwoord moet buiten het bereik van Claude blijven.
Simuleer drie afkoelruns
Ik heb drie runs gesimuleerd op basis van Newtons wet met een verborgen, continue verandering in de afkoeling. Run A start op 80 °C in een kamer van 21,0 °C, B op 95 °C in 24,0 °C en C op 110 °C in 22,5 °C. Een vaste NumPy random number generator voegt Gaussische ruis toe, en één meting krijgt expres extra fout.
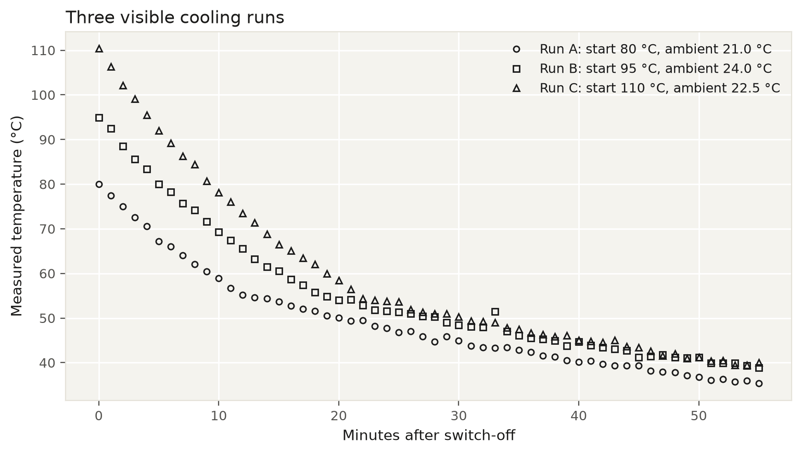
Drie rumoerige runs bevatten één uitschieter. Afbeelding door de auteur.
Run A koelt vroeg sneller af dan laat. Dat patroon op zich toont geen discrete verandering, want elke exponentiële curve vertraagt nabij kamertemperatuur.
Run B bevat een geïsoleerde sprong van ongeveer 4 °C, terwijl naburige verschillen elders onder 1,2 °C blijven. Elke knik spreidt zich uit over meerdere rumoerige minuten, dus visuele inspectie kan de tijds- en drempelmodellen niet scheiden.
Toets afkoelhypothesen met Python-tools
Python past elke afkoelkandidaat onder dezelfde regels en geeft de parameters en fouten terug. Claude ziet de pascode nooit, alleen wat elke tool teruggeeft.
Pas gedeelde parameters zonder dat één uitschieter domineert
Passen betekent parameterwaarden kiezen die elke voorspelde curve dicht bij de metingen houden. Ik gebruik soft L1-loss omdat die de invloed van een grote fout vermindert zonder die meting te verwijderen.
Alle runs delen de gepaste parameters, terwijl elke run zijn eigen begin- en kamertemperatuur behoudt. Voor het drempelmodel geeft dat elke run zijn eigen schakeltijd, ln((T0 - Ta) / (threshold - Ta)) / k_above.
SciPy's least_squares() zoekt naar de best passende parameters, terwijl parametergrenzen de snelheden en schakelmomenten binnen de vooraf vastgestelde bereiken houden.
Het fragment hieronder toont de solveraanroep en convergentiecontroles. De residufunctie en de rasterscan eromheen staan in de repository.
from scipy.optimize import least_squares
def _solve(hypothesis, names, x0, lo, hi, runs):
# soft L1: residuals under f_scale count roughly squared, larger ones roughly linearly
return least_squares(_residuals, x0, bounds=(lo, hi), method="trf",
loss="soft_l1", f_scale=0.5, args=(hypothesis, names, runs))
# scan the change point in 0.5 steps with the rates fitted at each step, then refine all three
res = _solve(hypothesis, names, best_grid_point, lo, hi, runs)
converged = bool(res.success and res.status > 0 and np.all(np.isfinite(res.x)))
at_bound = [n for n, v, a, b in zip(names, res.x, lo, hi) if min(v - a, b - v) < 1e-4 * (b - a)]Ik heb f_scale voor de run op 0,5 °C gezet. Residuen groter dan dat verliezen invloed onder soft L1. Een rasterscan over het schakelpunt geeft de solver een zinnige startwaarde.
Valideer modellen met leave-one-run-out-tests
MAE is de gemiddelde misser in °C. RMSE kwadrateert fouten eerst, dus grotere fouten tellen zwaarder mee.
Trainingsfout bevoordeelt modellen met meer parameters. Crossvalidatie schat de fout op achtergehouden data door de uitgesloten data te rouleren. Hier past leave-one-run-out (LORO) op twee runs en voorspelt de derde.
Definieer schemas voor Claude-tool-calls
Een toolschema is een JSON-beschrijving van een Python-functie en de argumenten die Claude mag sturen. Strikt gebruik van tools zorgt dat de API die vorm controleert voordat Python de functie draait.
Claude kan vier tools opvragen:
-
inspect_runs: geeft de zichtbare metingen en eenvoudige hellingssamenvattingen terug. -
fit_hypothesis: past één afkoelmodel en geeft de parameters en achtergehouden fouten terug. -
inspect_residuals: laat zien waar gemeten temperaturen afwijken van modelvoorspellingen. -
compare_predictions: vergelijkt gepaste modellen onder voorgestelde experimenteercondities.
Het compare_predictions-schema houdt bevestigingsmetingen buiten de tool:
{"name": "compare_predictions", "strict": True,
"description": "Predict a new run from existing fits under proposed conditions and report how far the "
"predictions differ. initial_temp_c must be 75 to 115 and ambient_temp_c 20 to 25. "
"Returns predictions only; no new measurements are generated.",
"input_schema": {"type": "object", "additionalProperties": False,
"properties": {"initial_temp_c": {"type": "number"},
"ambient_temp_c": {"type": "number"},
"fit_ids": {"type": "array", "items": {"type": "string"}}},
"required": ["initial_temp_c", "ambient_temp_c", "fit_ids"]}}De waarden van fit_ids verwijzen naar modellen die eerder in hetzelfde onderzoek zijn gepast. Strikte schema's accepteren geen minimum of maximum, dus Python controleert de temperatuurbereiken zelf. Laat tool_choice op auto staan, want forceren van een tool geeft een 400-fout op Fable 5.2.
Bouw de Claude-toollus
De applicatie herhaalt één cyclus: stuur het gesprek naar Claude, voer eventueel gevraagde Python-tools uit en geef de resultaten terug. Dit gaat door tot de vereiste vergelijkingen klaar zijn en vraagt dan Claude om een eindrapport in een vast formaat.
Schrijf een prompt voor hypothesetoetsing
De systeem-prompt beschrijft de methode zonder een antwoord te suggereren. De kernprompt is:
SYSTEM = """You are a scientific investigator working on a controlled cooling experiment. You decide which
checks to run and how to read the results. Python tools do every numerical calculation.
How to work:
- Look at the measurements before you choose a model.
- Fit every candidate model with fit_hypothesis. Compare them on leave-one-run-out error as well as
training error, because a model with more parameters always fits the training runs at least as well.
- Use inspect_residuals to look for systematic patterns and to decide whether any single reading is
an outlier.
- Use only numbers that a tool returned. Do not invent measurements, parameters, or errors.
- Keep observed evidence separate from assumptions. The data can show which mathematical model fits
best; it cannot show the physical cause of a change.
- If the evidence does not separate the candidates, say so and treat the result as inconclusive.
..."""Het laatste punt vind ik het belangrijkst. Zonder dat moet het model een winnaar aanwijzen, zelfs wanneer de fouten te dicht bij elkaar liggen om te kunnen beslissen.
Houd de toollus append-only
Elke call stuurt dezelfde system en tools mee, en elke response gaat ongewijzigd terug. Dit fragment laat de messageafhandeling zien; de volledige lus met stopafhandeling staat in de repository.
resp = client.messages.create(
model="claude-fable-5-2",
max_tokens=20_000,
system=SYSTEM,
tools=TOOLS, # all four, declared on the first request
thinking={"type": "adaptive", "display": "summarized"},
output_config={"effort": "high"},
cache_control={"type": "ephemeral"}, # automatic prompt caching
messages=messages,
)
messages.append({"role": "assistant", "content": resp.content}) # unchanged, thinking included
if resp.stop_reason == "tool_use":
results = []
for block in resp.content:
if block.type == "tool_use":
out, is_error = box.run(block.name, dict(block.input))
results.append({"type": "tool_result", "tool_use_id": block.id,
"content": out, "is_error": is_error})
messages.append({"role": "user", "content": results})Preserved thinking laat Claude zijn eerdere redenering over beurten heen behouden, zolang system, tools en eerdere berichten ongewijzigd blijven. Op Fable 5.2 geeft het bewerken van een van die onderdelen standaard een 400-fout.
Je kunt output_config, tool_choice en max_tokens tussen calls wijzigen, al mist een nieuw outputformaat nog steeds de promptcache. Groepeer parallelle toolresultaten in één userbericht, zoals de lus hierboven doet.
Stel limieten in voor requests, tijd en kosten
Python telt requests, tool-calls, verstreken tijd en kosten, en start geen nieuw werk zodra een limiet is bereikt. Een request dat al draait, kan nog steeds over de tijd- of kostenlimiet heen gaan, dus behandel die twee als zachte limieten.
Voordat een eindantwoord wordt geaccepteerd, controleert Python ook dat Claude elke kandidaat heeft gepast, residuen heeft geïnspecteerd en bevestigingsontwerpen heeft vergeleken. Als Claude om een andere reden stopt dan een toolverzoek of een afgeronde beurt, eindigt het onderzoek als niet-concludent. Zet max_tokens hoog genoeg voor redeneren plus het antwoord.
Geef een gestructureerd rapport terug
Zodra de controles slagen, vraagt één extra verzoek om gestructureerde outputs op dezelfde geschiedenis, zodat het eindrapport als een gevalideerd Python-object binnenkomt:
messages.append({"role": "user", "content": REPORT_PROMPT})
resp = client.messages.parse(
model="claude-fable-5-2", max_tokens=20_000, system=SYSTEM, tools=TOOLS,
thinking={"type": "adaptive", "display": "summarized"},
output_config={"effort": "high"},
output_format=InvestigationReport, # the SDK sends this as output_config.format
tool_choice={"type": "none"}, # tools stay declared, so the prefix check passes
messages=messages,
)
problems = validate(resp.parsed_output, box.fits) # fit IDs exist, all four covered, ranges holdPydantic controleert de vorm van het rapport, en validate() bevestigt dat elke genoemde fit bestaat en de condities binnen het toegestane bereik vallen. Daarna zijn de modelkeuze en condities definitief.
Fable 5.2 kiest het temperatuurdrempelmodel
Ik draaide één onderzoek op high-inspanning. Zo kwam Claude tot zijn antwoord.
Traceer Claudes testvolgorde
Claude begon met het inspecteren van de metingen. Nog voor het passen luidde de samenvatting: "De verandering verschijnt rond 55 °C in elke run: op minuut 12 in A, minuut 19 in B en minuut 22 in C. Dat wijst op een drempel, dus ik pas alle vier."
Ik zou dat anchoring noemen: Claude legde zich vast op een antwoord voordat het getest was. De latere pas kwam overeen, met schakels rond minuut 12, 18 en 22. De terminaltrace toont de volgorde van de resterende checks.
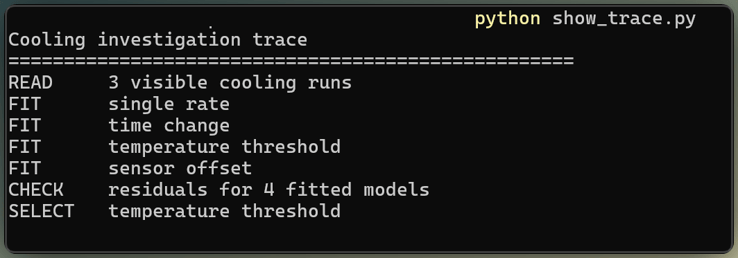
Terminaltrace toont Claudes testvolgorde. Afbeelding door de auteur.
Vergelijk achtergehouden fouten over vier modellen
TrainRMSE meet elke pas op alle drie de runs. De kolommen met achtergehouden data middelen de drie LORO-tests.
|
Kandidaat |
Hoofdaannames |
Train RMSE (°C) |
Achtergehouden MAE (°C) |
Achtergehouden RMSE (°C) |
|
Enkele snelheid |
Één snelheid gedurende de hele run |
4.08 |
3.90 |
4.60 |
|
Tijdsverandering |
Gedeelde schakel rond minuut 19 |
1.92 |
2.17 |
2.63 |
|
Temperatuurdrempel |
Gedeelde schakel rond 55 °C |
0.49 |
0.32 |
0.48 |
|
Sensorkalibratie |
Een toenemende meetdrift |
1.49 |
1.45 |
1.87 |
Voor het drempelmodel liggen training en achtergehouden fouten dicht bij elkaar, dus de pas draagt over van run naar run, al kunnen drie runs overfitting in het algemeen niet uitsluiten. De residugrafiek hieronder toont de gemeten temperatuur min de voorspelling van elk model.
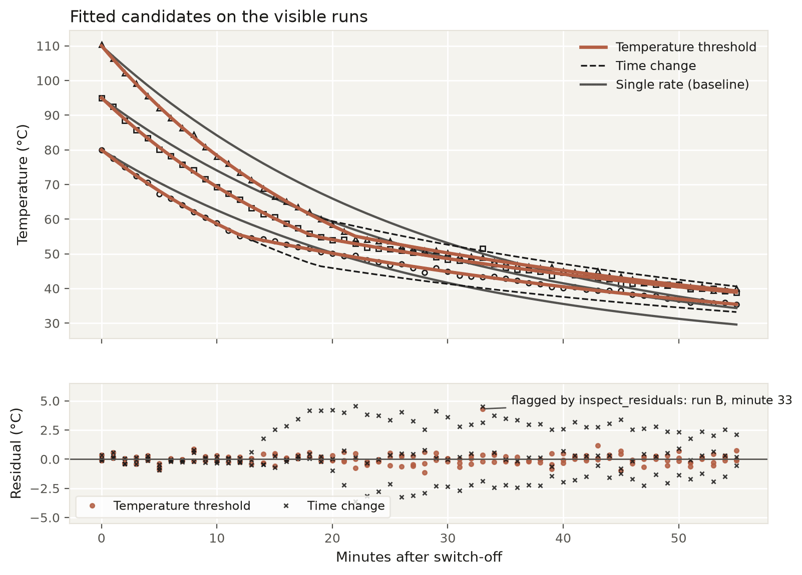
Drempelresiduen vertonen geen systematisch patroon. Afbeelding door de auteur.
De tijdwissel-fit komt overeen met run B. Na de omslag mist hij run A met grofweg +2,5 tot +3,5 °C en run C met -1,5 tot -2,8 °C.
Ik vind de tekenomslag nuttiger dan alleen de rangorde: die laat zien dat de omschakeling eerder komt in A en later in C, zoals een temperatuurdrempel voorspelt. Het sensor-offsetmodel verkleint wat fout door drift toe te voegen, maar de achtergehouden fouten blijven groter.
Controleer de gecorrumpeerde meting
De agent wist niet welke meting ik had gecorrumpeerd. Hij vond run B, minute 33, met een residu van ongeveer +4,3 °C. De robuuste z-score, die de afstand tot de typische residuspreiding meet, lag boven 12.
Claude liet de meting staan, omdat soft L1 de invloed al beperkt. Om die keuze te controleren heb ik alle vier de modellen zonder die meting opnieuw gefit. Het drempelmodel bleef met ruime voorsprong eerste en de drempelschatting verschoof nauwelijks.
Ontwerp een bevestigingsexperiment
De agent vergeleek kandidaatvoorspellingen bij verschillende begin- en kamertemperaturen en koos vervolgens condities zonder nieuwe metingen te zien.
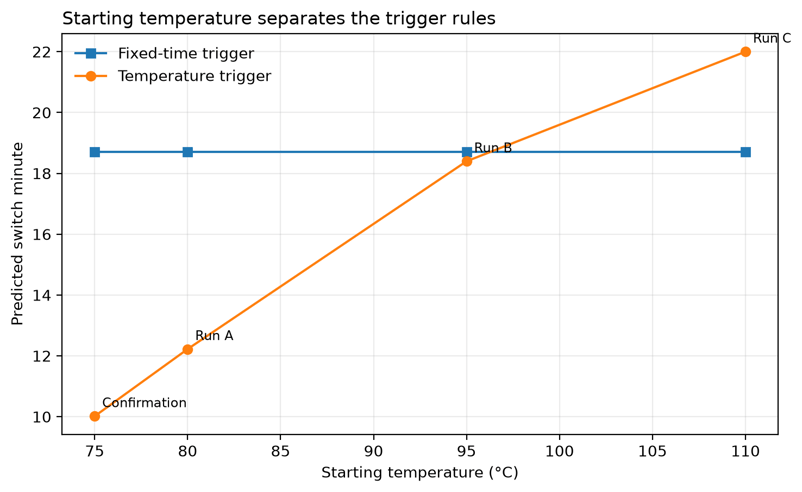
Begintemperaturen leggen elke triggerregel bloot. Afbeelding door de auteur.
Kies condities die de modellen uit elkaar trekken
Zoals in de TL;DR vermeld, koos de agent een start op 75 °C en een kamer van 20 °C. Het drempelmodel schakelt rond minuut 10, terwijl het tijdmodel rond minuut 19 schakelt. De sensor-offsetcurve blijft ook los van de drempelvoorspelling.
Een middenopstelling dicht bij run B zou het drempel- en tijdmodel maar met ongeveer 0,6 °C scheiden. De gekozen condities liggen net buiten het geteste bereik, en Claude heeft dat in zijn rapport gemarkeerd.
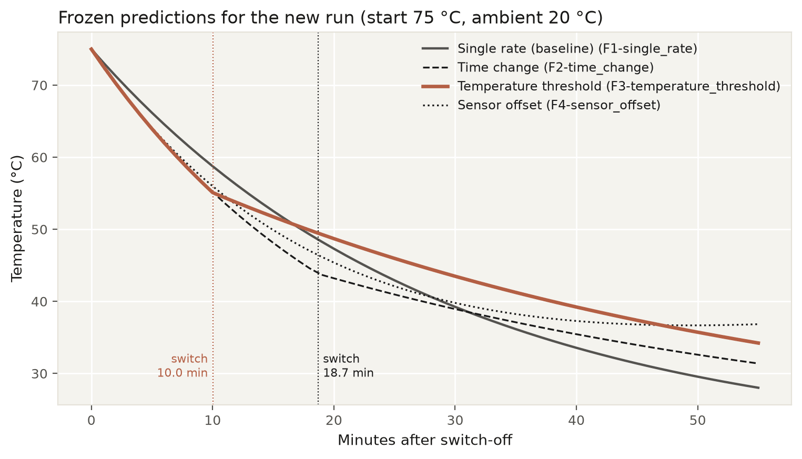
Kandidaatvoorspellingen voor de gekozen run. Afbeelding door de auteur.
Vergrendel voorspellingen vóór datageneratie
Ik heb de gekozen condities, gefitte parameters en de voorspelling van elke kandidaat vastgezet voordat ik nieuwe metingen genereerde. De agent ontving de bevestigingsmetingen niet en kon zijn antwoord na de uitkomst niet bijstellen.
De bevestigingsmetingen gebruiken hetzelfde Gaussische ruismodel, een aparte vaste seed en geen extra uitschieter.
Scoor de onzichtbare run
Afzonderlijke Python-code scoorde de bevroren voorspellingen. Die roept de API nooit aan, dus Claude heeft geen rol in het beoordelen van zijn eigen antwoord.
Scoreer voorspellingen met onafhankelijke Python
De drempelvoorspelling slaagde voor beide vooraf ingestelde tests. Op de onzichtbare run scoorde hij 0,27 °C MAE en 0,32 °C RMSE. Vaste-tijd scoorde 3,67 °C RMSE, sensoroffset 2,35 °C en enkelvoudig tempo 4,28 °C.
De bevestigingsrun bevat geen geplante uitschieter, wat de lagere fout verklaart vergeleken met de leave-one-run-out-resultaten. Een andere steekproef van willekeurige ruis kan ook meespelen.
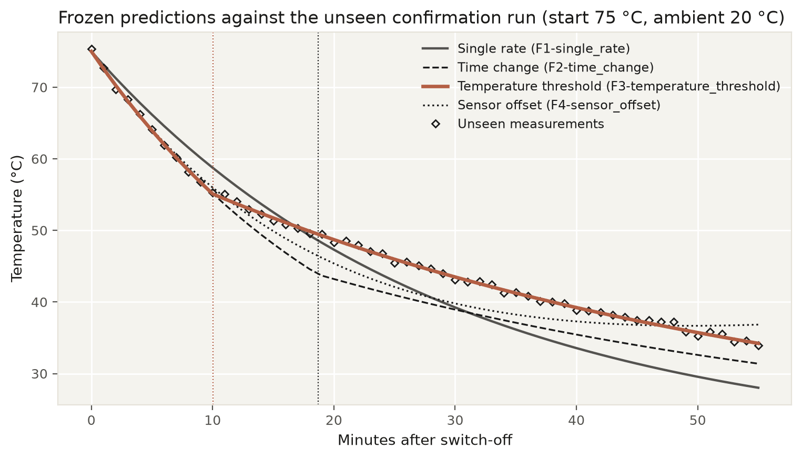
Bevroren voorspellingen komen overeen met de onzichtbare metingen. Afbeelding door de auteur.
Vergelijk gefitte parameters met de verborgen waarheid
Vergelijk na het scoren de gefitte parameters met de verborgen genererende waarden:
import numpy as np
def true_curve(t0, ta, minutes, truth):
"""Newton cooling whose rate drops when the temperature crosses a threshold. Continuous at the switch."""
t = np.asarray(minutes, dtype=float)
k1, k2, th = truth["k_above"], truth["k_below"], truth["threshold_c"]
if t0 <= th:
return ta + (t0 - ta) * np.exp(-k2 * t)
t_cross = np.log((t0 - ta) / (th - ta)) / k1
fast = ta + (t0 - ta) * np.exp(-k1 * t)
slow = ta + (th - ta) * np.exp(-k2 * (t - t_cross)) # restarts from the threshold
return np.where(t <= t_cross, fast, slow)De simulator voegt gezaaide Gaussische ruis rond deze curve toe.
De verborgen regel was een temperatuurdrempel op 55 °C, met snelheden van 0,045 en 0,020 per minuut en een ruis-standaarddeviatie van 0,35 °C.
Gefitte snelheden komen overeen tot op 3 decimalen, de drempel valt binnen 0,1 °C en de voorspelde omschakeling binnen 0,1 minuut.
De data identificeren de wiskundige regel die de simulator gebruikte. Ze kunnen niet aantonen of een echt apparaat dat rond 55 °C vertraagt te maken heeft met een faseverandering, een ventilatorcyclus of een andere fysieke oorzaak.
Bekijk hoe de agent tot zijn antwoord kwam
Het rapport noemde fit-ID's en toolnummers als bewijs, en gaf aan wat drie runs niet kunnen vaststellen. Het zwakke punt is de vroege gok die ik eerder noemde. Eén onderzoek kan niet laten zien hoe vaak zo'n gok misgaat.
Bekijk het onderzoek in Streamlit
In de video start ik een live run, volg ik het toollog en open ik na het scoren de tabbladen Report, Curves, Confirmation en Cost.
De Streamlit-interface toont één onderzoek. Video door de auteur.
Meet de kosten van de Claude Fable 5.2 API
Het onderzoek, inclusief het eindrapport, kostte ongeveer $0,49 en duurde iets meer dan een minuut. SciPy draait op je eigen machine, dus dat telt niet mee voor de API-rekening.
Alleen het rapportverzoek was goed voor bijna de helft van de kosten en tijd. Zoals ik in de tool-loopsectie aangaf, mist een nieuw uitvoerformaat de promptcache, dus die laatste aanvraag verwerkte het hele gesprek opnieuw voordat er een lang rapport werd geschreven. Houd ongecachte input, cache-schrijfsels, cache-lezingen en output afzonderlijk bij, want elk heeft zijn eigen prijs.
Beperkingen en praktische overwegingen
Twee soorten beperkingen zijn hier van belang: wat het experiment kan aantonen en wat de code nodig heeft voordat die als service kan draaien.
Wetenschappelijke beperkingen
De simulator en de drempelkandidaat gebruiken dezelfde vergelijking. Een geleidelijke omschakeling in een echt apparaat kan nog steeds in dit model passen terwijl het een andere curve volgt.
Als de ware regel ontbrak, zou de agent nog steeds het dichtstbijzijnde geleverde model kunnen kiezen in plaats van inconclusive te antwoorden. Meer ruis of een drempel die maar net wordt gepasseerd kan de fouten te vergelijkbaar maken om te scheiden. Een andere run kan een andere toolvolgorde nemen.
Vóór productie
De beperkingen uit de toollus dekken één onderzoek op je machine. Een productieservice heeft meer nodig:
- Stel SDK-retries en aanvraag-time-outs in voor de service.
- Valideer elke toolinput en -output in Python.
- Log het model, de SDK-versie, stopreden, tokens, latentie en kosten voor elke aanvraag.
- Pin model- en SDK-versies, draai de verborgen test opnieuw en bevestig het 30-dagenretentiebeleid vóór een upgrade.
Wanneer dit patroon past
Gebruik dit patroon wanneer meerdere verklaringen passen, Python ze kan testen en een verborgen experiment de keuze kan beoordelen, vooral wanneer het volgende experiment meer kost dan de API-call.
Gebruik plain Python wanneer je de modelfamilie kent. Anthropics Fable 5.2-modelgids raadt aan om eerst Opus te proberen en Fable te testen wanneer Opus niet aan de eis voldoet.
Slotgedachten
We hebben een agent gebouwd die vier koelmodellen vergeleek, een temperatuurdrempel koos, een bevestigingsrun ontwierp en metingen voorspelde die hij nog nooit had gezien. Voor dit synthetische apparaat is het antwoord op mijn openingsvraag ja.
Dat zou ik niet doortrekken naar echte apparatuur of open-einde-ontdekking. Zoals ik bij de beperkingen aangaf, bevatten de kandidaten de eigen vergelijking van de simulator, en ik heb de agent één keer laten draaien.
Wat overeind blijft is de methode: verberg de waarheid, stel de scoreregels vast vóór het eerste verzoek, vries voorspellingen in en gebruik een aparte beoordelaar. Een nuttige vervolgt test zou een geleidelijk-overgangsmodel toevoegen en het onderzoek herhalen bij verschillende ruisniveaus.
Voor modelselectie behandelt onze cursus Introduction to Claude Models de Claude-reeks en de bijbehorende trade-offs.
FAQs
Kan ik thinking uitschakelen of een thinking-budget instellen op Claude Fable 5.2?
Nee. Adaptief denken staat altijd aan, en zowel thinking: {type: "disabled"} als budget_tokens geven een 400-fout. Bepaal in plaats daarvan met de effort-parameter hoeveel het model nadenkt; die staat standaard op high. Denk-tokens worden als output gefactureerd en tellen mee voor max_tokens.
Waarom geeft Claude Fable 5.2 een 400-fout nadat ik eerdere berichten heb bewerkt?
Elk thinking-blok is alleen geldig voor de systemprompt, tools en berichten die eraan voorafgingen, en Fable 5.2 controleert dit op elk account. Houd het gesprek append-only en bevries system en tools voor de sessie. Als tussenoplossing laat het instellen van prefix_mismatch_behavior op "drop_block" met de bèta-header de betreffende blokken vallen in plaats van te falen.
Kan ik Claude Fable 5.2 dwingen om een specifieke tool aan te roepen?
Nee. tool_choice instellen op any of op een benoemde tool geeft een 400-fout; alleen auto en none werken. Noem de tool in je instructie en zet strict: true zodat de call overeenkomt met je schema. Als de call verplicht is, gebruik dan een systembericht halverwege het gesprek.
Wat gebeurt er als Claude Fable 5.2 een verzoek weigert?
De response komt terug met stop_reason: "refusal", en stop_details.category vertelt je welke beveiliging is geactiveerd. Je kunt zelf opnieuw proberen op een ander model, of kiezen voor server-side fallback met fallbacks: "default", een bèta die opnieuw probeert op Claude Opus 4.8 of Claude Opus 5. Het fallback-model ontvangt de thinking-blokken van Fable 5.2 niet.
Kan ik Claude Fable 5.2 gebruiken met zero data retention?
Niet standaard. Fable 5.2 vereist 30 dagen gegevensretentie, en API-verzoeken van een organisatie of workspace zonder die instelling geven een 400-fout. Onder een ZDR-regeling schakel je 30 dagen retentie in voor een workspace of neem je contact op met je Anthropic-accountteam.
Kan de Batch API de toollus uit dit experiment vervangen?
Nee. Elke toolstap heeft de vorige response nodig, dus de Batch API kan deze lus niet direct vervangen. De 50% korting past bij onafhankelijke verzoeken of parallelle evaluaties.

Ik ben een data-engineer en communitybouwer die werkt aan datapijplijnen, cloud en AI-tools, en tegelijkertijd praktische, impactvolle tutorials schrijft voor DataCamp en beginnende developers.


LLM’s zijn goed in klinken alsof ze redenerend tot een antwoord zijn gekomen. Of dat ook echt zo is, is lastiger te controleren. Bij de meeste taken heeft het model óf eerder iets soortgelijks gezien óf kan niemand het antwoord verifiëren. Dus heb ik een test gebouwd waarbij het antwoord verborgen blijft.
Claude Fable 5.2 krijgt rumoerige metingen van een gesimuleerd apparaat dat afkoelt nadat het is uitgeschakeld, plus 4 mogelijke verklaringen voor waarom die afkoeling halverwege vertraagt. Het moet er één kiezen, een vervolgexperiment ontwerpen en zich vastleggen op een voorspelling vóórdat het een enkele nieuwe meting ziet. Losstaande Python-code beoordeelt vervolgens de voorspelling, en Claude komt er niet aan.
Het koelende apparaat is alleen de testcase. Wat overdraagbaar is, is de setup: verberg de waarheid voor het model, leg de beoordelingsregels vast vóór de eerste API-call, vries de voorspellingen in en beoordeel ze met code die het model niet kan zien. Je kunt dit hergebruiken voor elk probleem van het type “welke verklaring is juist?”, van rootcause-analyses tot het lezen van een A/B-test.
In deze tutorial bouw je die agent in Python. SciPy doet het rekenwerk; Claude beslist welke check het daarna uitvoert en welke conclusie het trekt. Als je overweg kunt met Python-functies en API-requests, kun je meedoen, en ik leg de koel-wiskunde uit zodra die voor het eerst langskomt. We behandelen hoe je:
Onze Claude Fable 5.2-overzicht gaat over de lancering en benchmarks, dus ik blijf hier bij de API en de koelingstest. Ik draaide het experiment de dag na de lancering.
TL;DR
Ik gaf Fable 5.2 rumoerige data van een gesimuleerd apparaat waarvan de afkoeling halverwege vertraagt, plus vier mogelijke verklaringen. Het moest er één kiezen, een nieuw experiment ontwerpen en het resultaat voorspellen vóórdat het dit zag.