

Proiectează experimentul și harness-ul
Implementarea mea îl cuplează pe Claude cu patru funcții Python, numite instrumente, pe care le voi arăta după setul de date. Codul complet și interfața opțională Streamlit sunt în repozitoriul GitHub.
Definește cele patru modele de răcire
Legea răcirii a lui Newton spune că un obiect se răcește mai repede când este mult mai fierbinte decât încăperea, apoi încetinește pe măsură ce diferența de temperatură scade. Ecuația este T(t) = Ta + (T0 - Ta) * exp(-k * t). Aici, T0 este temperatura inițială, Ta este temperatura camerei, iar k este rata de răcire pe minut.
Am scris patru familii de modele din care agentul să aleagă:
-
Rată unică: un singur
kpe tot parcursul, folosit ca linie de bază -
Schimbare în timp: două rate, comutarea are loc în același minut (timp scurs) în fiecare rulare
-
Prag de temperatură: două rate, comutarea are loc la o temperatură comună, deci într-un minut diferit în fiecare rulare
-
Deviere a senzorului: o rată reală, plus o eroare a sondei care începe la jumătatea rulării și crește
Separă măsurătorile vizibile de adevărul ascuns
Claude vede trei serii de răcire și orice returnează instrumentele. Ratele reale, pragul, setările datelor și măsurătorile de confirmare rămân în afara accesului său la instrumente.
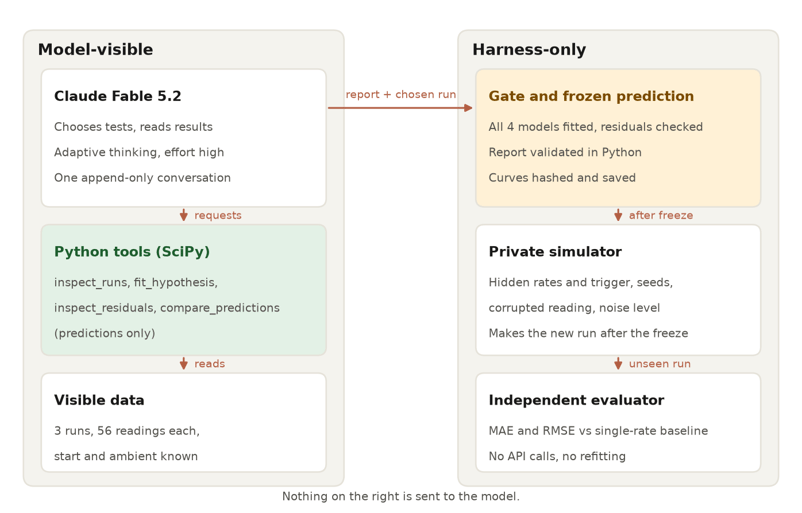
Claude accesează instrumentele; adevărul rămâne ascuns. Imagine de autor.
Tot ceea ce e în Python în jurul lui Claude face parte din agent harness. În afară de rularea instrumentelor, limitează cererile, timpul și cheltuiala, lucru pe care îl voi acoperi odată cu bucla de instrumente.
Înainte de primul apel la API, am fixat modelele candidate, limitele parametrilor, restricțiile și regula de trecere pentru noul experiment: un RMSE de cel mult 1,0 °C și cel mult jumătate din cel al liniei de bază cu rată unică. Aceste reguli au rămas fixe.
Configurează Claude Fable 5.2 în Python
Configurarea necesită un mediu virtual și o cheie API. Modelul claude-fable-5-2 poate citi până la 1M tokeni din prompt și istoricul conversației, apoi poate returna până la 128K tokeni de ieșire.
Gândirea adaptivă, în care modelul decide cât să raționeze înainte de a răspunde, este mereu activă, iar API-ul are implicit efort ridicat. Prețurile Claude API sunt 8 $ pe milion de tokeni de intrare și 40 $ pe milion de tokeni de ieșire, cu scrieri în cache-ul promptului de cinci minute la 10 $ și citiri din cache la 0,20 $.
Ai nevoie de:
-
Python 3.12+, pentru că NumPy 2.5.4 și SciPy 1.18.1 îl cer (pachetul Anthropic în sine suportă 3.10)
-
O cheie API cu acces la
claude-fable-5-2 -
anthropic2.7.0, versiunea care a adăugat ID-ul modelului
Clonează proiectul și instalează dependențele fixate. Pe macOS sau Linux, creează mediul cu python3.12 -m venv .venv, activează-l cu source .venv/bin/activate și înlocuiește Copy-Item cu cp.
git clone https://github.com/KhalidAbdelaty/claude-fable-5-2-api.git
cd claude-fable-5-2-api
py -3.12 -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env # then paste your key after ANTHROPIC_API_KEY=Codul încarcă cheia API din mediu fără a o afișa. README-ul repo-ului listează comenzile pentru experimentul complet, iar doar două dintre ele apelează API-ul. Ghidul nostru Claude API acoperă în general cheile și facturarea.
Fă prima ta cerere către API-ul Fable 5.2
Sari peste această secțiune dacă l-ai apelat deja pe Claude din Python. Această cerere se concentrează pe indiciile care separă cele două ipoteze.
import anthropic
from dotenv import load_dotenv
load_dotenv(".env", override=True)
client = anthropic.Anthropic() # reads ANTHROPIC_API_KEY
response = client.messages.create(
model="claude-fable-5-2",
max_tokens=4096,
output_config={"effort": "high"},
messages=[{"role": "user", "content": (
"Three cooling runs start at 80, 95, and 110 C. Each seems to slow down partway through. "
"In three short bullets: what pattern across the runs would point to a change after a fixed "
"time, what pattern would point to a change at a fixed temperature, and what the data alone "
"cannot tell us.")}],
)
print("block types:", [block.type for block in response.content])
print("stop reason:", response.stop_reason)
print("".join(block.text for block in response.content if block.type == "text"))Claude returnează o listă de blocuri de conținut tipizate, așa că citește textul după tipul blocului; content[0] poate fi un bloc de gândire. Iată primul răspuns:
block types: ['thinking', 'text']
stop reason: end_turn
- **Fixed time:** the slowdown appears at the same elapsed time in all three runs but at different temperatures, with the hotter-start runs still hotter when it happens.
- **Fixed temperature:** the slowdown appears at the same temperature in all three runs but at different elapsed times, with the hotter-start runs reaching it later.
- **What the data cannot tell us:** the cause. A matching pattern shows what the change tracks, not why it happens (for example a phase change, a setup artifact, or a shift in the surroundings). Since cooling naturally slows as it nears room temperature, the data also cannot show on its own that there is a distinct change rather than a smooth curve.Au apărut atât blocuri thinking, cât și text. Tokenii de gândire se contorizează ca tokeni de ieșire, deci include-i când estimezi costurile. Ghidul de migrare Claude Fable 5.2 menționează că budget_tokens, gândirea disabled, temperature, top_p și top_k returnează o eroare 400.
Creează un set de date de răcire fără scurgeri de date
Datele trebuie să fie suficient de dezordonate încât să necesite potrivirea modelului, iar răspunsul trebuie să rămână în afara accesului lui Claude.
Simulează trei rulări de răcire
Am simulat trei rulări pornind de la legea lui Newton, cu o schimbare ascunsă, continuă, în răcire. Rularea A începe la 80 °C într-o cameră la 21,0 °C, B la 95 °C în 24,0 °C, iar C la 110 °C în 22,5 °C. Un generator de numere aleatoare NumPy fix adaugă zgomot gaussian, iar o citire primește intenționat o eroare suplimentară.
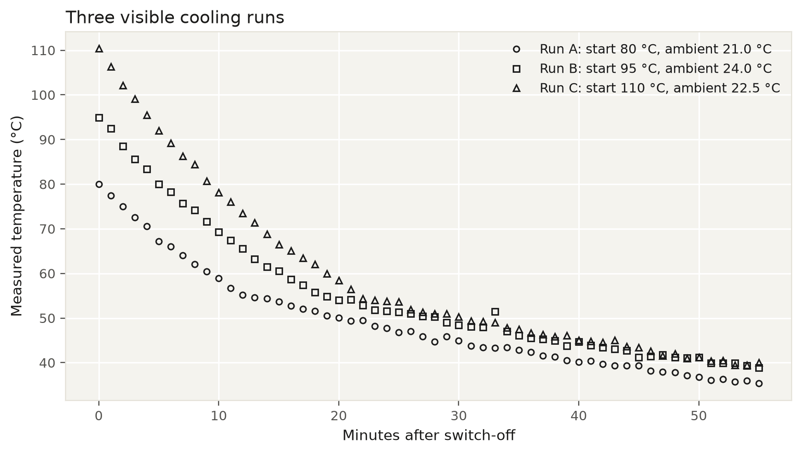
Trei rulări zgomotoase includ un outlier. Imagine de autor.
Rularea A se răcește mai repede la început decât spre final. Modelul acesta singur nu arată o schimbare discretă, fiindcă orice exponențială încetinește lângă temperatura camerei.
Rularea B conține un salt izolat de aproximativ 4 °C, în timp ce diferențele dintre citirile vecine în rest rămân sub 1,2 °C. Fiecare „cotitură” se întinde pe câteva minute zgomotoase, așa că inspecția vizuală nu poate separa modelele cu schimbare în timp și cu prag.
Testează ipoteze de răcire cu instrumente Python
Python potrivește fiecare candidat de răcire după aceleași reguli și returnează parametrii și erorile sale. Claude nu vede niciodată codul de potrivire, doar ce returnează fiecare instrument.
Potrivește parametri comuni fără ca un outlier să domine
Potrivirea înseamnă alegerea valorilor parametrilor care mențin fiecare curbă prezisă aproape de măsurătorile ei. Folosesc pierderea L1 moale (soft L1) pentru că reduce influența unei erori mari fără a șterge acea citire.
Toate rulările împart parametrii potriviți, în timp ce fiecare rulare își păstrează propria temperatură inițială și a camerei. Pentru modelul cu prag, asta oferă fiecărei rulări propriul timp de comutare, ln((T0 - Ta) / (threshold - Ta)) / k_above.
Funcția least_squares() din SciPy caută parametrii de potrivire cei mai buni, iar limitele parametrilor păstrează ratele și punctele de comutare în intervalele fixate înainte de rulare.
Fragmentul de mai jos arată apelul solverului și verificările de convergență. Funcția reziduală și scanarea în jurul ei sunt în repository.
from scipy.optimize import least_squares
def _solve(hypothesis, names, x0, lo, hi, runs):
# soft L1: residuals under f_scale count roughly squared, larger ones roughly linearly
return least_squares(_residuals, x0, bounds=(lo, hi), method="trf",
loss="soft_l1", f_scale=0.5, args=(hypothesis, names, runs))
# scan the change point in 0.5 steps with the rates fitted at each step, then refine all three
res = _solve(hypothesis, names, best_grid_point, lo, hi, runs)
converged = bool(res.success and res.status > 0 and np.all(np.isfinite(res.x)))
at_bound = [n for n, v, a, b in zip(names, res.x, lo, hi) if min(v - a, b - v) < 1e-4 * (b - a)]Am setat f_scale la 0,5 °C înainte de rulare. Reziduurile mai mari de atât încep să-și piardă influența sub L1 moale. O scanare în grilă peste punctul de comutare oferă solverului o valoare inițială rezonabilă.
Validează modelele cu teste leave-one-run-out
MAE este abaterea medie în °C. RMSE pătrățește mai întâi erorile, astfel încât erorile mai mari cântăresc mai mult.
Eroarea de antrenare favorizează modelele cu mai mulți parametri. Cross-validarea estimează eroarea pe date excluse prin rotirea seturilor omise. Aici, validarea leave-one-run-out (LORO) potrivește pe două rulări și prezice a treia.
Definește schemele de apelare a instrumentelor Claude
O schemă de instrument este o descriere JSON a unei funcții Python și a argumentelor pe care Claude le poate trimite. Strict tool use face ca API-ul să verifice acea formă înainte ca Python să ruleze funcția.
Claude poate solicita patru instrumente:
-
inspect_runs: returnează măsurătorile vizibile și rezumate simple ale pantei. -
fit_hypothesis: potrivește un model de răcire și returnează parametrii și erorile pe setul scos din antrenare. -
inspect_residuals: arată unde temperaturile observate diferă de predicțiile modelului. -
compare_predictions: compară modelele potrivite în condițiile propuse pentru experiment.
Schema compare_predictions păstrează măsurătorile de confirmare în afara instrumentului:
{"name": "compare_predictions", "strict": True,
"description": "Predict a new run from existing fits under proposed conditions and report how far the "
"predictions differ. initial_temp_c must be 75 to 115 and ambient_temp_c 20 to 25. "
"Returns predictions only; no new measurements are generated.",
"input_schema": {"type": "object", "additionalProperties": False,
"properties": {"initial_temp_c": {"type": "number"},
"ambient_temp_c": {"type": "number"},
"fit_ids": {"type": "array", "items": {"type": "string"}}},
"required": ["initial_temp_c", "ambient_temp_c", "fit_ids"]}}Valorile fit_ids se referă la modele potrivite mai devreme în aceeași investigație. Schemele stricte nu acceptă minimum sau maximum, deci Python verifică singur intervalele de temperatură. Lasă tool_choice pe auto, deoarece forțarea unui instrument returnează o eroare 400 pe Fable 5.2.
Construiește bucla de instrumente Claude
Aplicația repetă un ciclu: trimite conversația către Claude, rulează orice instrumente Python solicitate și returnează rezultatele lor. Continuă până când comparațiile cerute sunt finalizate, apoi îi cere lui Claude un raport final într-un format fix.
Scrie un prompt pentru testarea ipotezelor
Promptul de sistem descrie metoda fără a sugera un răspuns. Promptul de bază este:
SYSTEM = """You are a scientific investigator working on a controlled cooling experiment. You decide which
checks to run and how to read the results. Python tools do every numerical calculation.
How to work:
- Look at the measurements before you choose a model.
- Fit every candidate model with fit_hypothesis. Compare them on leave-one-run-out error as well as
training error, because a model with more parameters always fits the training runs at least as well.
- Use inspect_residuals to look for systematic patterns and to decide whether any single reading is
an outlier.
- Use only numbers that a tool returned. Do not invent measurements, parameters, or errors.
- Keep observed evidence separate from assumptions. The data can show which mathematical model fits
best; it cannot show the physical cause of a change.
- If the evidence does not separate the candidates, say so and treat the result as inconclusive.
..."""Îmi pasă cel mai mult de ultimul punct. Fără el, modelul trebuie să numească un câștigător chiar și când erorile sunt prea apropiate ca să tragi o concluzie.
Păstrează bucla de instrumente doar în regim de adăugare
Fiecare apel trimite aceleași system și tools, iar fiecare răspuns se trimite înapoi nemodificat. Acest fragment arată gestionarea mesajelor; bucla completă cu gestionarea opririlor este în repository.
resp = client.messages.create(
model="claude-fable-5-2",
max_tokens=20_000,
system=SYSTEM,
tools=TOOLS, # all four, declared on the first request
thinking={"type": "adaptive", "display": "summarized"},
output_config={"effort": "high"},
cache_control={"type": "ephemeral"}, # automatic prompt caching
messages=messages,
)
messages.append({"role": "assistant", "content": resp.content}) # unchanged, thinking included
if resp.stop_reason == "tool_use":
results = []
for block in resp.content:
if block.type == "tool_use":
out, is_error = box.run(block.name, dict(block.input))
results.append({"type": "tool_result", "tool_use_id": block.id,
"content": out, "is_error": is_error})
messages.append({"role": "user", "content": results})Gândirea păstrată îi permite lui Claude să-și păstreze raționarea anterioară între ture, atât timp cât system, tools și mesajele anterioare rămân neschimbate. Pe Fable 5.2, editarea oricăruia dintre ele returnează implicit o eroare 400.
Poți schimba output_config, tool_choice și max_tokens între apeluri, deși un format nou de ieșire tot ratează cache-ul de prompt. Grupează rezultatele paralele ale instrumentelor într-un singur mesaj de utilizator, așa cum face bucla de mai sus.
Stabilește limite pentru cereri, timp și cheltuială
Python numără cererile, apelurile de instrumente, timpul scurs și cheltuiala, și nu va începe muncă nouă odată ce se atinge o limită. O cerere deja în curs poate totuși să depășească limita de timp sau de cheltuială, deci tratează-le pe acestea două ca limite soft.
Înainte de a accepta un răspuns final, Python verifică și că Claude a potrivit fiecare candidat, a inspectat reziduurile și a comparat proiectele de confirmare. Dacă Claude se oprește din orice motiv în afară de o cerere de instrument sau o tură încheiată, investigația se încheie ca neconcludentă. Setează max_tokens suficient de sus pentru gândire plus răspuns.
Returnează un raport structurat
După ce verificările trec, încă o cerere solicită ieșiri structurate pe același istoric, astfel încât raportul final să sosească drept obiect Python validat:
messages.append({"role": "user", "content": REPORT_PROMPT})
resp = client.messages.parse(
model="claude-fable-5-2", max_tokens=20_000, system=SYSTEM, tools=TOOLS,
thinking={"type": "adaptive", "display": "summarized"},
output_config={"effort": "high"},
output_format=InvestigationReport, # the SDK sends this as output_config.format
tool_choice={"type": "none"}, # tools stay declared, so the prefix check passes
messages=messages,
)
problems = validate(resp.parsed_output, box.fits) # fit IDs exist, all four covered, ranges holdPydantic verifică forma raportului, iar validate() confirmă că fiecare potrivire citată există și că condițiile se încadrează în intervalul permis. După aceea, alegerea modelului și condițiile sunt finale.
Fable 5.2 selectează modelul cu prag de temperatură
Am rulat o investigație la efort high. Iată cum a ajuns Claude la răspuns.
Urmărește secvența de teste a lui Claude
Claude a început prin a inspecta măsurătorile. Înainte de a potrivi ceva, rezumatul lui a fost: „Schimbarea apare pe la 55 °C în fiecare rulare: la minutul 12 în A, minutul 19 în B și minutul 22 în C. Asta indică un prag, așa că le voi potrivi pe toate patru.”
Aș numi asta ancorare: Claude s-a angajat într-un răspuns înainte de a-l testa. Potrivirea de mai târziu a fost de acord, cu comutări în jurul minutelor 12, 18 și 22. Urma din terminal arată ordinea verificărilor rămase.
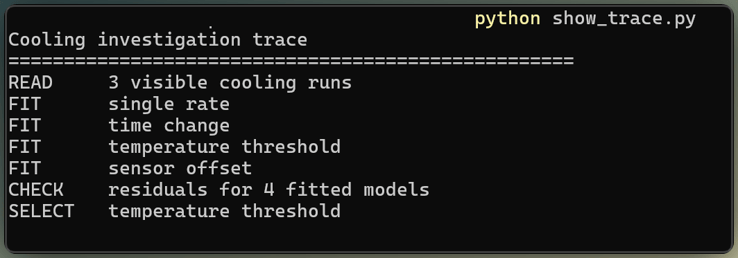
Urma din terminal arată ordinea testelor făcute de Claude. Imagine de autor.
Compară erorile pe setul scos din antrenare între patru modele
AntrenaRMSE măsoară fiecare potrivire pe toate cele trei rulări. Coloanele cu setul scos din antrenare mediază cele trei teste LORO.
|
Candidate |
Premisa principală |
Train RMSE (°C) |
Held-out MAE (°C) |
Held-out RMSE (°C) |
|
Rată unică |
O singură rată pe tot parcursul |
4.08 |
3.90 |
4.60 |
|
Schimbare în timp |
Comutare comună în jurul minutului 19 |
1.92 |
2.17 |
2.63 |
|
Prag de temperatură |
Comutare comună în jur de 55 °C |
0.49 |
0.32 |
0.48 |
|
Deviere a senzorului |
O derivă de măsurare în creștere |
1.49 |
1.45 |
1.87 |
Pentru modelul cu prag, erorile de antrenare și cele pe setul scos din antrenare sunt apropiate, deci potrivirea se menține de la o rulare la alta, deși trei rulări nu pot exclude în general supraadaptarea. Graficul reziduurilor de mai jos arată temperatura observată minus predicția fiecărui model.
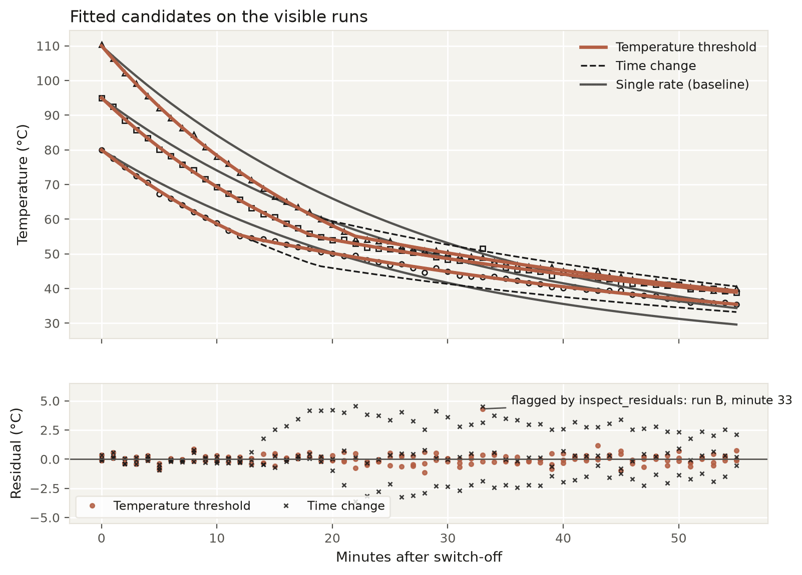
Reziduurile pentru prag nu arată niciun tipar sistematic. Imagine de autor.
Potrivirea cu schimbarea în timp se potrivește cu rularea B. După comutare, ratează rularea A cu aproximativ +2,5 până la +3,5 °C și rularea C cu -1,5 până la -2,8 °C.
Consider schimbarea de semn mai utilă decât ierarhia în sine: arată că comutarea sosește mai devreme în A și mai târziu în C, așa cum ar prezice un declanșator de temperatură. Modelul cu decalaj de senzor reduce o parte din eroare adăugând derivă, dar erorile pe setul scos din antrenare rămân mai mari.
Verifică citirea coruptă
Agentul nu știa care citire fusese coruptă. A găsit rularea B, minutul 33, cu un reziduu de aproximativ +4,3 °C. Z-score-ul său robust, care măsoară distanța față de răspândirea tipică a reziduurilor, a fost peste 12.
Claude a lăsat citirea în set, deoarece soft L1 deja îi limitează influența. Ca să verific acea alegere, am refăcut potrivirea tuturor celor patru modele fără ea. Modelul cu prag a rămas pe primul loc la mare distanță, iar estimarea pragului abia s-a mișcat.
Proiectează un experiment de confirmare
Agentul a comparat predicțiile candidaților la mai multe temperaturi inițiale și de cameră, apoi a ales condițiile fără a vedea nicio măsurătoare nouă.
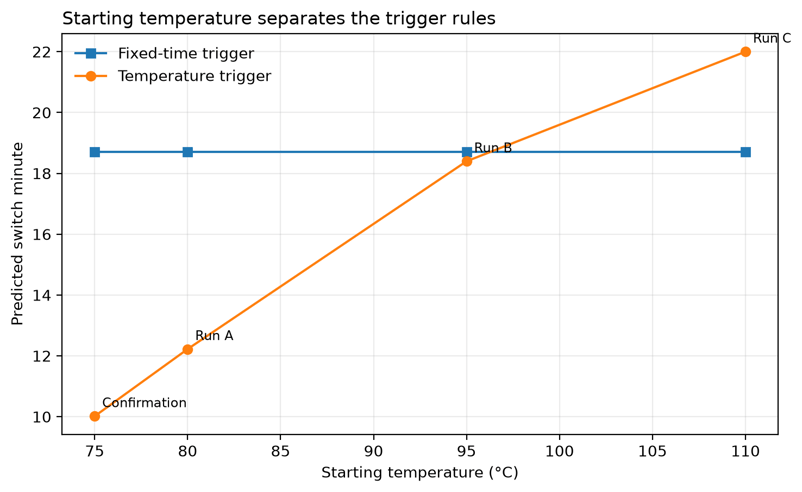
Temperaturile de start expun fiecare regulă de declanșare. Imagine de autor.
Alege condiții care separă modelele
Așa cum am menționat în TL;DR, agentul a ales un start la 75 °C și o cameră la 20 °C. Modelul cu prag comută în jurul minutului 10, în timp ce modelul cu timp comută în jurul minutului 19. Curba cu decalaj de senzor rămâne, de asemenea, separată de predicția cu prag.
O configurație de mijloc, aproape de rularea B, ar separa modelele cu prag și cu timp cu doar aproximativ 0,6 °C. Condițiile alese sunt ușor în afara intervalului testat, iar Claude a semnalat asta în raportul său.
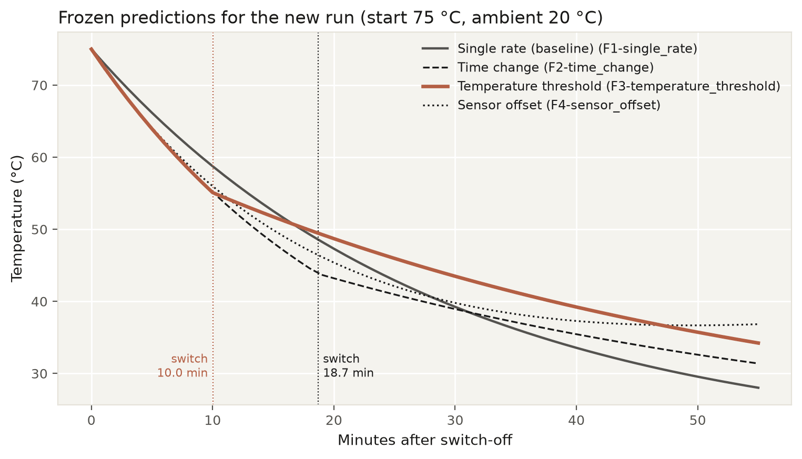
Predicțiile candidaților pentru rularea aleasă. Imagine de autor.
Blochează predicțiile înainte de generarea datelor
Am blocat condițiile alese, parametrii potriviți și predicția fiecărui candidat înainte de a genera orice măsurătoare nouă. Agentul nu a primit măsurătorile de confirmare și nu și-a putut revizui răspunsul după rezultat.
Măsurătorile de confirmare folosesc același model de zgomot Gaussian, un seed fix separat și niciun outlier adăugat.
Evaluează rularea nevăzută
Cod Python separat a evaluat predicțiile înghețate. Nu apelează niciodată API-ul, deci Claude nu are niciun rol în a-și nota propriul răspuns.
Evaluează predicțiile cu Python independent
Predicția cu prag a trecut ambele teste presetate. Pe rularea nevăzută, a obținut 0,27 °C MAE și 0,32 °C RMSE. Timp fix a obținut 3,67 °C RMSE, decalaj senzor 2,35 °C, iar rată unică 4,28 °C.
Rularea de confirmare nu conține outlier plantat, ceea ce ajută la explicarea erorii mai mici față de rezultatele leave-one-run-out. Un alt eșantion de zgomot aleator poate contribui, de asemenea.
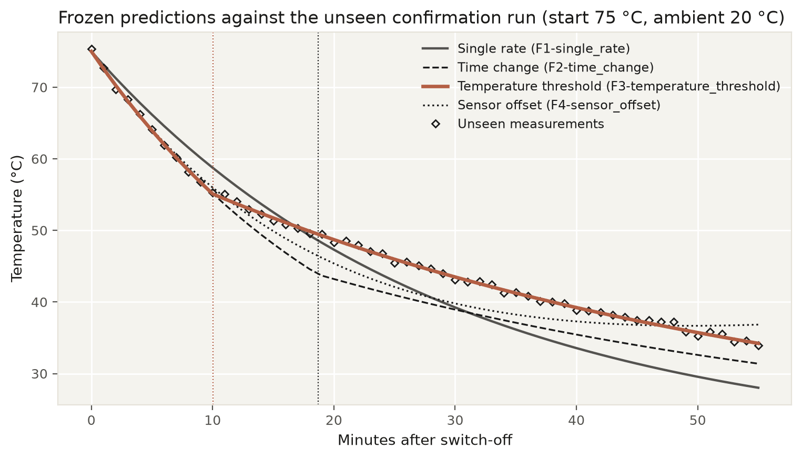
Predicțiile înghețate se potrivesc cu măsurătorile nevăzute. Imagine de autor.
Compară parametrii potriviți cu adevărul ascuns
După notare, compară parametrii potriviți cu valorile ascunse care au generat datele:
import numpy as np
def true_curve(t0, ta, minutes, truth):
"""Newton cooling whose rate drops when the temperature crosses a threshold. Continuous at the switch."""
t = np.asarray(minutes, dtype=float)
k1, k2, th = truth["k_above"], truth["k_below"], truth["threshold_c"]
if t0 <= th:
return ta + (t0 - ta) * np.exp(-k2 * t)
t_cross = np.log((t0 - ta) / (th - ta)) / k1
fast = ta + (t0 - ta) * np.exp(-k1 * t)
slow = ta + (th - ta) * np.exp(-k2 * (t - t_cross)) # restarts from the threshold
return np.where(t <= t_cross, fast, slow)Simulatorul adaugă zgomot Gaussian cu seed în jurul acestei curbe.
Regula ascunsă a fost un prag de temperatură la 55 °C, cu rate de 0,045 și 0,020 pe minut și o deviație standard a zgomotului de 0,35 °C.
Ratele potrivite se potrivesc la 3 zecimale, pragul cade în 0,1 °C, iar comutarea prezisă este în 0,1 minut.
Datele identifică regula matematică folosită de simulator. Ele nu pot arăta dacă un dispozitiv real care încetinește în jur de 55 °C implică o schimbare de fază, un ciclu al ventilatorului sau o altă cauză fizică.
Revizuiește cum a ajuns agentul la răspuns
Raportul a citat ID-uri de potrivire și numere de unelte ca dovezi și a menționat ce nu pot stabili trei rulări. Punctul slab este ghiceala timpurie pe care am menționat-o mai devreme. O singură investigație nu poate arăta cât de des merge prost un astfel de pariu.
Urmărește investigația în Streamlit
În video, pornesc o rulare live, urmăresc jurnalul uneltei și deschid filele Report, Curves, Confirmation și Cost după evaluare.
Interfața Streamlit arată o investigație. Video de autor.
Măsoară costul API Claude Fable 5.2
Investigația, inclusiv raportul final, a costat aproximativ 0,49 $ și a durat puțin peste un minut. SciPy rulează pe mașina ta, așa că nu adaugă nimic la factura API.
Doar cererea pentru raport a luat aproape jumătate din cost și timp. După cum am menționat în secțiunea despre bucla cu unelte, un format nou de ieșire ratează cache-ul promptului, astfel că acea ultimă cerere a procesat din nou toată conversația înainte de a scrie un raport lung. Ține separat evidența intrării necachate, a scrierilor în cache, a citirilor din cache și a ieșirii, deoarece fiecare are prețul propriu.
Limite și considerente practice
Contează două tipuri de limite aici: ce poate arăta experimentul și de ce are nevoie codul înainte să ruleze ca serviciu.
Limite științifice
Simulatorul și candidatul cu prag folosesc aceeași ecuație. O comutare treptată într-un dispozitiv real ar putea totuși să se potrivească acestui model urmând o altă curbă.
Dacă regula adevărată lipsea, agentul ar putea totuși alege modelul furnizat cel mai apropiat în loc să răspundă inconclusive. Mai mult zgomot sau un prag abia depășit ar putea face erorile prea similare ca să fie separate. O altă rulare poate lua o ordine diferită a uneltelor.
Înainte de producție
Limitele din bucla cu unelte acoperă o singură investigație pe mașina ta. Un serviciu de producție are nevoie de mai mult:
- Setează retry-urile SDK și time-out-urile cererilor pentru serviciu.
- Validează în Python fiecare intrare și ieșire a uneltelor.
- Jurnalizează modelul, versiunea SDK, motivul de oprire, tokenii, latența și costul pentru fiecare cerere.
- Blochează versiunile de model și SDK, rulează din nou testul ascuns și confirmă politica de retenție de 30 de zile înainte de un upgrade.
Când se potrivește acest tipar
Folosește acest tipar când mai multe explicații se potrivesc, Python le poate testa, iar un experiment ascuns poate nota alegerea, mai ales când următorul experiment costă mai mult decât apelul la API.
Folosește Python simplu când știi familia de modele. Ghidul pentru modelul Fable 5.2 de la Anthropic recomandă să încerci mai întâi Opus și să testezi Fable când Opus ratează cerința.
Gânduri finale
Am construit un agent care a comparat patru modele de răcire, a ales un prag de temperatură, a proiectat o rulare de confirmare și a prezis măsurători pe care nu le văzuse niciodată. Pentru acest dispozitiv sintetic, răspunsul la întrebarea mea de deschidere este da.
Nu aș extinde asta la echipamente reale sau la descoperiri deschise. Așa cum am acoperit la limite, candidații au inclus chiar ecuația simulatorului, iar eu am rulat agentul o singură dată.
Ce se transferă este metoda: ascunde adevărul, stabilește regulile de notare înainte de prima cerere, îngheață predicțiile și folosește un evaluator separat. Un test util în continuare ar adăuga un model cu tranziție treptată și ar repeta investigația la diferite niveluri de zgomot.
Pentru selecția modelelor, cursul nostru Introducere în modelele Claude acoperă gama Claude și compromisurile ei.
Întrebări frecvente
Pot să dezactivez gândirea sau să setez un buget de gândire pe Claude Fable 5.2?
Nu. Gândirea adaptivă este mereu activată, iar atât thinking: {type: "disabled"}, cât și budget_tokens returnează o eroare 400. Controlează cât de mult gândește prin parametrul effort, care implicit este high. Tokenii de gândire sunt facturați ca ieșire și se contorizează în max_tokens.
De ce returnează Claude Fable 5.2 o eroare 400 după ce editez mesajele anterioare?
Fiecare bloc de gândire este valid doar în raport cu promptul de sistem, unelte și mesajele anterioare, iar Fable 5.2 verifică asta pe fiecare cont. Păstrează conversația doar în anexă și îngheață system și tools pentru sesiune. Ca măsură provizorie, setarea prefix_mismatch_behavior la "drop_block" cu headerul beta elimină blocurile afectate în loc să eșueze.
Pot să forțez Claude Fable 5.2 să apeleze o unealtă anume?
Nu. Setarea tool_choice la any sau la o unealtă numită returnează o eroare 400; funcționează doar auto și none. Numește unealta în instrucțiune și setează strict: true astfel încât apelul să se potrivească schemei tale. Dacă apelul este obligatoriu, folosește un mesaj de sistem la mijlocul conversației.
Ce se întâmplă când Claude Fable 5.2 refuză o cerere?
Răspunsul revine cu stop_reason: "refusal", iar stop_details.category îți spune ce mecanism de siguranță a fost declanșat. Poți reîncerca tu însuți pe un alt model sau poți opta pentru fallback pe server cu fallbacks: "default", un beta care reîncearcă pe Claude Opus 4.8 sau Claude Opus 5. Modelul de fallback nu primește blocurile de gândire ale lui Fable 5.2.
Pot folosi Claude Fable 5.2 cu retenție zero de date?
Nu în mod implicit. Fable 5.2 necesită retenție de date de 30 de zile, iar cererile API dintr-o organizație sau un workspace fără aceasta returnează o eroare 400. În cadrul unui aranjament ZDR, activează retenția de 30 de zile pentru un workspace sau contactează echipa ta de cont Anthropic.
Poate Batch API să înlocuiască bucla cu unelte din acest experiment?
Nu. Fiecare pas cu unelte are nevoie de răspunsul anterior, așa că Batch API nu poate înlocui direct această buclă. Discountul de 50% se potrivește pentru cereri independente sau evaluări paralele.
LLM-urile sunt bune la a suna de parcă ar fi ajuns logic la un răspuns. Dacă chiar au făcut-o e mai greu de verificat. În cele mai multe sarcini, modelul fie a mai văzut ceva similar cu răspunsul, fie nimeni nu poate verifica deloc răspunsul. Așa că am construit un test în care răspunsul rămâne ascuns.
Claude Fable 5.2 primește citiri zgomotoase de la un dispozitiv simulat care se răcește după ce e oprit, plus 4 posibile explicații pentru motivul pentru care răcirea încetinește la jumătatea procesului. Trebuie să aleagă una, să proiecteze un experiment de urmărire și să își asume o predicție înainte de a vedea vreo nouă măsurătoare. Cod Python separat apoi notează predicția, iar Claude nu îl atinge niciodată.
Dispozitivul care se răcește e doar cazul de test. Ce se păstrează este configurația: ascunde adevărul de model, fixează regulile de notare înainte de primul apel API, îngheață-i predicțiile și evaluează-le cu cod pe care nu îl poate vedea. Poți refolosi asta pentru orice problemă de tip „care explicație e corectă?”, de la analiză a cauzei de bază până la interpretarea unui test A/B.
În acest tutorial, vei construi acel agent în Python. SciPy face calculele; Claude decide ce verificare să ruleze în continuare și ce concluzie să tragă. Dacă ești confortabil cu funcțiile Python și cererile API, poți urmări pașii, iar eu explic matematica răcirii când apare prima dată. Vom acoperi cum să:
Prezentarea noastră Claude Fable 5.2 acoperă lansarea și benchmark-urile, așa că aici rămân la API și testul de răcire. Am rulat experimentul a doua zi după lansare.
Pe scurt
I-am dat lui Fable 5.2 date zgomotoase de la un dispozitiv simulat a cărui răcire încetinește la jumătate, plus patru posibile explicații. A trebuit să aleagă una, să proiecteze un nou experiment și să prezică rezultatul înainte să-l vadă.