

Thiết kế thí nghiệm và bộ khung điều phối
Triển khai của tôi ghép Claude với bốn hàm Python, gọi là công cụ (tools), mà tôi sẽ trình bày sau phần dữ liệu. Mã đầy đủ và giao diện Streamlit tùy chọn có trong kho GitHub.
Định nghĩa bốn mô hình làm nguội
Định luật làm nguội Newton nói rằng một vật nguội nhanh hơn khi nó nóng hơn nhiều so với phòng, rồi chậm lại khi chênh lệch nhiệt độ thu hẹp. Phương trình là T(t) = Ta + (T0 - Ta) * exp(-k * t). Ở đây, T0 là nhiệt độ ban đầu, Ta là nhiệt độ phòng, và k là tốc độ làm nguội mỗi phút.
Tôi viết bốn họ mô hình để tác tử chọn:
-
Một tốc độ: một
ktrong suốt quá trình, dùng làm đường cơ sở -
Đổi theo thời gian: hai tốc độ, chuyển tại cùng một phút đã trôi qua trong mọi lần chạy
-
Ngưỡng nhiệt độ: hai tốc độ, chuyển tại một nhiệt độ chung, nên là những phút khác nhau ở mỗi lần chạy
-
Độ lệch cảm biến: một tốc độ thật, cộng thêm sai số đầu dò bắt đầu giữa chừng và tăng dần
Tách phép đo thấy được khỏi sự thật ẩn
Claude nhìn thấy ba chuỗi làm nguội và bất cứ thứ gì công cụ trả về. Các tốc độ thật, ngưỡng, thiết lập dữ liệu và phép đo xác nhận được giữ ngoài quyền truy cập công cụ của nó.
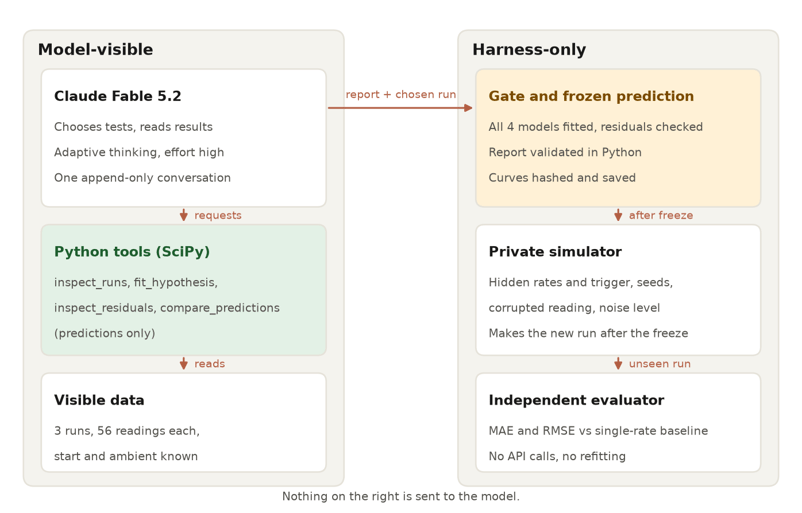
Claude truy cập công cụ; sự thật vẫn ẩn. Ảnh: Tác giả.
Mọi thứ trong Python xung quanh Claude tạo thành bộ khung (harness) cho tác tử. Ngoài việc chạy công cụ, nó còn giới hạn số yêu cầu, thời gian và chi phí, như tôi sẽ trình bày ở vòng lặp công cụ.
Trước cuộc gọi API đầu tiên, tôi cố định các mô hình ứng viên, giới hạn tham số, ràng buộc và quy tắc đạt cho thí nghiệm mới: RMSE tối đa 1,0 °C và không quá một nửa so với đường cơ sở đơn tốc độ. Những quy tắc đó được giữ nguyên.
Thiết lập Claude Fable 5.2 trong Python
Thiết lập cần một môi trường ảo và khóa API. claude-fable-5-2 model có thể đọc tối đa 1M token của prompt và lịch sử hội thoại, rồi trả về tối đa 128K token đầu ra.
Suy nghĩ thích ứng, nơi mô hình tự quyết định cần lý luận bao nhiêu trước khi trả lời, luôn bật, và API mặc định ở mức nỗ lực cao. Giá Claude API là $8 cho mỗi triệu token đầu vào và $40 cho mỗi triệu token đầu ra, với ghi cache prompt trong năm phút giá $10 và đọc cache giá $0,20.
Bạn cần:
-
Python 3.12+, vì NumPy 2.5.4 và SciPy 1.18.1 yêu cầu (bản Anthropic hỗ trợ 3.10)
-
Một khóa API có quyền truy cập
claude-fable-5-2 -
anthropic2.7.0, bản phát hành bổ sung model ID
Clone dự án và cài các phụ thuộc đã ghim. Trên macOS hoặc Linux, tạo môi trường bằng python3.12 -m venv .venv, kích hoạt bằng source .venv/bin/activate, và thay Copy-Item bằng cp.
git clone https://github.com/KhalidAbdelaty/claude-fable-5-2-api.git
cd claude-fable-5-2-api
py -3.12 -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env # then paste your key after ANTHROPIC_API_KEY=Mã tải khóa API từ biến môi trường mà không in ra. README của kho liệt kê các lệnh cho toàn bộ thí nghiệm, và chỉ hai lệnh gọi API. Hướng dẫn Claude API của chúng tôi bao quát chung về khóa và thanh toán.
Thực hiện yêu cầu API Fable 5.2 đầu tiên
Bỏ qua mục này nếu bạn đã từng gọi Claude từ Python. Yêu cầu này tập trung vào bằng chứng phân tách hai giả thuyết.
import anthropic
from dotenv import load_dotenv
load_dotenv(".env", override=True)
client = anthropic.Anthropic() # reads ANTHROPIC_API_KEY
response = client.messages.create(
model="claude-fable-5-2",
max_tokens=4096,
output_config={"effort": "high"},
messages=[{"role": "user", "content": (
"Three cooling runs start at 80, 95, and 110 C. Each seems to slow down partway through. "
"In three short bullets: what pattern across the runs would point to a change after a fixed "
"time, what pattern would point to a change at a fixed temperature, and what the data alone "
"cannot tell us.")}],
)
print("block types:", [block.type for block in response.content])
print("stop reason:", response.stop_reason)
print("".join(block.text for block in response.content if block.type == "text"))Claude trả về một danh sách các khối nội dung có kiểu, nên hãy đọc văn bản theo kiểu khối; content[0] có thể là khối suy nghĩ. Đây là phản hồi đầu tiên:
block types: ['thinking', 'text']
stop reason: end_turn
- **Fixed time:** the slowdown appears at the same elapsed time in all three runs but at different temperatures, with the hotter-start runs still hotter when it happens.
- **Fixed temperature:** the slowdown appears at the same temperature in all three runs but at different elapsed times, with the hotter-start runs reaching it later.
- **What the data cannot tell us:** the cause. A matching pattern shows what the change tracks, not why it happens (for example a phase change, a setup artifact, or a shift in the surroundings). Since cooling naturally slows as it nears room temperature, the data also cannot show on its own that there is a distinct change rather than a smooth curve.Cả khối thinking và text đều xuất hiện. Token suy nghĩ được tính là token đầu ra, nên hãy tính cả chúng khi ước lượng chi phí. Hướng dẫn chuyển đổi Claude Fable 5.2 nêu rằng budget_tokens, thinking disabled, temperature, top_p, và top_k trả về lỗi 400.
Tạo bộ dữ liệu làm nguội không rò rỉ dữ liệu
Dữ liệu phải đủ lộn xộn để cần khớp mô hình, và đáp án phải nằm ngoài tầm với của Claude.
Mô phỏng ba lần chạy làm nguội
Tôi mô phỏng ba lần chạy theo định luật Newton với một thay đổi liên tục ẩn trong quá trình làm nguội. Lần chạy A bắt đầu ở 80 °C trong phòng 21,0 °C, B ở 95 °C trong 24,0 °C, và C ở 110 °C trong 22,5 °C. Một bộ sinh số ngẫu nhiên NumPy cố định thêm nhiễu Gaussian, và một phép đo được cố ý thêm sai số.
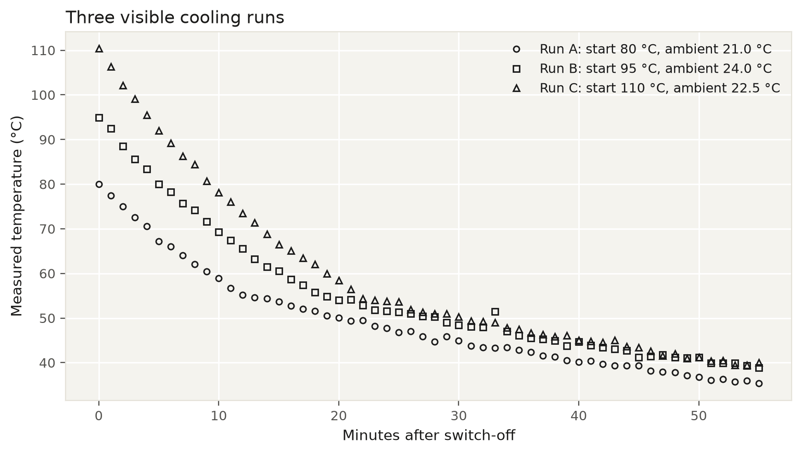
Ba lần chạy nhiễu gồm một ngoại lệ. Ảnh: Tác giả.
Lần chạy A nguội nhanh hơn lúc đầu so với về sau. Mẫu hình đó tự nó không cho thấy một thay đổi rời rạc vì bất kỳ hàm mũ nào cũng chậm lại gần nhiệt độ phòng.
Lần chạy B có một bước nhảy riêng lẻ khoảng 4 °C, trong khi các khoảng cách lân cận nơi khác đều dưới 1,2 °C. Mỗi khúc cong trải qua vài phút nhiễu, nên quan sát trực quan không thể tách mô hình theo thời gian và theo ngưỡng.
Kiểm định giả thuyết làm nguội bằng các công cụ Python
Python khớp từng ứng viên làm nguội theo cùng quy tắc và trả về tham số cùng lỗi. Claude không bao giờ thấy mã khớp, chỉ thấy những gì mỗi công cụ trả về.
Khớp tham số chung mà không để một ngoại lệ lấn át
Khớp nghĩa là chọn giá trị tham số để giữ mỗi đường cong dự đoán gần các phép đo của nó. Tôi dùng tổn thất L1 mềm vì nó giảm ảnh hưởng của một lỗi lớn mà không xóa phép đo đó.
Mọi lần chạy chia sẻ các tham số đã khớp, trong khi mỗi lần chạy giữ nhiệt độ bắt đầu và nhiệt độ phòng riêng. Với mô hình ngưỡng, điều đó cho mỗi lần chạy một thời điểm chuyển riêng, ln((T0 - Ta) / (threshold - Ta)) / k_above.
SciPy least_squares() tìm bộ tham số khớp tốt nhất, đồng thời ràng buộc tham số giữ các tốc độ và điểm chuyển trong khoảng đã cố định trước khi chạy.
Đoạn trích dưới đây cho thấy lời gọi bộ giải và kiểm tra hội tụ. Hàm phần dư và quét lưới xung quanh nằm trong kho mã.
from scipy.optimize import least_squares
def _solve(hypothesis, names, x0, lo, hi, runs):
# soft L1: residuals under f_scale count roughly squared, larger ones roughly linearly
return least_squares(_residuals, x0, bounds=(lo, hi), method="trf",
loss="soft_l1", f_scale=0.5, args=(hypothesis, names, runs))
# scan the change point in 0.5 steps with the rates fitted at each step, then refine all three
res = _solve(hypothesis, names, best_grid_point, lo, hi, runs)
converged = bool(res.success and res.status > 0 and np.all(np.isfinite(res.x)))
at_bound = [n for n, v, a, b in zip(names, res.x, lo, hi) if min(v - a, b - v) < 1e-4 * (b - a)]Tôi đặt f_scale là 0,5 °C trước khi chạy. Các phần dư lớn hơn ngưỡng đó bắt đầu giảm ảnh hưởng dưới L1 mềm. Quét lưới quanh điểm chuyển giúp bộ giải có giá trị khởi đầu hợp lý.
Xác thực mô hình bằng kiểm tra bỏ-một-lần-chạy
MAE là độ lệch trung bình theo °C. RMSE bình phương lỗi trước, nên lỗi lớn tính nặng hơn.
Lỗi huấn luyện thiên về mô hình có nhiều tham số hơn. Cross-validation ước lượng lỗi giữ lại bằng cách luân phiên loại trừ dữ liệu. Ở đây, xác thực bỏ-một-lần-chạy (LORO) khớp trên hai lần chạy và dự đoán lần thứ ba.
Định nghĩa schema gọi công cụ của Claude
Schema công cụ là mô tả JSON của một hàm Python và các tham số Claude có thể gửi. Strict tool use khiến API kiểm tra hình dạng đó trước khi Python chạy hàm.
Claude có thể yêu cầu bốn công cụ:
-
inspect_runs: trả về các phép đo thấy được và tóm tắt độ dốc đơn giản. -
fit_hypothesis: khớp một mô hình làm nguội và trả về tham số cùng lỗi giữ lại. -
inspect_residuals: hiển thị nơi nhiệt độ quan sát lệch khỏi dự đoán của mô hình. -
compare_predictions: so sánh các mô hình đã khớp theo điều kiện thí nghiệm đề xuất.
compare_predictions giữ các phép đo xác nhận ngoài công cụ:
{"name": "compare_predictions", "strict": True,
"description": "Predict a new run from existing fits under proposed conditions and report how far the "
"predictions differ. initial_temp_c must be 75 to 115 and ambient_temp_c 20 to 25. "
"Returns predictions only; no new measurements are generated.",
"input_schema": {"type": "object", "additionalProperties": False,
"properties": {"initial_temp_c": {"type": "number"},
"ambient_temp_c": {"type": "number"},
"fit_ids": {"type": "array", "items": {"type": "string"}}},
"required": ["initial_temp_c", "ambient_temp_c", "fit_ids"]}}Các giá trị fit_ids tham chiếu những mô hình đã khớp trước đó trong cùng cuộc điều tra. Schema nghiêm ngặt không chấp nhận minimum hoặc maximum, nên Python tự kiểm tra khoảng nhiệt độ. Để tool_choice ở auto, vì ép dùng công cụ trả về lỗi 400 trên Fable 5.2.
Xây dựng vòng lặp công cụ Claude
Ứng dụng lặp lại một chu trình: gửi hội thoại tới Claude, chạy bất kỳ công cụ Python nào được yêu cầu, và trả lại kết quả của chúng. Tiếp tục cho tới khi hoàn tất so sánh cần thiết, rồi yêu cầu Claude gửi báo cáo cuối ở định dạng cố định.
Viết prompt cho kiểm định giả thuyết
System prompt mô tả phương pháp mà không gợi ý đáp án. Prompt lõi là:
SYSTEM = """You are a scientific investigator working on a controlled cooling experiment. You decide which
checks to run and how to read the results. Python tools do every numerical calculation.
How to work:
- Look at the measurements before you choose a model.
- Fit every candidate model with fit_hypothesis. Compare them on leave-one-run-out error as well as
training error, because a model with more parameters always fits the training runs at least as well.
- Use inspect_residuals to look for systematic patterns and to decide whether any single reading is
an outlier.
- Use only numbers that a tool returned. Do not invent measurements, parameters, or errors.
- Keep observed evidence separate from assumptions. The data can show which mathematical model fits
best; it cannot show the physical cause of a change.
- If the evidence does not separate the candidates, say so and treat the result as inconclusive.
..."""Tôi quan tâm nhất đến gạch đầu dòng cuối. Nếu không có nó, mô hình sẽ phải chọn người thắng ngay cả khi lỗi quá sít sao để phân định.
Giữ vòng lặp công cụ chỉ-bổ-sung
Mỗi lần gọi gửi cùng system và tools, và mỗi phản hồi được chuyển lại nguyên vẹn. Đoạn trích này cho thấy cách xử lý message; vòng lặp đầy đủ với xử lý dừng nằm trong kho mã.
resp = client.messages.create(
model="claude-fable-5-2",
max_tokens=20_000,
system=SYSTEM,
tools=TOOLS, # all four, declared on the first request
thinking={"type": "adaptive", "display": "summarized"},
output_config={"effort": "high"},
cache_control={"type": "ephemeral"}, # automatic prompt caching
messages=messages,
)
messages.append({"role": "assistant", "content": resp.content}) # unchanged, thinking included
if resp.stop_reason == "tool_use":
results = []
for block in resp.content:
if block.type == "tool_use":
out, is_error = box.run(block.name, dict(block.input))
results.append({"type": "tool_result", "tool_use_id": block.id,
"content": out, "is_error": is_error})
messages.append({"role": "user", "content": results})Preserved thinking cho phép Claude giữ lý luận trước đó qua nhiều lượt, miễn là system, tools, và các message trước đó giữ nguyên. Trên Fable 5.2, chỉnh sửa bất kỳ cái nào mặc định trả về lỗi 400.
Bạn có thể thay đổi output_config, tool_choice, và max_tokens giữa các lần gọi, dù định dạng đầu ra mới vẫn bỏ lỡ cache prompt. Gom kết quả công cụ chạy song song trong một message người dùng, như vòng lặp trên làm.
Đặt giới hạn cho số yêu cầu, thời gian và chi phí
Python đếm số yêu cầu, số lần gọi công cụ, thời gian trôi qua và chi phí, và sẽ không bắt đầu công việc mới khi đạt giới hạn. Một yêu cầu đang chạy vẫn có thể vượt quá giới hạn thời gian hoặc chi phí, nên hãy coi hai giới hạn này là mềm.
Trước khi chấp nhận câu trả lời cuối, Python cũng kiểm tra rằng Claude đã khớp mọi ứng viên, kiểm tra phần dư, và so sánh các thiết kế xác nhận. Nếu Claude dừng vì bất cứ lý do nào ngoài yêu cầu công cụ hoặc hoàn tất lượt, cuộc điều tra kết thúc là chưa ngã ngũ. Đặt max_tokens đủ cao cho cả suy nghĩ và câu trả lời.
Trả về báo cáo có cấu trúc
Khi các kiểm tra đạt, một yêu cầu nữa yêu cầu đầu ra có cấu trúc trên cùng lịch sử, để báo cáo cuối đến dưới dạng một đối tượng Python đã được xác thực:
messages.append({"role": "user", "content": REPORT_PROMPT})
resp = client.messages.parse(
model="claude-fable-5-2", max_tokens=20_000, system=SYSTEM, tools=TOOLS,
thinking={"type": "adaptive", "display": "summarized"},
output_config={"effort": "high"},
output_format=InvestigationReport, # the SDK sends this as output_config.format
tool_choice={"type": "none"}, # tools stay declared, so the prefix check passes
messages=messages,
)
problems = validate(resp.parsed_output, box.fits) # fit IDs exist, all four covered, ranges holdPydantic kiểm tra hình dạng báo cáo, và validate() xác nhận mọi lần khớp được trích dẫn đều tồn tại và các điều kiện nằm trong khoảng cho phép. Sau đó, lựa chọn mô hình và điều kiện là cuối cùng.
Fable 5.2 chọn mô hình ngưỡng nhiệt độ
Tôi chạy một cuộc điều tra ở mức nỗ lực high. Đây là cách Claude đi đến câu trả lời.
Lần theo chuỗi kiểm tra của Claude
Claude bắt đầu bằng cách xem xét các phép đo. Trước khi khớp bất cứ thứ gì, tóm tắt của nó là: "Sự thay đổi xuất hiện khoảng 55 °C trong mọi lần chạy: phút 12 ở A, phút 19 ở B, và phút 22 ở C. Điều đó chỉ ra một ngưỡng, nên tôi sẽ khớp cả bốn."
Tôi gọi đó là sự neo bám: Claude cam kết câu trả lời trước khi kiểm định. Kết quả khớp sau đó đồng ý, với các điểm chuyển gần phút 12, 18 và 22. Bản ghi terminal cho thấy thứ tự các kiểm tra còn lại.
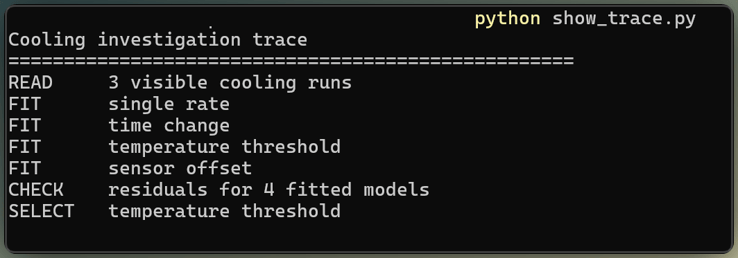
Bản ghi terminal cho thấy thứ tự kiểm tra của Claude. Ảnh: Tác giả.
So sánh lỗi giữ lại giữa bốn mô hình
RMSE huấn luyện đo mức khớp của từng mô hình trên cả ba lần chạy. Các cột giữ lại là trung bình của ba bài kiểm tra LORO.
|
Ứng viên |
Giả định chính |
RMSE huấn luyện (°C) |
MAE giữ lại (°C) |
RMSE giữ lại (°C) |
|
Một tốc độ |
Một tốc độ trong suốt quá trình |
4.08 |
3.90 |
4.60 |
|
Đổi theo thời gian |
Điểm chuyển chung gần phút 19 |
1.92 |
2.17 |
2.63 |
|
Ngưỡng nhiệt độ |
Điểm chuyển chung gần 55 °C |
0.49 |
0.32 |
0.48 |
|
Độ lệch cảm biến |
Độ trôi đo lường tăng dần |
1.49 |
1.45 |
1.87 |
Với mô hình ngưỡng, lỗi huấn luyện và giữ lại tương đối gần nhau, nên phép khớp chuyển tải tốt giữa các lần chạy, dù ba lần chạy không thể loại trừ việc quá khớp nói chung. Biểu đồ phần dư dưới đây cho thấy nhiệt độ quan sát trừ đi dự đoán của mỗi mô hình.
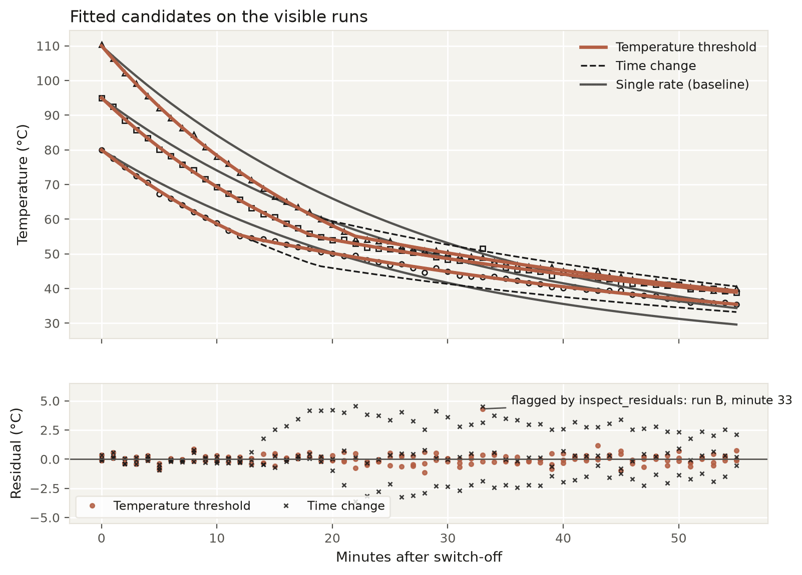
Phần dư của mô hình ngưỡng không cho thấy mẫu có hệ thống. Ảnh: Tác giả.
Khớp theo thời gian bám sát lần chạy B. Sau điểm chuyển, nó sai với lần chạy A khoảng +2,5 đến +3,5 °C và với lần chạy C khoảng -1,5 đến -2,8 °C.
Tôi thấy dấu đổi chiều hữu ích hơn xếp hạng đơn thuần: nó cho thấy điểm chuyển đến sớm hơn ở A và muộn hơn ở C, như một kích hoạt theo nhiệt độ dự đoán. Mô hình độ lệch cảm biến giảm bớt lỗi bằng cách thêm độ trôi, nhưng lỗi giữ lại vẫn lớn hơn.
Kiểm tra phép đo bị hỏng
Tác tử không biết phép đo nào tôi đã làm hỏng. Nó phát hiện lần chạy B, phút 33, với phần dư khoảng +4,3 °C. z-score bền vững của nó, đo khoảng cách so với độ phân tán phần dư điển hình, vượt 12.
Claude giữ lại phép đo đó, vì L1 mềm đã hạn chế lực kéo của nó. Để kiểm tra lựa chọn đó, tôi khớp lại cả bốn mô hình mà không có phép đo đó. Mô hình ngưỡng vẫn đứng đầu với cách biệt lớn, và ước lượng ngưỡng hầu như không đổi.
Thiết kế thí nghiệm xác nhận
Tác tử so sánh dự đoán ứng viên ở nhiều nhiệt độ bắt đầu và nhiệt độ phòng, rồi chọn điều kiện mà không thấy bất kỳ phép đo mới nào.
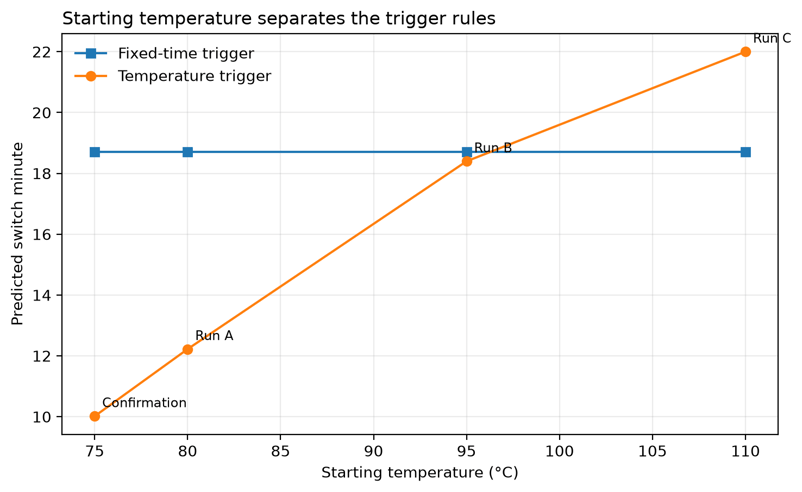
Nhiệt độ bắt đầu phơi bày từng quy tắc kích hoạt. Ảnh: Tác giả.
Chọn điều kiện tách bạch các mô hình
Như đã nêu trong phần tóm tắt, tác tử chọn bắt đầu ở 75 °C và phòng 20 °C. Mô hình ngưỡng chuyển gần phút 10, trong khi mô hình thời gian chuyển gần phút 19. Đường độ lệch cảm biến cũng tách biệt so với dự đoán ngưỡng.
Một thiết lập tầm trung gần lần chạy B chỉ tách mô hình ngưỡng và thời gian khoảng 0,6 °C. Điều kiện đã chọn hơi nằm ngoài khoảng đã thử, và Claude đánh dấu điều đó trong báo cáo.
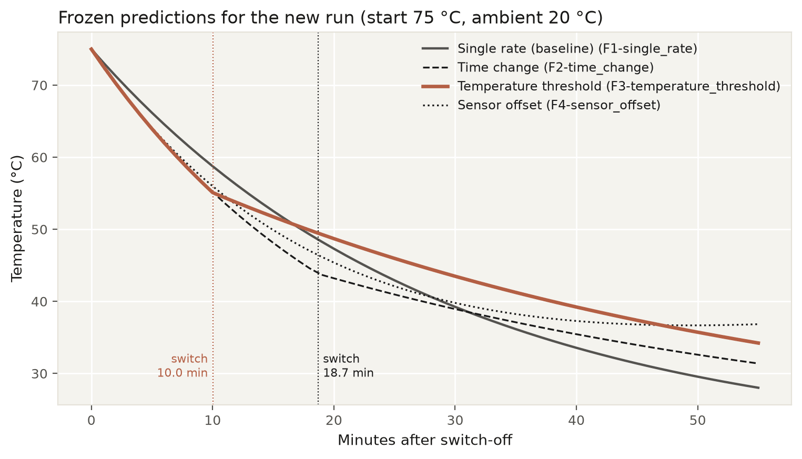
Các dự đoán ứng viên cho lần chạy đã chọn. Ảnh: Tác giả.
Khóa dự đoán trước khi tạo dữ liệu
Tôi khóa điều kiện đã chọn, tham số đã khớp, và dự đoán của mọi ứng viên trước khi tạo bất kỳ phép đo mới nào. Tác tử không nhận các phép đo xác nhận và không thể sửa câu trả lời sau khi biết kết quả.
Các phép đo xác nhận dùng cùng mô hình nhiễu Gaussian, một hạt giống cố định riêng, và không có ngoại lệ cài cắm.
Chấm điểm lần chạy chưa thấy
Mã Python độc lập chấm điểm các dự đoán đã đóng băng. Nó không bao giờ gọi API, nên Claude không tham gia tự chấm điểm câu trả lời của mình.
Chấm điểm dự đoán bằng Python độc lập
Dự đoán ngưỡng vượt cả hai bài kiểm tra đặt sẵn. Trên lần chạy chưa thấy, nó đạt 0,27 °C MAE và 0,32 °C RMSE. Thời gian cố định đạt 3,67 °C RMSE, độ lệch cảm biến 2,35 °C, và một tốc độ 4,28 °C.
Lần chạy xác nhận không có ngoại lệ cài cắm, giúp giải thích lỗi thấp hơn so với kết quả bỏ-một-lần-chạy. Một mẫu nhiễu ngẫu nhiên khác cũng có thể góp phần.
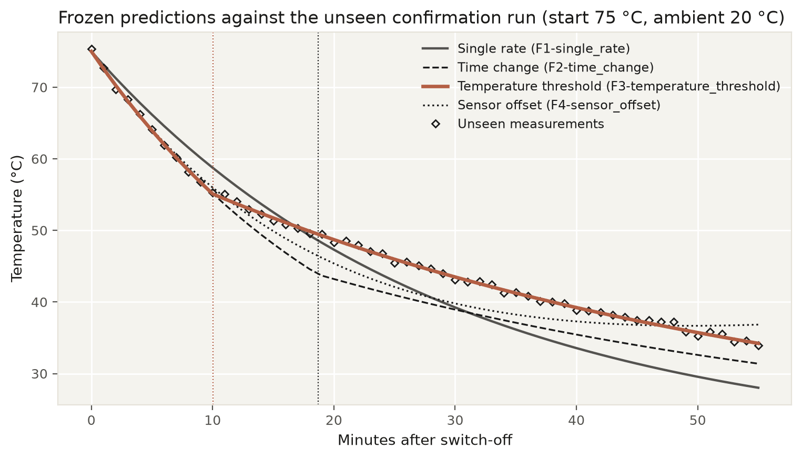
Dự đoán đóng băng khớp các phép đo chưa thấy. Ảnh: Tác giả.
So sánh tham số đã khớp với sự thật ẩn
Sau khi chấm điểm, so sánh các tham số đã khớp với giá trị sinh dữ liệu ẩn:
import numpy as np
def true_curve(t0, ta, minutes, truth):
"""Newton cooling whose rate drops when the temperature crosses a threshold. Continuous at the switch."""
t = np.asarray(minutes, dtype=float)
k1, k2, th = truth["k_above"], truth["k_below"], truth["threshold_c"]
if t0 <= th:
return ta + (t0 - ta) * np.exp(-k2 * t)
t_cross = np.log((t0 - ta) / (th - ta)) / k1
fast = ta + (t0 - ta) * np.exp(-k1 * t)
slow = ta + (th - ta) * np.exp(-k2 * (t - t_cross)) # restarts from the threshold
return np.where(t <= t_cross, fast, slow)Bộ mô phỏng thêm nhiễu Gaussian có hạt giống vào quanh đường cong này.
Quy tắc ẩn là ngưỡng nhiệt độ tại 55 °C, với tốc độ 0,045 và 0,020 mỗi phút và độ lệch chuẩn nhiễu 0,35 °C.
Các tốc độ đã khớp khớp tới ba chữ số thập phân, ngưỡng lệch trong 0,1 °C, và điểm chuyển dự đoán lệch trong 0,1 phút.
Dữ liệu xác định quy luật toán học mà bộ mô phỏng dùng. Chúng không thể cho biết liệu một thiết bị thật chậm lại gần 55 °C có liên quan đến chuyển pha, chu kỳ quạt hay nguyên nhân vật lý khác.
Xem lại cách tác tử đi đến câu trả lời
Báo cáo trích dẫn ID lần khớp và số công cụ làm bằng chứng, và nêu những điều ba lần chạy không thể thiết lập. Điểm yếu là phán đoán sớm tôi đã đề cập. Một cuộc điều tra đơn lẻ không cho thấy tần suất loại phán đoán đó sai.
Xem cuộc điều tra trên Streamlit
Trong video, tôi khởi động một lượt chạy trực tiếp, theo dõi log công cụ, và mở các tab Report, Curves, Confirmation, và Cost sau khi chấm điểm.
Giao diện Streamlit hiển thị một cuộc điều tra. Video: Tác giả.
Đo chi phí API Claude Fable 5.2
Cuộc điều tra, bao gồm cả báo cáo cuối, tốn khoảng $0,49 và chỉ hơn một phút. SciPy chạy trên máy của bạn, nên không cộng thêm gì vào hóa đơn API.
Yêu cầu báo cáo riêng lẻ đã chiếm gần nửa chi phí và thời gian. Như tôi đã đề cập trong phần vòng lặp công cụ, một định dạng đầu ra mới bỏ lỡ cache prompt, nên yêu cầu cuối đó xử lý lại toàn bộ hội thoại trước khi ghi một báo cáo dài. Hãy theo dõi riêng lẻ đầu vào không cache, ghi cache, đọc cache và đầu ra, vì mỗi loại có giá riêng.
Giới hạn và cân nhắc thực tiễn
Có hai loại giới hạn quan trọng: điều thí nghiệm có thể cho thấy, và điều mã cần trước khi chạy như một dịch vụ.
Giới hạn khoa học
Bộ mô phỏng và ứng viên ngưỡng dùng cùng phương trình. Một chuyển đổi dần dần trong thiết bị thật vẫn có thể khớp mô hình này trong khi đi theo đường cong khác.
Nếu quy luật thật bị thiếu, tác tử vẫn có thể chọn mô hình gần nhất trong số cung cấp thay vì trả lời inconclusive. Nhiễu nhiều hơn hoặc ngưỡng vừa đủ vượt qua có thể khiến lỗi quá giống nhau để phân tách. Một lượt chạy khác có thể dùng thứ tự công cụ khác.
Trước khi đưa vào sản xuất
Các giới hạn từ vòng lặp công cụ bao phủ một cuộc điều tra trên máy của bạn. Một dịch vụ sản xuất cần nhiều hơn:
- Đặt retry SDK và timeout yêu cầu cho dịch vụ.
- Xác thực mọi đầu vào và đầu ra của công cụ trong Python.
- Ghi log mô hình, phiên bản SDK, lý do dừng, token, độ trễ và chi phí cho mỗi yêu cầu.
- Ghim phiên bản mô hình và SDK, chạy lại bài kiểm tra ẩn, và xác nhận chính sách lưu giữ 30 ngày trước khi nâng cấp.
Khi mẫu hình này phù hợp
Hãy dùng mẫu này khi có vài cách giải thích phù hợp, Python có thể kiểm định chúng, và một thí nghiệm ẩn có thể chấm điểm lựa chọn, đặc biệt khi thí nghiệm tiếp theo đắt hơn cuộc gọi API.
Hãy dùng Python thuần khi bạn biết họ mô hình. Hướng dẫn mô hình Fable 5.2 của Anthropic khuyến nghị thử Opus trước và kiểm tra Fable khi Opus không đáp ứng yêu cầu.
Lời kết
Chúng ta đã xây dựng một tác tử so sánh bốn mô hình làm nguội, chọn ngưỡng nhiệt độ, thiết kế một lần chạy xác nhận, và dự đoán các phép đo mà nó chưa từng thấy. Với thiết bị tổng hợp này, câu trả lời cho câu hỏi mở đầu của tôi là có.
Tôi sẽ không mở rộng điều đó sang thiết bị thật hoặc khám phá mở. Như tôi đã đề cập trong phần giới hạn, các ứng viên bao gồm chính phương trình của bộ mô phỏng, và tôi chạy tác tử một lần.
Điều có thể chuyển giao là phương pháp: giấu sự thật, đặt quy tắc chấm điểm trước yêu cầu đầu tiên, đóng băng dự đoán, và dùng bộ đánh giá riêng. Bài kiểm tra tiếp theo hữu ích sẽ thêm một mô hình chuyển tiếp dần dần và lặp lại cuộc điều tra ở các mức nhiễu khác nhau.
Về chọn mô hình, khóa học Giới thiệu về các mô hình Claude của chúng tôi bao quát danh mục Claude và các đánh đổi của nó.
Câu hỏi thường gặp
Tôi có thể tắt suy nghĩ hoặc đặt ngân sách suy nghĩ trên Claude Fable 5.2 không?
Không. Suy nghĩ thích ứng luôn bật, và cả thinking: {type: "disabled"} lẫn budget_tokens đều trả về lỗi 400. Thay vào đó, hãy kiểm soát mức suy nghĩ bằng tham số effort, mặc định là high. Token suy nghĩ được tính phí như đầu ra và tính vào max_tokens.
Vì sao Claude Fable 5.2 trả về lỗi 400 sau khi tôi chỉnh sửa các message trước đó?
Mỗi khối suy nghĩ chỉ hợp lệ so với system prompt, công cụ và các message đi trước nó, và Fable 5.2 kiểm tra điều này trên mọi tài khoản. Hãy giữ hội thoại ở dạng chỉ-bổ-sung và đóng băng system và tools cho phiên làm việc. Như một biện pháp tạm, đặt prefix_mismatch_behavior thành "drop_block" với header beta sẽ loại bỏ các khối bị ảnh hưởng thay vì lỗi.
Tôi có thể ép Claude Fable 5.2 gọi một công cụ cụ thể không?
Không. Đặt tool_choice thành any hoặc một công cụ được đặt tên sẽ trả về lỗi 400; chỉ auto và none là hoạt động. Hãy nêu tên công cụ trong hướng dẫn của bạn và đặt strict: true để lời gọi khớp schema của bạn. Nếu lời gọi là bắt buộc, hãy dùng một system message giữa hội thoại.
Điều gì xảy ra khi Claude Fable 5.2 từ chối một yêu cầu?
Phản hồi trả về với stop_reason: "refusal", và stop_details.category cho bạn biết biện pháp bảo vệ nào được kích hoạt. Bạn có thể tự thử lại trên mô hình khác, hoặc chọn dự phòng phía máy chủ với fallbacks: "default", một tính năng beta sẽ thử lại trên Claude Opus 4.8 hoặc Claude Opus 5. Mô hình dự phòng không nhận các khối suy nghĩ của Fable 5.2.
Tôi có thể dùng Claude Fable 5.2 với chế độ không lưu giữ dữ liệu không?
Mặc định là không. Fable 5.2 yêu cầu lưu giữ dữ liệu 30 ngày, và các yêu cầu API từ tổ chức hoặc không gian làm việc không có điều này sẽ trả về lỗi 400. Theo thỏa thuận ZDR, hãy bật lưu giữ 30 ngày cho một không gian làm việc hoặc liên hệ nhóm phụ trách tài khoản Anthropic của bạn.
Batch API có thể thay thế vòng lặp công cụ trong thí nghiệm này không?
Không. Mỗi bước công cụ cần phản hồi trước đó, vì vậy Batch API không thể thay thế trực tiếp vòng lặp này. Mức giảm 50% của nó phù hợp cho các yêu cầu độc lập hoặc đánh giá song song.

Tôi là một kỹ sư dữ liệu và người xây dựng cộng đồng, làm việc với pipeline dữ liệu, đám mây và công cụ AI, đồng thời viết các hướng dẫn thực hành, tác động cao cho DataCamp và các nhà phát triển mới nổi.


LLM giỏi trong việc khiến câu trả lời nghe có vẻ như đã được suy luận kỹ càng. Việc chúng thực sự suy luận hay không thì khó kiểm chứng hơn. Trong đa số tác vụ, mô hình hoặc đã từng thấy thứ gì đó tương tự câu trả lời trước đây, hoặc không ai có thể xác minh câu trả lời cả. Vì vậy, tôi xây dựng một phép thử trong đó đáp án được giữ kín.
Claude Fable 5.2 nhận các số đo nhiễu từ một thiết bị mô phỏng bắt đầu nguội dần sau khi tắt, kèm 4 cách giải thích có thể vì sao tốc độ làm nguội chậm lại giữa chừng. Nó phải chọn một, thiết kế thí nghiệm tiếp theo, và cam kết một dự đoán trước khi nhìn thấy bất kỳ phép đo mới nào. Mã Python riêng biệt sau đó chấm điểm dự đoán, và Claude không hề đụng vào nó.
Thiết bị làm nguội chỉ là trường hợp thử. Điều quan trọng là cách thiết lập: giấu sự thật khỏi mô hình, cố định quy tắc chấm điểm trước cuộc gọi API đầu tiên, đóng băng dự đoán của nó, và chấm điểm bằng đoạn mã nó không thể nhìn thấy. Bạn có thể tái sử dụng cho mọi bài toán “cách giải thích nào đúng?”, từ phân tích nguyên nhân gốc rễ đến đọc kết quả A/B test.
Trong hướng dẫn này, bạn sẽ xây dựng tác tử đó bằng Python. SciPy làm phần tính toán; Claude quyết định nên chạy kiểm tra nào tiếp theo và kết luận ra sao. Nếu bạn quen với hàm Python và yêu cầu API, bạn có thể theo dõi, và tôi sẽ giải thích toán làm nguội khi nó xuất hiện lần đầu. Chúng ta sẽ đề cập cách:
Tổng quan Claude Fable 5.2 của chúng tôi đề cập đến ra mắt và benchmark, nên ở đây tôi tập trung vào API và phép thử làm nguội. Tôi chạy thí nghiệm vào ngày hôm sau khi ra mắt.
Tóm tắt
Tôi đưa cho Fable 5.2 dữ liệu nhiễu từ một thiết bị mô phỏng có tốc độ làm nguội chậm lại giữa chừng, kèm bốn cách giải thích có thể. Nó phải chọn một, thiết kế thí nghiệm mới, và dự đoán kết quả trước khi thấy nó.