

Progetta l’esperimento e l’harness
La mia implementazione abbina Claude a quattro funzioni Python, chiamate strumenti, che mostrerò dopo il dataset. Il codice completo e l’interfaccia Streamlit opzionale sono nel repository GitHub.
Definisci i quattro modelli di raffreddamento
La legge di raffreddamento di Newton afferma che un oggetto si raffredda più velocemente quando è molto più caldo dell’ambiente, poi rallenta man mano che il divario di temperatura si riduce. L’equazione è T(t) = Ta + (T0 - Ta) * exp(-k * t). Qui T0 è la temperatura iniziale, Ta è la temperatura ambiente e k è la velocità di raffreddamento per minuto.
Ho scritto quattro famiglie di modelli tra cui l’agente può scegliere:
-
Tasso unico: un solo
kper tutta la durata, usato come baseline -
Cambio nel tempo: due tassi, con switch allo stesso minuto trascorso in ogni run
-
Soglia di temperatura: due tassi, con switch a una temperatura condivisa, quindi a minuti diversi in ciascuna run
-
Offset del sensore: un tasso reale, più un errore della sonda che inizia a metà e cresce
Separa le misurazioni visibili dalla verità nascosta
Claude vede tre serie di raffreddamento e tutto ciò che restituiscono gli strumenti. I tassi reali, la soglia, le impostazioni dei dati e le misure di conferma restano fuori dalla sua portata tramite strumenti.
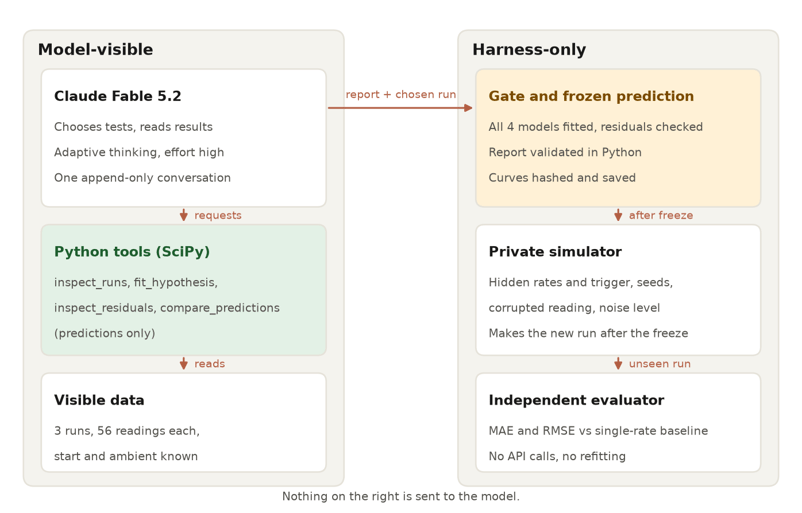
Claude accede agli strumenti; la verità resta nascosta. Immagine dell’autore.
Tutto ciò che in Python circonda Claude costituisce l’agent harness. Oltre a eseguire gli strumenti, impone limiti a richieste, tempo e spesa, come vedrai con il loop degli strumenti.
Prima della prima chiamata API, ho fissato i modelli candidati, i bound dei parametri, i limiti e la regola di superamento per il nuovo esperimento: una RMSE di al massimo 1,0 °C e non più della metà della baseline a tasso unico. Queste regole sono rimaste fisse.
Configura Claude Fable 5.2 in Python
La configurazione richiede un ambiente virtuale e una chiave API. Il modello claude-fable-5-2 può leggere fino a 1M token di prompt e cronologia della conversazione, quindi restituire fino a 128K token di output.
Il ragionamento adattivo, in cui il modello decide quanto ragionare prima di rispondere, è sempre attivo e l’API predefinisce un impegno alto. I prezzi dell’API Claude sono di 8 $ per milione di token in input e 40 $ per milione di token in output, con scritture nella prompt cache di cinque minuti a 10 $ e letture cache a 0,20 $.
Ti servono:
-
Python 3.12+, perché NumPy 2.5.4 e SciPy 1.18.1 lo richiedono (il pacchetto Anthropic in sé supporta la 3.10)
-
Una chiave API con accesso a
claude-fable-5-2 -
anthropic2.7.0, la release che ha aggiunto l’ID del modello
Clona il progetto e installa le dipendenze bloccate. Su macOS o Linux, crea l’ambiente con python3.12 -m venv .venv, attivalo con source .venv/bin/activate e sostituisci Copy-Item con cp.
git clone https://github.com/KhalidAbdelaty/claude-fable-5-2-api.git
cd claude-fable-5-2-api
py -3.12 -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env # then paste your key after ANTHROPIC_API_KEY=Il codice carica la chiave API dall’ambiente senza stamparla. Il README del repository elenca i comandi per l’esperimento completo, e solo due di essi chiamano l’API. La nostra guida all’API di Claude copre in generale chiavi e fatturazione.
Fai la tua prima richiesta all’API Fable 5.2
Salta questa sezione se hai già chiamato Claude da Python. Questa richiesta si concentra sull’evidenza che separa le due ipotesi.
import anthropic
from dotenv import load_dotenv
load_dotenv(".env", override=True)
client = anthropic.Anthropic() # reads ANTHROPIC_API_KEY
response = client.messages.create(
model="claude-fable-5-2",
max_tokens=4096,
output_config={"effort": "high"},
messages=[{"role": "user", "content": (
"Three cooling runs start at 80, 95, and 110 C. Each seems to slow down partway through. "
"In three short bullets: what pattern across the runs would point to a change after a fixed "
"time, what pattern would point to a change at a fixed temperature, and what the data alone "
"cannot tell us.")}],
)
print("block types:", [block.type for block in response.content])
print("stop reason:", response.stop_reason)
print("".join(block.text for block in response.content if block.type == "text"))Claude restituisce un elenco di blocchi di contenuto tipizzati, quindi leggi il testo per tipo di blocco; content[0] può essere un blocco di thinking. Ecco la prima risposta:
block types: ['thinking', 'text']
stop reason: end_turn
- **Fixed time:** the slowdown appears at the same elapsed time in all three runs but at different temperatures, with the hotter-start runs still hotter when it happens.
- **Fixed temperature:** the slowdown appears at the same temperature in all three runs but at different elapsed times, with the hotter-start runs reaching it later.
- **What the data cannot tell us:** the cause. A matching pattern shows what the change tracks, not why it happens (for example a phase change, a setup artifact, or a shift in the surroundings). Since cooling naturally slows as it nears room temperature, the data also cannot show on its own that there is a distinct change rather than a smooth curve.Sono apparsi sia blocchi di thinking sia di text. I token di thinking contano come token di output, quindi includili quando stimi il costo. La guida alla migrazione di Claude Fable 5.2 afferma che budget_tokens, thinking disabled, temperature, top_p e top_k restituiscono un errore 400.
Crea un dataset di raffreddamento senza leakage
I dati devono essere abbastanza disordinati da richiedere il fitting di un modello, e la risposta deve restare fuori dalla portata di Claude.
Simula tre run di raffreddamento
Ho simulato tre run dalla legge di Newton con un cambiamento continuo e nascosto nel raffreddamento. La run A parte da 80 °C in una stanza a 21,0 °C, la B da 95 °C a 24,0 °C e la C da 110 °C a 22,5 °C. Un generatore di numeri casuali di NumPy fisso aggiunge rumore gaussiano, e una lettura riceve intenzionalmente un errore extra.
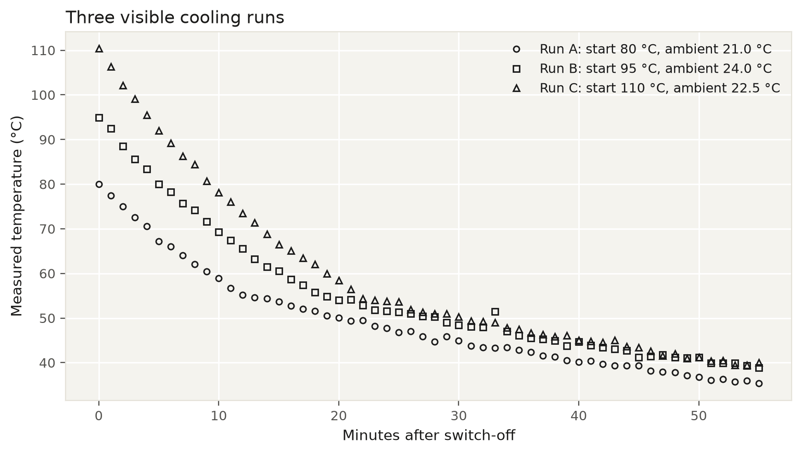
Tre run rumorose includono un outlier. Immagine dell’autore.
La run A si raffredda più velocemente all’inizio che alla fine. Questo pattern da solo non mostra un cambiamento discreto perché qualsiasi esponenziale rallenta vicino alla temperatura ambiente.
La run B contiene un salto isolato di circa 4 °C, mentre i gap vicini altrove restano sotto 1,2 °C. Ogni flessione si estende su diversi minuti rumorosi, quindi l’ispezione visiva non può separare i modelli a tempo e a soglia.
Metti alla prova le ipotesi di raffreddamento con strumenti Python
Python adatta ciascun candidato di raffreddamento con le stesse regole e restituisce i suoi parametri e gli errori. Claude non vede mai il codice di fitting, solo ciò che restituisce ogni strumento.
Adatta parametri condivisi senza che un outlier domini
Il fitting significa scegliere valori dei parametri che mantengano ciascuna curva prevista vicina alle sue misurazioni. Uso la loss L1 morbida perché riduce l’influenza di un errore grande senza eliminare quella lettura.
Tutte le run condividono i parametri adattati, mentre ciascuna run mantiene la propria temperatura iniziale e ambientale. Per il modello a soglia, questo dà a ogni run il proprio tempo di switch, ln((T0 - Ta) / (threshold - Ta)) / k_above.
La funzione least_squares() di SciPy cerca i parametri con miglior fitting, mentre i bound dei parametri mantengono tassi e punti di switch entro gli intervalli fissati prima della run.
L’estratto sotto mostra la chiamata al solver e i controlli di convergenza. La funzione dei residui e la scansione a griglia attorno a essa sono nel repository.
from scipy.optimize import least_squares
def _solve(hypothesis, names, x0, lo, hi, runs):
# soft L1: residuals under f_scale count roughly squared, larger ones roughly linearly
return least_squares(_residuals, x0, bounds=(lo, hi), method="trf",
loss="soft_l1", f_scale=0.5, args=(hypothesis, names, runs))
# scan the change point in 0.5 steps with the rates fitted at each step, then refine all three
res = _solve(hypothesis, names, best_grid_point, lo, hi, runs)
converged = bool(res.success and res.status > 0 and np.all(np.isfinite(res.x)))
at_bound = [n for n, v, a, b in zip(names, res.x, lo, hi) if min(v - a, b - v) < 1e-4 * (b - a)]Ho impostato f_scale a 0,5 °C prima della run. I residui più grandi di tale valore iniziano a perdere influenza sotto la L1 morbida. Una scansione a griglia sul punto di switch fornisce al solver un valore iniziale sensato.
Convalida i modelli con test leave-one-run-out
La MAE è l’errore medio in °C. La RMSE eleva prima al quadrato gli errori, quindi quelli più grandi contano di più.
L’errore di training favorisce i modelli con più parametri. La cross-validazione stima l’errore sui dati esclusi ruotando i dati esclusi. Qui, la validazione leave-one-run-out (LORO) adatta su due run e predice la terza.
Definisci gli schemi di chiamata degli strumenti di Claude
Uno schema di strumento è una descrizione JSON di una funzione Python e degli argomenti che Claude può inviare. L’uso rigoroso degli strumenti fa sì che l’API verifichi quella forma prima che Python esegua la funzione.
Claude può richiedere quattro strumenti:
-
inspect_runs: restituisce le misurazioni visibili e semplici riepiloghi di pendenza. -
fit_hypothesis: adatta un modello di raffreddamento e restituisce i suoi parametri e gli errori su dati esclusi. -
inspect_residuals: mostra dove le temperature osservate differiscono dalle previsioni del modello. -
compare_predictions: confronta i modelli adattati nelle condizioni di esperimento proposte.
Lo schema di compare_predictions mantiene le misurazioni di conferma fuori dallo strumento:
{"name": "compare_predictions", "strict": True,
"description": "Predict a new run from existing fits under proposed conditions and report how far the "
"predictions differ. initial_temp_c must be 75 to 115 and ambient_temp_c 20 to 25. "
"Returns predictions only; no new measurements are generated.",
"input_schema": {"type": "object", "additionalProperties": False,
"properties": {"initial_temp_c": {"type": "number"},
"ambient_temp_c": {"type": "number"},
"fit_ids": {"type": "array", "items": {"type": "string"}}},
"required": ["initial_temp_c", "ambient_temp_c", "fit_ids"]}}I valori di fit_ids si riferiscono a modelli adattati in precedenza nella stessa indagine. Gli schemi rigorosi non accettano minimum o maximum, quindi Python verifica da sé gli intervalli di temperatura. Lascia tool_choice su auto, perché forzare uno strumento restituisce un errore 400 su Fable 5.2.
Costruisci il loop degli strumenti di Claude
L’applicazione ripete un ciclo: invia la conversazione a Claude, esegue gli strumenti Python richiesti e restituisce i loro risultati. Continua finché i confronti richiesti non sono completi, quindi chiede a Claude un report finale in un formato fisso.
Scrivi un prompt per il test di ipotesi
Il prompt di sistema descrive il metodo senza suggerire una risposta. Il prompt principale è:
SYSTEM = """You are a scientific investigator working on a controlled cooling experiment. You decide which
checks to run and how to read the results. Python tools do every numerical calculation.
How to work:
- Look at the measurements before you choose a model.
- Fit every candidate model with fit_hypothesis. Compare them on leave-one-run-out error as well as
training error, because a model with more parameters always fits the training runs at least as well.
- Use inspect_residuals to look for systematic patterns and to decide whether any single reading is
an outlier.
- Use only numbers that a tool returned. Do not invent measurements, parameters, or errors.
- Keep observed evidence separate from assumptions. The data can show which mathematical model fits
best; it cannot show the physical cause of a change.
- If the evidence does not separate the candidates, say so and treat the result as inconclusive.
..."""Mi interessa soprattutto l’ultimo punto. Senza di esso, il modello deve nominare un vincitore anche quando gli errori sono troppo vicini per decidere.
Mantieni il loop degli strumenti append-only
Ogni chiamata invia gli stessi system e tools e ogni risposta torna indietro invariata. Questo estratto mostra la gestione dei messaggi; il loop completo con la gestione dello stop è nel repository.
resp = client.messages.create(
model="claude-fable-5-2",
max_tokens=20_000,
system=SYSTEM,
tools=TOOLS, # all four, declared on the first request
thinking={"type": "adaptive", "display": "summarized"},
output_config={"effort": "high"},
cache_control={"type": "ephemeral"}, # automatic prompt caching
messages=messages,
)
messages.append({"role": "assistant", "content": resp.content}) # unchanged, thinking included
if resp.stop_reason == "tool_use":
results = []
for block in resp.content:
if block.type == "tool_use":
out, is_error = box.run(block.name, dict(block.input))
results.append({"type": "tool_result", "tool_use_id": block.id,
"content": out, "is_error": is_error})
messages.append({"role": "user", "content": results})Thinking preservato consente a Claude di mantenere il ragionamento precedente tra i turni, purché system, tools e i messaggi precedenti restino invariati. Su Fable 5.2, modificarne uno qualsiasi restituisce per impostazione predefinita un errore 400.
Puoi modificare output_config, tool_choice e max_tokens tra le chiamate, anche se un nuovo formato di output non sfrutterà comunque la prompt cache. Raggruppa i risultati degli strumenti in parallelo in un unico messaggio utente, come fa il loop sopra.
Imposta limiti su richieste, tempo e spesa
Python conta richieste, chiamate agli strumenti, tempo trascorso e spesa, e non avvierà nuovo lavoro una volta raggiunto un limite. Una richiesta già in esecuzione può comunque superare il limite di tempo o di spesa, quindi tratta questi due come limiti soft.
Prima di accettare una risposta finale, Python controlla anche che Claude abbia adattato ogni candidato, ispezionato i residui e confrontato i design di conferma. Se Claude si interrompe per qualsiasi motivo diverso da una richiesta di strumento o dalla fine di un turno, l’indagine termina come inconcludente. Imposta max_tokens abbastanza alto per il thinking più la risposta.
Restituisci un report strutturato
Una volta superati i controlli, un’altra richiesta chiede output strutturati sulla stessa cronologia, così il report finale arriva come oggetto Python validato:
messages.append({"role": "user", "content": REPORT_PROMPT})
resp = client.messages.parse(
model="claude-fable-5-2", max_tokens=20_000, system=SYSTEM, tools=TOOLS,
thinking={"type": "adaptive", "display": "summarized"},
output_config={"effort": "high"},
output_format=InvestigationReport, # the SDK sends this as output_config.format
tool_choice={"type": "none"}, # tools stay declared, so the prefix check passes
messages=messages,
)
problems = validate(resp.parsed_output, box.fits) # fit IDs exist, all four covered, ranges holdPydantic verifica la forma del report e validate() conferma che ogni fit citato esista e che le condizioni rientrino nell’intervallo consentito. Dopo di ciò, la scelta del modello e le condizioni sono definitive.
Fable 5.2 seleziona il modello a soglia di temperatura
Ho eseguito un’indagine con impegno high. Ecco come Claude è arrivato alla sua risposta.
Ripercorri la sequenza di test di Claude
Claude ha iniziato ispezionando le misurazioni. Prima di adattare qualcosa, il suo riepilogo diceva: "Il cambiamento si manifesta intorno a 55 °C in ogni run: al minuto 12 nella A, al minuto 19 nella B e al minuto 22 nella C. Questo indica una soglia, quindi adatterò tutti e quattro."
Lo chiamerei anchoring: Claude si è impegnato in una risposta prima di testarla. L’adattamento successivo ha concordato, con switch intorno ai minuti 12, 18 e 22. La traccia del terminale mostra l’ordine dei controlli rimanenti.
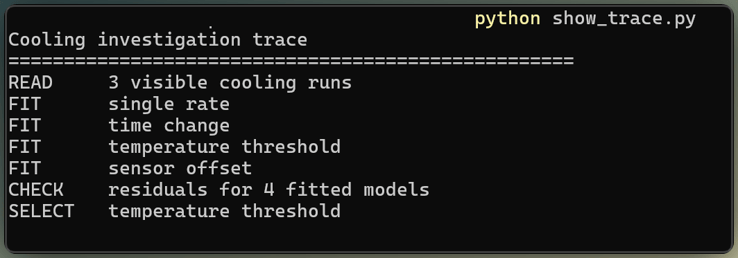
La traccia del terminale mostra l’ordine dei test di Claude. Immagine dell’autore.
Confronta gli errori su dati esclusi tra quattro modelli
La RMSE di training misura ciascun fit su tutte e tre le run. Le colonne su dati esclusi mediano i tre test LORO.
|
Candidato |
Assunzione principale |
RMSE train (°C) |
MAE su dati esclusi (°C) |
RMSE su dati esclusi (°C) |
|
Tasso unico |
Un tasso per tutta la durata |
4.08 |
3.90 |
4.60 |
|
Cambio nel tempo |
Switch condiviso intorno al minuto 19 |
1.92 |
2.17 |
2.63 |
|
Soglia di temperatura |
Switch condiviso intorno a 55 °C |
0.49 |
0.32 |
0.48 |
|
Offset del sensore |
Un drift di misurazione crescente |
1.49 |
1.45 |
1.87 |
Per il modello a soglia, gli errori di training e su dati esclusi sono vicini, quindi il fit si trasferisce da una run all’altra, anche se tre run non possono escludere in generale l’overfitting. Il grafico dei residui sotto mostra la temperatura osservata meno la previsione di ciascun modello.
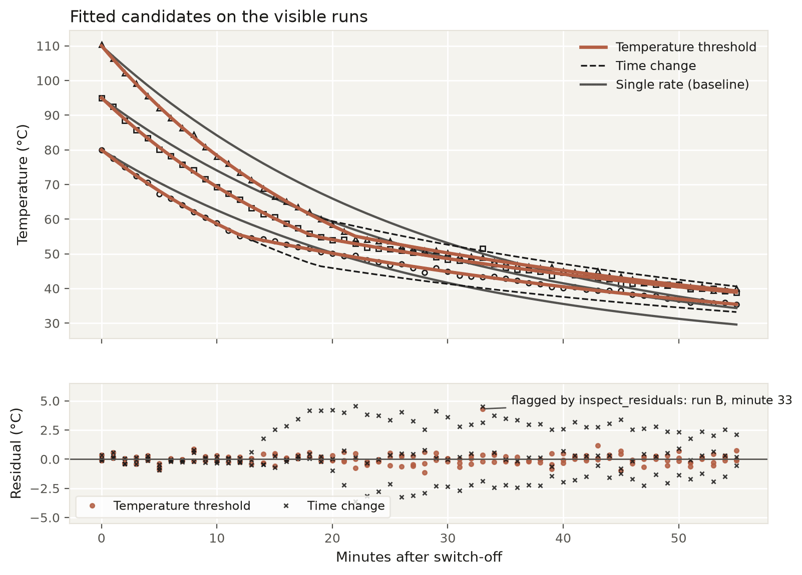
I residui del modello a soglia non mostrano schemi sistematici. Immagine dell’autore.
Il fit con cambio nel tempo corrisponde alla run B. Dopo il cambio, sbaglia la run A di circa +2,5 a +3,5 °C e la run C di -1,5 a -2,8 °C.
Trovo più utile il cambio di segno rispetto alla sola classifica: mostra che il cambio arriva prima in A e più tardi in C, come predice un trigger di temperatura. Il modello con offset del sensore riduce parte dell’errore aggiungendo drift, ma gli errori su dati esclusi restano maggiori.
Controlla la lettura corrotta
L’agente non sapeva quale lettura avessi corrotto. Ha trovato run B, minuto 33, con un residuo di circa +4,3 °C. Il suo z-score robusto, che mesura la distanza dalla tipica dispersione dei residui, era sopra 12.
Claude ha lasciato dentro la lettura, dato che la soft L1 già ne limita l’influenza. Per verificare questa scelta, ho rifittato tutti e quattro i modelli senza di essa. Il modello a soglia è rimasto primo con ampio margine e la sua stima della soglia è cambiata a malapena.
Progetta un esperimento di conferma
L’agente ha confrontato le previsioni dei candidati su diverse temperature iniziali e dell’ambiente, quindi ha scelto le condizioni senza vedere alcuna nuova misura.
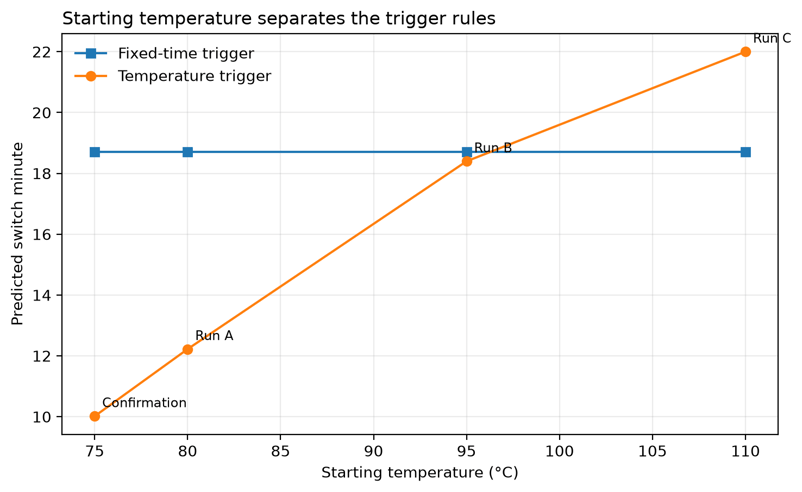
Le temperature iniziali mettono in evidenza ciascuna regola di attivazione. Immagine dell’autore.
Scegli condizioni che separino i modelli
Come notato nel TL;DR, l’agente ha scelto una partenza a 75 °C e una stanza a 20 °C. Il modello a soglia cambia intorno al minuto 10, mentre il modello a tempo cambia intorno al minuto 19. Anche la curva con offset del sensore rimane separata dalla previsione a soglia.
Un setup intermedio vicino alla run B separerebbe i modelli a soglia e a tempo di soli circa 0,6 °C. Le condizioni scelte si collocano leggermente al di fuori dell’intervallo testato, e Claude lo ha segnalato nel suo report.
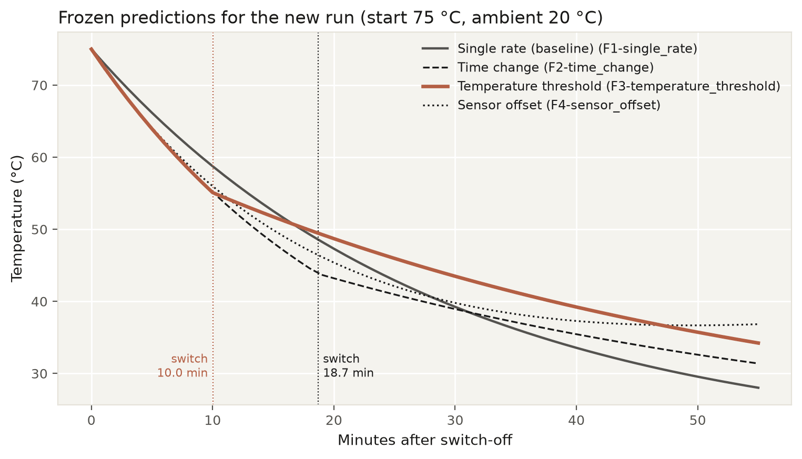
Previsioni dei candidati per la run scelta. Immagine dell’autore.
Blocca le previsioni prima di generare i dati
Ho bloccato condizioni scelte, parametri fittati e la previsione di ogni candidato prima di generare nuove misure. L’agente non ha ricevuto le misure di conferma e non poteva rivedere la sua risposta dopo l’esito.
Le misure di conferma usano lo stesso modello di rumore gaussiano, un seed fisso separato e nessun outlier aggiunto.
Valuta la run non vista
Codice Python separato ha valutato le previsioni congelate. Non chiama mai l’API, quindi Claude non partecipa alla valutazione della propria risposta.
Valuta le previsioni con Python indipendente
La previsione a soglia ha superato entrambi i test preimpostati. Sulla run non vista ha totalizzato 0,27 °C MAE e 0,32 °C RMSE. Tempo fisso ha totalizzato 3,67 °C RMSE, offset sensore 2,35 °C e singolo tasso 4,28 °C.
La run di conferma non contiene outlier inseriti, il che aiuta a spiegare il suo errore più basso rispetto ai risultati leave-one-run-out. Anche un diverso campione di rumore casuale può contribuire.
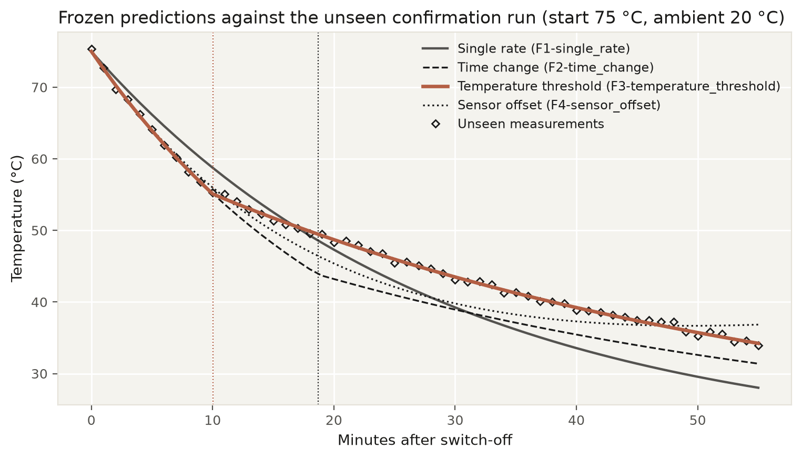
Le previsioni congelate corrispondono alle misure non viste. Immagine dell’autore.
Confronta i parametri fittati con la verità nascosta
Dopo la valutazione, confronta i parametri fittati con i valori generativi nascosti:
import numpy as np
def true_curve(t0, ta, minutes, truth):
"""Newton cooling whose rate drops when the temperature crosses a threshold. Continuous at the switch."""
t = np.asarray(minutes, dtype=float)
k1, k2, th = truth["k_above"], truth["k_below"], truth["threshold_c"]
if t0 <= th:
return ta + (t0 - ta) * np.exp(-k2 * t)
t_cross = np.log((t0 - ta) / (th - ta)) / k1
fast = ta + (t0 - ta) * np.exp(-k1 * t)
slow = ta + (th - ta) * np.exp(-k2 * (t - t_cross)) # restarts from the threshold
return np.where(t <= t_cross, fast, slow)Il simulatore aggiunge rumore gaussiano con seed attorno a questa curva.
La regola nascosta era una soglia di temperatura a 55 °C, con tassi di 0,045 e 0,020 al minuto e una deviazione standard del rumore di 0,35 °C.
I tassi fittati coincidono alle 3 cifre decimali, la soglia rientra entro 0,1 °C e il cambio previsto entro 0,1 minuti.
I dati identificano la regola matematica usata dal simulatore. Non possono mostrare se un dispositivo reale che rallenta vicino a 55 °C coinvolga un cambio di fase, un ciclo della ventola o un’altra causa fisica.
Rivedi come l’agente è arrivato alla sua risposta
Il report ha citato ID dei fit e numeri degli strumenti come prove, e ha indicato ciò che tre run non possono stabilire. Il punto debole è l’ipotesi precoce che ho menzionato. Una singola indagine non può mostrare quanto spesso quel tipo di ipotesi sbagli.
Guarda l’indagine in Streamlit
Nel video, avvio una run live, seguo il log dello strumento e apro le schede Report, Curve, Conferma e Costo dopo la valutazione.
L’interfaccia Streamlit mostra un’indagine. Video dell’autore.
Misura il costo dell’API Claude Fable 5.2
L’indagine, report finale incluso, è costata circa $0,49 e ha impiegato poco più di un minuto. SciPy gira sulla tua macchina, quindi non aggiunge nulla al conto dell’API.
La sola richiesta del report ha assorbito quasi metà del costo e del tempo. Come ho menzionato nella sezione sul loop degli strumenti, un nuovo formato di output non sfrutta la cache del prompt, quindi quell’ultima richiesta ha rielaborato di nuovo l’intera conversazione prima di scrivere un report lungo. Tieni traccia separatamente di input non in cache, scritture in cache, letture in cache e output, dato che ciascuno ha il proprio prezzo.
Limiti e considerazioni pratiche
Qui contano due tipi di limiti: cosa può mostrare l’esperimento e cosa serve al codice prima di girare come servizio.
Limiti scientifici
Il simulatore e il candidato a soglia usano la stessa equazione. Un cambio graduale in un dispositivo reale potrebbe comunque adattarsi a questo modello seguendo però una curva diversa.
Se mancasse la regola vera, l’agente potrebbe comunque scegliere il modello fornito più vicino invece di rispondere inconclusive. Più rumore o una soglia a malapena superata potrebbero rendere gli errori troppo simili per separarli. Un’altra run potrebbe seguire un ordine di strumenti diverso.
Prima della produzione
I limiti del loop degli strumenti coprono una singola indagine sulla tua macchina. Un servizio in produzione richiede altro:
- Imposta retry dell’SDK e timeout delle richieste per il servizio.
- Convalida ogni input e output degli strumenti in Python.
- Logga modello, versione dell’SDK, motivo di stop, token, latenza e costo per ogni richiesta.
- Blocca versioni di modello e SDK, riesegui il test nascosto e conferma la policy di retention a 30 giorni prima di un aggiornamento.
Quando questo pattern è adatto
Usa questo pattern quando più spiegazioni si adattano, Python può testarle e un esperimento nascosto può valutare la scelta, soprattutto quando il prossimo esperimento costa più della chiamata API.
Usa Python semplice quando conosci la famiglia di modelli. Le linee guida per il modello Fable 5.2 di Anthropic raccomandano di provare prima Opus e testare Fable quando Opus non soddisfa il requisito.
Considerazioni finali
Abbiamo costruito un agente che ha confrontato quattro modelli di raffreddamento, ha scelto una soglia di temperatura, ha progettato una run di conferma e ha previsto misure che non aveva mai visto. Per questo dispositivo sintetico, la risposta alla mia domanda iniziale è sì.
Non estenderei questo a dispositivi reali o alla scoperta open-ended. Come ho spiegato nei limiti, tra i candidati c’era l’equazione stessa del simulatore e ho eseguito l’agente una sola volta.
Ciò che si trasferisce è il metodo: nascondi la verità, imposta le regole di valutazione prima della prima richiesta, congela le previsioni e usa un valutatore separato. Un prossimo test utile aggiungerebbe un modello a transizione graduale e ripeterebbe l’indagine su diversi livelli di rumore.
Per la selezione del modello, il nostro corso Introduzione ai modelli Claude copre la lineup Claude e i relativi trade-off.
DOMANDE FREQUENTI
Posso disattivare il thinking o impostare un budget di thinking su Claude Fable 5.2?
No. Il pensiero adattivo è sempre attivo, e sia thinking: {type: "disabled"} sia budget_tokens restituiscono un errore 400. Controlla quanto pensa con il parametro effort, che per impostazione predefinita è high. I token di thinking sono fatturati come output e contano ai fini di max_tokens.
Perché Claude Fable 5.2 restituisce un errore 400 dopo che modifico messaggi precedenti?
Ogni blocco di thinking è valido solo rispetto al prompt di sistema, agli strumenti e ai messaggi che lo precedono, e Fable 5.2 lo verifica su ogni account. Mantieni la conversazione in sola append e blocca system e tools per la sessione. Come soluzione temporanea, impostare prefix_mismatch_behavior su "drop_block" con l’header beta fa sì che i blocchi interessati vengano scartati invece di generare un errore.
Posso forzare Claude Fable 5.2 a chiamare uno strumento specifico?
No. Impostare tool_choice su any o su uno strumento nominato restituisce un errore 400; funzionano solo auto e none. Nomina lo strumento nella tua istruzione e imposta strict: true affinché la chiamata corrisponda allo schema. Se la chiamata è obbligatoria, usa un messaggio di sistema a metà conversazione.
Cosa succede quando Claude Fable 5.2 rifiuta una richiesta?
La risposta torna con stop_reason: "refusal", e stop_details.category ti dice quale salvaguardia è stata attivata. Puoi riprovare personalmente su un altro modello, oppure optare per il fallback lato server con fallbacks: "default", una beta che riprova su Claude Opus 4.8 o Claude Opus 5. Il modello di fallback non riceve i blocchi di thinking di Fable 5.2.
Posso usare Claude Fable 5.2 con zero data retention?
Non per impostazione predefinita. Fable 5.2 richiede una retention dei dati di 30 giorni, e le richieste API provenienti da un’organizzazione o workspace senza di essa restituiscono un errore 400. In un accordo ZDR, abilita la retention a 30 giorni per un workspace o contatta il tuo team account di Anthropic.
La Batch API può sostituire il loop degli strumenti di questo esperimento?
No. Ogni step dello strumento necessita della risposta precedente, quindi la Batch API non può sostituire direttamente questo loop. Il suo sconto del 50% è adatto a richieste indipendenti o valutazioni in parallelo.

Sono un data engineer e community builder: lavoro su pipeline dati, cloud e strumenti di AI, e scrivo tutorial pratici e ad alto impatto per DataCamp e per sviluppatori alle prime armi.





Gli LLM sono bravi a sembrare come se avessero ragionato fino a una risposta. Verificare se lo hanno fatto davvero è più difficile. Nella maggior parte dei casi, il modello o ha già visto qualcosa di simile alla risposta, oppure nessuno può verificarla. Quindi ho costruito un test in cui la risposta resta nascosta.
Claude Fable 5.2 riceve letture rumorose da un dispositivo simulato che si raffredda dopo essere stato spento, più 4 possibili spiegazioni del perché il raffreddamento rallenti a metà. Deve sceglierne una, progettare un esperimento di follow-up e impegnarsi su una previsione prima di vedere anche una sola nuova misurazione. Un codice Python separato poi valuta la previsione, e Claude non lo tocca mai.
Il dispositivo di raffreddamento è solo il caso di test. Ciò che rimane è l’impostazione: nascondere la verità al modello, fissare le regole di punteggio prima della prima chiamata API, congelare le sue previsioni e valutarle con codice che non può vedere. Puoi riutilizzarla per qualsiasi problema del tipo “qual è la spiegazione giusta?”, dall’analisi della causa radice alla lettura di un test A/B.
In questo tutorial, costruirai quell’agente in Python. SciPy fa i conti; Claude decide quale controllo eseguire dopo e cosa concludere. Se ti senti a tuo agio con le funzioni Python e le richieste API, puoi seguire il percorso, e spiego la matematica del raffreddamento quando compare per la prima volta. Vedremo come:
La nostra panoramica su Claude Fable 5.2 copre il lancio e i benchmark, quindi qui mi concentro sull’API e sul test di raffreddamento. Ho eseguito l’esperimento il giorno dopo il lancio.
TL;DR
Ho dato a Fable 5.2 dati rumorosi da un dispositivo simulato il cui raffreddamento rallenta a metà, più quattro possibili spiegazioni. Doveva sceglierne una, progettare un nuovo esperimento e prevederne il risultato prima di vederlo.