

Rancang Eksperimen dan Harness
Implementasi saya memasangkan Claude dengan empat fungsi Python, disebut alat (tools), yang akan saya tampilkan setelah dataset. Kode lengkap dan antarmuka Streamlit opsional ada di repositori GitHub.
Definisikan empat model pendinginan
Hukum pendinginan Newton menyatakan suatu objek mendingin lebih cepat saat jauh lebih panas daripada ruangan, lalu melambat ketika selisih suhu menyempit. Persamaannya adalah T(t) = Ta + (T0 - Ta) * exp(-k * t). Di sini, T0 adalah suhu awal, Ta adalah suhu ruangan, dan k adalah laju pendinginan per menit.
Saya menulis empat keluarga model untuk dipilih oleh agen:
-
Laju tunggal: satu
ksepanjang waktu, digunakan sebagai baseline -
Perubahan waktu: dua laju, berganti pada menit yang sama di setiap run
-
Ambang suhu: dua laju, berganti pada suhu bersama, sehingga pada menit berbeda di tiap run
-
Offset sensor: satu laju sebenarnya, plus galat probe yang mulai di tengah dan membesar
Pisahkan pengukuran terlihat dari kebenaran tersembunyi
Claude melihat tiga seri pendinginan dan apa pun yang dikembalikan alat. Laju sebenarnya, ambang, pengaturan data, dan pengukuran konfirmasi tetap berada di luar akses alatnya.
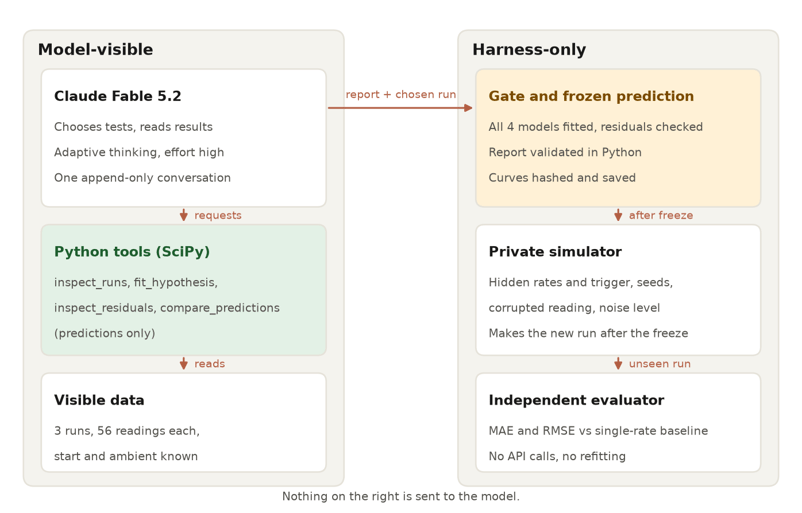
Claude mengakses alat; kebenaran tetap tersembunyi. Gambar oleh Penulis.
Segala sesuatu di Python di sekitar Claude membentuk agent harness. Selain menjalankan alat, ia membatasi permintaan, waktu, dan biaya, seperti yang akan saya bahas pada loop alat.
Sebelum panggilan API pertama, saya tetapkan kandidat model, batas parameter, limit, dan aturan lolos untuk eksperimen baru: RMSE paling tinggi 1,0 °C dan tidak lebih dari setengah baseline laju tunggal. Aturan-aturan itu tetap tetap.
Menyiapkan Claude Fable 5.2 di Python
Penyiapan memerlukan lingkungan virtual dan kunci API. Model claude-fable-5-2 dapat membaca hingga 1M token dari prompt dan riwayat percakapan, lalu mengembalikan hingga 128K token keluaran.
Pemikiran adaptif, di mana model memutuskan seberapa banyak bernalar sebelum menjawab, selalu aktif, dan API bawaan pada upaya tinggi. Harga Claude API adalah $8 per satu juta token input dan $40 per satu juta token output, dengan penulisan prompt-cache lima menit seharga $10 dan pembacaan cache $0,20.
Anda memerlukan:
-
Python 3.12+, karena NumPy 2.5.4 dan SciPy 1.18.1 membutuhkannya (paket Anthropic sendiri mendukung 3.10)
-
Kunci API dengan akses ke
claude-fable-5-2 -
anthropic2.7.0, rilis yang menambahkan ID model
Klon proyek dan pasang dependensi yang dipin. Di macOS atau Linux, buat lingkungan dengan python3.12 -m venv .venv, aktifkan dengan source .venv/bin/activate, dan ganti Copy-Item dengan cp.
git clone https://github.com/KhalidAbdelaty/claude-fable-5-2-api.git
cd claude-fable-5-2-api
py -3.12 -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env # then paste your key after ANTHROPIC_API_KEY=Kodenya memuat kunci API dari environment tanpa mencetaknya. README repositori mencantumkan perintah untuk eksperimen lengkap, dan hanya dua di antaranya yang memanggil API. Panduan API Claude kami mencakup kunci dan penagihan secara umum.
Buat permintaan API Fable 5.2 pertama Anda
Lewati bagian ini jika Anda sudah pernah memanggil Claude dari Python. Permintaan ini berfokus pada bukti yang membedakan dua hipotesis.
import anthropic
from dotenv import load_dotenv
load_dotenv(".env", override=True)
client = anthropic.Anthropic() # reads ANTHROPIC_API_KEY
response = client.messages.create(
model="claude-fable-5-2",
max_tokens=4096,
output_config={"effort": "high"},
messages=[{"role": "user", "content": (
"Three cooling runs start at 80, 95, and 110 C. Each seems to slow down partway through. "
"In three short bullets: what pattern across the runs would point to a change after a fixed "
"time, what pattern would point to a change at a fixed temperature, and what the data alone "
"cannot tell us.")}],
)
print("block types:", [block.type for block in response.content])
print("stop reason:", response.stop_reason)
print("".join(block.text for block in response.content if block.type == "text"))Claude mengembalikan daftar blok konten bertipe, jadi bacalah teks berdasarkan tipe blok; content[0] bisa jadi blok pemikiran. Berikut respons pertamanya:
block types: ['thinking', 'text']
stop reason: end_turn
- **Fixed time:** the slowdown appears at the same elapsed time in all three runs but at different temperatures, with the hotter-start runs still hotter when it happens.
- **Fixed temperature:** the slowdown appears at the same temperature in all three runs but at different elapsed times, with the hotter-start runs reaching it later.
- **What the data cannot tell us:** the cause. A matching pattern shows what the change tracks, not why it happens (for example a phase change, a setup artifact, or a shift in the surroundings). Since cooling naturally slows as it nears room temperature, the data also cannot show on its own that there is a distinct change rather than a smooth curve.Baik blok thinking maupun text muncul. Token pemikiran dihitung sebagai token keluaran, jadi sertakan saat memperkirakan biaya. Panduan migrasi Claude Fable 5.2 menyatakan bahwa budget_tokens, thinking disabled, temperature, top_p, dan top_k mengembalikan galat 400.
Buat Dataset Pendinginan Tanpa Kebocoran Data
Datanya harus cukup berantakan sehingga memerlukan pemodelan, dan jawabannya harus tetap di luar jangkauan Claude.
Simulasikan tiga run pendinginan
Saya mensimulasikan tiga run dari hukum Newton dengan perubahan pendinginan tersembunyi yang kontinu. Run A mulai pada 80 °C di ruangan 21,0 °C, B pada 95 °C di 24,0 °C, dan C pada 110 °C di 22,5 °C. Generator bilangan acak NumPy tetap menambahkan noise Gaussian, dan satu pembacaan sengaja diberi galat ekstra.
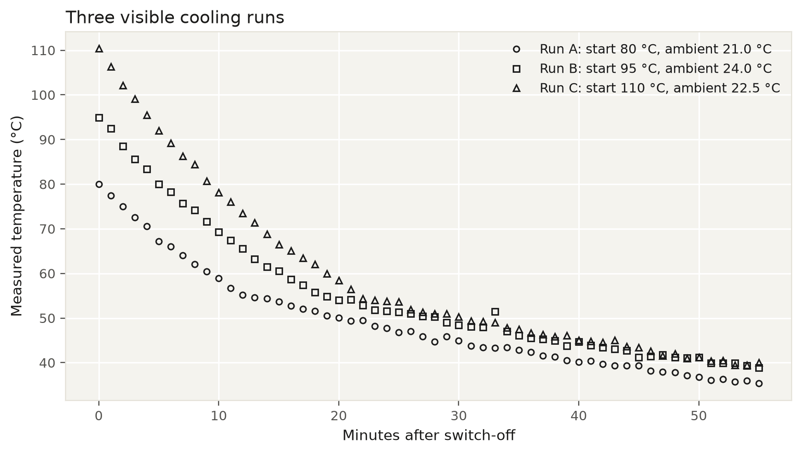
Tiga run berisik mencakup satu outlier. Gambar oleh Penulis.
Run A mendingin lebih cepat di awal daripada di akhir. Pola tersebut saja tidak menunjukkan perubahan diskret karena setiap eksponensial akan melambat saat mendekati suhu ruangan.
Run B berisi lonjakan terisolasi sekitar 4 °C, sementara celah tetangga di tempat lain tetap di bawah 1,2 °C. Setiap belokan menyebar selama beberapa menit yang berisik, jadi inspeksi visual tidak bisa membedakan model waktu vs ambang.
Uji Hipotesis Pendinginan dengan Alat Python
Python menyesuaikan (fit) tiap kandidat pendinginan di bawah aturan yang sama dan mengembalikan parameternya serta galatnya. Claude tidak pernah melihat kode fitting, hanya apa yang dikembalikan tiap alat.
Estimasi parameter bersama tanpa satu outlier mendominasi
Fitting berarti memilih nilai parameter yang menjaga tiap kurva prediksi tetap dekat dengan pengukurannya. Saya menggunakan loss L1 lembut karena itu mengurangi pengaruh galat besar tanpa menghapus pembacaan tersebut.
Semua run berbagi parameter hasil fitting, sedangkan tiap run menyimpan suhu awal dan suhu ruangannya sendiri. Untuk model ambang, itu memberi tiap run waktu ganti sendiri, ln((T0 - Ta) / (threshold - Ta)) / k_above.
Fungsi least_squares() SciPy mencari parameter terbaik, sementara batas parameter menjaga laju dan titik ganti tetap dalam rentang yang ditetapkan sebelum run.
Cuplikan di bawah menunjukkan pemanggilan solver dan pemeriksaan konvergensi. Fungsi residual dan pemindaian grid di sekitarnya ada di repositori.
from scipy.optimize import least_squares
def _solve(hypothesis, names, x0, lo, hi, runs):
# soft L1: residuals under f_scale count roughly squared, larger ones roughly linearly
return least_squares(_residuals, x0, bounds=(lo, hi), method="trf",
loss="soft_l1", f_scale=0.5, args=(hypothesis, names, runs))
# scan the change point in 0.5 steps with the rates fitted at each step, then refine all three
res = _solve(hypothesis, names, best_grid_point, lo, hi, runs)
converged = bool(res.success and res.status > 0 and np.all(np.isfinite(res.x)))
at_bound = [n for n, v, a, b in zip(names, res.x, lo, hi) if min(v - a, b - v) < 1e-4 * (b - a)]Saya menetapkan f_scale ke 0,5 °C sebelum run. Residual yang lebih besar dari itu mulai kehilangan pengaruh di bawah L1 lembut. Pemindaian grid atas titik ganti memberi solver nilai awal yang masuk akal.
Validasi model dengan uji leave-one-run-out
MAE adalah rata-rata selisih dalam °C. RMSE mengkuadratkan galat terlebih dahulu, sehingga galat yang lebih besar dihitung lebih berat.
Galat pelatihan menguntungkan model dengan lebih banyak parameter. Validasi silang memperkirakan galat data yang ditahan dengan memutar data yang dikecualikan. Di sini, validasi leave-one-run-out (LORO) melakukan fitting pada dua run dan memprediksi yang ketiga.
Definisikan skema pemanggilan alat Claude
Skema alat adalah deskripsi JSON tentang fungsi Python dan argumen yang boleh dikirim Claude. Strict tool use membuat API memeriksa bentuk tersebut sebelum Python menjalankan fungsinya.
Claude dapat meminta empat alat:
-
inspect_runs: mengembalikan pengukuran yang terlihat dan ringkasan kemiringan sederhana. -
fit_hypothesis: melakukan fitting satu model pendinginan dan mengembalikan parameternya serta galat data yang ditahan. -
inspect_residuals: menunjukkan di mana suhu terukur berbeda dari prediksi model. -
compare_predictions: membandingkan model terpasang di bawah kondisi eksperimen yang diusulkan.
Skema compare_predictions menjaga pengukuran konfirmasi tetap di luar alat:
{"name": "compare_predictions", "strict": True,
"description": "Predict a new run from existing fits under proposed conditions and report how far the "
"predictions differ. initial_temp_c must be 75 to 115 and ambient_temp_c 20 to 25. "
"Returns predictions only; no new measurements are generated.",
"input_schema": {"type": "object", "additionalProperties": False,
"properties": {"initial_temp_c": {"type": "number"},
"ambient_temp_c": {"type": "number"},
"fit_ids": {"type": "array", "items": {"type": "string"}}},
"required": ["initial_temp_c", "ambient_temp_c", "fit_ids"]}}Nilai fit_ids merujuk pada model yang telah difit sebelumnya dalam investigasi yang sama. Skema ketat tidak menerima minimum atau maximum, jadi Python memeriksa sendiri rentang suhu. Biarkan tool_choice pada auto, karena memaksa alat mengembalikan galat 400 pada Fable 5.2.
Bangun Tool Loop Claude
Aplikasi mengulang satu siklus: kirim percakapan ke Claude, jalankan alat Python yang diminta, dan kembalikan hasilnya. Ini berlanjut hingga perbandingan yang diperlukan selesai, lalu meminta Claude laporan akhir dalam format tetap.
Tulis prompt untuk pengujian hipotesis
Prompt sistem menggambarkan metode tanpa menyarankan jawaban. Inti promptnya adalah:
SYSTEM = """You are a scientific investigator working on a controlled cooling experiment. You decide which
checks to run and how to read the results. Python tools do every numerical calculation.
How to work:
- Look at the measurements before you choose a model.
- Fit every candidate model with fit_hypothesis. Compare them on leave-one-run-out error as well as
training error, because a model with more parameters always fits the training runs at least as well.
- Use inspect_residuals to look for systematic patterns and to decide whether any single reading is
an outlier.
- Use only numbers that a tool returned. Do not invent measurements, parameters, or errors.
- Keep observed evidence separate from assumptions. The data can show which mathematical model fits
best; it cannot show the physical cause of a change.
- If the evidence does not separate the candidates, say so and treat the result as inconclusive.
..."""Saya paling peduli dengan butir terakhir. Tanpanya, model harus menyebut pemenang bahkan ketika galatnya terlalu berdekatan untuk diputuskan.
Pertahankan tool loop hanya-menambah
Setiap panggilan mengirim system dan tools yang sama, dan setiap respons dikembalikan tanpa sentuhan. Cuplikan ini menunjukkan penanganan pesan; loop lengkap dengan penanganan penghentian ada di repositori.
resp = client.messages.create(
model="claude-fable-5-2",
max_tokens=20_000,
system=SYSTEM,
tools=TOOLS, # all four, declared on the first request
thinking={"type": "adaptive", "display": "summarized"},
output_config={"effort": "high"},
cache_control={"type": "ephemeral"}, # automatic prompt caching
messages=messages,
)
messages.append({"role": "assistant", "content": resp.content}) # unchanged, thinking included
if resp.stop_reason == "tool_use":
results = []
for block in resp.content:
if block.type == "tool_use":
out, is_error = box.run(block.name, dict(block.input))
results.append({"type": "tool_result", "tool_use_id": block.id,
"content": out, "is_error": is_error})
messages.append({"role": "user", "content": results})Preserved thinking memungkinkan Claude menyimpan penalaran sebelumnya lintas giliran, selama system, tools, dan pesan sebelumnya tetap tak berubah. Pada Fable 5.2, mengedit salah satunya mengembalikan galat 400 secara default.
Anda dapat mengubah output_config, tool_choice, dan max_tokens antar panggilan, meski format keluaran baru tetap tidak memanfaatkan prompt cache. Kelompokkan hasil alat paralel dalam satu pesan pengguna, seperti loop di atas.
Tetapkan batas permintaan, waktu, dan biaya
Python menghitung jumlah permintaan, panggilan alat, waktu berlalu, dan biaya, dan tidak akan memulai pekerjaan baru setelah batas tercapai. Permintaan yang sudah berjalan masih bisa melampaui batas waktu atau biaya, jadi perlakukan dua hal itu sebagai batas lunak.
Sebelum menerima jawaban akhir, Python juga memeriksa bahwa Claude telah melakukan fitting untuk semua kandidat, memeriksa residual, dan membandingkan desain konfirmasi. Jika Claude berhenti karena alasan apa pun selain permintaan alat atau giliran selesai, investigasi berakhir sebagai tidak konklusif. Tetapkan max_tokens cukup tinggi untuk pemikiran plus jawaban.
Kembalikan laporan terstruktur
Setelah pemeriksaan lolos, satu permintaan lagi meminta keluaran terstruktur pada riwayat yang sama, sehingga laporan akhir tiba sebagai objek Python yang tervalidasi:
messages.append({"role": "user", "content": REPORT_PROMPT})
resp = client.messages.parse(
model="claude-fable-5-2", max_tokens=20_000, system=SYSTEM, tools=TOOLS,
thinking={"type": "adaptive", "display": "summarized"},
output_config={"effort": "high"},
output_format=InvestigationReport, # the SDK sends this as output_config.format
tool_choice={"type": "none"}, # tools stay declared, so the prefix check passes
messages=messages,
)
problems = validate(resp.parsed_output, box.fits) # fit IDs exist, all four covered, ranges holdPydantic memeriksa bentuk laporan, dan validate() mengonfirmasi bahwa setiap fit yang disebutkan ada dan kondisinya berada dalam rentang yang diizinkan. Setelah itu, pilihan model dan kondisi bersifat final.
Fable 5.2 Memilih Model Ambang Suhu
Saya menjalankan satu investigasi pada upaya high. Berikut cara Claude sampai pada jawabannya.
Lacak urutan uji Claude
Claude memulai dengan memeriksa pengukuran. Sebelum melakukan fitting apa pun, ringkasannya berbunyi: "Perubahan muncul sekitar 55 °C di setiap run: pada menit 12 di A, menit 19 di B, dan menit 22 di C. Itu mengarah ke ambang, jadi saya akan fit keempatnya."
Saya menyebutnya anchoring: Claude berkomitmen pada jawaban sebelum mengujinya. Fitting berikutnya setuju, dengan pergantian dekat menit 12, 18, dan 22. Jejak terminal menunjukkan urutan pemeriksaan yang tersisa.
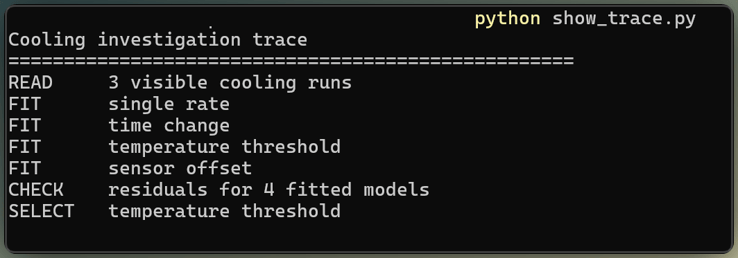
Jejak terminal menunjukkan urutan uji Claude. Gambar oleh Penulis.
Bandingkan galat data yang ditahan di empat model
RMSE latih mengukur tiap fit pada ketiga run. Kolom held-out merata-ratakan tiga uji LORO.
|
Kandidat |
Asumsi utama |
RMSE latih (°C) |
MAE held-out (°C) |
RMSE held-out (°C) |
|
Laju tunggal |
Satu laju sepanjang run |
4,08 |
3,90 |
4,60 |
|
Perubahan waktu |
Pergantian bersama sekitar menit 19 |
1,92 |
2,17 |
2,63 |
|
Ambang suhu |
Pergantian bersama sekitar 55 °C |
0,49 |
0,32 |
0,48 |
|
Offset sensor |
Drift pengukuran yang membesar |
1,49 |
1,45 |
1,87 |
Untuk model ambang, galat latih dan held-out berdekatan, jadi fit terbawa dari satu run ke run lain, meski tiga run tidak bisa menyingkirkan overfitting secara umum. Plot residual di bawah menunjukkan suhu teramati dikurangi prediksi tiap model.
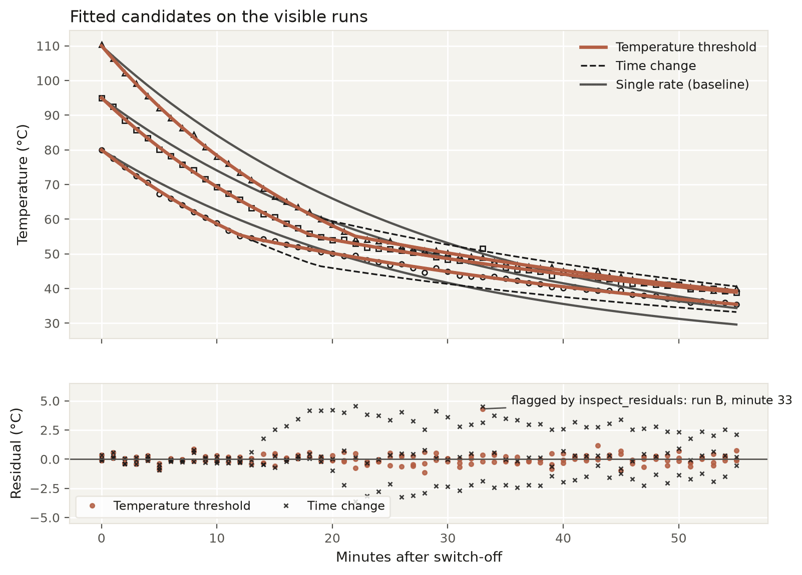
Residual ambang tidak menunjukkan pola sistematis. Gambar oleh Penulis.
Fit perubahan waktu cocok dengan run B. Setelah pergantian, ia meleset pada run A sekitar +2,5 hingga +3,5 °C dan pada run C sebesar -1,5 hingga -2,8 °C.
Saya menganggap perubahan tanda lebih berguna daripada peringkat semata: itu menunjukkan pergantian datang lebih awal di A dan lebih lambat di C, seperti yang diprediksi pemicu suhu. Model offset sensor mengurangi sebagian galat dengan menambahkan drift, namun galat held-out-nya tetap lebih besar.
Periksa pembacaan yang rusak
Agen tidak tahu pembacaan mana yang saya rusak. Ia menemukan run B, menit 33, dengan residual sekitar +4,3 °C. Z-score robust-nya, yang mengukur jarak dari sebaran residual khas, di atas 12.
Claude membiarkan pembacaan itu tetap ada, karena L1 lembut sudah membatasi tarikannya. Untuk memeriksa pilihan itu, saya melakukan fitting ulang keempat model tanpa pembacaan tersebut. Model ambang tetap pertama dengan selisih besar, dan estimasi ambangnya nyaris tidak bergerak.
Rancang Eksperimen Konfirmasi
Agen membandingkan prediksi kandidat di berbagai suhu awal dan suhu ruangan, lalu memilih kondisi tanpa melihat pengukuran baru apa pun.
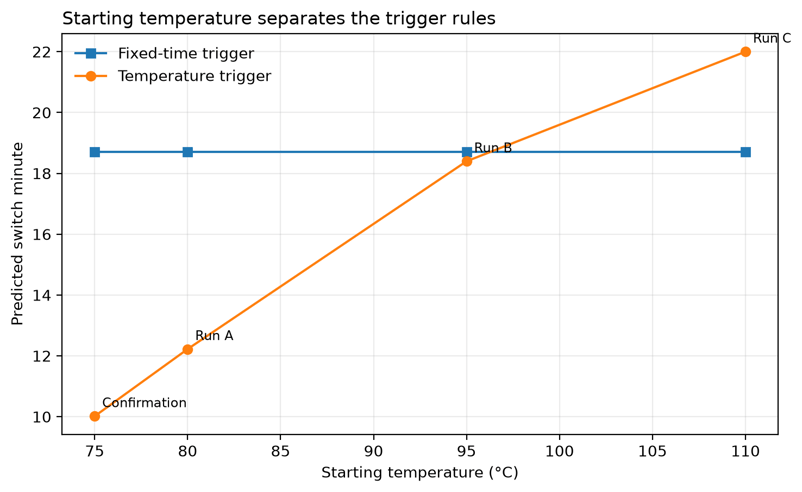
Suhu awal mengungkapkan masing-masing aturan pemicu. Gambar oleh Penulis.
Pilih kondisi yang memisahkan model
Seperti disebutkan di Ringkasnya, agen memilih awal 75 °C dan ruangan 20 °C. Model ambang berganti dekat menit 10, sementara model waktu berganti dekat menit 19. Kurva offset sensor juga tetap terpisah dari prediksi ambang.
Setelan menengah dekat run B hanya akan memisahkan model ambang dan waktu sekitar 0,6 °C. Kondisi yang dipilih sedikit berada di luar rentang yang diuji, dan Claude menandai itu dalam laporannya.
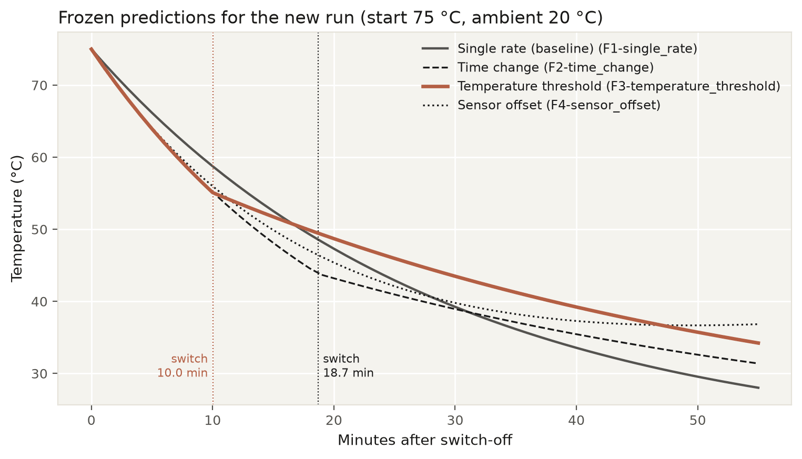
Prediksi kandidat untuk run terpilih. Gambar oleh Penulis.
Kunci prediksi sebelum pembuatan data
Saya mengunci kondisi pilihan, parameter hasil fitting, dan prediksi setiap kandidat sebelum menghasilkan pengukuran baru. Agen tidak menerima pengukuran konfirmasi dan tidak bisa merevisi jawabannya setelah hasil keluar.
Pengukuran konfirmasi menggunakan model noise Gaussian yang sama, seed tetap terpisah, dan tanpa outlier tambahan.
Nilai Run yang Tak Terlihat
Kode Python terpisah menilai prediksi beku. Ia tidak pernah memanggil API, jadi Claude tidak turut serta menilai jawabannya sendiri.
Nilai prediksi dengan Python independen
Prediksi ambang lulus kedua uji prasetel. Pada run yang tak terlihat, ia mencetak 0,27 °C MAE dan 0,32 °C RMSE. Waktu tetap mencetak 3,67 °C RMSE, offset sensor 2,35 °C, dan laju tunggal 4,28 °C.
Run konfirmasi tidak mengandung outlier yang ditanam, yang membantu menjelaskan galatnya lebih rendah dibanding hasil leave-one-run-out. Sampel noise acak yang berbeda juga bisa berkontribusi.
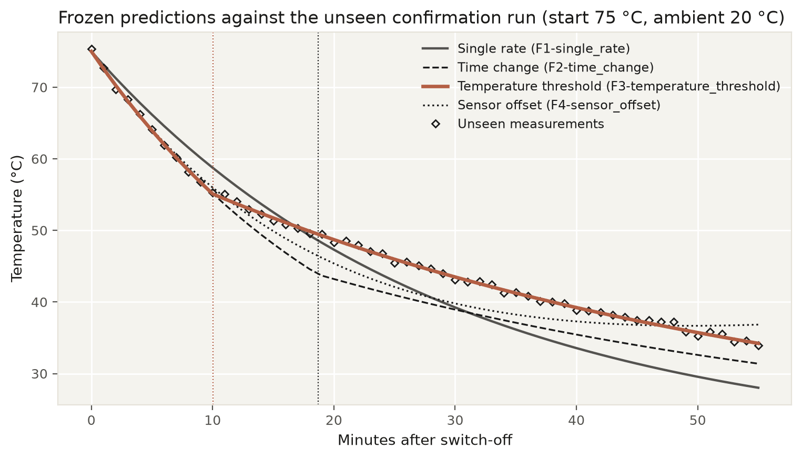
Prediksi beku cocok dengan pengukuran yang tak terlihat. Gambar oleh Penulis.
Bandingkan parameter hasil fitting dengan kebenaran tersembunyi
Setelah penilaian, bandingkan parameter hasil fitting dengan nilai pembangkitan tersembunyi:
import numpy as np
def true_curve(t0, ta, minutes, truth):
"""Newton cooling whose rate drops when the temperature crosses a threshold. Continuous at the switch."""
t = np.asarray(minutes, dtype=float)
k1, k2, th = truth["k_above"], truth["k_below"], truth["threshold_c"]
if t0 <= th:
return ta + (t0 - ta) * np.exp(-k2 * t)
t_cross = np.log((t0 - ta) / (th - ta)) / k1
fast = ta + (t0 - ta) * np.exp(-k1 * t)
slow = ta + (th - ta) * np.exp(-k2 * (t - t_cross)) # restarts from the threshold
return np.where(t <= t_cross, fast, slow)Simulator menambahkan noise Gaussian ber-seed di sekitar kurva ini.
Aturan tersembunyi adalah ambang suhu di 55 °C, dengan laju 0,045 dan 0,020 per menit serta deviasi standar noise 0,35 °C.
Laju hasil fitting cocok hingga 3 angka desimal, ambang berada dalam 0,1 °C, dan pergantian yang diprediksi dalam 0,1 menit.
Data mengidentifikasi aturan matematis yang digunakan simulator. Data tidak dapat menunjukkan apakah perangkat nyata yang melambat dekat 55 °C melibatkan perubahan fase, siklus kipas, atau penyebab fisik lainnya.
Tinjau bagaimana agen mencapai jawabannya
Laporan mengutip ID fit dan nomor alat sebagai bukti, dan menyebutkan hal yang tidak bisa ditegakkan oleh tiga run. Titik lemahnya adalah tebakan awal yang saya sebutkan tadi. Satu investigasi tidak bisa menunjukkan seberapa sering tebakan semacam itu keliru.
Tonton investigasi di Streamlit
Dalam video, saya memulai run langsung, mengikuti log alat, dan membuka tab Report, Curves, Confirmation, dan Cost setelah penilaian.
Antarmuka Streamlit menampilkan satu investigasi. Video oleh Penulis.
Ukur Biaya API Claude Fable 5.2
Investigasi, termasuk laporan akhir, memakan biaya sekitar $0,49 dan memakan waktu sedikit di atas satu menit. SciPy berjalan di mesin Anda, jadi tidak menambah tagihan API.
Permintaan laporan saja memakan hampir setengah biaya dan waktu. Seperti saya sebutkan di bagian tool-loop, format keluaran baru melewatkan prompt cache, sehingga permintaan terakhir itu memproses seluruh percakapan lagi sebelum menulis laporan panjang. Lacak input non-cache, penulisan cache, pembacaan cache, dan keluaran secara terpisah, karena masing-masing memiliki harga sendiri.
Batas dan Pertimbangan Praktis
Ada dua jenis batas yang penting di sini: apa yang dapat ditunjukkan oleh eksperimen, dan apa yang dibutuhkan kode sebelum berjalan sebagai layanan.
Batas ilmiah
Simulator dan kandidat ambang menggunakan persamaan yang sama. Pergantian bertahap pada perangkat nyata masih bisa cocok dengan model ini sambil mengikuti kurva yang berbeda.
Jika aturan sebenarnya tidak ada, agen masih bisa memilih model terdekat yang disediakan daripada menjawab inconclusive. Noise yang lebih besar atau ambang yang nyaris terlewati dapat membuat galat terlalu mirip untuk dipisahkan. Run lain mungkin mengambil urutan alat yang berbeda.
Sebelum produksi
Batas dari tool loop mencakup satu investigasi di mesin Anda. Layanan produksi memerlukan lebih banyak:
- Tetapkan ulang-otomatis SDK dan batas waktu permintaan untuk layanan.
- Validasi setiap input dan output alat di Python.
- Catat model, versi SDK, alasan berhenti, token, latensi, dan biaya untuk tiap permintaan.
- Pin versi model dan SDK, jalankan ulang uji tersembunyi, dan konfirmasi kebijakan retensi 30 hari sebelum upgrade.
Kapan pola ini cocok
Gunakan pola ini ketika ada beberapa penjelasan yang masuk akal, Python dapat mengujinya, dan eksperimen tersembunyi dapat menilai pilihannya, terutama saat eksperimen berikutnya lebih mahal daripada panggilan API.
Gunakan Python biasa ketika Anda sudah tahu keluarga modelnya. Panduan model Fable 5.2 dari Anthropic menyarankan mencoba Opus terlebih dahulu dan menguji Fable ketika Opus tidak memenuhi kebutuhan.
Pemikiran Akhir
Kita membangun agen yang membandingkan empat model pendinginan, memilih ambang suhu, merancang run konfirmasi, dan memprediksi pengukuran yang belum pernah dilihat. Untuk perangkat sintetis ini, jawaban atas pertanyaan pembuka saya adalah ya.
Saya tidak akan membawanya terlalu jauh ke peralatan nyata atau penemuan terbuka. Seperti yang saya bahas dalam batas, kandidat mencakup persamaan milik simulator, dan saya menjalankan agen sekali.
Yang terbawa adalah metodenya: sembunyikan kebenaran, tetapkan aturan penilaian sebelum permintaan pertama, bekukan prediksi, dan gunakan evaluator terpisah. Uji berikut yang berguna adalah menambahkan model transisi bertahap dan mengulangi investigasi pada tingkat noise yang berbeda.
Untuk pemilihan model, kursus Introduction to Claude Models kami membahas lini produk Claude dan pertukarannya.
FAQs
Bisakah saya mematikan pemikiran atau menetapkan anggaran pemikiran pada Claude Fable 5.2?
Tidak. Pemikiran adaptif selalu aktif, dan baik thinking: {type: "disabled"} maupun budget_tokens mengembalikan galat 400. Kendalikan seberapa banyak ia berpikir dengan parameter effort sebagai gantinya, yang default-nya high. Token pemikiran ditagih sebagai output dan dihitung terhadap max_tokens.
Mengapa Claude Fable 5.2 mengembalikan galat 400 setelah saya mengedit pesan sebelumnya?
Setiap blok pemikiran hanya valid terhadap prompt sistem, alat, dan pesan yang datang sebelumnya, dan Fable 5.2 memeriksa ini pada setiap akun. Pertahankan percakapan hanya-menambah dan bekukan system dan tools untuk sesi. Sebagai solusi sementara, mengatur prefix_mismatch_behavior ke "drop_block" dengan header beta akan menjatuhkan blok yang terdampak alih-alih gagal.
Bisakah saya memaksa Claude Fable 5.2 untuk memanggil alat tertentu?
Tidak. Mengatur tool_choice ke any atau ke nama alat tertentu mengembalikan galat 400; hanya auto dan none yang berfungsi. Sebutkan alatnya dalam instruksi Anda dan atur strict: true sehingga pemanggilan sesuai dengan skema Anda. Jika pemanggilan diperlukan, gunakan pesan sistem di tengah percakapan.
Apa yang terjadi ketika Claude Fable 5.2 menolak permintaan?
Respons kembali dengan stop_reason: "refusal", dan stop_details.category memberi tahu Anda pagar pengaman mana yang terpicu. Anda dapat mencoba lagi pada model lain sendiri, atau memilih fallback sisi server dengan fallbacks: "default", beta yang mencoba ulang pada Claude Opus 4.8 atau Claude Opus 5. Model fallback tidak menerima blok pemikiran Fable 5.2.
Bisakah saya menggunakan Claude Fable 5.2 dengan zero data retention?
Tidak secara default. Fable 5.2 memerlukan retensi data 30 hari, dan permintaan API dari organisasi atau ruang kerja tanpa itu mengembalikan galat 400. Di bawah pengaturan ZDR, aktifkan retensi 30 hari untuk ruang kerja atau hubungi tim akun Anthropic Anda.
Bisakah Batch API menggantikan tool loop dari eksperimen ini?
Tidak. Setiap langkah alat membutuhkan respons sebelumnya, jadi Batch API tidak dapat langsung menggantikan loop ini. Diskon 50%-nya cocok untuk permintaan independen atau evaluasi paralel.

Saya seorang data engineer dan pembangun komunitas yang bekerja lintas pipeline data, cloud, dan perkakas AI sambil menulis tutorial praktis dan berdampak tinggi untuk DataCamp dan pengembang yang sedang berkembang.




LLM pandai terdengar seolah-olah mereka menalar hingga menemukan jawaban. Apakah itu benar-benar terjadi lebih sulit untuk diperiksa. Dalam banyak tugas, model entah pernah melihat sesuatu yang mirip dengan jawabannya, atau tidak ada yang bisa memverifikasi jawabannya sama sekali. Jadi saya membuat sebuah uji di mana jawabannya tetap tersembunyi.
Claude Fable 5.2 menerima pembacaan berisik dari perangkat simulasi yang mendingin setelah dimatikan, ditambah 4 kemungkinan penjelasan mengapa pendinginannya melambat di tengah jalan. Ia harus memilih satu, merancang eksperimen lanjutan, dan berkomitmen pada prediksi sebelum melihat satu pun pengukuran baru. Kode Python terpisah kemudian menilai prediksinya, dan Claude tidak pernah menyentuhnya.
Perangkat pendingin hanyalah kasus uji. Yang dapat dibawa ke konteks lain adalah pengaturannya: sembunyikan kebenaran dari model, tetapkan aturan penilaian sebelum panggilan API pertama, bekukan prediksi, dan nilai menggunakan kode yang tidak dapat dilihatnya. Anda bisa menggunakannya ulang untuk masalah apa pun bertema “penjelasan mana yang benar?”, dari analisis akar penyebab hingga membaca uji A/B.
Dalam tutorial ini, Anda akan membangun agen tersebut di Python. SciPy menangani hitungan; Claude memutuskan pemeriksaan apa yang dijalankan berikutnya dan apa kesimpulannya. Jika Anda nyaman dengan fungsi Python dan permintaan API, Anda bisa mengikuti, dan saya menjelaskan matematika pendinginan saat pertama kali muncul. Kita akan membahas cara:
Ringkasan Claude Fable 5.2 kami membahas peluncuran dan tolok ukur, jadi di sini saya fokus pada API dan uji pendinginan. Saya menjalankan eksperimen sehari setelah peluncuran.
Ringkasnya
Saya memberi Fable 5.2 data berisik dari perangkat simulasi yang pendinginannya melambat di tengah jalan, plus empat kemungkinan penjelasan. Ia harus memilih satu, merancang eksperimen baru, dan memprediksi hasilnya sebelum melihatnya.