

Diseña el experimento y el arnés
Mi implementación empareja Claude con cuatro funciones de Python, llamadas herramientas, que mostraré tras el conjunto de datos. El código completo y la interfaz opcional en Streamlit están en el repositorio de GitHub.
Define los cuatro modelos de enfriamiento
La ley de enfriamiento de Newton dice que un objeto se enfría más rápido cuando está mucho más caliente que la habitación y se ralentiza a medida que se reduce la diferencia de temperatura. La ecuación es T(t) = Ta + (T0 - Ta) * exp(-k * t). Aquí, T0 es la temperatura inicial, Ta la temperatura ambiente y k la tasa de enfriamiento por minuto.
Escribí cuatro familias de modelos entre las que el agente puede elegir:
-
Tasa única: un solo
ken todo el proceso; sirve como referencia -
Cambio en el tiempo: dos tasas que cambian en el mismo minuto transcurrido en todas las ejecuciones
-
Umbral de temperatura: dos tasas que cambian a una temperatura compartida, por lo que ocurre en un minuto distinto en cada ejecución
-
Desvío del sensor: una tasa «real» más un error de la sonda que aparece a mitad y va creciendo
Separa las mediciones visibles de la verdad oculta
Claude ve tres series de enfriamiento y lo que devuelven las herramientas. Las tasas reales, el umbral, la configuración de los datos y las mediciones de confirmación quedan fuera de su acceso a herramientas.
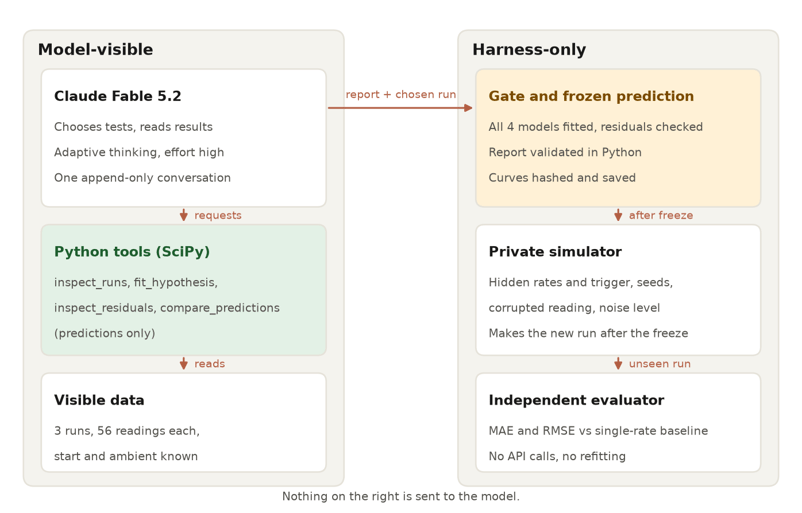
Claude accede a herramientas; la verdad permanece oculta. Imagen del autor.
Todo lo que rodea a Claude en Python conforma el arnés del agente. Además de ejecutar las herramientas, limita peticiones, tiempo y gasto, como verás con el bucle de herramientas.
Antes de la primera llamada a la API fijé los modelos candidatos, los límites de parámetros, las restricciones y la regla de aprobado para el nuevo experimento: un RMSE de como mucho 1,0 °C y no más de la mitad del de la referencia de tasa única. Esas reglas se mantuvieron fijas.
Configura Claude Fable 5.2 en Python
La configuración requiere un entorno virtual y una clave de API. El claude-fable-5-2 puede leer hasta 1 M de tokens de prompt e historial de conversación y devolver hasta 128 K tokens de salida.
El razonamiento adaptativo, donde el modelo decide cuánto pensar antes de responder, está siempre activo y la API usa por defecto un esfuerzo alto. La tarifa de la API de Claude es de 8 $ por millón de tokens de entrada y 40 $ por millón de tokens de salida, con escrituras en la caché de prompt de cinco minutos a 10 $ y lecturas a 0,20 $.
Necesitas:
-
Python 3.12+ porque NumPy 2.5.4 y SciPy 1.18.1 lo requieren (el paquete de Anthropic en sí admite 3.10)
-
Una clave de API con acceso a
claude-fable-5-2 -
anthropic2.7.0, la versión que añadió el ID del modelo
Clona el proyecto e instala sus dependencias fijadas. En macOS o Linux, crea el entorno con python3.12 -m venv .venv, actívalo con source .venv/bin/activate y sustituye Copy-Item por cp.
git clone https://github.com/KhalidAbdelaty/claude-fable-5-2-api.git
cd claude-fable-5-2-api
py -3.12 -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env # then paste your key after ANTHROPIC_API_KEY=El código carga la clave de la API desde el entorno sin imprimirla. El README del repositorio lista los comandos para el experimento completo, y solo dos llaman a la API. Nuestra guía de la API de Claude cubre claves y facturación en general.
Haz tu primera petición a la API de Fable 5.2
Sáltate esta sección si ya has llamado a Claude desde Python. Esta petición se centra en la evidencia que separa las dos hipótesis.
import anthropic
from dotenv import load_dotenv
load_dotenv(".env", override=True)
client = anthropic.Anthropic() # reads ANTHROPIC_API_KEY
response = client.messages.create(
model="claude-fable-5-2",
max_tokens=4096,
output_config={"effort": "high"},
messages=[{"role": "user", "content": (
"Three cooling runs start at 80, 95, and 110 C. Each seems to slow down partway through. "
"In three short bullets: what pattern across the runs would point to a change after a fixed "
"time, what pattern would point to a change at a fixed temperature, and what the data alone "
"cannot tell us.")}],
)
print("block types:", [block.type for block in response.content])
print("stop reason:", response.stop_reason)
print("".join(block.text for block in response.content if block.type == "text"))Claude devuelve una lista de bloques de contenido tipados, así que lee el texto por tipo de bloque; content[0] puede ser un bloque de pensamiento. Esta fue la primera respuesta:
block types: ['thinking', 'text']
stop reason: end_turn
- **Fixed time:** the slowdown appears at the same elapsed time in all three runs but at different temperatures, with the hotter-start runs still hotter when it happens.
- **Fixed temperature:** the slowdown appears at the same temperature in all three runs but at different elapsed times, with the hotter-start runs reaching it later.
- **What the data cannot tell us:** the cause. A matching pattern shows what the change tracks, not why it happens (for example a phase change, a setup artifact, or a shift in the surroundings). Since cooling naturally slows as it nears room temperature, the data also cannot show on its own that there is a distinct change rather than a smooth curve.Aparecieron bloques de thinking y de text. Los tokens de pensamiento cuentan como tokens de salida, así que inclúyelos al estimar el coste. La guía de migración de Claude Fable 5.2 indica que budget_tokens, thinking disabled, temperature, top_p y top_k devuelven un error 400.
Crea un dataset de enfriamiento sin fugas de datos
Los datos deben ser lo bastante sucios como para requerir ajuste de modelos, y la respuesta debe quedar fuera del alcance de Claude.
Simula tres ejecuciones de enfriamiento
Simulé tres ejecuciones con la ley de Newton y un cambio oculto y continuo en el enfriamiento. La ejecución A empieza a 80 °C en una habitación a 21,0 °C, B a 95 °C en 24,0 °C y C a 110 °C en 22,5 °C. Un generador aleatorio de NumPy fijo añade ruido gaussiano, y una lectura tiene un error extra a propósito.
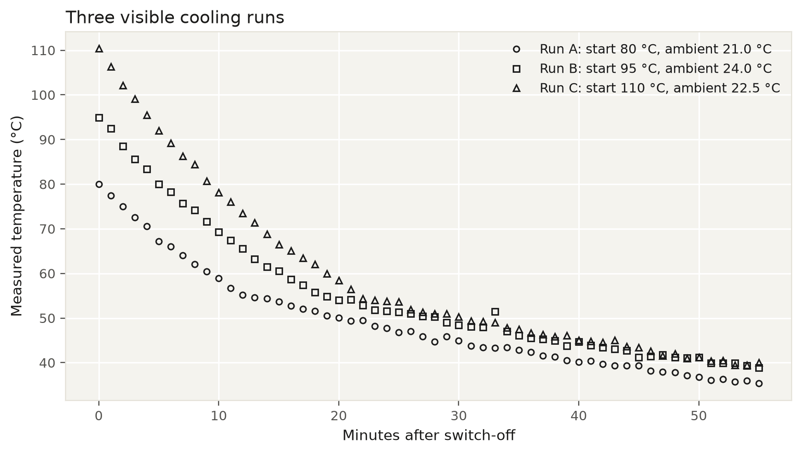
Tres ejecuciones ruidosas incluyen un valor atípico. Imagen del autor.
La ejecución A se enfría más rápido al principio que al final. Ese patrón por sí solo no demuestra un cambio discreto porque cualquier exponencial se ralentiza cerca de la temperatura ambiente.
La ejecución B contiene un salto aislado de unos 4 °C, mientras que las diferencias vecinas en otros puntos se mantienen por debajo de 1,2 °C. Cada codo se reparte en varios minutos ruidosos, por lo que la inspección visual no permite separar los modelos de tiempo y de umbral.
Pon a prueba hipótesis de enfriamiento con herramientas de Python
Python ajusta cada candidato de enfriamiento bajo las mismas reglas y devuelve sus parámetros y errores. Claude nunca ve el código de ajuste, solo lo que devuelve cada herramienta.
Ajusta parámetros compartidos sin que un atípico domine
Ajustar significa elegir valores de parámetros que mantengan cada curva predicha cerca de sus mediciones. Uso pérdida L1 suave porque reduce la influencia de un error grande sin eliminar esa lectura.
Todas las ejecuciones comparten los parámetros ajustados, mientras que cada una conserva su temperatura inicial y ambiente. En el modelo de umbral, eso da a cada ejecución su propio instante de cambio, ln((T0 - Ta) / (threshold - Ta)) / k_above.
El least_squares() de SciPy busca los parámetros que mejor encajan, mientras que los límites mantienen tasas y puntos de cambio dentro de los rangos fijados antes de la ejecución.
El extracto siguiente muestra la llamada al solver y las comprobaciones de convergencia. La función de residuos y el barrido de rejilla están en el repositorio.
from scipy.optimize import least_squares
def _solve(hypothesis, names, x0, lo, hi, runs):
# soft L1: residuals under f_scale count roughly squared, larger ones roughly linearly
return least_squares(_residuals, x0, bounds=(lo, hi), method="trf",
loss="soft_l1", f_scale=0.5, args=(hypothesis, names, runs))
# scan the change point in 0.5 steps with the rates fitted at each step, then refine all three
res = _solve(hypothesis, names, best_grid_point, lo, hi, runs)
converged = bool(res.success and res.status > 0 and np.all(np.isfinite(res.x)))
at_bound = [n for n, v, a, b in zip(names, res.x, lo, hi) if min(v - a, b - v) < 1e-4 * (b - a)]Fijé f_scale en 0,5 °C antes de la ejecución. Los residuos mayores empiezan a perder influencia con L1 suave. Un barrido por rejilla sobre el punto de cambio da al solver un valor inicial sensato.
Valida modelos con pruebas leave-one-run-out
La MAE es el error medio en °C. El RMSE eleva primero los errores al cuadrado, así que los grandes cuentan más.
El error de entrenamiento favorece a los modelos con más parámetros. La validación cruzada estima el error con datos reservados rotando qué datos se excluyen. Aquí, la validación leave-one-run-out (LORO) ajusta en dos ejecuciones y predice la tercera.
Define los esquemas de llamada a herramientas de Claude
Un esquema de herramienta es una descripción JSON de una función de Python y los argumentos que Claude puede enviar. El uso estricto de herramientas hace que la API compruebe esa forma antes de que Python ejecute la función.
Claude puede solicitar cuatro herramientas:
-
inspect_runs: devuelve las mediciones visibles y resúmenes sencillos de pendiente. -
fit_hypothesis: ajusta un modelo de enfriamiento y devuelve sus parámetros y errores con datos reservados. -
inspect_residuals: muestra dónde difieren las temperaturas observadas de las predichas por el modelo. -
compare_predictions: compara modelos ajustados bajo condiciones propuestas de experimento.
El esquema de compare_predictions mantiene las mediciones de confirmación fuera de la herramienta:
{"name": "compare_predictions", "strict": True,
"description": "Predict a new run from existing fits under proposed conditions and report how far the "
"predictions differ. initial_temp_c must be 75 to 115 and ambient_temp_c 20 to 25. "
"Returns predictions only; no new measurements are generated.",
"input_schema": {"type": "object", "additionalProperties": False,
"properties": {"initial_temp_c": {"type": "number"},
"ambient_temp_c": {"type": "number"},
"fit_ids": {"type": "array", "items": {"type": "string"}}},
"required": ["initial_temp_c", "ambient_temp_c", "fit_ids"]}}Los valores de fit_ids se refieren a modelos ajustados anteriormente en la misma investigación. Los esquemas estrictos no aceptan minimum ni maximum, así que Python comprueba por sí mismo los rangos de temperatura. Deja tool_choice en auto, porque forzar una herramienta devuelve un error 400 en Fable 5.2.
Construye el bucle de herramientas de Claude
La aplicación repite un ciclo: envía la conversación a Claude, ejecuta las herramientas de Python que solicite y devuelve sus resultados. Continúa hasta completar las comparaciones necesarias y luego pide a Claude un informe final en un formato fijo.
Escribe un prompt para contrastar hipótesis
El prompt del sistema describe el método sin sugerir una respuesta. El prompt principal es:
SYSTEM = """You are a scientific investigator working on a controlled cooling experiment. You decide which
checks to run and how to read the results. Python tools do every numerical calculation.
How to work:
- Look at the measurements before you choose a model.
- Fit every candidate model with fit_hypothesis. Compare them on leave-one-run-out error as well as
training error, because a model with more parameters always fits the training runs at least as well.
- Use inspect_residuals to look for systematic patterns and to decide whether any single reading is
an outlier.
- Use only numbers that a tool returned. Do not invent measurements, parameters, or errors.
- Keep observed evidence separate from assumptions. The data can show which mathematical model fits
best; it cannot show the physical cause of a change.
- If the evidence does not separate the candidates, say so and treat the result as inconclusive.
..."""Me importa sobre todo el último punto. Sin él, el modelo tendría que elegir un ganador incluso cuando los errores están demasiado ajustados.
Mantén el bucle de herramientas solo con anexos
Cada llamada envía el mismo system y las mismas tools, y cada respuesta se reenvía intacta. Este extracto muestra el manejo de mensajes; el bucle completo con gestión de paradas está en el repositorio.
resp = client.messages.create(
model="claude-fable-5-2",
max_tokens=20_000,
system=SYSTEM,
tools=TOOLS, # all four, declared on the first request
thinking={"type": "adaptive", "display": "summarized"},
output_config={"effort": "high"},
cache_control={"type": "ephemeral"}, # automatic prompt caching
messages=messages,
)
messages.append({"role": "assistant", "content": resp.content}) # unchanged, thinking included
if resp.stop_reason == "tool_use":
results = []
for block in resp.content:
if block.type == "tool_use":
out, is_error = box.run(block.name, dict(block.input))
results.append({"type": "tool_result", "tool_use_id": block.id,
"content": out, "is_error": is_error})
messages.append({"role": "user", "content": results})Preserved thinking permite a Claude conservar su razonamiento previo entre turnos siempre que system, tools y los mensajes anteriores permanezcan sin cambios. En Fable 5.2, editar cualquiera de ellos devuelve un error 400 por defecto.
Puedes cambiar output_config, tool_choice y max_tokens entre llamadas, aunque un formato de salida nuevo no aprovechará la caché de prompt. Agrupa los resultados de herramientas en paralelo en un solo mensaje de usuario, como hace el bucle anterior.
Pon límites a peticiones, tiempo y gasto
Python cuenta peticiones, llamadas a herramientas, tiempo transcurrido y gasto, y no inicia trabajo nuevo cuando se alcanza un límite. Una petición ya en curso puede sobrepasar el límite de tiempo o gasto, así que trata esos dos como límites flexibles.
Antes de aceptar una respuesta final, Python también comprueba que Claude ajustó todos los candidatos, inspeccionó los residuos y comparó diseños de confirmación. Si Claude se detiene por cualquier motivo que no sea una solicitud de herramienta o un turno finalizado, la investigación termina como inconclusa. Define max_tokens lo bastante alto para el pensamiento más la respuesta.
Devuelve un informe estructurado
Una vez superadas las comprobaciones, una petición más solicita salidas estructuradas sobre el mismo historial, de modo que el informe final llega como un objeto de Python validado:
messages.append({"role": "user", "content": REPORT_PROMPT})
resp = client.messages.parse(
model="claude-fable-5-2", max_tokens=20_000, system=SYSTEM, tools=TOOLS,
thinking={"type": "adaptive", "display": "summarized"},
output_config={"effort": "high"},
output_format=InvestigationReport, # the SDK sends this as output_config.format
tool_choice={"type": "none"}, # tools stay declared, so the prefix check passes
messages=messages,
)
problems = validate(resp.parsed_output, box.fits) # fit IDs exist, all four covered, ranges holdPydantic comprueba la forma del informe, y validate() confirma que cada ajuste citado existe y que las condiciones están dentro del rango permitido. A partir de ahí, la elección del modelo y las condiciones quedan definitivas.
Fable 5.2 elige el modelo de umbral de temperatura
Ejecuté una investigación con esfuerzo high. Así llegó Claude a su respuesta.
Sigue la secuencia de pruebas de Claude
Claude empezó inspeccionando las mediciones. Antes de ajustar nada, su resumen decía: «El cambio aparece en torno a 55 °C en todas las ejecuciones: en el minuto 12 en A, en el 19 en B y en el 22 en C. Eso apunta a un umbral, así que ajustaré los cuatro».
Yo lo llamaría anclaje: Claude se comprometió con una respuesta antes de comprobarla. El ajuste posterior coincidió, con cambios cerca de los minutos 12, 18 y 22. El rastro en terminal muestra el orden del resto de comprobaciones.
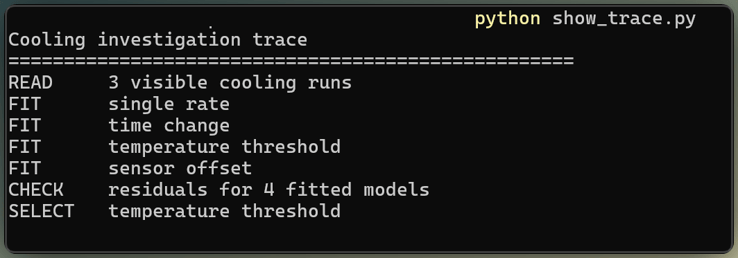
La terminal muestra el orden de pruebas de Claude. Imagen del autor.
Compara errores con datos reservados entre los cuatro modelos
El RMSE de entrenamiento mide cada ajuste en las tres ejecuciones. Las columnas de datos reservados promedian las tres pruebas LORO.
|
Candidato |
Supuesto principal |
RMSE entrenamiento (°C) |
MAE reservado (°C) |
RMSE reservado (°C) |
|
Tasa única |
Una tasa constante |
4.08 |
3.90 |
4.60 |
|
Cambio en el tiempo |
Cambio compartido cerca del minuto 19 |
1.92 |
2.17 |
2.63 |
|
Umbral de temperatura |
Cambio compartido cerca de 55 °C |
0.49 |
0.32 |
0.48 |
|
Desvío del sensor |
Deriva de medición creciente |
1.49 |
1.45 |
1.87 |
En el modelo de umbral, los errores de entrenamiento y de datos reservados son similares, así que el ajuste se traslada bien entre ejecuciones, aunque con tres ejecuciones no se puede descartar el sobreajuste en general. El gráfico de residuos siguiente muestra la temperatura observada menos la predicción de cada modelo.
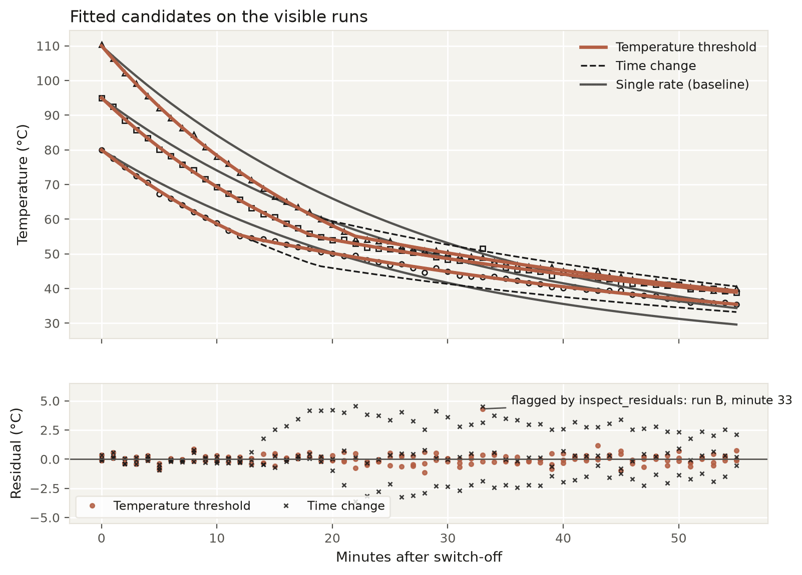
Los residuos del umbral no muestran patrones sistemáticos. Imagen del autor.
El ajuste de cambio temporal cuadra con la ejecución B. Tras el cambio, falla la A en torno a +2,5 a +3,5 °C y la C en -1,5 a -2,8 °C.
Me resulta más útil el cambio de signo que el ranking en sí: indica que el cambio llega antes en A y más tarde en C, como predice un disparo por temperatura. El modelo de desvío del sensor reduce algo de error añadiendo deriva, pero sus errores con datos reservados siguen siendo mayores.
Revisa la lectura corrupta
El agente no sabía qué lectura había corrompido. Encontró la ejecución B, minuto 33, con un residuo de unos +4,3 °C. Su z-score robusto, que mide la distancia respecto a la dispersión típica de residuos, superó 12.
Claude dejó la lectura, ya que L1 suave limita su arrastre. Para comprobar esa decisión, reajusté los cuatro modelos sin ella. El modelo de umbral siguió primero por un amplio margen y su estimación de umbral apenas cambió.
Diseña un experimento de confirmación
El agente comparó predicciones de los candidatos con varios inicios y temperaturas ambiente y luego eligió condiciones sin ver ninguna medición nueva.
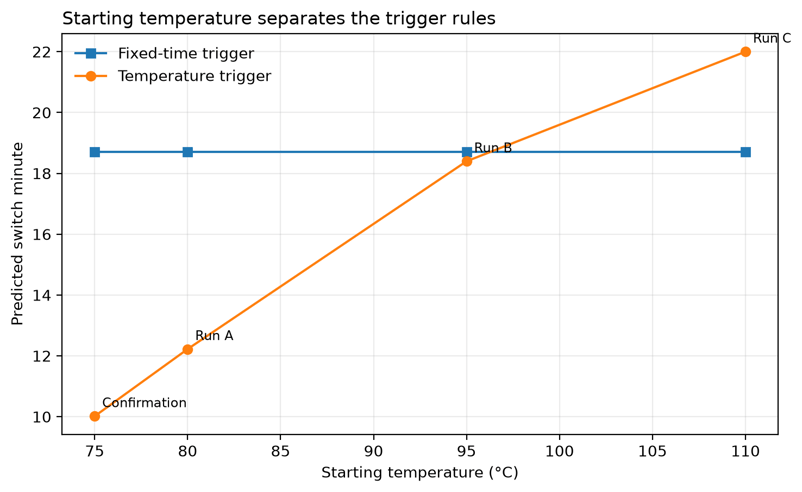
Las temperaturas iniciales revelan cada regla de disparo. Imagen del autor.
Elige condiciones que separen los modelos
Como señalé en el TL;DR, el agente escogió un inicio a 75 °C y una habitación a 20 °C. El modelo de umbral cambia cerca del minuto 10, mientras que el modelo temporal lo hace cerca del 19. La curva de desvío del sensor también se mantiene separada de la predicción por umbral.
Un ajuste intermedio cercano a la ejecución B solo separaría los modelos de umbral y tiempo en unos 0,6 °C. Las condiciones elegidas quedan ligeramente fuera del rango probado, y Claude lo señaló en su informe.
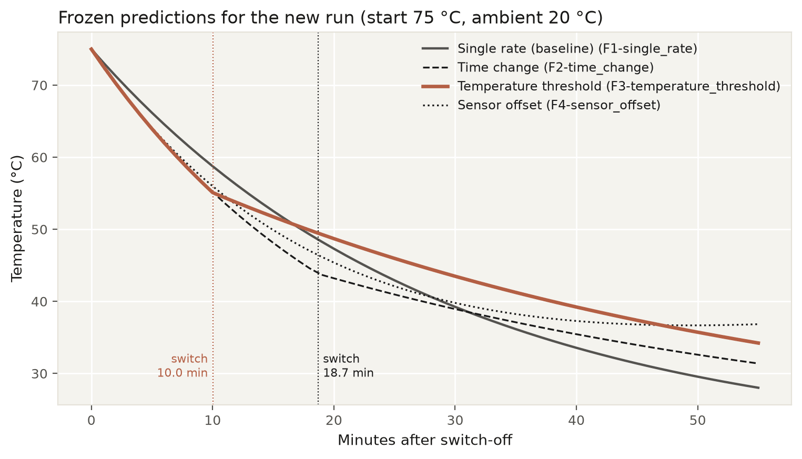
Predicciones de los candidatos para la ejecución elegida. Imagen del autor.
Bloquea las predicciones antes de generar datos
Bloqueé las condiciones elegidas, los parámetros ajustados y la predicción de cada candidato antes de generar nuevas mediciones. El agente no recibió las mediciones de confirmación y no pudo revisar su respuesta tras ver el resultado.
Las mediciones de confirmación usan el mismo modelo de ruido gaussiano, una semilla fija aparte y ningún atípico añadido.
Evalúa la ejecución oculta
Un código de Python independiente puntuó las predicciones congeladas. No llama a la API, así que Claude no participa en la corrección de su propia respuesta.
Evalúa predicciones con Python independiente
La predicción por umbral superó ambas pruebas predefinidas. En la ejecución oculta logró 0,27 °C MAE y 0,32 °C RMSE. Tiempo fijo obtuvo 3,67 °C de RMSE, desvío del sensor 2,35 °C y tasa única 4,28 °C.
La ejecución de confirmación no contiene un atípico introducido a propósito, lo que ayuda a explicar su error menor frente a los resultados leave-one-run-out. Otra muestra aleatoria de ruido también puede contribuir.
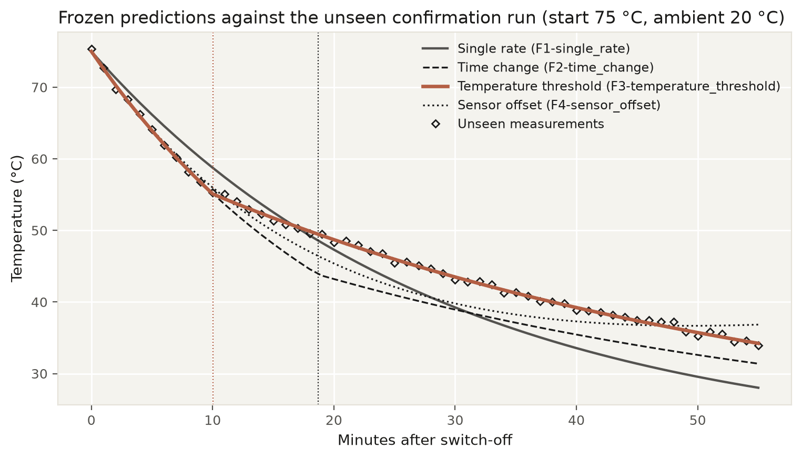
Las predicciones congeladas encajan con las mediciones ocultas. Imagen del autor.
Compara parámetros ajustados con la verdad oculta
Tras puntuar, compara los parámetros ajustados con los valores generadores ocultos:
import numpy as np
def true_curve(t0, ta, minutes, truth):
"""Newton cooling whose rate drops when the temperature crosses a threshold. Continuous at the switch."""
t = np.asarray(minutes, dtype=float)
k1, k2, th = truth["k_above"], truth["k_below"], truth["threshold_c"]
if t0 <= th:
return ta + (t0 - ta) * np.exp(-k2 * t)
t_cross = np.log((t0 - ta) / (th - ta)) / k1
fast = ta + (t0 - ta) * np.exp(-k1 * t)
slow = ta + (th - ta) * np.exp(-k2 * (t - t_cross)) # restarts from the threshold
return np.where(t <= t_cross, fast, slow)El simulador añade ruido gaussiano con semilla alrededor de esta curva.
La regla oculta era un umbral de temperatura a 55 °C, con tasas de 0,045 y 0,020 por minuto y una desviación estándar del ruido de 0,35 °C.
Las tasas ajustadas coinciden a 3 decimales, el umbral cae a menos de 0,1 °C y el instante de cambio previsto está dentro de 0,1 minuto.
Los datos identifican la regla matemática usada por el simulador. No pueden mostrar si, en un dispositivo real, el enlentecimiento cerca de 55 °C implica un cambio de fase, un ciclo de ventilador u otra causa física.
Revisa cómo llegó el agente a su respuesta
El informe citó IDs de ajustes y números de herramientas como evidencia, y señaló lo que tres ejecuciones no pueden establecer. El punto débil es la conjetura temprana que mencioné. Una sola investigación no demuestra con qué frecuencia ese tipo de conjetura falla.
Mira la investigación en Streamlit
En el vídeo, inicio una ejecución en directo, sigo el registro de herramientas y abro las pestañas Report, Curves, Confirmation y Cost tras puntuar.
La interfaz de Streamlit muestra una investigación. Vídeo del autor.
Mide el coste de la API de Claude Fable 5.2
La investigación, informe final incluido, costó unos 0,49 $ y tardó poco más de un minuto. SciPy se ejecuta en tu máquina, así que no suma nada a la factura de la API.
La petición del informe por sí sola supuso casi la mitad del coste y del tiempo. Como comenté en el apartado del bucle de herramientas, un formato de salida nuevo no aprovecha la caché de prompt, por lo que esa última petición volvió a procesar toda la conversación antes de escribir un informe largo. Controla por separado la entrada no cacheada, las escrituras y lecturas de caché y la salida, ya que cada una tiene su precio.
Límites y consideraciones prácticas
Aquí importan dos tipos de límites: lo que el experimento puede mostrar y lo que el código necesita antes de operar como servicio.
Límites científicos
El simulador y el candidato de umbral usan la misma ecuación. Un cambio gradual en un dispositivo real podría ajustarse a este modelo y, aun así, seguir otra curva.
Si faltara la regla verdadera, el agente podría elegir el modelo más cercano de los suministrados en lugar de responder inconclusive. Más ruido o un umbral apenas cruzado podrían hacer los errores demasiado similares como para separarlos. Otra ejecución puede seguir un orden distinto de herramientas.
Antes de producción
Los límites del bucle de herramientas cubren una investigación en tu máquina. Un servicio en producción necesita más:
- Configura reintentos del SDK y timeouts de las peticiones para el servicio.
- Valida toda entrada y salida de herramienta en Python.
- Registra modelo, versión del SDK, motivo de parada, tokens, latencia y coste por petición.
- Congela versiones de modelo y SDK, vuelve a ejecutar la prueba oculta y confirma la política de retención de 30 días antes de actualizar.
Cuándo encaja este patrón
Usa este patrón cuando haya varias explicaciones posibles, Python pueda ponerlas a prueba y un experimento oculto pueda puntuar la elección, especialmente cuando el siguiente experimento cueste más que la llamada a la API.
Usa Python «a pelo» cuando ya conozcas la familia de modelos. Las recomendaciones del modelo Fable 5.2 de Anthropic sugieren probar primero Opus y evaluar Fable cuando Opus no cumpla el requisito.
Reflexiones finales
Construimos un agente que comparó cuatro modelos de enfriamiento, eligió un umbral de temperatura, diseñó una ejecución de confirmación y predijo mediciones que nunca había visto. Para este dispositivo sintético, la respuesta a mi pregunta inicial es que sí.
No extrapolaría eso a equipos reales o a un descubrimiento abierto. Como conté en los límites, los candidatos incluían la propia ecuación del simulador y ejecuté el agente una vez.
Lo que se mantiene es el método: oculta la verdad, fija las reglas de puntuación antes de la primera petición, congela las predicciones y usa un evaluador aparte. Una buena siguiente prueba sería añadir un modelo de transición gradual y repetir la investigación con distintos niveles de ruido.
Para selección de modelos, nuestro curso Introduction to Claude Models repasa la oferta de Claude y sus trade-offs.
FAQs
¿Puedo desactivar el pensamiento o fijar un presupuesto de pensamiento en Claude Fable 5.2?
No. El razonamiento adaptativo está siempre activo, y tanto thinking: {type: "disabled"} como budget_tokens devuelven un error 400. Controla cuánto piensa con el parámetro effort, que por defecto es high. Los tokens de pensamiento se facturan como salida y cuentan para max_tokens.
¿Por qué Claude Fable 5.2 devuelve un error 400 tras editar mensajes anteriores?
Cada bloque de pensamiento solo es válido respecto al prompt del sistema, las herramientas y los mensajes que lo preceden, y Fable 5.2 lo comprueba en cada turno. Mantén la conversación solo con anexos y congela system y tools durante la sesión. Como solución temporal, ajustar prefix_mismatch_behavior a "drop_block" con el encabezado beta descarta los bloques afectados en lugar de fallar.
¿Puedo forzar que Claude Fable 5.2 llame a una herramienta específica?
No. Establecer tool_choice en any o en una herramienta concreta devuelve un error 400; solo funcionan auto y none. Menciona la herramienta en tu instrucción y marca strict: true para que la llamada se ajuste a tu esquema. Si la llamada es obligatoria, usa un mensaje de sistema a mitad de conversación.
¿Qué pasa cuando Claude Fable 5.2 rechaza una petición?
La respuesta llega con stop_reason: "refusal", y stop_details.category indica qué salvaguarda se activó. Puedes reintentar tú mismo en otro modelo o activar la conmutación en servidor con fallbacks: "default", una beta que reintenta en Claude Opus 4.8 o Claude Opus 5. El modelo de respaldo no recibe los bloques de pensamiento de Fable 5.2.
¿Puedo usar Claude Fable 5.2 con retención cero de datos?
No por defecto. Fable 5.2 requiere retención de datos de 30 días, y las peticiones de API desde una organización o espacio de trabajo sin ella devuelven un error 400. Con un acuerdo ZDR, habilita la retención de 30 días para un espacio de trabajo o contacta con tu equipo de cuenta de Anthropic.
¿Puede la Batch API sustituir el bucle de herramientas de este experimento?
No. Cada paso de herramienta necesita la respuesta previa, así que la Batch API no puede sustituir directamente a este bucle. Su descuento del 50% encaja con peticiones independientes o evaluaciones en paralelo.

Soy ingeniero de datos y creador de comunidades. Trabajo con canalizaciones de datos, nube y herramientas de IA, al tiempo que escribo tutoriales prácticos y de gran impacto para DataCamp y programadores emergentes.



Los LLM son buenos dando la impresión de que han razonado su respuesta. Comprobar si realmente lo han hecho es otra historia. En la mayoría de tareas, el modelo ya ha visto algo parecido a la respuesta o nadie puede verificarla. Así que diseñé una prueba donde la respuesta permanece oculta.
Claude Fable 5.2 recibe lecturas ruidosas de un dispositivo simulado que se enfría tras apagarse, junto con 4 posibles explicaciones de por qué su enfriamiento se ralentiza a mitad. Debe elegir una, diseñar un experimento de confirmación y comprometerse con una predicción antes de ver ni una sola medición nueva. Un código de Python independiente evalúa la predicción, y Claude no lo toca.
El dispositivo de enfriamiento es solo el caso de prueba. Lo que importa es el planteamiento: ocultar la verdad al modelo, fijar las reglas de puntuación antes de la primera llamada a la API, congelar sus predicciones y evaluarlas con código que no puede ver. Puedes reutilizarlo para cualquier problema de «¿qué explicación es la correcta?», desde análisis de causa raíz hasta la lectura de un test A/B.
En este tutorial, construirás ese agente en Python. SciPy hace las cuentas; Claude decide qué comprobación ejecutar y qué concluir. Si te manejas con funciones de Python y peticiones a APIs, podrás seguirlo; además explico las matemáticas del enfriamiento cuando aparecen por primera vez. Veremos cómo:
Nuestro resumen de Claude Fable 5.2 cubre el lanzamiento y los benchmarks, así que aquí me centro en la API y la prueba de enfriamiento. Ejecuté el experimento al día siguiente del lanzamiento.
TL;DR
Le di a Fable 5.2 datos ruidosos de un dispositivo simulado cuyo enfriamiento se ralentiza a mitad, junto con cuatro posibles explicaciones. Tenía que elegir una, diseñar un nuevo experimento y predecir el resultado antes de verlo.