

Zaprojektuj eksperyment i otoczkę (harness)
Moja implementacja łączy Claude’a z czterema funkcjami Pythona, zwanymi narzędziami, które pokażę po zbiorze danych. Kompletny kod i opcjonalny interfejs Streamlit są w repozytorium GitHub.
Zdefiniuj cztery modele chłodzenia
Prawo stygnięcia Newtona mówi, że obiekt stygnie szybciej, gdy jest dużo cieplejszy niż otoczenie, a potem zwalnia, gdy różnica temperatur maleje. Równanie to T(t) = Ta + (T0 - Ta) * exp(-k * t). Tutaj T0 to temperatura początkowa, Ta to temperatura otoczenia, a k to tempo chłodzenia na minutę.
Napisałem cztery rodziny modeli, spośród których agent ma wybierać:
-
Pojedyncze tempo: jedno
kprzez cały czas, używane jako baza -
Zmiana w czasie: dwa tempa, przełączane w tej samej minucie od startu w każdym przebiegu
-
Próg temperatury: dwa tempa, przełączane przy wspólnej temperaturze, więc w innej minucie w każdym przebiegu
-
Offset sensora: jedno prawdziwe tempo plus błąd sondy, który zaczyna się w połowie i narasta
Oddziel widoczne pomiary od ukrytej prawdy
Claude widzi trzy serie chłodzenia i wszystko, co zwracają narzędzia. Prawdziwe tempa, próg, ustawienia danych i pomiary potwierdzające pozostają poza jego dostępem do narzędzi.
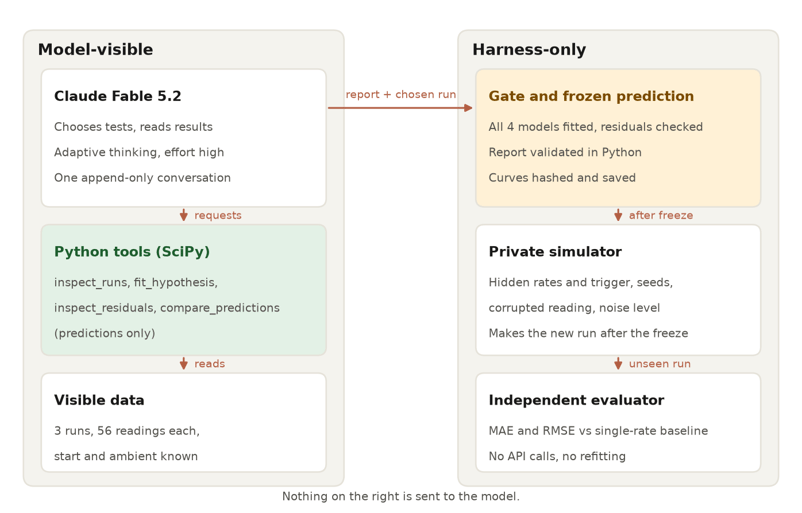
Claude ma dostęp do narzędzi; prawda pozostaje ukryta. Ilustracja autora.
Wszystko w Pythonie wokół Claude’a tworzy otoczkę agenta (agent harness). Poza tym uruchamia narzędzia, ogranicza liczbę żądań, czas i koszty — omówię to przy pętli narzędzi.
Przed pierwszym wywołaniem API ustaliłem kandydackie modele, ograniczenia parametrów, limity i regułę zaliczenia dla nowego eksperymentu: RMSE maks. 1,0 °C i nie więcej niż połowa bazowego jednorzędowego modelu. Te zasady pozostały stałe.
Skonfiguruj Claude Fable 5.2 w Pythonie
Konfiguracja wymaga wirtualnego środowiska i klucza API. Model claude-fable-5-2 może czytać do 1M tokenów z promptu i historii rozmowy, a następnie zwrócić do 128K tokenów wyjściowych.
Adaptacyjne myślenie, czyli decyzja modelu, ile rozumować przed odpowiedzią, jest zawsze włączone, a API domyślnie ustawia wysiłek na wysoki. Cennik Claude API to 8 USD na milion tokenów wejścia i 40 USD na milion tokenów wyjścia, z zapisami cache’u promptu (5 min) po 10 USD i odczytami cache’u po 0,20 USD.
Potrzebujesz:
-
Pythona 3.12+, bo tego wymagają NumPy 2.5.4 i SciPy 1.18.1 (pakiet Anthropic sam wspiera 3.10)
-
Klucza API z dostępem do
claude-fable-5-2 -
anthropic2.7.0, wydania, które dodało identyfikator modelu
Sklonuj projekt i zainstaluj przypięte zależności. W macOS lub Linuksie utwórz środowisko poleceniem python3.12 -m venv .venv, aktywuj je przez source .venv/bin/activate i zamień Copy-Item na cp.
git clone https://github.com/KhalidAbdelaty/claude-fable-5-2-api.git
cd claude-fable-5-2-api
py -3.12 -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env # then paste your key after ANTHROPIC_API_KEY=Kod ładuje klucz API ze środowiska, bez jego wypisywania. README w repozytorium zawiera komendy dla pełnego eksperymentu, z czego tylko dwie wywołują API. Nasz przewodnik po Claude API ogólnie omawia klucze i rozliczenia.
Wykonaj swoje pierwsze żądanie do API Fable 5.2
Pomiń tę sekcję, jeśli już wywoływałeś Claude’a z Pythona. To żądanie skupia się na dowodach rozróżniających dwie hipotezy.
import anthropic
from dotenv import load_dotenv
load_dotenv(".env", override=True)
client = anthropic.Anthropic() # reads ANTHROPIC_API_KEY
response = client.messages.create(
model="claude-fable-5-2",
max_tokens=4096,
output_config={"effort": "high"},
messages=[{"role": "user", "content": (
"Three cooling runs start at 80, 95, and 110 C. Each seems to slow down partway through. "
"In three short bullets: what pattern across the runs would point to a change after a fixed "
"time, what pattern would point to a change at a fixed temperature, and what the data alone "
"cannot tell us.")}],
)
print("block types:", [block.type for block in response.content])
print("stop reason:", response.stop_reason)
print("".join(block.text for block in response.content if block.type == "text"))Claude zwraca listę bloków treści z typami, więc czytaj tekst po typie bloku; content[0] może być blokiem myślenia. Oto pierwsza odpowiedź:
block types: ['thinking', 'text']
stop reason: end_turn
- **Fixed time:** the slowdown appears at the same elapsed time in all three runs but at different temperatures, with the hotter-start runs still hotter when it happens.
- **Fixed temperature:** the slowdown appears at the same temperature in all three runs but at different elapsed times, with the hotter-start runs reaching it later.
- **What the data cannot tell us:** the cause. A matching pattern shows what the change tracks, not why it happens (for example a phase change, a setup artifact, or a shift in the surroundings). Since cooling naturally slows as it nears room temperature, the data also cannot show on its own that there is a distinct change rather than a smooth curve.Pojawiły się bloki thinking i text. Tokeny myślenia liczą się jako tokeny wyjścia, więc uwzględnij je przy szacowaniu kosztu. Przewodnik migracji Claude Fable 5.2 informuje, że budget_tokens, myślenie disabled, temperature, top_p i top_k zwracają błąd 400.
Utwórz zbiór danych chłodzenia bez wycieku danych
Dane muszą być na tyle nieuporządkowane, by wymagały dopasowania modelu, a odpowiedź musi pozostać poza zasięgiem Claude’a.
Zasymuluj trzy przebiegi chłodzenia
Zasymulowałem trzy przebiegi z prawa Newtona z ukrytą, ciągłą zmianą tempa chłodzenia. Przebieg A startuje z 80 °C w pokoju 21,0 °C, B z 95 °C w 24,0 °C, a C z 110 °C w 22,5 °C. Stały generator liczb losowych NumPy dodaje szum Gaussa, a jeden odczyt celowo dostaje dodatkowy błąd.
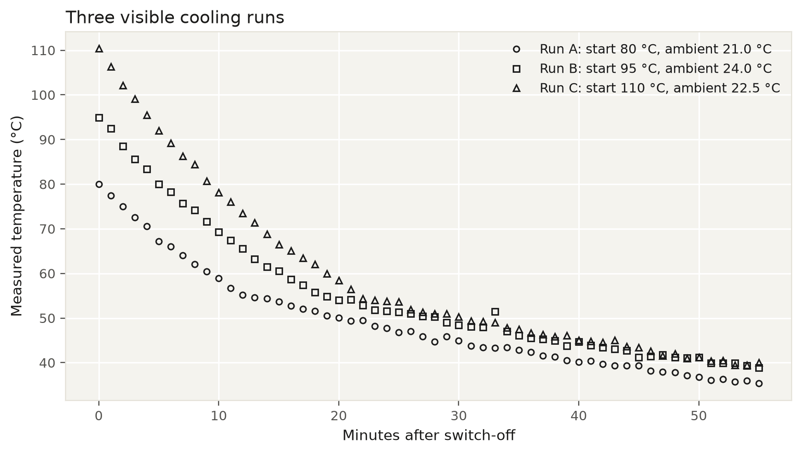
Trzy zaszumione przebiegi zawierają jeden odstający punkt. Ilustracja autora.
Przebieg A stygnie szybciej na początku niż później. Sam ten wzór nie dowodzi skokowej zmiany, bo każda eksponenta zwalnia w pobliżu temperatury otoczenia.
Przebieg B zawiera pojedynczy skok ok. 4 °C, podczas gdy sąsiednie różnice gdzie indziej pozostają poniżej 1,2 °C. Każde załamanie rozciąga się na kilka zaszumionych minut, więc oględziny nie rozdzielą modeli czasu i progu.
Testuj hipotezy chłodzenia za pomocą narzędzi Pythona
Python dopasowuje każdego kandydata chłodzenia według tych samych zasad i zwraca jego parametry oraz błędy. Claude nigdy nie widzi kodu dopasowania, tylko to, co zwraca każde narzędzie.
Dopasuj współdzielone parametry bez dominacji jednego odstającego
Dopasowanie oznacza wybór wartości parametrów, które utrzymują każdą przewidywaną krzywą blisko jej pomiarów. Używam straty soft L1, bo zmniejsza wpływ dużego błędu bez usuwania tego odczytu.
Wszystkie przebiegi współdzielą dopasowane parametry, a każdy zachowuje swoją temperaturę początkową i otoczenia. W modelu progu daje to każdemu przebiegowi własny czas przełączenia, ln((T0 - Ta) / (threshold - Ta)) / k_above.
Funkcja least_squares() z SciPy wyszukuje najlepsze dopasowanie parametrów, a ograniczenia parametrów utrzymują tempa i punkty przełączeń w zakresach ustalonych przed uruchomieniem.
Poniższy fragment pokazuje wywołanie solvera i testy zbieżności. Funkcja reszt i skan siatki wokół niej są w repozytorium.
from scipy.optimize import least_squares
def _solve(hypothesis, names, x0, lo, hi, runs):
# soft L1: residuals under f_scale count roughly squared, larger ones roughly linearly
return least_squares(_residuals, x0, bounds=(lo, hi), method="trf",
loss="soft_l1", f_scale=0.5, args=(hypothesis, names, runs))
# scan the change point in 0.5 steps with the rates fitted at each step, then refine all three
res = _solve(hypothesis, names, best_grid_point, lo, hi, runs)
converged = bool(res.success and res.status > 0 and np.all(np.isfinite(res.x)))
at_bound = [n for n, v, a, b in zip(names, res.x, lo, hi) if min(v - a, b - v) < 1e-4 * (b - a)]Ustawiłem f_scale na 0,5 °C przed uruchomieniem. Reszty większe niż ten próg zaczynają tracić wpływ w soft L1. Skan siatki po punkcie przełączenia daje solverowi sensowną wartość startową.
Waliduj modele testami leave-one-run-out
MAE to średnie pudło w °C. RMSE najpierw podnosi błędy do kwadratu, więc większe liczą się bardziej.
Błąd treningowy faworyzuje modele z większą liczbą parametrów. Walidacja krzyżowa szacuje błąd na odłożonych danych, rotując wykluczony fragment. Tutaj LORO (leave-one-run-out) dopasowuje na dwóch przebiegach i przewiduje trzeci.
Zdefiniuj schematy wywoływania narzędzi Claude’a
Schemat narzędzia to opis JSON funkcji Pythona i argumentów, które Claude może wysłać. Ścisłe użycie narzędzi sprawia, że API sprawdza ten kształt, zanim Python uruchomi funkcję.
Claude może żądać czterech narzędzi:
-
inspect_runs: zwraca widoczne pomiary i proste podsumowania nachyleń. -
fit_hypothesis: dopasowuje jeden model chłodzenia i zwraca jego parametry oraz błędy na odłożonych danych. -
inspect_residuals: pokazuje, gdzie obserwacje różnią się od predykcji modelu. -
compare_predictions: porównuje dopasowane modele pod proponowanymi warunkami eksperymentu.
Schemat compare_predictions trzyma pomiary potwierdzające poza narzędziem:
{"name": "compare_predictions", "strict": True,
"description": "Predict a new run from existing fits under proposed conditions and report how far the "
"predictions differ. initial_temp_c must be 75 to 115 and ambient_temp_c 20 to 25. "
"Returns predictions only; no new measurements are generated.",
"input_schema": {"type": "object", "additionalProperties": False,
"properties": {"initial_temp_c": {"type": "number"},
"ambient_temp_c": {"type": "number"},
"fit_ids": {"type": "array", "items": {"type": "string"}}},
"required": ["initial_temp_c", "ambient_temp_c", "fit_ids"]}}Wartości fit_ids odnoszą się do modeli dopasowanych wcześniej w tym samym dochodzeniu. Ścisłe schematy nie przyjmują minimum ani maximum, więc Python sam sprawdza zakresy temperatur. Zostaw tool_choice na auto, bo wymuszenie narzędzia zwraca błąd 400 w Fable 5.2.
Zbuduj pętlę narzędzi Claude’a
Aplikacja powtarza jeden cykl: wyślij rozmowę do Claude’a, uruchom żądane narzędzia Pythona i zwróć ich wyniki. Kontynuuje, aż wymagane porównania będą gotowe, a potem prosi Claude’a o raport końcowy w stałym formacie.
Napisz prompt do testowania hipotez
Prompt systemowy opisuje metodę bez sugerowania odpowiedzi. Główny prompt to:
SYSTEM = """You are a scientific investigator working on a controlled cooling experiment. You decide which
checks to run and how to read the results. Python tools do every numerical calculation.
How to work:
- Look at the measurements before you choose a model.
- Fit every candidate model with fit_hypothesis. Compare them on leave-one-run-out error as well as
training error, because a model with more parameters always fits the training runs at least as well.
- Use inspect_residuals to look for systematic patterns and to decide whether any single reading is
an outlier.
- Use only numbers that a tool returned. Do not invent measurements, parameters, or errors.
- Keep observed evidence separate from assumptions. The data can show which mathematical model fits
best; it cannot show the physical cause of a change.
- If the evidence does not separate the candidates, say so and treat the result as inconclusive.
..."""Najbardziej zależy mi na ostatnim punkcie. Bez niego model musi wskazać zwycięzcę nawet wtedy, gdy błędy są zbyt zbliżone, by rozstrzygać.
Utrzymuj pętlę narzędzi tylko z dopisaniem (append-only)
Każde wywołanie wysyła ten sam system i tools, a każda odpowiedź wraca niezmieniona. Ten fragment pokazuje obsługę wiadomości; pełna pętla z obsługą zatrzymań jest w repozytorium.
resp = client.messages.create(
model="claude-fable-5-2",
max_tokens=20_000,
system=SYSTEM,
tools=TOOLS, # all four, declared on the first request
thinking={"type": "adaptive", "display": "summarized"},
output_config={"effort": "high"},
cache_control={"type": "ephemeral"}, # automatic prompt caching
messages=messages,
)
messages.append({"role": "assistant", "content": resp.content}) # unchanged, thinking included
if resp.stop_reason == "tool_use":
results = []
for block in resp.content:
if block.type == "tool_use":
out, is_error = box.run(block.name, dict(block.input))
results.append({"type": "tool_result", "tool_use_id": block.id,
"content": out, "is_error": is_error})
messages.append({"role": "user", "content": results})Zachowane rozumowanie pozwala Claude’owi utrzymać wcześniejsze tok myślenia między turami, o ile system, tools i wcześniejsze wiadomości pozostają niezmienione. W Fable 5.2 edycja któregokolwiek z nich domyślnie zwraca błąd 400.
Możesz zmieniać output_config, tool_choice i max_tokens między wywołaniami, choć nowy format wyjścia i tak ominie cache promptu. Grupuj równoległe wyniki narzędzi w jednej wiadomości użytkownika, jak powyżej.
Ustaw limity żądań, czasu i kosztu
Python zlicza żądania, wywołania narzędzi, upływ czasu i koszt, i nie zacznie nowej pracy po osiągnięciu limitu. Żądanie już trwające może przekroczyć limit czasu lub kosztu, więc traktuj te dwa jako miękkie limity.
Przed przyjęciem odpowiedzi końcowej Python sprawdza też, czy Claude dopasował każdego kandydata, obejrzał reszty i porównał projekty potwierdzające. Jeśli Claude zatrzyma się z innego powodu niż żądanie narzędzia lub zakończona tura, dochodzenie kończy się jako nierozstrzygnięte. Ustaw max_tokens wystarczająco wysoko dla myślenia i odpowiedzi.
Zwróć ustrukturyzowany raport
Gdy kontrole przejdą, jedno kolejne żądanie prosi o ustrukturyzowane wyniki na tej samej historii, więc raport końcowy przychodzi jako zweryfikowany obiekt Pythona:
messages.append({"role": "user", "content": REPORT_PROMPT})
resp = client.messages.parse(
model="claude-fable-5-2", max_tokens=20_000, system=SYSTEM, tools=TOOLS,
thinking={"type": "adaptive", "display": "summarized"},
output_config={"effort": "high"},
output_format=InvestigationReport, # the SDK sends this as output_config.format
tool_choice={"type": "none"}, # tools stay declared, so the prefix check passes
messages=messages,
)
problems = validate(resp.parsed_output, box.fits) # fit IDs exist, all four covered, ranges holdPydantic sprawdza kształt raportu, a validate() potwierdza, że każdy cytowany fit istnieje i warunki mieszczą się w dozwolonym zakresie. Po tym wybór modelu i warunki są ostateczne.
Fable 5.2 wybiera model progu temperatury
Przeprowadziłem jedno dochodzenie przy wysiłku high. Oto jak Claude doszedł do odpowiedzi.
Prześledź sekwencję testów Claude’a
Claude zaczął od obejrzenia pomiarów. Zanim cokolwiek dopasował, jego podsumowanie brzmiało: „Zmiana pojawia się około 55 °C w każdym przebiegu: w minucie 12 w A, 19 w B i 22 w C. To wskazuje na próg, więc dopasuję wszystkie cztery”.
Nazwałbym to zakotwiczeniem: Claude przywiązał się do odpowiedzi przed jej testem. Późniejsze dopasowanie to potwierdziło, ze switchami koło minut 12, 18 i 22. Ślad w terminalu pokazuje kolejność pozostałych kontroli.
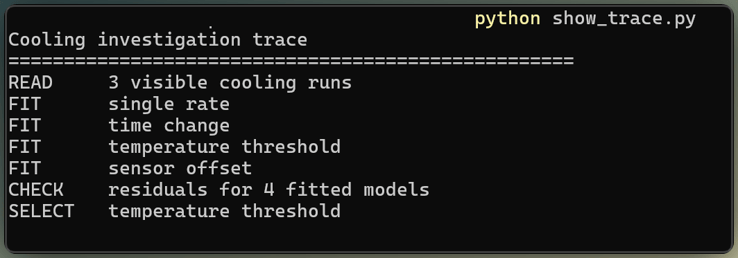
Ślad w terminalu pokazuje kolejność testów Claude’a. Ilustracja autora.
Porównaj błędy na danych odłożonych w czterech modelach
Treningowe RMSE mierzy każde dopasowanie na trzech przebiegach. Kolumny „held-out” uśredniają trzy testy LORO.
|
Kandydat |
Główne założenie |
Train RMSE (°C) |
Held-out MAE (°C) |
Held-out RMSE (°C) |
|
Single rate |
Jedno tempo przez cały przebieg |
4.08 |
3.90 |
4.60 |
|
Time change |
Wspólny przełącznik w okolicach 19. minuty |
1.92 |
2.17 |
2.63 |
|
Temperature threshold |
Wspólny przełącznik w okolicach 55 °C |
0.49 |
0.32 |
0.48 |
|
Sensor offset |
Narastający dryf pomiaru |
1.49 |
1.45 |
1.87 |
W modelu progu błędy treningowe i na danych odłożonych są zbliżone, więc dopasowanie przenosi się między przebiegami, choć trzy przebiegi nie wykluczają nadmiernego dopasowania ogólnie. Poniższy wykres reszt pokazuje obserwowaną temperaturę minus predykcję każdego modelu.
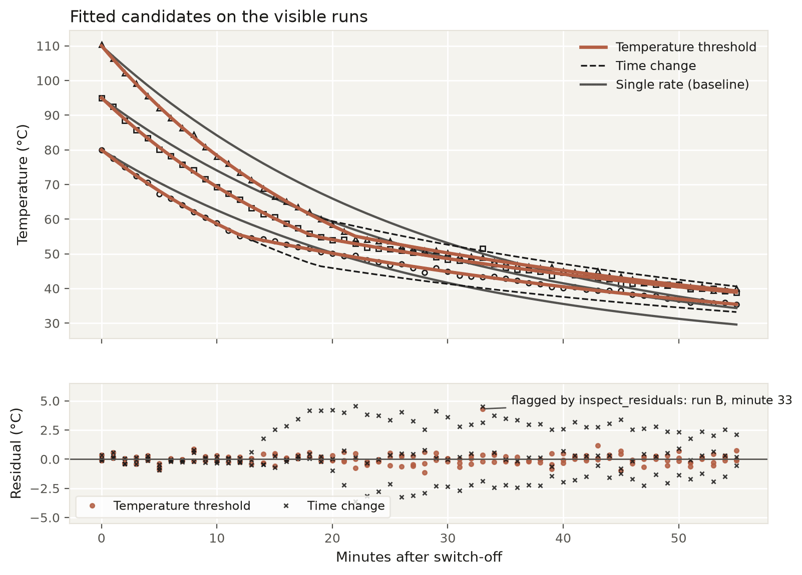
Reszty dla progu nie pokazują wzorca systematycznego. Ilustracja autora.
Dopasowanie „time-change” pasuje do przebiegu B. Po przełączeniu myli się w A o ok. +2,5 do +3,5 °C, a w C o -1,5 do -2,8 °C.
Bardziej niż sam ranking pomaga mi zmiana znaku: pokazuje, że przełączenie przychodzi wcześniej w A i później w C, tak jak przewiduje wyzwalacz temperaturowy. Model offsetu sensora zmniejsza część błędu, dodając dryf, ale jego błędy na danych odłożonych są większe.
Sprawdź uszkodzony odczyt
Agent nie wiedział, który odczyt zepsułem. Znalazł przebieg B, minuta 33, z resztą ok. +4,3 °C. Jego odporna statystyka z-score, która mierzy odległość od typowego rozrzutu reszt, przekraczała 12.
Claude pozostawił odczyt, bo soft L1 już ogranicza jego wpływ. Żeby to sprawdzić, dopasowałem wszystkie cztery modele bez niego. Model progu pozostał pierwszy z dużym zapasem, a jego estymata progu prawie się nie ruszyła.
Zaprojektuj eksperyment potwierdzający
Agent porównał predykcje kandydatów dla kilku temperatur startowych i pokojowych, a potem wybrał warunki bez oglądania nowych pomiarów.
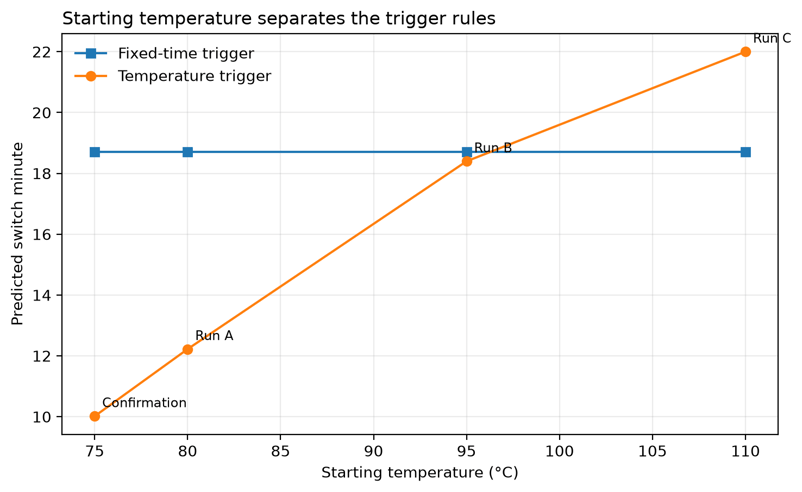
Temperatury startowe obnażają każdą regułę wyzwalacza. Ilustracja autora.
Wybierz warunki, które rozdzielają modele
Jak w TL;DR, agent wybrał start 75 °C i pokój 20 °C. Model progu przełącza w okolicach 10. minuty, a model czasu w okolicach 19. Krzywa offsetu sensora też pozostaje odseparowana od predykcji progu.
Ustawienie ze środka zakresu, blisko przebiegu B, rozdzieliłoby modele progu i czasu tylko o ok. 0,6 °C. Wybrane warunki leżą lekko poza testowanym zakresem i Claude to zaznaczył w raporcie.
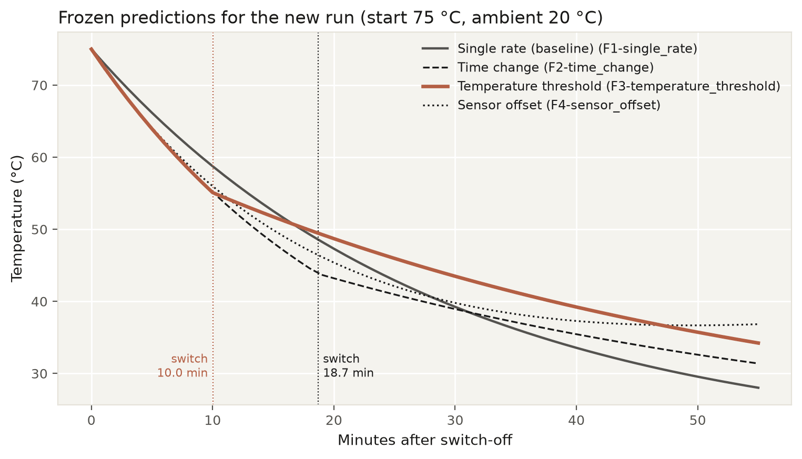
Predykcje kandydatów dla wybranego przebiegu. Ilustracja autora.
Zablokuj predykcje przed generowaniem danych
Zablokowałem wybrane warunki, dopasowane parametry i predykcje każdego kandydata, zanim wygenerowano jakiekolwiek nowe pomiary. Agent nie otrzymał pomiarów potwierdzających i nie mógł zrewidować odpowiedzi po wyniku.
Pomiary potwierdzające używają tego samego modelu szumu Gaussa, osobnego stałego ziarna i bez dodanego odstającego.
Oceń niewidoczny przebieg
Osobny kod Pythona ocenił zamrożone predykcje. Nigdy nie wywołuje API, więc Claude nie ma udziału w ocenianiu własnej odpowiedzi.
Oceń predykcje niezależnym Pythonem
Predykcja progu przeszła oba wcześniej ustalone testy. Na niewidocznym przebiegu uzyskała 0,27 °C MAE i 0,32 °C RMSE. Fixed-time osiągnął 3,67 °C RMSE, sensor offset 2,35 °C, a single-rate 4,28 °C.
Przebieg potwierdzający nie zawiera zasianego odstającego, co pomaga wyjaśnić niższy błąd względem wyników leave-one-run-out. Inna próbka szumu losowego też może się przyczyniać.
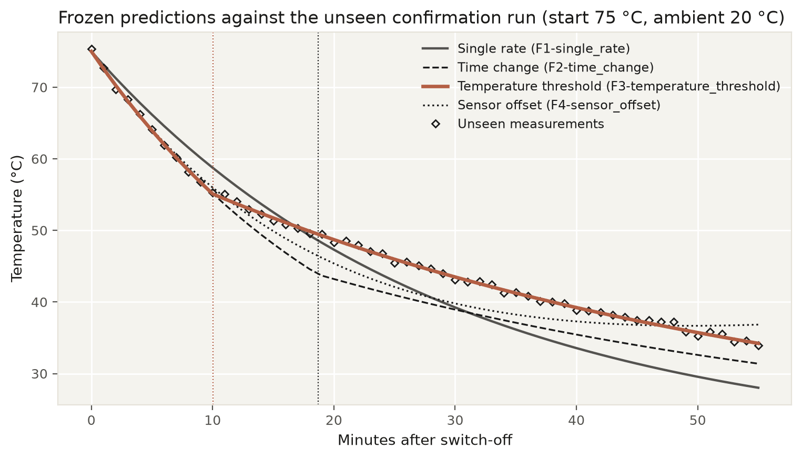
Zamrożone predykcje zgadzają się z niewidocznymi pomiarami. Ilustracja autora.
Porównaj dopasowane parametry z ukrytą prawdą
Po ocenie porównaj dopasowane parametry z ukrytymi wartościami generującymi:
import numpy as np
def true_curve(t0, ta, minutes, truth):
"""Newton cooling whose rate drops when the temperature crosses a threshold. Continuous at the switch."""
t = np.asarray(minutes, dtype=float)
k1, k2, th = truth["k_above"], truth["k_below"], truth["threshold_c"]
if t0 <= th:
return ta + (t0 - ta) * np.exp(-k2 * t)
t_cross = np.log((t0 - ta) / (th - ta)) / k1
fast = ta + (t0 - ta) * np.exp(-k1 * t)
slow = ta + (th - ta) * np.exp(-k2 * (t - t_cross)) # restarts from the threshold
return np.where(t <= t_cross, fast, slow)Symulator dodaje zasiany szum Gaussa wokół tej krzywej.
Ukrytą regułą był próg temperatury 55 °C, z tempami 0,045 i 0,020 na minutę oraz odchyleniem standardowym szumu 0,35 °C.
Dopasowane tempa zgadzają się do 3 miejsc po przecinku, próg mieści się w 0,1 °C, a przewidywany przełącznik w 0,1 minuty.
Dane identyfikują regułę matematyczną używaną przez symulator. Nie pokażą, czy prawdziwe urządzenie zwalniające przy ~55 °C przechodzi zmianę fazy, cykl wentylatora czy inną przyczynę fizyczną.
Przejrzyj, jak agent doszedł do odpowiedzi
Raport cytował identyfikatory fitów i numery narzędzi jako dowody i nazwał to, czego trzy przebiegi nie są w stanie ustalić. Słabym punktem jest wspomniany wczesny strzał. Jedno dochodzenie nie pokaże, jak często taki strzał się myli.
Obejrzyj dochodzenie w Streamlit
Na wideo uruchamiam przebieg na żywo, śledzę log narzędzi i po ocenie otwieram karty Raport, Krzywe, Potwierdzenie i Koszt.
Interfejs Streamlit pokazuje jedno dochodzenie. Wideo autora.
Zmierz koszt API Claude Fable 5.2
Dochodzenie, wraz z raportem końcowym, kosztowało ok. 0,49 USD i trwało nieco ponad minutę. SciPy działa na twojej maszynie, więc nie dodaje nic do rachunku API.
Samo żądanie raportu zajęło niemal połowę kosztu i czasu. Jak wspomniałem w sekcji o pętli narzędzi, nowy format wyjścia omija cache promptu, więc to ostatnie żądanie przetworzyło całą rozmowę od nowa przed napisaniem długiego raportu. Śledź osobno wejście niecache’owane, zapisy cache’u, odczyty cache’u i wyjście, bo każde ma swoją cenę.
Ograniczenia i kwestie praktyczne
Liczą się tu dwa rodzaje ograniczeń: co eksperyment może pokazać i czego potrzebuje kod, zanim będzie działał jako usługa.
Ograniczenia naukowe
Symulator i kandydat z progiem używają tego samego równania. Stopniowa zmiana w prawdziwym urządzeniu mogłaby nadal pasować do tego modelu, podążając inną krzywą.
Gdyby brakowało prawdziwej reguły, agent mógłby i tak wybrać najbliższy dostarczony model zamiast odpowiedzieć inconclusive. Więcej szumu lub próg ledwie przekroczony mogłyby sprawić, że błędy będą zbyt podobne, by rozróżnić. Inny przebieg może użyć innej kolejności narzędzi.
Przed produkcją
Ograniczenia z pętli narzędzi obejmują jedno dochodzenie na twojej maszynie. Usługa produkcyjna potrzebuje więcej:
- Ustaw ponowienia SDK i timeouty żądań dla usługi.
- Waliduj w Pythonie każdy wkład i wynik narzędzia.
- Loguj model, wersję SDK, powód zatrzymania, tokeny, opóźnienie i koszt dla każdego żądania.
- Przypnij wersje modelu i SDK, ponownie uruchom ukryty test i potwierdź politykę retencji 30 dni przed aktualizacją.
Kiedy ten wzorzec pasuje
Użyj go, gdy pasuje kilka wyjaśnień, Python może je testować, a ukryty eksperyment potrafi ocenić wybór — szczególnie gdy kolejny eksperyment kosztuje więcej niż wywołanie API.
Użyj czystego Pythona, gdy znasz rodzinę modeli. Wskazówki do modelu Fable 5.2 od Anthropic zalecają najpierw spróbować Opus i testować Fable, gdy Opus nie spełni wymogu.
Końcowe przemyślenia
Zbudowaliśmy agenta, który porównał cztery modele chłodzenia, wybrał próg temperatury, zaprojektował przebieg potwierdzający i przewidział pomiary, których nigdy nie widział. Dla tego syntetycznego urządzenia odpowiedź na moje pytanie otwierające brzmi: tak.
Nie rozciągałbym tego na prawdziwy sprzęt ani otwarte odkrycia. Jak omawiałem przy ograniczeniach, wśród kandydatów było równanie samego symulatora, a agenta uruchomiłem raz.
To, co się przenosi, to metoda: ukryj prawdę, ustal zasady punktacji przed pierwszym żądaniem, zamroź predykcje i użyj osobnego ewaluatora. Przydatnym kolejnym testem byłoby dodanie modelu z płynną tranzycją i powtórzenie dochodzenia przy różnych poziomach szumu.
W wyborze modelu nasz kurs Wprowadzenie do modeli Claude omawia ofertę Claude’a i jej kompromisy.
FAQs
Czy mogę wyłączyć myślenie lub ustawić budżet myślenia w Claude Fable 5.2?
Nie. Adaptacyjne myślenie jest zawsze włączone, a zarówno thinking: {type: "disabled"}, jak i budget_tokens zwracają błąd 400. Zamiast tego kontroluj, ile myśli, parametrem effort, który domyślnie wynosi high. Tokeny myślenia są rozliczane jako wyjście i liczą się do max_tokens.
Dlaczego Claude Fable 5.2 zwraca błąd 400 po edycji wcześniejszych wiadomości?
Każdy blok myślenia jest ważny tylko względem promptu systemowego, narzędzi i wiadomości, które go poprzedzały, i Fable 5.2 sprawdza to przy każdym koncie. Utrzymuj rozmowę tylko z dopisywaniem i zamroź system i tools na czas sesji. Doraźnie ustawienie prefix_mismatch_behavior na "drop_block" z nagłówkiem beta odrzuca dotknięte bloki zamiast zgłaszać błąd.
Czy mogę wymusić, by Claude Fable 5.2 wywołał konkretne narzędzie?
Nie. Ustawienie tool_choice na any lub na nazwane narzędzie zwraca błąd 400; działają tylko auto i none. Nazwij narzędzie w instrukcji i ustaw strict: true, aby wywołanie zgadzało się ze schematem. Jeśli wywołanie jest wymagane, użyj systemowego komunikatu w środku rozmowy.
Co się dzieje, gdy Claude Fable 5.2 odmawia realizacji żądania?
Odpowiedź wraca ze stop_reason: "refusal", a stop_details.category mówi, która ochrona została wyzwolona. Możesz sam ponowić na innym modelu albo włączyć fallback po stronie serwera ustawieniem fallbacks: "default", betą, która ponawia na Claude Opus 4.8 lub Claude Opus 5. Model zapasowy nie dostaje bloków myślenia Fable 5.2.
Czy mogę używać Claude Fable 5.2 z zerową retencją danych?
Nie domyślnie. Fable 5.2 wymaga 30-dniowej retencji danych, a żądania API z organizacji lub przestrzeni roboczej bez niej zwracają błąd 400. W ramach ustaleń ZDR włącz 30-dniową retencję dla workspace’a lub skontaktuj się z zespołem Anthropic ds. kont.
Czy Batch API może zastąpić pętlę narzędzi z tego eksperymentu?
Nie. Każdy krok narzędzia potrzebuje poprzedniej odpowiedzi, więc Batch API nie zastąpi bezpośrednio tej pętli. Jego 50% zniżki pasuje do niezależnych żądań lub równoległych ewaluacji.
Modele językowe świetnie brzmią, jakby dochodziły do odpowiedzi logicznie. Sprawdzenie, czy faktycznie tak było, jest trudniejsze. W większości zadań model albo już widział coś podobnego, albo nikt nie jest w stanie zweryfikować odpowiedzi. Dlatego zbudowałem test, w którym odpowiedź pozostaje ukryta.
Claude Fable 5.2 dostaje zaszumione odczyty z symulowanego urządzenia, które stygnie po wyłączeniu, oraz 4 możliwe wyjaśnienia, czemu tempo stygnięcia spowalnia w pewnym momencie. Musi wybrać jedno, zaprojektować eksperyment potwierdzający i zadeklarować predykcję, zanim zobaczy choć jeden nowy pomiar. Osobny kod w Pythonie ocenia predykcję, a Claude nigdy go nie dotyka.
Urządzenie chłodzące to tylko przypadek testowy. Kluczowy jest układ: ukryj prawdę przed modelem, ustal zasady punktacji przed pierwszym wywołaniem API, zamroź jego przewidywania i oceń je kodem, którego nie widzi. Możesz to wykorzystać w dowolnym problemie „które wyjaśnienie jest poprawne?”, od analizy przyczyn źródłowych po czytanie testów A/B.
W tym samouczku zbudujesz takiego agenta w Pythonie. SciPy robi matematykę; Claude decyduje, który test uruchomić dalej i jakie wyciągnąć wnioski. Jeśli czujesz się swobodnie z funkcjami Pythona i zapytaniami do API, nadążysz — a ja wyjaśniam matematykę chłodzenia, gdy tylko się pojawi. Omówimy, jak:
Nasz przegląd Claude Fable 5.2 omawia premierę i benchmarki, więc tutaj trzymam się API i testu chłodzenia. Eksperyment uruchomiłem dzień po premierze.
TL;DR
Dałem Fable 5.2 zaszumione dane z symulowanego urządzenia, którego chłodzenie spowalnia w połowie, plus cztery możliwe wyjaśnienia. Musiał wybrać jedno, zaprojektować nowy eksperyment i przewidzieć wynik, zanim go zobaczy.