

Concevoir l'expérience et le harnais
Mon implémentation associe Claude à quatre fonctions Python, appelées outils, que je montrerai après le jeu de données. Le code complet et l'interface Streamlit optionnelle se trouvent dans le dépôt GitHub.
Définir les quatre modèles de refroidissement
La loi du refroidissement de Newton dit qu'un objet refroidit plus vite lorsqu'il est bien plus chaud que la pièce, puis ralentit à mesure que l'écart diminue. L'équation est T(t) = Ta + (T0 - Ta) * exp(-k * t). Ici, T0 est la température initiale, Ta la température ambiante, et k le taux de refroidissement par minute.
J'ai écrit quatre familles de modèles parmi lesquels l'agent peut choisir :
-
Taux unique : un seul
ksur toute la durée, utilisé comme référence -
Changement dans le temps : deux taux, avec bascule à la même minute écoulée pour chaque essai
-
Seuil de température : deux taux, avec bascule à une température commune, donc à une minute différente selon l'essai
-
Décalage capteur : un taux réel constant, plus une erreur de sonde qui commence en cours de route et croît
Séparer mesures visibles et vérité cachée
Claude voit trois séries de refroidissement et ce que retournent les outils. Les vrais taux, le seuil, les réglages de données et les mesures de confirmation restent hors d'accès pour ses outils.
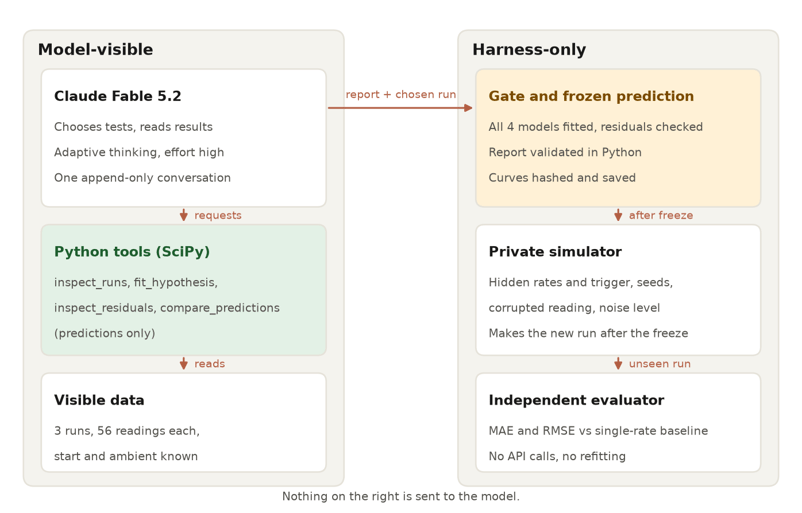
Claude accède aux outils ; la vérité reste cachée. Image de l'auteur.
Tout ce qui entoure Claude en Python constitue le harnachement d'agent. Outre l'exécution des outils, il plafonne les requêtes, le temps et les dépenses, comme je le détaillerai avec la boucle d'outils.
Avant le premier appel d'API, j'ai fixé les modèles candidats, les bornes de paramètres, les limites et la règle de réussite pour la nouvelle expérience : une RMSE d'au plus 1,0 °C et au plus la moitié de celle du modèle de référence à taux unique. Ces règles sont restées figées.
Configurer Claude Fable 5.2 en Python
La configuration requiert un environnement virtuel et une clé d'API. Le modèle claude-fable-5-2 peut lire jusqu'à 1 M de tokens de prompt et d'historique de conversation, puis retourner jusqu'à 128 K tokens en sortie.
Le raisonnement adaptatif, où le modèle décide de l'effort de réflexion avant de répondre, est toujours activé, et l'API est par défaut en effort élevé. La tarification de l'API Claude est de 8 $ par million de tokens en entrée et 40 $ par million de tokens en sortie, avec des écritures de cache de prompt sur cinq minutes à 10 $ et des lectures à 0,20 $.
Vous avez besoin :
-
De Python 3.12+, car NumPy 2.5.4 et SciPy 1.18.1 l'exigent (le package Anthropic lui-même prend en charge 3.10)
-
D'une clé d'API avec accès à
claude-fable-5-2 -
anthropic2.7.0, la version qui a ajouté l'ID du modèle
Clonez le projet et installez ses dépendances figées. Sous macOS ou Linux, créez l'environnement avec python3.12 -m venv .venv, activez-le avec source .venv/bin/activate, et remplacez Copy-Item par cp.
git clone https://github.com/KhalidAbdelaty/claude-fable-5-2-api.git
cd claude-fable-5-2-api
py -3.12 -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env # then paste your key after ANTHROPIC_API_KEY=Le code charge la clé d'API depuis l'environnement sans l'afficher. Le README du dépôt liste les commandes pour l'expérience complète, et seules deux d'entre elles appellent l'API. Notre guide de l'API Claude couvre de manière générale les clés et la facturation.
Envoyer votre première requête API à Fable 5.2
Passez cette section si vous avez déjà appelé Claude depuis Python. Cette requête se concentre sur les éléments qui distinguent les deux hypothèses.
import anthropic
from dotenv import load_dotenv
load_dotenv(".env", override=True)
client = anthropic.Anthropic() # reads ANTHROPIC_API_KEY
response = client.messages.create(
model="claude-fable-5-2",
max_tokens=4096,
output_config={"effort": "high"},
messages=[{"role": "user", "content": (
"Three cooling runs start at 80, 95, and 110 C. Each seems to slow down partway through. "
"In three short bullets: what pattern across the runs would point to a change after a fixed "
"time, what pattern would point to a change at a fixed temperature, and what the data alone "
"cannot tell us.")}],
)
print("block types:", [block.type for block in response.content])
print("stop reason:", response.stop_reason)
print("".join(block.text for block in response.content if block.type == "text"))Claude renvoie une liste de blocs de contenu typés, donc lisez le texte par type de bloc ; content[0] peut être un bloc de raisonnement. Voici la première réponse :
block types: ['thinking', 'text']
stop reason: end_turn
- **Fixed time:** the slowdown appears at the same elapsed time in all three runs but at different temperatures, with the hotter-start runs still hotter when it happens.
- **Fixed temperature:** the slowdown appears at the same temperature in all three runs but at different elapsed times, with the hotter-start runs reaching it later.
- **What the data cannot tell us:** the cause. A matching pattern shows what the change tracks, not why it happens (for example a phase change, a setup artifact, or a shift in the surroundings). Since cooling naturally slows as it nears room temperature, the data also cannot show on its own that there is a distinct change rather than a smooth curve.Des blocs thinking et text sont apparus. Les tokens de raisonnement comptent comme tokens de sortie, donc incluez-les dans l'estimation du coût. Le guide de migration de Claude Fable 5.2 indique que budget_tokens, thinking disabled, temperature, top_p et top_k renvoient une erreur 400.
Créer un jeu de données de refroidissement sans fuite d'information
Les données doivent être suffisamment désordonnées pour nécessiter un ajustement de modèle, et la réponse doit rester hors de portée de Claude.
Simuler trois essais de refroidissement
J'ai simulé trois essais à partir de la loi de Newton, avec un changement continu et caché du refroidissement. L'essai A démarre à 80 °C dans une pièce à 21,0 °C, B à 95 °C dans 24,0 °C, et C à 110 °C dans 22,5 °C. Un générateur aléatoire NumPy fixé ajoute un bruit gaussien, et une mesure reçoit volontairement une erreur supplémentaire.
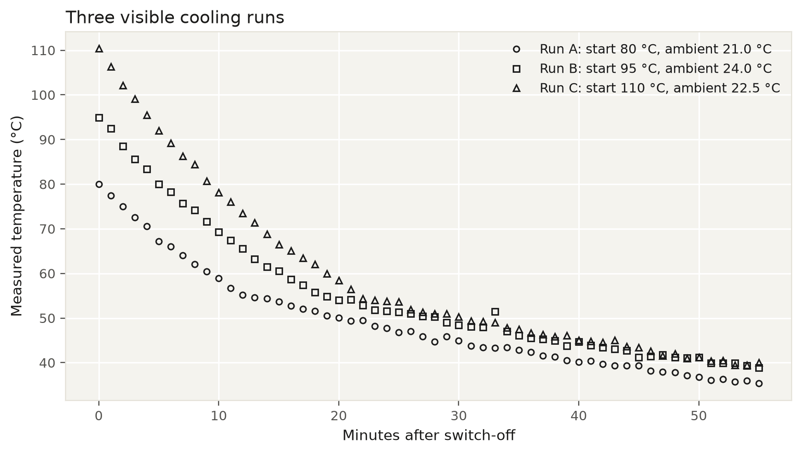
Trois essais bruités avec une valeur aberrante. Image de l'auteur.
L'essai A refroidit plus vite au début qu'à la fin. Ce motif seul ne prouve pas un changement discret car toute exponentielle ralentit près de la température ambiante.
L'essai B contient un saut isolé d'environ 4 °C, alors que les écarts voisins ailleurs restent en dessous de 1,2 °C. Chaque coude s'étale sur plusieurs minutes bruitées, donc l'inspection visuelle ne permet pas de trancher entre les modèles « temps » et « seuil ».
Tester des hypothèses de refroidissement avec des outils Python
Python ajuste chaque candidat selon les mêmes règles et renvoie ses paramètres et erreurs. Claude ne voit jamais le code d'ajustement, seulement ce que renvoie chaque outil.
Ajuster des paramètres partagés sans qu'un outlier ne domine
Ajuster consiste à choisir des valeurs de paramètres qui rapprochent chaque courbe prédite de ses mesures. J'utilise la perte L1 souple (soft L1) car elle réduit l'influence d'une grande erreur sans supprimer la lecture.
Tous les essais partagent les paramètres ajustés, tandis que chaque essai conserve sa température de départ et sa température ambiante. Pour le modèle à seuil, cela donne à chaque essai son propre instant de bascule, ln((T0 - Ta) / (threshold - Ta)) / k_above.
La fonction least_squares() de SciPy cherche les paramètres qui s'ajustent au mieux, tandis que les bornes maintiennent les taux et points de bascule dans les plages fixées avant le run.
L'extrait ci-dessous montre l'appel au solveur et les vérifications de convergence. La fonction de résidus et le balayage de grille autour sont dans le dépôt.
from scipy.optimize import least_squares
def _solve(hypothesis, names, x0, lo, hi, runs):
# soft L1: residuals under f_scale count roughly squared, larger ones roughly linearly
return least_squares(_residuals, x0, bounds=(lo, hi), method="trf",
loss="soft_l1", f_scale=0.5, args=(hypothesis, names, runs))
# scan the change point in 0.5 steps with the rates fitted at each step, then refine all three
res = _solve(hypothesis, names, best_grid_point, lo, hi, runs)
converged = bool(res.success and res.status > 0 and np.all(np.isfinite(res.x)))
at_bound = [n for n, v, a, b in zip(names, res.x, lo, hi) if min(v - a, b - v) < 1e-4 * (b - a)]J'ai fixé f_scale à 0,5 °C avant le run. Les résidus supérieurs à cette valeur commencent à perdre de l'influence sous soft L1. Un balayage de grille sur le point de bascule donne au solveur une valeur de départ sensée.
Valider les modèles avec des tests leave-one-run-out
La MAE est l'écart moyen en °C. La RMSE met au carré les erreurs d'abord, donc les erreurs plus grandes comptent davantage.
L'erreur d'entraînement favorise les modèles avec plus de paramètres. La validation croisée estime l'erreur tenue à l'écart en faisant tourner les données exclues. Ici, la validation leave-one-run-out (LORO) ajuste sur deux essais et prédit le troisième.
Définir les schémas d'appel d'outils de Claude
Un schéma d'outil est une description JSON d'une fonction Python et des arguments que Claude peut envoyer. L'usage strict des outils fait vérifier cette forme par l'API avant l'exécution Python.
Claude peut demander quatre outils :
-
inspect_runs: renvoie les mesures visibles et des synthèses de pente simples. -
fit_hypothesis: ajuste un modèle de refroidissement et retourne ses paramètres et erreurs tenues à l'écart. -
inspect_residuals: met en évidence où les températures observées diffèrent des prédictions. -
compare_predictions: compare des modèles ajustés selon des conditions d'expérience proposées.
Le schéma compare_predictions maintient les mesures de confirmation hors de l'outil :
{"name": "compare_predictions", "strict": True,
"description": "Predict a new run from existing fits under proposed conditions and report how far the "
"predictions differ. initial_temp_c must be 75 to 115 and ambient_temp_c 20 to 25. "
"Returns predictions only; no new measurements are generated.",
"input_schema": {"type": "object", "additionalProperties": False,
"properties": {"initial_temp_c": {"type": "number"},
"ambient_temp_c": {"type": "number"},
"fit_ids": {"type": "array", "items": {"type": "string"}}},
"required": ["initial_temp_c", "ambient_temp_c", "fit_ids"]}}Les valeurs fit_ids renvoient à des modèles ajustés plus tôt dans la même investigation. Les schémas stricts n'acceptent pas minimum ou maximum, donc Python vérifie lui-même les plages de température. Laissez tool_choice en auto, car forcer un outil renvoie une erreur 400 sur Fable 5.2.
Construire la boucle d'outils de Claude
L'application répète un cycle : envoyer la conversation à Claude, exécuter les outils Python demandés, puis retourner leurs résultats. Elle continue jusqu'à ce que les comparaisons requises soient terminées, puis demande à Claude un rapport final dans un format fixe.
Rédiger un prompt pour tester des hypothèses
Le prompt système décrit la méthode sans suggérer de réponse. Le cœur du prompt :
SYSTEM = """You are a scientific investigator working on a controlled cooling experiment. You decide which
checks to run and how to read the results. Python tools do every numerical calculation.
How to work:
- Look at the measurements before you choose a model.
- Fit every candidate model with fit_hypothesis. Compare them on leave-one-run-out error as well as
training error, because a model with more parameters always fits the training runs at least as well.
- Use inspect_residuals to look for systematic patterns and to decide whether any single reading is
an outlier.
- Use only numbers that a tool returned. Do not invent measurements, parameters, or errors.
- Keep observed evidence separate from assumptions. The data can show which mathematical model fits
best; it cannot show the physical cause of a change.
- If the evidence does not separate the candidates, say so and treat the result as inconclusive.
..."""Je tiens surtout au dernier point. Sans lui, le modèle doit nommer un vainqueur même quand les erreurs sont trop proches pour trancher.
Garder la boucle d'outils en ajout seul
Chaque appel envoie les mêmes system et tools, et chaque réponse repart inchangée. Cet extrait montre la gestion des messages ; la boucle complète avec gestion des arrêts est dans le dépôt.
resp = client.messages.create(
model="claude-fable-5-2",
max_tokens=20_000,
system=SYSTEM,
tools=TOOLS, # all four, declared on the first request
thinking={"type": "adaptive", "display": "summarized"},
output_config={"effort": "high"},
cache_control={"type": "ephemeral"}, # automatic prompt caching
messages=messages,
)
messages.append({"role": "assistant", "content": resp.content}) # unchanged, thinking included
if resp.stop_reason == "tool_use":
results = []
for block in resp.content:
if block.type == "tool_use":
out, is_error = box.run(block.name, dict(block.input))
results.append({"type": "tool_result", "tool_use_id": block.id,
"content": out, "is_error": is_error})
messages.append({"role": "user", "content": results})La préservation du raisonnement permet à Claude de conserver ses réflexions d'un tour à l'autre, tant que system, tools et les messages précédents restent inchangés. Sur Fable 5.2, modifier l'un d'eux renvoie une erreur 400 par défaut.
Vous pouvez modifier output_config, tool_choice et max_tokens entre les appels, bien qu'un nouveau format de sortie n'exploite pas le cache de prompt. Regroupez les résultats d'outils parallèles dans un seul message utilisateur, comme ci-dessus.
Fixer des limites de requêtes, de temps et de dépenses
Python compte les requêtes, les appels d'outils, le temps écoulé et les dépenses, et il ne lance pas de nouveau travail une fois la limite atteinte. Une requête déjà en cours peut toutefois dépasser la limite de temps ou de coût ; considérez donc ces deux dernières comme souples.
Avant d'accepter une réponse finale, Python vérifie aussi que Claude a ajusté chaque candidat, inspecté les résidus et comparé des conceptions de confirmation. Si Claude s'arrête pour une autre raison qu'une demande d'outil ou une fin de tour, l'investigation est jugée non concluante. Réglez max_tokens assez haut pour couvrir le raisonnement et la réponse.
Renvoyer un rapport structuré
Une fois les contrôles validés, une requête supplémentaire demande des sorties structurées sur le même historique, de sorte que le rapport final arrive comme un objet Python validé :
messages.append({"role": "user", "content": REPORT_PROMPT})
resp = client.messages.parse(
model="claude-fable-5-2", max_tokens=20_000, system=SYSTEM, tools=TOOLS,
thinking={"type": "adaptive", "display": "summarized"},
output_config={"effort": "high"},
output_format=InvestigationReport, # the SDK sends this as output_config.format
tool_choice={"type": "none"}, # tools stay declared, so the prefix check passes
messages=messages,
)
problems = validate(resp.parsed_output, box.fits) # fit IDs exist, all four covered, ranges holdPydantic vérifie la structure du rapport, et validate() confirme que chaque ajustement cité existe et que les conditions restent dans la plage autorisée. Après cela, le choix du modèle et les conditions sont définitifs.
Fable 5.2 choisit le modèle à seuil de température
J'ai mené une investigation en high effort. Voici comment Claude est arrivé à sa réponse.
Suivre la séquence de tests de Claude
Claude a commencé par inspecter les mesures. Avant tout ajustement, son résumé disait : « Le changement apparaît vers 55 °C dans chaque essai : à la minute 12 pour A, 19 pour B et 22 pour C. Cela pointe vers un seuil, donc je vais ajuster les quatre ».
J'appelle cela de l'ancrage : Claude s'est engagé sur une réponse avant de la tester. L'ajustement ultérieur a confirmé, avec des bascules vers les minutes 12, 18 et 22. La trace en terminal montre l'ordre des contrôles restants.
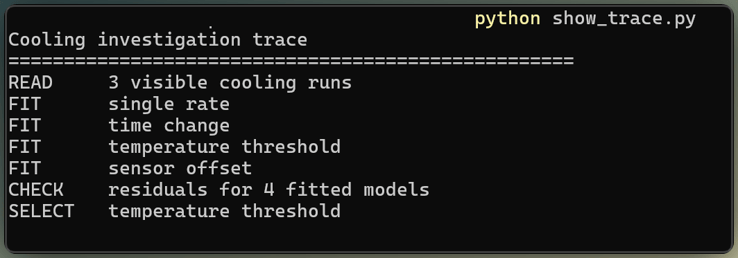
La trace terminale montre l'ordre des tests de Claude. Image de l'auteur.
Comparer les erreurs tenues à l'écart sur quatre modèles
La RMSE d'entraînement mesure chaque ajustement sur les trois essais. Les colonnes tenues à l'écart moyennent les trois tests LORO.
|
Candidat |
Hypothèse principale |
RMSE entraînement (°C) |
MAE tenue à l'écart (°C) |
RMSE tenue à l'écart (°C) |
|
Taux unique |
Un seul taux sur toute la durée |
4,08 |
3,90 |
4,60 |
|
Changement dans le temps |
Bascule partagée vers la minute 19 |
1,92 |
2,17 |
2,63 |
|
Seuil de température |
Bascule partagée vers 55 °C |
0,49 |
0,32 |
0,48 |
|
Décalage capteur |
Une dérive de mesure croissante |
1,49 |
1,45 |
1,87 |
Pour le modèle à seuil, les erreurs d'entraînement et tenues à l'écart sont proches, donc l'ajustement se transfère d'un essai à l'autre, même si trois essais ne suffisent pas à exclure le surapprentissage en général. Le graphique de résidus ci-dessous montre la température observée moins la prédiction de chaque modèle.
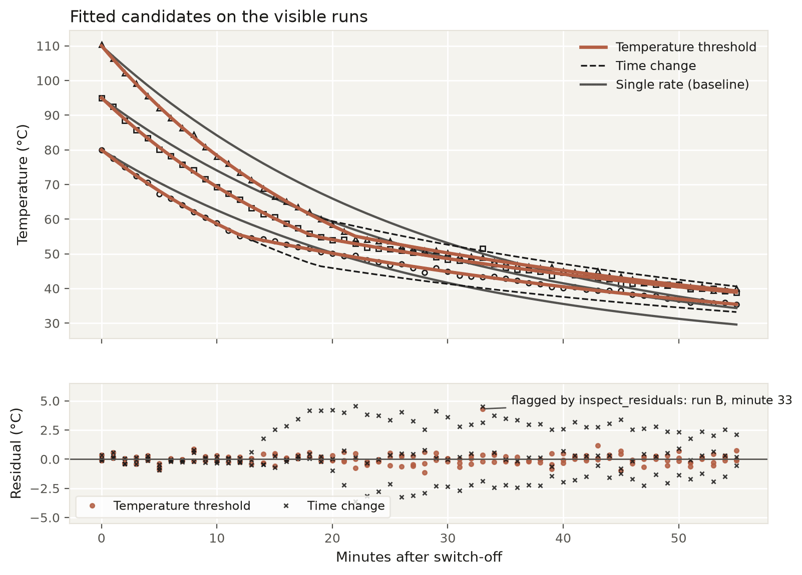
Les résidus du modèle à seuil ne montrent pas de motif systématique. Image de l'auteur.
L'ajustement « changement dans le temps » colle à l'essai B. Après la bascule, il manque l'essai A d'environ +2,5 à +3,5 °C et l'essai C d'environ -1,5 à -2,8 °C.
Je trouve le changement de signe plus parlant que le classement seul : il montre que la bascule arrive plus tôt pour A et plus tard pour C, comme le prédit un déclencheur par température. Le modèle « décalage capteur » réduit une partie de l'erreur en ajoutant de la dérive, mais ses erreurs tenues à l'écart restent plus élevées.
Vérifier la lecture corrompue
L'agent ne savait pas quelle lecture j'avais corrompue. Il a repéré l'essai B, minute 33, avec un résidu d'environ +4,3 °C. Son z-score robuste, qui mesure l'écart à la dispersion typique des résidus, dépassait 12.
Claude a conservé la lecture, puisque soft L1 limite déjà son influence. Pour vérifier ce choix, j'ai réajusté les quatre modèles sans elle. Le modèle à seuil est resté premier de loin, et son estimation de seuil a à peine bougé.
Concevoir une expérience de confirmation
L'agent a comparé les prédictions des candidats à travers plusieurs températures de départ et ambiantes, puis choisi des conditions sans voir aucune nouvelle mesure.
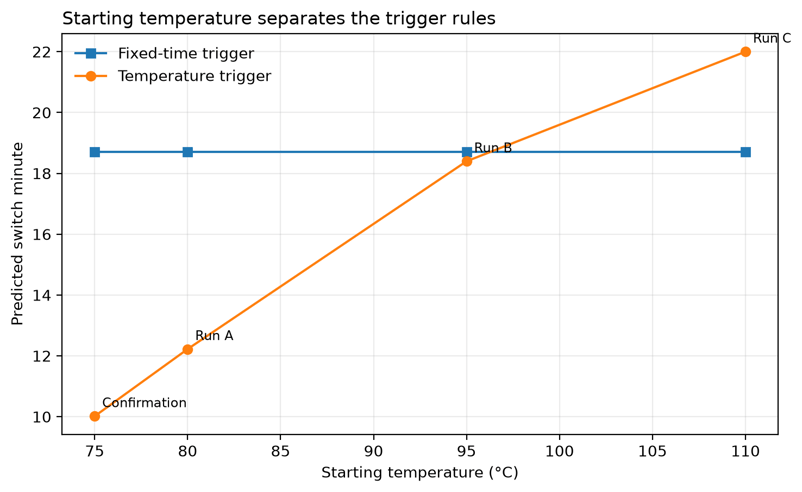
Les températures de départ révèlent chaque règle de déclenchement. Image de l'auteur.
Choisir des conditions qui séparent les modèles
Comme indiqué dans le TL;DR, l'agent a choisi un départ à 75 °C et une pièce à 20 °C. Le modèle à seuil bascule vers la minute 10, tandis que le modèle « temps » bascule vers la minute 19. La courbe « décalage capteur » reste également distincte de la prédiction à seuil.
Un réglage intermédiaire proche de l'essai B ne séparerait les modèles seuil et temps que d'environ 0,6 °C. Les conditions choisies se situent légèrement en dehors de la plage testée, et Claude l'a signalé dans son rapport.
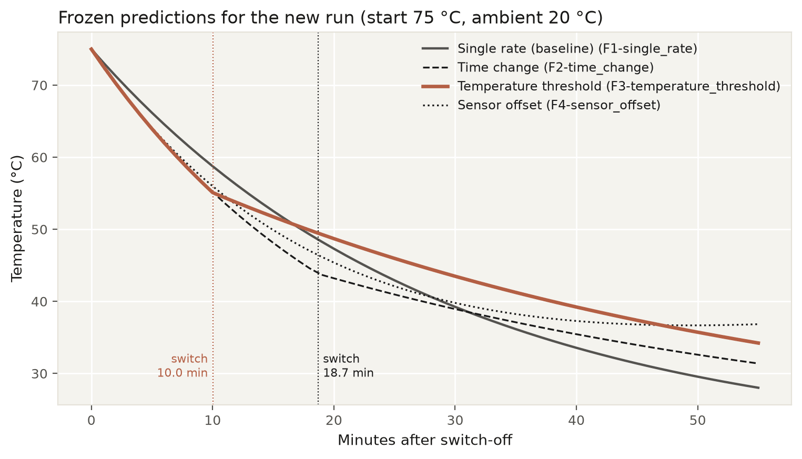
Prédictions candidates pour l'essai choisi. Image de l'auteur.
Verrouiller les prédictions avant de générer les données
J'ai verrouillé les conditions choisies, les paramètres ajustés et la prédiction de chaque candidat avant de générer de nouvelles mesures. L'agent n'a pas reçu les mesures de confirmation et ne pouvait pas réviser sa réponse après le résultat.
Les mesures de confirmation utilisent le même bruit gaussien, une graine fixe séparée, et aucun outlier ajouté.
Noter l'essai non vu
Un code Python indépendant a noté les prédictions gelées. Il n'appelle jamais l'API, donc Claude ne participe pas à la notation de sa propre réponse.
Évaluer les prédictions avec un Python indépendant
La prédiction à seuil a réussi les deux tests préétablis. Sur l'essai non vu, elle obtient 0,27 °C de MAE et 0,32 °C de RMSE. « Temps fixe » obtient 3,67 °C de RMSE, « décalage capteur » 2,35 °C, et « taux unique » 4,28 °C.
L'essai de confirmation ne contient pas d'outlier injecté, ce qui aide à expliquer son erreur plus faible par rapport aux résultats leave-one-run-out. Un autre échantillon de bruit aléatoire peut aussi jouer.
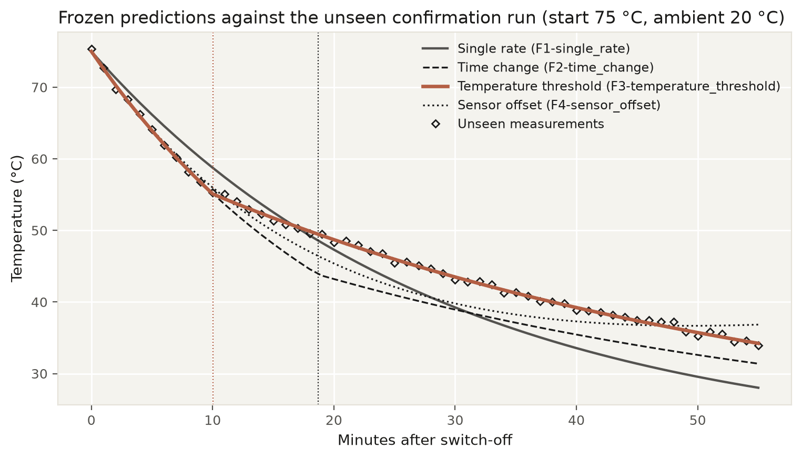
Les prédictions gelées correspondent aux mesures non vues. Image de l'auteur.
Comparer paramètres ajustés et vérité cachée
Après notation, comparez les paramètres ajustés aux valeurs génératrices cachées :
import numpy as np
def true_curve(t0, ta, minutes, truth):
"""Newton cooling whose rate drops when the temperature crosses a threshold. Continuous at the switch."""
t = np.asarray(minutes, dtype=float)
k1, k2, th = truth["k_above"], truth["k_below"], truth["threshold_c"]
if t0 <= th:
return ta + (t0 - ta) * np.exp(-k2 * t)
t_cross = np.log((t0 - ta) / (th - ta)) / k1
fast = ta + (t0 - ta) * np.exp(-k1 * t)
slow = ta + (th - ta) * np.exp(-k2 * (t - t_cross)) # restarts from the threshold
return np.where(t <= t_cross, fast, slow)Le simulateur ajoute un bruit gaussien à graine fixe autour de cette courbe.
La règle cachée était un seuil de température à 55 °C, avec des taux de 0,045 et 0,020 par minute et un écart-type du bruit de 0,35 °C.
Les taux ajustés correspondent à 3 décimales près, le seuil est à moins de 0,1 °C, et l'instant de bascule prédit à moins de 0,1 minute.
Les données identifient la règle mathématique utilisée par le simulateur. Elles ne montrent pas si, sur un appareil réel, un ralentissement près de 55 °C implique un changement de phase, un cycle de ventilation ou une autre cause physique.
Revoir le cheminement de l'agent
Le rapport citait des IDs d'ajustement et des numéros d'outils comme preuves, et mentionnait ce que trois essais ne permettent pas d'établir. Le point faible est l'hypothèse initiale évoquée plus haut. Une seule investigation ne permet pas de savoir à quelle fréquence ce genre d'intuition se trompe.
Voir l'investigation dans Streamlit
Dans la vidéo, je lance un run en direct, je suis le journal des outils et j'ouvre les onglets Report, Curves, Confirmation et Cost après la notation.
L'interface Streamlit montre une investigation. Vidéo de l'auteur.
Mesurer le coût API de Claude Fable 5.2
L'investigation, rapport final inclus, a coûté environ 0,49 $ et a pris un peu plus d'une minute. SciPy s'exécute sur votre machine, donc n'ajoute rien à la facture API.
La seule requête de rapport a pris presque la moitié du coût et du temps. Comme mentionné dans la section boucle d'outils, un nouveau format de sortie n'utilise pas le cache de prompt, donc cette dernière requête a retraité toute la conversation avant de rédiger un long rapport. Suivez séparément l'entrée non mise en cache, les écritures et lectures de cache, et la sortie, car chacun a son propre prix.
Limites et aspects pratiques
Deux types de limites comptent ici : ce que l'expérience peut montrer, et ce dont le code a besoin avant de tourner en service.
Limites scientifiques
Le simulateur et le candidat à seuil utilisent la même équation. Un basculement progressif sur un appareil réel pourrait encore s'ajuster à ce modèle tout en suivant une courbe différente.
Si la vraie règle manquait, l'agent pourrait malgré tout choisir le modèle fourni le plus proche plutôt que de répondre inconclusive. Plus de bruit ou un seuil à peine franchi pourraient rendre les erreurs trop proches pour trancher. Un autre run peut suivre un ordre d'outils différent.
Avant la production
Les limites de la boucle d'outils couvrent une investigation sur votre machine. Un service de production nécessite davantage :
- Configurer les retries du SDK et les timeouts de requête pour le service.
- Valider chaque entrée et sortie d'outil en Python.
- Journaliser le modèle, la version du SDK, la raison d'arrêt, les tokens, la latence et le coût pour chaque requête.
- Figer les versions du modèle et du SDK, relancer le test caché et confirmer la politique de rétention à 30 jours avant une mise à niveau.
Quand appliquer ce schéma
Utilisez ce schéma lorsque plusieurs explications sont plausibles, que Python peut les tester et qu'une expérience cachée peut évaluer le choix, notamment quand l'expérience suivante coûte plus cher que l'appel d'API.
Utilisez du Python pur quand vous connaissez la famille de modèles. Les recommandations du modèle Fable 5.2 chez Anthropic conseillent d'essayer d'abord Opus et de tester Fable quand Opus ne remplit pas le besoin.
Dernières réflexions
Nous avons construit un agent qui a comparé quatre modèles de refroidissement, choisi un seuil de température, conçu un essai de confirmation et prédit des mesures qu'il n'avait jamais vues. Pour cet appareil synthétique, la réponse à ma question d'ouverture est oui.
Je n'étendrais pas cela à du matériel réel ou à une découverte ouverte. Comme expliqué dans les limites, les candidats incluaient l'équation du simulateur, et j'ai fait tourner l'agent une seule fois.
Ce qui se transpose, c'est la méthode : cacher la vérité, fixer les règles de notation avant le premier appel, geler les prédictions et utiliser un évaluateur séparé. Un test utile suivant consisterait à ajouter un modèle à transition progressive et à répéter l'investigation sur différents niveaux de bruit.
Pour la sélection de modèles, notre cours Introduction to Claude Models couvre la gamme Claude et ses compromis.
FAQ
Puis-je désactiver le raisonnement ou fixer un budget de raisonnement sur Claude Fable 5.2 ?
Non. Le raisonnement adaptatif est toujours activé, et thinking: {type: "disabled"} comme budget_tokens renvoient une erreur 400. Maîtrisez l'ampleur du raisonnement avec le paramètre effort, qui est par défaut sur high. Les tokens de raisonnement sont facturés en sortie et comptent dans max_tokens.
Pourquoi Claude Fable 5.2 renvoie-t-il une erreur 400 après que j'ai modifié des messages antérieurs ?
Chaque bloc de raisonnement n'est valide qu'au regard du prompt système, des outils et des messages qui le précèdent, et Fable 5.2 le vérifie à chaque appel. Gardez la conversation en ajout seul et figez system et tools pour la session. En solution d'attente, définir prefix_mismatch_behavior à "drop_block" avec l'en-tête bêta supprime les blocs concernés au lieu d'échouer.
Puis-je forcer Claude Fable 5.2 à appeler un outil spécifique ?
Non. Régler tool_choice sur any ou sur un outil nommé renvoie une erreur 400 ; seuls auto et none fonctionnent. Nommez l'outil dans votre instruction et définissez strict: true pour que l'appel corresponde à votre schéma. Si l'appel est obligatoire, utilisez un message système en cours de conversation.
Que se passe-t-il quand Claude Fable 5.2 refuse une requête ?
La réponse revient avec stop_reason: "refusal", et stop_details.category indique quelle protection a été déclenchée. Vous pouvez retenter sur un autre modèle vous-même, ou activer un repli côté serveur avec fallbacks: "default", une bêta qui retente sur Claude Opus 4.8 ou Claude Opus 5. Le modèle de repli ne reçoit pas les blocs de raisonnement de Fable 5.2.
Puis-je utiliser Claude Fable 5.2 avec rétention zéro des données ?
Pas par défaut. Fable 5.2 exige une rétention des données de 30 jours, et les requêtes API d'une organisation ou d'un espace de travail sans cette rétention renvoient une erreur 400. Dans le cadre d'un accord ZDR, activez la rétention à 30 jours pour un espace de travail ou contactez votre équipe de compte Anthropic.
L'API Batch peut-elle remplacer la boucle d'outils de cette expérience ?
Non. Chaque étape d'outil dépend de la réponse précédente, donc l'API Batch ne peut pas remplacer directement cette boucle. Sa remise de 50 % convient à des requêtes indépendantes ou des évaluations en parallèle.

Je suis ingénieur de données et créateur de communautés. Je travaille sur les pipelines de données, le cloud et les outils d'IA, tout en rédigeant des tutoriels pratiques et percutants pour DataCamp et les développeurs émergents.




Les LLM excellent pour donner l'impression qu'ils ont raisonné jusqu'à la bonne réponse. Vérifier s'ils l'ont vraiment fait est plus délicat. Dans la plupart des tâches, soit le modèle a déjà vu quelque chose de proche de la bonne réponse, soit personne ne peut vérifier la réponse. J'ai donc conçu un test où la vérité reste cachée.
Claude Fable 5.2 reçoit des relevés bruités d'un dispositif simulé qui refroidit après extinction, ainsi que 4 explications possibles au ralentissement du refroidissement en cours de route. Il doit en choisir une, concevoir une expérience de confirmation et s'engager sur une prédiction avant de voir la moindre nouvelle mesure. Un code Python distinct évalue ensuite la prédiction, et Claude n'y touche jamais.
Le dispositif de refroidissement n'est que le cas de test. Ce qui compte vraiment, c'est le protocole : cacher la vérité au modèle, fixer les règles de notation avant le premier appel d'API, geler ses prédictions et les évaluer avec un code qu'il ne voit pas. Vous pouvez réutiliser ce schéma pour tout problème « quelle explication est la bonne ? », de l'analyse de cause racine à l'interprétation d'un test A/B.
Dans ce tutoriel, vous allez construire cet agent en Python. SciPy fait les calculs ; Claude décide quel contrôle exécuter ensuite et quoi conclure. Si vous êtes à l'aise avec les fonctions Python et les requêtes d'API, vous pouvez suivre, et j'explique les équations de refroidissement au moment où elles apparaissent. Nous verrons comment :
Notre aperçu de Claude Fable 5.2 couvre le lancement et les benchmarks ; je me concentre ici sur l'API et le test de refroidissement. J'ai mené l'expérience le lendemain du lancement.
TL;DR
J'ai fourni à Fable 5.2 des données bruitées issues d'un dispositif simulé dont le refroidissement ralentit en cours de route, plus quatre explications possibles. Il devait en choisir une, concevoir une nouvelle expérience et en prédire le résultat avant de le voir.