

Projete o experimento e o harness
Minha implementação combina o Claude com quatro funções Python, chamadas de ferramentas, que vou mostrar depois do conjunto de dados. O código completo e a interface opcional em Streamlit estão no repositório no GitHub.
Defina os quatro modelos de resfriamento
A lei do resfriamento de Newton diz que um objeto esfria mais rápido quando está bem mais quente que o ambiente, e depois desacelera conforme a diferença de temperatura diminui. A equação é T(t) = Ta + (T0 - Ta) * exp(-k * t). Aqui, T0 é a temperatura inicial, Ta é a temperatura ambiente e k é a taxa de resfriamento por minuto.
Escrevi quatro famílias de modelos para o agente escolher:
-
Taxa única: um
kpara todo o período, usado como base -
Mudança no tempo: duas taxas, trocando no mesmo minuto decorrido em todas as execuções
-
Limiar de temperatura: duas taxas, trocando em uma temperatura compartilhada — portanto, em minutos diferentes em cada execução
-
Deslocamento do sensor: uma taxa real, mais um erro da sonda que começa no meio e cresce
Separe medições visíveis da verdade oculta
O Claude vê três séries de resfriamento e tudo que as ferramentas retornam. As taxas verdadeiras, o limiar, as configurações dos dados e as medições de confirmação ficam fora do acesso das ferramentas.
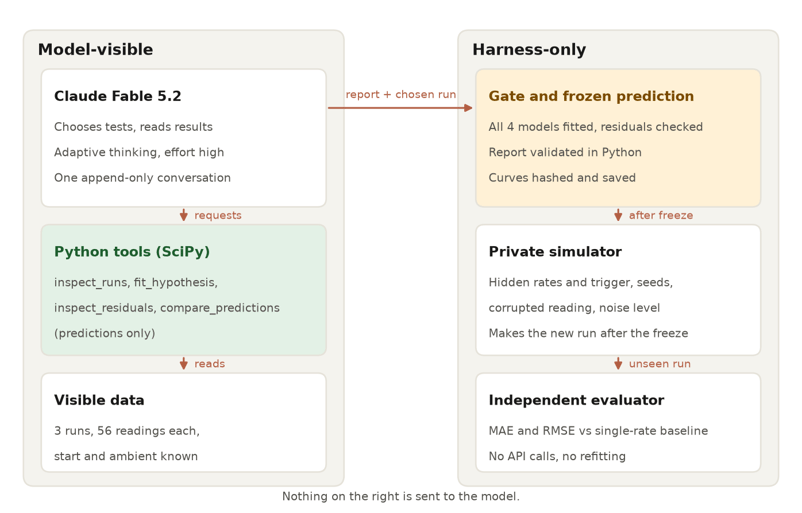
Claude acessa ferramentas; a verdade permanece oculta. Imagem do autor.
Tudo em Python ao redor do Claude compõe o agent harness. Além de rodar as ferramentas, ele limita requisições, tempo e gasto — vou mostrar no loop de ferramentas.
Antes da primeira chamada de API, eu defini os modelos candidatos, limites de parâmetros, restrições e a regra de aprovação para o novo experimento: um RMSE de no máximo 1,0 °C e não mais que a metade do baseline de taxa única. Essas regras ficaram fixas.
Configure o Claude Fable 5.2 em Python
A configuração exige um ambiente virtual e uma chave de API. O claude-fable-5-2 consegue ler até 1M de tokens de prompt e histórico da conversa e retornar até 128K tokens de saída.
O raciocínio adaptativo, onde o modelo decide quanto pensar antes de responder, fica sempre ativado, e a API usa esforço alto por padrão. A precificação da Claude API é de US$ 8 por milhão de tokens de entrada e US$ 40 por milhão de tokens de saída, com gravações no prompt cache por cinco minutos a US$ 10 e leituras de cache a US$ 0,20.
Você vai precisar de:
-
Python 3.12+, porque NumPy 2.5.4 e SciPy 1.18.1 exigem (o pacote Anthropic em si suporta 3.10)
-
Uma chave de API com acesso a
claude-fable-5-2 -
anthropic2.7.0, a versão que adicionou o ID do modelo
Clone o projeto e instale as dependências pinadas. No macOS ou Linux, crie o ambiente com python3.12 -m venv .venv, ative com source .venv/bin/activate e substitua Copy-Item por cp.
git clone https://github.com/KhalidAbdelaty/claude-fable-5-2-api.git
cd claude-fable-5-2-api
py -3.12 -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env # then paste your key after ANTHROPIC_API_KEY=O código carrega a chave da API do ambiente sem imprimi-la. O README do repositório lista os comandos para o experimento completo, e só dois deles chamam a API. Nosso guia da Claude API cobre chaves e cobrança em geral.
Faça sua primeira requisição à API do Fable 5.2
Pule esta seção se você já chamou o Claude a partir do Python. Esta chamada foca nas evidências que separam as duas hipóteses.
import anthropic
from dotenv import load_dotenv
load_dotenv(".env", override=True)
client = anthropic.Anthropic() # reads ANTHROPIC_API_KEY
response = client.messages.create(
model="claude-fable-5-2",
max_tokens=4096,
output_config={"effort": "high"},
messages=[{"role": "user", "content": (
"Three cooling runs start at 80, 95, and 110 C. Each seems to slow down partway through. "
"In three short bullets: what pattern across the runs would point to a change after a fixed "
"time, what pattern would point to a change at a fixed temperature, and what the data alone "
"cannot tell us.")}],
)
print("block types:", [block.type for block in response.content])
print("stop reason:", response.stop_reason)
print("".join(block.text for block in response.content if block.type == "text"))O Claude retorna uma lista de blocos de conteúdo tipados, então leia o texto por tipo de bloco; content[0] pode ser um bloco de raciocínio. Aqui está a primeira resposta:
block types: ['thinking', 'text']
stop reason: end_turn
- **Fixed time:** the slowdown appears at the same elapsed time in all three runs but at different temperatures, with the hotter-start runs still hotter when it happens.
- **Fixed temperature:** the slowdown appears at the same temperature in all three runs but at different elapsed times, with the hotter-start runs reaching it later.
- **What the data cannot tell us:** the cause. A matching pattern shows what the change tracks, not why it happens (for example a phase change, a setup artifact, or a shift in the surroundings). Since cooling naturally slows as it nears room temperature, the data also cannot show on its own that there is a distinct change rather than a smooth curve.Blocos de thinking e de text apareceram. Tokens de raciocínio contam como tokens de saída, então inclua-os ao estimar costo. O guia de migração do Claude Fable 5.2 informa que budget_tokens, thinking disabled, temperature, top_p e top_k retornam erro 400.
Crie um dataset de resfriamento sem vazamento de dados
Os dados precisam ser bagunçados o suficiente para exigir ajuste de modelo, e a resposta precisa ficar fora do alcance do Claude.
Simule três execuções de resfriamento
Eu simulei três execuções pela lei de Newton com uma mudança contínua e oculta no resfriamento. A começa em 80 °C em uma sala a 21,0 °C, B em 95 °C a 24,0 °C e C em 110 °C a 22,5 °C. Um gerador de números aleatórios do NumPy fixo adiciona ruído Gaussiano, e uma leitura recebe um erro extra de propósito.
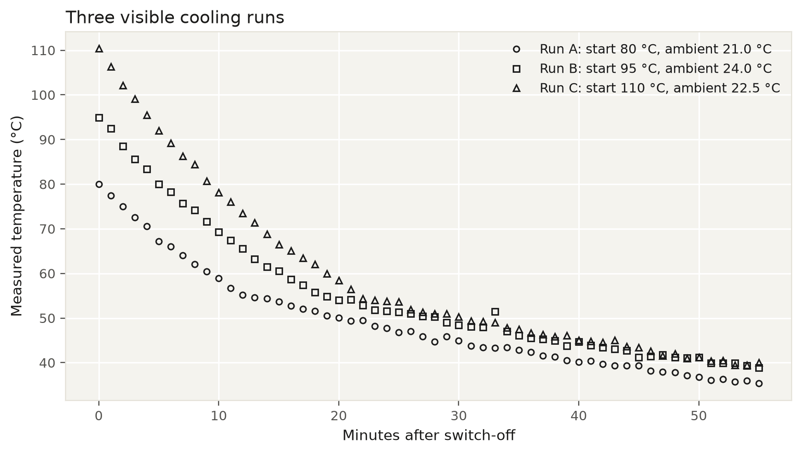
Três execuções ruidosas com um outlier. Imagem do autor.
A execução A esfria mais rápido no início do que no fim. Esse padrão, sozinho, não mostra uma mudança discreta, porque qualquer exponencial desacelera perto da temperatura ambiente.
A execução B contém um salto isolado de cerca de 4 °C, enquanto lacunas vizinhas em outros trechos ficam abaixo de 1,2 °C. Cada dobra se espalha por vários minutos com ruído, então a inspeção visual não separa os modelos de tempo e de limiar.
Teste hipóteses de resfriamento com ferramentas em Python
O Python ajusta cada candidato sob as mesmas regras e retorna seus parâmetros e erros. O Claude nunca vê o código de ajuste — só o que cada ferramenta retorna.
Ajuste parâmetros compartilhados sem deixar um outlier dominar
Ajustar significa escolher valores de parâmetros que mantenham cada curva prevista próxima de suas medições. Eu uso perda L1 suave (soft L1) porque ela reduz a influência de um erro grande sem deletar aquela leitura.
Todas as execuções compartilham os parâmetros ajustados, enquanto cada execução mantém sua temperatura inicial e ambiente. Para o modelo de limiar, isso dá a cada execução seu próprio minuto de troca, ln((T0 - Ta) / (threshold - Ta)) / k_above.
O least_squares() do SciPy busca os parâmetros que melhor se ajustam, enquanto limites de parâmetros mantêm taxas e pontos de troca dentro dos intervalos definidos antes da execução.
O trecho abaixo mostra a chamada do solver e as checagens de convergência. A função de resíduos e o escaneamento em grade estão no repositório.
from scipy.optimize import least_squares
def _solve(hypothesis, names, x0, lo, hi, runs):
# soft L1: residuals under f_scale count roughly squared, larger ones roughly linearly
return least_squares(_residuals, x0, bounds=(lo, hi), method="trf",
loss="soft_l1", f_scale=0.5, args=(hypothesis, names, runs))
# scan the change point in 0.5 steps with the rates fitted at each step, then refine all three
res = _solve(hypothesis, names, best_grid_point, lo, hi, runs)
converged = bool(res.success and res.status > 0 and np.all(np.isfinite(res.x)))
at_bound = [n for n, v, a, b in zip(names, res.x, lo, hi) if min(v - a, b - v) < 1e-4 * (b - a)]Eu defini f_scale como 0,5 °C antes da execução. Resíduos maiores que isso começam a perder influência sob soft L1. Um escaneamento em grade sobre o ponto de troca dá ao solver um valor inicial razoável.
Valide modelos com leave-one-run-out
MAE é o erro médio em °C. RMSE eleva os erros ao quadrado primeiro, então erros maiores pesam mais.
Erro de treino favorece modelos com mais parâmetros. A validação cruzada estima o erro em dados retidos rotacionando o que fica de fora. Aqui, LORO (leave-one-run-out) ajusta em duas execuções e prevê a terceira.
Defina os esquemas de chamadas de ferramentas do Claude
Um schema de ferramenta é uma descrição JSON de uma função Python e dos argumentos que o Claude pode enviar. O modo estrito de ferramentas faz a API checar esse formato antes do Python rodar a função.
O Claude pode solicitar quatro ferramentas:
-
inspect_runs: retorna as medições visíveis e resumos simples de inclinação. -
fit_hypothesis: ajusta um modelo de resfriamento e retorna seus parâmetros e erros em dados retidos. -
inspect_residuals: mostra onde as temperaturas observadas diferem das previsões do modelo. -
compare_predictions: compara modelos ajustados sob condições de experimento propostas.
O schema de compare_predictions mantém as medições de confirmação fora da ferramenta:
{"name": "compare_predictions", "strict": True,
"description": "Predict a new run from existing fits under proposed conditions and report how far the "
"predictions differ. initial_temp_c must be 75 to 115 and ambient_temp_c 20 to 25. "
"Returns predictions only; no new measurements are generated.",
"input_schema": {"type": "object", "additionalProperties": False,
"properties": {"initial_temp_c": {"type": "number"},
"ambient_temp_c": {"type": "number"},
"fit_ids": {"type": "array", "items": {"type": "string"}}},
"required": ["initial_temp_c", "ambient_temp_c", "fit_ids"]}}Os valores de fit_ids se referem a modelos ajustados antes na mesma investigação. Schemas estritos não aceitam minimum ou maximum, então o Python checa os intervalos de temperatura. Deixe tool_choice no automático, já que forçar uma ferramenta retorna erro 400 no Fable 5.2.
Construa o loop de ferramentas do Claude
O app repete um ciclo: envia a conversa ao Claude, roda quaisquer ferramentas Python solicitadas e retorna seus resultados. Continua até concluir as comparações necessárias e, então, pede ao Claude um relatório final em um formato fixo.
Escreva um prompt para testar hipóteses
O prompt de sistema descreve o método sem sugerir uma resposta. O núcleo do prompt é:
SYSTEM = """You are a scientific investigator working on a controlled cooling experiment. You decide which
checks to run and how to read the results. Python tools do every numerical calculation.
How to work:
- Look at the measurements before you choose a model.
- Fit every candidate model with fit_hypothesis. Compare them on leave-one-run-out error as well as
training error, because a model with more parameters always fits the training runs at least as well.
- Use inspect_residuals to look for systematic patterns and to decide whether any single reading is
an outlier.
- Use only numbers that a tool returned. Do not invent measurements, parameters, or errors.
- Keep observed evidence separate from assumptions. The data can show which mathematical model fits
best; it cannot show the physical cause of a change.
- If the evidence does not separate the candidates, say so and treat the result as inconclusive.
..."""O que mais me importa é o último bullet. Sem ele, o modelo teria que apontar um vencedor mesmo quando os erros estão próximos demais para decidir.
Mantenha o loop de ferramentas somente-apêndice
Cada chamada envia o mesmo system e as mesmas tools, e cada resposta volta intacta. Este trecho mostra o tratamento das mensagens; o loop completo com tratamento de parada está no repositório.
resp = client.messages.create(
model="claude-fable-5-2",
max_tokens=20_000,
system=SYSTEM,
tools=TOOLS, # all four, declared on the first request
thinking={"type": "adaptive", "display": "summarized"},
output_config={"effort": "high"},
cache_control={"type": "ephemeral"}, # automatic prompt caching
messages=messages,
)
messages.append({"role": "assistant", "content": resp.content}) # unchanged, thinking included
if resp.stop_reason == "tool_use":
results = []
for block in resp.content:
if block.type == "tool_use":
out, is_error = box.run(block.name, dict(block.input))
results.append({"type": "tool_result", "tool_use_id": block.id,
"content": out, "is_error": is_error})
messages.append({"role": "user", "content": results})Preserved thinking permite que o Claude mantenha seu raciocínio anterior entre turnos, desde que system, tools e mensagens anteriores fiquem inalterados. No Fable 5.2, editar qualquer um deles retorna erro 400 por padrão.
Você pode mudar output_config, tool_choice e max_tokens entre chamadas, embora um novo formato de saída ainda perca o prompt cache. Agrupe resultados paralelos de ferramentas em uma única mensagem do usuário, como o loop acima faz.
Defina limites para requisições, tempo e gasto
O Python conta requisições, chamadas de ferramenta, tempo decorrido e gasto, e não inicia novo trabalho quando um limite é atingido. Uma requisição que já está rodando ainda pode ultrapassar o limite de tempo ou gasto, então trate esses dois como limites flexíveis.
Antes de aceitar a resposta final, o Python também checa se o Claude ajustou todos os candidatos, inspecionou resíduos e comparou os desenhos de confirmação. Se o Claude parar por qualquer motivo além de uma solicitação de ferramenta ou um turno concluído, a investigação termina como inconclusiva. Defina max_tokens alto o suficiente para o raciocínio mais a resposta.
Retorne um relatório estruturado
Depois que as checagens passam, mais uma sosaídas estruturadas com a mesma conversa, então o relatório final chega como um objeto Python validado:
messages.append({"role": "user", "content": REPORT_PROMPT})
resp = client.messages.parse(
model="claude-fable-5-2", max_tokens=20_000, system=SYSTEM, tools=TOOLS,
thinking={"type": "adaptive", "display": "summarized"},
output_config={"effort": "high"},
output_format=InvestigationReport, # the SDK sends this as output_config.format
tool_choice={"type": "none"}, # tools stay declared, so the prefix check passes
messages=messages,
)
problems = validate(resp.parsed_output, box.fits) # fit IDs exist, all four covered, ranges holdO Pydantic checa o formato do relatório, e validate() confirma que todo ajuste citado existe e que as condições caem no intervalo permitido. A partir daí, a escolha de modelo e as condições ficam finais.
Fable 5.2 escolhe o modelo de limiar de temperatura
Rodei uma investigação com esforço high. Aqui está como o Claude chegou à resposta.
Acompanhe a sequência de testes do Claude
O Claude começou inspecionando as medições. Antes de ajustar qualquer coisa, seu resumo dizia: "A mudança aparece por volta de 55 °C em todas as execuções: no minuto 12 em A, minuto 19 em B e minuto 22 em C. Isso aponta para um limiar, então vou ajustar as quatro."
Eu chamaria isso de ancoragem: o Claude se comprometeu com uma resposta antes de testá-la. O ajuste posterior concordou, com trocas perto dos minutos 12, 18 e 22. O log no terminal mostra a ordem das checagens restantes.
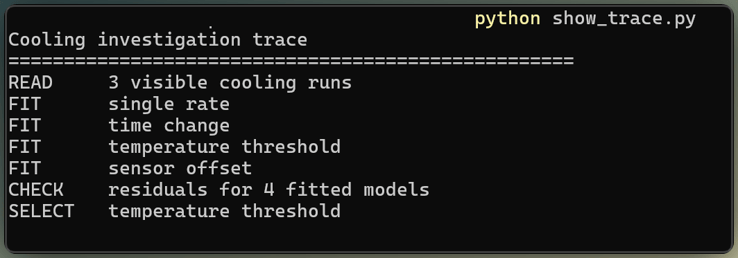
O terminal mostra a ordem dos testes do Claude. Imagem do autor.
Compare erros em dados retidos entre os quatro modelos
O RMSE de treino mede cada ajuste nas três execuções. As colunas de held-out fazem a média dos três testes LORO.
|
Candidato |
Premissa principal |
RMSE de treino (°C) |
MAE held-out (°C) |
RMSE held-out (°C) |
|
Taxa única |
Uma taxa ao longo de todo o período |
4,08 |
3,90 |
4,60 |
|
Mudança no tempo |
Troca compartilhada perto do minuto 19 |
1,92 |
2,17 |
2,63 |
|
Limiar de temperatura |
Troca compartilhada perto de 55 °C |
0,49 |
0,32 |
0,48 |
|
Deslocamento do sensor |
Deriva de medição crescente |
1,49 |
1,45 |
1,87 |
No modelo de limiar, os erros de treino e de held-out são próximos, então o ajuste se mantém de uma execução para outra — embora três execuções não descartem overfitting em geral. O gráfico de resíduos abaixo mostra a temperatura observada menos a previsão de cada modelo.
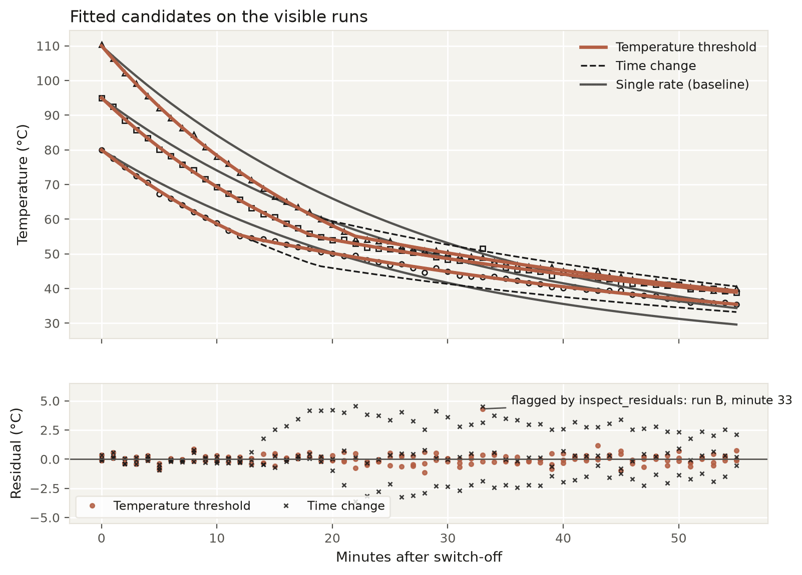
Resíduos do modelo de limiar não mostram padrão sistemático. Imagem do autor.
O ajuste de mudança no tempo casa com a execução B. Após a troca, ele erra a A em cerca de +2,5 a +3,5 °C e a C em -1,5 a -2,8 °C.
A mudança de sinal é mais informativa do que o ranking isolado: mostra que a troca chega antes em A e depois em C, como um gatilho por temperatura prevê. O modelo de deslocamento do sensor reduz algum erro ao adicionar deriva, mas seus erros em held-out continuam maiores.
Verifique a leitura corrompida
O agente não sabia qual leitura eu tinha corrompido. Ele encontrou em B, miz-score robusto, que mede a distância em relação à dispersão típica dos resíduos, passou de 12.
O Claude manteve a leitura, já que o soft L1 já limita sua influência. Para checar essa decisão, eu reajustei os quatro modelos sem ela. O modelo de limiar continuou em primeiro com boa margem, e sua estimativa de limiar mal se moveu.
Desenhe um experimento de confirmação
O agente comparou previsões dos candidatos em várias temperaturas iniciais e ambientes e depois escolheu as condições sem ver nenhuma nova medição.
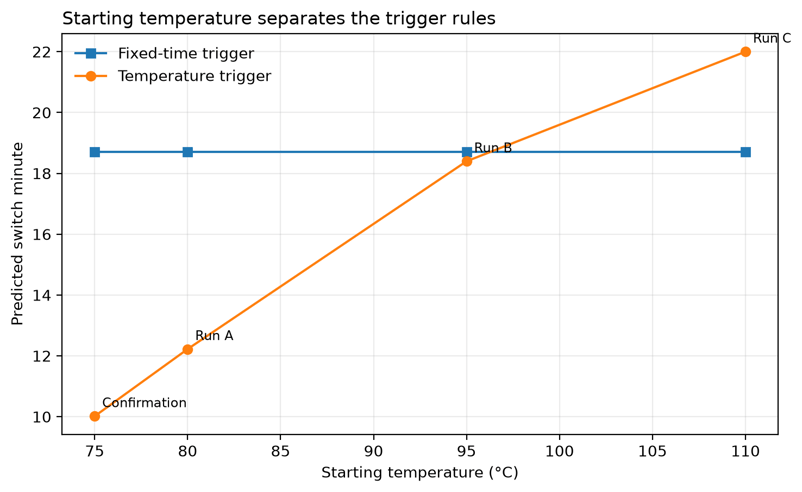
Temperaturas iniciais expõem cada regra de gatilho. Imagem do autor.
Escolha condições que separem os modelos
Como no resumo, o agente escolheu início em 75 °C e ambiente a 20 °C. O modelo de limiar troca perto do minuto 10, enquanto o modelo de tempo troca perto do minuto 19. A curva de deslocamento do sensor também fica separada da previsão de limiar.
Uma configuração intermediária próxima da execução B separaria os modelos de limiar e tempo em só ~0,6 °C. As condições escolhidas ficam levemente fora do intervalo testado, e o Claude sinalizou isso no relatório.
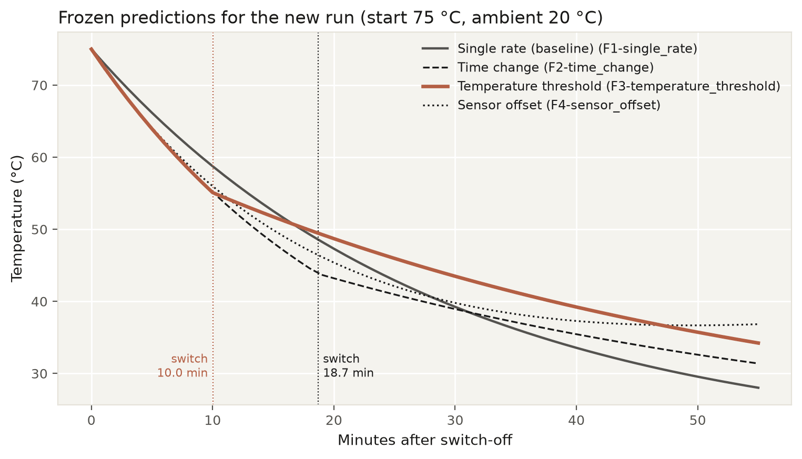
Previsões dos candidatos para a execução escolhida. Imagem do autor.
Congele as previsões antes de gerar os dados
Eu congelei as condições escolhidas, os parâmetros ajustados e a previsão de cada candidato antes de gerar quaisquer novas medições. O agente não recebeu as medições de confirmação e não pôde revisar a resposta após o resultado.
As medições de confirmação usam o mesmo modelo de ruído Gaussiano, uma semente fixa separada e nenhum outlier inserido.
Pontue a execução oculta
Um código Python separado avaliou as previsões congeladas. Ele nunca chama a API, então o Claude não participa da correção da própria resposta.
Pontue previsões com Python independente
A previsão do modelo de limiar passou nos dois testes predefinidos. Na execução oculta, marcou 0,27 °C de MAE e 0,32 °C de RMSE. Tempo fixo ficou com 3,67 °C de RMSE, deslocamento do sensor com 2,35 °C e taxa única com 4,28 °C.
A execução de confirmação não tem outlier inserido, o que ajuda a explicar o erro menor em comparação com os resultados leave-one-run-out. Outra amostra aleatória de ruído também pode contribuir.
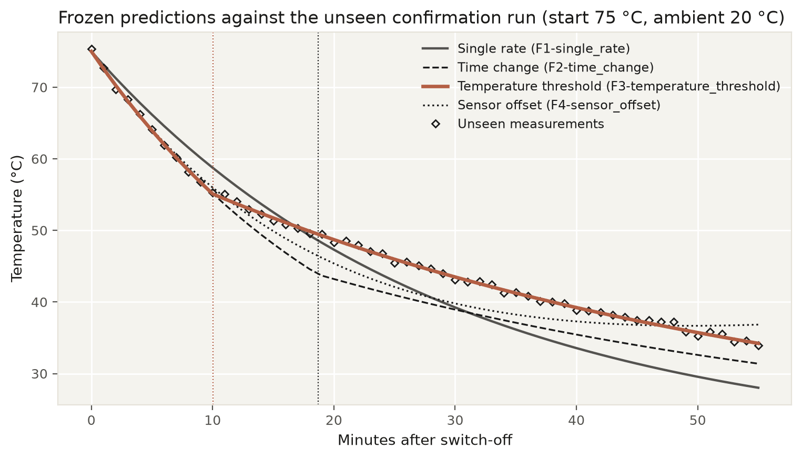
Previsões congeladas batem com as medições ocultas. Imagem do autor.
Compare parâmetros ajustados com a verdade oculta
Depois de pontuar, compare os parâmetros ajustados com os valores geradores ocultos:
import numpy as np
def true_curve(t0, ta, minutes, truth):
"""Newton cooling whose rate drops when the temperature crosses a threshold. Continuous at the switch."""
t = np.asarray(minutes, dtype=float)
k1, k2, th = truth["k_above"], truth["k_below"], truth["threshold_c"]
if t0 <= th:
return ta + (t0 - ta) * np.exp(-k2 * t)
t_cross = np.log((t0 - ta) / (th - ta)) / k1
fast = ta + (t0 - ta) * np.exp(-k1 * t)
slow = ta + (th - ta) * np.exp(-k2 * (t - t_cross)) # restarts from the threshold
return np.where(t <= t_cross, fast, slow)O simulador adiciona ruído Gaussiano com semente fixa em torno dessa curva.
A regra oculta era um limiar de temperatura em 55 °C, com taxas de 0,045 e 0,020 por minuto e desvio padrão do ruído de 0,35 °C.
As taxas ajustadas batem nas 3 casas decimais, o limiar ficou a 0,1 °C e a troca prevista a 0,1 minuto.
Os dados identificam a regra matemática usada pelo simulador. Eles não mostram se um dispositivo real desacelerando perto de 55 °C envolve mudança de fase, ciclo de ventilador ou outra causa física.
Revise como o agente chegou à resposta
O relatório citou IDs de ajustes e números de ferramentas como evidência, e nomeou o que três execuções não conseguem estabelecer. O ponto fraco é o palpite inicial que mencionei. Uma única investigação não mostra com que frequência esse tipo de palpite dá errado.
Veja a investigação no Streamlit
No vídeo, inicio uma execução ao vivo, acompanho o log de ferramentas e abro as abas Report, Curves, Confirmation e Cost depois da pontuação.
A interface em Streamlit mostra uma investigação. Vídeo do autor.
Meça o custo da API do Claude Fable 5.2
A investigação, incluindo o relatório final, custou cerca de US$ 0,49 e levou pouco mais de um minuto. O SciPy roda na sua máquina, então não adiciona nada à fatura da API.
Só o pedido do relatório levou quase metade do custo e do tempo. Como mencionei no loop de ferramentas, um novo formato de saída perde o prompt cache, então esse último pedido processou a conversa inteira de novo antes de escrever um relatório longo. Acompanhe entrada sem cache, gravações de cache, leituras de cache e saída separadamente, já que cada uma tem seu preço.
Limites e considerações práticas
Dois tipos de limite importam aqui: o que o experimento pode mostrar e o que o código precisa antes de rodar como serviço.
Limites científicos
O simulador e o candidato de limiar usam a mesma equação. Uma troca gradual em um dispositivo real ainda pode se ajustar a esse modelo enquanto segue outra curva.
Se a regra verdadeira faltasse, o agente ainda poderia escolher o modelo mais próximo entre os fornecidos em vez de responder inconclusive. Mais ruído ou um limiar mal cruzado pode deixar os erros parecidos demais para separar. Outra execução pode seguir uma ordem de ferramentas diferente.
Antes de ir para produção
Os limites do loop de ferramentas cobrem uma investigação na sua máquina. Um serviço em produção precisa de mais:
- Defina retries do SDK e timeouts para o serviço.
- Valide toda entrada e saída de ferramenta em Python.
- Logue modelo, versão do SDK, motivo de parada, tokens, latência e custo de cada requisição.
- Firme versões de modelo e SDK, refaça o teste oculto e confirme a política de retenção de 30 dias antes de atualizar.
Quando esse padrão se aplica
Use este padrão quando várias explicações se encaixam, o Python consegue testá-las e um experimento oculto pode pontuar a escolha — especialmente quando o próximo experimento custa mais do que a chamada à API.
Use Python puro quando você já conhece a faorientação do modelo Fable 5.2 recomenda testar o Opus primeiro e experimentar o Fable quando o Opus não cumprir o requisito.
Considerações finais
Construímos um agente que comparou quatro modelos de resfriamento, escolheu um limiar de temperatura, desenhou uma execução de confirmação e previu medições que nunca tinha visto. Para este dispositivo sintético, a resposta à pergunta inicial é sim.
Eu não estenderia isso a equipamentos reais ou descoberta aberta. Como cobri nos limites, os candidatos incluíam a própria equação do simulador, e eu rodei o agente uma vez.
O que se mantém é o método: esconda a verdade, defina as regras de pontuação antes da primeira chamada, congele previsões e use um avaliador separado. Um próximo teste útil seria adicionar um modelo de transição gradual e repetir a investigação em diferentes níveis de ruído.
Para seleção de modelos, nosso curso Introduction to Claude Models cobre a linha Claude e seus trade-offs.
FAQs
Posso desativar o thinking ou definir um orçamento de thinking no Claude Fable 5.2?
Não. O raciocínio adaptativo fica sempre ativado, e tanto thinking: {type: "disabled"} quanto budget_tokens retornam erro 400. Em vez disso, controle o quanto ele pensa pelo parâmetro effort, que por padrão é high. Tokens de raciocínio são cobrados como saída e contam para max_tokens.
Por que o Claude Fable 5.2 retorna erro 400 após eu editar mensagens anteriores?
Cada bloco de raciocínio só é válido em relação ao prompt de sistema, ferramentas e mensagens que vieram antes, e o Fable 5.2 checa isso em toda conta. Mantenha a conversa somente-apêndice e congele system e tools na sessão. Como paliativo, definir prefix_mismatch_behavior como "drop_block" com o cabeçalho beta descarta os blocos afetados em vez de falhar.
Posso forçar o Claude Fable 5.2 a chamar uma ferramenta específica?
Não. Definir tool_choice como any ou para uma ferramenta nomeada retorna erro 400; só auto e none funcionam. Nomeie a ferramenta na sua instrução e defina strict: true para que a chamada bata com seu schema. Se a chamada for obrigatória, use uma mensagem de sistema no meio da conversa.
O que acontece quando o Claude Fable 5.2 recusa uma solicitação?
A resposta volta com stop_reason: "refusal", e stop_details.category informa qual salvaguarda foi acionada. Você pode tentar outro modelo por conta própria ou aderir ao fallback no servidor com fallbacks: "default", um beta que refaz a tentativa no Claude Opus 4.8 ou Claude Opus 5. O modelo de fallback não recebe os blocos de raciocínio do Fable 5.2.
Posso usar o Claude Fable 5.2 com zero retenção de dados?
Não por padrão. O Fable 5.2 exige retenção de dados por 30 dias, e requisições de API de uma organização ou workspace sem isso retornam erro 400. Em um acordo ZDR, ative a retenção de 30 dias para um workspace ou fale com seu time de conta na Anthropic.
A Batch API pode substituir o loop de ferramentas deste experimento?
Não. Cada etapa de ferramenta precisa da resposta anterior, então a Batch API não substitui esse loop diretamente. Seu desconto de 50% se aplica a requisições independentes ou avaliações em paralelo.

Sou engenheiro de dados e criador de comunidades que trabalha com pipelines de dados, nuvem e ferramentas de IA, além de escrever tutoriais práticos e de alto impacto para o DataCamp e desenvolvedores iniciantes.





LLMs são ótimos em soar como se tivessem raciocinado até chegar à resposta. Verificar se de fato raciocinaram é bem mais difícil. Na maioria das tarefas, o modelo já viu algo parecido com a resposta, ou ninguém consegue verificar a resposta. Então, criei um teste onde a resposta fica oculta.
Claude Fable 5.2 recebe leituras ruidosas de um dispositivo simulado que esfria depois de ser desligado, mais 4 possíveis explicações para a desaceleração do resfriamento no meio do processo. Ele precisa escolher uma, desenhar um experimento de confirmação e se comprometer com uma previsão antes de ver qualquer nova medição. Um código Python separado então avalia a previsão — e o Claude não encosta nele.
O dispositivo de resfriamento é só o caso de teste. O que importa é a configuração: esconder a verdade do modelo, fixar as regras de pontuação antes da primeira chamada à API, congelar as previsões e avaliá-las com um código que ele não pode ver. Dá para reutilizar esse padrão em qualquer problema de "qual explicação está certa?", de análise de causa raiz a leitura de um teste A/B.
Neste tutorial, você vai construir esse agente em Python. SciPy faz a conta; o Claude decide qual checagem rodar e o que concluir. Se você está confortável com funções em Python e requisições a APIs, dá para acompanhar — e eu explico a matemática do resfriamento quando ela aparece pela primeira vez. Vamos ver como:
Nosso overview do Claude Fable 5.2 cobre o lançamento e os benchmarks, então aqui eu foco na API e no teste de resfriamento. Rodei o experimento no dia seguinte ao lançamento.
Resumo
Eu dei ao Fable 5.2 dados ruidosos de um dispositivo simulado cujo resfriamento desacelera no meio do processo, além de quatro explicações possíveis. Ele precisou escolher uma, desenhar um novo experimento e prever o resultado antes de vê-lo.