

Спроектируйте эксперимент и каркас
В моей реализации Claude работает в паре с четырьмя функциями Python (инструментами), которые я покажу после датасета. Полный код и опциональный интерфейс Streamlit доступны в репозитории GitHub.
Определите четыре модели охлаждения
Закон охлаждения Ньютона гласит: объект остывает быстрее, когда он значительно горячее комнаты, и замедляется по мере сокращения температурной разницы. Уравнение: T(t) = Ta + (T0 - Ta) * exp(-k * t). Здесь T0 — начальная температура, Ta — температура комнаты, k — скорость охлаждения в минуту.
Я задал четыре семейства моделей, из которых агент выбирает:
-
Одна скорость: единый
kна всём протяжении, базовая линия -
Смена по времени: две скорости, переключение в одну и ту же минуту в каждом прогоне
-
Температурный порог: две скорости, переключение при общей температуре, поэтому в разное время в каждом прогоне
-
Смещение датчика: одна истинная скорость плюс ошибка зонда, которая начинается на середине и растёт
Отделите видимые измерения от скрытой истины
Claude видит три серии охлаждения и всё, что возвращают инструменты. Истинные скорости, порог, настройки данных и подтверждающие измерения остаются вне доступа инструментов.
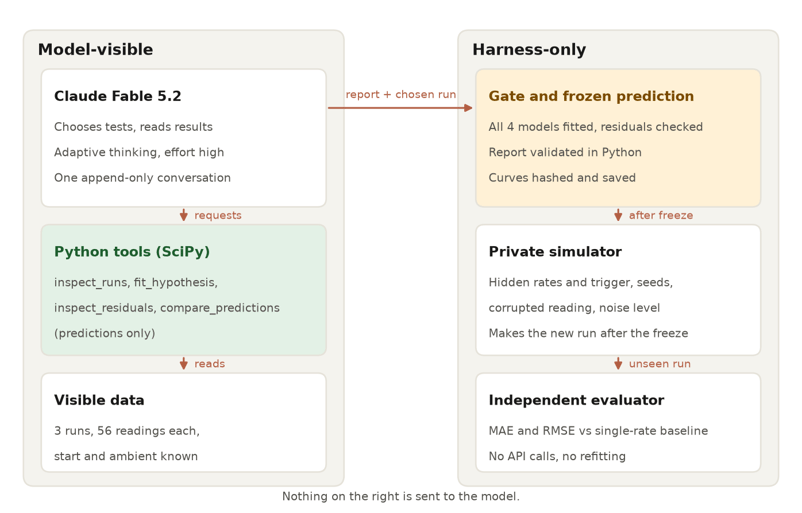
Claude получает доступ к инструментам; истина остаётся скрытой. Изображение автора.
Всё окружение Python вокруг Claude составляет каркас агента. Помимо запуска инструментов, он ограничивает число запросов, время и расходы — это разберём в цикле инструментов.
До первого вызова API я зафиксировал кандидатов-моделей, границы параметров, лимиты и правило прохождения нового эксперимента: RMSE не более 1,0 °C и не более половины базовой ошибки с одной скоростью. Эти правила оставались неизменными.
Настройте Claude Fable 5.2 в Python
Понадобятся виртуальное окружение и API‑ключ. Модель claude-fable-5-2 может читать до 1 млн токенов из промпта и истории диалога и возвращать до 128 тыс. токенов вывода.
Адаптивное мышление, при котором модель сама решает, сколько рассуждать до ответа, всегда включено, а по умолчанию API использует высокий уровень усилий. Цены Claude API — $8 за миллион входных токенов и $40 за миллион выходных токенов; запись в кэш промптов на 5 минут — $10, чтение из кэша — $0.20.
Вам понадобятся:
-
Python 3.12+, так как этого требуют NumPy 2.5.4 и SciPy 1.18.1 (сам пакет Anthropic поддерживает 3.10)
-
API‑ключ с доступом к
claude-fable-5-2 -
anthropic2.7.0, релиз, добавивший этот идентификатор модели
Клонируйте проект и установите закреплённые зависимости. На macOS или Linux создайте окружение командой python3.12 -m venv .venv, активируйте его через source .venv/bin/activate и замените Copy-Item на cp.
git clone https://github.com/KhalidAbdelaty/claude-fable-5-2-api.git
cd claude-fable-5-2-api
py -3.12 -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env # then paste your key after ANTHROPIC_API_KEY=Код загружает API‑ключ из переменных окружения и не печатает его. В README репозитория перечислены команды для полного эксперимента, и только две из них обращаются к API. Наш гайд по Claude API охватывает ключи и биллинг в целом.
Сделайте первый запрос к Fable 5.2
Пропустите этот раздел, если вы уже вызывали Claude из Python. Этот запрос фокусируется на свидетельствах, разделяющих две гипотезы.
import anthropic
from dotenv import load_dotenv
load_dotenv(".env", override=True)
client = anthropic.Anthropic() # reads ANTHROPIC_API_KEY
response = client.messages.create(
model="claude-fable-5-2",
max_tokens=4096,
output_config={"effort": "high"},
messages=[{"role": "user", "content": (
"Three cooling runs start at 80, 95, and 110 C. Each seems to slow down partway through. "
"In three short bullets: what pattern across the runs would point to a change after a fixed "
"time, what pattern would point to a change at a fixed temperature, and what the data alone "
"cannot tell us.")}],
)
print("block types:", [block.type for block in response.content])
print("stop reason:", response.stop_reason)
print("".join(block.text for block in response.content if block.type == "text"))Claude возвращает список типизированных блоков содержимого, поэтому читайте текст по типу блока; content[0] может оказаться блоком рассуждений. Вот первый ответ:
block types: ['thinking', 'text']
stop reason: end_turn
- **Fixed time:** the slowdown appears at the same elapsed time in all three runs but at different temperatures, with the hotter-start runs still hotter when it happens.
- **Fixed temperature:** the slowdown appears at the same temperature in all three runs but at different elapsed times, with the hotter-start runs reaching it later.
- **What the data cannot tell us:** the cause. A matching pattern shows what the change tracks, not why it happens (for example a phase change, a setup artifact, or a shift in the surroundings). Since cooling naturally slows as it nears room temperature, the data also cannot show on its own that there is a distinct change rather than a smooth curve.Появились блоки thinking и text. Токены рассуждений считаются выходными токенами, учитывайте их при оценке стоимости. В руководстве по миграции Claude Fable 5.2 указано, что параметры budget_tokens, думание disabled, temperature, top_p и top_k приводят к ошибке 400.
Создайте датасет охлаждения без утечки данных
Данные должны быть достаточно шумными, чтобы требовалась подгонка модели, и при этом ответ должен оставаться недоступным для Claude.
Смоделируйте три прогона охлаждения
Я смоделировал три прогона по закону Ньютона со скрытым, непрерывным изменением скорости охлаждения. Прогон A стартует при 80 °C в комнате 21,0 °C, B — при 95 °C в 24,0 °C и C — при 110 °C в 22,5 °C. Фиксированный генератор случайных чисел NumPy добавляет гауссов шум, и одно измерение преднамеренно получает дополнительную ошибку.
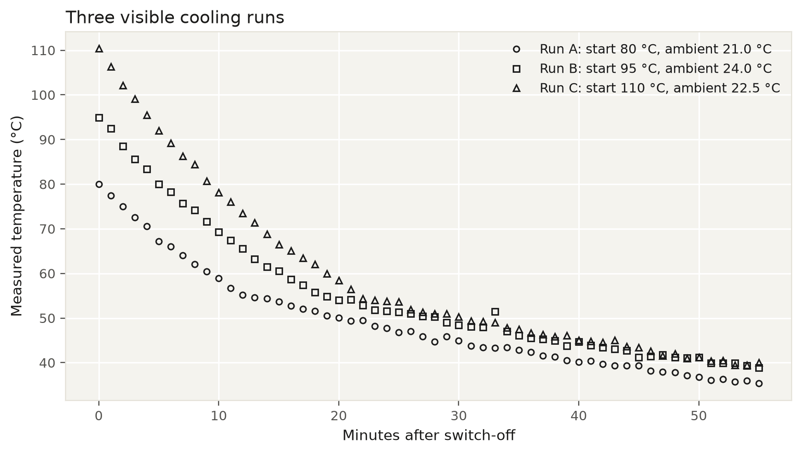
Три шумных прогона включают один выброс. Изображение автора.
Прогон A остывает быстрее в начале, чем в конце. Сам по себе этот рисунок не доказывает дискретного изменения, потому что любая экспонента замедляется возле комнатной температуры.
В прогоне B есть одиночный скачок примерно на 4 °C, тогда как соседние разрывы в других местах остаются ниже 1,2 °C. Каждый изгиб растянут на несколько шумных минут, поэтому визуально отделить модели «время» и «порог» невозможно.
Проверьте гипотезы охлаждения с помощью инструментов Python
Python подгоняет каждого кандидата по единым правилам и возвращает параметры и ошибки. Claude не видит код подгонки — только то, что возвращают инструменты.
Подгоняйте общие параметры без доминирования выброса
Подгонка означает выбор значений параметров, при которых каждая предсказанная кривая близка к измерениям. Я использую функцию потерь soft L1, потому что она снижает влияние большой ошибки, не удаляя это измерение.
Все прогоны разделяют подбираемые параметры, при этом каждый сохраняет свои начальные и комнатные температуры. Для модели порога это даёт каждому прогону своё время переключения: ln((T0 - Ta) / (threshold - Ta)) / k_above.
Функция SciPy least_squares() ищет лучшие параметры, а границы параметров удерживают скорости и точки переключения внутри заранее заданных диапазонов.
Отрывок ниже показывает вызов решателя и проверки сходимости. Функция невязок и сеточный скан рядом с ней — в репозитории.
from scipy.optimize import least_squares
def _solve(hypothesis, names, x0, lo, hi, runs):
# soft L1: residuals under f_scale count roughly squared, larger ones roughly linearly
return least_squares(_residuals, x0, bounds=(lo, hi), method="trf",
loss="soft_l1", f_scale=0.5, args=(hypothesis, names, runs))
# scan the change point in 0.5 steps with the rates fitted at each step, then refine all three
res = _solve(hypothesis, names, best_grid_point, lo, hi, runs)
converged = bool(res.success and res.status > 0 and np.all(np.isfinite(res.x)))
at_bound = [n for n, v, a, b in zip(names, res.x, lo, hi) if min(v - a, b - v) < 1e-4 * (b - a)]Я задал f_scale равным 0,5 °C до запуска. Невязки больше этого порога начинают терять влияние в soft L1. Сеточный скан по точке переключения даёт решателю разумную стартовую оценку.
Валидируйте модели методом leave-one-run-out
MAE — средний промах в °C. RMSE сначала возводит ошибки в квадрат, поэтому крупные ошибки весят больше.
Обучающая ошибка благоволит моделям с большим числом параметров. Кросс‑валидация оценивает ошибку на отложенных данных, поочерёдно исключая части. Здесь LORO‑валидация обучается на двух прогонах и предсказывает третий.
Определите схемы вызова инструментов Claude
Схема инструмента — это JSON‑описание функции Python и аргументов, которые Claude может прислать. Строгий режим инструментов заставляет API проверять форму данных до выполнения функции в Python.
Claude может запрашивать четыре инструмента:
-
inspect_runs: возвращает видимые измерения и простые сводки наклонов. -
fit_hypothesis: подгоняет одну модель охлаждения и возвращает её параметры и ошибки на отложенной выборке. -
inspect_residuals: показывает, где наблюдения расходятся с предсказаниями модели. -
compare_predictions: сравнивает подогнанные модели при предложенных условиях эксперимента.
Схема compare_predictions удерживает подтверждающие измерения вне инструмента:
{"name": "compare_predictions", "strict": True,
"description": "Predict a new run from existing fits under proposed conditions and report how far the "
"predictions differ. initial_temp_c must be 75 to 115 and ambient_temp_c 20 to 25. "
"Returns predictions only; no new measurements are generated.",
"input_schema": {"type": "object", "additionalProperties": False,
"properties": {"initial_temp_c": {"type": "number"},
"ambient_temp_c": {"type": "number"},
"fit_ids": {"type": "array", "items": {"type": "string"}}},
"required": ["initial_temp_c", "ambient_temp_c", "fit_ids"]}}Значения fit_ids ссылаются на модели, подогнанные ранее в том же исследовании. Строгие схемы не принимают minimum или maximum, поэтому Python сам проверяет диапазоны температур. Оставьте tool_choice в режиме auto, так как принудительный выбор инструмента в Fable 5.2 возвращает ошибку 400.
Постройте цикл инструментов Claude
Приложение повторяет цикл: отправить диалог Claude, выполнить запрошенные инструменты Python и вернуть их результаты. Цикл продолжается, пока необходимые сравнения не завершены, после чего Claude запрашивается на финальный отчёт в фиксированном формате.
Напишите промпт для проверки гипотез
Системный промпт описывает метод без подсказки ответа. Основной промпт:
SYSTEM = """You are a scientific investigator working on a controlled cooling experiment. You decide which
checks to run and how to read the results. Python tools do every numerical calculation.
How to work:
- Look at the measurements before you choose a model.
- Fit every candidate model with fit_hypothesis. Compare them on leave-one-run-out error as well as
training error, because a model with more parameters always fits the training runs at least as well.
- Use inspect_residuals to look for systematic patterns and to decide whether any single reading is
an outlier.
- Use only numbers that a tool returned. Do not invent measurements, parameters, or errors.
- Keep observed evidence separate from assumptions. The data can show which mathematical model fits
best; it cannot show the physical cause of a change.
- If the evidence does not separate the candidates, say so and treat the result as inconclusive.
..."""Больше всего мне важен последний пункт. Без него модель вынуждена назвать победителя, даже когда ошибки слишком близки, чтобы выбирать.
Держите цикл инструментов только с добавлением
Каждый вызов отправляет одни и те же system и tools, а каждый ответ возвращается без изменений. Этот фрагмент показывает работу с сообщениями; полный цикл с обработкой остановок — в репозитории.
resp = client.messages.create(
model="claude-fable-5-2",
max_tokens=20_000,
system=SYSTEM,
tools=TOOLS, # all four, declared on the first request
thinking={"type": "adaptive", "display": "summarized"},
output_config={"effort": "high"},
cache_control={"type": "ephemeral"}, # automatic prompt caching
messages=messages,
)
messages.append({"role": "assistant", "content": resp.content}) # unchanged, thinking included
if resp.stop_reason == "tool_use":
results = []
for block in resp.content:
if block.type == "tool_use":
out, is_error = box.run(block.name, dict(block.input))
results.append({"type": "tool_result", "tool_use_id": block.id,
"content": out, "is_error": is_error})
messages.append({"role": "user", "content": results})Сохранение рассуждений позволяет Claude переносить ранние выводы между ходами, если system, tools и ранние сообщения остаются неизменными. В Fable 5.2 изменение любого из них по умолчанию приводит к ошибке 400.
Можно менять output_config, tool_choice и max_tokens между вызовами, но новый формат вывода всё равно не попадёт в кэш промпта. Группируйте параллельные результаты инструментов в одном пользовательском сообщении, как показано выше.
Установите лимиты на запросы, время и расходы
Python считает запросы, вызовы инструментов, прошедшее время и расходы и не начнёт новую работу после достижения лимита. Уже запущенный запрос может превысить лимит по времени или расходам, так что относитесь к ним как к мягким.
Перед принятием финального ответа Python также проверяет, что Claude подогнал все кандидаты, инспектировал невязки и сравнил варианты подтверждения. Если Claude останавливается по любой причине, кроме запроса инструмента или завершённого хода, исследование завершается как неокончательное. Поставьте max_tokens достаточно высоким для рассуждений и ответа.
Верните структурированный отчёт
Когда проверки пройдены, ещё один запрос запрашивает структурированный вывод по той же истории, чтобы финальный отчёт пришёл как валидированный объект Python:
messages.append({"role": "user", "content": REPORT_PROMPT})
resp = client.messages.parse(
model="claude-fable-5-2", max_tokens=20_000, system=SYSTEM, tools=TOOLS,
thinking={"type": "adaptive", "display": "summarized"},
output_config={"effort": "high"},
output_format=InvestigationReport, # the SDK sends this as output_config.format
tool_choice={"type": "none"}, # tools stay declared, so the prefix check passes
messages=messages,
)
problems = validate(resp.parsed_output, box.fits) # fit IDs exist, all four covered, ranges holdPydantic проверяет форму отчёта, а validate() подтверждает, что каждая указанная подгонка существует и условия лежат в допустимом диапазоне. После этого выбор модели и условий окончателен.
Fable 5.2 выбирает модель с температурным порогом
Я провёл одно исследование с уровнем усилий high. Вот как Claude пришёл к ответу.
Проследите последовательность проверок Claude
Claude начал с просмотра измерений. До подгонки он резюмировал: «Изменение проявляется примерно при 55 °C в каждом прогоне: на 12‑й минуте в A, на 19‑й в B и на 22‑й в C. Это указывает на порог, так что я подгоню все четыре».
Я бы назвал это эффектом якоря: Claude заранее привязался к ответу до проверки. Позднейшая подгонка с этим согласилась: переключения около 12, 18 и 22 минут. Терминальный лог показывает порядок оставшихся проверок.
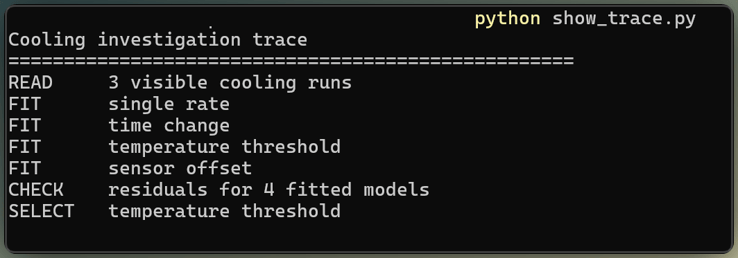
Лог в терминале показывает порядок проверок Claude. Изображение автора.
Сравните ошибки на отложенной выборке у четырёх моделей
Train RMSE измеряет подгонку на всех трёх прогонах. Столбцы с отложенной оценкой усредняют три LORO‑теста.
|
Кандидат |
Основное допущение |
RMSE на обучении (°C) |
MAE на отложении (°C) |
RMSE на отложении (°C) |
|
Одна скорость |
Одна скорость на всём протяжении |
4.08 |
3.90 |
4.60 |
|
Смена по времени |
Общее переключение около 19‑й минуты |
1.92 |
2.17 |
2.63 |
|
Температурный порог |
Общее переключение около 55 °C |
0.49 |
0.32 |
0.48 |
|
Смещение датчика |
Растущее смещение измерений |
1.49 |
1.45 |
1.87 |
Для модели с порогом обучающая и отложенная ошибки близки, значит, подгонка переносится между прогонами, хотя три прогона в целом не исключают переобучение. График невязок ниже показывает наблюдаемую температуру минус предсказание модели.
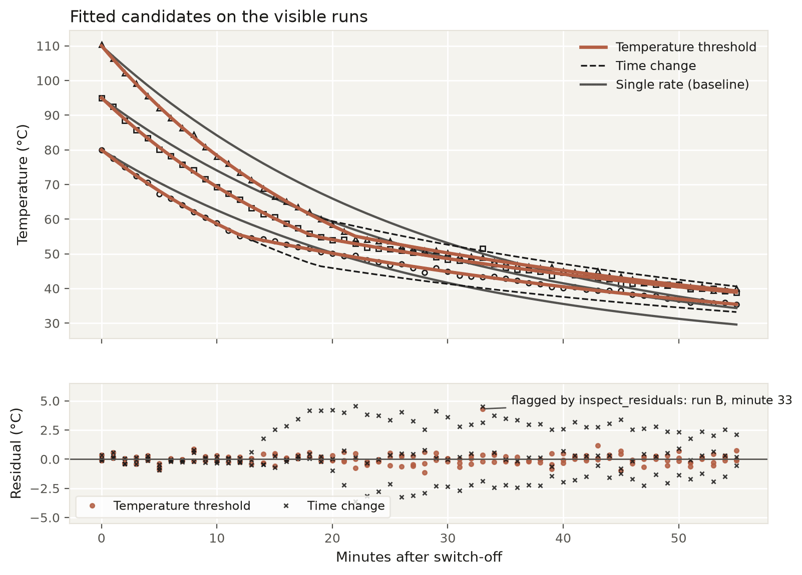
Невязки порога не показывают систематики. Изображение автора.
Модель «смена по времени» хорошо ложится на прогон B. После переключения она промахивается по прогону A примерно на +2,5…+3,5 °C и по прогону C на −1,5…−2,8 °C.
Смена знака полезнее, чем один лишь рейтинг: видно, что переключение приходит раньше в A и позже в C — как и предсказывает температурный триггер. Модель со смещением датчика частично снижает ошибку за счёт дрейфа, но её отложенные ошибки всё равно больше.
Проверьте испорченное измерение
Агент не знал, какое измерение я исказил. Он нашёл прогон B, 33‑ю минуту, с невязкой около +4,3 °C. Его робастный z‑скор, который измеряет отклонение от типичного разброса невязок, превысил 12.
Claude оставил это измерение, поскольку soft L1 уже ограничивает его влияние. Для проверки я переподогнал все модели без него. Модель порога осталась первой с большим отрывом, а оценка порога почти не изменилась.
Спроектируйте подтверждающий эксперимент
Агент сравнил предсказания кандидатов при нескольких стартовых и комнатных температурах, затем выбрал условия, не видя новых измерений.
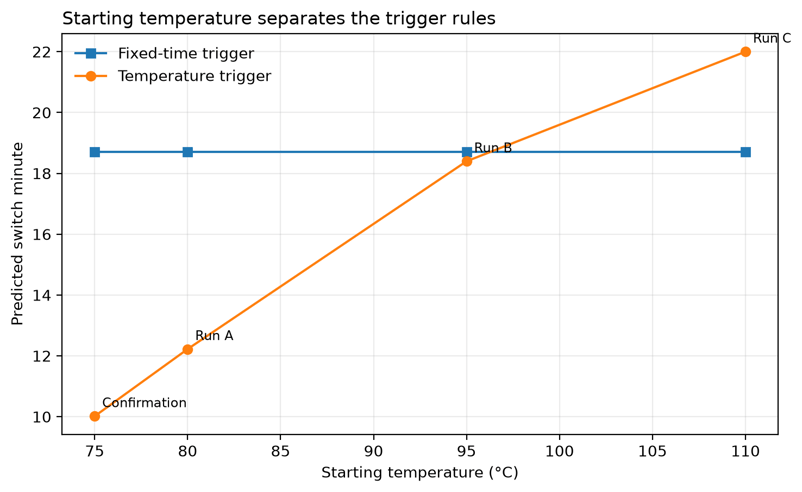
Стартовые температуры выявляют правило срабатывания. Изображение автора.
Выберите условия, разделяющие модели
Как отмечено в «Кратко», агент выбрал старт 75 °C и комнату 20 °C. Модель порога переключается около 10‑й минуты, а модель времени — около 19‑й. Кривая со смещением датчика также остаётся отделена от предсказания порога.
Настройка среднего уровня, близкая к прогону B, разделила бы порог и время всего на ~0,6 °C. Выбранные условия слегка выходят за протестированный диапазон, и Claude отметил это в отчёте.
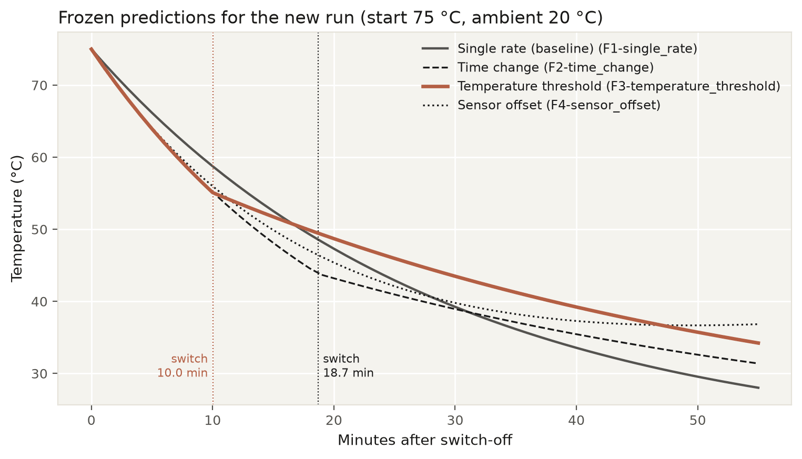
Предсказания кандидатов для выбранного прогона. Изображение автора.
Зафиксируйте предсказания до генерации данных
Я зафиксировал выбранные условия, подогнанные параметры и предсказания каждого кандидата до генерации любых новых измерений. Агент не получил подтверждающие измерения и не мог пересмотреть ответ после исхода.
Подтверждающие измерения используют ту же модель гауссова шума, отдельное фиксированное зерно и без добавленного выброса.
Оцените невидимый прогон
Отдельный код Python оценил замороженные предсказания. Он не вызывает API, поэтому Claude не участвует в оценке собственного ответа.
Оцените предсказания независимым Python
Предсказание порога прошло обе заранее заданные проверки. На невидимом прогоне оно дало 0,27 °C MAE и 0,32 °C RMSE. «Фиксированное время» получило 3,67 °C RMSE, «смещение датчика» — 2,35 °C, «одна скорость» — 4,28 °C.
В подтверждающем прогоне нет намеренно добавленного выброса, что частично объясняет меньшую ошибку по сравнению с результатами LORO. Также мог повлиять другой выбор случайного шума.
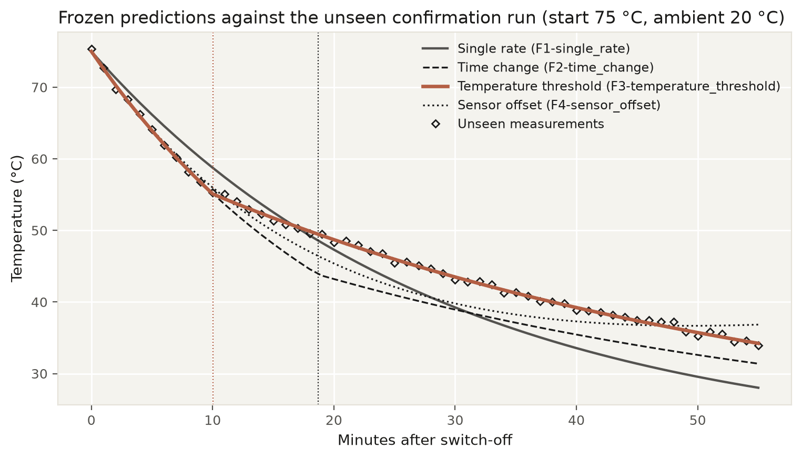
Замороженные предсказания совпадают с невидимыми измерениями. Изображение автора.
Сравните подогнанные параметры со скрытой истиной
После оценки сравните подогнанные параметры со скрытыми порождающими значениями:
import numpy as np
def true_curve(t0, ta, minutes, truth):
"""Newton cooling whose rate drops when the temperature crosses a threshold. Continuous at the switch."""
t = np.asarray(minutes, dtype=float)
k1, k2, th = truth["k_above"], truth["k_below"], truth["threshold_c"]
if t0 <= th:
return ta + (t0 - ta) * np.exp(-k2 * t)
t_cross = np.log((t0 - ta) / (th - ta)) / k1
fast = ta + (t0 - ta) * np.exp(-k1 * t)
slow = ta + (th - ta) * np.exp(-k2 * (t - t_cross)) # restarts from the threshold
return np.where(t <= t_cross, fast, slow)Симулятор добавляет гауссов шум с фиксированным зерном вокруг этой кривой.
Скрытое правило — температурный порог на 55 °C со скоростями 0,045 и 0,020 в минуту и стандартным отклонением шума 0,35 °C.
Подогнанные скорости совпадают до 3 знаков после запятой, порог отличается менее чем на 0,1 °C, а предсказанное время переключения — менее чем на 0,1 минуты.
Данные идентифицируют математическое правило, которое использовал симулятор. Они не могут показать, связано ли замедление реального устройства около 55 °C с фазовым переходом, циклом вентилятора или иной физической причиной.
Оцените, как агент пришёл к ответу
В отчёте в качестве свидетельств указывались идентификаторы подгонок и номера инструментов, а также то, чего три прогона установить не могут. Слабое место — ранняя догадка, о которой я упоминал. Один прогон исследования не показывает, как часто такая догадка оказывается неверной.
Посмотрите исследование в Streamlit
В видео я запускаю прогон в реальном времени, слежу за логом инструментов и открываю вкладки Report, Curves, Confirmation и Cost после оценки.
Интерфейс Streamlit показывает одно исследование. Видео автора.
Измерьте стоимость API Claude Fable 5.2
Исследование, включая финальный отчёт, стоило около $0.49 и заняло чуть больше минуты. SciPy работает на вашей машине и не добавляет ничего к счёту API.
Один лишь запрос отчёта занял почти половину стоимости и времени. Как упоминалось в разделе о цикле инструментов, новый формат вывода не попадает в кэш промпта, поэтому последний запрос снова обработал всю переписку перед записью длинного отчёта. Отдельно отслеживайте не кэшированный ввод, записи в кэш, чтения из кэша и вывод — у каждого своя цена.
Ограничения и практические моменты
Здесь важны два вида ограничений: что может показать эксперимент и что нужно коду перед запуском как сервиса.
Научные ограничения
Симулятор и кандидат с порогом используют одно и то же уравнение. Плавное переключение в реальном устройстве всё ещё может хорошо ложиться на эту модель, следуя другой кривой.
Если истинного правила нет среди кандидатов, агент всё равно может выбрать ближайшую модель вместо ответа inconclusive. Больше шума или едва пересечённый порог могут сделать ошибки слишком близкими для разделения. Другой прогон может идти в ином порядке инструментов.
Перед продакшеном
Ограничения в цикле инструментов охватывают одно исследование на вашей машине. Продакшен‑сервису нужно больше:
- Задайте повторы SDK и таймауты запросов для сервиса.
- Валидируйте каждый ввод и вывод инструмента в Python.
- Логируйте модель, версию SDK, причину остановки, токены, задержку и стоимость для каждого запроса.
- Закрепляйте версии модели и SDK, перегоняйте скрытый тест и подтверждайте политику хранения 30 дней перед апгрейдом.
Когда подходит этот шаблон
Используйте этот подход, когда подходит несколько объяснений, Python может их проверить, а скрытый эксперимент способен оценить выбор — особенно когда следующий эксперимент дороже вызова API.
Используйте чистый Python, когда семейство моделей известно. В рекомендациях по модели Fable 5.2 от Anthropic советуют сперва пробовать Opus, а Fable тестировать, если Opus не закрывает требования.
Итоги
Мы построили агента, который сравнил четыре модели охлаждения, выбрал температурный порог, спроектировал подтверждающий прогон и предсказал невидимые прежде измерения. Для этого синтетического устройства ответ на мой начальный вопрос — да.
Не стал бы переносить это на реальное оборудование или открытое исследование. Как уже говорилось, среди кандидатов было уравнение самого симулятора, и агент я запускал один раз.
Переносится методика: спрятать истину, задать правила оценки до первого запроса, заморозить предсказания и использовать отдельного оценщика. Полезный следующий тест — добавить модель с плавным переходом и повторить исследование при разных уровнях шума.
Для выбора модели наш курс Introduction to Claude Models охватывает линейку Claude и её компромиссы.
FAQs
Могу ли я отключить рассуждения или задать бюджет на рассуждения в Claude Fable 5.2?
Нет. Адаптивное мышление всегда включено, а и thinking: {type: "disabled"}, и budget_tokens возвращают ошибку 400. Вместо этого управляйте глубиной рассуждений параметром effort, который по умолчанию равен high. Токены рассуждений тарифицируются как вывод и учитываются в лимите max_tokens.
Почему Claude Fable 5.2 возвращает ошибку 400 после правки ранних сообщений?
Каждый блок рассуждений действителен только относительно системного промпта, инструментов и сообщений, которые ему предшествовали, и Fable 5.2 проверяет это при каждом запросе. Держите переписку только с добавлением и замораживайте system и tools на время сессии. Как временную меру можно установить prefix_mismatch_behavior в "drop_block" с бета‑заголовком — тогда затронутые блоки будут отбрасываться вместо ошибки.
Могу ли я принудить Claude Fable 5.2 вызвать конкретный инструмент?
Нет. Установка tool_choice в any или наименованного инструмента возвращает ошибку 400; работают только auto и none. Назовите инструмент в инструкции и укажите strict: true, чтобы вызов соответствовал вашей схеме. Если вызов обязателен, используйте системное сообщение посреди диалога.
Что происходит, когда Claude Fable 5.2 отказывается выполнить запрос?
Ответ приходит со значением stop_reason: "refusal", а stop_details.category сообщает, какой предохранитель сработал. Вы можете повторить запрос на другой модели сами или включить серверный фолбэк через fallbacks: "default" (бета), который повторит на Claude Opus 4.8 или Claude Opus 5. Модель‑фолбэк не получает блоки рассуждений Fable 5.2.
Можно ли использовать Claude Fable 5.2 с нулевым хранением данных?
По умолчанию — нет. Fable 5.2 требует 30‑дневного хранения данных, и API‑запросы от организации или рабочего пространства без этого требования вернут ошибку 400. В условиях ZDR включите 30‑дневное хранение для рабочего пространства или свяжитесь с вашей командой Anthropic.
Может ли Batch API заменить цикл инструментов в этом эксперименте?
Нет. Каждый шаг с инструментом зависит от предыдущего ответа, поэтому Batch API не может напрямую заменить этот цикл. Его скидка 50% подходит для независимых запросов или параллельных оценок.
Большие языковые модели хорошо умеют звучать так, словно пришли к ответу рассуждением. Проверить, действительно ли так, гораздо сложнее. В большинстве задач модель либо уже видела что-то похожее на ответ, либо ответ вообще невозможно верифицировать. Поэтому я построил тест, в котором ответ остаётся скрытым.
Claude Fable 5.2 получает зашумлённые показания от смоделированного устройства, которое остывает после выключения, и 4 возможных объяснения того, почему охлаждение замедляется на середине. Модель должна выбрать одно объяснение, спроектировать подтверждающий эксперимент и зафиксировать предсказание до того, как увидит хоть одно новое измерение. Отдельный код на Python затем оценивает предсказание, и Claude его не трогает.
Охлаждающее устройство — лишь тестовый кейс. Важна методика: скрыть истину от модели, зафиксировать правила оценки до первого вызова API, заморозить её предсказания и проверять их кодом, которого она не видит. Эту схему можно переиспользовать для любых задач «какое объяснение верно?», от поиска первопричин до интерпретации A/B‑теста.
В этом руководстве вы построите такого агента на Python. За математику отвечает SciPy; Claude решает, какую проверку выполнить дальше и к чему прийти. Если вы уверенно работаете с функциями Python и API‑запросами, сможете повторить, а математику охлаждения я объясняю при первом появлении. Мы рассмотрим, как:
В нашем обзоре Claude Fable 5.2 описаны запуск и бенчмарки, поэтому здесь я сосредоточусь на API и тесте охлаждения. Эксперимент проводился на следующий день после релиза.
Кратко
Я дал Fable 5.2 шумные данные от смоделированного устройства, чьё охлаждение замедляется на середине, и четыре возможных объяснения. Модель должна была выбрать одно, спроектировать новый эксперимент и предсказать результат до его наблюдения.