courses
OpenAI API 활용하기
3
175.5K
여기서는 GPT-6 Sol을 사용해 Northstar Checkout이라는 작은 가상의 파이썬 체크아웃 서비스를 로컬 v1 결제 어댑터에서 v2로 마이그레이션합니다.
구체적으로는 다음을 다룹니다.
첫 GPT-6 Sol API 호출을 만들고 usage 필드를 읽는 방법
모델이 저장소를 보기 전에 마이그레이션 계약을 정의하는 방법
GPT-6 Sol에 제한된 파일 및 테스트 도구를 제공하고 allowed_tools로 접근 단계를 설정하는 방법
트리아지에는 GPT-6 Luna를 사용하고 GPT-6 Sol로 후보군을 검증하는 방법
구조화된 마이그레이션 계획을 반환하고 GPT-6 Sol이 이미 읽은 파일에 대조하는 방법
WebSocket으로 마이그레이션을 실행하고 편집 시작 후 조향(steering)하는 방법
독립적인 배포 프로브 실패 후 추론 노력도를 높이는 방법
API 사용량에서 기록된 비용을 계산하는 방법
다음 네 가지 발견으로 다음 버전을 만드는 방식이 달라졌습니다.
GPT-6 Sol은 OpenAI의 GPT-6 제품군 중간 티어이며, API 모델 ID는 gpt-6-sol 입니다. GPT-6 모델 티어 가이드에서 출시와 벤치마크를 다룹니다. OpenAI의 GPT-6 안내서는 GPT-6 Astra를 최상위, GPT-6 Sol을 중간, GPT-6 Luna를 최저 비용으로 위치시킵니다.
GPT-6 Sol은 1,050,000 토큰 컨텍스트 윈도우를 가지며 최대 128,000 출력 토큰을 반환합니다. 추론 노력도는 none부터 max까지이며 기본값은 medium입니다. Chat Completions는 GPT-6 Sol의 함수 호출을 none에서만 지원하므로, 여기의 모든 요청은 Responses API를 사용합니다.
가격과 API 지원이 하네스가 각 요청을 보내는 방식을 결정합니다.
OpenAI의 가격 페이지에 따르면, GPT-6 Sol은 입력 토큰 100만 개당 $2, 출력 토큰 100만 개당 $10이며, 272,000 입력 토큰까지의 요청에 적용됩니다. 캐시된 입력은 100만 개당 $0.20, 캐시 쓰기는 $2.50입니다. 동일한 네 가지 범주에서 GPT-6 Luna의 요율은 $0.10, $0.01, $0.125, $0.50입니다.
272,000 입력 토큰을 넘기면 전체 요청이 입력 및 캐시 요율의 2배, 출력 요율의 1.5배로 청구됩니다. 이 프로젝트의 어떤 요청도 그 근처에 가지 않았습니다.
하네스, 즉 모델을 둘러싼 파이썬 코드는 다음 GPT-6 제어 기능을 사용합니다.
턴 중간 조향은 실행 중인 응답을 업데이트합니다
configuration_update는 캐시된 프리픽스를 다시 쓰지 않고 추론 노력도를 변경합니다
allowed_tools는 요청에서 호출 가능한 하위 집합을 설정합니다
구조화된 출력은 계획과 보고서의 필드를 지정합니다
이 네 가지 제어는 모두 동일한 Responses API 응답 체인 내부에 머뭅니다.
Northstar Checkout을 Payments Adapter v1에서 v2로 이전하는 에이전트를 만듭니다. 두 어댑터는 이 실험을 위해 작성한 로컬 대체물로, 실제 결제 SDK는 아닙니다. 전체 코드, 픽스처, 기록된 실행은 이 GitHub 저장소에 있습니다.
저장소는 결제 코드와 관련 없는 모듈이 섞여 있으므로, GPT-6 Sol은 영향을 받는 파일을 스스로 찾아야 합니다. v2는 네 가지 어댑터 계약을 깨뜨립니다.
결제 생성이 client.charge(...)에서 client.payments.create(...)로 이동
결과 딕셔너리가 Money 금액을 가진 타입 객체로 변경
거절된 카드가 예외를 발생시키는 대신 상태를 반환
웹훅의 이름, 엔벨로프, 서명 헤더 변경
검색-치환은 메서드 이름 변경만 처리합니다. 동작 변화는 전혀 처리하지 못합니다.
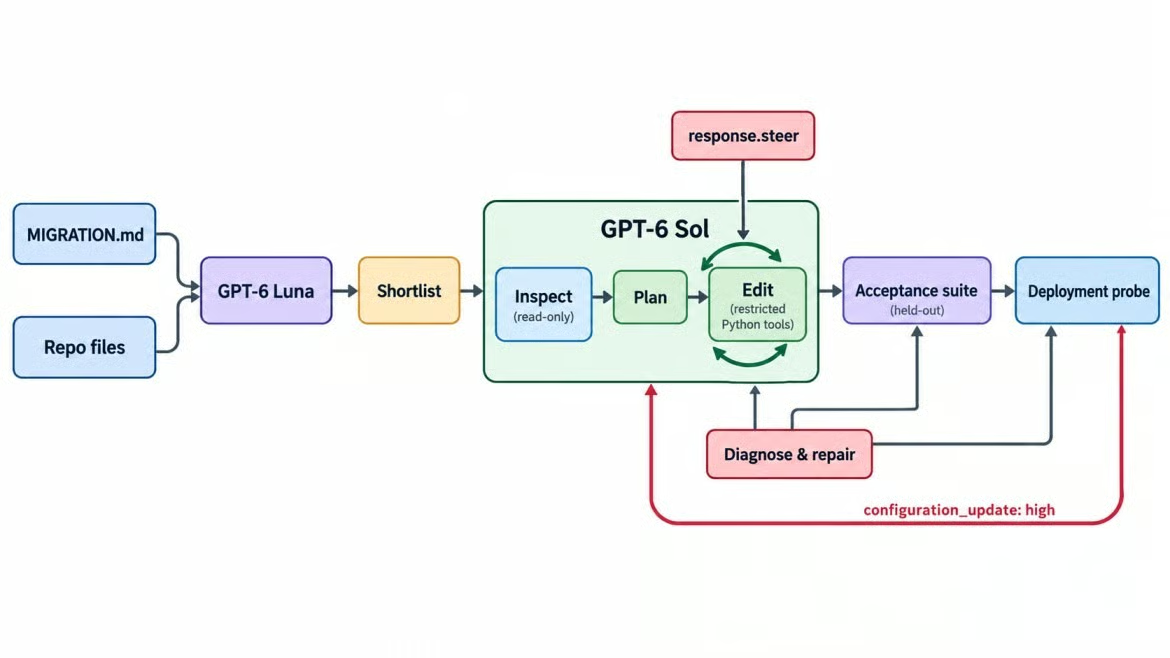
하나의 마이그레이션 루프, 두 개의 GPT-6 모델. 이미지: 작성자.
GPT-6 Sol은 스펙, 파일 트리, 단계적으로 호출 가능해지는 제한된 도구를 받습니다. 어떤 파일이 변경이 필요한지, 요구사항이 바뀔지 모릅니다.
스펙의 두 부분은 함정입니다. 의도적으로 심어둔 버그가 아니라, v2 동작이 기존 코드와 만난 결과입니다.
멱등성. v2는 반복된 request_id를 보면 파라미터를 비교하지만, 체크아웃은 매 시도마다 메타데이터에 새로운 order_id를 넣기 때문에, 단순 재시도는 중복 제거 대신 거절됩니다.
환불 총액. v2의 payment.refunded 웹훅은 지금까지의 총 환불액을 보고하는 반면, 기존 핸들러는 각 값을 +=로 누적합니다.
둘 다 타입 체커를 통과합니다. 체크아웃과 환불을 끝까지 실행해야만 발견됩니다.
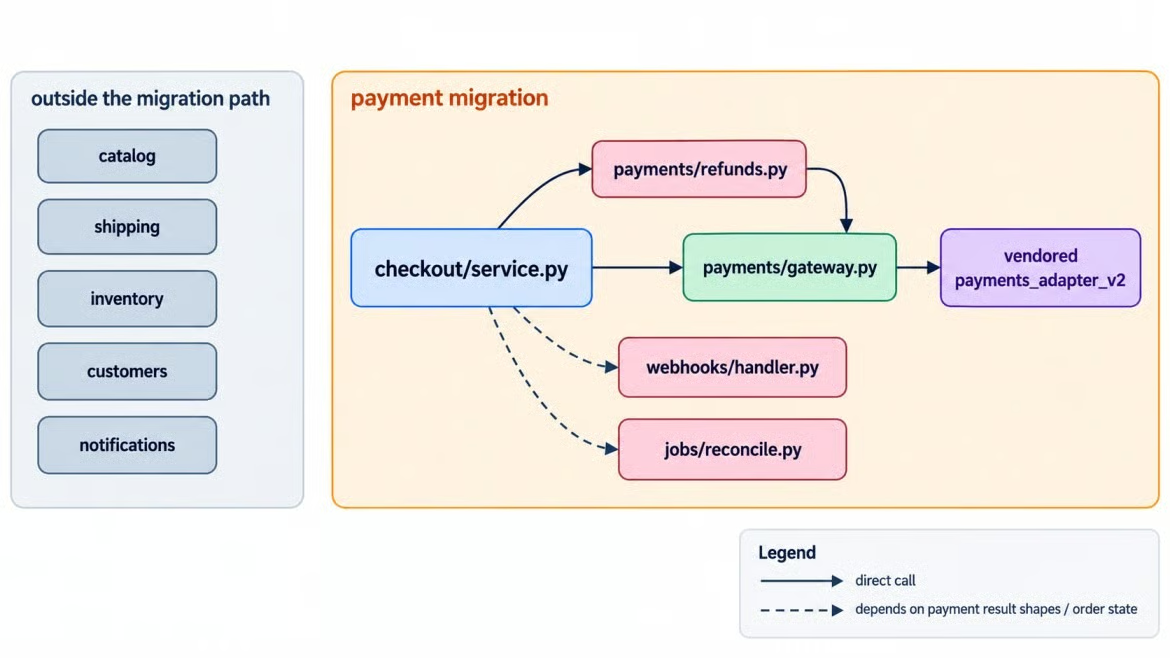
결제 변경은 여러 Northstar 모듈을 가로지릅니다. 이미지: 작성자.
지도는 어댑터를 직접 임포트하는 부분과 결제 동작에 의존하는 모듈을 구분합니다. 이러한 간접 연결 때문에 전체 저장소에 대한 정답 키가 중요합니다.
모델 호출 이전에 작성된 보류 인수 테스트 스위트가 결과를 결정합니다. GPT-6 Sol은 이를 전혀 보지 않으며, 하네스가 마이그레이션된 복사본에 대해 pytest로 실행합니다. 다음을 확인합니다.
체크아웃이 v2를 통해 성공하고, 동일한 멱등 키로 재시도 시 한 번만 청구
거절된 카드는 여전히 공개 CheckoutDeclined 오류를 발생
전액 환불, 두 번의 부분 환불, 재전달된 웹훅 모두가 올바른 총액 유지
CheckoutClient 메서드 시그니처 불변
v1 참조 없음, vendor/ 및 MIGRATION.md 미수정, 공개 테스트 통과
원본 코드는 이미 변경되지 않은 인터페이스와 보호 파일에 대한 검사에 합격했으며, 나머지 검사는 마이그레이션을 측정합니다. 별도의 정답 키가 필요한 변경을 나열하지만, 하네스만 이를 읽습니다.
acceptance/와 probes/ 디렉터리는 두 모델에 노출된 복사 저장소 바깥에 있습니다. 정답 키는 acceptance/ 아래에 있어 GPT-6 Luna의 입력, 파일 트리, 어떤 저장소 도구에도 들어갈 수 없습니다.
읽기 게이트는 GPT-6 Sol의 자체 계획에서 경로를 반환할 수 있습니다. 정답 키 커버리지 결과는 평가만을 위해 기록되며, 누락된 정답 경로를 GPT-6 Sol에 되돌려 보내지 않습니다.
그 후 배포 프로브가 실행됩니다. 두 검사 모두 모델의 "완료" 메시지를 증거로 인정하지 않습니다.
Python 3.10 이상과 두 모델에 접근 가능한 API 키가 필요합니다. 요구 사항에는 조향에 필요한 realtime extra가 포함됩니다.
git clone https://github.com/KhalidAbdelaty/gpt-6-sol-api.git
cd gpt-6-sol-api
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
macOS 또는 Linux에서는 source .venv/bin/activate와 cp .env.example .env를 사용한 뒤 OPENAI_API_KEY=...를 .env에 입력하세요.
키가 이미 Responses API에서 동작한다면, 다음 하위 섹션은 건너뛰세요.
가장 작은 유용한 요청은 키와 모델 ID, 비용 섹션에 필요한 usage 필드를 확인합니다.
from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()
client = OpenAI()
response = client.responses.create(
    model="gpt-6-sol",
    input="In one sentence, why is a breaking API migration harder than renaming a function?",
)
print(response.reasoning.effort, response.output_text)
print(response.usage)
응답은 medium 노력도를 보고하고, usage에는 cached_tokens와 cache_write_tokens가 포함됩니다. temperature와 top_p는 생략하세요. 둘 다 노력도가 none이 아닐 때마다 400을 반환합니다.
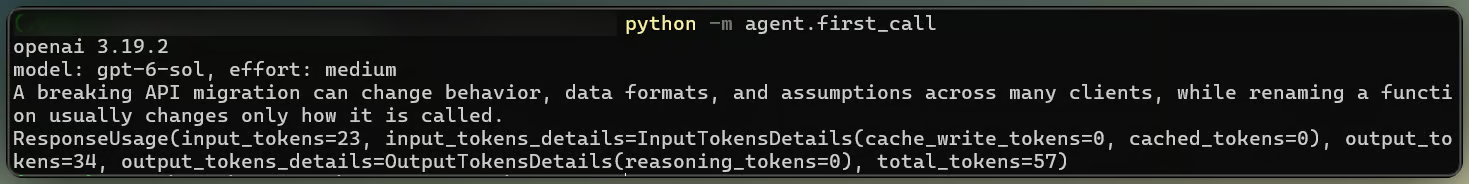
첫 GPT-6 Sol 요청이 usage를 반환. 이미지: 작성자.
medium인 기본값으로 시작하고, 전체 실행 동안 요청 수준 설정을 그대로 유지하세요. 대부분의 마이그레이션 턴은 읽기와 작은 수정입니다. 이후 배포 프로브가 노력도 상향의 근거를 제공합니다.
도구 계층이 에이전트의 권한을 소유합니다. GPT-6 Sol은 strict: true로 다음 함수 도구를 받습니다.
list_files 및 search_code로 관련 코드를 찾기
read_file는 하나의 저장소 파일 반환
edit_file은 정확히 한 곳의 발생만 변경
run_tests는 허용된 pytest 타깃 실행
엄격한 스키마는 인자 형태만 검사하고 경로 안전성은 검사하지 않으므로, 파이썬이 쓰기 경계를 강제합니다.
READ_ONLY = ("vendor/", "MIGRATION.md", "conftest.py")

if write:
    if rel_posix.startswith(READ_ONLY) or rel_posix in READ_ONLY:
        raise ToolError(f"{rel_posix} is read-only")  # the spec and both adapters
    if not rel_posix.startswith(("northstar/", "tests/")) or not rel_posix.endswith(".py"):
        raise ToolError("writes are limited to Python files under northstar/ and tests/")
경로는 먼저 해석되므로 ../와 절대 경로는 실패합니다. edit_file은 정확히 일치하는 한 곳만 대체하고, run_tests는 tests/ 아래의 타깃만 허용합니다.
하네스는 차단된 호출을 ERROR: 도구 출력으로 반환하며, 루프는 계속됩니다. 에이전트 하네스 엔지니어링 가이드는 왜 이러한 검사를 프롬프트가 아니라 하네스에 두는지 설명합니다.
각 도구를 반드시 거부해야 하는 입력으로 호출하세요.
..이 포함된 경로
절대 경로
vendor/ 아래의 쓰기
셸 명령을 포함한 테스트 타깃
어떤 것도 통과하면 안 됩니다. 둘 이상의 위치와 일치하는 수정은 더 많은 컨텍스트를 요청해야 하며, 규칙을 커스텀 함수에 두면 한 곳에서 테스트할 수 있습니다.
저장소 트리아지는 좁은 분류 작업입니다. 각 파일의 관련성을 평가하고 v1 참조를 인용합니다. GPT-6 Luna는 이 일만 맡고, GPT-6 Sol이 아무것도 검색하기 전에 먼저 실행됩니다.
class FileVerdict(BaseModel):
    path: str
    relevance: Literal["high", "medium", "low", "none"]
    legacy_references: list[str]

triage = client.responses.parse(model="gpt-6-luna", input=spec_and_all_files,
                                text_format=TriageResult)  # a list of FileVerdict
입력은 스펙과 northstar/ 및 tests/ 아래의 모든 파이썬 파일입니다. high 또는 medium로 평가된 것은 다음에 GPT-6 Sol이 받는 후보군에 포함됩니다.
앞서의 정답 키와 후보군을 대조하고, 먼저 재현율을 봅니다. GPT-6 Luna는 영향을 받은 모든 파일을 유지했고, 변경이 필요 없는 몇 개를 추가했습니다.
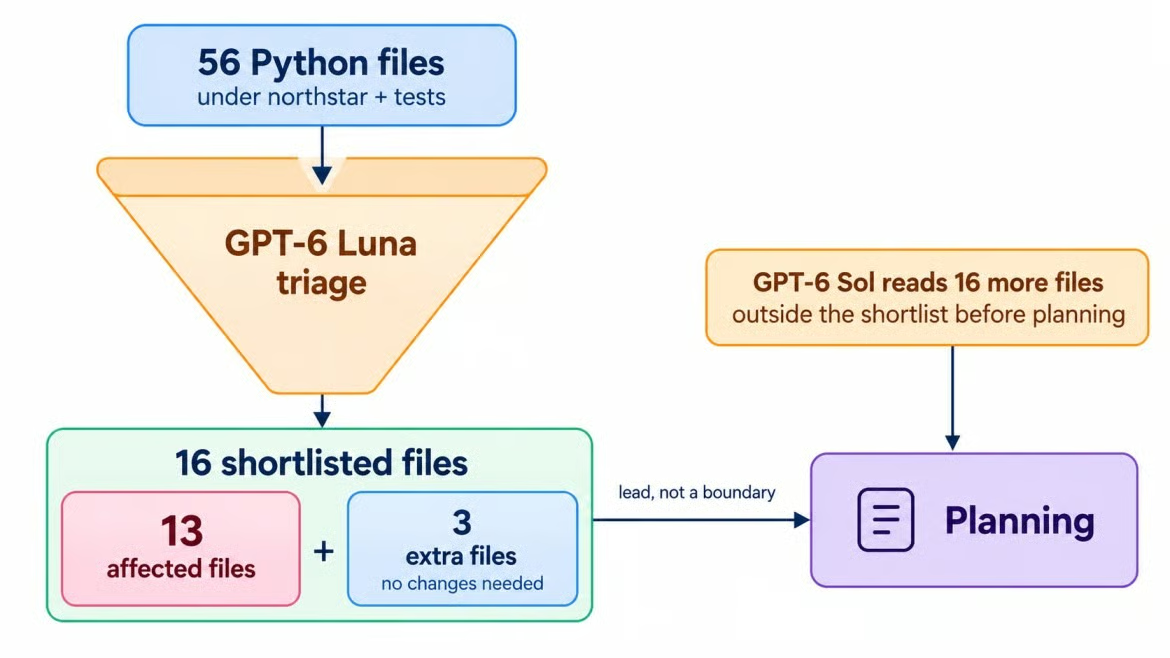
GPT-6 Luna가 56개를 16개로 좁힙니다. 이미지: 작성자.
후보군은 단서이지 경계가 아닙니다.
allowed_tools 사용 방법allowed_tools는 전체 도구 목록을 유지하면서 모델이 호출할 수 있는 도구를 제한하는 tool_choice 모드입니다. 이것이 GPT-6 Sol의 첫 번째 패스를 읽기 전용으로 유지하는 방식입니다. 전체 목록은 모든 요청에 정의되어 있지만, 목록과 검색만 호출 가능합니다.
def allowed(names):
    return {"type": "allowed_tools", "mode": "auto",
            "tools": [{"type": "function", "name": n} for n in names]}

response = client.responses.create(
    model="gpt-6-sol", instructions=INSTRUCTIONS, tools=TOOLS,  # full list, every time
    tool_choice=allowed(["list_files", "search_code"]),
    reasoning={"effort": "medium"}, input=inspect_prompt, store=True,
)tools를 단계 사이에 바꾸면 캐시된 프리픽스를 다시 씁니다. 함수 호출 가이드는 호출 가능한 하위 집합만 바뀌어야 할 때 allowed_tools를 권장합니다.
읽기 전용 패스는 진단과 실행을 분리합니다. GPT-6 Sol은 오탐 가능성을 경고한 GPT-6 Luna의 후보군을 받았고, v1 임포트, charge 호출, 웹훅 이름에 대한 검색만으로 영향을 받은 모든 파일을 스스로 드러냈습니다.
또한 후보군을 넘어 주문 모델, 주문 저장소, 시리얼라이저, 원장(ledger) 내보내기를 다운스트림 의존성으로 표시했습니다. 이들 중 어떤 것도 실제로 변경이 필요하지 않았지만, 읽어봐야만 그 사실을 알 수 있습니다. 파일을 편집하는 모든 에이전트에 allowed_tools를 유지하겠습니다.
마이그레이션 계획은 에이전트가 쓰기 권한을 받기 전에 특정 파일에 커밋하는 단계입니다. 계획 수립에서는 read_file이 추가되며, 도구는 꺼진 상태에서 구조화된 출력으로 계획을 반환합니다.
plan = client.responses.parse(
    model="gpt-6-sol", instructions=INSTRUCTIONS, tools=TOOLS, tool_choice="none",
    reasoning={"effort": "medium"}, previous_response_id=last_id,
    input=PLAN_REQUEST, text_format=MigrationPlan,  # files, evidence, risks
)
계획은 필요한 모든 변경을 다뤘고, 재시도 시 새로운 order ID가 v2 메타데이터를 변경할 것이라는 경고를 남겼습니다. 그 경고는 나중에 돌아옵니다.
쓰기 권한을 부여하기 전에, 하네스는 계획의 구조, 증거, 커버리지를 확인합니다.
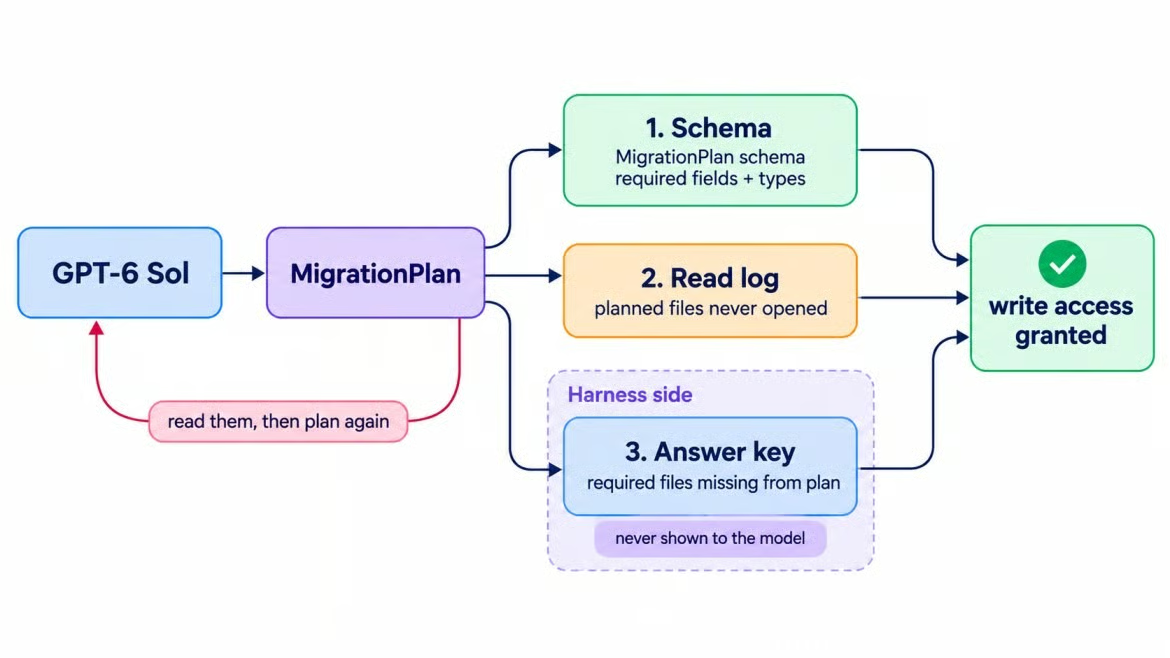
세 가지 검사가 하나의 마이그레이션 계획을 테스트합니다. 이미지: 작성자.
계획은 각 게이트를 통과했습니다. 또한 스펙의 정리 섹션 제안에 따라 v2 명명에 맞추기 위해 공개 client.py 파라미터 이름 변경을 제안했습니다. 이 제안이 조향 테스트가 됩니다.
GPT-6 Sol 코딩 에이전트는 도구 루프를 사용합니다. 응답을 기다리고, 그 함수 호출을 실행하고, 출력을 반환합니다. OpenAI Responses API 가이드는 요청 및 도구 결과 형식을 설명합니다. 이 마이그레이션은 조향이 필요하므로 루프를 하나의 WebSocket 연결에서 유지합니다.
with client.responses.connect() as conn:
    conn.response.create(**base, previous_response_id=plan_id, input=[start_message])
    for event in conn:
        if event.type == "response.incomplete":
            reason = getattr(event.response.incomplete_details, "reason", None)
            if reason == "steered":
                continue  # keep reading for the automatic successor
            raise RuntimeError(reason or "response incomplete")
        if event.type != "response.completed":
            continue
        calls = [i for i in event.response.output if i.type == "function_call"]
        if not calls:
            break  # GPT-6 Sol says it's done here; the held-out tests decide whether it is
        outputs = [{"type": "function_call_output", "call_id": c.call_id,
                    "output": tools.run(c.name, c.arguments)} for c in calls]
        conn.response.create(**base, previous_response_id=event.response.id,
input=outputs)base는 모델, 지침, 도구, medium 노력도를 프롬프트 캐싱을 위해 고정합니다. GPT-6 Sol은 작업하면서 공개 테스트를 실행했지만, 대부분의 새로운 테스트를 직접 작성했으므로 독립적인 검증에는 사용할 수 없습니다.
턴 중간 조향은 실행 중인 응답에 지시를 추가하되, 취소하지 않습니다. response.created 이후 동일한 연결에서 해당 응답 ID와 함께 response.steer를 보내면, 서버가 후속 응답에 그 지시를 적용합니다.
새 요구사항은 스토어프론트 팀에서 왔습니다. CheckoutClient 시그니처는 "오늘과 정확히 동일하게" 유지되어야 했습니다. 다른 서비스가 이를 호출하기 때문입니다. 도착 시점을 타이머에 맡기고 싶지 않아, 하네스가 저장소를 감시합니다. 각 도구 호출 배치 후 디스크의 공개 시그니처를 원본과 비교하고, 첫 차이가 조향을 가동합니다.
if steer_state == "idle" and signature_changes(repo):  # CheckoutClient, compared with ast
    steer_state = "armed"

if event.type == "response.created" and steer_state == "armed":
    conn.response.steer(previous_response_id=event.response.id, input=STEER_TEXT)
    steer_state = "sent"
이는 조향이 그에 반하는 이름 변경 이후에 도착하도록 보장하며, 바로 그 상황이 테스트 가치가 있습니다. 더 일찍 보내면 그저 더 긴 프롬프트일 뿐입니다.
그 다음 서버는 조향 라이프사이클을 보고했습니다.
response.steer.accepted는 업데이트가 적용된 것이 아니라 큐에 들어갔음을 의미
response.incomplete가 원래 응답을 steered 이유로 종료
후속 response.created가 새로운 요구사항으로 계속 진행
응답이 도구 결과를 기다리는 중이라면, 서버는 response.steer.pending를 보내고 하네스가 결과를 반환할 때까지 조향을 보류합니다. 조향 보류 중에도 도구 호출에 계속 응답하세요.
조향은 모델이 다음에 하는 일을 바꿉니다. OpenAI의 가이드는 나머지에 대해 명확합니다. 조향은 이미 전송된 출력을 다시 쓰지 않고, 이전 작업을 취소하지 않으며, 이미 시작된 도구를 중단하지 않습니다.
조향이 도착했을 때 이름 변경은 이미 디스크의 client.py에 반영되어 있었습니다. GPT-6 Sol은 이를 되돌렸고, 이후 보류된 시그니처 검사가 최종 인터페이스를 확인했습니다.
편집은 되돌릴 수 있습니다. 이미 외부 시스템을 호출한 도구는 되돌릴 것이 없으므로, 각 조향이 도착할 때 저장소 상태를 기록하세요.
이 저장소에서는 가능합니다. 다만 한 번에 끝나지는 않았습니다. 첫 마이그레이션은 원래 계약을 충족했지만, 배포 프로브가 누락된 케이스를 드러냈습니다.
GPT-6 Sol이 마이그레이션 완료를 보고했을 때, 보류된 스위트는 복구 라운드 없이 통과했습니다. 환불 부분에서는 GPT-6 Sol이 덧셈을 누적 읽기로 바꾸어, 순서가 뒤바뀐 웹훅도 무시했습니다.
-        order.refunded_cents += data["amount_refunded"]
+        order.refunded_cents = max(order.refunded_cents, refunded["cents"])
멱등성의 경우 GPT-6 Sol은 시도마다 새로운 order_id를 유지하면서, v2에 도달하기 전에 반복 요청에 응답하는 요청 캐시를 주문 저장소에 추가했습니다. 이 캐시는 프로세스 메모리에 존재하며, 곧 중요해집니다.
그럴 수 있습니다. 첫 보고서는 업데이트된 웹훅 테스트를 회귀로 간주했고, 비록 계획에서 함정을 명시했음에도 서버 간 재시도 위험을 누락했습니다.
구조화된 출력은 스키마를 검증할 뿐, 그 주장들은 아닙니다. 기록된 증거와 보고서 필드를 대조하고, 위험 목록이 비었다고 남은 위험이 없다는 증거로 보지 마세요.
스위트는 다른 앱 인스턴스로 라우팅된 재시도를 놓쳤습니다. 프로세스 메모리를 공유하지 않는 두 클라이언트가 하나의 결제 프로세서를 공유하는 배포 프로브를 추가했습니다.
프로브는 실패했습니다. 두 번째 인스턴스의 재시도가 payments_adapter_v2.IdempotencyConflict를 발생시켰는데, 스토어프론트가 보도록 설계되지 않은 어댑터 예외였습니다.
둘 이상의 프로세스가 있는 배포에서만 이 실패가 드러나며, 이것이 추론 상향의 트리거가 됩니다.
configuration_update 입력 항목은 다음 응답과 그 이후 모든 응답에 대한 추론 노력도를 변경합니다. 다른 업데이트가 대체하기 전까지 유지됩니다. 요청 수준 노력도는 그대로여서 캐시된 프리픽스가 유지됩니다. 프로브가 실패했을 때, 하네스는 추론 가이드에 따라 다음 요청을 보냈습니다.
마이그레이션 요청은 store=True를 사용하므로, WebSocket이 닫힌 후에도 하네스는 일반 Responses API 요청으로 저장된 응답 체인을 이어갈 수 있습니다.
response = client.responses.create(
    model="gpt-6-sol", reasoning={"effort": "medium"},  # unchanged, so the prefix survives
    instructions=INSTRUCTIONS, tools=TOOLS, tool_choice=allowed(DIAGNOSE_TOOLS),
    previous_response_id=last_id,
    input=[{"type": "configuration_update", "reasoning": {"effort": "high"}},
           {"role": "user", "content": probe_failure + DIAGNOSE_FIRST}],
)
active_effort = "high"  # the harness records it; the response won't
GPT-6 Sol은 실패와 배포 형태를 받지만, 수정에 대한 힌트는 없습니다. DIAGNOSE_TOOLS는 읽기와 테스트만 허용하고, 편집은 허용하지 않습니다. 도구와 text.format을 변경하지 않으면 캐시된 프리픽스가 유지됩니다.
하나 아쉬운 API 세부사항: response.reasoning.effort은 업데이트 이후에도 요청 수준 설정을 보고합니다. 하네스는 응답에서 활성 노력도를 되읽을 수 없으므로, 업데이트를 보낼 때 값을 자체적으로 기록하고 이후 모든 응답에 태깅합니다.
high 노력도의 복구는 성공했나요?성공했습니다. GPT-6 Sol은 두 번째 서버의 로컬 저장소에서 실패를 추적한 다음, 새로운 order ID가 결제 메타데이터로 들어가는 경로를 따라갔습니다. 공유 프로세서는 동일한 request_id에 대해 다른 파라미터를 보게 되었습니다.
수정은 order ID를 request ID의 함수로 만들어, 모든 서버가 동일한 값을 계산하도록 했습니다.
-def new_order_id() -> str:
+def new_order_id(request_id: str | None = None) -> str:
+    if request_id:
+        stable = uuid.uuid5(uuid.NAMESPACE_URL, f"northstar.checkout.order:{request_id}")
+        return f"ord_{stable.hex[:12]}"
     return f"ord_{uuid.uuid4().hex[:12]}"
GPT-6 Sol은 이 케이스에 대한 공개 테스트도 추가했습니다. 프로브와 인수 스위트 모두 통과했고, 이어서 configuration_update로 노력도를 medium으로 되돌렸습니다. 최종 보고서는 이번에 실제 실패를 정확히 설명했습니다.
프로젝트의 Streamlit 앱은 API 호출 없이 저장된 실행을 재생합니다. 영상은 개요에서 조향 이벤트로, 그리고 인수 및 프로브 결과로 이동합니다.
데이터캠프와 함께 배우기
courses
courses
courses