
Kurs
Arbeiten mit der OpenAI-API
3 Std.
175.5K
Hier migrieren wir Northstar Checkout, einen kleinen fiktiven Python-Checkout-Service, mit GPT-6 Sol von einem lokalen Zahlungsadapter v1 auf v2.
Konkret zeige ich dir, wie du:
Den ersten GPT-6 Sol API-Call machst und die Usage-Felder liest
Den Migrationsvertrag definierst, bevor das Modell das Repository sieht
GPT-6 Sol restriktive Datei- und Test-Tools gibst und den Zugriff mit allowed_tools staffelst
GPT-6 Luna für die Triage nutzt und GPT-6 Sol die Shortlist verifizieren lässt
Einen strukturierten Migrationsplan zurückgibst und ihn gegen bereits gelesene Dateien von GPT-6 Sol prüfst
Die Migration über WebSocket laufen lässt und sie nach Start der Edits steuerst
Den Reasoning-Aufwand erhöhst, nachdem eine unabhängige Deployment-Probe fehlschlägt
Die aufgezeichneten Kosten aus der API-Nutzung berechnest
Vier Einsichten würden meine nächste Version prägen:
GPT-6 Sol ist die mittlere Stufe der GPT-6-Familie von OpenAI, die API-Model-ID ist gpt-6-sol. Unser Leitfaden zu den GPT-6-Modellstufen deckt Launch und Benchmarks ab. OpenAIs GPT-6 Guidance ordnet GPT-6 Astra an die Spitze, GPT-6 Sol in die Mitte und GPT-6 Luna als günstigste Stufe ein.
GPT-6 Sol hat ein Kontextfenster von 1.050.000 Tokens und liefert bis zu 128.000 Output-Tokens. Der Reasoning-Aufwand reicht von none bis max und ist standardmäßig medium. Chat Completions unterstützt die Funktionsaufrufe von GPT-6 Sol nur bei none, daher verwenden alle Anfragen hier die Responses API.
Preisgestaltung und API-Support bestimmen, wie das Harness jede Anfrage sendet.
GPT-6 Sol kostet 2 $ pro Million Input-Tokens und 10 $ pro Million Output-Tokens für Anfragen bis 272.000 Input-Tokens, laut OpenAIs Preisseite. Zwischengespeicherter Input kostet 0,20 $ pro Million, Cache-Writes 2,50 $. GPT-6 Lunas Preise für dieselben vier Kategorien liegen bei 0,10 $, 0,01 $, 0,125 $ und 0,50 $.
Über 272.000 Input-Tokens wird die gesamte Anfrage mit dem 2-fachen Input- und Cache-Satz sowie dem 1,5-fachen Output-Satz abgerechnet. Keine Anfrage in diesem Projekt kam in die Nähe.
Das Harness – die Python-Umgebung rund um das Modell – nutzt diese GPT-6-Regler:
Steering während der Antwort aktualisiert eine laufende Antwort
configuration_update ändert den Reasoning-Aufwand ohne das zwischengespeicherte Prefix neu zu schreiben
allowed_tools legt die aufrufbare Teilmenge pro Anfrage fest
Structured Outputs definieren die Felder für Plan und Report
Alle vier Regler bleiben in derselben Responses-API-Response-Kette.
Wir bauen einen Agenten, der Northstar Checkout von Payments Adapter v1 auf v2 umstellt. Beide Adapter sind lokale Platzhalter, die ich für dieses Experiment geschrieben habe – keine echten Payment-SDKs. Der vollständige Code, Fixtures und ein aufgezeichneter Lauf sind in diesem GitHub-Repository.
Das Repository mischt Payment-Code mit unabhängigen Modulen, daher muss GPT-6 Sol die betroffenen Dateien selbst finden. V2 bricht vier Adapterverträge:
Die Zahlungserstellung wechselt von client.charge(...) zu client.payments.create(...)
Result-Dictionaries werden zu typisierten Objekten mit Beträgen vom Typ Money
Abgelehnte Karten liefern einen Status statt eine Exception zu werfen
Webhooks ändern Namen, Hülle und Signatur-Header
Suchen-und-Ersetzen erledigt die Methodenumbenennung. Keine der Verhaltensänderungen werden so abgedeckt.
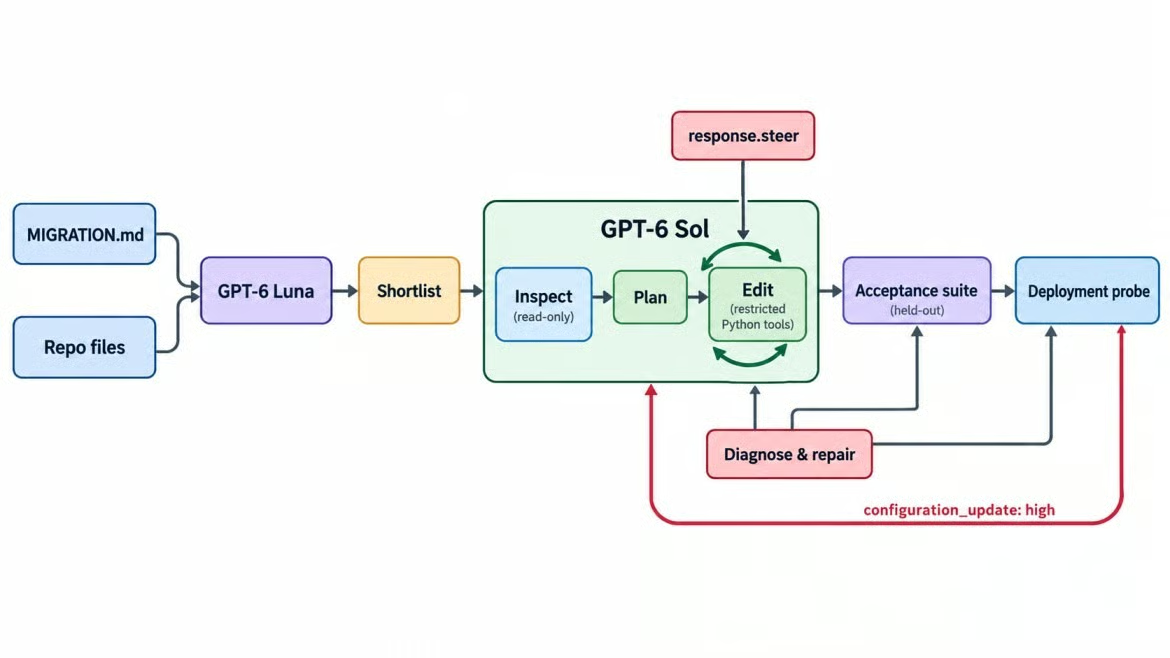
Eine Migrationsschleife, zwei GPT-6-Modelle. Bild: Autor.
GPT-6 Sol erhält die Spezifikation, den Dateibaum und restriktive Tools, die stufenweise aufrufbar werden. Es weiß nicht, welche Dateien geändert werden müssen oder dass sich eine Anforderung ändern wird.
Zwei Teile der Spez sind Fallen. Keiner ist ein absichtlich eingeschleuster Bug; beide entstehen aus v2-Verhalten in Kombination mit vorhandenem Code:
Idempotenz. V2 vergleicht Parameter bei wiederholter request_id, aber Checkout setzt bei jedem Versuch eine frische order_id in die Metadaten, deshalb wird ein naiver Retry abgelehnt statt dedupliziert.
Refund-Totale. Der v2-Webhook payment.refunded meldet den bisher insgesamt erstatteten Betrag, während der alte Handler jeden Wert mit += addiert.
Beides übersteht einen Type-Checker. Du findest es nur, wenn du Checkout und Refunds End-to-End ausführst.
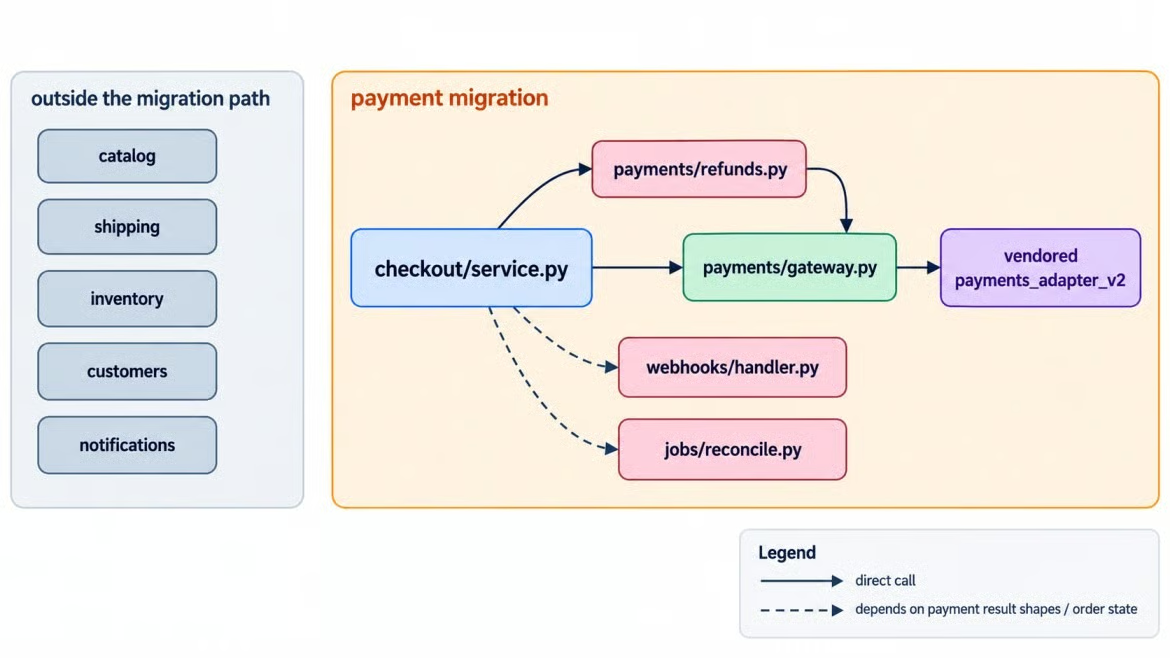
Zahlungsänderungen betreffen mehrere Northstar-Module. Bild: Autor.
Die Karte trennt direkte Adapter-Imports von Modulen, die vom Zahlungs-Verhalten abhängen. Diese indirekten Verbindungen sind der Grund, warum ein Antwortschlüssel für das gesamte Repository wichtig ist.
Eine zurückgehaltene Acceptance-Suite, vor dem ersten Modellaufruf geschrieben, entscheidet über das Ergebnis. GPT-6 Sol sieht sie nie; das Harness führt sie mit pytest gegen die migrierte Kopie aus. Sie prüft, dass:
Checkout über v2 gelingt und ein Retry mit demselben Idempotency-Key nur einmal belastet
Eine abgelehnte Karte weiterhin den öffentlichen Fehler CheckoutDeclined auslöst
Eine Vollerstattung, zwei Teil-Erstattungen und ein erneut zugestellter Webhook stets korrekte Totale hinterlassen
CheckoutClient-Methodensignaturen unverändert bleiben
Keine v1-Referenzen mehr vorhanden sind, vendor/ und MIGRATION.md unberührt bleiben und die sichtbaren Tests bestehen
Der ursprüngliche Code besteht bereits Checks für unveränderte Schnittstellen und geschützte Dateien; die restlichen Checks messen die Migration. Ein separater Antwortschlüssel listet die nötigen Änderungen – gelesen wird er nur vom Harness.
Die Verzeichnisse acceptance/ und probes/ liegen außerhalb der kopierten Repository-Version, die beiden Modellen zugänglich ist. Der Antwortschlüssel liegt unter acceptance/ und kann daher weder in GPT-6 Lunas Input noch in den Dateibaum oder ein Repo-Tool gelangen.
Das Read-Gate kann Pfade aus GPT-6 Sols eigenem Plan zurückgeben. Die Answer-Key-Coverage wird nur für die Auswertung aufgezeichnet; fehlende Ground-Truth-Pfade werden nie an GPT-6 Sol zurückgespielt.
Nach der Suite läuft eine Deployment-Probe. Keiner der Checks akzeptiert die „fertig“-Meldung des Modells als Beweis.
Du brauchst Python 3.10 oder neuer und einen API-Key mit Zugriff auf beide Modelle. Die Requirements beinhalten das realtime-Extra für Steering:
git clone https://github.com/KhalidAbdelaty/gpt-6-sol-api.git
cd gpt-6-sol-api
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
Unter macOS oder Linux verwende source .venv/bin/activate und cp .env.example .env und trage dann OPENAI_API_KEY=... in .env ein.
Wenn dein Key mit der Responses API schon funktioniert, kannst du den nächsten Abschnitt überspringen.
Die kleinste sinnvolle Anfrage bestätigt Key, Model-ID und die Usage-Felder, die du für die Kosten brauchst:
from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()
client = OpenAI()
response = client.responses.create(
    model="gpt-6-sol",
    input="In one sentence, why is a breaking API migration harder than renaming a function?",
)
print(response.reasoning.effort, response.output_text)
print(response.usage)
Die Antwort meldet den Aufwand medium und usage enthält cached_tokens und cache_write_tokens. Lass temperature und top_p weg. Beide führen zu 400, wenn der Aufwand nicht none ist.
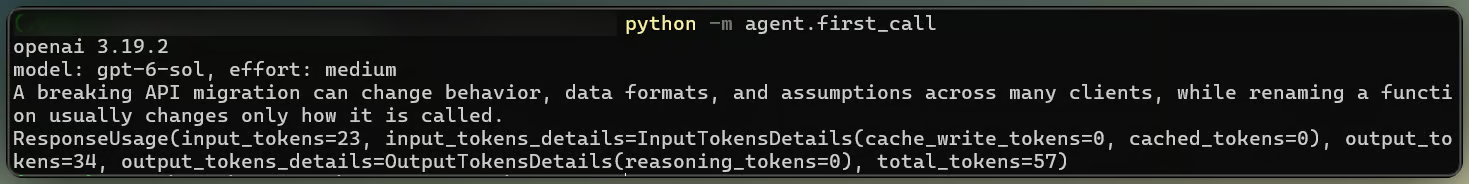
Erster GPT-6 Sol-Request liefert Usage. Bild: Autor.
Starte mit medium, dem Standard, und belasse die Einstellung auf Anfrage-Ebene für den gesamten Lauf dort. Die meisten Migrations-Turns sind Reads und kleine Edits. Die Deployment-Probe liefert später den Grund, den Aufwand zu erhöhen.
Die Tool-Schicht bestimmt die Berechtigungen des Agenten. GPT-6 Sol bekommt diese Funktions-Tools mit strict: true:
list_files und search_code finden relevanten Code
read_file liefert eine Repository-Datei zurück
edit_file ändert genau ein Vorkommen
run_tests führt ein erlaubtes pytest-Target aus
Strikte Schemas prüfen die Argument-Form, nicht die Pfadsicherheit, deshalb erzwingt Python die Schreibgrenze:
READ_ONLY = ("vendor/", "MIGRATION.md", "conftest.py")

if write:
    if rel_posix.startswith(READ_ONLY) or rel_posix in READ_ONLY:
        raise ToolError(f"{rel_posix} is read-only")  # the spec and both adapters
    if not rel_posix.startswith(("northstar/", "tests/")) or not rel_posix.endswith(".py"):
        raise ToolError("writes are limited to Python files under northstar/ and tests/")
Der Pfad wird zuerst aufgelöst, daher schlagen ../ und absolute Pfade fehl. edit_file ersetzt genau ein exaktes Match, und run_tests akzeptiert nur Targets unter tests/.
Das Harness gibt einen blockierten Aufruf als ERROR: Tool-Output zurück, und die Schleife läuft weiter. Unser Guide zum Agent-Harness-Engineering erklärt, warum diese Checks ins Harness und nicht ins Prompt gehören.
Rufe jedes Tool mit einem Input auf, den es ablehnen muss:
Ein Pfad mit ..
Ein absoluter Pfad
Ein Write unter vendor/
Ein Test-Target mit Shell-Befehl
Keiner davon darf durchkommen. Ein Edit mit mehr als einer Übereinstimmung sollte nach mehr Kontext fragen. Eigene Funktionen bündeln die Regeln an einem gut testbaren Ort.
Repository-Triage ist eine enge Klassifizierungsaufgabe: Relevanz je Datei bewerten und v1-Referenzen zitieren. GPT-6 Luna erledigt genau diese Aufgabe und sonst nichts – und läuft zuerst, bevor GPT-6 Sol irgendetwas gesucht hat.
class FileVerdict(BaseModel):
    path: str
    relevance: Literal["high", "medium", "low", "none"]
    legacy_references: list[str]

triage = client.responses.parse(model="gpt-6-luna", input=spec_and_all_files,
                                text_format=TriageResult)  # a list of FileVerdict
Der Input ist die Spez plus alle Python-Dateien unter northstar/ und tests/. Alles mit Bewertung high oder medium kommt auf die Shortlist, die GPT-6 Sol als Nächstes erhält.
Vergleiche die Shortlist mit dem früheren Antwortschlüssel und schau zuerst auf die Recall. GPT-6 Luna hat jede betroffene Datei behalten und ein paar unnötige ergänzt.
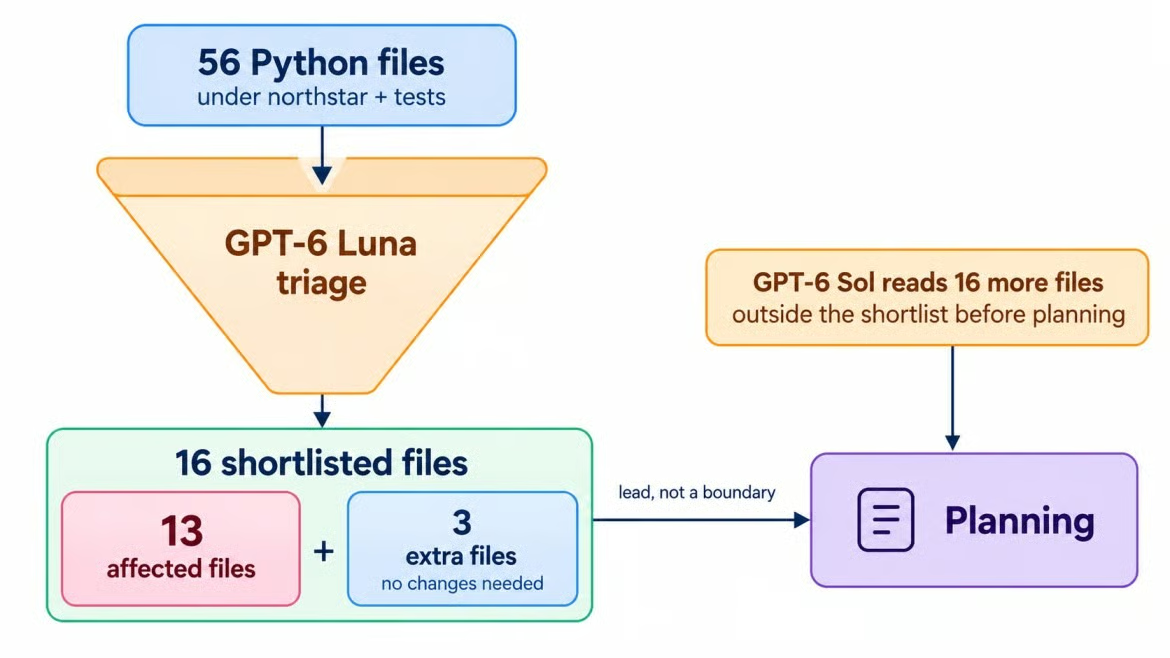
GPT-6 Luna verengt 56 auf 16. Bild: Autor.
Eine Shortlist ist ein Hinweis, keine Grenze.
allowed_tools für gestaffelte Berechtigungenallowed_tools ist ein tool_choice-Modus, der festlegt, welche Tools das Modell aufrufen darf, während die volle Tool-Liste bestehen bleibt. So bleibt der erste Durchlauf von GPT-6 Sol read-only: Die volle Liste ist auf jeder Anfrage definiert, aber nur Listen und Suchen sind aufrufbar.
def allowed(names):
    return {"type": "allowed_tools", "mode": "auto",
            "tools": [{"type": "function", "name": n} for n in names]}

response = client.responses.create(
    model="gpt-6-sol", instructions=INSTRUCTIONS, tools=TOOLS,  # full list, every time
    tool_choice=allowed(["list_files", "search_code"]),
    reasoning={"effort": "medium"}, input=inspect_prompt, store=True,
)
Das Ändern von tools zwischen Phasen überschreibt das zwischengespeicherte Prefix. Der Function-Calling-Guide empfiehlt allowed_tools, wenn sich nur die aufrufbare Teilmenge ändern soll.
Ein Read-Only-Durchlauf trennt Diagnose von Aktion. GPT-6 Sol bekam die GPT-6 Luna-Shortlist mit dem klaren Hinweis, dass sie falsch sein kann, und seine Suchen nach v1-Imports, charge-Aufrufen und Webhook-Namen brachten alle betroffenen Dateien eigenständig zutage.
Es ging auch über die Liste hinaus, markierte Order-Modelle, den Order-Store, Serializer und den Ledger-Export als Downstream-Abhängigkeiten zum Prüfen. Keines davon brauchte am Ende Änderungen – aber das findest du nur durchs Lesen heraus. Ich würde allowed_tools für jeden Agenten beibehalten, der Dateien editiert.
Ein Migrationsplan ist die Stelle, an der sich der Agent vor Schreibzugriff auf konkrete Dateien festlegt. Beim Planen kommt read_file hinzu, und der Plan kommt über Structured Outputs zurück – mit abgeschalteten Tools:
plan = client.responses.parse(
    model="gpt-6-sol", instructions=INSTRUCTIONS, tools=TOOLS, tool_choice="none",
    reasoning={"effort": "medium"}, previous_response_id=last_id,
    input=PLAN_REQUEST, text_format=MigrationPlan,  # files, evidence, risks
)
Der Plan deckte alle nötigen Änderungen ab und warnte, dass eine frische Order-ID bei einem Retry die v2-Metadaten verändert. Diese Warnung kehrt später zurück.
Bevor Schreibzugriff gewährt wird, prüft das Harness Struktur, Evidenz und Abdeckung des Plans.
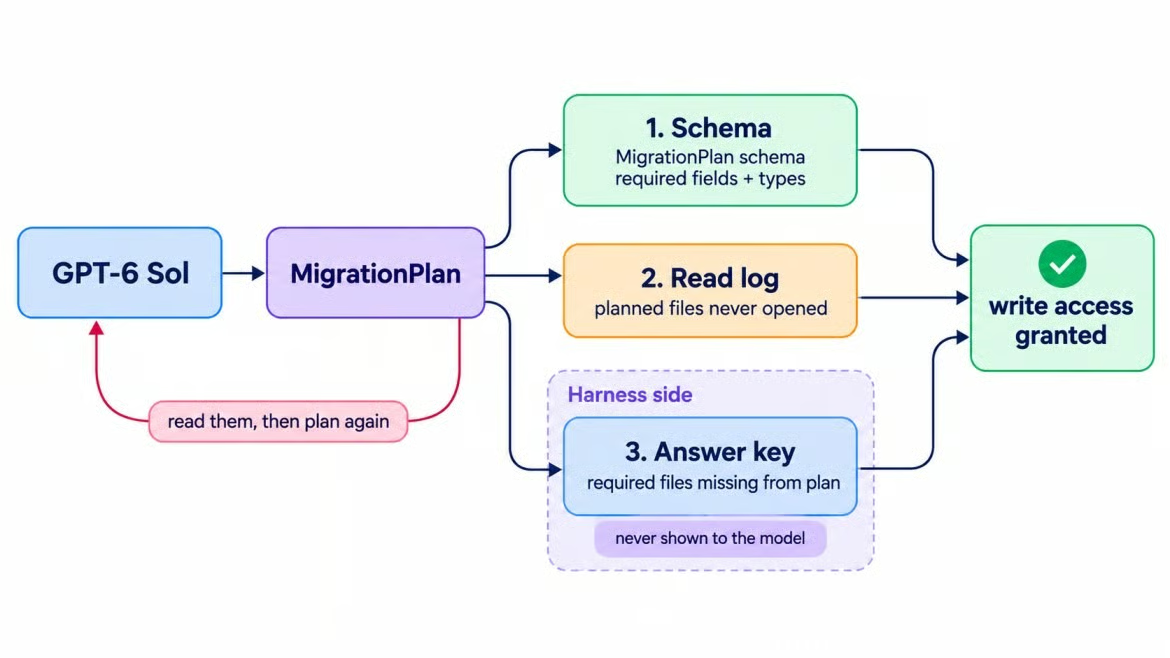
Drei Checks testen einen Migrationsplan. Bild: Autor.
Der Plan bestand alle Gates. Er schlug außerdem vor, einen öffentlichen Parameter in client.py umzubenennen, um v2 zu spiegeln – im Cleanup-Abschnitt der Spez vorgeschlagen. Dieser Vorschlag wird zum Steering-Test.
Ein GPT-6 Sol Coding-Agent nutzt eine Tool-Schleife: auf eine Response warten, ihre Funktionsaufrufe ausführen und Outputs zurückgeben. Unser Guide zur OpenAI Responses API erklärt Request- und Tool-Result-Formate. Diese Migration hält die Schleife auf einer WebSocket-Verbindung, weil Steering sie braucht.
with client.responses.connect() as conn:
    conn.response.create(**base, previous_response_id=plan_id, input=[start_message])
    for event in conn:
        if event.type == "response.incomplete":
            reason = getattr(event.response.incomplete_details, "reason", None)
            if reason == "steered":
                continue  # keep reading for the automatic successor
            raise RuntimeError(reason or "response incomplete")
        if event.type != "response.completed":
            continue
        calls = [i for i in event.response.output if i.type == "function_call"]
        if not calls:
            break  # GPT-6 Sol says it's done here; the held-out tests decide whether it is
        outputs = [{"type": "function_call_output", "call_id": c.call_id,
                    "output": tools.run(c.name, c.arguments)} for c in calls]
        conn.response.create(**base, previous_response_id=event.response.id,
                             input=outputs)
base hält Modell, Instructions, Tools und Aufwand medium für Prompt-Caching konstant. GPT-6 Sol führte die sichtbaren Tests während der Arbeit aus, schrieb aber auch die meisten neuen Tests – sie taugen daher nicht als unabhängiger Check.
Steering während des Turns fügt einer laufenden Response eine Anweisung hinzu, ohne sie abzubrechen. Nach response.created sendest du response.steer auf derselben Verbindung mit der ID dieser Response, und der Server wendet die Anweisung in einer Nachfolger-Response an.
Die neue Anforderung kam vom Storefront-Team: CheckoutClient-Signaturen „müssen exakt bleiben wie heute“, weil ein anderer Service sie aufruft. Ich wollte keinen Timer darüber entscheiden lassen, wann das ankommt, also beobachtet das Harness das Repository. Nach jedem Batch von Tool-Calls vergleicht es die öffentlichen Signaturen auf Disk mit den Originalen, und die erste Abweichung scharfstellt das Steering:
if steer_state == "idle" and signature_changes(repo):  # CheckoutClient, compared with ast
    steer_state = "armed"

if event.type == "response.created" and steer_state == "armed":
    conn.response.steer(previous_response_id=event.response.id, input=STEER_TEXT)
    steer_state = "sent"
So landet das Steering garantiert nach der widersprochenen Umbenennung – genau die Situation, die es zu testen gilt. Früher gesendet, wäre es nur ein längeres Prompt.
Der Server meldete dann den Steering-Lebenszyklus:
response.steer.accepted bedeutete, das Update ist in der Queue, noch nicht angewendet
response.incomplete beendete die ursprüngliche Response mit Grund steered
Eine nachfolgende response.created lief mit der neuen Anforderung weiter
Wartet die Response auf ein Tool-Result, sendet der Server response.steer.pending und hält das Steering, bis das Harness es zurückgibt. Beantworte Tool-Calls weiter, während ein Steering aussteht.
Steering ändert, was das Modell als Nächstes tut. OpenAIs Guide ist klar: Ein Steer überschreibt nicht bereits gesendeten Output, macht frühere Aktionen nicht rückgängig und bricht bereits gestartete Tools nicht ab.
Als das Steering eintraf, lag die Umbenennung bereits in client.py auf Disk. GPT-6 Sol machte sie rückgängig, und ein zurückgehaltener Signatur-Check bestätigte später die finale Schnittstelle.
Einen Edit kann man zurückrollen. Ein Tool, das bereits ein externes System aufgerufen hat, hinterließe nichts rückgängig zu machen – protokolliere daher den Repo-Zustand, wenn jedes Steering ankommt.
In diesem Repository ja, aber nicht in einem Durchlauf. Die erste Migration erfüllte den ursprünglichen Vertrag, dann deckte die Deployment-Probe einen fehlenden Fall auf.
Als GPT-6 Sol die Migration als abgeschlossen meldete, bestand die zurückgehaltene Suite ohne Reparatur-Runde. Für Refunds ersetzte GPT-6 Sol die Addition durch ein kumulatives Lesen, das auch außer der Reihenfolge zugestellte Webhooks ignoriert:
-        order.refunded_cents += data["amount_refunded"]
+        order.refunded_cents = max(order.refunded_cents, refunded["cents"])
Für Idempotenz behielt GPT-6 Sol eine frische order_id pro Versuch bei und ergänzte im Order-Store einen Request-Cache, der Wiederholungen beantwortet, bevor sie v2 erreichen. Dieser Cache lebt im Prozessspeicher – gleich wichtig.
Ja. Der erste Report bezeichnete einen aktualisierten Webhook-Test als Regression und ließ das Risiko von Retries über Server hinweg aus – obwohl der Plan diese Falle benannt hatte.
Structured Outputs validieren das Schema, nicht die Aussagen. Prüfe Report-Felder gegen aufgezeichnete Evidenz und nimm eine leere Risikoliste nie als Beweis, dass kein Risiko bleibt.
Die Suite übersah einen Retry, der an eine andere App-Instanz ging. Ich ergänzte eine Deployment-Probe mit zwei Clients, die sich einen Payment-Prozessor teilen, aber nicht denselben Prozessspeicher.
Die Probe schlug fehl. Der Retry auf der zweiten Instanz warf payments_adapter_v2.IdempotencyConflict – eine Adapter-Exception, die die Storefront nie sehen sollte.
Nur ein Deployment mit mehr als einem Prozess legt diesen Fehler offen – der Auslöser für die Reasoning-Eskalation.
Ein configuration_update-Input ändert den Reasoning-Aufwand für die nächste und jede folgende Response, bis ein weiteres Update kommt. Der Aufwand auf Anfrage-Ebene bleibt unverändert, das gecachte Prefix überlebt. Nach dem Probenfehler sendete das Harness diese Anfrage, wie im Reasoning-Guide beschrieben:
Die Migrations-Requests setzen store=True, daher kann das Harness nach Schließen des WebSockets die gespeicherte Response-Kette mit einer regulären Responses-API-Anfrage fortsetzen.
response = client.responses.create(
    model="gpt-6-sol", reasoning={"effort": "medium"},  # unchanged, so the prefix survives
    instructions=INSTRUCTIONS, tools=TOOLS, tool_choice=allowed(DIAGNOSE_TOOLS),
    previous_response_id=last_id,
    input=[{"type": "configuration_update", "reasoning": {"effort": "high"}},
           {"role": "user", "content": probe_failure + DIAGNOSE_FIRST}],
)
active_effort = "high"  # the harness records it; the response won't
GPT-6 Sol erhält den Fehler und die Deployment-Form, aber keinen Hinweis auf die Lösung. DIAGNOSE_TOOLS erlaubt Lesen und Testen, kein Editieren. Unveränderte Tools und text.format bewahren das gecachte Prefix.
Ein API-Detail ist unglücklich: response.reasoning.effort meldet nach einem Update weiterhin die Anfrage-Einstellung. Das Harness kann den aktiven Aufwand nicht aus der Response auslesen, daher zeichnet es den Wert beim Senden des Updates selbst auf und taggt jede spätere Response damit.
high Aufwand funktioniert?Ja. GPT-6 Sol verfolgte das Scheitern bis zum lokalen Store des zweiten Servers und folgte dann der frischen Order-ID in die Payment-Metadaten. Der geteilte Prozessor sah unterschiedliche Parameter für dieselbe request_id.
Der Fix machte die Order-ID zu einer Funktion der Request-ID, sodass jeder Server dieselbe berechnet:
-def new_order_id() -> str:
+def new_order_id(request_id: str | None = None) -> str:
+    if request_id:
+        stable = uuid.uuid5(uuid.NAMESPACE_URL, f"northstar.checkout.order:{request_id}")
+        return f"ord_{stable.hex[:12]}"
     return f"ord_{uuid.uuid4().hex[:12]}"
GPT-6 Sol fügte außerdem einen sichtbaren Test für den Fall hinzu. Die Probe und die Acceptance-Suite bestanden, dann setzte ein configuration_update den Aufwand zurück auf medium. Der finale Report beschrieb das echte Scheitern diesmal korrekt.
Die Streamlit-App des Projekts spielt den gespeicherten Lauf ohne API-Calls ab. Das Video geht von der Übersicht zu den Steering-Events und dann zu den Acceptance- und Probe-Ergebnissen.
Lerne mit DataCamp
Kurs
Kurs
Kurs
Blog
Tutorial
Kurtis Pykes
15 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Derrick Mwiti
10 Min.
Tutorial
DataCamp Team
3 Min.


