
Last chance! 50% off DataCamp Premium
Sale ends in
Qui useremo GPT-6 Sol per migrare Northstar Checkout, un piccolo servizio di checkout Python fittizio, da un adapter di pagamento locale v1 a v2.
Più nello specifico, vedremo come:
Effettuare una prima chiamata all’API GPT-6 Sol e leggere i suoi campi di utilizzo
Definire il contratto di migrazione prima che il modello veda il repository
Dare a GPT-6 Sol strumenti di file e test con restrizioni, quindi abilitare l’accesso a fasi con allowed_tools
Usare GPT-6 Luna per il triage e far verificare a GPT-6 Sol la shortlist
Restituire un piano di migrazione strutturato e verificarlo rispetto ai file già letti da GPT-6 Sol
Eseguire la migrazione via WebSocket e guidarla dopo l’inizio delle modifiche
Aumentare lo sforzo di ragionamento dopo il fallimento di una probe di deploy indipendente
Calcolare il costo registrato a partire dall’utilizzo dell’API
Quattro scoperte hanno cambiato come costruirei la prossima versione:
GPT-6 Sol è il livello intermedio della famiglia GPT-6 di OpenAI, e il suo ID modello API è gpt-6-sol. La nostra guida ai livelli dei modelli GPT-6 copre il lancio e i benchmark. Le indicazioni su GPT-6 di OpenAI mettono GPT-6 Astra al primo posto, GPT-6 Sol in mezzo e GPT-6 Luna come il più economico.
GPT-6 Sol ha una finestra di contesto da 1.050.000 token e restituisce fino a 128.000 token in output. Lo sforzo di ragionamento va da none a max e per impostazione predefinita è medium. Chat Completions supporta la function calling di GPT-6 Sol solo a none, quindi qui ogni richiesta usa le Responses API.
Prezzi e supporto API determinano come l’harness invia ogni richiesta.
GPT-6 Sol costa 2 $ per milione di token in input e 10 $ per milione di token in output per richieste fino a 272.000 token in input, secondo la pagina prezzi di OpenAI. L’input in cache costa 0,20 $ per milione, e le scritture in cache 2,50 $. Le tariffe di GPT-6 Luna per le stesse quattro categorie sono 0,10 $, 0,01 $, 0,125 $ e 0,50 $.
Sopra i 272.000 token in input, l’intera richiesta viene fatturata al doppio delle tariffe di input e cache e a 1,5x per l’output. Nessuna richiesta in questo progetto ci si è avvicinata.
L’harness, cioè il codice Python attorno al modello, usa questi controlli di GPT-6:
Steering a turno in corso aggiorna una risposta mentre è in esecuzione
configuration_update cambia lo sforzo di ragionamento senza riscrivere il prefisso in cache
allowed_tools imposta il sottoinsieme richiamabile per una richiesta
Structured Outputs definisce i campi nel piano e nel report
Tutti e quattro i controlli restano nella stessa catena di risposte delle Responses API.
Costruiremo un agente che sposta Northstar Checkout da Payments Adapter v1 a v2. Entrambi gli adapter sono stand-in locali scritti da me per questo esperimento, non veri SDK di pagamento. Il codice completo, i fixture e la run registrata sono in questo repository GitHub.
Il repository mescola codice di pagamento con moduli non correlati, quindi GPT-6 Sol deve trovare da solo i file interessati. La v2 rompe quattro contratti dell’adapter:
La creazione del pagamento passa da client.charge(...) a client.payments.create(...)
I dizionari di risultato diventano oggetti tipizzati con importi Money
Le carte rifiutate restituiscono uno stato invece di sollevare un’eccezione
I webhook cambiano nome, involucro e header di firma
Il search-and-replace gestisce il rename del metodo. Non gestisce nessuno dei cambiamenti di comportamento.
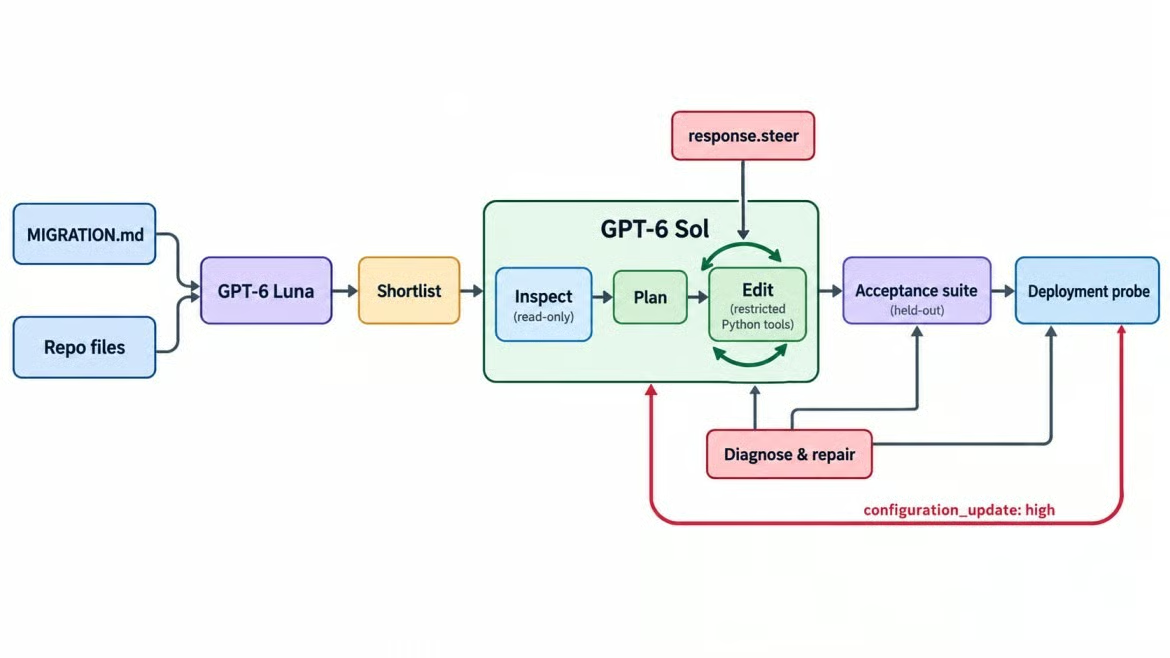
Un loop di migrazione, due modelli GPT-6. Immagine dell’autore.
GPT-6 Sol riceve la specifica, l’albero dei file e strumenti con restrizioni che diventano richiamabili a fasi. Non sa quali file richiedano modifiche né che un requisito cambierà.
Due parti della specifica sono trappole. Nessuna è un bug inserito ad arte; entrambe derivano dall’incontro tra il comportamento della v2 e il codice esistente:
Idempotenza. la v2 confronta i parametri quando vede un request_id ripetuto, ma il checkout inserisce un order_id nuovo nei metadati a ogni tentativo, quindi un retry ingenuo viene rifiutato invece che deduplicato.
Totali rimborsati. il webhook payment.refunded della v2 riporta il totale rimborsato finora, mentre il vecchio handler somma ogni valore con +=.
Entrambi superano un type checker. Li cogli solo eseguendo end-to-end checkout e rimborsi.
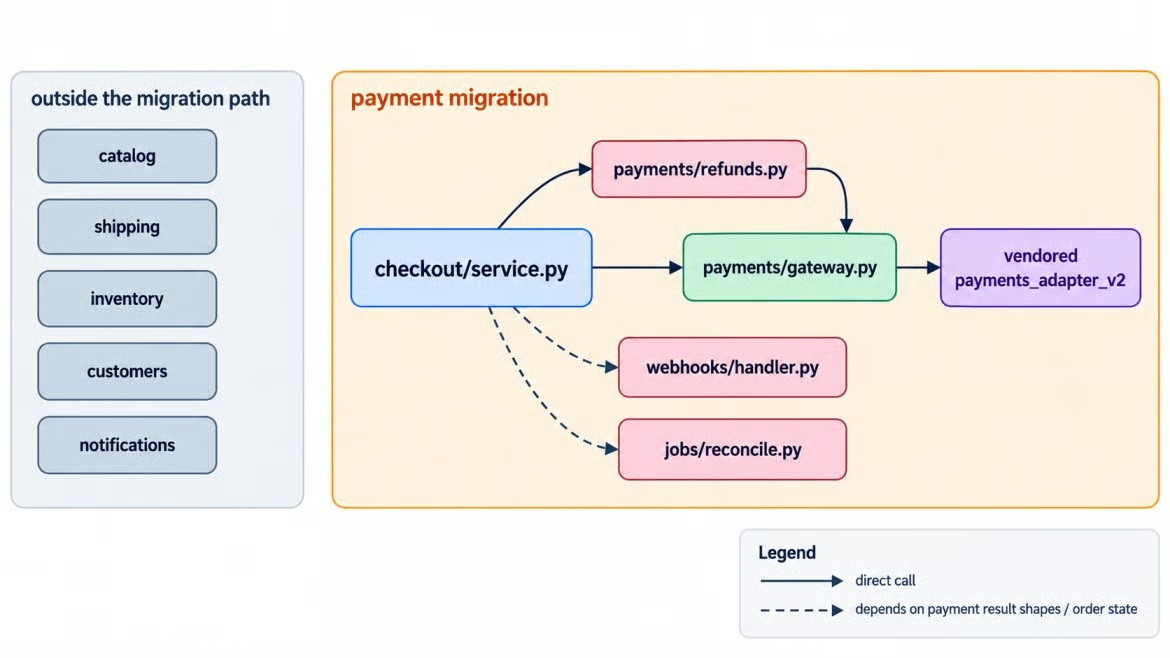
I cambiamenti sui pagamenti attraversano diversi moduli Northstar. Immagine dell’autore.
La mappa separa gli import diretti dell’adapter dai moduli che dipendono dal comportamento dei pagamenti. Questi legami indiretti sono il motivo per cui è importante una chiave di risposta per l’intero repository.
Una suite di accettazione tenuta da parte, scritta prima di qualsiasi chiamata al modello, decide il risultato. GPT-6 Sol non la vede mai; l’harness la esegue con pytest contro la copia migrata. Verifica che:
Il checkout riesca con la v2, e un retry con la stessa chiave di idempotenza addebiti una volta sola
Una carta rifiutata sollevi ancora l’errore pubblico CheckoutDeclined
Un rimborso completo, due parziali e un webhook riconsegnato lascino tutti totali corretti
CheckoutClient mantenga invariate le firme dei metodi
Non restino riferimenti alla v1, vendor/ e MIGRATION.md siano intatti, e i test visibili passino
Il codice originale supera già i controlli per le interfacce invariate e i file protetti; i controlli rimanenti misurano la migrazione. Una chiave di risposta separata elenca le modifiche richieste, ma solo l’harness la legge.
Le directory acceptance/ e probes/ stanno fuori dalla copia del repository esposta a entrambi i modelli. La chiave di risposta vive sotto acceptance/, quindi non può entrare nell’input di GPT-6 Luna, nell’albero dei file o in alcuno strumento del repository.
La read gate può restituire percorsi dal piano di GPT-6 Sol stesso. Il risultato di copertura della chiave di risposta è registrato solo per la valutazione; non invia mai a GPT-6 Sol i percorsi di ground truth mancanti.
Dopo quella suite gira una probe di deploy. Nessun controllo accetta il messaggio "done" del modello come evidenza.
Ti serve Python 3.10 o superiore e una chiave API con accesso a entrambi i modelli. I requirements includono l’extra realtime necessario per lo steering:
git clone https://github.com/KhalidAbdelaty/gpt-6-sol-api.git
cd gpt-6-sol-api
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
Su macOS o Linux, usa source .venv/bin/activate e cp .env.example .env, poi inserisci OPENAI_API_KEY=... in .env.
Se la tua chiave funziona già con le Responses API, salta la prossima sottosezione.
La richiesta utile più piccola conferma la chiave, l’ID del modello e i campi di utilizzo che servono alla sezione costi:
from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()
client = OpenAI()
response = client.responses.create(
    model="gpt-6-sol",
    input="In one sentence, why is a breaking API migration harder than renaming a function?",
)
print(response.reasoning.effort, response.output_text)
print(response.usage)
La risposta riporta sforzo medium, e usage include cached_tokens e cache_write_tokens. Lascia fuori temperature e top_p. Entrambi restituiscono un 400 ogni volta che lo sforzo non è none.
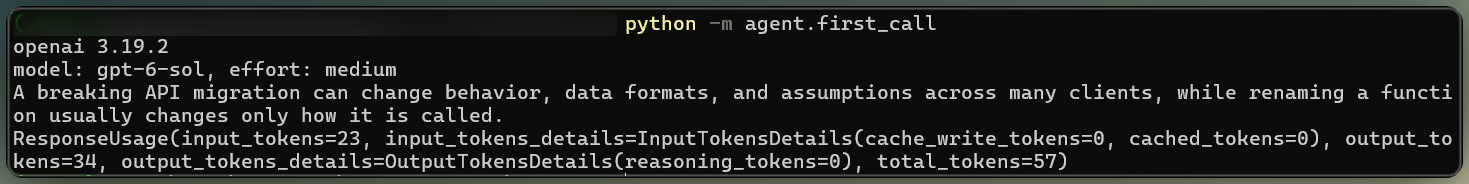
La prima richiesta a GPT-6 Sol restituisce l’utilizzo. Immagine dell’autore.
Inizia da medium, il default, e mantieni l’impostazione a livello di richiesta per tutta la run. La maggior parte dei turni della migrazione sono letture e piccole modifiche. Più tardi la probe di deploy fornisce un motivo per alzare lo sforzo.
Il livello degli strumenti governa i permessi dell’agente. GPT-6 Sol riceve questi function tool con strict: true:
list_files e search_code individuano il codice rilevante
read_file restituisce un file del repository
edit_file modifica un’unica occorrenza esatta
run_tests esegue un target pytest consentito
Gli schemi strict controllano la forma degli argomenti, non la sicurezza dei percorsi, quindi Python fa rispettare il perimetro di scrittura:
READ_ONLY = ("vendor/", "MIGRATION.md", "conftest.py")

if write:
    if rel_posix.startswith(READ_ONLY) or rel_posix in READ_ONLY:
        raise ToolError(f"{rel_posix} is read-only")  # the spec and both adapters
    if not rel_posix.startswith(("northstar/", "tests/")) or not rel_posix.endswith(".py"):
        raise ToolError("writes are limited to Python files under northstar/ and tests/")
Il percorso viene risolto per primo, quindi ../ e i path assoluti falliscono. edit_file sostituisce una sola corrispondenza esatta, e run_tests accetta solo target sotto tests/.
L’harness restituisce una chiamata bloccata come output dello strumento con ERROR:, e il loop prosegue. La nostra guida all’ingegneria dell’harness degli agenti spiega perché questi controlli appartengono all’harness e non al prompt.
Chiama ogni strumento con un input che deve rifiutare:
Un percorso che contiene ..
Un percorso assoluto
Una scrittura sotto vendor/
Un target di test che contenga un comando shell
Nessuno dovrebbe passare. Una modifica che corrisponde a più di una posizione dovrebbe chiedere più contesto, e mantenere le regole in funzioni personalizzate le mette in un unico posto testabile.
Il triage del repository è un lavoro di classificazione ristretto: valuta la rilevanza di ogni file e cita i riferimenti alla v1. GPT-6 Luna riceve questo compito e nient’altro, e gira per primo, prima che GPT-6 Sol abbia cercato qualcosa.
class FileVerdict(BaseModel):
    path: str
    relevance: Literal["high", "medium", "low", "none"]
    legacy_references: list[str]

triage = client.responses.parse(model="gpt-6-luna", input=spec_and_all_files,
                                text_format=TriageResult)  # a list of FileVerdict
L’input è la specifica più ogni file Python sotto northstar/ e tests/. Tutto ciò che è valutato high o medium va nella shortlist che GPT-6 Sol riceve dopo.
Confronta la shortlist con la chiave di risposta di prima, e guarda prima il richiamo. GPT-6 Luna ha trattenuto ogni file interessato e ne ha aggiunti alcuni che non richiedevano modifiche.
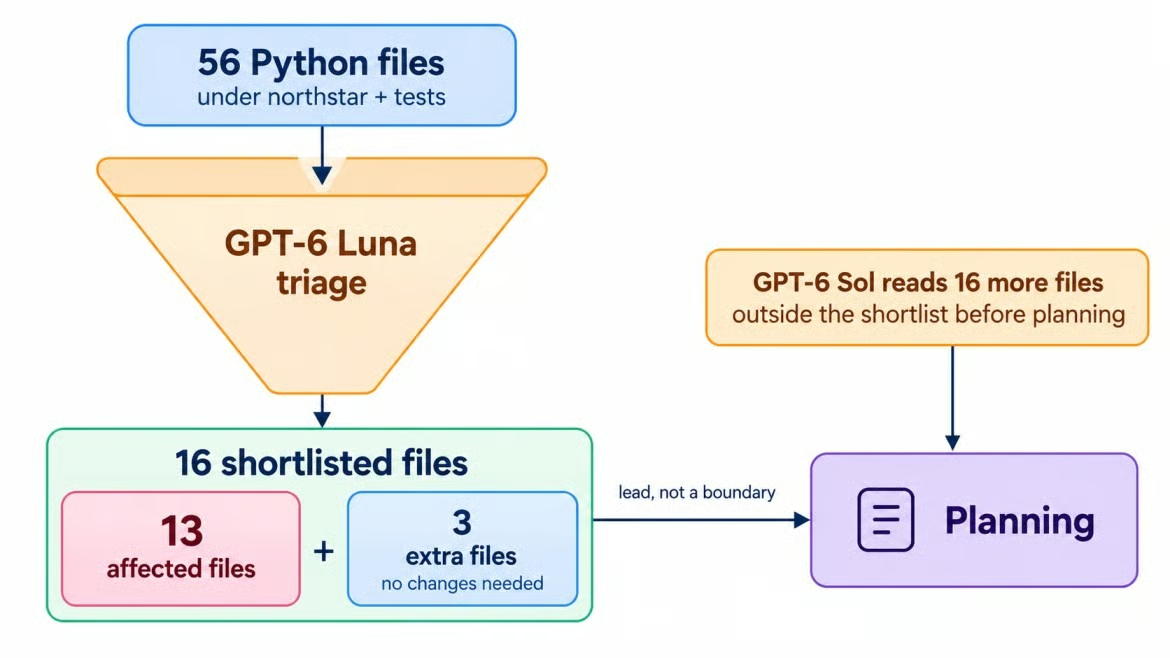
GPT-6 Luna restringe da 56 a 16. Immagine dell’autore.
Una shortlist è una traccia, non un confine.
allowed_tools per permessi a fasiallowed_tools è una modalità di tool_choice che limita quali strumenti il modello può chiamare mentre l’elenco completo resta in posto. È così che il primo passaggio di GPT-6 Sol resta in sola lettura: la lista completa è definita in ogni richiesta, ma solo listing e searching sono richiamabili.
def allowed(names):
    return {"type": "allowed_tools", "mode": "auto",
            "tools": [{"type": "function", "name": n} for n in names]}

response = client.responses.create(
    model="gpt-6-sol", instructions=INSTRUCTIONS, tools=TOOLS,  # full list, every time
    tool_choice=allowed(["list_files", "search_code"]),
    reasoning={"effort": "medium"}, input=inspect_prompt, store=True,
)
Cambiare tools tra le fasi riscrive il prefisso in cache. La guida alla function calling raccomanda allowed_tools quando deve cambiare solo il sottoinsieme richiamabile.
Un passaggio in sola lettura separa diagnosi e azione. GPT-6 Sol ha ricevuto la shortlist di GPT-6 Luna con un semplice avviso che poteva essere errata, e le sue ricerche di import v1, chiamate a charge e nomi dei webhook hanno fatto emergere da sole tutti i file interessati.
È anche andato oltre l’elenco, segnalando i modelli d’ordine, lo store degli ordini, i serializer e l’export del ledger come dipendenze a valle da controllare. Nessuno di loro ha poi richiesto modifiche, ma leggerli è come lo scopri. Terrei allowed_tools per qualsiasi agente che modifichi file.
Un piano di migrazione è dove l’agente si impegna su file specifici prima di ottenere l’accesso in scrittura. La pianificazione aggiunge read_file, e il piano torna tramite Structured Outputs con gli strumenti disattivati:
plan = client.responses.parse(
    model="gpt-6-sol", instructions=INSTRUCTIONS, tools=TOOLS, tool_choice="none",
    reasoning={"effort": "medium"}, previous_response_id=last_id,
    input=PLAN_REQUEST, text_format=MigrationPlan,  # files, evidence, risks
)
Il piano ha coperto ogni modifica richiesta e avvertito che un nuovo order ID avrebbe cambiato i metadati della v2 al retry. Quell’avvertimento torna più avanti.
Prima di concedere l’accesso in scrittura, l’harness controlla la struttura del piano, le evidenze e la copertura.
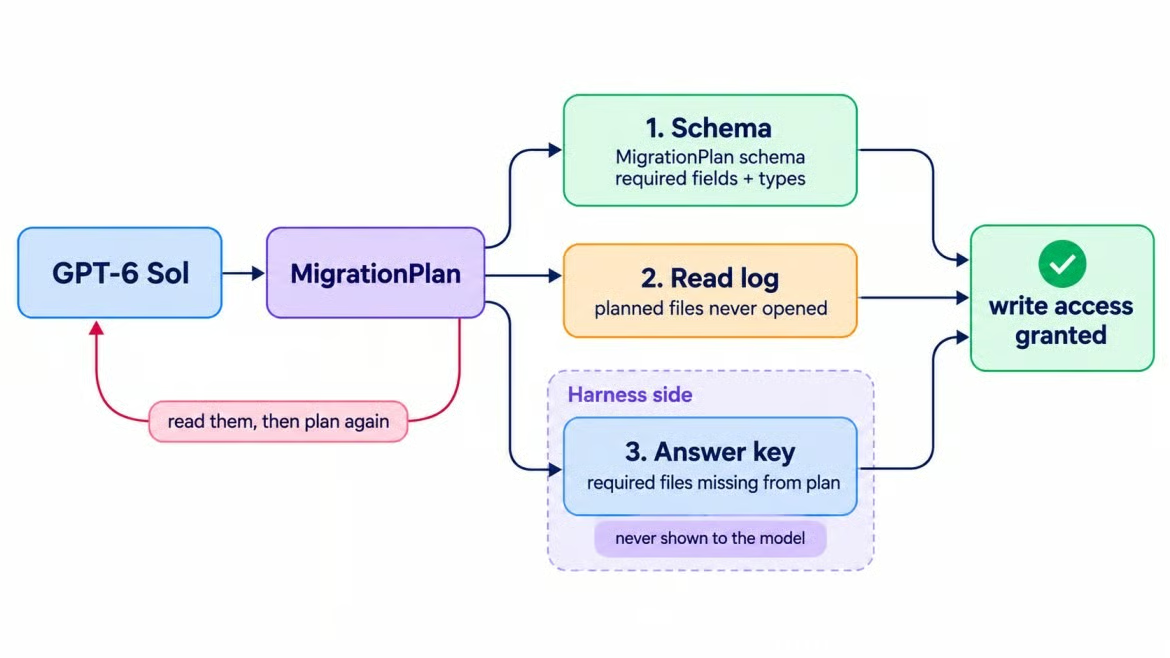
Tre controlli testano un piano di migrazione. Immagine dell’autore.
Il piano ha superato ogni gate. Ha anche proposto di rinominare un parametro pubblico in client.py per allinearlo alla nomenclatura della v2, come suggeriva la sezione di cleanup della specifica. Quella proposta diventa il test per lo steering.
Un agente di coding GPT-6 Sol usa un loop di strumenti: aspetta una risposta, esegue le sue function call e restituisce gli output. La nostra guida alle OpenAI Responses API spiega i formati di richiesta e dei risultati degli strumenti. Questa migrazione mantiene il loop su un’unica connessione WebSocket perché lo steering ne ha bisogno.
with client.responses.connect() as conn:
    conn.response.create(**base, previous_response_id=plan_id, input=[start_message])
    for event in conn:
        if event.type == "response.incomplete":
            reason = getattr(event.response.incomplete_details, "reason", None)
            if reason == "steered":
                continue  # keep reading for the automatic successor
            raise RuntimeError(reason or "response incomplete")
        if event.type != "response.completed":
            continue
        calls = [i for i in event.response.output if i.type == "function_call"]
        if not calls:
            break  # GPT-6 Sol says it's done here; the held-out tests decide whether it is
        outputs = [{"type": "function_call_output", "call_id": c.call_id,
                    "output": tools.run(c.name, c.arguments)} for c in calls]
        conn.response.create(**base, previous_response_id=event.response.id,
                             input=outputs)
base mantiene fisso il modello, le istruzioni, gli strumenti e lo sforzo medium per il caching del prompt. GPT-6 Sol ha eseguito i test visibili mentre lavorava, ma ha anche scritto la maggior parte dei nuovi test, quindi non possono servire da verifica indipendente.
Lo steering a turno in corso aggiunge un’istruzione a una risposta ancora in esecuzione, senza annullarla. Dopo response.created, invii response.steer sulla stessa connessione con l’ID di quella risposta, e il server applica l’istruzione in una risposta successore.
Il nuovo requisito è arrivato dal team storefront: le firme di CheckoutClient “devono restare esattamente come sono oggi”, perché un altro servizio le chiama. Non volevo che un timer decidesse quando arriva, quindi l’harness guarda il repository. Dopo ogni batch di chiamate agli strumenti, confronta le firme pubbliche su disco con gli originali, e la prima differenza arma lo steer:
if steer_state == "idle" and signature_changes(repo):  # CheckoutClient, compared with ast
    steer_state = "armed"

if event.type == "response.created" and steer_state == "armed":
    conn.response.steer(previous_response_id=event.response.id, input=STEER_TEXT)
    steer_state = "sent"
Questo garantisce che lo steer atterri dopo il rename che contraddice, che è la situazione che vale la pena testare. Inviato prima, sarebbe solo un prompt più lungo.
Il server ha poi riportato il ciclo di vita dello steering:
response.steer.accepted significava che l’aggiornamento era in coda, non applicato
response.incomplete ha concluso la risposta originale con la ragione steered
Un response.created successore ha proseguito con il nuovo requisito
Se la risposta sta aspettando il risultato di uno strumento, il server invia response.steer.pending e tiene lo steer finché l’harness non lo restituisce. Continua a rispondere alle chiamate degli strumenti mentre uno steer è in sospeso.
Lo steering cambia cosa fa il modello dopo. La guida di OpenAI è chiara sul resto: uno steer non riscrive l’output già inviato, non annulla azioni precedenti, né cancella strumenti già partiti.
Quando lo steer è arrivato, il rename era già su disco in client.py. GPT-6 Sol lo ha annullato, e un controllo sulle firme tenuto da parte ha poi confermato l’interfaccia finale.
Una modifica può essere annullata. Uno strumento che avesse già chiamato un sistema esterno non lascerebbe nulla da annullare, quindi registra lo stato del repository quando arriva ogni steer.
In questo repository, sì, anche se non in un solo passaggio. La prima migrazione ha soddisfatto il contratto originale, poi la probe di deploy ha esposto un caso mancante.
Quando GPT-6 Sol ha dichiarato la migrazione completa, la suite tenuta da parte è passata senza un giro di riparazione. Per i rimborsi, GPT-6 Sol ha sostituito l’addizione con una lettura cumulativa che ignora anche i webhook fuori ordine:
-        order.refunded_cents += data["amount_refunded"]
+        order.refunded_cents = max(order.refunded_cents, refunded["cents"])
Per l’idempotenza, GPT-6 Sol ha mantenuto un order_id nuovo per tentativo e ha aggiunto una cache delle richieste nello store ordini che risponde alle richieste ripetute prima che raggiungano la v2. Quella cache vive nella memoria del processo, cosa che tra poco conta.
Sì. Il primo report ha chiamato “regressione” un test di webhook aggiornato e ha omesso il rischio dei retry tra server, anche se il piano aveva nominato quella trappola.
Structured Outputs valida lo schema, non quelle affermazioni. Controlla i campi del report contro le evidenze registrate, e non trattare una lista di rischi vuota come prova che non resti alcun rischio.
La suite ha mancato un retry instradato a un’altra istanza dell’app. Ho aggiunto una probe di deploy con due client che condividono lo stesso processore di pagamento ma non la memoria di processo.
La probe è fallita. Il retry sulla seconda istanza ha sollevato payments_adapter_v2.IdempotencyConflict, un’eccezione dell’adapter che lo storefront non doveva mai vedere.
Solo un deploy con più di un processo espone questo failure, che innesca l’escalation dello sforzo di ragionamento.
Un elemento di input configuration_update cambia lo sforzo di ragionamento per la prossima risposta e tutte le successive, finché un altro aggiornamento non lo sostituisce. Lo sforzo a livello di richiesta resta fermo, quindi il prefisso in cache sopravvive. Quando la probe è fallita, l’harness ha inviato questa richiesta, seguendo la guida al ragionamento:
Le richieste della migrazione usano store=True, quindi dopo la chiusura del WebSocket l’harness può continuare la catena di risposte salvata con una normale richiesta alle Responses API.
response = client.responses.create(
    model="gpt-6-sol", reasoning={"effort": "medium"},  # unchanged, so the prefix survives
    instructions=INSTRUCTIONS, tools=TOOLS, tool_choice=allowed(DIAGNOSE_TOOLS),
    previous_response_id=last_id,
    input=[{"type": "configuration_update", "reasoning": {"effort": "high"}},
           {"role": "user", "content": probe_failure + DIAGNOSE_FIRST}],
)
active_effort = "high"  # the harness records it; the response won't
GPT-6 Sol riceve il failure e la forma del deploy, ma nessun indizio sulla fix. DIAGNOSE_TOOLS consente lettura e testing, non editing. Mantenere invariati strumenti e text.format preserva il prefisso in cache.
Un dettaglio API è fastidioso: response.reasoning.effort riporta comunque l’impostazione a livello di richiesta dopo un aggiornamento. L’harness non può leggere lo sforzo attivo dalla risposta, quindi registra il valore da sé quando invia l’aggiornamento e lo associa a ogni risposta successiva.
high ha funzionato?Sì. GPT-6 Sol ha ricondotto il failure allo store locale del secondo server, poi ha seguito l’order ID nuovo dentro i metadati di pagamento. Il processore condiviso vedeva parametri diversi per lo stesso request_id.
La fix ha reso l’order ID funzione del request ID, così ogni server calcola lo stesso:
-def new_order_id() -> str:
+def new_order_id(request_id: str | None = None) -> str:
+    if request_id:
+        stable = uuid.uuid5(uuid.NAMESPACE_URL, f"northstar.checkout.order:{request_id}")
+        return f"ord_{stable.hex[:12]}"
     return f"ord_{uuid.uuid4().hex[:12]}"
GPT-6 Sol ha anche aggiunto un test visibile per il caso. La probe e la suite di accettazione sono passate, poi un
configuration_update ha riportato lo sforzo a medium. Il report finale questa volta ha descritto correttamente il failure reale.
L’app Streamlit del progetto riproduce la run salvata senza effettuare chiamate API. Il video passa dalla panoramica agli eventi di steering e poi ai risultati di accettazione e della probe.
Impara con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min




