Curso
Trabajar con la API de OpenAI
3 h
175.5K
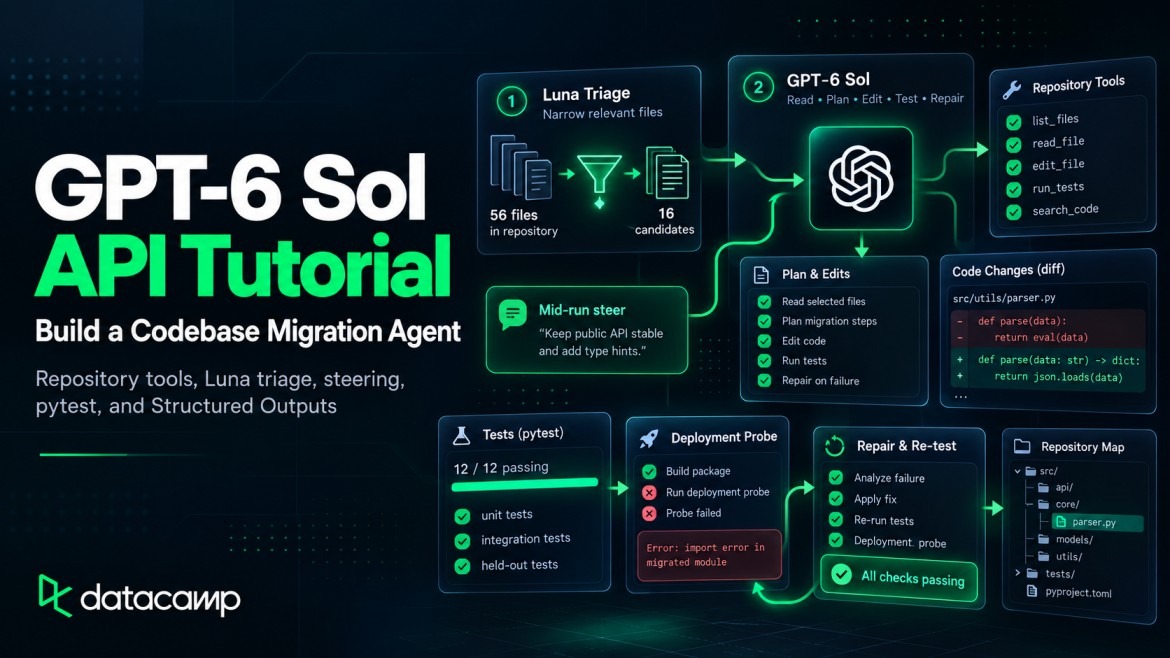
Aquí usaremos GPT-6 Sol para migrar Northstar Checkout, un pequeño servicio ficticio de checkout en Python, de un adaptador de pagos local v1 a v2.
En concreto, veremos cómo:
Hacer una primera llamada a la API de GPT-6 Sol y leer sus campos de uso
Definir el contrato de migración antes de que el modelo vea el repositorio
Dar a GPT-6 Sol herramientas restringidas de archivos y de pruebas, y luego escalonar el acceso con allowed_tools
Usar GPT-6 Luna para el triaje y hacer que GPT-6 Sol verifique la lista corta
Devolver un plan de migración estructurado y contrastarlo con los archivos que GPT-6 Sol ya haya leído
Ejecutar la migración por WebSocket y dirigirla una vez que empiece a editar
Aumentar el esfuerzo de razonamiento tras fallar una verificación de despliegue independiente
Calcular el coste registrado a partir del uso de la API
Cuatro hallazgos cambiarían cómo construiría la siguiente versión:
GPT-6 Sol es el nivel intermedio de la familia GPT-6 de OpenAI, y su ID de modelo en la API es gpt-6-sol. Nuestra guía de los niveles de GPT-6 cubre el lanzamiento y los benchmarks. En la guía de GPT-6 de OpenAI, GPT-6 Astra va primero, GPT-6 Sol queda en medio y GPT-6 Luna es el de menor coste.
GPT-6 Sol tiene una ventana de contexto de 1.050.000 tokens y devuelve hasta 128.000 tokens de salida. El esfuerzo de razonamiento va de none a max y por defecto es medium. Chat Completions solo admite la llamada a funciones de GPT-6 Sol con none, así que aquí todas las solicitudes usan la Responses API.
El precio y las capacidades de la API determinan cómo el arnés envía cada solicitud.
GPT-6 Sol cuesta 2 $ por millón de tokens de entrada y 10 $ por millón de tokens de salida para solicitudes de hasta 272.000 tokens de entrada, según la página de precios de OpenAI. La entrada en caché cuesta 0,20 $ por millón y las escrituras en caché 2,50 $. Las tarifas de GPT-6 Luna para esas cuatro categorías son 0,10 $, 0,01 $, 0,125 $ y 0,50 $.
Por encima de 272.000 tokens de entrada, se factura toda la solicitud al doble de las tarifas de entrada y caché, y a 1,5× la tarifa de salida. Ninguna solicitud de este proyecto se acercó a ese umbral.
El arnés, es decir, el código Python alrededor del modelo, usa estos controles de GPT-6:
Steering a mitad de turno actualiza una respuesta mientras se está ejecutando
configuration_update cambia el esfuerzo de razonamiento sin reescribir el prefijo en caché
allowed_tools limita el subconjunto invocable en una solicitud
Structured Outputs define los campos del plan y del informe
Los cuatro controles se mantienen dentro de la misma cadena de respuestas de la Responses API.
Crearemos un agente que migre Northstar Checkout de Payments Adapter v1 a v2. Ambos adaptadores son sustitutos locales que escribí para este experimento, no SDKs de pago reales. El código completo, fixtures y la ejecución grabada están en este repositorio de GitHub.
El repositorio mezcla código de pagos con módulos no relacionados, así que GPT-6 Sol debe encontrar por sí mismo los archivos afectados. La v2 rompe cuatro contratos del adaptador:
La creación de pagos pasa de client.charge(...) a client.payments.create(...)
Los diccionarios de resultados pasan a objetos tipados con importes Money
Las tarjetas denegadas devuelven un estado en lugar de lanzar una excepción
Los webhooks cambian de nombre, de sobre y de cabecera de firma
Buscar y reemplazar resuelve el cambio de método. No resuelve ninguno de los cambios de comportamiento.
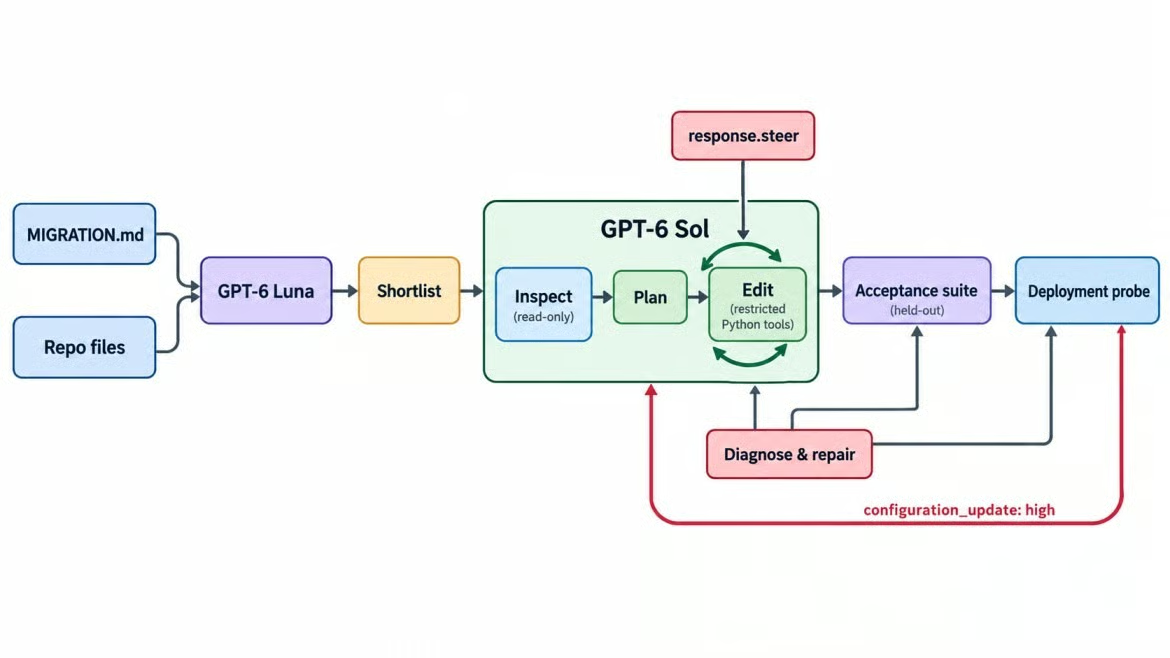
Un ciclo de migración, dos modelos GPT-6. Imagen del autor.
GPT-6 Sol recibe la especificación, el árbol de archivos y herramientas restringidas que se van habilitando por etapas. No sabe qué archivos necesitan cambios ni que llegará un cambio de requisito.
Hay dos trampas en la especificación. No son bugs «plantados»; ambas surgen del choque entre el comportamiento de v2 y el código existente:
Idempotencia. v2 compara parámetros cuando ve un request_id repetido, pero checkout pone un order_id nuevo en los metadatos en cada intento, así que un reintento ingenuo se rechaza en lugar de deduplicarse.
Totales de reembolso. El webhook payment.refunded de v2 informa del total reembolsado hasta el momento, mientras que el manejador anterior sumaba cada valor con +=.
Ambas pasarían un verificador de tipos. Solo las detectas ejecutando el checkout y los reembolsos de extremo a extremo.
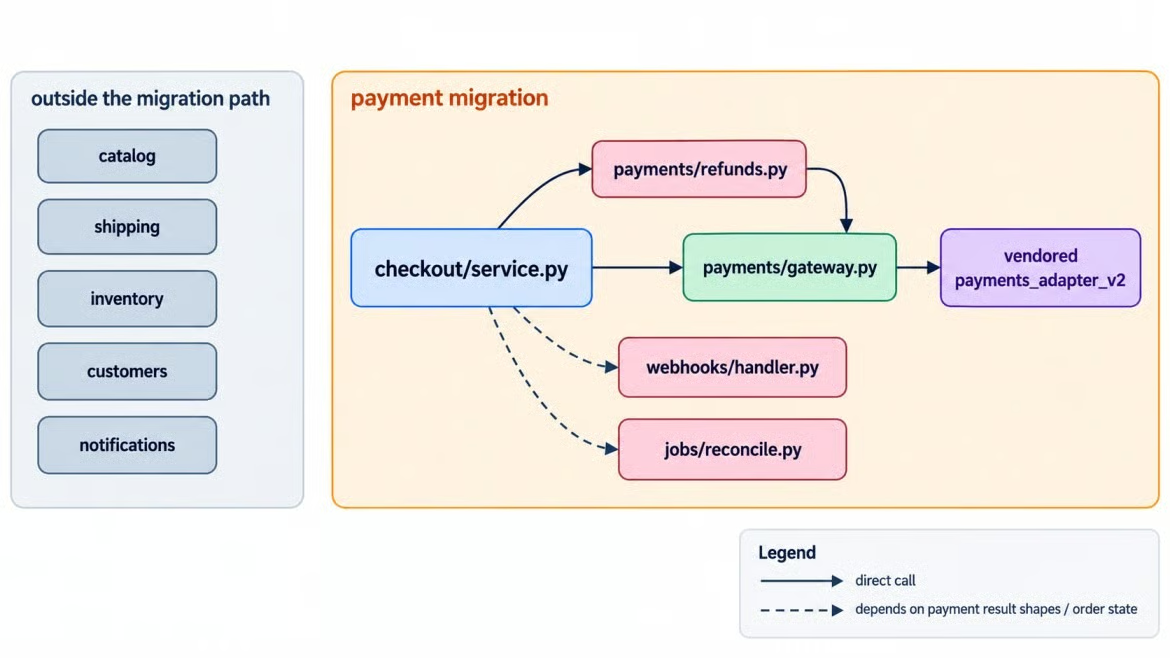
Los cambios de pago cruzan varios módulos de Northstar. Imagen del autor.
El mapa separa las importaciones directas del adaptador de los módulos que dependen del comportamiento de pagos. Esos vínculos indirectos son la razón por la que importa tener una clave de respuestas para todo el repositorio.
Una suite de aceptación reservada, escrita antes de cualquier llamada al modelo, decide el resultado. GPT-6 Sol nunca la ve; el arnés la ejecuta con pytest contra la copia migrada. Verifica que:
El checkout tiene éxito con v2 y un reintento con la misma clave de idempotencia cobra una sola vez
Una tarjeta denegada sigue lanzando el error público CheckoutDeclined
Un reembolso completo, dos parciales y un webhook reentregado dejan totales correctos
CheckoutClient mantiene sin cambios las firmas de sus métodos
No quedan referencias a v1, vendor/ y MIGRATION.md permanecen intactos, y pasan las pruebas visibles
El código original ya pasa los checks de interfaces sin cambios y archivos protegidos; los checks restantes miden la migración. Una clave de respuestas separada enumera los cambios necesarios, pero solo la lee el arnés.
Los directorios acceptance/ y probes/ quedan fuera de la copia del repositorio expuesta a ambos modelos. La clave de respuestas vive bajo acceptance/, así que no puede entrar en la entrada de GPT-6 Luna, el árbol de archivos ni ninguna herramienta del repositorio.
La compuerta de lectura puede devolver rutas del propio plan de GPT-6 Sol. El resultado de cobertura frente a la clave de respuestas se registra solo para evaluación; nunca devuelve rutas de ground truth que falten a GPT-6 Sol.
Después de esa suite se ejecuta una sonda de despliegue. Ninguna verificación acepta el mensaje de «hecho» del modelo como evidencia.
Necesitas Python 3.10 o superior y una clave de API con acceso a ambos modelos. Los requisitos incluyen el extra realtime que necesita steering:
git clone https://github.com/KhalidAbdelaty/gpt-6-sol-api.git
cd gpt-6-sol-api
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
En macOS o Linux, usa source .venv/bin/activate y cp .env.example .env, y luego pon OPENAI_API_KEY=... en .env.
Si tu clave ya funciona con la Responses API, sáltate la siguiente subsección.
La solicitud útil mínima confirma la clave, el ID del modelo y los campos de uso que necesita la sección de costes:
from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()
client = OpenAI()
response = client.responses.create(
    model="gpt-6-sol",
    input="In one sentence, why is a breaking API migration harder than renaming a function?",
)
print(response.reasoning.effort, response.output_text)
print(response.usage)
La respuesta informa esfuerzo medium, y usage incluye cached_tokens y cache_write_tokens. Omite temperature y top_p. Ambas devuelven un 400 cuando el esfuerzo no es none.
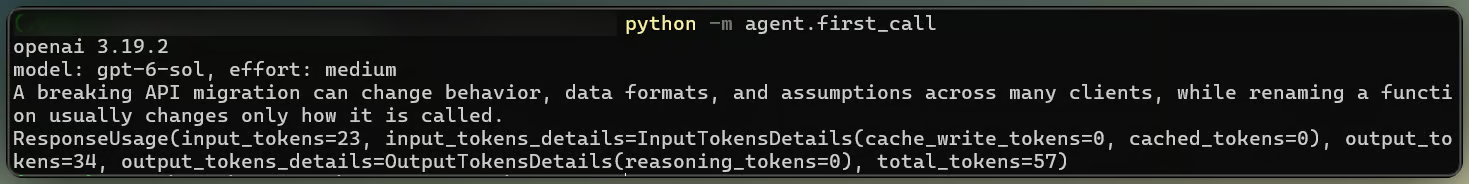
La primera solicitud a GPT-6 Sol devuelve uso. Imagen del autor.
Empieza con medium, el valor por defecto, y mantenlo a nivel de solicitud durante toda la ejecución. La mayoría de turnos de una migración son lecturas y ediciones pequeñas. Más tarde, la sonda de despliegue aporta un motivo para subir el esfuerzo.
La capa de herramientas controla los permisos del agente. GPT-6 Sol recibe estas herramientas de función con strict: true:
list_files y search_code localizan código relevante
read_file devuelve un archivo del repositorio
edit_file cambia una sola coincidencia exacta
run_tests ejecuta un objetivo de pytest permitido
Los esquemas estrictos validan la forma de los argumentos, no la seguridad de rutas, así que Python impone la frontera de escritura:
READ_ONLY = ("vendor/", "MIGRATION.md", "conftest.py")

if write:
    if rel_posix.startswith(READ_ONLY) or rel_posix in READ_ONLY:
        raise ToolError(f"{rel_posix} is read-only")  # the spec and both adapters
    if not rel_posix.startswith(("northstar/", "tests/")) or not rel_posix.endswith(".py"):
        raise ToolError("writes are limited to Python files under northstar/ and tests/")
La ruta se resuelve primero, así que ../ y las rutas absolutas fallan. edit_file reemplaza una coincidencia exacta, y run_tests solo acepta objetivos bajo tests/.
El arnés devuelve una llamada bloqueada como salida de herramienta con ERROR: y el bucle continúa. Nuestra guía de ingeniería de arneses para agentes explica por qué estos checks deben vivir en el arnés y no en el prompt.
Llama a cada herramienta con una entrada que deba rechazar:
Una ruta que contenga ..
Una ruta absoluta
Una escritura bajo vendor/
Un objetivo de prueba que contenga un comando de shell
Ninguna debería pasar. Una edición que coincida con más de una ubicación debe pedir más contexto, y mantener las reglas en funciones personalizadas las deja en un único lugar comprobable.
El triaje del repositorio es una clasificación acotada: puntuar la relevancia de cada archivo y citar referencias a v1. GPT-6 Luna hace este trabajo y nada más, y se ejecuta primero, antes de que GPT-6 Sol haya buscado nada.
class FileVerdict(BaseModel):
    path: str
    relevance: Literal["high", "medium", "low", "none"]
    legacy_references: list[str]

triage = client.responses.parse(model="gpt-6-luna", input=spec_and_all_files,
                                text_format=TriageResult)  # a list of FileVerdict
La entrada es la especificación más todos los archivos Python bajo northstar/ y tests/. Todo lo evaluado como high o medium entra en la lista corta que recibe GPT-6 Sol a continuación.
Contrasta la lista con la clave de respuestas de antes y mira primero el recall. GPT-6 Luna conservó todos los archivos afectados y añadió algunos que no requerían cambios.
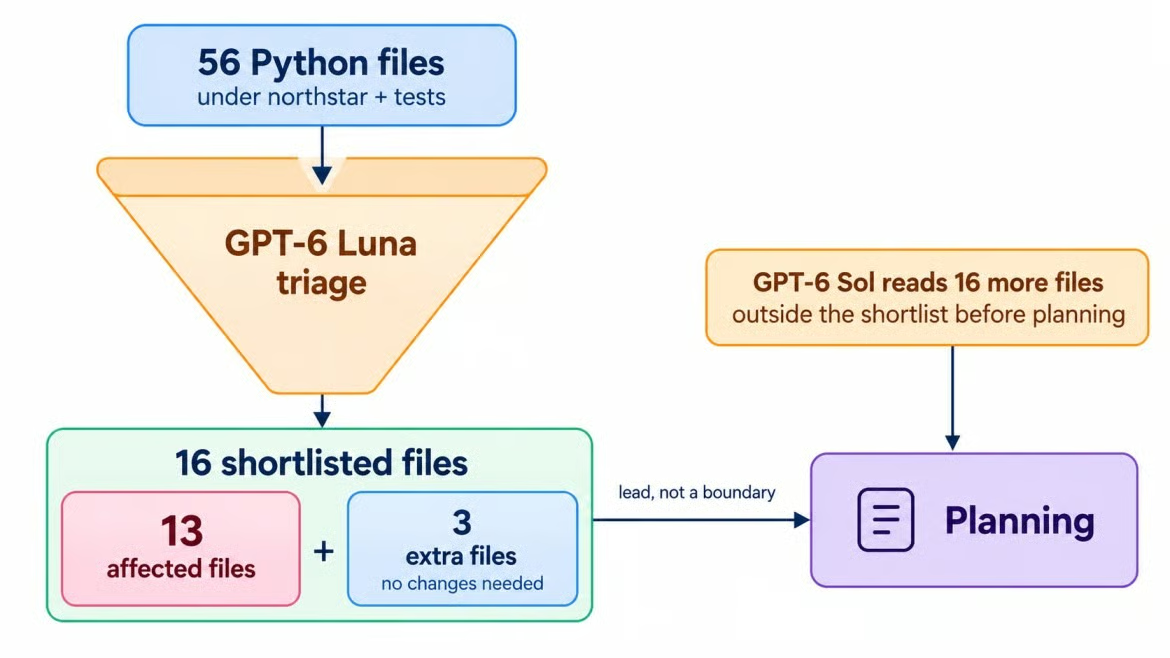
GPT-6 Luna reduce de 56 a 16. Imagen del autor.
Una lista corta es una pista, no una frontera.
allowed_tools para permisos por etapasallowed_tools es un modo de tool_choice que limita qué herramientas puede invocar el modelo mientras la lista completa de herramientas sigue definida. Así es como la primera pasada de GPT-6 Sol se mantiene en solo lectura: la lista completa se define en cada solicitud, pero solo se pueden invocar listado y búsqueda.
def allowed(names):
    return {"type": "allowed_tools", "mode": "auto",
            "tools": [{"type": "function", "name": n} for n in names]}

response = client.responses.create(
    model="gpt-6-sol", instructions=INSTRUCTIONS, tools=TOOLS,  # full list, every time
    tool_choice=allowed(["list_files", "search_code"]),
    reasoning={"effort": "medium"}, input=inspect_prompt, store=True,
)
Cambiar tools entre fases reescribe el prefijo en caché. La guía de llamadas a funciones recomienda allowed_tools cuando solo debe cambiar el subconjunto invocable.
Una pasada de solo lectura separa diagnóstico de acción. GPT-6 Sol recibió la lista corta de GPT-6 Luna con una advertencia clara de que podía estar equivocada, y sus búsquedas de importaciones de v1, llamadas a charge y nombres de webhooks sacaron a la luz todos los archivos afectados por sí mismas.
También fue más allá de la lista, señalando modelos de pedido, el almacén de pedidos, serializadores y la exportación del libro mayor como dependencias a comprobar. Ninguno necesitó cambios al final, pero leerlos es como lo averiguas. Mantendría allowed_tools para cualquier agente que edite archivos.
El plan de migración es donde el agente se compromete con archivos concretos antes de obtener permisos de escritura. En la planificación se añade read_file, y el plan vuelve mediante Structured Outputs con las herramientas desactivadas:
plan = client.responses.parse(
    model="gpt-6-sol", instructions=INSTRUCTIONS, tools=TOOLS, tool_choice="none",
    reasoning={"effort": "medium"}, previous_response_id=last_id,
    input=PLAN_REQUEST, text_format=MigrationPlan,  # files, evidence, risks
)
El plan cubrió cada cambio requerido y advirtió de que un order ID nuevo cambiaría los metadatos de v2 en un reintento. Esa advertencia volverá más adelante.
Antes de conceder escritura, el arnés comprueba la estructura del plan, su evidencia y su cobertura.
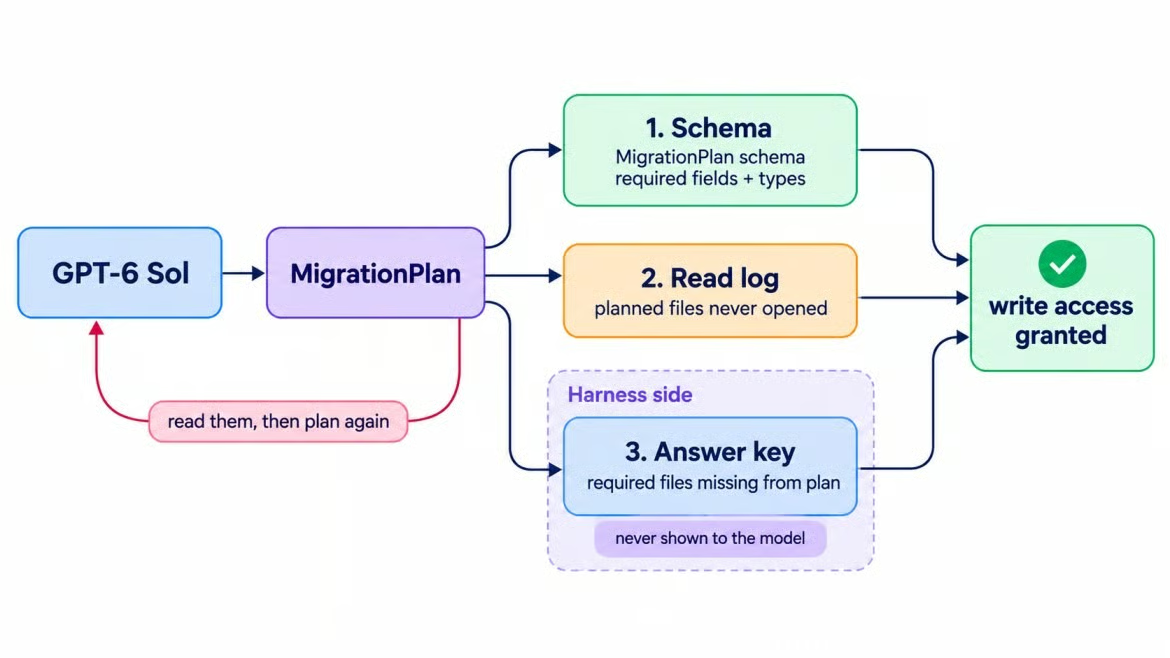
Tres checks validan un plan de migración. Imagen del autor.
El plan pasó cada compuerta. También propuso renombrar un parámetro público en client.py para ajustarlo a la nomenclatura de v2, como sugería la sección de limpieza de la especificación. Esa propuesta se convierte en la prueba de steering.
Un agente de código con GPT-6 Sol usa un bucle de herramientas: espera una respuesta, ejecuta sus llamadas a funciones y devuelve las salidas. Nuestra guía de la Responses API de OpenAI explica los formatos de solicitud y de resultados de herramientas. Esta migración mantiene el bucle en una sola conexión WebSocket porque steering lo requiere.
with client.responses.connect() as conn:
    conn.response.create(**base, previous_response_id=plan_id, input=[start_message])
    for event in conn:
        if event.type == "response.incomplete":
            reason = getattr(event.response.incomplete_details, "reason", None)
            if reason == "steered":
                continue  # keep reading for the automatic successor
            raise RuntimeError(reason or "response incomplete")
        if event.type != "response.completed":
            continue
        calls = [i for i in event.response.output if i.type == "function_call"]
        if not calls:
            break  # GPT-6 Sol says it's done here; the held-out tests decide whether it is
        outputs = [{"type": "function_call_output", "call_id": c.call_id,
                    "output": tools.run(c.name, c.arguments)} for c in calls]
        conn.response.create(**base, previous_response_id=event.response.id,
                             input=outputs)
base mantiene el modelo, las instrucciones, las herramientas y el esfuerzo medium fijos para aprovechar la caché de prompt. GPT-6 Sol ejecutó las pruebas visibles mientras trabajaba, pero también escribió la mayoría de las nuevas, así que no pueden servir como verificación independiente.
El steering a mitad de turno añade una instrucción a una respuesta que aún se está ejecutando, sin cancelarla. Tras response.created, envías response.steer en la misma conexión con el ID de esa respuesta, y el servidor aplica la instrucción en una respuesta sucesora.
El nuevo requisito llegó del equipo de la tienda: las firmas de CheckoutClient «deben quedarse exactamente como están hoy», porque otro servicio las llama. No quería que un temporizador decidiese cuándo llega, así que el arnés vigila el repositorio. Tras cada lote de llamadas a herramientas, compara las firmas públicas en disco con las originales, y la primera diferencia arma el steer:
if steer_state == "idle" and signature_changes(repo):  # CheckoutClient, compared with ast
    steer_state = "armed"

if event.type == "response.created" and steer_state == "armed":
    conn.response.steer(previous_response_id=event.response.id, input=STEER_TEXT)
    steer_state = "sent"
Eso garantiza que el steer caiga después del renombrado que contradice, que es la situación que merece la prueba. Si llega antes, solo es un prompt más largo.
Luego, el servidor informó del ciclo de vida del steering:
response.steer.accepted significa que la actualización se puso en cola, no que se aplicó
response.incomplete terminó la respuesta original con la razón steered
Una response.created sucesora continuó con el nuevo requisito
Si la respuesta está esperando el resultado de una herramienta, el servidor envía response.steer.pending y retiene el steer hasta que el arnés se lo devuelve. Sigue respondiendo a las llamadas a herramientas mientras haya un steer pendiente.
El steering cambia lo que el modelo hará a continuación. La guía de OpenAI es clara con lo demás: un steer no reescribe la salida ya enviada, no deshace acciones previas ni cancela herramientas que ya hayan empezado.
Cuando llegó el steer, el renombrado ya estaba en disco en client.py. GPT-6 Sol lo revirtió y un check de firmas reservado confirmó la interfaz final después.
Una edición se puede revertir. Una herramienta que ya hubiese llamado a un sistema externo no dejaría nada que revertir, así que registra el estado del repositorio cuando llegue cada steer.
En este repositorio, sí, aunque no en una sola pasada. La primera migración cumplió su contrato original, luego la sonda de despliegue destapó un caso que faltaba.
Cuando GPT-6 Sol informó de la migración completa, la suite reservada pasó sin ronda de reparación. En reembolsos, GPT-6 Sol sustituyó la suma por una lectura acumulativa que también ignora webhooks fuera de orden:
-        order.refunded_cents += data["amount_refunded"]
+        order.refunded_cents = max(order.refunded_cents, refunded["cents"])
Para la idempotencia, GPT-6 Sol mantuvo un order_id nuevo por intento y añadió una caché de solicitudes en el almacén de pedidos que responde a peticiones repetidas antes de que lleguen a v2. Esa caché vive en la memoria del proceso, lo cual importa en un momento.
Sí. El primer informe llamó «regresión» a una prueba de webhook actualizada y omitió el riesgo de reintentos entre servidores, pese a que el plan había nombrado esa trampa.
Structured Outputs valida el esquema, no esas afirmaciones. Contrasta los campos del informe con la evidencia registrada y no tomes una lista de riesgos vacía como prueba de que no queda riesgo.
La suite no cubrió un reintento dirigido a otra instancia de la app. Añadí una sonda de despliegue con dos clientes que comparten un procesador de pagos pero no su memoria de proceso.
La sonda falló. El reintento en la segunda instancia lanzó payments_adapter_v2.IdempotencyConflict, una excepción del adaptador que la tienda nunca debía ver.
Solo un despliegue con más de un proceso expone este fallo, que dispara la escalada de razonamiento.
Un elemento de entrada configuration_update cambia el esfuerzo de razonamiento para la siguiente respuesta y las posteriores, hasta que otra actualización lo reemplace. El esfuerzo a nivel de solicitud no cambia, así que el prefijo en caché sobrevive. Cuando falló la sonda, el arnés envió esta solicitud, siguiendo la guía de razonamiento:
Las solicitudes de la migración usan store=True, así que tras cerrar el WebSocket el arnés puede continuar la cadena de respuesta almacenada con una solicitud normal de la Responses API.
response = client.responses.create(
    model="gpt-6-sol", reasoning={"effort": "medium"},  # unchanged, so the prefix survives
    instructions=INSTRUCTIONS, tools=TOOLS, tool_choice=allowed(DIAGNOSE_TOOLS),
    previous_response_id=last_id,
    input=[{"type": "configuration_update", "reasoning": {"effort": "high"}},
           {"role": "user", "content": probe_failure + DIAGNOSE_FIRST}],
)
active_effort = "high"  # the harness records it; the response won't
GPT-6 Sol recibe el fallo y la topología de despliegue, pero sin pistas sobre la solución. DIAGNOSE_TOOLS permite leer y probar, no editar. Mantener herramientas y text.format sin cambios preserva el prefijo en caché.
Hay un detalle de API molesto: response.reasoning.effort sigue informando el ajuste a nivel de solicitud tras una actualización. El arnés no puede leer el esfuerzo activo de la respuesta, así que lo registra cuando envía la actualización y etiqueta cada respuesta posterior con él.
high?Sí. GPT-6 Sol rastreó el fallo hasta el almacén local del segundo servidor y luego siguió el order ID nuevo hasta los metadatos de pago. El procesador compartido vio parámetros distintos para el mismo request_id.
La solución hizo que el order ID fuera función del request ID, de modo que cada servidor compute el mismo:
-def new_order_id() -> str:
+def new_order_id(request_id: str | None = None) -> str:
+    if request_id:
+        stable = uuid.uuid5(uuid.NAMESPACE_URL, f"northstar.checkout.order:{request_id}")
+        return f"ord_{stable.hex[:12]}"
     return f"ord_{uuid.uuid4().hex[:12]}"
GPT-6 Sol también añadió una prueba visible para el caso. La sonda y la suite de aceptación pasaron, y luego un configuration_update devolvió el esfuerzo a medium. El informe final describió correctamente el fallo real esta vez.
La app de Streamlit del proyecto reproduce la ejecución guardada sin hacer llamadas a la API. El vídeo pasa de la vista general a los eventos de steering y luego a los resultados de la suite de aceptación y la sonda.
Learn withi DataCamp
Curso
Curso
Curso
blog
Abid Ali Awan
9 min
Tutorial
Richie Cotton
14 min
Tutorial
Zoumana Keita
12 min
Tutorial
Abid Ali Awan
8 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial