course
Praca z API OpenAI
3 godz.
175.5K
Tutaj użyjemy GPT-6 Sol, aby zmigrować Northstar Checkout, małą fikcyjną usługę checkout w Pythonie, z lokalnego adaptera płatności v1 na v2.
Dokładniej, omówimy jak:
Wykonać pierwsze wywołanie API GPT-6 Sol i odczytać jego pola użycia
Zdefiniować kontrakt migracji zanim model zobaczy repozytorium
Dać GPT-6 Sol ograniczone narzędzia do plików i testów, a następnie etapować dostęp poprzez allowed_tools
Użyć GPT-6 Luna do triażu i kazać GPT-6 Sol zweryfikować krótką listę
Zwrócić ustrukturyzowany plan migracji i sprawdzić go względem plików już przeczytanych przez GPT-6 Sol
Uruchomić migrację przez WebSocket i sterować nią po rozpoczęciu edycji
Podnieść nakład rozumowania po nieudanej niezależnej sondzie wdrożeniowej
Obliczyć zarejestrowany koszt z użycia API
Cztery spostrzeżenia zmieniły to, jak zbudowałbym następną wersję:
GPT-6 Sol to środkowy poziom rodziny GPT-6 od OpenAI, a jego identyfikator modelu w API to gpt-6-sol. Nasz przewodnik po poziomach modeli GPT-6 obejmuje premierę i benchmarki. Wytyczne GPT-6 od OpenAI stawiają na pierwszym miejscu GPT-6 Astra, w środku GPT-6 Sol, a najniżej kosztowo GPT-6 Luna.
GPT-6 Sol ma okno kontekstowe 1 050 000 tokenów i zwraca do 128 000 tokenów wyjściowych. Nakład rozumowania mieści się od none do max i domyślnie wynosi medium. Chat Completions obsługuje wywoływanie funkcji w GPT-6 Sol tylko przy none, więc każdy wniosek tutaj używa Responses API.
Cennik i wsparcie API decydują, jak harness wysyła każde żądanie.
GPT-6 Sol kosztuje 2 $ za milion tokenów wejściowych i 10 $ za milion tokenów wyjściowych dla żądań do 272 000 tokenów wejściowych, zgodnie z cennikiem OpenAI. Wejście z cache kosztuje 0,20 $ za milion, a zapis do cache 2,50 $. Stawki GPT-6 Luna dla tych samych czterech kategorii to 0,10 $, 0,01 $, 0,125 $ i 0,50 $.
Powyżej 272 000 tokenów wejściowych całe żądanie jest rozliczane po 2x stawce wejścia i cache oraz 1,5x stawce wyjścia. Żadne żądanie w tym projekcie nawet się nie zbliżyło.
Harness, czyli kod Pythona wokół modelu, używa tych kontroli GPT-6:
Sterowanie w trakcie odpowiedzi aktualizuje odpowiedź podczas jej wykonywania
configuration_update zmienia nakład rozumowania bez przepisywania keszowanego prefiksu
allowed_tools ustawia podzbiór wywoływalnych narzędzi dla żądania
Structured Outputs definiuje pola w planie i raporcie
Wszystkie cztery kontrole pozostają w tym samym łańcuchu odpowiedzi Responses API.
Zbudujemy agenta, który przeniesie Northstar Checkout z Payments Adapter v1 na v2. Oba adaptery to lokalne zamienniki, które napisałem na potrzeby tego eksperymentu, a nie prawdziwe SDK płatności. Pełny kod, fixtury i zapis przebiegu znajdziesz w tym repozytorium GitHub.
Repozytorium miesza kod płatności z niepowiązanymi modułami, więc GPT-6 Sol musi sam znaleźć dotknięte pliki. Wersja v2 łamie cztery kontrakty adaptera:
Tworzenie płatności przechodzi z client.charge(...) na client.payments.create(...)
Słowniki wyników stają się typowanymi obiektami z kwotami Money
Odrzucone karty zwracają stan zamiast podnosić wyjątek
Webhooki zmieniają nazwy, kopertę i nagłówek podpisu
Wyszukaj-i-zastąp poradzi sobie ze zmianą nazwy metody. Nie obsłuży żadnej ze zmian zachowania.
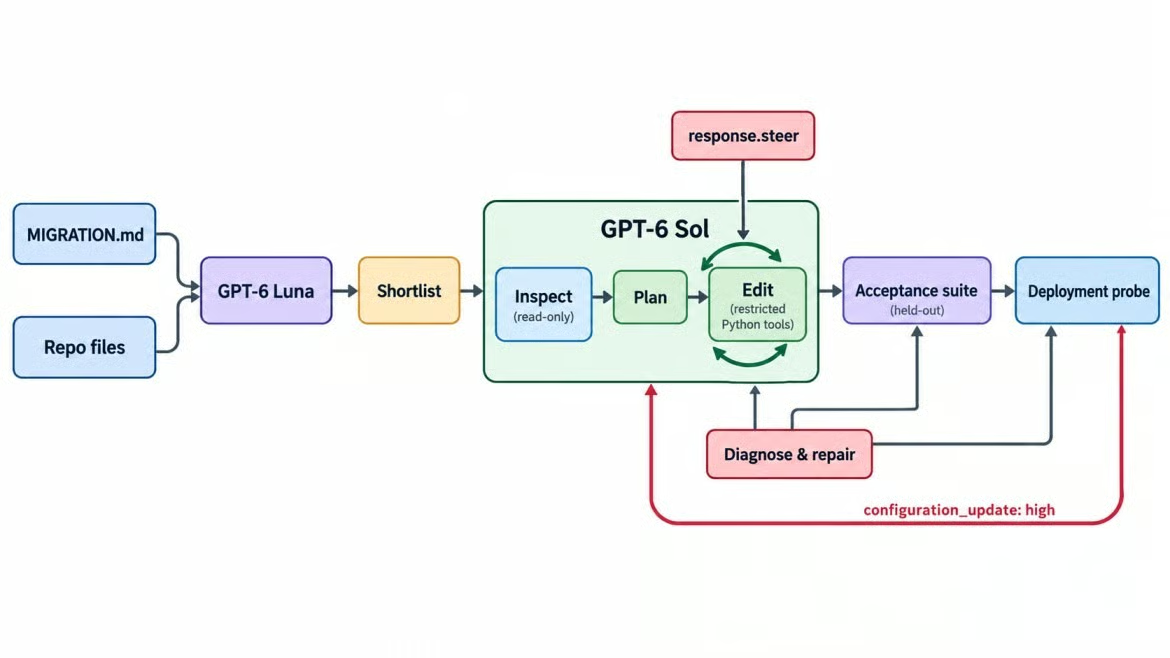
Jedna pętla migracji, dwa modele GPT-6. Obraz: autor.
GPT-6 Sol dostaje specyfikację, drzewo plików oraz ograniczone narzędzia, które stają się wywoływalne etapami. Nie wie, które pliki wymagają zmian ani że wymaganie się zmieni.
Dwie części specyfikacji to pułapki. Żadna nie jest zasadzonym błędem; obie wynikają ze zderzenia zachowania v2 z istniejącym kodem:
Idempotencja. v2 porównuje parametry, gdy widzi powtórzony request_id, ale checkout wkłada świeży order_id w metadane przy każdej próbie, więc naiwny retry zostaje odrzucony zamiast zdeduplikowany.
Sumy zwrotów. webhook payment.refunded w v2 raportuje łączną kwotę zwróconą do tej pory, podczas gdy stary handler dodaje każdą wartość operatorem +=.
Oba przypadki przechodzą przez checker typów. Złapiesz je tylko, uruchamiając checkout i zwroty end-to-end.
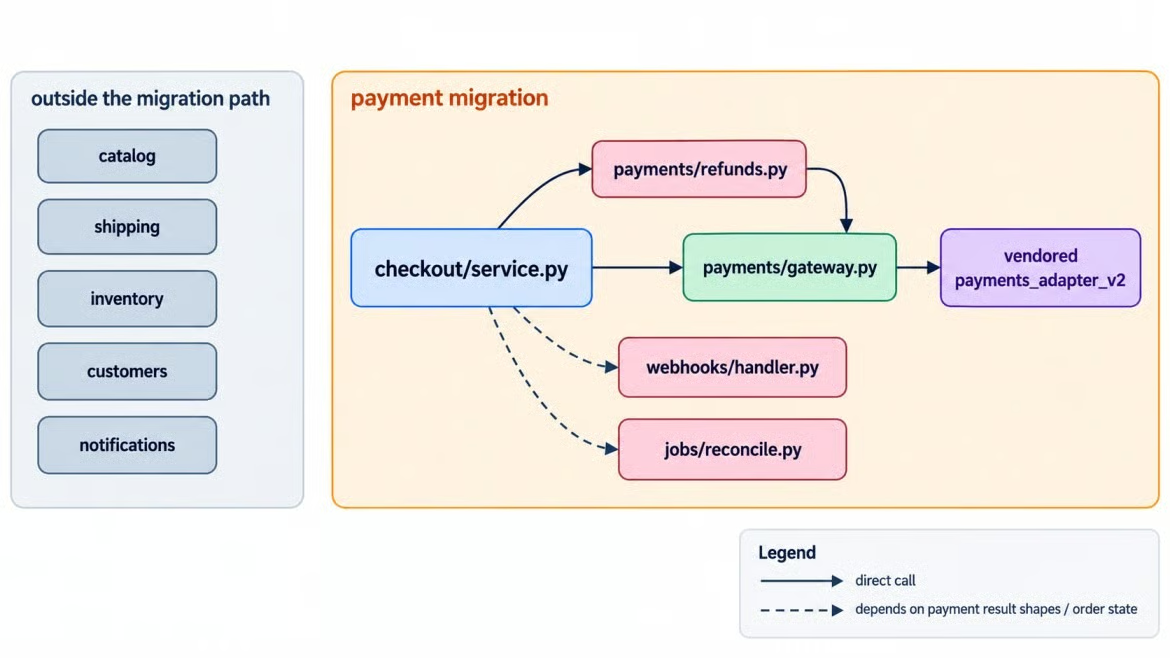
Zmiany płatności obejmują kilka modułów Northstar. Obraz: autor.
Mapa oddziela bezpośrednie importy adaptera od modułów, które zależą od zachowania płatności. Te pośrednie powiązania sprawiają, że kluczowy jest klucz odpowiedzi dla całego repozytorium.
Wynik określa odłożony zestaw akceptacyjny, napisany przed jakimkolwiek wywołaniem modelu. GPT-6 Sol nigdy go nie widzi; harness uruchamia go przy użyciu pytest na zmigrowanej kopii. Sprawdza, że:
Checkout działa przez v2, a ponowna próba z tym samym kluczem idempotencji obciąża raz
Odrzucona karta wciąż podnosi publiczny błąd CheckoutDeclined
Pełny zwrot, dwa częściowe zwroty i ponownie dostarczony webhook pozostawiają poprawne sumy
CheckoutClient zachowuje niezmienione sygnatury metod
Nie pozostają żadne odniesienia do v1, vendor/ i MIGRATION.md są nietknięte, a widoczne testy przechodzą
Oryginalny kod już przechodzi kontrole niezmienionych interfejsów i chronionych plików; pozostałe kontrole mierzą migrację. Oddzielny klucz odpowiedzi wymienia wymagane zmiany, ale tylko harness go czyta.
Katalogi acceptance/ i probes/ leżą poza skopiowanym repozytorium ujawnionym obu modelom. Klucz odpowiedzi znajduje się pod acceptance/, więc nie może wejść do wejścia GPT-6 Luna, drzewa plików ani żadnego narzędzia repozytorium.
Brama odczytu może zwrócić ścieżki z własnego planu GPT-6 Sol. Wynik pokrycia klucza odpowiedzi jest rejestrowany tylko do ewaluacji; nigdy nie odsyła brakujących ścieżek prawdy do GPT-6 Sol.
Po tym zestawie uruchamiana jest sonda wdrożeniowa. Żadna z kontroli nie akceptuje komunikatu modelu „done” jako dowodu.
Potrzebujesz Pythona 3.10 lub nowszego oraz klucza API z dostępem do obu modeli. Wymagania obejmują dodatek realtime, którego potrzebuje sterowanie:
git clone https://github.com/KhalidAbdelaty/gpt-6-sol-api.git
cd gpt-6-sol-api
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
Na macOS lub Linuksie użyj source .venv/bin/activate i cp .env.example .env, a potem umieść OPENAI_API_KEY=... w .env.
Jeśli twój klucz już działa z Responses API, pomiń następną podsekcję.
Najmniejsze użyteczne żądanie potwierdza klucz, ID modelu i pola użycia potrzebne do sekcji kosztów:
from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()
client = OpenAI()
response = client.responses.create(
    model="gpt-6-sol",
    input="In one sentence, why is a breaking API migration harder than renaming a function?",
)
print(response.reasoning.effort, response.output_text)
print(response.usage)
Odpowiedź raportuje wysiłek medium, a usage zawiera cached_tokens i cache_write_tokens. Pomiń temperature i top_p. Oba zwracają 400, kiedy wysiłek nie jest none.
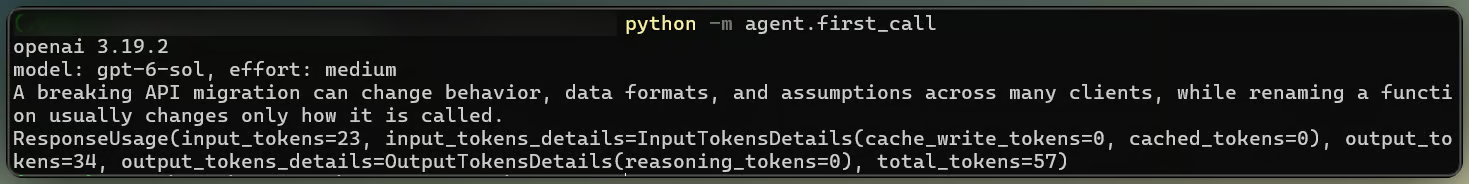
Pierwsze żądanie GPT-6 Sol zwraca usage. Obraz: autor.
Zacznij od medium, domyślnego, i utrzymuj ustawienie na poziomie żądania przez cały przebieg. Większość tur migracji to odczyty i małe edycje. Sonda wdrożeniowa później dostarczy powód do podniesienia wysiłku.
Warstwa narzędzi zarządza uprawnieniami agenta. GPT-6 Sol dostaje te narzędzia funkcji z strict: true:
list_files i search_code lokalizują odpowiedni kod
read_file zwraca jeden plik repozytorium
edit_file zmienia jedno dokładne wystąpienie
run_tests uruchamia dozwolony cel pytest
Ścisłe schematy sprawdzają kształt argumentów, nie bezpieczeństwo ścieżek, więc Python egzekwuje granicę zapisu:
READ_ONLY = ("vendor/", "MIGRATION.md", "conftest.py")

if write:
    if rel_posix.startswith(READ_ONLY) or rel_posix in READ_ONLY:
        raise ToolError(f"{rel_posix} is read-only")  # the spec and both adapters
    if not rel_posix.startswith(("northstar/", "tests/")) or not rel_posix.endswith(".py"):
        raise ToolError("writes are limited to Python files under northstar/ and tests/")
Ścieżka jest najpierw rozwijana, więc
../ i ścieżki bezwzględne zawodzą. edit_file zastępuje jedno dokładne dopasowanie, a run_tests akceptuje tylko cele pod tests/.
Harness zwraca zablokowane wywołanie jako wynik narzędzia ERROR:, a pętla toczy się dalej. Nasz przewodnik po inżynierii harnessa agentów wyjaśnia, dlaczego te kontrole należą do harnessa, a nie do promptu.
Wywołaj każde narzędzie z wejściem, które musi odrzucić:
Ścieżka zawierająca ..
Ścieżka bezwzględna
Zapis pod vendor/
Cel testu zawierający polecenie shellowe
Żaden nie powinien przejść. Edycja, która pasuje do więcej niż jednej lokalizacji, powinna poprosić o więcej kontekstu, a trzymanie reguł w niestandardowych funkcjach umieszcza je w jednym, testowalnym miejscu.
Triaż repozytorium to wąskie zadanie klasyfikacji: oceń relewantność każdego pliku i zacytuj odniesienia do v1. GPT-6 Luna dostaje to zadanie i nic więcej, i działa jako pierwsza, zanim GPT-6 Sol cokolwiek przeszuka.
class FileVerdict(BaseModel):
    path: str
    relevance: Literal["high", "medium", "low", "none"]
    legacy_references: list[str]

triage = client.responses.parse(model="gpt-6-luna", input=spec_and_all_files,
                                text_format=TriageResult)  # a list of FileVerdict
Wejście to specyfikacja plus każdy plik Pythona pod northstar/ i tests/. Wszystko ocenione na high lub medium trafia na krótką listę, którą GPT-6 Sol otrzymuje w następnej kolejności.
Porównaj krótką listę z kluczem odpowiedzi z wcześniejszego kroku i najpierw spójrz na trafność. GPT-6 Luna zachowała każdy dotknięty plik i dodała kilka, które nie wymagały zmian.
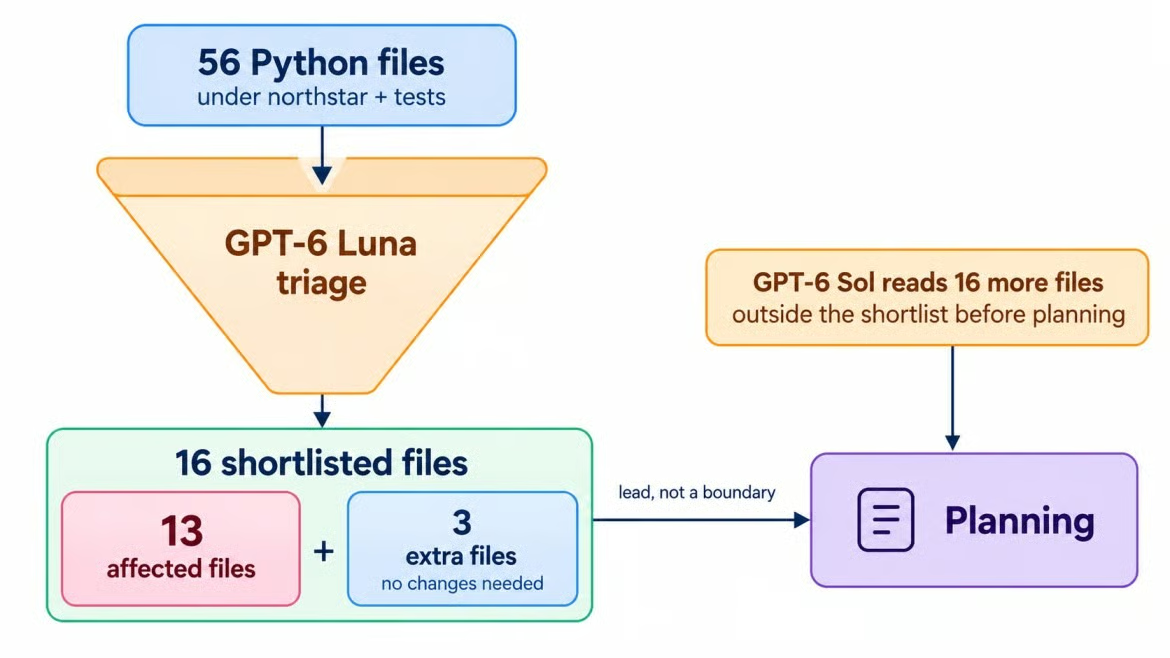
GPT-6 Luna zawęża 56 do 16. Obraz: autor.
Krótka lista to trop, nie granica.
allowed_tools do etapowanych uprawnieńallowed_tools to tryb tool_choice, który ogranicza, które narzędzia model może wywołać, podczas gdy pełna lista narzędzi pozostaje na miejscu. Tak właśnie pierwszy przebieg GPT-6 Sol pozostaje tylko do odczytu: pełna lista jest zdefiniowana w każdym żądaniu, ale tylko listing i wyszukiwanie są wywoływalne.
def allowed(names):
    return {"type": "allowed_tools", "mode": "auto",
            "tools": [{"type": "function", "name": n} for n in names]}

response = client.responses.create(
    model="gpt-6-sol", instructions=INSTRUCTIONS, tools=TOOLS,  # full list, every time
    tool_choice=allowed(["list_files", "search_code"]),
    reasoning={"effort": "medium"}, input=inspect_prompt, store=True,
)
Zmiana
tools między fazami przepisuje keszowany prefiks. Przewodnik po wywoływaniu funkcji zaleca allowed_tools, gdy zmieniać ma się tylko podzbiór wywoływalnych narzędzi.
Przebieg tylko do odczytu oddziela diagnozę od działania. GPT-6 Sol dostał krótką listę GPT-6 Luna z prostym ostrzeżeniem, że może być błędna, a jego wyszukiwania importów v1, wywołań charge i nazw webhooków samodzielnie ujawniły każdy dotknięty plik.
Poszedł też poza listę, oznaczając modele zamówień, magazyn zamówień, serializery i eksport księgi jako zależności downstream do sprawdzenia. Żaden nie wymagał zmian, ale ich przeczytanie to jedyny sposób, by to stwierdzić. Zostawiłbym allowed_tools dla każdego agenta, który edytuje pliki.
Plan migracji to miejsce, w którym agent zobowiązuje się do konkretnych plików, zanim dostanie dostęp do zapisu. Planowanie dodaje read_file, a plan wraca przez Structured Outputs przy wyłączonych narzędziach:
plan = client.responses.parse(
    model="gpt-6-sol", instructions=INSTRUCTIONS, tools=TOOLS, tool_choice="none",
    reasoning={"effort": "medium"}, previous_response_id=last_id,
    input=PLAN_REQUEST, text_format=MigrationPlan,  # files, evidence, risks
)
Plan objął każdą wymaganą zmianę i ostrzegł, że świeży identyfikator zamówienia zmieni metadane v2 przy ponowieniu. To ostrzeżenie wróci później.
Zanim przyznasz dostęp do zapisu, harness sprawdza strukturę planu, dowody i pokrycie.
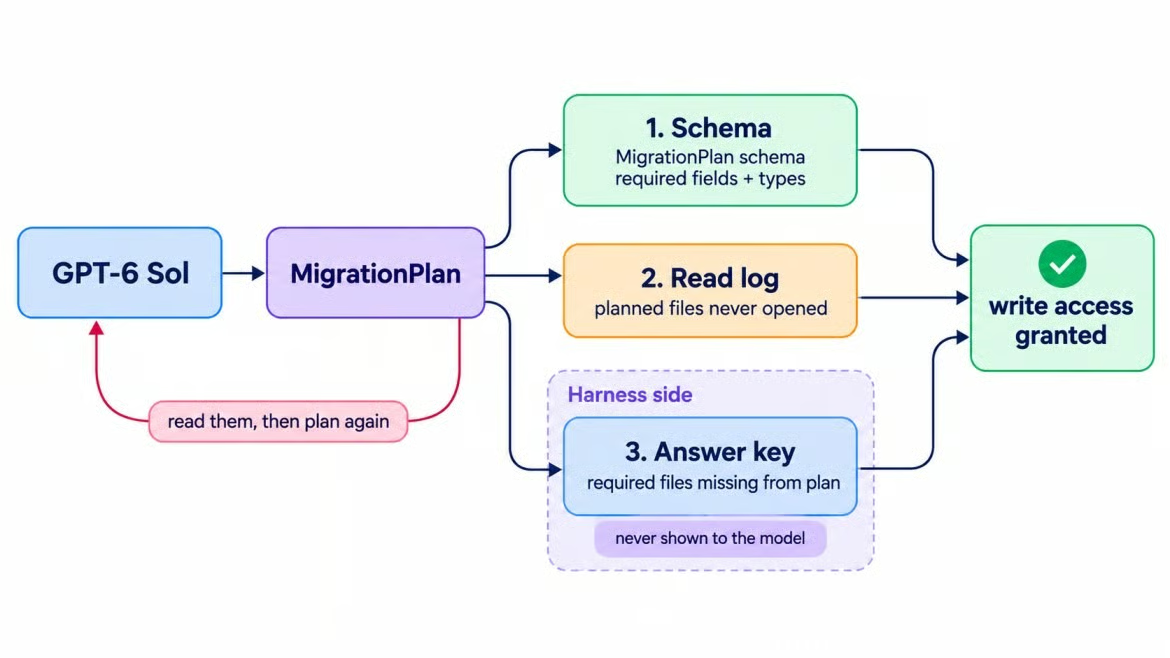
Trzy kontrole testują jeden plan migracji. Obraz: autor.
Plan przeszedł każdą bramkę. Zaproponował też zmianę nazwy publicznego parametru w client.py, aby dopasować nazewnictwo v2, co sugerowała sekcja sprzątania w specyfikacji. Ta propozycja staje się testem sterowania.
Agent kodujący GPT-6 Sol używa pętli narzędzi: czeka na odpowiedź, uruchamia jej wywołania funkcji i zwraca wyniki. Nasz przewodnik po OpenAI Responses API wyjaśnia formaty żądania i wyników narzędzi. Ta migracja utrzymuje pętlę na jednym połączeniu WebSocket, bo sterowanie tego wymaga.
with client.responses.connect() as conn:
    conn.response.create(**base, previous_response_id=plan_id, input=[start_message])
    for event in conn:
        if event.type == "response.incomplete":
            reason = getattr(event.response.incomplete_details, "reason", None)
            if reason == "steered":
                continue  # keep reading for the automatic successor
            raise RuntimeError(reason or "response incomplete")
        if event.type != "response.completed":
            continue
        calls = [i for i in event.response.output if i.type == "function_call"]
        if not calls:
            break  # GPT-6 Sol says it's done here; the held-out tests decide whether it is
        outputs = [{"type": "function_call_output", "call_id": c.call_id,
                    "output": tools.run(c.name, c.arguments)} for c in calls]
        conn.response.create(**base, previous_response_id=event.response.id,
                             input=outputs)
base utrzymuje model, instrukcje, narzędzia i wysiłek medium stałe dla cache’u promptu. GPT-6 Sol uruchamiał widoczne testy w trakcie pracy, ale też napisał większość nowych testów, więc nie mogą one służyć jako niezależna kontrola.
Sterowanie w trakcie dodaje instrukcję do odpowiedzi, która wciąż trwa, bez jej anulowania. Po response.created wysyłasz response.steer na tym samym połączeniu z ID tej odpowiedzi, a serwer stosuje instrukcję w następczej odpowiedzi.
Nowy wymóg przyszedł od zespołu sklepu: sygnatury CheckoutClient „muszą pozostać dokładnie takie, jak dziś”, bo wywołuje je inna usługa. Nie chciałem, by timer decydował, kiedy to nadejdzie, więc harness obserwuje repozytorium. Po każdej partii wywołań narzędzi porównuje publiczne sygnatury na dysku z oryginałami, a pierwsza różnica uzbraja sterowanie:
if steer_state == "idle" and signature_changes(repo):  # CheckoutClient, compared with ast
    steer_state = "armed"

if event.type == "response.created" and steer_state == "armed":
    conn.response.steer(previous_response_id=event.response.id, input=STEER_TEXT)
    steer_state = "sent"
To gwarantuje, że sterowanie trafi po zmianie nazwy, której zaprzecza, co jest sytuacją wartą testu. Wysłane wcześniej byłoby tylko dłuższym promptem.
Serwer następnie raportował cykl życia sterowania:
response.steer.accepted oznaczało, że aktualizacja została zakolejkowana, nie zastosowana
response.incomplete zakończyło oryginalną odpowiedź z powodem steered
Następcza response.created kontynuowała z nowym wymogiem
Jeśli odpowiedź czeka na wynik narzędzia, serwer wysyła response.steer.pending i trzyma sterowanie, aż harness go zwróci. Odpowiadaj na wywołania narzędzi, gdy sterowanie jest w stanie pending.
Sterowanie zmienia to, co model zrobi dalej. Przewodnik OpenAI jest wprost o reszcie: sterowanie nie przepisuje już wysłanego wyjścia, nie cofa wcześniejszych działań ani nie anuluje narzędzi, które już się rozpoczęły.
Gdy sterowanie dotarło, zmiana nazwy była już na dysku w client.py. GPT-6 Sol cofnął ją, a odłożona kontrola sygnatur później potwierdziła finalny interfejs.
Edycję można cofnąć. Narzędzie, które zdążyło już wywołać system zewnętrzny, nie zostawi nic do cofnięcia, więc zapisuj stan repozytorium, gdy każde sterowanie dociera.
W tym repozytorium tak, choć nie w jednym przebiegu. Pierwsza migracja spełniła pierwotny kontrakt, po czym sonda wdrożeniowa ujawniła brakujący przypadek.
Gdy GPT-6 Sol zameldował ukończenie migracji, odłożony zestaw przeszedł bez rundy naprawczej. Dla zwrotów GPT-6 Sol zastąpił dodawanie odczytem skumulowanym, który ignoruje też webhooki poza kolejnością:
-        order.refunded_cents += data["amount_refunded"]
+        order.refunded_cents = max(order.refunded_cents, refunded["cents"])
Dla idempotencji GPT-6 Sol zachował świeży order_id na próbę i dodał cache żądań w magazynie zamówień, który odpowiada na powtórzone żądania, zanim dotrą do v2. Ten cache żyje w pamięci procesu, co za chwilę ma znaczenie.
Tak. Pierwszy raport uznał zaktualizowany test webhooka za regresję i pominął ryzyko ponowień między serwerami, mimo że plan nazwał tę pułapkę.
Structured Outputs waliduje schemat, nie te twierdzenia. Sprawdzaj pola raportu względem zarejestrowanych dowodów i nie traktuj pustej listy ryzyk jako dowodu, że żadne nie pozostało.
Zestaw przeoczył ponowienie skierowane do innej instancji aplikacji. Dodałem sondę wdrożeniową z dwoma klientami, którzy współdzielą jeden procesor płatności, ale nie pamięć procesową.
Sonda zawiodła. Ponowienie na drugiej instancji podniosło payments_adapter_v2.IdempotencyConflict, wyjątek adaptera, którego frontend nie miał nigdy zobaczyć.
Tylko wdrożenie z więcej niż jednym procesem ujawnia tę porażkę, która wyzwala eskalację rozumowania.
Element wejścia configuration_update zmienia nakład rozumowania dla następnej odpowiedzi i każdej późniejszej, aż kolejna aktualizacja go zastąpi. Wysiłek na poziomie żądania pozostaje, więc keszowany prefiks przetrwa. Gdy sonda zawiodła, harness wysłał to żądanie, zgodnie z przewodnikiem po rozumowaniu:
Żądania migracji używają store=True, więc po zamknięciu WebSocket harness może kontynuować zapisany łańcuch odpowiedzi zwykłym żądaniem Responses API.
response = client.responses.create(
    model="gpt-6-sol", reasoning={"effort": "medium"},  # unchanged, so the prefix survives
    instructions=INSTRUCTIONS, tools=TOOLS, tool_choice=allowed(DIAGNOSE_TOOLS),
    previous_response_id=last_id,
    input=[{"type": "configuration_update", "reasoning": {"effort": "high"}},
           {"role": "user", "content": probe_failure + DIAGNOSE_FIRST}],
)
active_effort = "high"  # the harness records it; the response won't
GPT-6 Sol dostaje porażkę i kształt wdrożenia, ale bez wskazówki dotyczącej poprawki. DIAGNOSE_TOOLS pozwala na odczyt i testy, nie edycję. Zachowanie narzędzi i text.format bez zmian zachowuje keszowany prefiks.
Jeden detal API jest uciążliwy: response.reasoning.effort wciąż raportuje ustawienie na poziomie żądania po aktualizacji. Harness nie może odczytać aktywnego wysiłku z odpowiedzi, więc zapisuje wartość sam, gdy wysyła aktualizację, i taguje nią każdą późniejszą odpowiedź.
high zadziałała?Tak. GPT-6 Sol prześledził porażkę do lokalnego magazynu drugiego serwera, a potem podążył za świeżym identyfikatorem zamówienia do metadanych płatności. Współdzielony procesor widział różne parametry dla tego samego request_id.
Poprawka sprawiła, że identyfikator zamówienia stał się funkcją identyfikatora żądania, więc każdy serwer wylicza ten sam:
-def new_order_id() -> str:
+def new_order_id(request_id: str | None = None) -> str:
+    if request_id:
+        stable = uuid.uuid5(uuid.NAMESPACE_URL, f"northstar.checkout.order:{request_id}")
+        return f"ord_{stable.hex[:12]}"
     return f"ord_{uuid.uuid4().hex[:12]}"
GPT-6 Sol dodał też widoczny test dla tego przypadku. Sonda i zestaw akceptacyjny przeszły, potem
configuration_update przywrócił wysiłek do medium. Końcowy raport tym razem trafnie opisał realną porażkę.
Aplikacja Streamlit projektu odtwarza zapisany przebieg bez wykonywania wywołań API. Wideo przechodzi od przeglądu do zdarzeń sterowania, a następnie do wyników akceptacji i sondy.
Ucz się z DataCamp
course
course
course