
course
OpenAI API के साथ काम करना
3 घंटा
175.5K
यहाँ, हम GPT-6 Sol का उपयोग करके Northstar Checkout—एक छोटा काल्पनिक Python चेकआउट सर्विस—को लोकल v1 पेमेंट एडेप्टर से v2 में माइग्रेट करेंगे।
विशेष रूप से, हम यह कवर करेंगे कि कैसे:
पहली GPT-6 Sol API कॉल करें और उसके usage फ़ील्ड पढ़ें
मॉडल के रिपॉजिटरी देखने से पहले माइग्रेशन कॉन्ट्रैक्ट परिभाषित करें
GPT-6 Sol को प्रतिबंधित फाइल और टेस्ट टूल दें, फिर allowed_tools से स्टेज़्ड एक्सेस दें
ट्रायेज़ के लिए GPT-6 Luna का उपयोग करें और GPT-6 Sol से शॉर्टलिस्ट की जाँच कराएँ
एक संरचित माइग्रेशन प्लान लौटाएँ और उसे GPT-6 Sol द्वारा पहले पढ़ी गई फाइलों से मिलान करें
WebSocket पर माइग्रेशन चलाएँ और एडिटिंग शुरू होने के बाद उसे स्टियर करें
स्वतंत्र डिप्लॉयमेंट प्रोब असफल होने पर रीजनिंग effort बढ़ाएँ
API usage से रिकॉर्डेड लागत की गणना करें
चार निष्कर्षों ने बदल दिया कि मैं अगला संस्करण कैसे बनाऊँगा:
GPT-6 Sol, OpenAI के GPT-6 परिवार का मिड-टियर है, और इसका API मॉडल ID gpt-6-sol है। हमारे GPT-6 मॉडल टियर्स के गाइड में लॉन्च और बेंचमार्क शामिल हैं। OpenAI की GPT-6 मार्गदर्शिका में GPT-6 Astra को पहले, GPT-6 Sol को बीच में, और GPT-6 Luna को लागत में सबसे नीचे रखा गया है।
GPT-6 Sol का 1,050,000-टोकन का कॉन्टेक्स्ट विंडो है और यह अधिकतम 128,000 आउटपुट टोकन लौटाता है। रीजनिंग effort none से max तक चलता है और डिफ़ॉल्ट medium है। Chat Completions, GPT-6 Sol की फ़ंक्शन कॉलिंग को केवल none पर सपोर्ट करता है, इसलिए यहाँ हर अनुरोध Responses API का उपयोग करता है।
प्राइसिंग और API सपोर्ट तय करते हैं कि हार्नेस हर अनुरोध कैसे भेजता है।
OpenAI के अनुसार प्राइसिंग पेज पर 272,000 इनपुट टोकन तक के अनुरोधों के लिए GPT-6 Sol की लागत प्रति मिलियन इनपुट टोकन $2 और प्रति मिलियन आउटपुट टोकन $10 है। कैश्ड इनपुट $0.20/मिलियन है, और कैश राइट्स $2.50। GPT-6 Luna के लिए इन्हीं चार श्रेणियों की दरें $0.10, $0.01, $0.125, और $0.50 हैं।
272,000 इनपुट टोकन से ऊपर, पूरा अनुरोध इनपुट और कैश दरों पर 2x तथा आउटपुट दर पर 1.5x पर बिल होता है। इस प्रोजेक्ट के किसी अनुरोध ने उसके आस-पास भी नहीं पहुँचा।
हार्नेस—अर्थात मॉडल के चारों ओर का Python कोड—इन GPT-6 कंट्रोल्स का उपयोग करता है:
Mid-turn steering चलते हुए response को अपडेट करता है
configuration_update कैश्ड प्रीफ़िक्स को बदले बिना रीजनिंग effort बदलता है
allowed_tools किसी अनुरोध के लिए कॉल किए जा सकने वाले सबसेट को सेट करता है
Structured Outputs प्लान और रिपोर्ट के फ़ील्ड तय करता है
ये चारों कंट्रोल्स एक ही Responses API रेस्पॉन्स चेन के भीतर रहते हैं।
हम एक एजेंट बनाएँगे जो Northstar Checkout को Payments Adapter v1 से v2 में ले जाए। दोनों एडेप्टर इस प्रयोग के लिए लिखे गए लोकल स्टैंड-इन्स हैं, वास्तविक पेमेंट SDK नहीं। पूरा कोड, फिक्स्चर, और रिकॉर्डेड रन इस GitHub रिपॉजिटरी में है।
रिपॉजिटरी पेमेंट कोड को असंबंधित मॉड्यूल्स के साथ मिलाती है, इसलिए GPT-6 Sol को स्वयं प्रभावित फाइलें ढूँढनी होंगी। V2 चार एडेप्टर कॉन्ट्रैक्ट्स तोड़ता है:
पेमेंट क्रिएशन client.charge(...) से client.payments.create(...) में चला जाता है
रिज़ल्ट डिक्शनरीज़, Money अमाउंट्स वाले टाइप्ड ऑब्जेक्ट्स बन जाते हैं
डिक्लाइंड कार्ड अब अपवाद उठाने के बजाय एक state लौटाते हैं
वेबहुक्स के नाम, एनवेलप, और सिग्नेचर हेडर बदल जाते हैं
सर्च-एंड-रिप्लेस मेथड के नाम बदलने को संभाल लेता है। यह किसी भी व्यवहार परिवर्तन को नहीं संभालता।
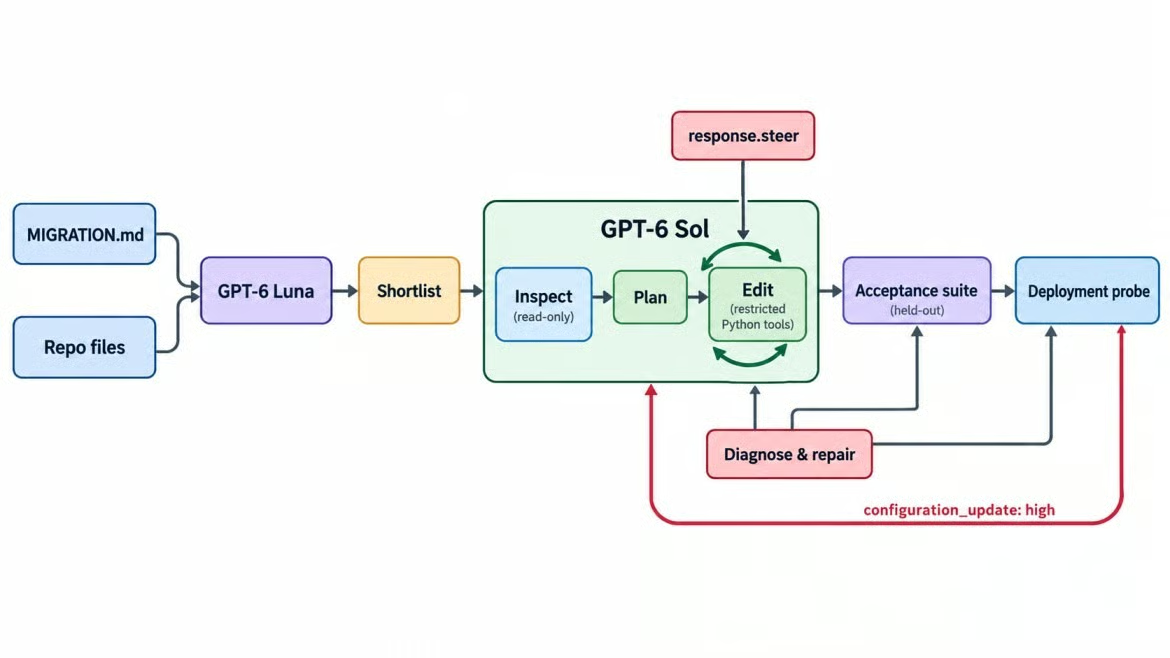
एक माइग्रेशन लूप, दो GPT-6 मॉडल। छवि: लेखक।
GPT-6 Sol को स्पेक, फाइल ट्री, और प्रतिबंधित टूल्स मिलते हैं जो चरणों में कॉल किए जा सकते हैं। उसे नहीं पता कि किन फाइलों को बदलाव चाहिए या कोई आवश्यकता बदलेगी।
स्पेक के दो हिस्से जाल हैं। कोई भी लगाया हुआ बग नहीं; दोनों v2 व्यवहार के मौजूदा कोड से मिलने से आते हैं:
Idempotency. v2, दोहराए गए request_id पर पैरामीटर्स की तुलना करता है, पर चेकआउट हर प्रयास पर मेटाडेटा में नया order_id डालता है, इसलिए एक साधारण retry डेडुप्लिकेट होने के बजाय रिजेक्ट हो जाता है।
Refund totals. v2 का payment.refunded वेबहुक अब तक का कुल रिफंड बताता है, जबकि पुराना हैंडलर हर वैल्यू को += से जोड़ता है।
दोनों एक टाइप चेकर से बच जाते हैं। आप इन्हें केवल चेकआउट और रिफंड्स को एंड-टू-एंड चलाकर ही पकड़ते हैं।
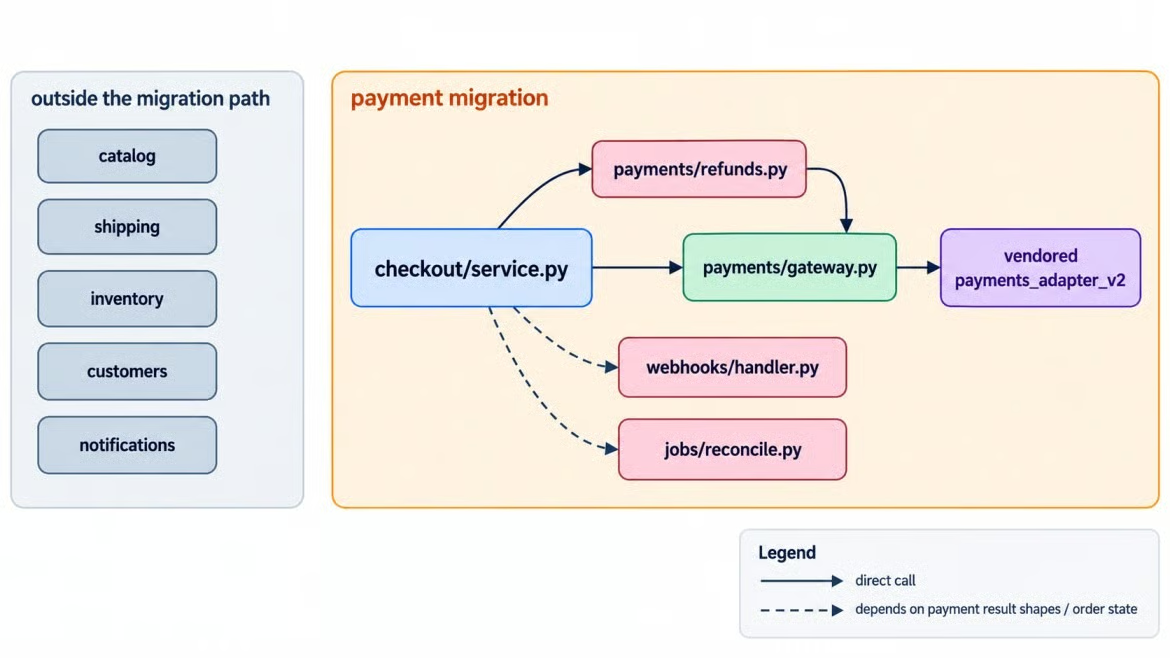
पेमेंट परिवर्तन कई Northstar मॉड्यूल्स से होकर गुजरते हैं। छवि: लेखक।
मैप सीधे एडेप्टर इम्पोर्ट्स को उन मॉड्यूल्स से अलग करता है जो पेमेंट व्यवहार पर निर्भर हैं। वे परोक्ष लिंक इसीलिए मायने रखते हैं कि पूरी रिपॉजिटरी के लिए उत्तर कुंजी का महत्व है।
एक होल्ड-आउट स्वीकृति सूट, जिसे किसी भी मॉडल कॉल से पहले लिखा गया, परिणाम तय करता है। GPT-6 Sol इसे कभी नहीं देखता; हार्नेस इसे माइग्रेटेड कॉपी पर pytest से चलाता है। यह जाँचता है कि:
चेकआउट v2 के जरिए सफल होता है, और समान idempotency key के साथ retry एक ही बार चार्ज करता है
डिक्लाइंड कार्ड अब भी पब्लिक CheckoutDeclined त्रुटि उठाता है
एक फुल रिफंड, दो आंशिक रिफंड, और एक री-डिलीवर्ड वेबहुक सभी सही टोटल छोड़ते हैं
CheckoutClient की मेथड सिग्नेचर्स अपरिवर्तित हैं
कोई v1 संदर्भ नहीं बचता, vendor/ और MIGRATION.md अप्रभावित हैं, और दृश्य टेस्ट पास होते हैं
मूल कोड पहले से ही अपरिवर्तित इंटरफेसेज़ और संरक्षित फाइलों के चेक पास करता है; शेष चेक माइग्रेशन को मापते हैं। एक अलग उत्तर कुंजी आवश्यक परिवर्तनों की सूची देती है, पर केवल हार्नेस ही उसे पढ़ता है।
acceptance/ और probes/ डायरेक्टरीज़ कॉपी की गई रिपॉजिटरी के बाहर रहती हैं जो दोनों मॉडलों को एक्सपोज़ होती है। उत्तर कुंजी acceptance/ के अंतर्गत रहती है, इसलिए वह GPT-6 Luna के इनपुट, फाइल ट्री, या किसी रिपॉजिटरी टूल में प्रवेश नहीं कर सकती।
रीड गेट, GPT-6 Sol की अपनी योजना से पाथ लौटा सकता है। उत्तर-कुंजी कवरेज परिणाम केवल मूल्यांकन के लिए रिकॉर्ड होता है; यह कभी भी मिसिंग ग्राउंड-ट्रुथ पाथ्स GPT-6 Sol को वापस नहीं भेजता।
उस सूट के बाद एक डिप्लॉयमेंट प्रोब चलता है। कोई भी चेक मॉडल के "done" संदेश को साक्ष्य नहीं मानता।
आपको Python 3.10 या नया और दोनों मॉडलों तक पहुँच वाली API key चाहिए। आवश्यकताओं में realtime extra शामिल है, जिसकी steering को ज़रूरत होती है:
git clone https://github.com/KhalidAbdelaty/gpt-6-sol-api.git
cd gpt-6-sol-api
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
macOS या Linux पर source .venv/bin/activate और cp .env.example .env का उपयोग करें, फिर OPENAI_API_KEY=... को .env में रखें।
यदि आपकी key पहले से Responses API के साथ काम करती है, तो अगला उपखंड छोड़ दें।
सबसे छोटा उपयोगी अनुरोध key, मॉडल ID, और cost सेक्शन को चाहिए usage फ़ील्ड की पुष्टि करता है:
from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()
client = OpenAI()
response = client.responses.create(
    model="gpt-6-sol",
    input="In one sentence, why is a breaking API migration harder than renaming a function?",
)
print(response.reasoning.effort, response.output_text)
print(response.usage)
response में medium effort रिपोर्ट होता है, और usage में cached_tokens और cache_write_tokens शामिल हैं। temperature और top_p छोड़ दें। effort none न होने पर दोनों 400 लौटाते हैं।
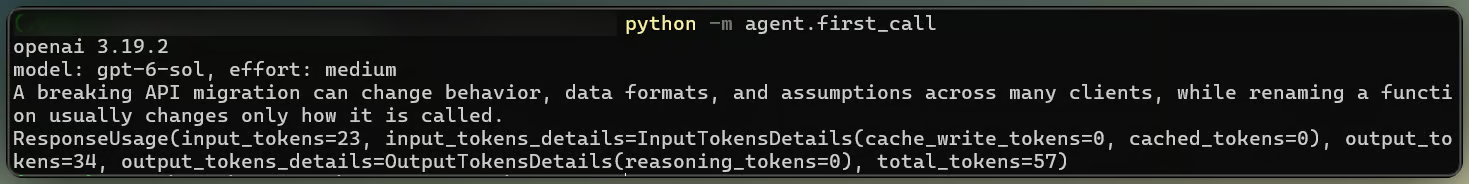
पहली GPT-6 Sol रिक्वेस्ट usage लौटाती है। छवि: लेखक।
डिफ़ॉल्ट medium से शुरू करें, और पूरे रन के लिए रिक्वेस्ट-लेवल सेटिंग वहीं रखें। अधिकांश माइग्रेशन टर्न रीड्स और छोटे एडिट होते हैं। बाद में डिप्लॉयमेंट प्रोब effort बढ़ाने का कारण देता है।
टूल लेयर एजेंट की अनुमतियों की मालिक है। GPT-6 Sol को ये फ़ंक्शन टूल्स strict: true के साथ मिलते हैं:
list_files और search_code प्रासंगिक कोड ढूँढते हैं
read_file एक रिपॉजिटरी फाइल लौटाता है
edit_file एक सटीक उपस्थिति को बदलता है
run_tests अनुमत pytest टारगेट चलाता है
सख्त स्कीमा आर्ग्युमेंट के आकार की जाँच करते हैं, पाथ सुरक्षा की नहीं, इसलिए Python लिखने की सीमा लागू करता है:
READ_ONLY = ("vendor/", "MIGRATION.md", "conftest.py")

if write:
    if rel_posix.startswith(READ_ONLY) or rel_posix in READ_ONLY:
        raise ToolError(f"{rel_posix} is read-only")  # the spec and both adapters
    if not rel_posix.startswith(("northstar/", "tests/")) or not rel_posix.endswith(".py"):
        raise ToolError("writes are limited to Python files under northstar/ and tests/")
पाथ पहले resolve होता है, इसलिए ../ और एब्सोल्यूट पाथ असफल होते हैं। edit_file एक सटीक मैच को बदलता है, और run_tests केवल tests/ के अंतर्गत टारगेट स्वीकार करता है।
हार्नेस एक ब्लॉक्ड कॉल को ERROR: टूल आउटपुट के रूप में लौटाता है, और लूप चलता रहता है। हमारा एजेंट हार्नेस इंजीनियरिंग गाइड बताता है कि ये चेक प्रॉम्प्ट की बजाय हार्नेस में क्यों होने चाहिए।
हर टूल को ऐसे इनपुट से कॉल करें जिसे वह अस्वीकार करे:
एक पाथ जिसमें .. शामिल हो
एक एब्सोल्यूट पाथ
vendor/ के अंतर्गत एक write
एक टेस्ट टारगेट जिसमें शेल कमांड हो
कोई भी पार नहीं होना चाहिए। ऐसा एडिट जो एक से अधिक स्थानों से मेल खाता हो, अधिक संदर्भ माँगना चाहिए, और नियमों को कस्टम फ़ंक्शंस में रखने से वे एक ही टेस्टेबल जगह पर रहते हैं।
रिपॉजिटरी ट्रायेज़ एक संकीर्ण वर्गीकरण कार्य है: हर फाइल की प्रासंगिकता रेट करें और v1 संदर्भ उद्धृत करें। GPT-6 Luna को यही काम और कुछ नहीं दिया जाता, और यह GPT-6 Sol के कुछ भी खोजने से पहले, सबसे पहले चलता है।
class FileVerdict(BaseModel):
    path: str
    relevance: Literal["high", "medium", "low", "none"]
    legacy_references: list[str]

triage = client.responses.parse(model="gpt-6-luna", input=spec_and_all_files,
                                text_format=TriageResult)  # a list of FileVerdict
इनपुट स्पेक और
northstar/ तथा tests/ के अंतर्गत हर Python फाइल है। जिसे भी high या medium रेट किया गया है, वह शॉर्टलिस्ट पर जाता है जिसे GPT-6 Sol अगली बार प्राप्त करता है।
शॉर्टलिस्ट की पहले की उत्तर कुंजी से तुलना करें, और पहले रिकॉल देखें। GPT-6 Luna ने हर प्रभावित फाइल को बनाए रखा और कुछ ऐसी भी जो बदलाव की ज़रूरत नहीं थीं।
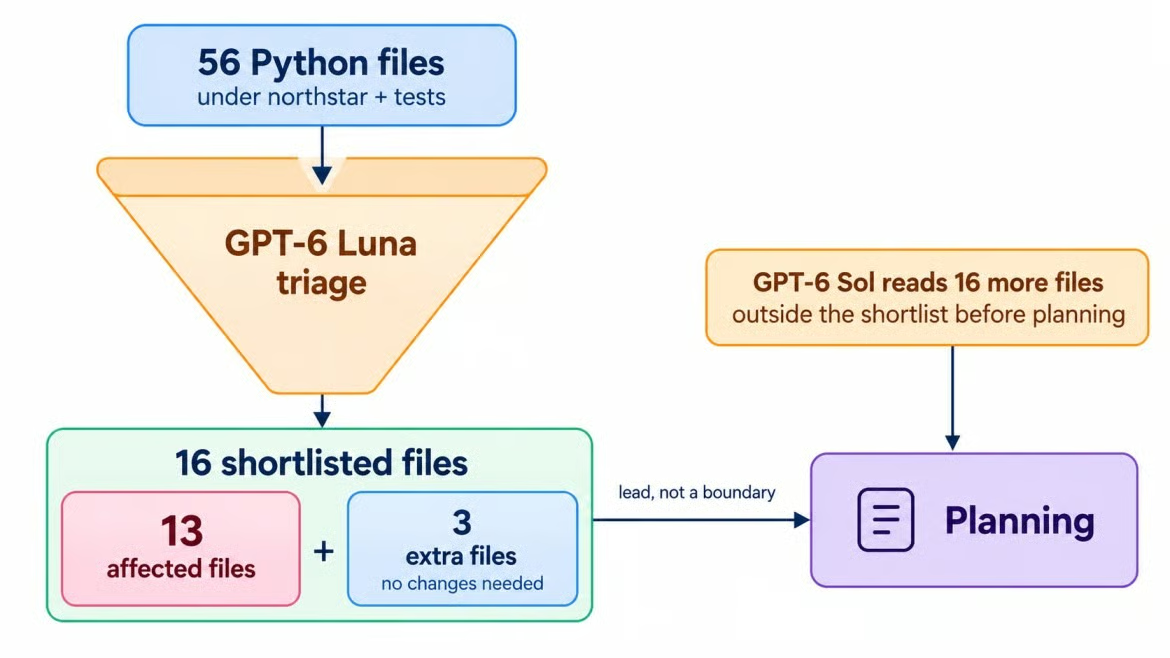
GPT-6 Luna 56 को 16 तक सीमित करता है। छवि: लेखक।
शॉर्टलिस्ट एक सुराग है, सीमा नहीं।
allowed_tools का उपयोग कैसे करेंallowed_tools एक tool_choice मोड है जो पूर्ण टूल सूची को रखते हुए मॉडल किन टूल्स को कॉल कर सकता है, उसे सीमित करता है। इसीलिए GPT-6 Sol का पहला पास केवल रीड-ओनली रहता है: हर अनुरोध पर पूर्ण सूची परिभाषित है, पर केवल लिस्टिंग और सर्चिंग कॉल की जा सकती हैं।
def allowed(names):
    return {"type": "allowed_tools", "mode": "auto",
            "tools": [{"type": "function", "name": n} for n in names]}

response = client.responses.create(
    model="gpt-6-sol", instructions=INSTRUCTIONS, tools=TOOLS,  # full list, every time
    tool_choice=allowed(["list_files", "search_code"]),
    reasoning={"effort": "medium"}, input=inspect_prompt, store=True,
)
फेज़ के बीच tools बदलना कैश्ड प्रीफ़िक्स को फिर से लिखता है। फ़ंक्शन कॉलिंग गाइड तब allowed_tools की सिफारिश करता है जब केवल कॉल किए जा सकने वाला सबसेट बदलना चाहिए।
एक रीड-ओनली पास निदान को कार्रवाई से अलग करता है। GPT-6 Sol को GPT-6 Luna की शॉर्टलिस्ट एक साधारण चेतावनी के साथ मिली कि यह गलत हो सकती है, और v1 इम्पोर्ट्स, चार्ज कॉल्स, और वेबहुक नामों के लिए उसकी सर्च ने अपने दम पर हर प्रभावित फाइल सतह पर ला दी।
यह सूची से आगे भी गया, ऑर्डर मॉडल्स, ऑर्डर स्टोर, सीरियलाइज़र्स, और लेजर एक्सपोर्ट को डाउनस्ट्रीम डिपेंडेंसीज़ के रूप में चिह्नित किया जिन्हें जाँचना चाहिए। उनमें से किसी को बदलाव की आवश्यकता नहीं निकली, पर उन्हें पढ़ना ही है जिससे आप यह पता लगाते हैं। मैं allowed_tools किसी भी फाइल एडिट करने वाले एजेंट के लिए रखूँगा।
माइग्रेशन प्लान वह है जहाँ एजेंट, write एक्सेस मिलने से पहले, विशिष्ट फाइलों पर कमिट करता है। प्लानिंग में read_file जोड़ा जाता है, और प्लान, टूल्स ऑफ़ रहने पर Structured Outputs के जरिए वापस आता है:
plan = client.responses.parse(
    model="gpt-6-sol", instructions=INSTRUCTIONS, tools=TOOLS, tool_choice="none",
    reasoning={"effort": "medium"}, previous_response_id=last_id,
    input=PLAN_REQUEST, text_format=MigrationPlan,  # files, evidence, risks
)
प्लान ने हर आवश्यक बदलाव को कवर किया और चेतावनी दी कि नया ऑर्डर ID retry पर v2 मेटाडेटा बदल देगा। यह चेतावनी बाद में लौटती है।
write एक्सेस देने से पहले, हार्नेस प्लान की संरचना, एविडेंस, और कवरेज जाँचता है।
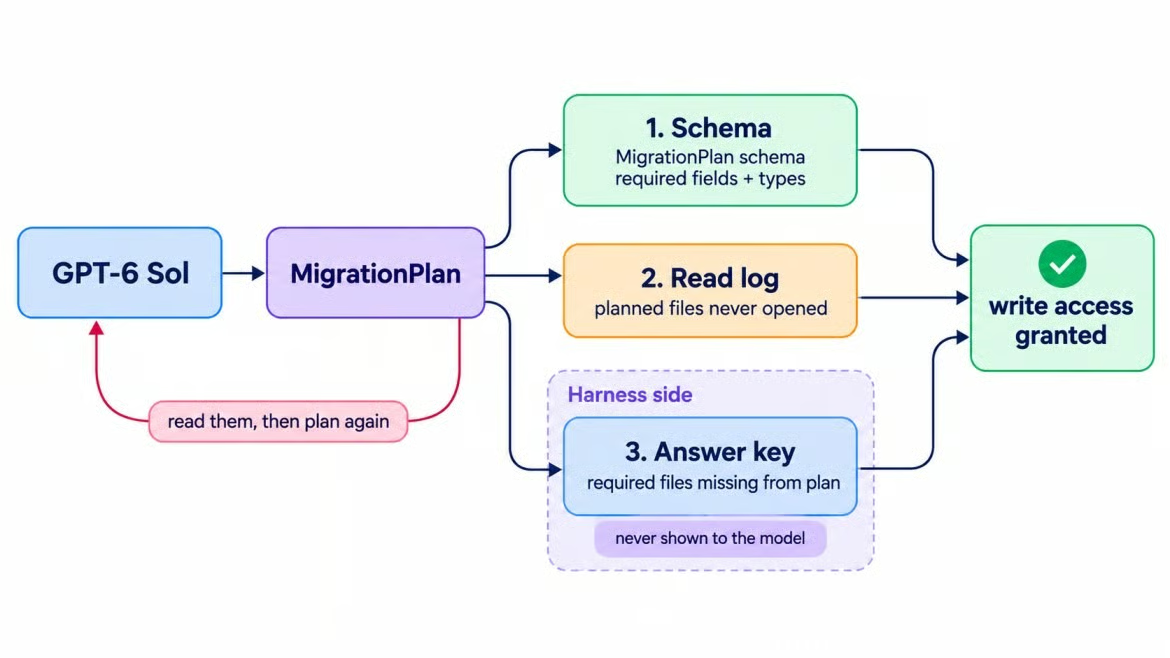
तीन चेक एक माइग्रेशन प्लान को परखते हैं। छवि: लेखक।
प्लान हर गेट से पास हुआ। इसने पब्लिक client.py पैरामीटर का नाम v2 के नेमिंग से मिलाने का प्रस्ताव भी रखा, जिसका सुझाव स्पेक के क्लीनअप सेक्शन ने दिया था। यही प्रस्ताव steering टेस्ट बनता है।
एक GPT-6 Sol कोडिंग एजेंट एक टूल लूप का उपयोग करता है: response की प्रतीक्षा करें, उसके फ़ंक्शन कॉल्स चलाएँ, और आउटपुट लौटाएँ। हमारा OpenAI Responses API गाइड अनुरोध और टूल-रिज़ल्ट फ़ॉर्मैट समझाता है। यह माइग्रेशन एक ही WebSocket कनेक्शन पर लूप रखता है क्योंकि steering को इसकी आवश्यकता होती है।
with client.responses.connect() as conn:
    conn.response.create(**base, previous_response_id=plan_id, input=[start_message])
    for event in conn:
        if event.type == "response.incomplete":
            reason = getattr(event.response.incomplete_details, "reason", None)
            if reason == "steered":
                continue  # keep reading for the automatic successor
            raise RuntimeError(reason or "response incomplete")
        if event.type != "response.completed":
            continue
        calls = [i for i in event.response.output if i.type == "function_call"]
        if not calls:
            break  # GPT-6 Sol says it's done here; the held-out tests decide whether it is
        outputs = [{"type": "function_call_output", "call_id": c.call_id,
                    "output": tools.run(c.name, c.arguments)} for c in calls]
        conn.response.create(**base, previous_response_id=event.response.id,
                             input=outputs)
base मॉडल, निर्देश, टूल्स, और medium effort को प्रॉम्प्ट कैशिंग के लिए स्थिर रखता है। GPT-6 Sol काम करते समय दृश्य टेस्ट चलाता रहा, पर उसने अधिकांश नए टेस्ट भी लिखे, इसलिए वे स्वतंत्र जाँच नहीं बन सकते।
Mid-turn steering, बिना कैंसल किए, अभी चल रहे response में एक निर्देश जोड़ता है। response.created के बाद, आप उसी कनेक्शन पर उस response के ID के साथ response.steer भेजते हैं, और सर्वर उत्तराधिकारी response में निर्देश लागू करता है।
नई आवश्यकता स्टोरफ़्रंट टीम से आई: CheckoutClient सिग्नेचर्स "आज जैसे हैं बिल्कुल वैसे ही रहने चाहिए," क्योंकि दूसरी सर्विस उन्हें कॉल करती है। मैं नहीं चाहता था कि कोई टाइमर तय करे कि यह कब पहुँचे, इसलिए हार्नेस इसके बजाय रिपॉजिटरी पर नज़र रखता है। हर बैच के टूल कॉल्स के बाद, वह डिस्क पर पब्लिक सिग्नेचर्स की मूल सिग्नेचर्स से तुलना करता है, और पहला अंतर steer को आर्म कर देता है:
if steer_state == "idle" and signature_changes(repo):  # CheckoutClient, compared with ast
    steer_state = "armed"

if event.type == "response.created" and steer_state == "armed":
    conn.response.steer(previous_response_id=event.response.id, input=STEER_TEXT)
    steer_state = "sent"
यह सुनिश्चित करता है कि steer उस रीनेम के बाद ही पहुँचे जिसे वह खंडित करता है—यही स्थिति परखने लायक है। पहले भेजे जाने पर, यह केवल लंबा प्रॉम्प्ट होता।
इसके बाद सर्वर ने steering का लाइफसाइकल बताया:
response.steer.accepted का मतलब था अपडेट कतार में है, लागू नहीं
response.incomplete ने मूल response को कारण steered के साथ समाप्त किया
उत्तराधिकारी response.created ने नई आवश्यकता के साथ जारी रखा
यदि response किसी टूल रिज़ल्ट की प्रतीक्षा कर रहा है, तो सर्वर response.steer.pending भेजता है और steer को तब तक रोकता है जब तक हार्नेस उसे लौटा न दे। steer पेंडिंग रहते हुए टूल कॉल्स का उत्तर देते रहें।
steering यह बदलता है कि मॉडल आगे क्या करता है। OpenAI की गाइड बाकी पर स्पष्ट है: steer पहले से भेजे गए आउटपुट को फिर से नहीं लिखता, पहले की कार्रवाइयों को पूर्ववत नहीं करता, या पहले से शुरू किए गए टूल्स को कैंसल नहीं करता।
जब steer पहुँचा, रीनेम पहले से ही client.py में डिस्क पर था। GPT-6 Sol ने उसे रिवर्ट किया, और बाद में एक होल्ड-आउट सिग्नेचर चेक ने अंतिम इंटरफेस की पुष्टि की।
एडिट को रिवर्ट किया जा सकता है। कोई टूल जिसने पहले ही किसी बाहरी सिस्टम को कॉल कर दिया हो, उसके लिए रिवर्ट करने को कुछ नहीं बचेगा, इसलिए जब भी कोई steer पहुँचे, रिपॉजिटरी स्टेट रिकॉर्ड करें।
इस रिपॉजिटरी में, हाँ—हालाँकि एक ही पास में नहीं। पहला माइग्रेशन अपने मूल कॉन्ट्रैक्ट से मिला, फिर डिप्लॉयमेंट प्रोब ने एक मिसिंग केस उजागर किया।
जब GPT-6 Sol ने माइग्रेशन पूरा बताया, होल्ड-आउट सूट बिना रिपेयर राउंड के पास हो गया। रिफंड्स के लिए, GPT-6 Sol ने जोड़ने के बजाय संचयी रीड रखी जो आउट-ऑफ-ऑर्डर वेबहुक्स को भी नज़रअंदाज़ करती है:
-        order.refunded_cents += data["amount_refunded"]
+        order.refunded_cents = max(order.refunded_cents, refunded["cents"])
Idempotency के लिए, GPT-6 Sol ने हर प्रयास पर नया order_id बनाए रखा और ऑर्डर स्टोर में एक रिक्वेस्ट कैश जोड़ा जो v2 तक पहुँचने से पहले दोहराए गए अनुरोधों का उत्तर देता है। यह कैश प्रोसेस मेमोरी में रहता है, जो अभी ज़रूरी होगा।
हाँ। पहली रिपोर्ट ने एक अपडेटेड वेबहुक टेस्ट को रिग्रेशन कहा और सर्वरों के पार retries के जोखिम को छोड़ दिया, जबकि प्लान ने उस जाल का नाम लिया था।
Structured Outputs स्कीमा को वेलिडेट करता है, वे दावे नहीं। रिपोर्ट फ़ील्ड्स को रिकॉर्डेड एविडेंस से मिलाएँ, और खाली जोखिम सूची को यह प्रमाण न मानें कि कोई जोखिम नहीं बचा।
सूट से एक retry जो दूसरे ऐप इंस्टेंस की ओर गया, छूट गया। मैंने दो क्लाइंट्स के साथ एक डिप्लॉयमेंट प्रोब जोड़ा जो एक ही पेमेंट प्रोसेसर साझा करते हैं पर उनकी प्रोसेस मेमोरी साझा नहीं।
प्रोब असफल हुआ। दूसरे इंस्टेंस पर retry ने payments_adapter_v2.IdempotencyConflict उठाया—एक एडेप्टर अपवाद जिसे स्टोरफ़्रंट को कभी नहीं देखना था।
केवल एक से अधिक प्रक्रियाओं वाली डिप्लॉयमेंट यह विफलता उजागर करती है—यही रीजनिंग एस्केलेशन को ट्रिगर करती है।
एक configuration_update इनपुट आइटम अगले और हर बाद के response के लिए रीजनिंग effort बदलता है, जब तक कोई और अपडेट उसे बदल न दे। रिक्वेस्ट-लेवल effort जस का तस रहता है, इसलिए कैश्ड प्रीफ़िक्स बचा रहता है। जब प्रोब असफल हुआ, हार्नेस ने रीजनिंग गाइड के अनुसार यह अनुरोध भेजा:
माइग्रेशन अनुरोध store=True का उपयोग करते हैं, इसलिए WebSocket बंद होने के बाद हार्नेस स्टोर्ड रेस्पॉन्स चेन को सामान्य Responses API अनुरोध से जारी रख सकता है।
response = client.responses.create(
    model="gpt-6-sol", reasoning={"effort": "medium"},  # unchanged, so the prefix survives
    instructions=INSTRUCTIONS, tools=TOOLS, tool_choice=allowed(DIAGNOSE_TOOLS),
    previous_response_id=last_id,
    input=[{"type": "configuration_update", "reasoning": {"effort": "high"}},
           {"role": "user", "content": probe_failure + DIAGNOSE_FIRST}],
)
active_effort = "high"  # the harness records it; the response won't
GPT-6 Sol को विफलता और डिप्लॉयमेंट आकृति मिलती है, पर सुधार के बारे में कोई संकेत नहीं। DIAGNOSE_TOOLS पढ़ने और परीक्षण की अनुमति देता है, एडिटिंग की नहीं। टूल्स और text.format अपरिवर्तित रखने से कैश्ड प्रीफ़िक्स सुरक्षित रहता है।
एक API विवरण खीझ पैदा करता है: response.reasoning.effort अपडेट के बाद भी रिक्वेस्ट-लेवल सेटिंग रिपोर्ट करता है। हार्नेस रेस्पॉन्स से सक्रिय effort वापस नहीं पढ़ सकता, इसलिए वह जब अपडेट भेजता है तब वैल्यू खुद रिकॉर्ड करता है और हर बाद के response को उससे टैग करता है।
high effort पर रिपेयर कामयाब हुआ?हाँ। GPT-6 Sol ने विफलता का पता दूसरे सर्वर के लोकल स्टोर तक लगाया, फिर नए ऑर्डर ID का पीछा करते हुए पेमेंट मेटाडेटा तक पहुँचा। साझा प्रोसेसर ने एक ही request_id के लिए अलग-अलग पैरामीटर्स देखे।
फिक्स ने ऑर्डर ID को request ID का फ़ंक्शन बना दिया, ताकि हर सर्वर वही ID कंप्यूट करे:
-def new_order_id() -> str:
+def new_order_id(request_id: str | None = None) -> str:
+    if request_id:
+        stable = uuid.uuid5(uuid.NAMESPACE_URL, f"northstar.checkout.order:{request_id}")
+        return f"ord_{stable.hex[:12]}"
     return f"ord_{uuid.uuid4().hex[:12]}"
GPT-6 Sol ने इस केस के लिए एक दृश्य टेस्ट भी जोड़ा। प्रोब और स्वीकृति सूट पास हुए, फिर एक configuration_update ने effort को वापस medium कर दिया। अंतिम रिपोर्ट ने इस बार वास्तविक विफलता को सटीक रूप से वर्णित किया।
प्रोजेक्ट का Streamlit ऐप सेव्ड रन को बिना API कॉल किए रिप्ले करता है। वीडियो ओवरव्यू से steering इवेंट्स और फिर स्वीकृति तथा प्रोब परिणामों की ओर बढ़ता है।
DataCamp के साथ सीखें
course
course
course