courses
OpenAI API 활용하기
3
173.9K
더 효율적이고 합리적인 가격의 프런티어 모델 경쟁에서 Anthropic의 새 모델에 쏠린 관심은 약 한 시간 남짓에 그쳤습니다.
Claude Opus 5.5는 Claude 5.5 제품군의 첫 모델로, Opus 5보다 낮은 실행 비용으로 Fable 5.1 수준의 성능을 내세웁니다.
OpenAI는 빠르게 응답했습니다. 플래그십 GPT-6 Astra와 같은 방법으로 학습한 GPT-6 Sol을 GPT-6 제품군의 중간급으로 공개했고, 전작인 GPT-5.6 Sol 대비 API 가격을 절반으로 출시했습니다.
이 글에서는 성능, 가드레일, 가격 등 여러 범주에서 GPT-6 Sol과 Claude Opus 5.5를 비교하고, 두 모델 모두로 수행한 실전 빌드 테스트 결과도 제공합니다.
GPT-6 Sol은 OpenAI의 중간급 GPT-6 모델로, 2026년 9월 22일 GPT-6 Luna와 함께 출시되었으며, 플래그십 GPT-6 Astra 아래에 위치합니다.
주요 포인트는 Astra의 학습 레시피를 적용하면서 GPT-5.6 Sol의 API 가격을 절반으로 낮췄고, 대화 중 추론 노력이나 도구 설정이 바뀌어도 유지되는 프롬프트 캐싱을 제공합니다.
우리의 GPT-6 Sol과 Luna 가이드에서 출시 내용을 살펴볼 수 있고, GPT-6 Astra API 튜토리얼에서는 제품군의 비동기 도구와 스티어링을 다룹니다.
Claude Opus 5.5는 Anthropic의 첫 Claude 5.5 모델로, 2026년 9월 22일 출시되었으며 장시간 에이전틱 코딩과 지식 작업을 위한 회사의 새로운 주력 모델입니다.
주요 포인트는 Opus 가격대에서 Fable급 결과를 제공한다는 점입니다. Anthropic은 대부분의 작업에서 Claude Fable 5.1과 대등하다고 말하며, Fable급 사이버보안 및 생물학 안전장치를 제공합니다.
우리의 Opus 5.5 가이드에서 출시 내용을, Claude Opus 5 API 튜토리얼에서 이전 세대의 API를 확인할 수 있습니다.
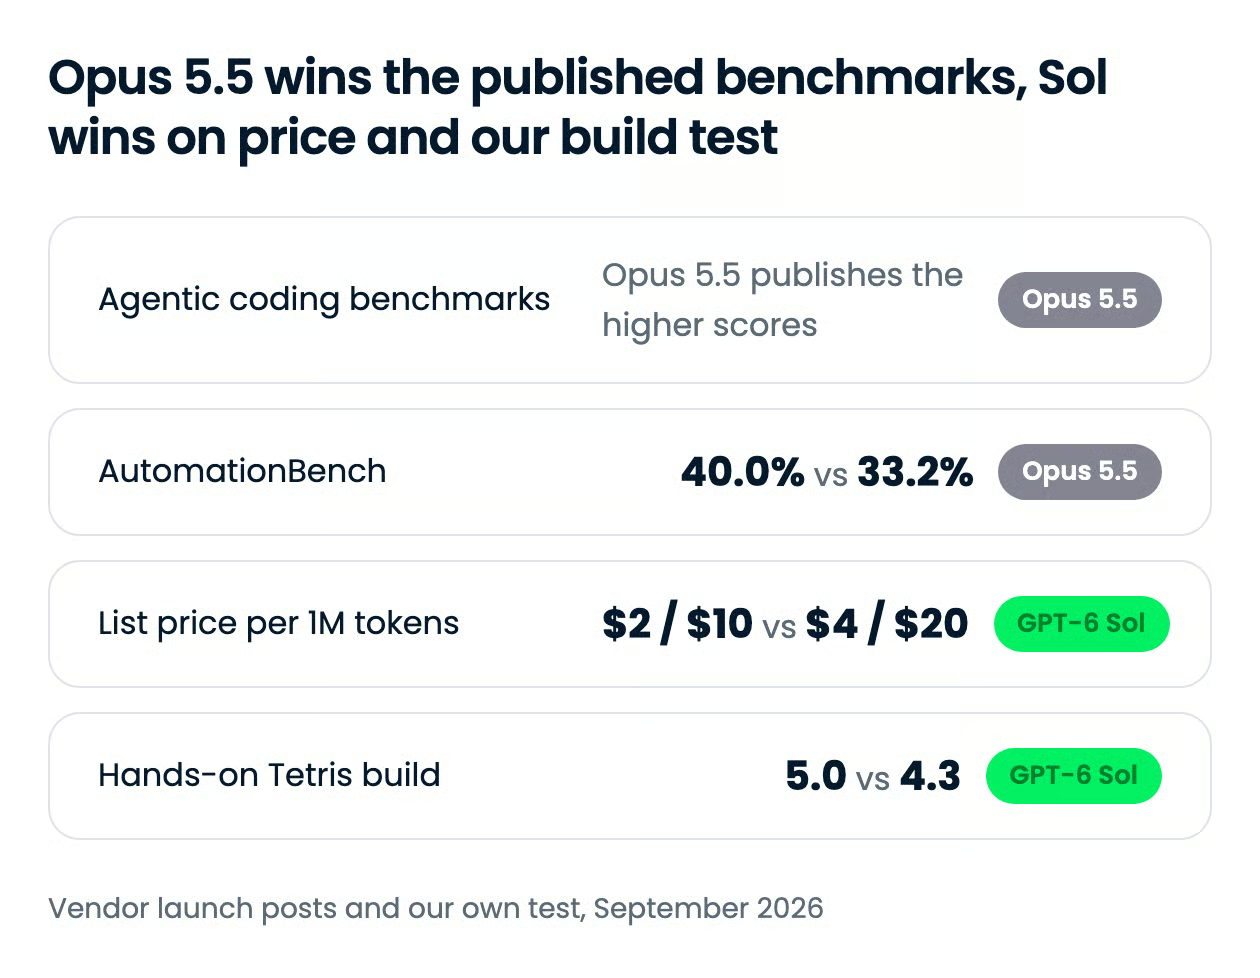
출시 시점이 촉박해 서로의 새 모델을 상대의 표에 넣지 못했기 때문에 두 모델이 겹치는 벤치마크는 두 개뿐이고, 둘 다 Opus 5.5가 앞섭니다. Sol의 논리는 가격과, 그리고 우리 테스트에서의 성과에 기반합니다.
| 기능 | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| 에이전틱 코딩 벤치마크 | DeepSWE v1.1 최대 노력 68.8%; FrontierCode에서 "Claude Fable 5.1과 동등"(수치 비공개) | Terminal-Bench 4.0 66.4%, FrontierCode v1.1 54.4%, CursorBench 4.0 57.8% |
| AutomationBench (공유) | xhigh 노력 33.2%, 작업당 $0.27 | 40.0% (Zapier 실행, 폴백 모델 없음) |
| OSWorld 2.0, 부분 점수 (공유) | xhigh 노력으로 오프라인 세트 60.5% | 81.8% |
| 지식 작업 | OpenAI 내부 평가에서 GPT-5.6 Sol 대비 사실 오류 약 절반 | GDPval-AA v2.1 1846 Elo, GPT-6 Astra 및 GPT-5.6 Sol보다 앞섬 |
| 컨텍스트 윈도우 / 최대 출력 | 1.05M 토큰 / 128K | 1M 토큰 / 128K |
| 정가(1M 토큰당) | 입력 $2 / 출력 $10 | 입력 $4 / 출력 $20 |
| 가드레일 | none부터 max까지 노력 조절; GPT-5.6 Sol 대비 코딩 작업에 대한 오해 소지가 있는 주장 감소 |
생각(추론)을 끌 수 없음; 대부분의 사이버보안 작업은 Opus 4.8로 라우팅 |
| 우리의 테트리스 빌드(세 축 평균) | 5.0 | 4.3 |
Opus 5.5는 에이전틱 코딩 수치가 더 강하며, Sol의 발표는 이를 직접 반박하지 않습니다. Anthropic은 Opus 5.5의 Terminal-Bench 4.0, FrontierCode, CursorBench 점수를 공개했고, OpenAI는 Sol의 DeepSWE 점수와 FrontierCode 결과를 xhigh 노력에서 Claude Fable 5.1과 동등하다고만 설명합니다. Anthropic은 FrontierCode에서 Fable 5.1이 50.3%, Opus 5.5가 54.4%라고 밝히므로, 두 주장 모두 사실이라면 두 업체가 모두 언급한 유일한 코딩 벤치마크에서 Sol은 Opus 5.5보다 약 4점 낮은 셈입니다.
| 벤치마크 | GPT-6 Sol | Claude Opus 5.5 | 비고 |
|---|---|---|---|
| Terminal-Bench 4.0 | 비공개 | 66.4% (xhigh) | Anthropic 실행; OpenAI 발표 기준 GPT-6 Astra 57.9%, GPT-5.6 Sol 37.3% |
| FrontierCode v1.1 Main | 비공개; "Claude Fable 5.1 xhigh와 동등" | 54.4% | Anthropic은 Fable 5.1을 50.3%로 평가; 단순 정답률이 아닌 머지 가능성 기준 |
| CursorBench 4.0 | 비공개 | 57.8% | Anthropic 실행; GPT-5.6 Sol 41.7% |
| DeepSWE v1.1 | 68.8% (max) | 비공개 | OpenAI 실행; Claude Fable 5의 최고 점수는 xhigh에서 69.9% |
두 업체 모두 공통 점수보다는 장기 작업 일화를 내세웁니다. Anthropic의 내부 사례인 HAProxy의 C→Rust 리라이트는 Opus 5.5가 Fable 5.1 대비 51% 저렴한 비용으로 9.5시간에 마쳤고 Fable 5.1은 12시간이 걸렸습니다. OpenAI의 논리는 작업당 비용입니다. Sol은 DeepSWE에서 Fable 5에 약 1포인트 차이로 접근하면서 비용은 약 80% 낮췄다는 주장입니다.
이 표들을 감안해야 할 이유 두 가지:
서류상으로는 Opus 5.5가 더 강한 코딩 모델이지만, 아래의 단일 빌드 테스트에서는 그 격차가 드러나지 않았습니다.
Opus 5.5는 두 모델이 공유하는 벤치마크 둘 다에서 앞서며, AutomationBench 격차는 이 글에서 가장 명확한 수치입니다. 47개 비즈니스 도구 전반에서 에이전트를 시험하는 Zapier의 테스트에서 Opus 5.5는 40.0%, Sol은 33.2%입니다.
Sol의 반론은 청구서입니다. OpenAI는 Sol이 작업당 비용에서 Claude Opus 5 대비 9% 수준으로 앞선다고 프레이밍하지만, 이 비교는 이전 Opus와의 비교입니다.
| 벤치마크 | GPT-6 Sol | Claude Opus 5.5 | 비고 |
|---|---|---|---|
| AutomationBench | 33.2% (xhigh), 작업당 $0.27 | 40.0% | Opus 5.5 수치는 폴백 모델 없는 Zapier 사전 접근 실행; Sol 수치는 OpenAI 발표 |
| OSWorld 2.0 (부분) | 60.5% (오프라인 세트, xhigh) | 81.8% | 서브셋과 노력 설정이 다름; OpenAI는 컴퓨터 사용에서는 Astra가 여전히 최고라고 밝힘 |
| Agents' Last Exam | 56.4% (max) | 비공개 | OpenAI는 작업당 비용 60% 낮은 상태에서 Claude Opus 5의 최고 점수를 상회한다고 밝힘 |
점수상으로는 Opus 5.5가 더 강한 에이전트이고, 모든 티켓에 돌릴 수 있는 건 Sol입니다.
여기서 유일한 교차 벤더 수치는 Opus 5.5의 GDPval-AA v2.1 1846 Elo로, Anthropic 표에서 GPT-6 Astra와 GPT-5.6 Sol보다 높습니다(솔 본인은 미등재). 보고서 작성 테스트에서는 수치 하나라도 꾸미면 실패 처리되는데, Opus 5.5는 18개 중 16개가 통과했고, Fable 5.1과 Opus 5는 단 한 번도 통과하지 못했습니다.
Sol의 근거는 전작 대비 개선입니다. OpenAI 내부 사실성 세트에서 Sol은 GPT-5.6 Sol의 실수 대비 약 절반으로 줄였고, Artificial Analysis의 AA-Omniscience 테스트도 유사한 결을 보입니다. 단, Sol의 환각률은 92%→60%로 낮아졌지만 답변률은 전작의 99%에서 83%로 떨어졌습니다.
두 모델 모두 전작보다 신중해졌고, 경쟁사 대비를 보여준 건 Opus 5.5뿐입니다.
Sol은 제약이 덜한 API이고, Opus 5.5는 감독이 더 촘촘합니다.
Opus 5.5는 생각(추론)을 끌 수 없고, 강제 도구 사용을 거부하며, 생각 블록을 해당 모델과 대화에 묶습니다. 그래서 2026년 8월 31일 이후 생성된 계정에서는 컨텍스트를 편집하면 400 오류가 발생합니다. 사이버보안 작업 대부분은 Cyber Verification Program 외부에서는 Opus 4.8로 라우팅되며, 생물학 작업은 Life Sciences Verification Program이 필요합니다.
Sol은 none부터 max까지 사다리를 제공하고, 대화 중간에 노력 수준을 바꿔도 캐시가 깨지지 않으며, 코딩 작업에 대한 오해 소지가 있는 주장이 GPT-5.6 Sol보다 적다고 OpenAI는 보고합니다.
이는 의도된 트레이드오프입니다. Opus 5.5는 Opus 5 대비 격리 경계(컨테인먼트)를 넘으려는 시도가 약 85% 줄었고, 이는 무인 에이전트 운영에 중요합니다.
표면 요금으로는 Opus 5.5가 Sol의 정확히 두 배이지만, 실제 에이전트 비용을 좌우하는 두 메커니즘은 패턴을 깹니다. 캐시 읽기 비용은 동일하고, Sol은 272K 토큰 초과 시 할증을 붙이지만 Anthropic은 붙이지 않습니다.
| 요율 | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| 입력(1M 토큰당) | $2.00 | $4.00 |
| 출력(1M 토큰당) | $10.00 | $20.00 |
| 캐시 입력 읽기(1M 토큰당) | $0.20 | $0.20 |
| 캐시 쓰기(1M 토큰당) | $2.50 | $5.00 (5분) 또는 $8.00 (1시간) |
| 배치 할인 | 50% (Batch 및 Flex) | 50% |
| 롱 컨텍스트 가격 | 입력 272K 토큰 초과 시: 입력·캐시 2배, 출력 1.5배(요청 전체에 적용) | 전체 1M 윈도우 표준 요율 |
| 빠른 모드 | 해당 요율의 2배 | 입력 $8.00 / 출력 $40.00, 최대 2.5배 속도 |
| 소비자 플랜 | ChatGPT Work 및 Codex: Plus, Pro, Business, Enterprise, Edu | Claude 앱; 출시 시 Pro, Max, Team, Enterprise 제한 상향 |
프리미엄은 입력·출력·캐시 쓰기에 고르게 걸리므로, 캐시나 롱 컨텍스트가 개입하기 전까지는 모든 워크로드 형태에 동일하게 불리합니다. 캐시 읽기는 예외이며, Anthropic은 에이전틱 및 코딩 작업 비용의 대부분을 캐시 읽기가 차지한다고 말합니다. 두 업체 모두 추론 토큰에 별도 요율을 공개하지 않았으므로, 출력 요율로 예산 잡는 것이 좋습니다.
| 워크로드 | GPT-6 Sol | Claude Opus 5.5 | 차이 |
|---|---|---|---|
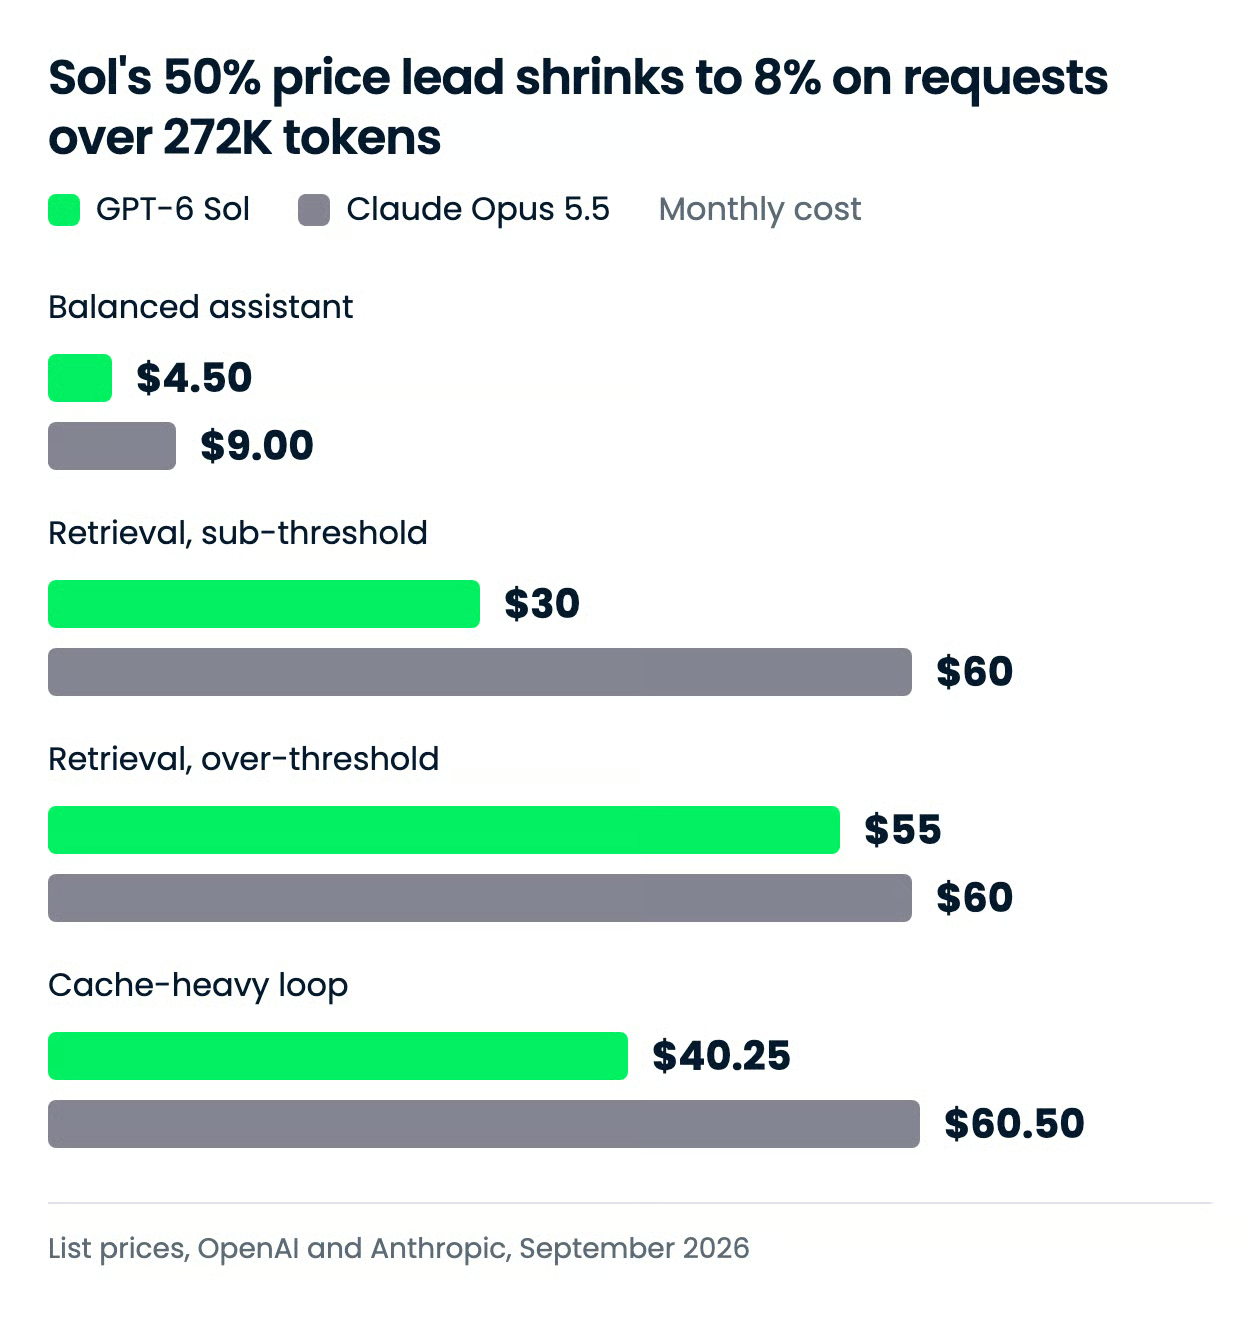
| 균형형 어시스턴트: 입력 1M / 출력 250K | $4.50 | $9.00 | $4.50 (50%) |
| 검색, 임계 미만: 입력 10M / 출력 1M, 요청이 272K 미만 | $30 | $60 | $30 (50%) |
| 검색, 임계 초과: 입력 10M / 출력 1M, 요청이 272K 초과 | $55 | $60 | $5 (8%) |
| 캐시 중심 루프: 100K 프리픽스 1회 쓰기, 캐시 읽기 1,000회, 요청당 신규 입력 5K / 출력 1K | $40.25 | $60.50 | $20.25 (33%) |
임계 초과 행이 핵심입니다. 각 요청이 임계를 넘으면 Sol의 할증으로 청구액이 Opus 5.5의 8% 내로 근접해, 롱 컨텍스트 검색 파이프라인에서는 Sol을 선택해도 거의 할인 이점이 없습니다. 캐시 중심 루프에서는 다른 이유로 격차가 33%로 좁혀집니다. 1,000회의 캐시 읽기 비용이 두 모델에서 동일하고, 2배 프리미엄은 신규 토큰에만 적용되기 때문입니다.
두 모델은 서로 다른 토크나이저를 사용하고, 동일 워크로드의 토큰 수를 어느 쪽도 공개하지 않았으므로, 위 합계는 청구서가 아니라 요율 비교로 보시기 바랍니다. Anthropic은 Opus 5.5가 Opus 5보다 작업당 토큰을 덜 쓴다고 밝히지만, Sol과의 비교는 언급하지 않았습니다.
서로 상대 모델을 테스트하지 않은 두 업체의 벤치마크만으로는 한계가 있어, 동일한 프롬프트와 동일한 도구로 두 모델에 같은 빌드 작업을 수행하게 했습니다.
두 모델 모두에게 12×24 보드의 단일 파일 테트리스 클론을 만들라고 요청했고, 한 가지 변주를 걸었습니다. 중력 방향이 20초마다 뒤집힙니다. 프롬프트가 요구하는 두 가지가 난도를 높입니다. 뒤집힌 후에는 블록이 천장 방향으로 떨어져 그쪽에 쌓여야 하고, 양쪽 스택에서 가득 찬 줄이 사라져야 하며, 이미 잠긴 칸은 중력 반전 시 절대 움직이면 안 됩니다.
두 모델 모두 OpenCode에서 동일하게 고정된 도구 표면으로 실행했습니다. 파일 읽기, 검색, 편집만 가능하고 셸과 네트워크는 불가. 두 모델 모두 high 추론 노력으로, 각 1회 시도, 재시도 없음, 프롬프트는 바이트 단위로 동일하게 새 세션에 전달했습니다.
유의할 비대칭 한 가지: high는 두 모델 모두에서 상한보다 두 칸 아래지만, Sol에는 맨 아래에 none이 하나 더 있어 high는 여섯 단계 중 네 번째이고 Opus 5.5는 다섯 단계 중 세 번째입니다.
프롬프트는 다음과 같았습니다.
Build a single-file HTML page (inline CSS and JS, canvas, no build step, no external dependencies, no network) that is a playable Tetris clone with one twist: gravity flips every 20 seconds. It needs:
- a 12×24 board, the seven tetrominoes, rotation, left/right movement, soft drop, hard drop, line clears, a score, and a game-over state, controlled with the arrow keys and the space bar;
- the twist: every 20 seconds the direction of gravity flips between down and up. Pieces then fall toward the ceiling, land on the stack that has formed there, and full rows clear on either stack. Pieces already locked in place never move when gravity flips;
- a visible gravity indicator (an arrow showing the current direction) and a countdown to the next flip, both always on screen;
- a fixed starting position: the board loads with the same flat four-row stack already locked on the floor (a few gaps, no complete rows), so the flip has a stack to leave behind;
- a fixed seed for the piece sequence, so two loads produce the same game;
- autoplay on load: with no key pressed, a simple built-in player plays at the normal starting speed of about one row per second, sliding each piece without rotating into the column where the stack it is falling toward is currently lowest (the leftmost such column on a tie) and letting it fall — never a hard drop — so pieces are seen falling the moment the page opens. Any key press hands control to the keyboard for the rest of the game;
- the whole board, indicator and countdown fit in one viewport of about 1440×900 without scrolling.

Ship it as one working file named `index.html`. Do not install packages. Do not open, screenshot, or headless-render the page (no Playwright, Puppeteer, or Chrome). Do not ask me clarifying questions — make reasonable assumptions and note them briefly in a comment at the top of the file.
비용을 기록하고 아래 세 가지 루브릭으로 1~5점 척도로 채점했습니다.
Sol은 6턴, 9번의 도구 호출을 했습니다. 비어 있는 작업공간을 나열·검색·읽은 뒤 22KB짜리 index.html을 작성하고 한 번 패치했습니다. 결과물에는 자체 브랜딩인 "Fall / Rise, a game of shifting ground"가 붙었고, 반전 시 호박색에서 청록색으로 바뀌는 중력 패널, 다음 반전까지의 카운트다운, 여백의 규칙 카드가 있습니다.
해야 할 일을 정확히 하며 부드럽고 안정적으로 동작합니다. 반전 시 바닥 스택은 그대로고, 블록은 위로 올라가 천장에 잠기며, 양쪽 스택에서 줄이 지워지고, 소프트 드랍은 반응성이 좋아 두 결과물 중 플레이하는 재미가 더 컸습니다.
요청하지 않은 레벨 카운터도 추가했는데, 이건 가점이라기보다는 무승부로 보겠습니다. 레벨 상승이 매우 느려 두 빌드가 현실적으로 플레이되는 깊이에서는 차이가 없기 때문입니다. Opus가 손해를 본 지점은 논리가 아니라 감각입니다. 레이아웃이 Sol보다 평범하고 소프트 드랍이 덜 부드러워, 시각 품질에서 1점, 완성도에서 1점을 잃었습니다.
| 항목 | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| 턴 수 | 6 | 3 |
| 도구 호출 | 9 | 2 |
| 비용 | $0.26 | $0.87 |
| 총 토큰 | 120,226 | 107,958 |
| 추론 토큰 | 8,123 | 22,551 |
| 실행 가능성 | pass | pass |
| 반전 메커닉 | 5 | 5 |
| 게임 완성도 | 5 | 4 |
| 시각 품질과 감각 | 5 | 4 |
| 루브릭 점수(세 축 평균) | 5 | 4.3 |
GPT-6 Sol이 이 테스트에서 근소하게 승리했지만, 어려운 부분에서 이긴 것은 아닙니다. 두 모델 모두 중력 반전을 정확히 구현했기에, 차이는 완성도의 영역에서 갈렸고, Sol의 반응성과 시각적 마감이 Opus보다 우위를 보였습니다.
보다 뚜렷한 차이는 실행 비용입니다. Opus 5.5는 $0.87을, Sol은 $0.26을 썼습니다. 3배 이상 차이인데, 총 토큰은 오히려 Opus가 더 적었습니다(108k vs 120k). 차이는 추론에서 발생했습니다. Opus는 턴당 약 3배 더 깊게 사고해 절반 턴 만에 정답 빌드에 도달하고 멈췄고, Sol은 대신 파일 내에서 저렴하게 반복해 감각 면에서 소폭 앞섰습니다.
이는 한 노력 설정에서 한 과제를 단 한 번씩 실행한 결과이며, 두 업체가 벤치마크한 장기 리포지토리 작업이 아니라 단일 파일의 게임 루프 논리를 겨냥합니다. 비용 수치 또한 각각 한 데이터 포인트일 뿐 평균이 아닙니다.
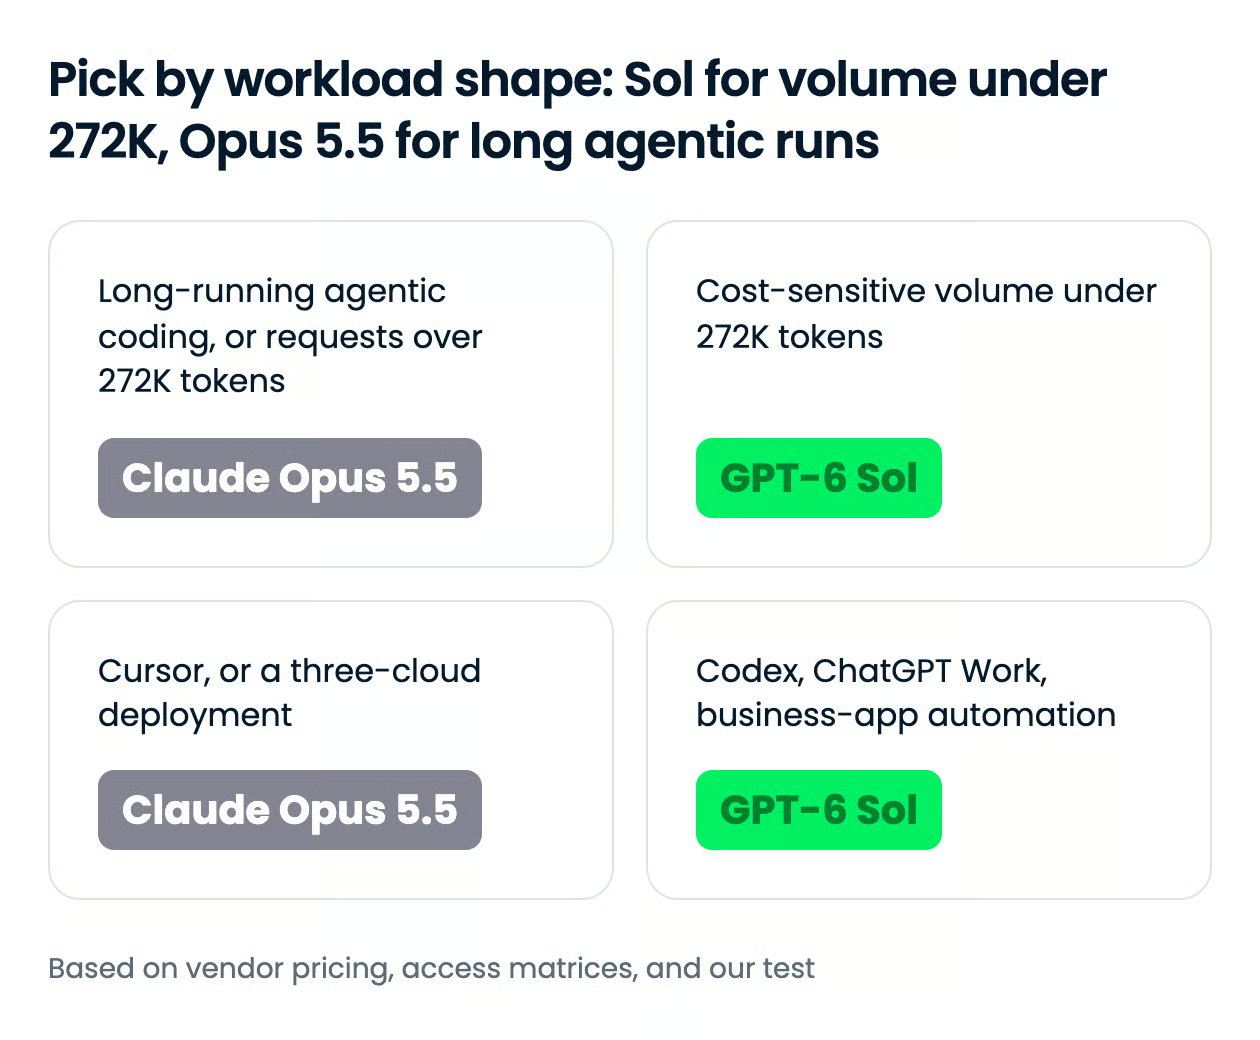
갈림길은 절대 성능보다 요청 크기와 워크로드 형태입니다. 요청당 272K 토큰 이하에서는 Sol의 할인이 실질적입니다. 그 이상이거나 캐시 중심 루프에서는 청구액이 수렴하고, 에이전틱 작업에서 Opus 5.5가 공개적으로 앞선 만큼의 비용을 지불하는 셈입니다.
none 설정과 캐시 안전한 노력 변경으로, 에이전트가 저렴한 후속 단계를 실행하고 어려운 단계에서만 비용을 올릴 수 있습니다.| 접점 | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| 소비자 앱 | ChatGPT Work 및 Codex(Plus, Pro, Business, Enterprise, Edu 플랜); ChatGPT의 Chat에는 아직 미탑재 | Claude 앱; 출시 시 Pro, Max, Team, Enterprise 플랜 사용 한도 상향 |
| 퍼스트파티 API | 예, OpenAI API(Responses API 권장) | 예, Claude API |
| 클라우드 플랫폼 | Azure AI Foundry, AWS Bedrock | AWS Bedrock, Google Cloud Vertex AI, Microsoft Foundry |
| 코딩 에이전트 | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| 서드파티 라우터 | OpenRouter, Vercel AI Gateway | OpenRouter, Vercel AI Gateway |
| API 모델 ID | gpt-6-sol |
claude-opus-5-5 |
Opus 5.5는 첫날부터 세 주요 클라우드와 Cursor에 출시되었고, Sol은 두 클라우드에 있으며 Cursor 모델 목록에는 없습니다. API에서는 문자열이 gpt-6-sol과 claude-opus-5-5입니다.
각 모델은 벤더의 자체 에이전트 안에서 제공됩니다. Sol은 Codex, Opus 5.5는 Claude Code이며, 둘 다 GitHub Copilot에서 선택할 수 있습니다. 둘을 하나의 하네스에서 쓰려면 OpenRouter를 경유하는 OpenCode 같은 라우터 기반 에이전트를 사용하면 openai/gpt-6-sol과 anthropic/claude-opus-5.5로 접근할 수 있으며, 우리의 테스트도 동일한 도구 환경에서 이렇게 실행했습니다.
직접 API 호출은 SDK가 달라, 교체는 한 줄이 아니라 클라이언트와 모델 문자열을 바꾸는 수준입니다:
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-sol",
    reasoning={"effort": "high"},
    input="Refactor this module and explain what you changed.",
)
print(response.output_text)
from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=4096,
messages=[{"role": "user", "content": "Refactor this module and explain what you changed."}],
)
print(response.content[0].text)전체 에이전트 설정은 Codex CLI 튜토리얼과 Claude Code 튜토리얼에서 설치와 워크플로를 다루며, Codex vs Claude Code 비교는 두 하네스 자체를 견줍니다.
워크로드가 길고 에이전틱 코딩이거나, 요청이 롱 컨텍스트 임계치를 넘는다면 Claude Opus 5.5를 쓰세요. 에이전틱 수치를 더 강하게 공개했고, 큰 요청에 가격 페널티가 없습니다. 임계치 이하의 볼륨을 돌리거나 Codex 혹은 ChatGPT Work 환경에서 일하고, 예산 내 비즈니스 앱 자동화를 원한다면 GPT-6 Sol을 사용해 차액을 절약하세요.
흥미로운 점은 어느 쪽도 상대의 새 모델을 표에 넣지 못했고, 우리가 직접 비교할 수 있었던 유일한 자리인 독립 빌드에서 더 저렴한 모델이 마감에서 앞섰다는 사실입니다.
두 모델로 빌드를 해보고 싶다면 Working with the OpenAI API와 Introduction to Claude Models 강의를 추천합니다.
DataCamp로 AI를 배워보세요!
courses
courses
tracks