Courses
使用 OpenAI API
3小时
175.5K
本文将使用 GPT-6 Sol 将一个虚构的小型 Python 结账服务 Northstar Checkout,从本地的 v1 支付适配器迁移到 v2。
更具体地,我们将讲解如何:
发出首个 GPT-6 Sol API 调用并读取其用量字段
在模型查看代码库之前定义迁移契约
为 GPT-6 Sol 提供受限的文件与测试工具,并用 allowed_tools 分阶段开放访问
使用 GPT-6 Luna 进行分诊,并让 GPT-6 Sol 验证候选清单
返回结构化的迁移计划,并与 GPT-6 Sol 已读取的文件进行核对
通过 WebSocket 运行迁移,并在开始编辑后进行引导
在独立部署探针失败后提升推理投入强度
根据 API 用量计算记录的成本
有四点发现改变了我下一版的构建方式:
GPT-6 Sol 是 OpenAI GPT-6 家族的中档型号,其 API 模型 ID 为 gpt-6-sol。我们的 GPT-6 模型分层指南涵盖了发布与基准。OpenAI 的 GPT-6 指南将 GPT-6 Astra 置于首位,GPT-6 Sol 居中,GPT-6 Luna 成本最低。
GPT-6 Sol 拥有 1,050,000 个 token 的上下文窗口,最多返回 128,000 个输出 token。推理投入强度从 none 到 max,默认 medium。Chat Completions 仅在 none 时支持 GPT-6 Sol 的函数调用,因此本文全部使用 Responses API。
定价与 API 支持共同决定了 harness 如何发送每次请求。
根据 OpenAI 的定价页面,对于不超过 272,000 个输入 token 的请求,GPT-6 Sol 的价格为每百万输入 token $2、每百万输出 token $10。缓存命中输入为每百万 $0.20,缓存写入为 $2.50。相同四类下,GPT-6 Luna 分别为 $0.10、$0.01、$0.125 和 $0.50。
超过 272,000 个输入 token 后,整条请求按输入与缓存费率的 2 倍、输出费率的 1.5 倍计费。本项目没有任何请求接近该上限。
harness(即包裹模型的 Python 代码)使用了以下 GPT-6 控制项:
中途引导(Mid-turn steering) 在响应运行中更新其行为
configuration_update 在不重写缓存前缀的情况下更改推理投入强度
allowed_tools 为一次请求设置可调用工具的子集
结构化输出(Structured Outputs) 设定计划与报告的字段
这四项控制都保持在同一条 Responses API 响应链内。
我们将构建一个代理,将 Northstar Checkout 从 Payments Adapter v1 迁移到 v2。两个适配器都是我为本实验编写的本地替代品,并非真实的支付 SDK。完整代码、夹具与录制运行位于该 GitHub 仓库。
该仓库将支付相关代码与无关模块混在一起,因此 GPT-6 Sol 需要自行定位受影响的文件。v2 打破了四项适配器契约:
支付创建从 client.charge(...) 变为 client.payments.create(...)
结果字典变为带有 Money 金额的类型化对象
拒付卡返回状态而非抛出异常
Webhook 的名称、信封与签名请求头发生变化
搜索替换可处理方法重命名,但对行为变化无能为力。
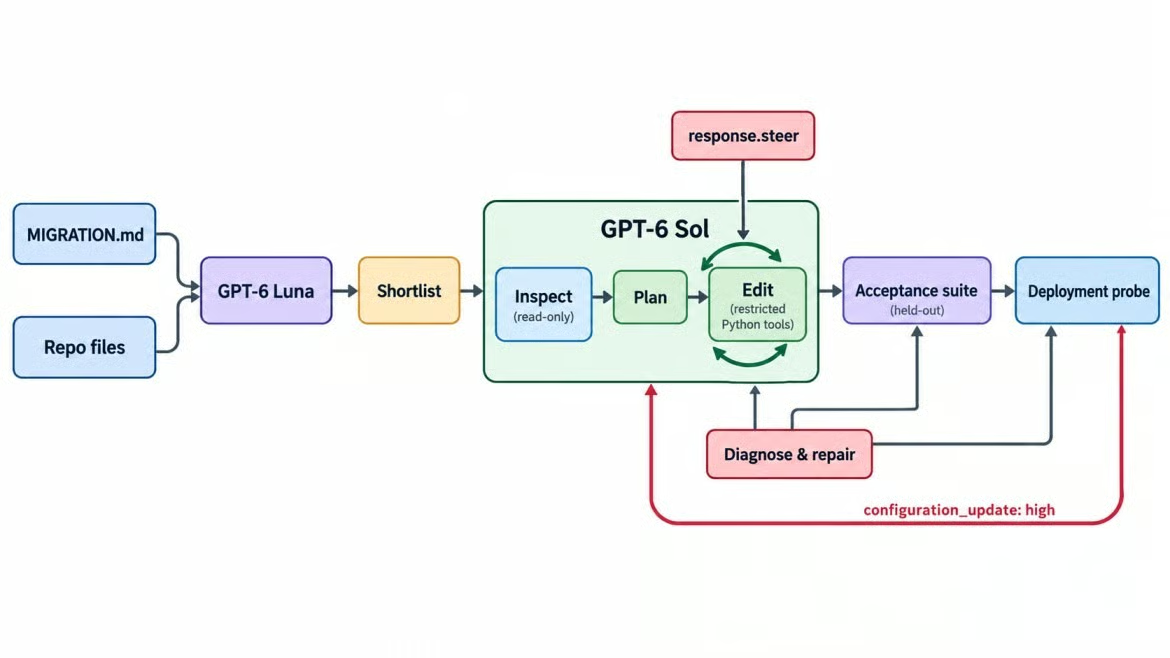
一次迁移循环,两个 GPT-6 模型。图片作者自制。
GPT-6 Sol 获得规范、文件树以及将分阶段开放的受限工具。它并不知道哪些文件需要修改,也不知道需求会发生变化。
规范中有两处陷阱。二者都不是故意埋下的 bug,而是 v2 行为与既有代码相遇时自然产生的:
幂等性。 当 v2 看到重复的 request_id 时会比较参数,但结账在每次尝试时都会在 metadata 中放入一个新的 order_id,因此朴素的重试会被拒绝而不是被去重。
退款总额。 v2 的 payment.refunded webhook 报告迄今为止的累计退款,而旧的处理器用 += 逐次累加。
它们都能通过类型检查。只有端到端运行结账与退款,才能抓住这些问题。
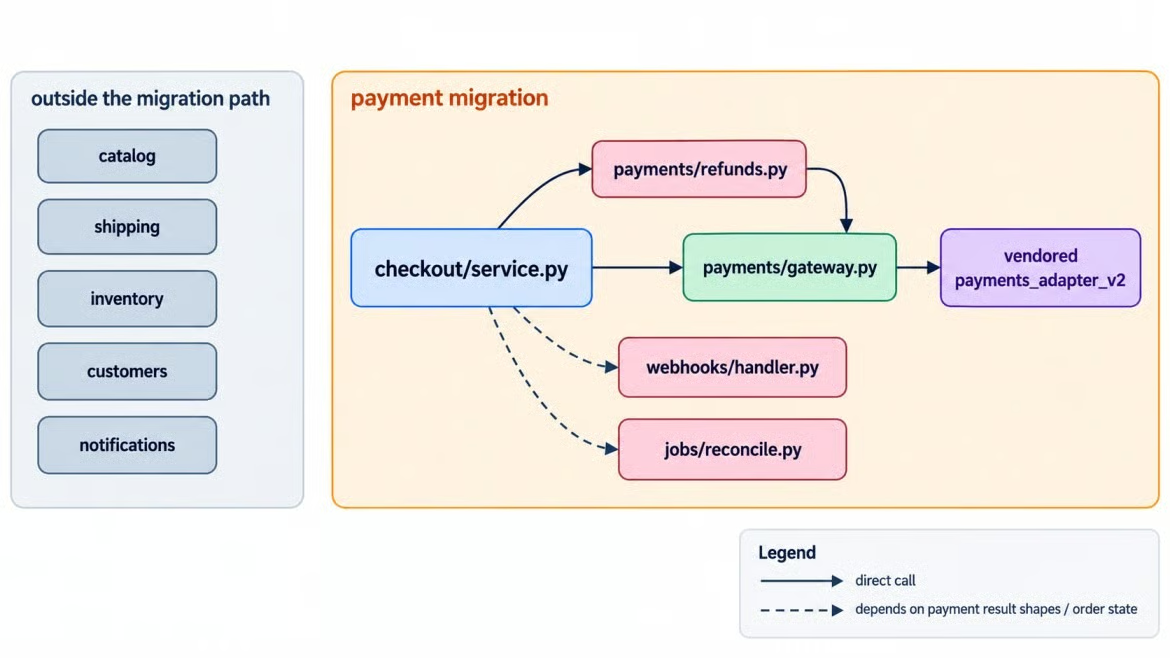
支付变更跨越多个 Northstar 模块。图片作者自制。
该图将直接导入适配器的模块与依赖支付行为的模块区分开来。正是这些间接关联,使得需要一份覆盖整个仓库的答案清单。
一个在任何模型调用之前编写、对模型隐藏的验收套件决定最终结果。GPT-6 Sol 从未见过它;harness 使用 pytest 对迁移后的副本运行。它检查:
结账可通过 v2 成功完成,且使用同一幂等键的重试仅扣款一次
拒付卡仍会抛出公共的 CheckoutDeclined 错误
全额退款、两次部分退款,以及重复投递的 webhook,均应留下正确的累计值
CheckoutClient 方法签名不变
不再残留 v1 引用,vendor/ 与 MIGRATION.md 未被触碰,可见测试全部通过
原始代码已通过接口不变与受保护文件不变的检查;其余检查衡量迁移效果。单独的答案清单列出了所需变更,但只有 harness 会读取它。
目录 acceptance/ 与 probes/ 位于复制出的仓库之外,对两个模型均不可见。答案清单位于 acceptance/ 下,因此不会进入 GPT-6 Luna 的输入、文件树或任何仓库工具。
读取网关可返回来自 GPT-6 Sol 自身计划中的路径。答案清单的覆盖结果仅用于评估;它从不会将缺失的真实路径反馈给 GPT-6 Sol。
之后会运行部署探针。这两项检查都不会把模型的“完成”消息当作证据。
您需要 Python 3.10 或更高版本,以及一个可访问两种模型的 API 密钥。依赖项包含引导所需的 realtime 扩展:
git clone https://github.com/KhalidAbdelaty/gpt-6-sol-api.git
cd gpt-6-sol-api
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
在 macOS 或 Linux 上,使用 source .venv/bin/activate 与 cp .env.example .env,然后在 .env 中填入 OPENAI_API_KEY=...。
如果您的密钥已可用于 Responses API,可跳过下节。
最小的实用请求可确认密钥、模型 ID 与费用章节所需的用量字段:
from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()
client = OpenAI()
response = client.responses.create(
    model="gpt-6-sol",
    input="In one sentence, why is a breaking API migration harder than renaming a function?",
)
print(response.reasoning.effort, response.output_text)
print(response.usage)
响应会报告 medium 的投入强度,且 usage 包括 cached_tokens 与 cache_write_tokens。不要传 temperature 与 top_p。在投入强度不是 none 时,这两者都会返回 400。
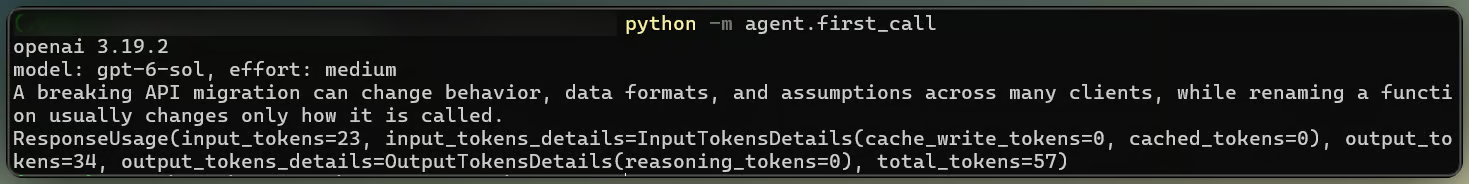
首个 GPT-6 Sol 请求返回用量信息。图片作者自制。
从默认的 medium 开始,并在整个运行期间将请求级别设置保持在该值。大多数迁移回合是读取与小改动。随后部署探针会提供提升投入强度的理由。
工具层决定代理的权限。GPT-6 Sol 在 strict: true 下获取以下函数工具:
list_files 与 search_code 定位相关代码
read_file 返回仓库中的单个文件
edit_file 修改一个精确匹配的出现位置
run_tests 执行允许的 pytest 目标
严格的 schema 检查参数形状,而非路径安全,因此由 Python 强制写入边界:
READ_ONLY = ("vendor/", "MIGRATION.md", "conftest.py")

if write:
    if rel_posix.startswith(READ_ONLY) or rel_posix in READ_ONLY:
        raise ToolError(f"{rel_posix} is read-only")  # the spec and both adapters
    if not rel_posix.startswith(("northstar/", "tests/")) or not rel_posix.endswith(".py"):
        raise ToolError("writes are limited to Python files under northstar/ and tests/")
路径会先被解析,因此 ../ 与绝对路径会失败。 edit_file 仅替换一个精确匹配,run_tests 只接受 tests/ 下的目标。
harness 会将被阻止的调用作为 ERROR: 工具输出返回,循环继续。我们的 代理 harness 工程指南 解释了为何这些检查应放在 harness,而非提示词里。
用必须被拒绝的输入调用每个工具:
包含 .. 的路径
绝对路径
在 vendor/ 下的写入
包含 shell 命令的测试目标
均不应放行。匹配多个位置的编辑应请求更多上下文,并将规则保存在自定义函数中,便于集中测试。
代码库分诊是一项窄范围的分类任务:评估每个文件的相关性并引用 v1 的参考。GPT-6 Luna 只负责这项任务,并首先运行,在 GPT-6 Sol 开始搜索之前。
class FileVerdict(BaseModel):
    path: str
    relevance: Literal["high", "medium", "low", "none"]
    legacy_references: list[str]

triage = client.responses.parse(model="gpt-6-luna", input=spec_and_all_files,
                                text_format=TriageResult)  # a list of FileVerdict
输入是规范加上 northstar/ 与 tests/ 下的所有 Python 文件。被评为 high 或 medium 的会进入下一步 GPT-6 Sol 接收的候选清单。
将候选清单与先前的答案清单对照,优先看召回。GPT-6 Luna 保留了每个受影响文件,并额外加入了少量无需修改的文件。
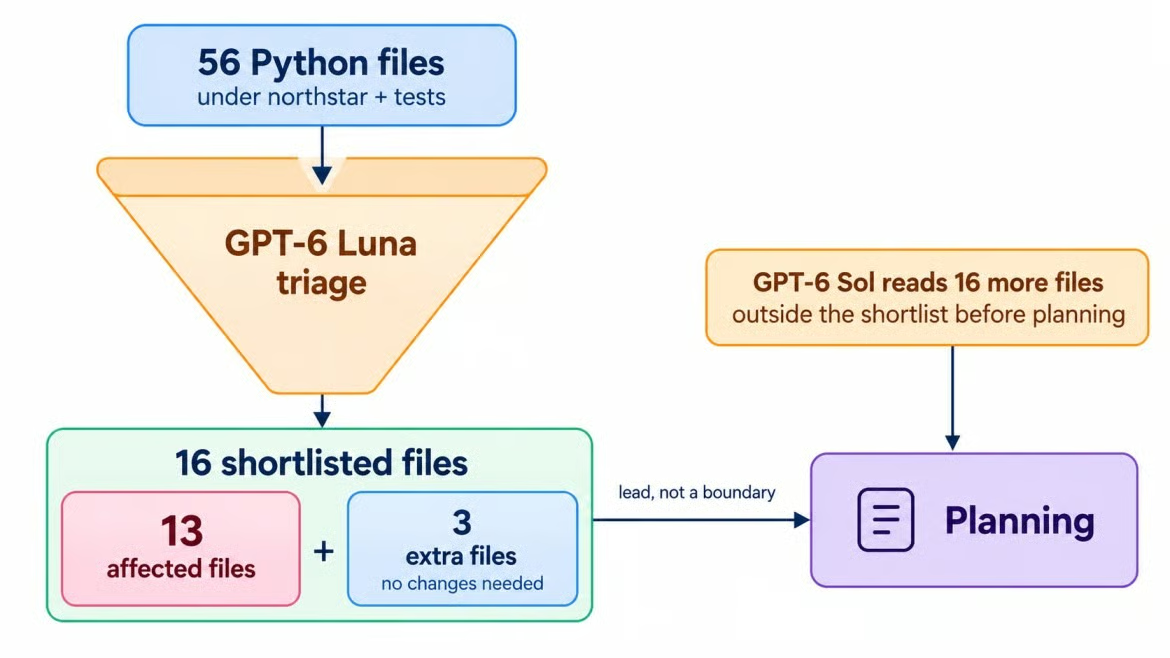
GPT-6 Luna 将 56 个缩至 16 个。图片作者自制。
候选清单是引导,不是边界。
allowed_tools 实现分阶段权限allowed_tools 是一种 tool_choice 模式,用于在完整工具列表保留的同时,限制模型可调用的工具。这使得 GPT-6 Sol 的首轮保持只读:每次请求都定义完整工具列表,但只有列举与搜索可被调用。
def allowed(names):
    return {"type": "allowed_tools", "mode": "auto",
            "tools": [{"type": "function", "name": n} for n in names]}

response = client.responses.create(
    model="gpt-6-sol", instructions=INSTRUCTIONS, tools=TOOLS,  # full list, every time
    tool_choice=allowed(["list_files", "search_code"]),
    reasoning={"effort": "medium"}, input=inspect_prompt, store=True,
)
在阶段之间变更 tools 会重写缓存前缀。 函数调用指南 建议在仅需更改可调用子集时使用 allowed_tools。
只读回合将诊断与行动分离。我们向 GPT-6 Sol 提供了 GPT-6 Luna 的候选清单,并明确提示其可能有误;它通过搜索 v1 导入、charge 调用与 webhook 名称,自行发现了所有受影响的文件。
它也越过了该清单,将订单模型、订单存储、序列化器与分账导出标注为下游依赖需检查。它们最终均无需变更,但唯有读过才能得出此结论。我会在任何会编辑文件的代理中保留 allowed_tools。
迁移计划让代理在获得写入权限前,先对具体文件作出承诺。规划阶段开放 read_file,并在关闭工具的情况下,经由结构化输出返回计划:
plan = client.responses.parse(
    model="gpt-6-sol", instructions=INSTRUCTIONS, tools=TOOLS, tool_choice="none",
    reasoning={"effort": "medium"}, previous_response_id=last_id,
    input=PLAN_REQUEST, text_format=MigrationPlan,  # files, evidence, risks
)
该计划覆盖了所有必要变更,并警告说重试时新的订单 ID 会改变 v2 的 metadata。这个警告后来又回到了视线中。
在授予写入权限之前,harness 会检查计划的结构、证据与覆盖面。
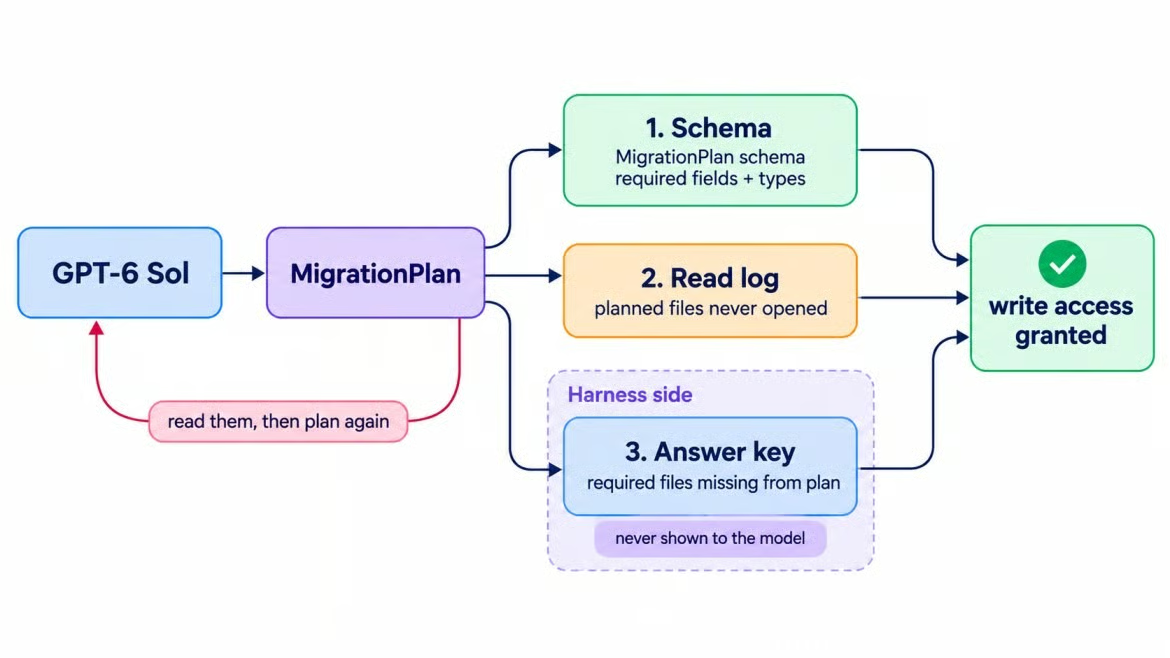
三项检查验证一份迁移计划。图片作者自制。
计划通过了每一道关卡。它还建议将公共的 client.py 参数重命名以匹配 v2 的命名,这与规范的清理章节建议一致。该建议成为引导测试。
GPT-6 Sol 编码代理采用工具循环:等待响应、执行其函数调用并返回输出。我们的 OpenAI Responses API 指南 解释了请求与工具结果的格式。本次迁移将循环保持在一条 WebSocket 连接 上,因为引导需要它。
with client.responses.connect() as conn:
    conn.response.create(**base, previous_response_id=plan_id, input=[start_message])
    for event in conn:
        if event.type == "response.incomplete":
            reason = getattr(event.response.incomplete_details, "reason", None)
            if reason == "steered":
                continue  # keep reading for the automatic successor
            raise RuntimeError(reason or "response incomplete")
        if event.type != "response.completed":
            continue
        calls = [i for i in event.response.output if i.type == "function_call"]
        if not calls:
            break  # GPT-6 Sol says it's done here; the held-out tests decide whether it is
        outputs = [{"type": "function_call_output", "call_id": c.call_id,
                    "output": tools.run(c.name, c.arguments)} for c in calls]
        conn.response.create(**base, previous_response_id=event.response.id,
                             input=outputs)
base 保持模型、指令、工具与 medium 投入强度固定,以便提示缓存。GPT-6 Sol 在工作过程中运行了可见测试,但它也编写了大多数新测试,因此这些测试无法作为独立校验。
中途引导在响应仍在运行时添加一条指令,无需取消它。发送 response.created 之后,您在同一连接上针对该响应的 ID 发送 response.steer,服务器会在后继响应中应用这条指令。
新需求来自前台团队: CheckoutClient 的签名“必须与今天保持完全一致”,因为有其他服务调用它。我不希望用定时器决定它何时到达,因此 harness 转而监听仓库。在每一批工具调用后,它将磁盘上的公共签名与原始版本对比,第一次出现差异就会武装引导:
if steer_state == "idle" and signature_changes(repo):  # CheckoutClient, compared with ast
    steer_state = "armed"

if event.type == "response.created" and steer_state == "armed":
    conn.response.steer(previous_response_id=event.response.id, input=STEER_TEXT)
    steer_state = "sent"
这确保引导在与其矛盾的重命名之后落地,也就是最值得测试的场景。若更早发送,它只是更长的提示词。
随后,服务器报告了引导的生命周期:
response.steer.accepted 表示更新已入队,尚未应用
response.incomplete 以 steered 原因结束原响应
后继的 response.created 载入了新需求继续执行
如果响应正等待工具结果,服务器会发送 response.steer.pending 并持有该引导,直到 harness 返回结果。在引导挂起时继续处理工具调用。
引导会改变模型接下来的行为。OpenAI 的指南非常直接:引导不会重写已发送的输出、撤销之前的操作,或取消已启动的工具。
当引导到达时,重命名已经落盘于 client.py。GPT-6 Sol 将其回滚,随后独立的签名检查确认了最终接口。
编辑可以回滚。若某工具已调用外部系统,则无从回滚,因此应在每次引导到达时记录代码库状态。
在这个仓库中可以,但不是一次完成。第一次迁移满足了原始契约,随后部署探针揭示了一个遗漏的情形。
当 GPT-6 Sol 报告迁移完成后,隐藏套件在无需修复回合的情况下通过。关于退款,GPT-6 Sol 将累加替换为按累计值读取,同时也忽略乱序到达的 webhook:
-        order.refunded_cents += data["amount_refunded"]
+        order.refunded_cents = max(order.refunded_cents, refunded["cents"])
关于幂等性,GPT-6 Sol 保持每次尝试都使用新的 order_id,并在订单存储中加入一个请求缓存,在请求到达 v2 之前就回复重复请求。该缓存位于进程内存中,这一点稍后会变得重要。
会。第一份报告将一个更新后的 webhook 测试称为回归,并遗漏了跨服务器重试的风险,尽管计划里已点出该陷阱。
结构化输出验证的是 schema,而非报告陈述。请将报告字段与记录的证据对照,不要把空的风险列表当作“无风险”的证明。
该套件漏掉了路由到另一应用实例的重试。我加入了一个部署探针,使用两个客户端共享一个支付处理器,但不共享各自的进程内存。
探针失败。第二个实例上的重试抛出了 payments_adapter_v2.IdempotencyConflict,这是前台不应见到的适配器异常。
只有多进程部署才能暴露这一失败,它触发了推理升级。
一条 configuration_update 输入项会更改下一条及后续每条响应的投入强度,直到另一次更新替换它。请求级别的投入强度保持不变,因此缓存前缀得以保留。当探针失败时,harness 按照 推理指南 发送了如下请求:
迁移请求使用了 store=True,因此在 WebSocket 关闭后,harness 仍可用常规 Responses API 请求延续已存储的响应链。
response = client.responses.create(
    model="gpt-6-sol", reasoning={"effort": "medium"},  # unchanged, so the prefix survives
    instructions=INSTRUCTIONS, tools=TOOLS, tool_choice=allowed(DIAGNOSE_TOOLS),
    previous_response_id=last_id,
    input=[{"type": "configuration_update", "reasoning": {"effort": "high"}},
           {"role": "user", "content": probe_failure + DIAGNOSE_FIRST}],
)
active_effort = "high"  # the harness records it; the response won't
GPT-6 Sol 会接收失败信息与部署形态,但不会获得任何修复提示。DIAGNOSE_TOOLS 只允许读取与测试,不允许编辑。保持工具与 text.format 不变可保留缓存前缀。
有个 API 细节较为恼人:在更新后,response.reasoning.effort 仍报告请求级别设置。harness 无法从响应中读到“当前生效”的投入强度,因此在发送更新时自行记录该值,并为后续每个响应打上标签。
high 投入强度下的修复是否奏效?奏效了。GPT-6 Sol 将失败追溯到第二台服务器的本地存储,然后顺着新的订单 ID 找到了支付 metadata。共享的处理器看到了同一 request_id 下不同的参数。
修复方案让订单 ID 成为 request_id 的函数,因此每台服务器都会计算出相同的订单 ID:
-def new_order_id() -> str:
+def new_order_id(request_id: str | None = None) -> str:
+    if request_id:
+        stable = uuid.uuid5(uuid.NAMESPACE_URL, f"northstar.checkout.order:{request_id}")
+        return f"ord_{stable.hex[:12]}"
     return f"ord_{uuid.uuid4().hex[:12]}"
GPT-6 Sol 还为该情形添加了一个可见测试。探针与验收套件均通过,随后用 configuration_update 将投入强度降回 medium。最终报告这次准确地描述了真实失败。
该项目的 Streamlit 应用会回放保存的运行,无需发起 API 调用。视频先展示总览,然后是引导事件,最后是验收与探针结果。
与 DataCamp 一起学习
Courses
Courses
Courses