
Courses
Làm việc với OpenAI API
3 giờ
175.5K
Ở đây, chúng ta sẽ dùng GPT-6 Sol để di trú Northstar Checkout, một dịch vụ checkout Python giả lập nhỏ, từ adapter thanh toán cục bộ v1 lên v2.
Cụ thể hơn, chúng ta sẽ đề cập cách:
Thực hiện cuộc gọi API GPT-6 Sol đầu tiên và đọc các trường usage của nó
Xác lập hợp đồng di trú trước khi mô hình xem kho mã
Cung cấp cho GPT-6 Sol các công cụ tệp và kiểm thử bị giới hạn, rồi tuần tự cấp quyền bằng allowed_tools
Dùng GPT-6 Luna để phân loại sơ bộ và yêu cầu GPT-6 Sol xác minh danh sách rút gọn
Trả về kế hoạch di trú có cấu trúc và kiểm tra nó đối chiếu với các tệp GPT-6 Sol đã đọc
Chạy di trú qua WebSocket và điều hướng giữa chừng sau khi bắt đầu chỉnh sửa
Tăng mức nỗ lực suy luận sau khi phép thử triển khai độc lập thất bại
Tính chi phí ghi nhận được từ usage của API
Bốn phát hiện sau đã thay đổi cách tôi sẽ xây phiên bản tiếp theo:
GPT-6 Sol là tầng giữa trong họ GPT-6 của OpenAI, và ID mô hình API là gpt-6-sol. Hướng dẫn về các tầng mô hình GPT-6 của chúng tôi bao quát thông tin ra mắt và benchmark. Hướng dẫn GPT-6 của OpenAI xếp GPT-6 Astra đầu tiên, GPT-6 Sol ở giữa, và GPT-6 Luna có chi phí thấp nhất.
GPT-6 Sol có cửa sổ ngữ cảnh 1.050.000 token và trả về tối đa 128.000 token đầu ra. Mức nỗ lực suy luận chạy từ none đến max và mặc định là medium. Chat Completions chỉ hỗ trợ function calling của GPT-6 Sol ở mức none, vì vậy mọi yêu cầu ở đây dùng Responses API.
Giá thành và hỗ trợ API quyết định cách khung (harness) gửi mỗi yêu cầu.
GPT-6 Sol có giá $2 cho mỗi triệu token đầu vào và $10 cho mỗi triệu token đầu ra đối với yêu cầu lên đến 272.000 token đầu vào, theo trang giá của OpenAI. Đầu vào dùng cache có giá $0,20 mỗi triệu, và ghi cache có giá $2,50. Mức giá tương ứng của GPT-6 Luna cho bốn hạng mục trên là $0,10, $0,01, $0,125 và $0,50.
Trên 272.000 token đầu vào, toàn bộ yêu cầu bị tính 2x cho đầu vào và cache, và 1,5x cho đầu ra. Không yêu cầu nào trong dự án này tiến gần ngưỡng đó.
Harness, tức là mã Python bao quanh mô hình, dùng các điều khiển GPT-6 sau:
Steering giữa lượt cập nhật một phản hồi khi nó đang chạy
configuration_update thay đổi mức nỗ lực suy luận mà không ghi đè tiền tố cache
allowed_tools đặt tập công cụ có thể gọi cho một yêu cầu
Structured Outputs thiết lập các trường trong kế hoạch và báo cáo
Cả bốn điều khiển đều nằm trong cùng một chuỗi phản hồi của Responses API.
Chúng ta sẽ xây một agent chuyển Northstar Checkout từ Payments Adapter v1 sang v2. Cả hai adapter đều là bản thay thế cục bộ tôi viết cho thí nghiệm này, không phải SDK thanh toán thật. Toàn bộ mã, fixture, và bản chạy đã ghi được nằm trong kho GitHub này.
Kho trộn lẫn mã thanh toán với các module không liên quan, nên GPT-6 Sol phải tự tìm các tệp bị ảnh hưởng. V2 phá vỡ bốn hợp đồng adapter:
Tạo thanh toán chuyển từ client.charge(...) sang client.payments.create(...)
Các dict kết quả trở thành đối tượng có kiểu với số tiền dạng Money
Thẻ bị từ chối trả về một trạng thái thay vì ném ngoại lệ
Webhook thay đổi tên, bao gói và header chữ ký
Tìm-và-thay thế xử lý được việc đổi tên phương thức. Nó không xử lý được bất kỳ thay đổi hành vi nào.
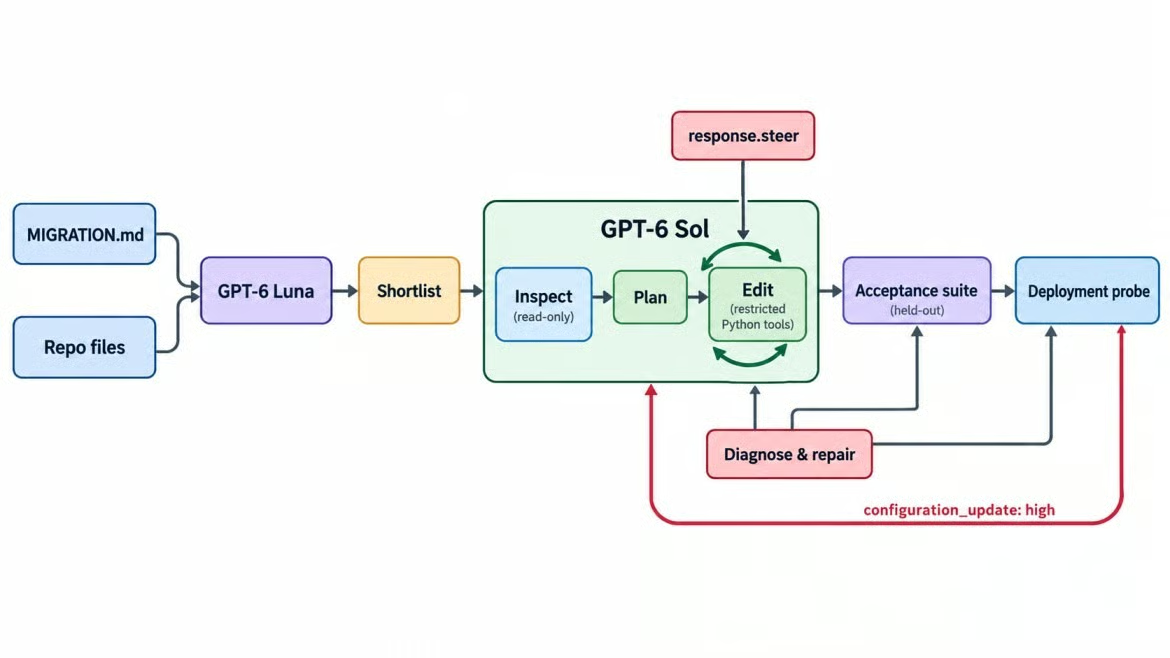
Một vòng lặp di trú, hai mô hình GPT-6. Ảnh: Tác giả.
GPT-6 Sol nhận đặc tả, cây tệp và các công cụ bị hạn chế sẽ được cho phép theo giai đoạn. Nó không biết tệp nào cần thay đổi hoặc rằng yêu cầu sẽ thay đổi.
Hai phần của đặc tả là cái bẫy. Không phải lỗi cài cắm; cả hai xuất phát từ hành vi v2 gặp mã hiện có:
Idempotency. v2 so sánh tham số khi gặp request_id lặp lại, nhưng checkout đặt một order_id mới trong metadata ở mỗi lần thử, nên một lần thử lại ngây thơ sẽ bị từ chối thay vì được khử trùng lặp.
Tổng hoàn tiền. Webhook payment.refunded của v2 báo cáo tổng số đã hoàn tính đến hiện tại, trong khi handler cũ cộng dồn từng giá trị bằng +=.
Cả hai đều vượt qua kiểm tra kiểu. Bạn chỉ bắt được chúng bằng cách chạy checkout và hoàn tiền từ đầu đến cuối.
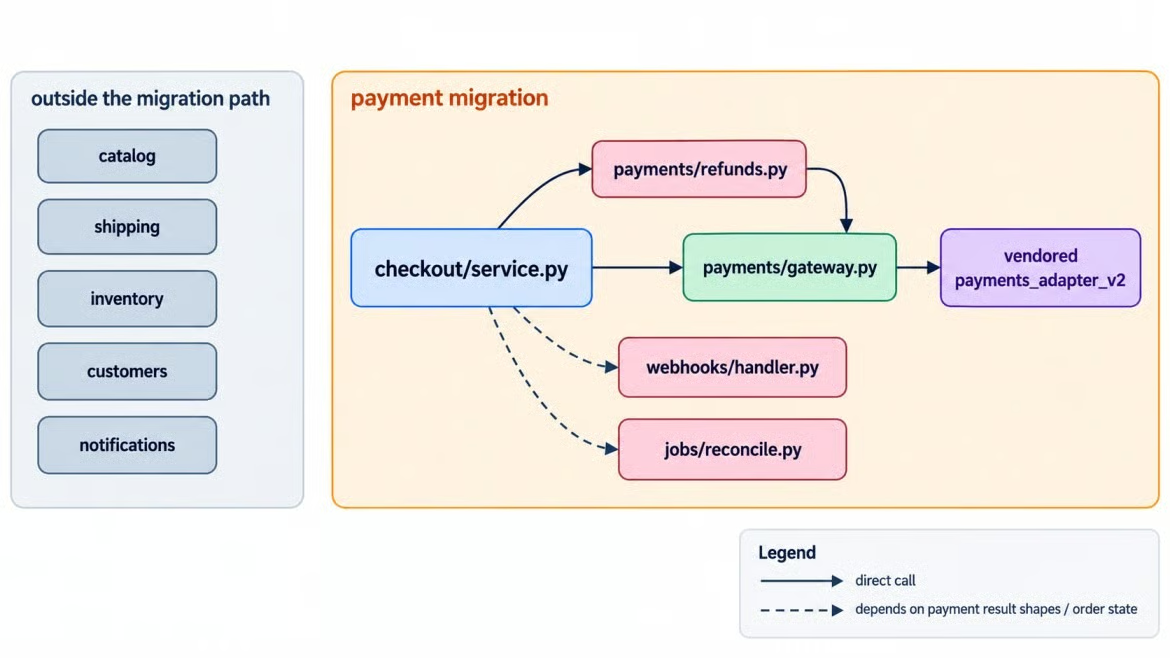
Thay đổi thanh toán đi qua nhiều module của Northstar. Ảnh: Tác giả.
Bản đồ tách các import trực tiếp adapter khỏi các module phụ thuộc vào hành vi thanh toán. Những liên kết gián tiếp đó là lý do một đáp án chuẩn cho toàn bộ kho có ý nghĩa.
Một bộ acceptance giữ lại, được viết trước bất kỳ cuộc gọi mô hình nào, sẽ quyết định kết quả. GPT-6 Sol không bao giờ thấy nó; harness chạy nó bằng pytest trên bản sao đã di trú. Nó kiểm tra rằng:
Checkout thành công qua v2, và thử lại với cùng idempotency key chỉ bị tính phí một lần
Thẻ bị từ chối vẫn ném lỗi public CheckoutDeclined
Một lần hoàn toàn bộ, hai lần hoàn một phần, và một webhook gửi lại đều để lại tổng chính xác
CheckoutClient giữ nguyên chữ ký phương thức
Không còn tham chiếu v1, vendor/ và MIGRATION.md không bị đụng tới, và các kiểm thử hiển thị đều vượt
Mã gốc đã vượt qua các kiểm tra về giao diện không đổi và tệp được bảo vệ; các kiểm tra còn lại đo lường việc di trú. Một đáp án chuẩn riêng liệt kê các thay đổi cần thiết, nhưng chỉ harness đọc nó.
Thư mục acceptance/ và probes/ nằm ngoài bản sao kho được lộ cho cả hai mô hình. Đáp án chuẩn nằm trong acceptance/, nên nó không thể vào đầu vào của GPT-6 Luna, cây tệp, hay bất kỳ công cụ kho nào.
Cổng đọc có thể trả về các đường dẫn từ chính kế hoạch của GPT-6 Sol. Kết quả bao phủ theo đáp án chuẩn chỉ được ghi cho mục đích đánh giá; nó không bao giờ gửi các đường dẫn ground-truth còn thiếu về cho GPT-6 Sol.
Một phép thử triển khai chạy sau bộ đó. Không kiểm tra nào chấp nhận thông điệp “đã xong” của mô hình làm bằng chứng.
Bạn cần Python 3.10 trở lên và một API key có quyền truy cập cả hai mô hình. Yêu cầu bao gồm thêm realtime mà steering cần:
git clone https://github.com/KhalidAbdelaty/gpt-6-sol-api.git
cd gpt-6-sol-api
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
Trên macOS hoặc Linux, dùng source .venv/bin/activate và cp .env.example .env, sau đó đặt OPENAI_API_KEY=... trong .env.
Nếu key của bạn đã hoạt động với Responses API, hãy bỏ qua tiểu mục tiếp theo.
Yêu cầu nhỏ nhất có ích xác nhận key, ID mô hình, và các trường usage mà phần tính chi phí cần:
from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()
client = OpenAI()
response = client.responses.create(
    model="gpt-6-sol",
    input="In one sentence, why is a breaking API migration harder than renaming a function?",
)
print(response.reasoning.effort, response.output_text)
print(response.usage)
Phản hồi báo cáo mức nỗ lực medium, và usage bao gồm cached_tokens và cache_write_tokens. Bỏ qua temperature và top_p. Cả hai trả 400 bất cứ khi nào nỗ lực không phải none.
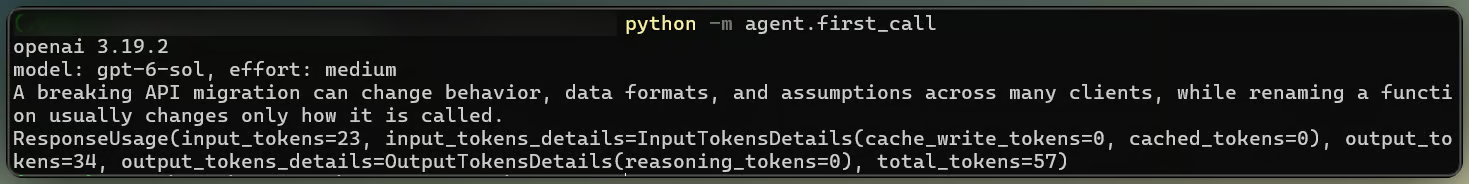
Yêu cầu GPT-6 Sol đầu tiên trả về usage. Ảnh: Tác giả.
Bắt đầu ở medium, mức mặc định, và giữ thiết lập ở cấp yêu cầu đó cho toàn bộ phiên. Hầu hết các lượt di trú là đọc và chỉnh sửa nhỏ. Sau này phép thử triển khai sẽ cung cấp lý do để tăng nỗ lực.
Lớp công cụ sở hữu quyền của agent. GPT-6 Sol nhận các công cụ hàm này với strict: true:
list_files và search_code tìm mã liên quan
read_file trả về một tệp trong kho
edit_file thay đổi đúng một vị trí khớp
run_tests thực thi mục tiêu pytest được cho phép
Schema nghiêm ngặt kiểm tra hình dạng tham số, không phải an toàn đường dẫn, nên Python áp đặt ranh giới ghi:
READ_ONLY = ("vendor/", "MIGRATION.md", "conftest.py")

if write:
    if rel_posix.startswith(READ_ONLY) or rel_posix in READ_ONLY:
        raise ToolError(f"{rel_posix} is read-only")  # the spec and both adapters
    if not rel_posix.startswith(("northstar/", "tests/")) or not rel_posix.endswith(".py"):
        raise ToolError("writes are limited to Python files under northstar/ and tests/")
Đường dẫn được chuẩn hóa trước, nên ../ và đường dẫn tuyệt đối sẽ thất bại. edit_file thay thế một khớp chính xác, và run_tests chỉ chấp nhận mục tiêu dưới tests/.
Harness trả về một lệnh bị chặn dưới dạng đầu ra công cụ ERROR:, và vòng lặp tiếp tục. Hướng dẫn kỹ thuật harness cho agent của chúng tôi giải thích tại sao các kiểm tra này nên nằm trong harness thay vì prompt.
Gọi mỗi công cụ với một đầu vào mà nó bắt buộc phải từ chối:
Đường dẫn chứa ..
Đường dẫn tuyệt đối
Một thao tác ghi dưới vendor/
Mục tiêu kiểm thử chứa lệnh shell
Không trường hợp nào được phép lọt qua. Một chỉnh sửa khớp quá một vị trí nên yêu cầu thêm ngữ cảnh, và đưa quy tắc vào các hàm tùy biến đặt chúng tại một vị trí dễ kiểm thử.
Phân loại kho mã là một bài toán phân loại hẹp: chấm mức liên quan của mỗi tệp và trích dẫn các tham chiếu v1. GPT-6 Luna nhận đúng việc này và không gì khác, và nó chạy trước, trước khi GPT-6 Sol tìm kiếm bất cứ thứ gì.
class FileVerdict(BaseModel):
    path: str
    relevance: Literal["high", "medium", "low", "none"]
    legacy_references: list[str]

triage = client.responses.parse(model="gpt-6-luna", input=spec_and_all_files,
                                text_format=TriageResult)  # a list of FileVerdict
Đầu vào là đặc tả cộng với mọi tệp Python dưới northstar/ và tests/. Mọi thứ được chấm high hoặc medium sẽ vào danh sách rút gọn mà GPT-6 Sol nhận tiếp theo.
Đối chiếu danh sách rút gọn với đáp án chuẩn từ trước, và nhìn vào recall trước. GPT-6 Luna giữ lại mọi tệp bị ảnh hưởng và thêm vài tệp không cần thay đổi.
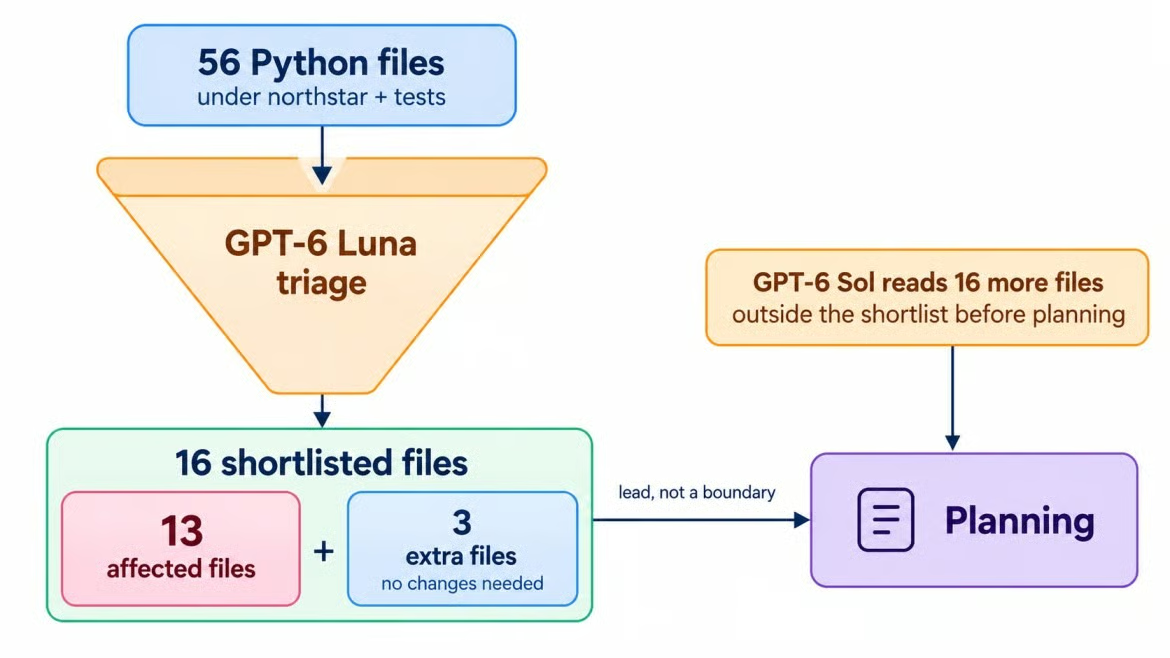
GPT-6 Luna rút từ 56 còn 16. Ảnh: Tác giả.
Danh sách rút gọn là manh mối, không phải biên giới.
allowed_tools cho quyền theo giai đoạnallowed_tools là một chế độ tool_choice giới hạn các công cụ mô hình có thể gọi trong khi danh sách đầy đủ vẫn tồn tại. Đó là cách lượt đầu của GPT-6 Sol giữ ở chế độ chỉ đọc: danh sách đầy đủ được định nghĩa ở mọi yêu cầu, nhưng chỉ liệt kê và tìm kiếm là được phép gọi.
def allowed(names):
    return {"type": "allowed_tools", "mode": "auto",
            "tools": [{"type": "function", "name": n} for n in names]}

response = client.responses.create(
    model="gpt-6-sol", instructions=INSTRUCTIONS, tools=TOOLS,  # full list, every time
    tool_choice=allowed(["list_files", "search_code"]),
    reasoning={"effort": "medium"}, input=inspect_prompt, store=True,
)
Thay đổi tools giữa các giai đoạn sẽ ghi lại tiền tố cache. Hướng dẫn function calling khuyến nghị dùng allowed_tools khi chỉ tập con có thể gọi cần thay đổi.
Một lượt chỉ đọc tách chẩn đoán khỏi hành động. GPT-6 Sol nhận danh sách rút gọn của GPT-6 Luna kèm cảnh báo đơn giản rằng nó có thể sai, và các tìm kiếm của nó về import v1, lời gọi charge, và tên webhook đã tự bộc lộ mọi tệp bị ảnh hưởng.
Nó cũng đi xa hơn danh sách, gắn cờ các model đơn hàng, kho đơn hàng, serializer, và xuất sổ cái như các phụ thuộc hạ lưu cần kiểm tra. Không cái nào cuối cùng cần thay đổi, nhưng đọc chúng là cách bạn phát hiện điều đó. Tôi sẽ giữ allowed_tools cho mọi agent chỉnh sửa tệp.
Kế hoạch di trú là nơi agent cam kết các tệp cụ thể trước khi được cấp quyền ghi. Lập kế hoạch thêm read_file, và kế hoạch quay về qua Structured Outputs với công cụ tắt đi:
plan = client.responses.parse(
    model="gpt-6-sol", instructions=INSTRUCTIONS, tools=TOOLS, tool_choice="none",
    reasoning={"effort": "medium"}, previous_response_id=last_id,
    input=PLAN_REQUEST, text_format=MigrationPlan,  # files, evidence, risks
)
Kế hoạch bao quát mọi thay đổi cần thiết và cảnh báo rằng một order ID mới sẽ thay đổi metadata v2 khi thử lại. Cảnh báo đó sẽ quay lại sau.
Trước khi cấp quyền ghi, harness kiểm tra cấu trúc, bằng chứng, và độ bao phủ của kế hoạch.
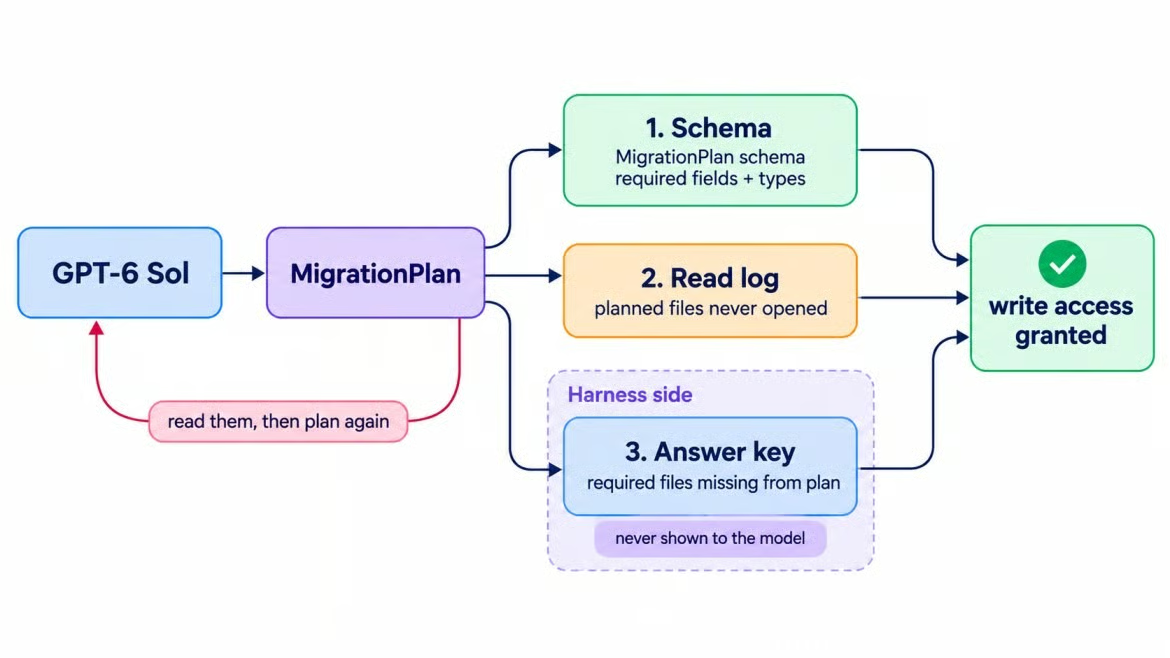
Ba kiểm tra cho một kế hoạch di trú. Ảnh: Tác giả.
Kế hoạch vượt qua từng cổng. Nó cũng đề xuất đổi tên một tham số public trong client.py để khớp tên gọi của v2, điều mà phần dọn dẹp trong đặc tả gợi ý. Đề xuất đó trở thành bài thử steering.
Một coding agent GPT-6 Sol dùng vòng lặp công cụ: đợi phản hồi, chạy các lời gọi hàm của nó, và trả các đầu ra. Hướng dẫn OpenAI Responses API của chúng tôi giải thích định dạng yêu cầu và kết quả công cụ. Lần di trú này giữ vòng lặp trên một kết nối WebSocket vì steering cần nó.
with client.responses.connect() as conn:
    conn.response.create(**base, previous_response_id=plan_id, input=[start_message])
    for event in conn:
        if event.type == "response.incomplete":
            reason = getattr(event.response.incomplete_details, "reason", None)
            if reason == "steered":
                continue  # keep reading for the automatic successor
            raise RuntimeError(reason or "response incomplete")
        if event.type != "response.completed":
            continue
        calls = [i for i in event.response.output if i.type == "function_call"]
        if not calls:
            break  # GPT-6 Sol says it's done here; the held-out tests decide whether it is
        outputs = [{"type": "function_call_output", "call_id": c.call_id,
                    "output": tools.run(c.name, c.arguments)} for c in calls]
        conn.response.create(**base, previous_response_id=event.response.id,
                             input=outputs)
base giữ cố định mô hình, hướng dẫn, công cụ, và mức nỗ lực medium cho việc cache prompt. GPT-6 Sol chạy các kiểm thử hiển thị khi làm việc, nhưng nó cũng viết phần lớn kiểm thử mới, nên chúng không thể là kiểm tra độc lập.
Steering giữa lượt thêm một chỉ dẫn vào phản hồi vẫn đang chạy, mà không hủy nó. Sau response.created, bạn gửi response.steer trên cùng kết nối với ID của phản hồi đó, và máy chủ áp dụng chỉ dẫn trong một phản hồi kế nhiệm.
Yêu cầu mới đến từ đội storefront: chữ ký CheckoutClient “phải giữ y nguyên như hôm nay,” vì một dịch vụ khác gọi chúng. Tôi không muốn một bộ đếm thời gian quyết định khi nào điều đó đến, nên harness thay vào đó theo dõi kho mã. Sau mỗi lô lời gọi công cụ, nó so sánh chữ ký public trên đĩa với bản gốc, và khác biệt đầu tiên sẽ kích hoạt steer:
if steer_state == "idle" and signature_changes(repo):  # CheckoutClient, compared with ast
    steer_state = "armed"

if event.type == "response.created" and steer_state == "armed":
    conn.response.steer(previous_response_id=event.response.id, input=STEER_TEXT)
    steer_state = "sent"
Điều đó đảm bảo steer hạ cánh sau lần đổi tên mà nó mâu thuẫn, đây mới là tình huống đáng thử. Gửi sớm hơn thì chỉ là prompt dài hơn.
Máy chủ sau đó báo vòng đời steering:
response.steer.accepted nghĩa là cập nhật đã được xếp hàng, chưa áp dụng
response.incomplete kết thúc phản hồi gốc với lý do steered
Một response.created kế nhiệm tiếp tục với yêu cầu mới
Nếu phản hồi đang chờ kết quả công cụ, máy chủ gửi response.steer.pending và giữ steer cho đến khi harness trả về. Hãy tiếp tục trả lời các lời gọi công cụ trong khi một steer đang chờ.
Steering thay đổi việc mô hình làm tiếp theo. Hướng dẫn của OpenAI nói thẳng về phần còn lại: một steer không viết lại đầu ra đã gửi, không hoàn tác hành động trước đó, và không hủy các công cụ đã bắt đầu.
Khi steer đến, việc đổi tên đã ở trên đĩa trong client.py. GPT-6 Sol đã hoàn nguyên nó, và một kiểm tra chữ ký giữ lại sau đó xác nhận giao diện cuối cùng.
Một chỉnh sửa có thể bị hoàn nguyên. Một công cụ đã gọi hệ thống bên ngoài thì sẽ không còn gì để hoàn nguyên, nên hãy ghi lại trạng thái kho tại thời điểm mỗi steer đến.
Trong kho này, có, dù không chỉ trong một lượt. Lần di trú đầu tiên đáp ứng hợp đồng gốc, rồi phép thử triển khai phơi bày một trường hợp thiếu.
Khi GPT-6 Sol báo hoàn tất di trú, bộ giữ lại vượt mà không cần vòng sửa. Với hoàn tiền, GPT-6 Sol thay phép cộng bằng lần đọc lũy kế đồng thời bỏ qua webhook không theo thứ tự:
-        order.refunded_cents += data["amount_refunded"]
+        order.refunded_cents = max(order.refunded_cents, refunded["cents"])
Về idempotency, GPT-6 Sol giữ một order_id mới cho mỗi lần thử và thêm một cache yêu cầu trong kho đơn hàng để trả lời các yêu cầu lặp trước khi chúng đến v2. Cache đó ở bộ nhớ tiến trình, điều này sẽ quan trọng ngay sau đây.
Có. Báo cáo đầu tiên gọi một kiểm thử webhook đã cập nhật là hồi quy và bỏ sót rủi ro từ thử lại giữa các máy chủ, dù kế hoạch đã nêu cái bẫy đó.
Structured Outputs xác thực schema, không xác thực các nhận định đó. Hãy đối chiếu các trường báo cáo với bằng chứng đã ghi, và đừng coi một danh sách rủi ro trống là bằng chứng rằng không còn rủi ro.
Bộ này bỏ lỡ một lần thử lại được điều hướng sang instance ứng dụng khác. Tôi thêm một phép thử triển khai với hai client dùng chung một bộ xử lý thanh toán nhưng không dùng chung bộ nhớ tiến trình.
Phép thử thất bại. Lần thử lại trên instance thứ hai ném payments_adapter_v2.IdempotencyConflict, một ngoại lệ adapter mà storefront không bao giờ nên thấy.
Chỉ triển khai có hơn một tiến trình mới phơi bày lỗi này, và đó là tác nhân kích hoạt tăng nỗ lực suy luận.
Một mục đầu vào configuration_update thay đổi mức nỗ lực suy luận cho phản hồi tiếp theo và mọi phản hồi sau đó, cho đến khi có cập nhật khác thay thế. Mức nỗ lực ở cấp yêu cầu giữ nguyên, nên tiền tố cache vẫn còn. Khi phép thử thất bại, harness gửi yêu cầu này, theo hướng dẫn suy luận:
Các yêu cầu di trú dùng store=True, nên sau khi WebSocket đóng, harness có thể tiếp tục chuỗi phản hồi đã lưu bằng một yêu cầu Responses API thông thường.
response = client.responses.create(
    model="gpt-6-sol", reasoning={"effort": "medium"},  # unchanged, so the prefix survives
    instructions=INSTRUCTIONS, tools=TOOLS, tool_choice=allowed(DIAGNOSE_TOOLS),
    previous_response_id=last_id,
    input=[{"type": "configuration_update", "reasoning": {"effort": "high"}},
           {"role": "user", "content": probe_failure + DIAGNOSE_FIRST}],
)
active_effort = "high"  # the harness records it; the response won't
GPT-6 Sol nhận lỗi và hình dạng triển khai, nhưng không có gợi ý về bản sửa. DIAGNOSE_TOOLS cho phép đọc và kiểm thử, không cho phép chỉnh sửa. Giữ nguyên công cụ và text.format giúp giữ tiền tố cache.
Một chi tiết API gây khó chịu: response.reasoning.effort vẫn báo thiết lập ở cấp yêu cầu sau một cập nhật. Harness không thể đọc mức nỗ lực đang hoạt động từ phản hồi, nên nó tự ghi lại giá trị khi gửi cập nhật và gắn nhãn mọi phản hồi sau bằng giá trị đó.
high có hoạt động không?Có. GPT-6 Sol lần theo lỗi đến kho cục bộ của máy chủ thứ hai, rồi theo order_id mới vào metadata thanh toán. Bộ xử lý dùng chung thấy tham số khác nhau cho cùng một request_id.
Bản sửa biến order ID thành một hàm của request ID, để mọi máy chủ tính cùng một giá trị:
-def new_order_id() -> str:
+def new_order_id(request_id: str | None = None) -> str:
+    if request_id:
+        stable = uuid.uuid5(uuid.NAMESPACE_URL, f"northstar.checkout.order:{request_id}")
+        return f"ord_{stable.hex[:12]}"
     return f"ord_{uuid.uuid4().hex[:12]}"
GPT-6 Sol cũng thêm một kiểm thử hiển thị cho trường hợp này. Phép thử và bộ acceptance vượt qua, rồi một
configuration_update đưa mức nỗ lực về medium. Báo cáo cuối mô tả chính xác lỗi thực sự lần này.
Ứng dụng Streamlit của dự án phát lại bản chạy đã lưu mà không thực hiện cuộc gọi API. Video đi từ tổng quan đến các sự kiện steering rồi đến kết quả acceptance và phép thử.
Học cùng DataCamp
Courses
Courses
Courses
blogs
Matt Crabtree
10 phút
