Courses
OpenAI APIを使いこなす
3時間
175.5K
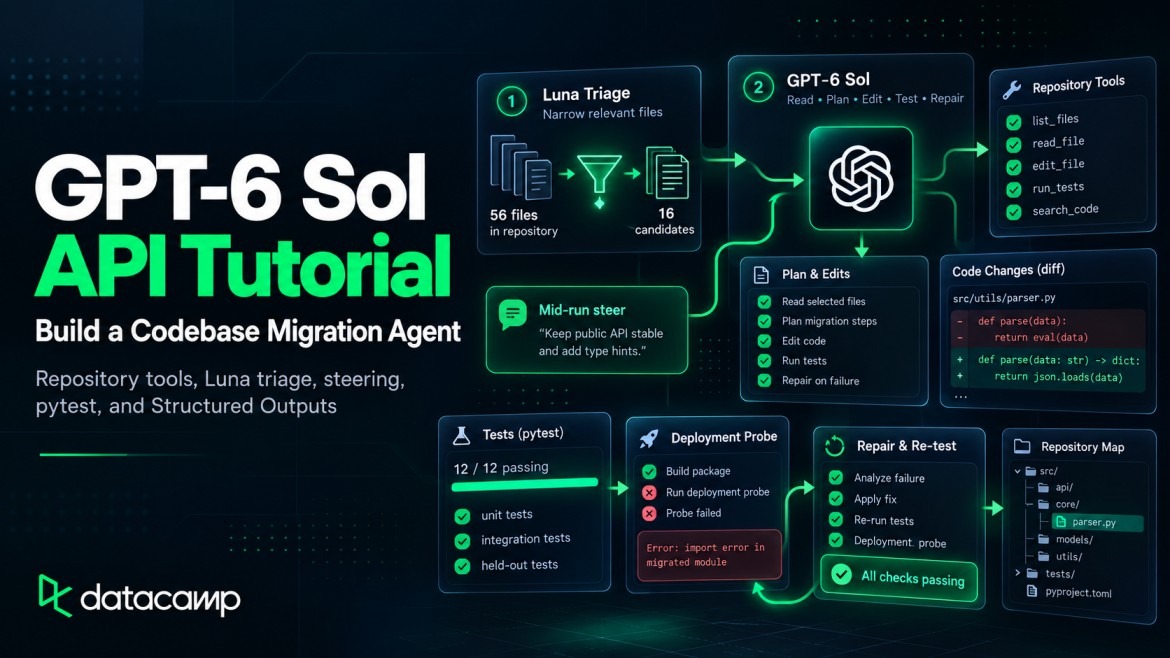
ここでは、GPT-6 Solを使って、架空の小規模PythonチェックアウトサービスであるNorthstar Checkoutを、ローカルのv1決済アダプタからv2へ移行します。
具体的には、次の内容を扱います。
最初のGPT-6 Sol API呼び出しを行い、usageフィールドを読む
モデルがリポジトリを見る前に、移行契約を定義する
GPT-6 Solに制限付きのファイル/テストツールを与え、allowed_toolsで段階的にアクセスを付与する
トリアージにGPT-6 Lunaを使い、GPT-6 Solにショートリストの検証をさせる
構造化された移行計画を返し、GPT-6 Solがすでに読んだファイルと突き合わせる
WebSocket経由で移行を実行し、編集開始後に舵取り(steer)する
独立したデプロイ検査が失敗した後に推論努力値を上げる
API使用量から記録されたコストを計算する
次の4点の発見により、次版の作り方が変わりました。
GPT-6 SolはOpenAIのGPT-6ファミリーの中位モデルで、APIのモデルIDはgpt-6-solです。弊社のGPT-6モデル階層ガイドではローンチ内容とベンチマークを扱っています。OpenAIのGPT-6ガイダンスでは、GPT-6 Astraが最上位、GPT-6 Solが中位、GPT-6 Lunaが最も低コストと位置付けられています。
GPT-6 Solのコンテキストウィンドウは1,050,000トークンで、最大128,000トークンを出力します。推論努力値はnoneからmaxまでの範囲で、デフォルトはmediumです。Chat CompletionsはGPT-6 Solの関数呼び出しをnoneのときのみサポートするため、本稿の全リクエストはResponses APIを使用します。
料金とAPI機能の対応が、ハーネスが各リクエストをどのように送るかを決めます。
GPT-6 Solは、OpenAIの料金ページによれば、入力272,000トークンまでのリクエストについて、入力100万トークンあたり$2、出力100万トークンあたり$10です。キャッシュ済み入力は100万トークンあたり$0.20、キャッシュ書き込みは$2.50です。GPT-6 Lunaの同4区分の料金は、それぞれ$0.10、$0.01、$0.125、$0.50です。
入力272,000トークンを超える場合、リクエスト全体が入力とキャッシュ系は2倍、出力は1.5倍のレートで課金されます。本プロジェクトではその水準に近づくことはありませんでした。
ここでの「ハーネス」(モデルの周囲にあるPythonコード)は、以下のGPT-6コントロールを使用します。
ターン途中のステアリング:応答の実行中に更新を適用
configuration_update:キャッシュ済みプレフィックスを書き換えずに推論努力値を変更
allowed_tools:リクエストで呼び出し可能なツールのサブセットを設定
Structured Outputs:計画やレポートのフィールドを定義
これら4つのコントロールは、同一のResponses APIレスポンスチェーン内で完結します。
Northstar CheckoutをPayments Adapter v1からv2へ移すエージェントを構築します。両アダプタはこの実験用に筆者が作成したローカルの代替物で、実在の決済SDKではありません。完全なコード、フィクスチャ、実行記録はGitHubリポジトリにあります。
このリポジトリは決済コードと無関係なモジュールが混在しているため、GPT-6 Sol自らが影響ファイルを見つける必要があります。v2は4つのアダプタ契約を破壊します。
支払い作成がclient.charge(...)からclient.payments.create(...)に移動
結果ディクショナリが、Money金額を持つ型付きオブジェクトに
却下カードは例外を投げず、状態を返す
Webhookの名称・エンベロープ・署名ヘッダが変更
検索置換でメソッド名のリネームは対処できます。挙動変更には対応できません。
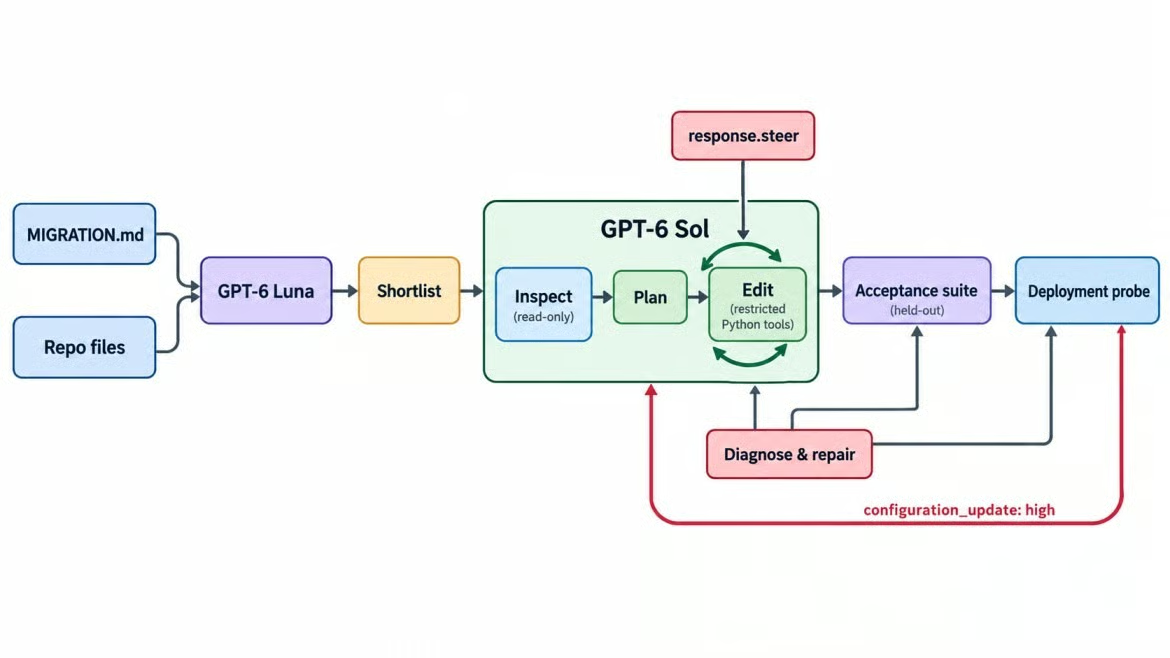
1回の移行ループに2つのGPT-6モデル。画像:筆者作成。
GPT-6 Solは仕様・ファイルツリー・段階的に呼び出し可能となる制限付きツールを受け取ります。どのファイルが変更対象か、新要件が来ることも、事前には知りません。
仕様の2箇所が落とし穴です。どちらも仕込みのバグではなく、v2の挙動が既存コードに出会うことで生まれます。
冪等性。 v2は繰り返しのrequest_idを見るとパラメータを比較しますが、チェックアウト側は各試行でメタデータに新しいorder_idを入れるため、素朴なリトライは重複排除ではなく拒否されます。
返金合計。 v2のpayment.refunded webhookはこれまでの累計返金額を報告しますが、旧ハンドラは各値を+=で加算します。
どちらも型チェッカは通過します。チェックアウトと返金をエンドツーエンドで動かして初めて捕まえられます。
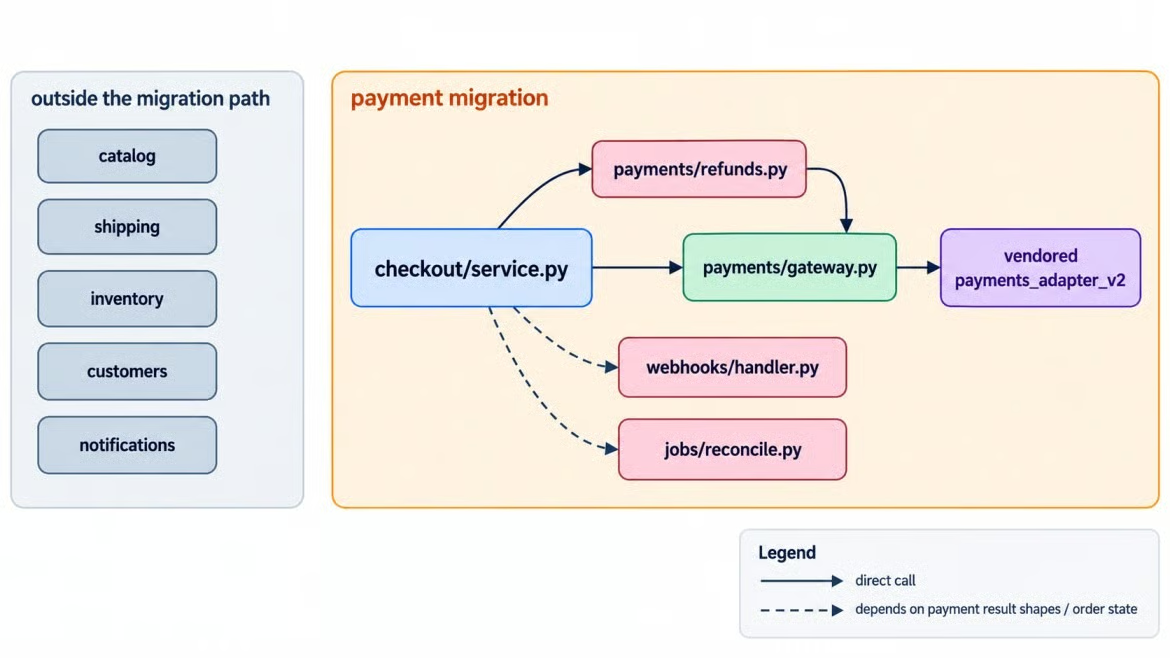
決済の変更はNorthstarの複数モジュールをまたぐ。画像:筆者作成。
マップは、アダプタの直接インポートと、決済挙動に依存するモジュールを分けています。後者の間接リンクが、リポジトリ全体の解答キーの重要性を高めます。
モデル呼び出しの前に作成したホールドアウトの受け入れスイートが結果を判定します。GPT-6 Solはこれを見ません。ハーネスが移行後のコピーに対してpytestで実行します。以下を確認します。
チェックアウトがv2経由で成功し、同じ冪等化キーでのリトライは1回のみ課金される
却下カードは公開エラーCheckoutDeclinedを引き続き送出する
全額返金、2回の部分返金、Webhookの再配信が、いずれも正しい合計に落ち着く
CheckoutClientのメソッドシグネチャは不変である
v1参照が残っていないこと、vendor/とMIGRATION.mdが未変更であること、可視テストが合格すること
元のコードは、インターフェイス不変と保護ファイル未変更のチェックにはすでに合格しています。残りのチェックが移行度合いを測ります。別の解答キーに必須変更が列挙されていますが、ハーネスだけがこれを読みます。
acceptance/とprobes/ディレクトリは、両モデルに公開されるコピー済みリポジトリの外側にあります。解答キーはacceptance/配下にあり、GPT-6 Lunaの入力やファイルツリー、いかなるリポジトリツールにも入ることはありません。
リードゲートはGPT-6 Sol自身の計画からパスを返すことができます。解答キーのカバレッジ結果は評価用に記録されるのみで、欠落している真値のパスをGPT-6 Solに送り返すことはありません。
その後にデプロイ検査が走ります。いずれのチェックも、モデルの「完了」メッセージを証拠として受け付けません。
Python 3.10以降と、両モデルにアクセスできるAPIキーが必要です。要件にはステアリングに必要なrealtimeエクストラが含まれます。
git clone https://github.com/KhalidAbdelaty/gpt-6-sol-api.git
cd gpt-6-sol-api
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .envmacOSやLinuxでは、source .venv/bin/activate と cp .env.example .envを使用し、その後OPENAI_API_KEY=...を.envに設定してください。
すでにResponses APIでキーが使えている場合は、次の小節はスキップしてください。
最小限の有用なリクエストは、キー・モデルID・コスト計算に必要なusageフィールドを確認します。
from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()
client = OpenAI()
response = client.responses.create(
    model="gpt-6-sol",
    input="In one sentence, why is a breaking API migration harder than renaming a function?",
)
print(response.reasoning.effort, response.output_text)
print(response.usage)レスポンスは努力値mediumを報告し、usageにはcached_tokensとcache_write_tokensが含まれます。temperatureやtop_pは指定しないでください。努力値がnoneでないときは常に400を返します。
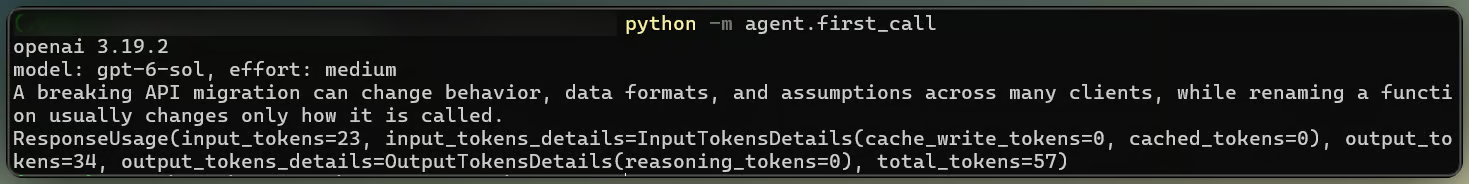
初回のGPT-6 Solリクエストはusageを返す。画像:筆者作成。
デフォルトのmediumから始め、実行全体でリクエストレベルの設定はそのままにしてください。移行の大半は読み取りと小さな編集です。後のデプロイ検査が、努力値を上げる理由を与えます。
ツール層がエージェントの権限を管理します。GPT-6 Solにはstrict: true付きの以下の関数ツールを与えます。
list_files と search_code:関連コードの特定
read_file:リポジトリの1ファイルを返す
edit_file:1箇所の完全一致のみを変更
run_tests:許可されたpytestターゲットを実行
厳格スキーマは引数形状を検査しますが、パスの安全性は検査しません。そのため、Python側で書き込み境界を強制します。
READ_ONLY = ("vendor/", "MIGRATION.md", "conftest.py")

if write:
    if rel_posix.startswith(READ_ONLY) or rel_posix in READ_ONLY:
        raise ToolError(f"{rel_posix} is read-only")  # the spec and both adapters
    if not rel_posix.startswith(("northstar/", "tests/")) or not rel_posix.endswith(".py"):
raise ToolError("writes are limited to Python files under northstar/ and tests/")パスは先に正規化されるため、../ や絶対パスは失敗します。edit_fileは完全一致1箇所のみを置換し、run_testsはtests/配下のターゲットのみを受け付けます。
ハーネスはブロックされた呼び出しをツール出力のERROR:として返し、ループは継続します。エージェントハーネス設計ガイドでは、これらのチェックをプロンプトではなくハーネス側に置く理由を説明しています。
各ツールに、拒否すべき入力で呼び出してみてください。
..を含むパス
絶対パス
vendor/配下への書き込み
シェルコマンドを含むテストターゲット
いずれも通過してはいけません。複数箇所に一致する編集は、さらなる文脈提示を求めるべきです。ルールをカスタム関数に収めることで、テスト可能な単一の場所に集約できます。
リポジトリのトリアージは狭義の分類タスクです:各ファイルの関連度を評価し、v1参照を引用します。GPT-6 Lunaはこの作業のみに使い、GPT-6 Solが何も検索する前、最初に実行します。
class FileVerdict(BaseModel):
    path: str
    relevance: Literal["high", "medium", "low", "none"]
    legacy_references: list[str]

triage = client.responses.parse(model="gpt-6-luna", input=spec_and_all_files,
text_format=TriageResult) # a list of FileVerdict入力は仕様と、northstar/およびtests/配下のすべてのPythonファイルです。highまたはmediumに評価されたものは、次にGPT-6 Solへ渡すショートリストに入ります。
先ほどの解答キーに照らしてショートリストを確認し、まずはリコールを見るべきです。GPT-6 Lunaは影響ファイルをすべて保持し、変更不要のものもいくつか加えました。
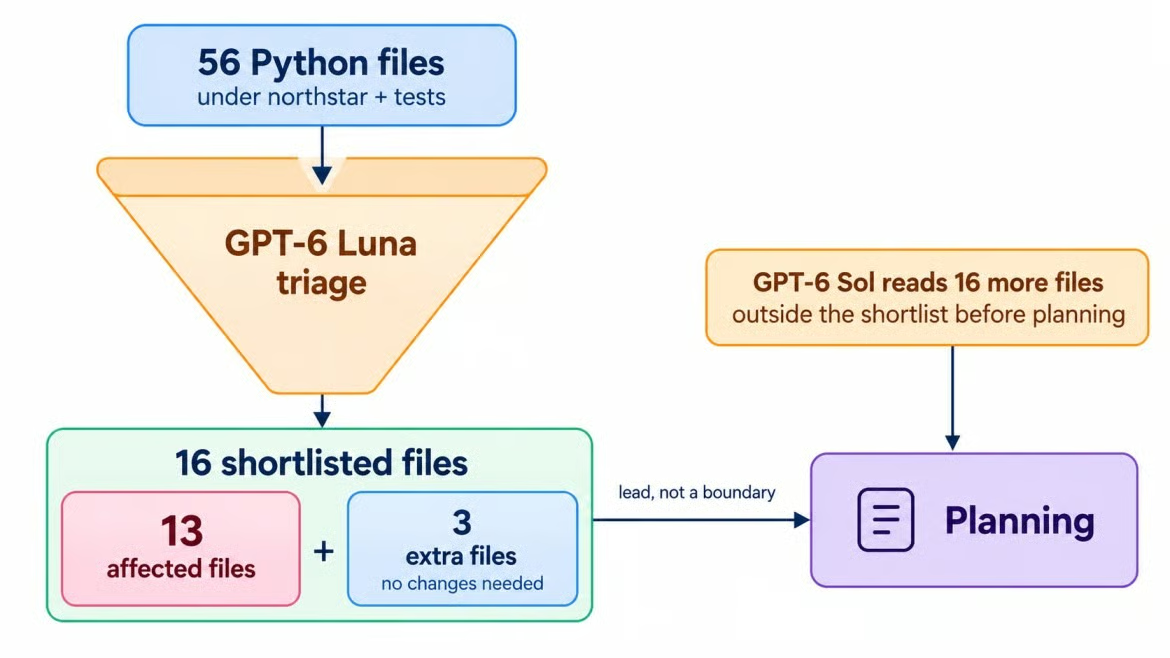
GPT-6 Lunaが56を16に絞る。画像:筆者作成。
ショートリストは境界ではなく、手掛かりです。
allowed_toolsを使う方法allowed_toolsは、完全なツールリストは保持したまま、モデルが呼べるツールを制限するtool_choiceモードです。これにより、GPT-6 Solの最初のパスは読み取り専用になります。各リクエストに完全なリストを定義しつつ、呼び出せるのは列挙と検索だけにします。
def allowed(names):
    return {"type": "allowed_tools", "mode": "auto",
            "tools": [{"type": "function", "name": n} for n in names]}

response = client.responses.create(
    model="gpt-6-sol", instructions=INSTRUCTIONS, tools=TOOLS,  # full list, every time
    tool_choice=allowed(["list_files", "search_code"]),
    reasoning={"effort": "medium"}, input=inspect_prompt, store=True,
)toolsをフェーズ間で変えるとキャッシュ済みプレフィックスが書き換わります。関数呼び出しガイドでは、呼び出し可能サブセットだけを変える場合はallowed_toolsの使用を推奨しています。
読み取り専用パスは、診断と実行を分離します。GPT-6 Solは、ショートリストが誤っているかもしれないという簡単な警告つきでGPT-6 Lunaのショートリストを受け取り、v1のインポート、charge呼び出し、Webhook名を検索することで、独力でもすべての影響ファイルを炙り出しました。
さらにリストを越えて、注文モデル、注文ストア、シリアライザ、台帳エクスポートを下流依存としてフラグ付けしました。いずれも変更は不要でしたが、読むからこそ不要だと分かるのです。ファイルを編集するエージェントなら、allowed_toolsは常に使いたいところです。
移行計画は、書き込み権限を与える前に、エージェントが特定のファイルにコミットする場です。計画フェーズではread_fileを追加し、計画はツールをオフにしたStructured Outputs経由で返されます。
plan = client.responses.parse(
    model="gpt-6-sol", instructions=INSTRUCTIONS, tools=TOOLS, tool_choice="none",
    reasoning={"effort": "medium"}, previous_response_id=last_id,
    input=PLAN_REQUEST, text_format=MigrationPlan,  # files, evidence, risks
)
計画は必要な変更をすべてカバーし、リトライ時に新しい注文IDがv2のメタデータを変えると警告しました。この警告は後で再登場します。
書き込み権限を与える前に、ハーネスは計画の構造・根拠・カバレッジを検査します。
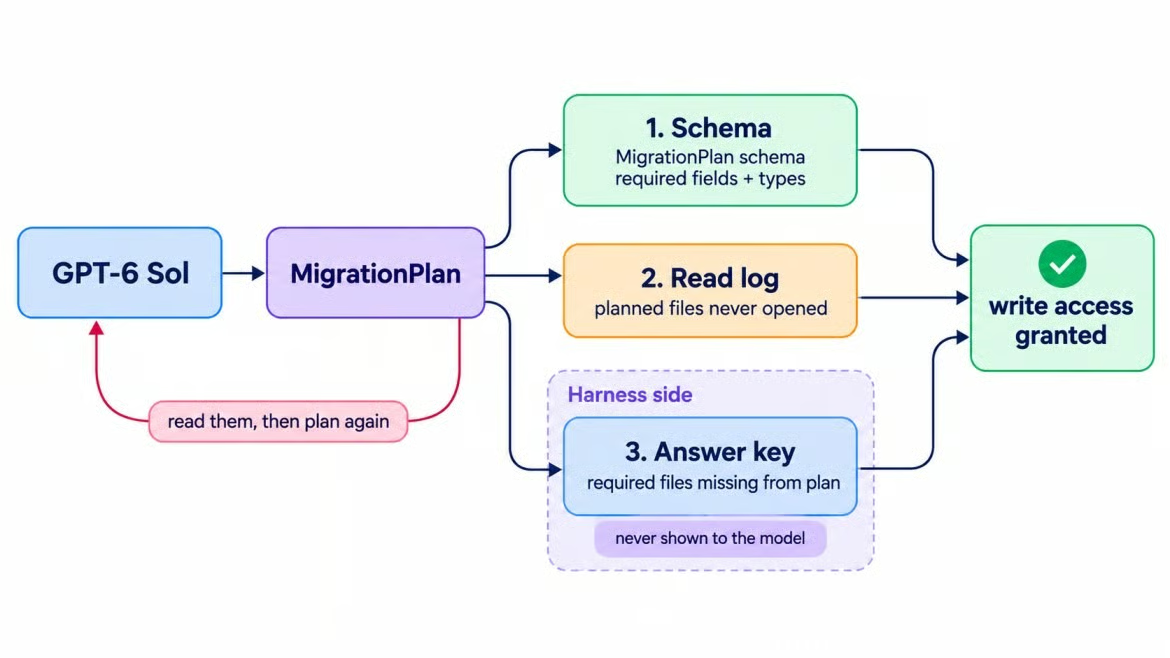
1つの移行計画を3つのチェックで検証。画像:筆者作成。
計画は各ゲートを通過しました。また、仕様のクリーンアップ節の提案に合わせ、公開のclient.pyパラメータの名称変更を提案しました。この提案がステアリングのテストとなります。
GPT-6 Solのコーディングエージェントはツールループを使います:応答を待ち、その関数呼び出しを実行し、出力を返す。弊社のOpenAI Responses APIガイドでは、リクエストとツール結果の形式を解説しています。本移行では、ステアリングが必要なためWebSocket接続を1本に保ちます。
with client.responses.connect() as conn:
    conn.response.create(**base, previous_response_id=plan_id, input=[start_message])
    for event in conn:
        if event.type == "response.incomplete":
            reason = getattr(event.response.incomplete_details, "reason", None)
            if reason == "steered":
                continue  # keep reading for the automatic successor
            raise RuntimeError(reason or "response incomplete")
        if event.type != "response.completed":
            continue
        calls = [i for i in event.response.output if i.type == "function_call"]
        if not calls:
            break  # GPT-6 Sol says it's done here; the held-out tests decide whether it is
        outputs = [{"type": "function_call_output", "call_id": c.call_id,
                    "output": tools.run(c.name, c.arguments)} for c in calls]
        conn.response.create(**base, previous_response_id=event.response.id,
input=outputs)baseは、モデル・インストラクション・ツール・mediumの努力値を固定してプロンプトキャッシュを活かします。GPT-6 Solは作業中に可視テストを実行しましたが、新規テストの多くも自ら作成しているため、独立した検証としては使えません。
ターン途中ステアリングは、レスポンスをキャンセルせず、実行中のレスポンスにインストラクションを追加します。response.createdの後、同じ接続上でそのレスポンスIDを指定してresponse.steerを送ると、サーバーは後続レスポンスにそのインストラクションを適用します。
新要件はストアフロントチームからのものです。CheckoutClientのシグネチャは「今日のまま完全に維持」する必要があり、別サービスが呼び出しているためです。これが届くタイミングをタイマーに任せたくなかったので、ハーネスは代わりにリポジトリを監視します。各ツール呼び出しのバッチ後に、ディスク上の公開シグネチャをオリジナルと比較し、最初の差分でステアを武装(armed)します。
if steer_state == "idle" and signature_changes(repo):  # CheckoutClient, compared with ast
    steer_state = "armed"

if event.type == "response.created" and steer_state == "armed":
    conn.response.steer(previous_response_id=event.response.id, input=STEER_TEXT)
    steer_state = "sent"
これにより、矛盾するリネームが行われた「後」にステアが到達することが保証され、テストに値する状況が作られます。これより前に送れば、単にプロンプトが長くなるだけです。
サーバーは次のようにステアリングのライフサイクルを報告しました。
response.steer.accepted:更新がキューに入り、まだ適用されていない
response.incomplete:元レスポンスがsteeredの理由で終了
後続のresponse.createdが新要件で続行
レスポンスがツール結果待ちのとき、サーバーはresponse.steer.pendingを送り、ハーネスが結果を返すまでステアを保留します。ステアが保留中でも、ツール呼び出しへは引き続き応答してください。
ステアリングは、モデルの「次の挙動」を変えます。OpenAIのガイドは残りについて明快です:ステアはすでに送信済みの出力を書き換えず、過去のアクションを取り消さず、開始済みのツールもキャンセルしません。
ステア到着時、リネームはすでにclient.pyに反映済みでした。GPT-6 Solはこれを元に戻し、後のホールドアウトのシグネチャチェックで最終的なインターフェイスが確認されました。
編集は取り消せます。外部システムをすでに呼んだツールには戻すものがないため、各ステアの到着時点でのリポジトリ状態を記録してください。
このリポジトリでは可能でしたが、一発ではありません。最初の移行は元の契約を満たしましたが、デプロイ検査で抜け漏れが露見しました。
GPT-6 Solが移行完了を報告した時点で、修復ラウンドなしにホールドアウトスイートは合格しました。返金について、GPT-6 Solは加算処理を累積読み取りへ置換し、順不同のWebhookも無視するようにしました。
-        order.refunded_cents += data["amount_refunded"]
+        order.refunded_cents = max(order.refunded_cents, refunded["cents"])
冪等性については、GPT-6 Solは試行ごとに新しいorder_idを維持し、注文ストアにリクエストキャッシュを追加して、v2に届く前に繰り返し要求へ応答するようにしました。このキャッシュはプロセスのメモリ内にあり、この後の点が重要になります。
あります。最初のレポートは更新されたWebhookテストを回帰と見なし、サーバー間リトライのリスクを外しました。計画ではその落とし穴を名指ししていたにもかかわらず、です。
Structured Outputsはスキーマを検証するだけで、中身の主張は検証しません。レポートのフィールドは記録済みの根拠と突き合わせ、リスクが空であることを「リスクがない証明」として扱ってはいけません。
別インスタンスにルーティングされたリトライを見逃しました。筆者は、1つの決済プロセッサを共有する一方でプロセスメモリを共有しない2つのクライアントで、デプロイ検査を追加しました。
検査は失敗しました。2つ目のインスタンスでのリトライは、ストアフロントが見るはずのないアダプタ例外payments_adapter_v2.IdempotencyConflictを送出しました。
複数プロセスのデプロイでのみ露見するこの不具合が、推論エスカレーションのトリガーです。
configuration_update入力アイテムは、次以降のレスポンスの推論努力値を変更し、別の更新が来るまで有効です。リクエストレベルの努力値は据え置きなので、キャッシュ済みプレフィックスは生き残ります。検査が失敗したとき、ハーネスは推論ガイドに従い、次のリクエストを送りました。
移行リクエストはstore=Trueを使っているため、WebSocketを閉じた後でも、ハーネスは保存済みレスポンスチェーンを通常のResponses APIリクエストで継続できます。
response = client.responses.create(
    model="gpt-6-sol", reasoning={"effort": "medium"},  # unchanged, so the prefix survives
    instructions=INSTRUCTIONS, tools=TOOLS, tool_choice=allowed(DIAGNOSE_TOOLS),
    previous_response_id=last_id,
    input=[{"type": "configuration_update", "reasoning": {"effort": "high"}},
           {"role": "user", "content": probe_failure + DIAGNOSE_FIRST}],
)
active_effort = "high"  # the harness records it; the response won't
GPT-6 Solは失敗とデプロイ形態を受け取りますが、修正の示唆は与えません。
DIAGNOSE_TOOLSは読み取りとテストを許可し、編集は許しません。ツールとtext.formatを不変にすることで、キャッシュ済みプレフィックスを保持します。
1点面倒なのは、response.reasoning.effortが更新後もリクエストレベルの設定を報告することです。ハーネスはレスポンスから有効な努力値を読み取れないため、更新を送る際に自分で値を記録し、以降のレスポンスにタグ付けします。
highの努力値で修復は成功した?成功しました。GPT-6 Solは、2台目サーバーのローカルストアへと失敗を追跡し、さらに新しい注文IDが決済メタデータへ入る流れを追いました。共有のプロセッサは、同じrequest_idに対して異なるパラメータを見ていました。
修正では、注文IDをrequest_idの関数にし、どのサーバーでも同じIDを計算するようにしました。
-def new_order_id() -> str:
+def new_order_id(request_id: str | None = None) -> str:
+    if request_id:
+        stable = uuid.uuid5(uuid.NAMESPACE_URL, f"northstar.checkout.order:{request_id}")
+        return f"ord_{stable.hex[:12]}"
     return f"ord_{uuid.uuid4().hex[:12]}"
GPT-6 Solはこのケース用の可視テストも追加しました。検査と受け入れスイートは合格し、その後のconfiguration_updateで努力値をmediumに戻しました。最終レポートは、今回は実際の不具合を正確に記述しました。
本プロジェクトのStreamlitアプリは、API呼び出しを行わずに保存済み実行を再生します。ビデオは概観からステアリングイベント、そして受け入れと検査の結果へと進みます。
DataCampで学ぶ
Courses
Courses
Courses