Curso
Trabalhar com a API da OpenAI
3 h
175.5K
Aqui, vamos usar o GPT-6 Sol para migrar o Northstar Checkout, um pequeno serviço fictício de checkout em Python, de um adaptador de pagamentos local v1 para v2.
Mais especificamente, vamos ver como:
Fazer a primeira chamada à API do GPT-6 Sol e ler seus campos de uso
Definir o contrato da migração antes de o modelo ver o repositório
Dar ao GPT-6 Sol ferramentas restritas de arquivos e testes e, depois, liberar acesso em etapas com allowed_tools
Usar o GPT-6 Luna para triagem e fazer o GPT-6 Sol verificar a shortlist
Retornar um plano de migração estruturado e conferi-lo com arquivos já lidos pelo GPT-6 Sol
Rodar a migração via WebSocket e direcioná-la depois que as edições começarem
Aumentar o esforço de raciocínio depois que uma sondagem de deployment independente falhar
Calcular o custo registrado a partir do uso da API
Quatro descobertas mudaram como eu construiria a próxima versão:
GPT-6 Sol é o nível intermediário da família GPT-6 da OpenAI, e seu ID de modelo na API é gpt-6-sol. Nosso guia dos níveis de modelos GPT-6 cobre o lançamento e os benchmarks. A orientação sobre GPT-6 da OpenAI coloca o GPT-6 Astra em primeiro, o GPT-6 Sol no meio e o GPT-6 Luna como a opção de menor custo.
O GPT-6 Sol tem janela de contexto de 1.050.000 tokens e retorna até 128.000 tokens de saída. O esforço de raciocínio vai de none até max e o padrão é medium. Chat Completions suporta o function calling do GPT-6 Sol apenas em none, então todo pedido aqui usa a Responses API.
Preço e suporte de API determinam como o harness envia cada requisição.
O GPT-6 Sol custa US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída para requisições de até 272.000 tokens de entrada, segundo a página de preços da OpenAI. Entrada em cache custa US$ 0,20 por milhão, e gravações em cache custam US$ 2,50. As tarifas do GPT-6 Luna para as mesmas quatro categorias são US$ 0,10, US$ 0,01, US$ 0,125 e US$ 0,50.
Acima de 272.000 tokens de entrada, a requisição inteira é cobrada a 2x as taxas de entrada e cache e 1,5x a taxa de saída. Nenhuma requisição deste projeto chegou perto disso.
O harness, isto é, o código Python ao redor do modelo, usa estes controles do GPT-6:
Steering no meio do turno atualiza uma resposta enquanto ela ainda está rodando
configuration_update muda o esforço de raciocínio sem reescrever o prefixo em cache
allowed_tools define o subconjunto de ferramentas chamáveis em uma requisição
Structured Outputs define os campos no plano e no relatório
Os quatro controles ficam dentro da mesma cadeia de respostas da Responses API.
Vamos criar um agente que migra o Northstar Checkout do Payments Adapter v1 para v2. Ambos os adaptadores são substitutos locais que eu escrevi para este experimento, não SDKs de pagamento reais. O código completo, fixtures e a execução gravada estão neste repositório no GitHub.
O repositório mistura código de pagamento com módulos não relacionados, então o GPT-6 Sol precisa encontrar sozinho os arquivos afetados. A v2 quebra quatro contratos do adaptador:
A criação de pagamento sai de client.charge(...) para client.payments.create(...)
Dicionários de resultado viram objetos tipados com quantias Money
Cartões recusados retornam um estado em vez de lançar exceção
Webhooks mudam nomes, envelope e o header de assinatura
Busca e substituição resolvem o rename do método. Não resolvem nenhuma das mudanças de comportamento.
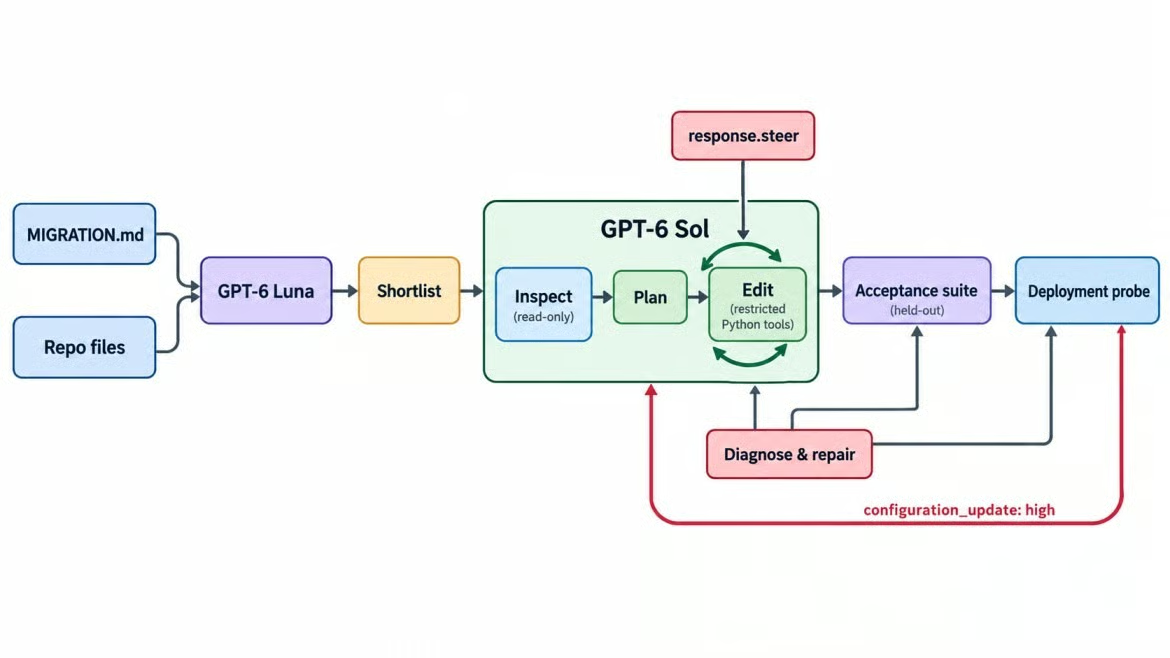
Um ciclo de migração, dois modelos GPT-6. Imagem do autor.
O GPT-6 Sol recebe a especificação, a árvore de arquivos e ferramentas restritas que ficam chamáveis em etapas. Ele não sabe quais arquivos precisam de mudança nem que um requisito vai mudar.
Duas partes da especificação são armadilhas. Não são bugs plantados; surgem do encontro do comportamento da v2 com o código existente:
Idempotência. a v2 compara parâmetros quando vê um request_id repetido, mas o checkout coloca um order_id novo nos metadados a cada tentativa, então um retry ingênuo é rejeitado em vez de deduplicado.
Totais de reembolso. o webhook payment.refunded da v2 informa o total reembolsado até agora, enquanto o handler antigo soma cada valor com +=.
Ambas passam por um type checker. Você só pega rodando checkout e reembolsos de ponta a ponta.
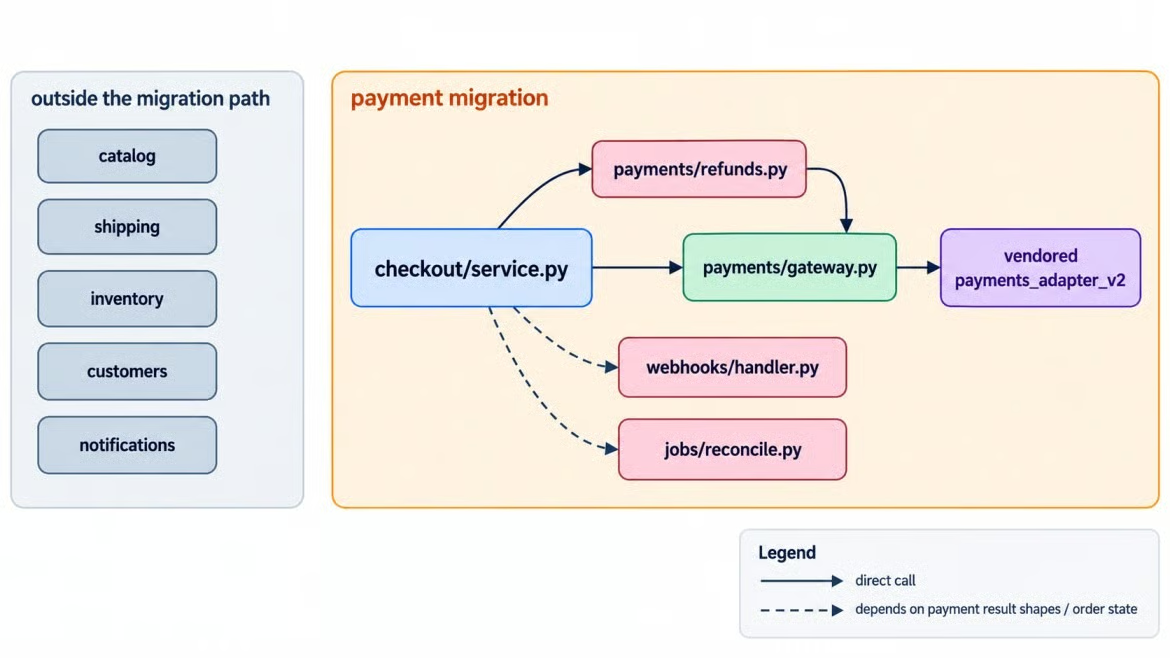
As mudanças de pagamento cruzam vários módulos do Northstar. Imagem do autor.
O mapa separa imports diretos do adaptador de módulos que dependem do comportamento de pagamento. Esses vínculos indiretos são o motivo pelo qual uma "resposta gabarito" para o repositório inteiro importa.
Um suite de aceitação reservado, escrito antes de qualquer chamada ao modelo, decide o resultado. O GPT-6 Sol nunca vê esse suite; o harness o executa com pytest contra a cópia migrada. Ele verifica que:
O checkout tem sucesso via v2, e um retry com a mesma chave de idempotência cobra uma vez
Um cartão recusado ainda lança o erro público CheckoutDeclined
Um reembolso total, dois parciais e um webhook reentregue mantêm os totais corretos
CheckoutClient mantém as assinaturas de método inalteradas
Não restam referências à v1, vendor/ e MIGRATION.md ficam intactos, e os testes visíveis passam
O código original já passa nas verificações de interfaces inalteradas e arquivos protegidos; as verificações restantes medem a migração. Um gabarito separado lista as mudanças exigidas, mas só o harness o lê.
Os diretórios acceptance/ e probes/ ficam fora da cópia do repositório exposta aos dois modelos. O gabarito mora sob acceptance/, então não pode entrar na entrada do GPT-6 Luna, na árvore de arquivos ou em qualquer ferramenta do repositório.
O portão de leitura pode devolver caminhos a partir do próprio plano do GPT-6 Sol. O resultado de cobertura do gabarito é registrado apenas para avaliação; ele nunca envia caminhos de verdade ausentes de volta para o GPT-6 Sol.
Uma sondagem de deployment roda depois desse suite. Nenhuma verificação aceita a mensagem de "concluído" do modelo como evidência.
Você precisa de Python 3.10 ou mais recente e uma chave de API com acesso aos dois modelos. Os requirements incluem o extra realtime que o steering precisa:
git clone https://github.com/KhalidAbdelaty/gpt-6-sol-api.git
cd gpt-6-sol-api
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
No macOS ou Linux, use source .venv/bin/activate e cp .env.example .env, depois coloque OPENAI_API_KEY=... em .env.
Se sua chave já funciona com a Responses API, pule a próxima subseção.
A menor requisição útil confirma a chave, o ID do modelo e os campos de uso que a seção de custos precisa:
from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()
client = OpenAI()
response = client.responses.create(
    model="gpt-6-sol",
    input="In one sentence, why is a breaking API migration harder than renaming a function?",
)
print(response.reasoning.effort, response.output_text)
print(response.usage)
A resposta informa esforço medium e usage inclui cached_tokens e cache_write_tokens. Deixe de fora temperature e top_p. Ambos retornam 400 sempre que o esforço não é none.
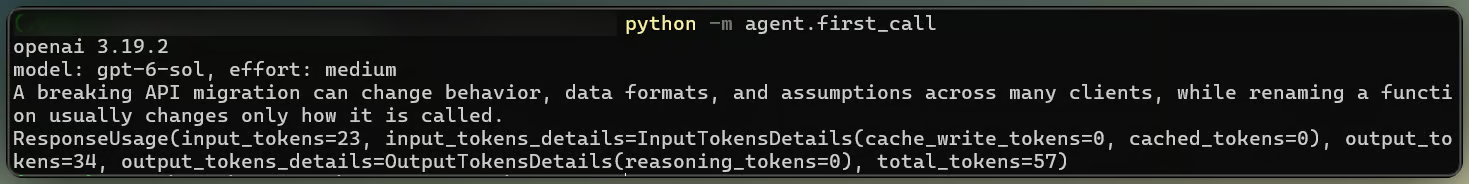
A primeira requisição ao GPT-6 Sol retorna uso. Imagem do autor.
Comece em medium, o padrão, e mantenha essa configuração no nível da requisição durante toda a execução. A maioria das etapas da migração são leituras e edições pequenas. A sondagem de deployment mais adiante dá um motivo para aumentar o esforço.
A camada de ferramentas define as permissões do agente. O GPT-6 Sol recebe estas function tools com strict: true:
list_files e search_code localizam código relevante
read_file retorna um arquivo do repositório
edit_file altera uma ocorrência exata
run_tests executa um alvo permitido do pytest
Esquemas strict conferem o formato dos argumentos, não a segurança de caminhos, então o Python aplica o limite de escrita:
READ_ONLY = ("vendor/", "MIGRATION.md", "conftest.py")

if write:
    if rel_posix.startswith(READ_ONLY) or rel_posix in READ_ONLY:
        raise ToolError(f"{rel_posix} is read-only")  # the spec and both adapters
    if not rel_posix.startswith(("northstar/", "tests/")) or not rel_posix.endswith(".py"):
        raise ToolError("writes are limited to Python files under northstar/ and tests/")
O caminho é resolvido primeiro, então ../ e caminhos absolutos falham. edit_file substitui um match exato, e run_tests aceita apenas alvos sob tests/.
O harness devolve uma chamada bloqueada como saída de ferramenta com ERROR:, e o loop continua. Nosso guia de engenharia de harness para agentes explica por que esses checks pertencem ao harness e não ao prompt.
Chame cada ferramenta com uma entrada que ela deve rejeitar:
Um caminho contendo ..
Um caminho absoluto
Uma escrita sob vendor/
Um alvo de teste contendo um comando de shell
Nenhuma deve passar. Uma edição que corresponda a mais de um local deve solicitar mais contexto, e manter as regras em funções personalizadas coloca tudo em um ponto testável.
A triagem do repositório é um trabalho de classificação estreito: avaliar a relevância de cada arquivo e citar referências à v1. O GPT-6 Luna recebe esse trabalho e nada mais, e roda primeiro, antes de o GPT-6 Sol pesquisar qualquer coisa.
class FileVerdict(BaseModel):
    path: str
    relevance: Literal["high", "medium", "low", "none"]
    legacy_references: list[str]

triage = client.responses.parse(model="gpt-6-luna", input=spec_and_all_files,
                                text_format=TriageResult)  # a list of FileVerdict
A entrada é a especificação mais cada arquivo Python sob northstar/ e tests/. Tudo que receber high ou medium entra na shortlist que o GPT-6 Sol recebe na sequência.
Confira a shortlist com o gabarito de antes e olhe o recall primeiro. O GPT-6 Luna reteve todo arquivo afetado e adicionou alguns que não precisavam de mudança.
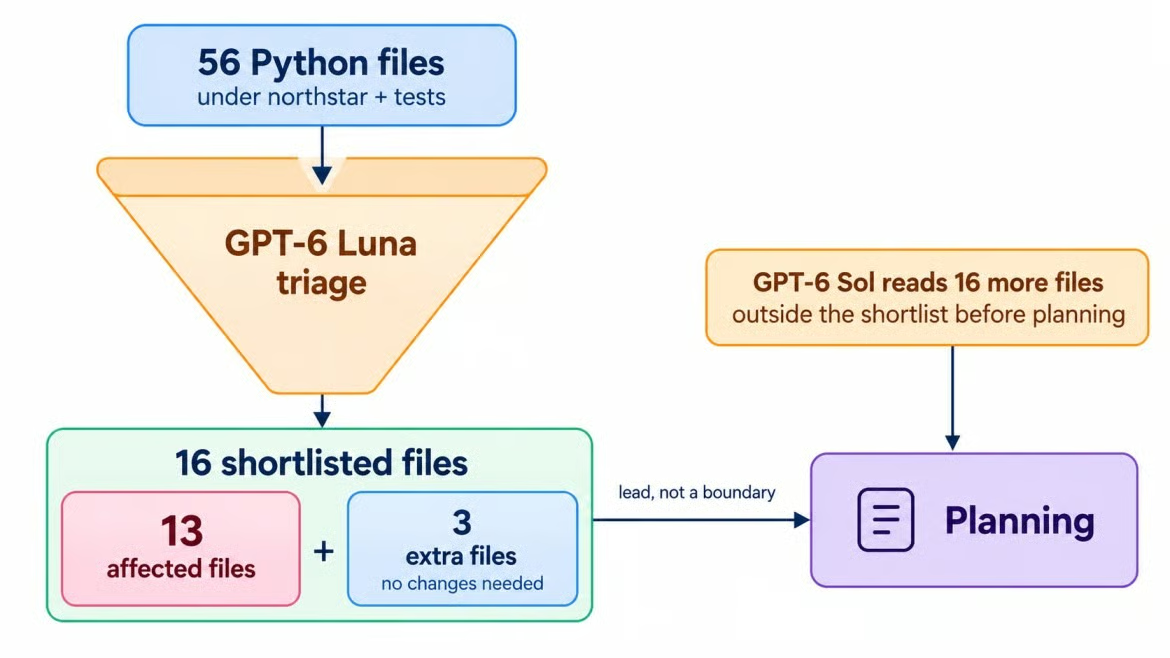
GPT-6 Luna reduz de 56 para 16. Imagem do autor.
Uma shortlist é uma pista, não um limite.
allowed_tools para permissões em etapasallowed_tools é um modo de tool_choice que limita quais ferramentas o modelo pode chamar enquanto a lista completa permanece definida. É assim que a primeira passada do GPT-6 Sol fica somente leitura: a lista completa é definida em toda requisição, mas só listar e buscar são chamáveis.
def allowed(names):
    return {"type": "allowed_tools", "mode": "auto",
            "tools": [{"type": "function", "name": n} for n in names]}

response = client.responses.create(
    model="gpt-6-sol", instructions=INSTRUCTIONS, tools=TOOLS,  # full list, every time
    tool_choice=allowed(["list_files", "search_code"]),
    reasoning={"effort": "medium"}, input=inspect_prompt, store=True,
)
Alterar tools entre fases reescreve o prefixo em cache. O guia de function calling recomenda allowed_tools quando só o subconjunto chamável deve mudar.
Uma passada somente leitura separa diagnóstico de ação. O GPT-6 Sol recebeu a shortlist do GPT-6 Luna com um aviso simples de que ela poderia estar errada, e suas buscas por imports da v1, chamadas a charge e nomes de webhooks trouxeram todos os arquivos afetados por conta própria.
Ele também foi além da lista, sinalizando modelos de pedido, o store de pedidos, serializers e a exportação do razão (ledger) como dependências downstream para checar. Nenhum precisou de mudanças, mas ler é como você descobre isso. Eu manteria allowed_tools para qualquer agente que edite arquivos.
Um plano de migração é onde o agente se compromete com arquivos específicos antes de ganhar acesso de escrita. No planejamento, liberamos read_file, e o plano volta por Structured Outputs com as ferramentas desligadas:
plan = client.responses.parse(
    model="gpt-6-sol", instructions=INSTRUCTIONS, tools=TOOLS, tool_choice="none",
    reasoning={"effort": "medium"}, previous_response_id=last_id,
    input=PLAN_REQUEST, text_format=MigrationPlan,  # files, evidence, risks
)
O plano cobriu toda mudança necessária e alertou que um order ID novo mudaria os metadados da v2 no retry. Esse alerta volta depois.
Antes de conceder acesso de escrita, o harness confere a estrutura, as evidências e a cobertura do plano.
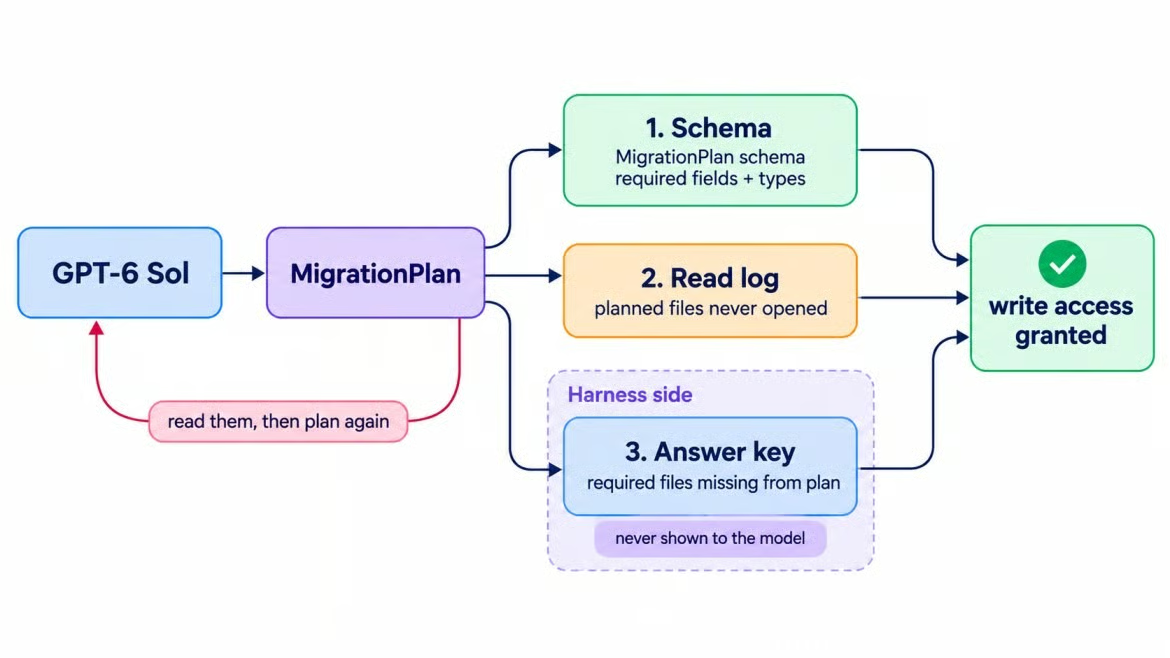
Três checks testam um plano de migração. Imagem do autor.
O plano passou por cada portão. Ele também propôs renomear um parâmetro público em client.py para combinar com a nomenclatura da v2, o que a seção de limpeza da spec sugeria. Essa proposta vira o teste de steering.
Um agente de código com GPT-6 Sol usa um loop de ferramentas: esperar uma resposta, executar suas function calls e devolver as saídas. Nosso guia da OpenAI Responses API explica os formatos de requisição e resultados de ferramenta. Esta migração mantém o loop em uma única conexão WebSocket porque o steering precisa disso.
with client.responses.connect() as conn:
    conn.response.create(**base, previous_response_id=plan_id, input=[start_message])
    for event in conn:
        if event.type == "response.incomplete":
            reason = getattr(event.response.incomplete_details, "reason", None)
            if reason == "steered":
                continue  # keep reading for the automatic successor
            raise RuntimeError(reason or "response incomplete")
        if event.type != "response.completed":
            continue
        calls = [i for i in event.response.output if i.type == "function_call"]
        if not calls:
            break  # GPT-6 Sol says it's done here; the held-out tests decide whether it is
        outputs = [{"type": "function_call_output", "call_id": c.call_id,
                    "output": tools.run(c.name, c.arguments)} for c in calls]
        conn.response.create(**base, previous_response_id=event.response.id,
                             input=outputs)
base mantém modelo, instruções, ferramentas e esforço medium fixos para cache de prompt. O GPT-6 Sol rodou os testes visíveis enquanto trabalhava, mas também escreveu a maioria dos novos testes, então eles não podem servir como checagem independente.
O steering no meio do turno adiciona uma instrução a uma resposta que ainda está rodando, sem cancelá-la. Após response.created, você envia response.steer na mesma conexão com o ID dessa resposta, e o servidor aplica a instrução em uma resposta sucessora.
O novo requisito veio do time do storefront: as assinaturas de CheckoutClient "precisam ficar exatamente como estão hoje", porque outro serviço as chama. Eu não quis que um timer decidisse quando isso chega, então o harness observa o repositório. Depois de cada lote de chamadas de ferramenta, ele compara as assinaturas públicas no disco com as originais, e a primeira diferença arma o steer:
if steer_state == "idle" and signature_changes(repo):  # CheckoutClient, compared with ast
    steer_state = "armed"

if event.type == "response.created" and steer_state == "armed":
    conn.response.steer(previous_response_id=event.response.id, input=STEER_TEXT)
    steer_state = "sent"
Isso garante que o steer caia depois do rename que ele contradiz, que é a situação que vale testar. Enviado antes, vira só um prompt maior.
O servidor então reportou o ciclo de vida do steering:
response.steer.accepted significa que a atualização foi enfileirada, não aplicada
response.incomplete encerrou a resposta original com o motivo steered
Uma response.created sucessora continuou com o novo requisito
Se a resposta estiver esperando o resultado de uma ferramenta, o servidor envia response.steer.pending e segura o steer até o harness devolvê-lo. Continue respondendo às chamadas de ferramenta enquanto houver um steer pendente.
O steering muda o que o modelo fará a seguir. A própria OpenAI é direta sobre o resto: um steer não reescreve a saída já enviada, não desfaz ações anteriores nem cancela ferramentas que já começaram.
Quando o steer chegou, o rename já estava no disco em client.py. O GPT-6 Sol o reverteu, e uma checagem de assinaturas reservada confirmou a interface final.
Uma edição pode ser revertida. Uma ferramenta que já tivesse chamado um sistema externo não deixaria nada para reverter, então registre o estado do repositório quando cada steer chegar.
Neste repositório, sim, embora não em uma passada. A primeira migração atendeu ao contrato original, então a sondagem de deployment expôs um caso faltante.
Quando o GPT-6 Sol reportou a migração concluída, o suite reservado passou sem rodada de reparo. Para reembolsos, o GPT-6 Sol trocou a soma por uma leitura acumulada que também ignora webhooks fora de ordem:
-        order.refunded_cents += data["amount_refunded"]
+        order.refunded_cents = max(order.refunded_cents, refunded["cents"])
Para idempotência, o GPT-6 Sol manteve um order_id novo por tentativa e adicionou um cache de requisições no store de pedidos que responde a repetições antes de elas chegarem à v2. Esse cache vive na memória do processo, o que importa daqui a pouco.
Podem. O primeiro relatório chamou um teste de webhook atualizado de regressão e omitiu o risco de retries entre servidores, embora o plano tivesse citado essa armadilha.
Structured Outputs valida o schema, não as alegações. Confira os campos do relatório contra evidências registradas e não trate uma lista de riscos vazia como prova de que não restam riscos.
O suite perdeu um retry roteado para outra instância do app. Eu adicionei uma sondagem de deployment com dois clientes que compartilham um processador de pagamentos, mas não a memória de processo.
A sondagem falhou. O retry na segunda instância lançou payments_adapter_v2.IdempotencyConflict, uma exceção do adaptador que o storefront nunca deveria ver.
Só um deployment com mais de um processo expõe essa falha, que aciona a escalada de raciocínio.
Um item de entrada configuration_update muda o esforço de raciocínio para a próxima resposta e todas as seguintes, até outra atualização substituí-lo. O esforço no nível da requisição fica como está, então o prefixo em cache sobrevive. Quando a sondagem falhou, o harness enviou este pedido, seguindo o guia de raciocínio:
As requisições da migração usam store=True, então, depois que o WebSocket fecha, o harness pode continuar a cadeia de respostas armazenada com uma requisição normal da Responses API.
response = client.responses.create(
    model="gpt-6-sol", reasoning={"effort": "medium"},  # unchanged, so the prefix survives
    instructions=INSTRUCTIONS, tools=TOOLS, tool_choice=allowed(DIAGNOSE_TOOLS),
    previous_response_id=last_id,
    input=[{"type": "configuration_update", "reasoning": {"effort": "high"}},
           {"role": "user", "content": probe_failure + DIAGNOSE_FIRST}],
)
active_effort = "high"  # the harness records it; the response won't
O GPT-6 Sol recebe a falha e o formato do deployment, mas sem dica sobre a correção. DIAGNOSE_TOOLS permite leitura e testes, não edição. Manter ferramentas e text.format inalterados preserva o prefixo em cache.
Um detalhe da API incomoda: response.reasoning.effort ainda reporta a configuração no nível da requisição após uma atualização. O harness não consegue ler o esforço ativo da resposta, então registra o valor ao enviar a atualização e marca todas as respostas seguintes com ele.
high funcionou?Sim. O GPT-6 Sol rastreou a falha até o store local do segundo servidor e seguiu o order ID novo até os metadados de pagamento. O processador compartilhado viu parâmetros diferentes para o mesmo request_id.
A correção tornou o order ID uma função do request ID, então todo servidor calcula o mesmo:
-def new_order_id() -> str:
+def new_order_id(request_id: str | None = None) -> str:
+    if request_id:
+        stable = uuid.uuid5(uuid.NAMESPACE_URL, f"northstar.checkout.order:{request_id}")
+        return f"ord_{stable.hex[:12]}"
     return f"ord_{uuid.uuid4().hex[:12]}"
O GPT-6 Sol também adicionou um teste visível para o caso. A sondagem e o suite de aceitação passaram, então um configuration_update devolveu o esforço para medium. O relatório final descreveu a falha real corretamente desta vez.
O app em Streamlit do projeto reproduz a execução salva sem fazer chamadas de API. O vídeo vai do panorama para os eventos de steering e depois para os resultados do suite de aceitação e da sondagem.
Aprenda com a DataCamp
Curso
Curso
Curso
blog
Abid Ali Awan
9 min
Tutorial
Tutorial
Moez Ali
11 min
Tutorial
Abid Ali Awan
8 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Moez Ali
12 min