Courses
การทำงานกับ OpenAI API
3 ชม.
175.5K
ที่นี่ จะใช้ GPT-6 Sol เพื่อย้าย Northstar Checkout ซึ่งเป็นบริการเช็กเอาต์ Python ขนาดเล็กในเรื่องสมมติ จากตัวเชื่อมต่อการชำระเงินแบบโลคัล v1 ไปยัง v2
โดยเฉพาะ จะครอบคลุมวิธี:
เรียก API GPT-6 Sol ครั้งแรกและอ่านฟิลด์การใช้งาน
กำหนดสัญญาการย้ายระบบก่อนที่โมเดลจะเห็นรีโพสิทอรี
ให้ GPT-6 Sol ใช้เครื่องมือไฟล์และการทดสอบแบบจำกัด แล้วทยอยเปิดสิทธิ์ด้วย allowed_tools
ใช้ GPT-6 Luna เพื่อคัดกรอง และให้ GPT-6 Sol ตรวจยืนยันรายชื่อย่อ
ส่งคืนแผนการย้ายระบบแบบมีโครงสร้างและตรวจเทียบกับไฟล์ที่ GPT-6 Sol อ่านไปแล้ว
รันการย้ายระบบผ่าน WebSocket และคุมทิศทางหลังเริ่มแก้ไข
เพิ่มระดับความพยายามในการให้เหตุผลหลังจากการทดสอบจำลองการดีพลอยล้มเหลว
คำนวณต้นทุนที่บันทึกจากการใช้งาน API
ข้อค้นพบสี่ข้อที่ทำให้วิธีสร้างเวอร์ชันถัดไปเปลี่ยนไป:
GPT-6 Sol เป็นรุ่นระดับกลางของตระกูล GPT-6 ของ OpenAI โดยมีรหัสโมเดล API คือ gpt-6-sol คู่มือแนะนำระดับโมเดล GPT-6 ของเราครอบคลุมการเปิดตัวและเบนช์มาร์ก เอกสาร แนวทาง GPT-6 ของ OpenAI จัด GPT-6 Astra ไว้อันดับแรก GPT-6 Sol อยู่กลาง และ GPT-6 Luna มีต้นทุนต่ำสุด
GPT-6 Sol มีหน้าต่างบริบท 1,050,000 โทเค็น และส่งออกได้สูงสุด 128,000 โทเค็น ระดับความพยายามในการให้เหตุผลมีตั้งแต่ none ถึง max และค่าเริ่มต้นคือ medium Chat Completions รองรับการเรียกฟังก์ชันของ GPT-6 Sol ได้เฉพาะที่ none ดังนั้นทุกคำขอที่นี่จึงใช้ Responses API
ราคาและการรองรับ API กำหนดว่าฮาร์เนสจะส่งแต่ละคำขออย่างไร
GPT-6 Sol มีค่าใช้จ่าย $2 ต่อหนึ่งล้านโทเค็นขาเข้า และ $10 ต่อหนึ่งล้านโทเค็นขาออก สำหรับคำขอที่มีโทเค็นขาเข้าไม่เกิน 272,000 ตามที่ระบุใน หน้าราคา OpenAI อินพุตที่แคชมีค่า $0.20 ต่อหนึ่งล้าน และการเขียนแคชมีค่า $2.50 อัตราของ GPT-6 Luna สำหรับสี่หมวดเดียวกันคือ $0.10, $0.01, $0.125 และ $0.50
เหนือ 272,000 โทเค็นขาเข้า ทั้งคำขอจะถูกคิดที่อัตราอินพุตและแคช 2 เท่า และอัตราขาออก 1.5 เท่า โปรเจ็กต์นี้ไม่มีคำขอใดเข้าใกล้จำนวนนั้น
ฮาร์เนส หมายถึงโค้ด Python รอบโมเดล ใช้ตัวควบคุม GPT-6 เหล่านี้:
การคุมทิศทางกลางเทิร์น อัปเดตการตอบกลับขณะกำลังรัน
configuration_update เปลี่ยนระดับความพยายามในการให้เหตุผลโดยไม่เขียน prefix ที่แคชใหม่
allowed_tools กำหนดชุดเครื่องมือที่เรียกได้สำหรับคำขอ
Structured Outputs กำหนดฟิลด์ในแผนและรายงาน
ตัวควบคุมทั้งสี่อยู่ในสายการตอบกลับเดียวกันของ Responses API
จะสร้างเอเจนต์ที่ย้าย Northstar Checkout จาก Payments Adapter v1 ไป v2 ตัวเชื่อมต่อทั้งสองเป็นตัวแทนโลคัลที่เขียนขึ้นเพื่อการทดลองนี้ ไม่ใช่ SDK การชำระเงินจริง โค้ดแบบสมบูรณ์ ฟิกซ์เจอร์ และการรันที่บันทึกไว้ อยู่ใน รีโพสิทอรี GitHub นี้.
รีโพสิทอรีผสมโค้ดการชำระเงินกับโมดูลที่ไม่เกี่ยวข้อง ดังนั้น GPT-6 Sol ต้องหาไฟล์ที่ได้รับผลกระทบเอง V2 ทำลายสัญญาตัวเชื่อมต่อสี่ข้อ:
การสร้างการชำระเงินย้ายจาก client.charge(...) ไป client.payments.create(...)
ดิกชันนารีผลลัพธ์กลายเป็นออบเจกต์แบบไทป์พร้อมจำนวนเงินแบบ Money
กรณีบัตรถูกปฏิเสธจะส่งคืนสถานะแทนการยก exception
Webhook เปลี่ยนชื่อ ซองห่อ และเฮดเดอร์ลายเซ็น
การค้นหาและแทนที่ช่วยจัดการการเปลี่ยนชื่อเมธอดได้ แต่ไม่ครอบคลุมการเปลี่ยนพฤติกรรมใด ๆ
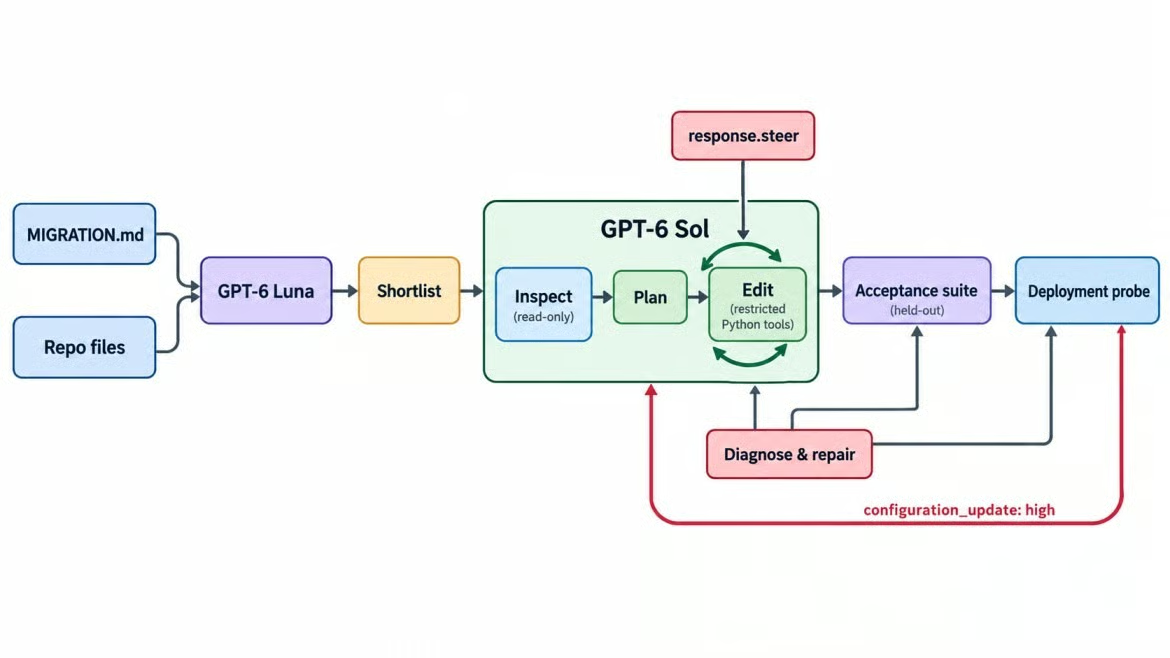
หนึ่งลูปการย้าย สองโมเดล GPT-6 ภาพโดยผู้เขียน
GPT-6 Sol ได้รับสเปก ผังไฟล์ และเครื่องมือแบบจำกัดที่เปิดให้เรียกได้เป็นระยะ ๆ มันไม่รู้ว่าไฟล์ไหนต้องแก้ หรือว่าจะมีข้อกำหนดเปลี่ยน
มีสองส่วนในสเปกที่เป็นกับดัก ไม่ใช่บั๊กที่จงใจปลูก แต่เกิดจากพฤติกรรม v2 ปะทะกับโค้ดที่มีอยู่:
Idempotency v2 จะเปรียบเทียบพารามิเตอร์เมื่อเห็น request_id ซ้ำ แต่เช็กเอาต์จะใส่ order_id ใหม่ลงในเมทาดาทาทุกครั้งที่ลองใหม่ ทำให้การลองแบบไร้เดียงสาถูกปฏิเสธแทนที่จะดีดิวพลิเคต
ยอดคืนเงิน webhook payment.refunded ของ v2 รายงานยอดรวมที่คืนแล้ว ขณะที่ตัวจัดการเก่าบวกค่าทีละรายการด้วย +=.
ทั้งสองอย่างผ่านตัวตรวจไทป์ได้ จับได้ก็ต่อเมื่อรันเช็กเอาต์และการคืนเงินครบกระบวนการเท่านั้น
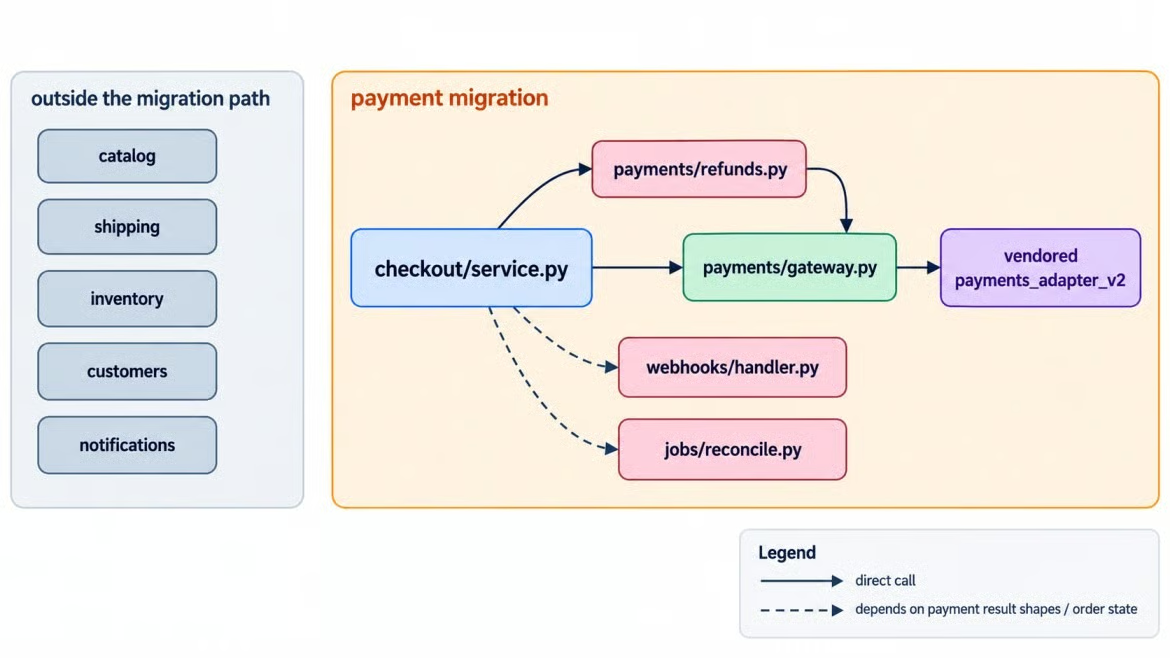
การเปลี่ยนแปลงการชำระเงินพาดผ่านหลายโมดูลของ Northstar ภาพโดยผู้เขียน
แผนที่แยกการอิมพอร์ตตรงจากตัวเชื่อมต่อ ออกจากโมดูลที่ขึ้นกับพฤติกรรมการชำระเงิน ลิงก์ทางอ้อมเหล่านั้นเป็นเหตุผลที่คำตอบสำหรับทั้งรีโพสิทอรีมีความสำคัญ
ชุดทดสอบการยอมรับที่กันไว้ เขียนก่อนเรียกโมเดลใด ๆ จะเป็นผู้ตัดสิน GPT-6 Sol ไม่เคยเห็นมัน ฮาร์เนสจะรันด้วย pytest กับสำเนาที่ถูกย้าย โดยตรวจว่า:
เช็กเอาต์สำเร็จผ่าน v2 และการลองใหม่ด้วยคีย์ idempotency เดิมถูกเรียกเก็บเพียงครั้งเดียว
กรณีบัตรถูกปฏิเสธยังคงยกข้อผิดพลาดสาธารณะ CheckoutDeclined
การคืนเต็มจำนวน การคืนบางส่วนสองครั้ง และ webhook ที่ส่งซ้ำ ให้ยอดคงถูกต้องทั้งหมด
CheckoutClient คงลายเซ็นเมธอดเดิมไม่เปลี่ยน
ไม่มีการอ้างอิง v1 เหลืออยู่ vendor/ และ MIGRATION.md ไม่ถูกแตะ และการทดสอบที่มองเห็นผ่าน
โค้ดเดิมผ่านการตรวจสำหรับอินเทอร์เฟซที่ไม่เปลี่ยนและไฟล์ที่ป้องกันแล้ว การตรวจที่เหลือวัดผลการย้าย กุญแจตอบ (answer key) แยกต่างหากระบุการเปลี่ยนที่ต้องการ แต่มีเพียงฮาร์เนสที่อ่านมัน
ไดเรกทอรี acceptance/ และ probes/ อยู่ภายนอกรีโพสิทอรีที่คัดลอกซึ่งเปิดให้ทั้งสองโมเดล กุญแจตอบอยู่ใต้ acceptance/ จึงไม่สามารถเข้าอินพุตของ GPT-6 Luna ผังไฟล์ หรือเครื่องมือใดในรีโพสิทอรีได้
เกตการอ่านสามารถส่งคืนพาธจากแผนของ GPT-6 Sol เอง ผลครอบคลุมของกุญแจตอบถูกบันทึกเพื่อการประเมินเท่านั้น ไม่เคยส่งพาธความจริงพื้นฐานที่ขาดไปกลับให้ GPT-6 Sol
หลังชุดนั้นจะมีการดีพลอยโปรบรันตามมา ไม่มีการตรวจใดยอมรับข้อความ "เสร็จแล้ว" ของโมเดลเป็นหลักฐาน
ต้องใช้ Python 3.10 ขึ้นไป และคีย์ API ที่เข้าถึงได้ทั้งสองโมเดล ความต้องการรวมถึงส่วนเสริม realtime ที่จำเป็นสำหรับการคุมทิศทาง:
git clone https://github.com/KhalidAbdelaty/gpt-6-sol-api.git
cd gpt-6-sol-api
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
บน macOS หรือ Linux ให้ใช้ source .venv/bin/activate และ cp .env.example .env จากนั้นใส่ OPENAI_API_KEY=... ลงใน .env.
หากคีย์ใช้งานกับ Responses API ได้อยู่แล้ว ให้ข้ามหัวข้อย่อยถัดไป
คำขอที่เล็กที่สุดซึ่งมีประโยชน์จะยืนยันคีย์ รหัสโมเดล และฟิลด์การใช้งานที่ส่วนต้นทุนต้องใช้:
from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()
client = OpenAI()
response = client.responses.create(
    model="gpt-6-sol",
    input="In one sentence, why is a breaking API migration harder than renaming a function?",
)
print(response.reasoning.effort, response.output_text)
print(response.usage)
การตอบกลับรายงานความพยายามระดับ medium และ usage มี cached_tokens และ cache_write_tokens ไม่ต้องใส่ temperature และ top_p ทั้งสองจะส่ง 400 ทุกครั้งเมื่อความพยายามไม่ใช่ none.
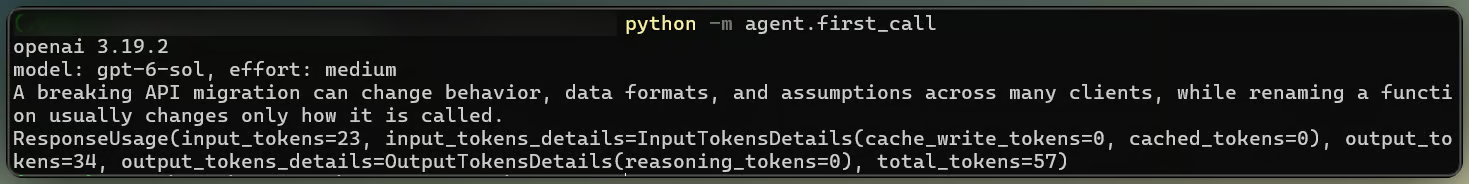
คำขอ GPT-6 Sol ครั้งแรกส่งคืนการใช้งาน ภาพโดยผู้เขียน
เริ่มที่ medium ซึ่งเป็นค่าเริ่มต้น และคงการตั้งค่าระดับคำขอไว้ตลอดการรัน ส่วนใหญ่ของเทิร์นการย้ายคือการอ่านและแก้เล็กน้อย ดีพลอยโปรบภายหลังจะให้เหตุผลในการเพิ่มความพยายาม
เลเยอร์เครื่องมือเป็นเจ้าของสิทธิ์ของเอเจนต์ GPT-6 Sol ได้รับเครื่องมือฟังก์ชันเหล่านี้พร้อม strict: true:
list_files และ search_code เพื่อหาโค้ดที่เกี่ยวข้อง
read_file คืนไฟล์หนึ่งไฟล์ในรีโพสิทอรี
edit_file เปลี่ยนแปลงหนึ่งตำแหน่งที่ตรงกันแบบเป๊ะ
run_tests รันทาร์เก็ต pytest ที่อนุญาต
สคีมาแบบ strict ตรวจเฉพาะรูปร่างอาร์กิวเมนต์ ไม่ใช่ความปลอดภัยของพาธ จึงให้ Python บังคับขอบเขตการเขียน:
READ_ONLY = ("vendor/", "MIGRATION.md", "conftest.py")

if write:
    if rel_posix.startswith(READ_ONLY) or rel_posix in READ_ONLY:
        raise ToolError(f"{rel_posix} is read-only")  # the spec and both adapters
    if not rel_posix.startswith(("northstar/", "tests/")) or not rel_posix.endswith(".py"):
        raise ToolError("writes are limited to Python files under northstar/ and tests/")
พาธจะถูกแก้ให้เรียบร้อยก่อน ดังนั้น ../ และพาธสัมบูรณ์จะล้มเหลว edit_file จะแทนที่ตรงกับหนึ่งตำแหน่งเท่านั้น และ run_tests ยอมรับเฉพาะทาร์เก็ตใต้ tests/.
ฮาร์เนสจะส่งคืนการเรียกที่ถูกบล็อกเป็นเอาต์พุตเครื่องมือที่ขึ้นต้นด้วย ERROR: และลูปจะดำเนินต่อไป คู่มือวิศวกรรมฮาร์เนสเอเจนต์ ของเราอธิบายว่าทำไมการตรวจเหล่านี้ควรอยู่ในฮาร์เนสมากกว่าในพรอมต์
เรียกแต่ละเครื่องมือด้วยอินพุตที่ต้องถูกปฏิเสธ:
พาธที่มี ..
พาธแบบสัมบูรณ์
การเขียนใต้ vendor/
ทาร์เก็ตการทดสอบที่มีคำสั่งเชลล์
ไม่มีรายการใดควรผ่านได้ การแก้ไขที่ตรงกับหลายตำแหน่งควรขอคอนเท็กซ์เพิ่มเติม และการเก็บกติกาไว้ในฟังก์ชันกำหนดเองจะรวมไว้ในที่เดียวที่ทดสอบได้
การคัดกรองรีโพสิทอรีเป็นงานจัดประเภทแบบแคบ: ให้เรตความเกี่ยวข้องของแต่ละไฟล์และยกคำอ้างอิง v1 GPT-6 Luna ได้งานนี้และเท่านั้น และจะรันก่อนที่ GPT-6 Sol จะได้ค้นหาอะไร
class FileVerdict(BaseModel):
    path: str
    relevance: Literal["high", "medium", "low", "none"]
    legacy_references: list[str]

triage = client.responses.parse(model="gpt-6-luna", input=spec_and_all_files,
                                text_format=TriageResult)  # a list of FileVerdict
อินพุตคือสเปกบวกไฟล์ Python ทั้งหมดใต้ northstar/ และ tests/ อะไรก็ตามที่จัดเรตเป็น high หรือ medium จะเข้ารายชื่อย่อที่ส่งให้ GPT-6 Sol ถัดไป
ตรวจรายชื่อย่อเทียบกับกุญแจตอบจากก่อนหน้า และดูรีคอลก่อน GPT-6 Luna เก็บไฟล์ที่ได้รับผลกระทบทุกไฟล์และเพิ่มบางไฟล์ที่ไม่ต้องแก้
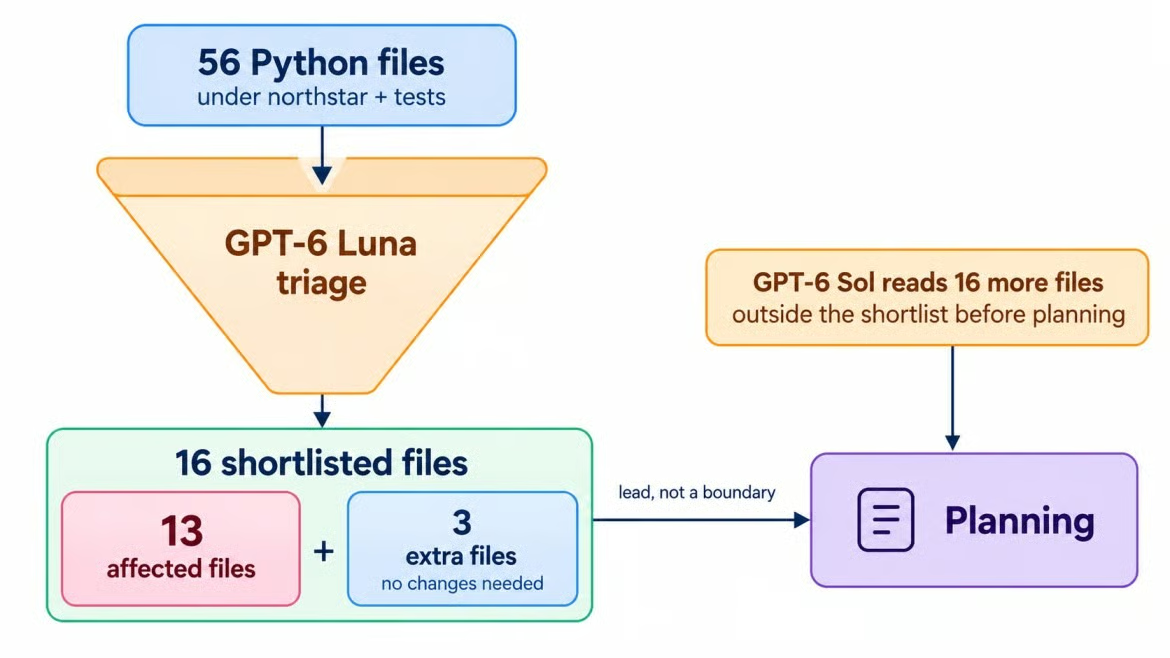
GPT-6 Luna ลดจาก 56 เหลือ 16 ภาพโดยผู้เขียน
รายชื่อย่อเป็นเบาะแส ไม่ใช่ขอบเขต
allowed_tools เพื่อเปิดสิทธิ์แบบเป็นระยะallowed_tools คือโหมดของ tool_choice ที่จำกัดเครื่องมือที่โมเดลเรียกได้ ในขณะที่รายการเครื่องมือเต็มยังคงอยู่ นั่นทำให้การวนรอบแรกของ GPT-6 Sol เป็นแบบอ่านอย่างเดียว: กำหนดรายการเต็มในทุกคำขอ แต่เรียกได้เฉพาะ list และ search
def allowed(names):
    return {"type": "allowed_tools", "mode": "auto",
            "tools": [{"type": "function", "name": n} for n in names]}

response = client.responses.create(
    model="gpt-6-sol", instructions=INSTRUCTIONS, tools=TOOLS,  # full list, every time
    tool_choice=allowed(["list_files", "search_code"]),
    reasoning={"effort": "medium"}, input=inspect_prompt, store=True,
)
การเปลี่ยน tools ระหว่างเฟสจะเขียน prefix ที่แคชใหม่ คู่มือการเรียกฟังก์ชัน แนะนำให้ใช้ allowed_tools เมื่อควรเปลี่ยนเฉพาะชุดที่เรียกได้
การผ่านอ่านอย่างเดียวแยกการวินิจฉัยออกจากการลงมือ GPT-6 Sol ได้รายชื่อย่อของ GPT-6 Luna พร้อมคำเตือนทั่วไปว่าอาจผิดพลาด และการค้นหาอิมพอร์ต v1 การเรียก charge และชื่อ webhook ก็เผยไฟล์ที่ได้รับผลกระทบทั้งหมดด้วยตัวเอง
มันยังอ่านเกินรายชื่อ ยกธงโมเดลออร์เดอร์ สโตร์ออร์เดอร์ ซีเรียไลเซอร์ และเอ็กซ์พอร์ตบัญชีแยกประเภทเป็นการพึ่งพาปลายน้ำเพื่อตรวจสอบ ไม่มีอันไหนต้องแก้ แต่การอ่านคือวิธีที่จะรู้เรื่องนั้น จะคงใช้ allowed_tools สำหรับเอเจนต์ใดก็ตามที่แก้ไฟล์
แผนการย้ายคือจุดที่เอเจนต์ผูกมัดกับไฟล์ที่เฉพาะเจาะจงก่อนจะได้สิทธิ์เขียน เฟสวางแผนจะเพิ่ม read_file และแผนจะถูกส่งกลับผ่าน Structured Outputs โดยปิดเครื่องมือ:
plan = client.responses.parse(
    model="gpt-6-sol", instructions=INSTRUCTIONS, tools=TOOLS, tool_choice="none",
    reasoning={"effort": "medium"}, previous_response_id=last_id,
    input=PLAN_REQUEST, text_format=MigrationPlan,  # files, evidence, risks
)
แผนครอบคลุมการเปลี่ยนที่ต้องการทั้งหมด และเตือนว่า order ID ใหม่จะเปลี่ยนเมทาดาทา v2 เมื่อรีไทร ซึ่งคำเตือนนั้นจะกลับมาอีกภายหลัง
ก่อนให้สิทธิ์เขียน ฮาร์เนสจะตรวจโครงสร้างของแผน หลักฐาน และความครอบคลุม
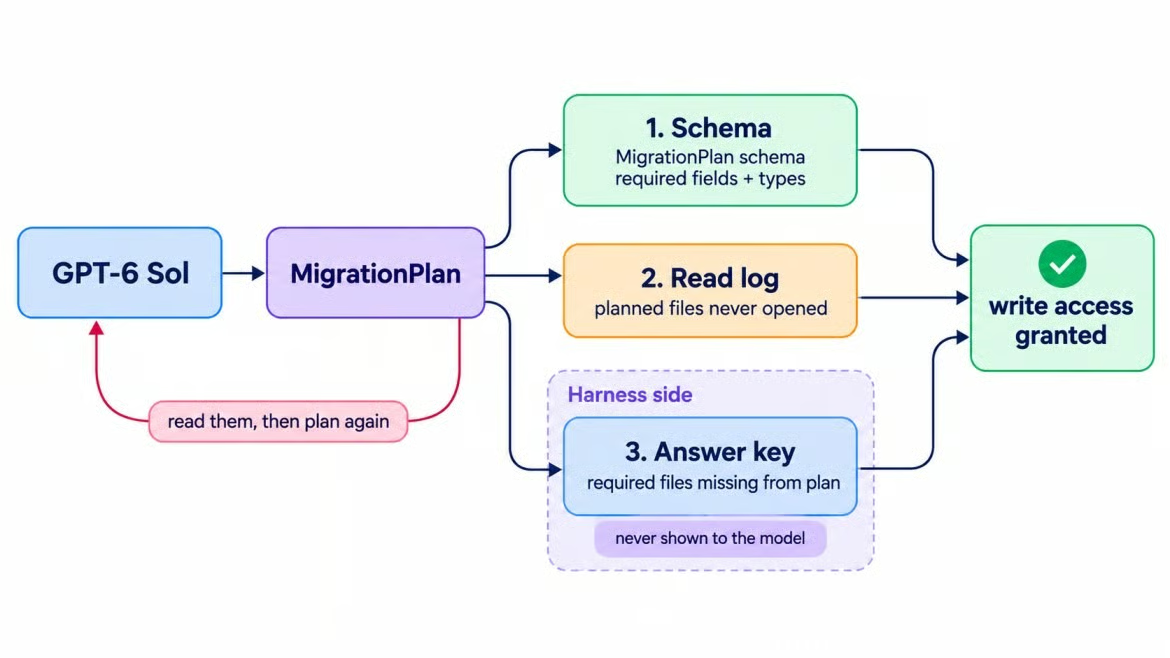
การตรวจสามอย่างสำหรับแผนการย้ายหนึ่งแผน ภาพโดยผู้เขียน
แผนผ่านทุกเกต นอกจากนี้ยังเสนอให้เปลี่ยนชื่อพารามิเตอร์สาธารณะใน client.py ให้ตรงกับการตั้งชื่อของ v2 ซึ่งส่วนทำความสะอาดของสเปกแนะนำ ข้อเสนอนั้นกลายเป็นบททดสอบการคุมทิศทาง
เอเจนต์เขียนโค้ด GPT-6 Sol ใช้ลูปเครื่องมือ: รอการตอบกลับ รันการเรียกฟังก์ชัน และส่งคืนเอาต์พุต คู่มือ OpenAI Responses API ของเราอธิบายรูปแบบคำขอและผลลัพธ์จากเครื่องมือ การย้ายนี้เก็บลูปไว้บนการเชื่อมต่อ WebSocket เดียว เพราะการคุมทิศทางต้องใช้
with client.responses.connect() as conn:
    conn.response.create(**base, previous_response_id=plan_id, input=[start_message])
    for event in conn:
        if event.type == "response.incomplete":
            reason = getattr(event.response.incomplete_details, "reason", None)
            if reason == "steered":
                continue  # keep reading for the automatic successor
            raise RuntimeError(reason or "response incomplete")
        if event.type != "response.completed":
            continue
        calls = [i for i in event.response.output if i.type == "function_call"]
        if not calls:
            break  # GPT-6 Sol says it's done here; the held-out tests decide whether it is
        outputs = [{"type": "function_call_output", "call_id": c.call_id,
                    "output": tools.run(c.name, c.arguments)} for c in calls]
        conn.response.create(**base, previous_response_id=event.response.id,
                             input=outputs)
base คงโมเดล คำสั่ง เครื่องมือ และความพยายามระดับ medium ไว้เพื่อแคชพรอมต์ GPT-6 Sol รันทดสอบที่มองเห็นได้ระหว่างทำงาน แต่ก็เขียนการทดสอบใหม่ส่วนใหญ่ด้วย จึงใช้เป็นการตรวจอิสระไม่ได้
การคุมทิศทางกลางเทิร์นจะเพิ่มคำสั่งให้กับการตอบกลับที่กำลังรัน โดยไม่ยกเลิกมัน หลังจาก response.created ส่ง response.steer บนการเชื่อมต่อเดียวกันพร้อม ID ของการตอบกลับนั้น แล้วเซิร์ฟเวอร์จะใช้คำสั่งในคำตอบถัดไป
ข้อกำหนดใหม่มาจากทีมหน้าร้าน: ลายเซ็นของ CheckoutClient "ต้องคงเหมือนวันนี้ทุกประการ" เพราะมีบริการอื่นเรียกใช้ ไม่อยากให้ตัวจับเวลาเป็นคนกำหนดจังหวะ จึงให้ฮาร์เนสดูรีโพสิทอรีแทน หลังแต่ละชุดการเรียกเครื่องมือ จะเทียบลายเซ็นสาธารณะบนดิสก์กับต้นฉบับ และความต่างครั้งแรกจะเตรียมการคุมทิศทาง:
if steer_state == "idle" and signature_changes(repo):  # CheckoutClient, compared with ast
    steer_state = "armed"

if event.type == "response.created" and steer_state == "armed":
    conn.response.steer(previous_response_id=event.response.id, input=STEER_TEXT)
    steer_state = "sent"
นั่นรับประกันว่าคำสั่งจะมาหลังการเปลี่ยนชื่อที่มันขัดกับ ซึ่งเป็นสถานการณ์ที่ควรทดสอบ ถ้าส่งก่อน ก็แค่พรอมต์ที่ยาวขึ้น
จากนั้นเซิร์ฟเวอร์รายงานวงจรชีวิตของการคุมทิศทาง:
response.steer.accepted หมายถึงการอัปเดตถูกเข้าคิว ยังไม่ถูกใช้
response.incomplete จบการตอบกลับเดิมด้วยเหตุผล steered
คำตอบผู้สืบทอด response.created ดำเนินต่อด้วยข้อกำหนดใหม่
หากการตอบกลับกำลังรอผลลัพธ์จากเครื่องมือ เซิร์ฟเวอร์จะส่ง response.steer.pending และพักการคุมทิศทางไว้จนกว่าฮาร์เนสจะส่งคืนผล จงตอบการเรียกเครื่องมือต่อไปในระหว่างที่การคุมทิศทางยังค้างอยู่
การคุมทิศทางเปลี่ยนสิ่งที่โมเดลจะทำต่อไป คู่มือของ OpenAI ชัดเจนกับส่วนที่เหลือ: การคุมทิศทางไม่เขียนทับเอาต์พุตที่ส่งไปแล้ว ไม่ย้อนการกระทำก่อนหน้า และไม่ยกเลิกเครื่องมือที่เริ่มทำงานไปแล้ว
เมื่อคำสั่งมาถึง การเปลี่ยนชื่ออยู่บนดิสก์ใน client.py แล้ว GPT-6 Sol ย้อนกลับ และการตรวจลายเซ็นที่กันไว้ยืนยันอินเทอร์เฟซสุดท้าย
การแก้ไขสามารถย้อนกลับได้ เครื่องมือที่เรียกระบบภายนอกไปแล้วจะไม่มีอะไรให้ย้อน ดังนั้นจงบันทึกสถานะรีโพสิทอรีเมื่อคำสั่งแต่ละครั้งมาถึง
ในรีโพนี้ทำได้ แม้ไม่จบในครั้งเดียว การย้ายครั้งแรกเป็นไปตามสัญญาเดิม จากนั้นดีพลอยโปรบเผยกรณีที่ตกหล่น
เมื่อ GPT-6 Sol รายงานว่าย้ายเสร็จ ชุดที่กันไว้ผ่านโดยไม่ต้องซ่อม รอบการคืนเงิน GPT-6 Sol แทนที่การบวกด้วยการอ่านยอดสะสมที่ยังละเว้น webhook ที่มาไม่ตามลำดับด้วย:
-        order.refunded_cents += data["amount_refunded"]
+        order.refunded_cents = max(order.refunded_cents, refunded["cents"])
สำหรับ idempotency GPT-6 Sol คงการใช้ order_id ใหม่ในแต่ละครั้ง และเพิ่มแคชคำขอในสโตร์ออร์เดอร์ที่ตอบคำขอซ้ำก่อนถึง v2 แคชนั้นอยู่ในหน่วยความจำของโพรเซส ซึ่งจะมีความสำคัญในอีกครู่
ได้ รายงานแรกเรียกการทดสอบ webhook ที่อัปเดตว่าเป็นการถดถอย และละความเสี่ยงจากการลองใหม่ข้ามเซิร์ฟเวอร์ ทั้งที่แผนได้ระบุกับดักนั้นไว้แล้ว
Structured Outputs ตรวจสคีมา ไม่ใช่ข้อกล่าวเหล่านั้น ตรวจฟิลด์รายงานเทียบกับหลักฐานที่บันทึกไว้ และอย่าถือว่ารายการความเสี่ยงว่างเปล่าเป็นหลักฐานว่าไม่มีความเสี่ยงคงเหลือ
ชุดดังกล่าวพลาดการลองใหม่ที่ถูกส่งไปอินสแตนซ์แอปอีกตัว จึงเพิ่มดีพลอยโปรบด้วยไคลเอนต์สองตัวที่ใช้โปรเซสเซอร์การชำระเงินร่วมกัน แต่ไม่แชร์หน่วยความจำของโพรเซส
โปรบล้มเหลว การลองใหม่บนอินสแตนซ์ที่สองยก payments_adapter_v2.IdempotencyConflict ซึ่งเป็น exception ของตัวเชื่อมต่อที่หน้าร้านไม่ควรเห็นเลย
มีเพียงการดีพลอยด้วยมากกว่าหนึ่งโพรเซสเท่านั้นที่เผยความล้มเหลวนี้ ซึ่งจะเป็นตัวกระตุ้นการยกระดับความพยายามในการให้เหตุผล
รายการอินพุตแบบ configuration_update จะเปลี่ยนความพยายามในการให้เหตุผลสำหรับคำตอบถัดไปและทุกคำตอบถัดจากนั้น จนกว่าจะมีการอัปเดตใหม่แทนที่ ระดับความพยายามที่ระดับคำขอจะคงเดิม จึงรักษา prefix ที่แคชไว้ เมื่อโปรบล้มเหลว ฮาร์เนสส่งคำขอนี้ ตามคู่มือการให้เหตุผล:
คำขอย้ายใช้ store=True ดังนั้นหลังปิด WebSocket ฮาร์เนสสามารถดำเนินสายการตอบที่บันทึกไว้ต่อด้วยคำขอ Responses API ปกติ
response = client.responses.create(
    model="gpt-6-sol", reasoning={"effort": "medium"},  # unchanged, so the prefix survives
    instructions=INSTRUCTIONS, tools=TOOLS, tool_choice=allowed(DIAGNOSE_TOOLS),
    previous_response_id=last_id,
    input=[{"type": "configuration_update", "reasoning": {"effort": "high"}},
           {"role": "user", "content": probe_failure + DIAGNOSE_FIRST}],
)
active_effort = "high"  # the harness records it; the response won't
GPT-6 Sol ได้รับความล้มเหลวและรูปแบบการดีพลอย แต่ไม่มีคำใบ้เกี่ยวกับวิธีแก้ DIAGNOSE_TOOLS อนุญาตการอ่านและทดสอบ ไม่ใช่การแก้ไข การคงเครื่องมือและ text.format เดิมจะคง prefix ที่แคชไว้
รายละเอียด API หนึ่งอย่างที่น่ารำคาญ: response.reasoning.effort ยังรายงานค่าระดับคำขอหลังการอัปเดต ฮาร์เนสจึงอ่านค่าความพยายามที่ใช้งานจากการตอบไม่ได้ ต้องบันทึกค่าเองเมื่อส่งอัปเดต และติดแท็กการตอบทุกครั้งหลังจากนั้นด้วยค่าเดียวกัน
high ใช้งานได้หรือไม่?ได้ GPT-6 Sol ไล่หาความล้มเหลวไปยังสโตร์โลคัลของเซิร์ฟเวอร์ที่สอง แล้วตามรอย order ID ใหม่เข้าไปในเมทาดาทาการชำระเงิน โปรเซสเซอร์ที่แชร์เห็นพารามิเตอร์ต่างกันสำหรับ request_id เดิม
วิธีแก้ทำให้ order ID เป็นฟังก์ชันของ request ID เพื่อให้ทุกเซิร์ฟเวอร์คำนวณได้เหมือนกัน:
-def new_order_id() -> str:
+def new_order_id(request_id: str | None = None) -> str:
+    if request_id:
+        stable = uuid.uuid5(uuid.NAMESPACE_URL, f"northstar.checkout.order:{request_id}")
+        return f"ord_{stable.hex[:12]}"
     return f"ord_{uuid.uuid4().hex[:12]}"
GPT-6 Sol ยังเพิ่มการทดสอบที่มองเห็นได้สำหรับกรณีนี้ โปรบและชุดการยอมรับผ่าน แล้ว
configuration_update ตั้งค่าความพยายามกลับเป็น medium รายงานสุดท้ายอธิบายความล้มเหลวจริงได้อย่างแม่นยำในครั้งนี้
แอป Streamlit ของโปรเจ็กต์เล่นซ้ำการรันที่บันทึกไว้โดยไม่เรียก API วิดีโอเริ่มจากภาพรวมไปยังอีเวนต์การคุมทิศทาง และปิดท้ายด้วยผลการยอมรับและโปรบ
เรียนรู้กับ DataCamp
Courses
Courses
Courses