강의
PyTorch로 배우는 Transformer 모델
2시간
9.2K
KTransformers는 오픈 소스 추론 프레임워크로, 추론 중에 CPU와 GPU가 서로 다른 전문가(expert)를 적극적으로 실행할 수 있게 해 MoE(Mixture-of-Experts) 모델을 GPU 메모리보다 훨씬 큰 규모로도 실행할 수 있습니다. vLLM 같은 프레임워크도 가중치를 CPU 메모리로 오프로딩할 수 있지만, KTransformers는 MoE 모델의 희소 구조에 맞춰 특별히 설계되었습니다.
이 튜토리얼에서는 KTransformers와 SGLang을 사용해 192 GB의 VRAM에도 들어가지 않는 320B 파라미터 모델인 GLM-5.3-Flash를 실행합니다. CPU와 GPU 메모리 사용량을 모니터링하고, 전문가 배치를 실험하며, OpenAI 호환 API를 테스트한 뒤, 모델을 Pi에 연결해 로컬 코딩 에이전트로 활용해 보겠습니다.
핵심 아이디어는 단순합니다. CPU 메모리를 단순한 오버플로 스토리지로 취급하는 대신, KTransformers는 추론 중 CPU 연산과 GPU 연산을 함께 활용합니다.
KTransformers는 오픈 소스 추론 프레임워크로, GPU VRAM과 CPU RAM을 조합해 초대형 언어 모델을 실행합니다. 일반적으로 대형 모델을 서빙하려면 대부분의 가중치를 GPU 메모리에 적재해야 하며, GLM-5.3-Flash 같은 모델 규모에서는 금세 비용이 커집니다.
KTransformers는 다른 접근을 취합니다. 다수의 MoE 전문가 가중치를 시스템 메모리에 유지하고, GPU 가속의 이점을 가장 크게 받는 추론 경로에 GPU 메모리를 할당합니다.
이 방식은 모든 토큰에서 모든 전문가가 사용되지 않는 MoE 모델에 특히 잘 맞습니다. 예를 들어 GLM-5.3-Flash에는 288개의 라우팅 전문가가 있지만, 라우터는 토큰마다 8개(공유 전문가 1개 포함)를 선택합니다. 따라서 KTransformers는 전문가 연산을 CPU와 GPU에 분산할 수 있습니다.
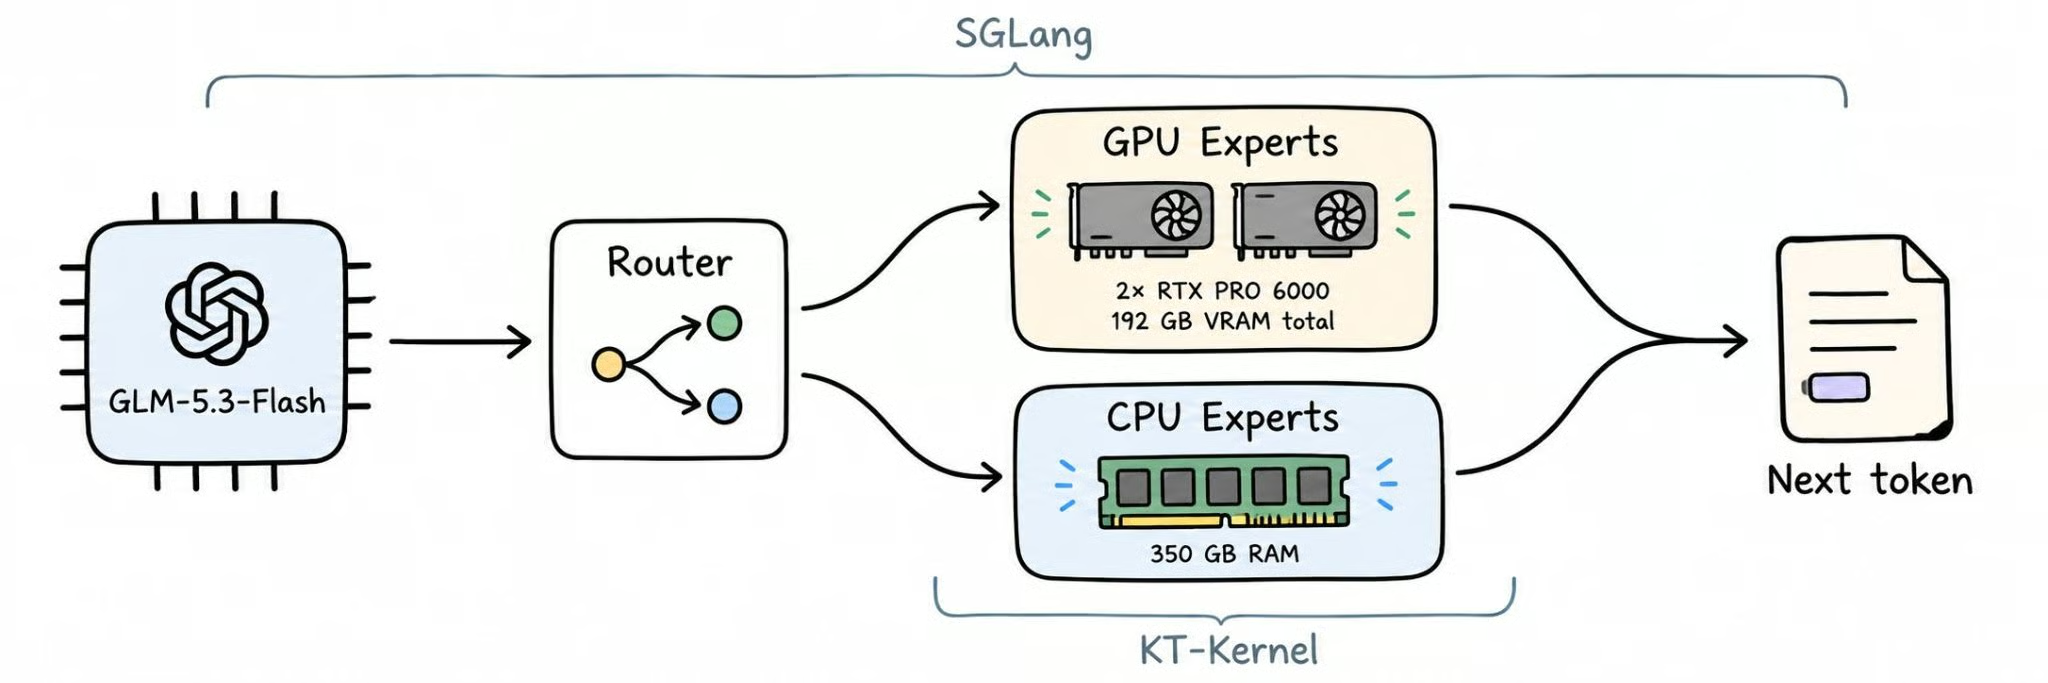
현재 KTransformers 스택은 이종 CPU-GPU 추론을 위해 KT-Kernel과 SGLang을 통합합니다. 각 구성 요소는 역할이 다릅니다.
KTransformers는 또한 워크로드 패턴에 따라 전문가 배치를 변경하는 기능을 지원하며, 이는 전문가 스케줄링 튜토리얼에 설명되어 있습니다.
즉, KTransformers는 전체 모델이 GPU VRAM에 들어가야 한다고 요구하는 대신, CPU 메모리와 GPU 메모리를 하나의 추론 시스템으로 취급합니다. 이것이 매우 큰 MoE 모델을 보통 필요로 하는 GPU 메모리보다 훨씬 적은 GPU 메모리로도 실행할 수 있게 해줍니다.
GLM-5.3-Flash는 Z.ai가 2026년 8월 MIT 라이선스로 공개한 오픈 웨이트, 네이티브 멀티모달 MoE 모델입니다. 이름에 "Flash"가 들어가지만 규모는 큽니다. 총 320B 파라미터이며, 토큰당 활성 파라미터는 약 18B입니다.
로컬 추론에 중요한 사양은 다음과 같습니다.
zai-org/GLM-5.3-Flash) 기준 약 306 GiBKTransformers는 공식 FP8 가중치를 직접 읽으므로 변환이나 추가 양자화 단계가 필요 없습니다. 벤치마크와 전체 모델 개요는 GLM-5.3-Flash 가이드를 참고하세요.
GLM-5.3-Flash의 경우 하드웨어는 주로 시스템 RAM 용량이 관건입니다. 공식 KTransformers GLM-5.3-Flash 튜토리얼은 최소 350 GB의 사용 가능한 시스템 메모리 확보를 권장합니다.
이 튜토리얼에서는 대략 다음과 같은 사양의 RunPod 인스턴스를 사용합니다.
GPU:         2× RTX PRO 6000
VRAM:        96 GB each
Total VRAM:  192 GB

System RAM:  350 GB+
Storage:     500 GB+
Python:      3.11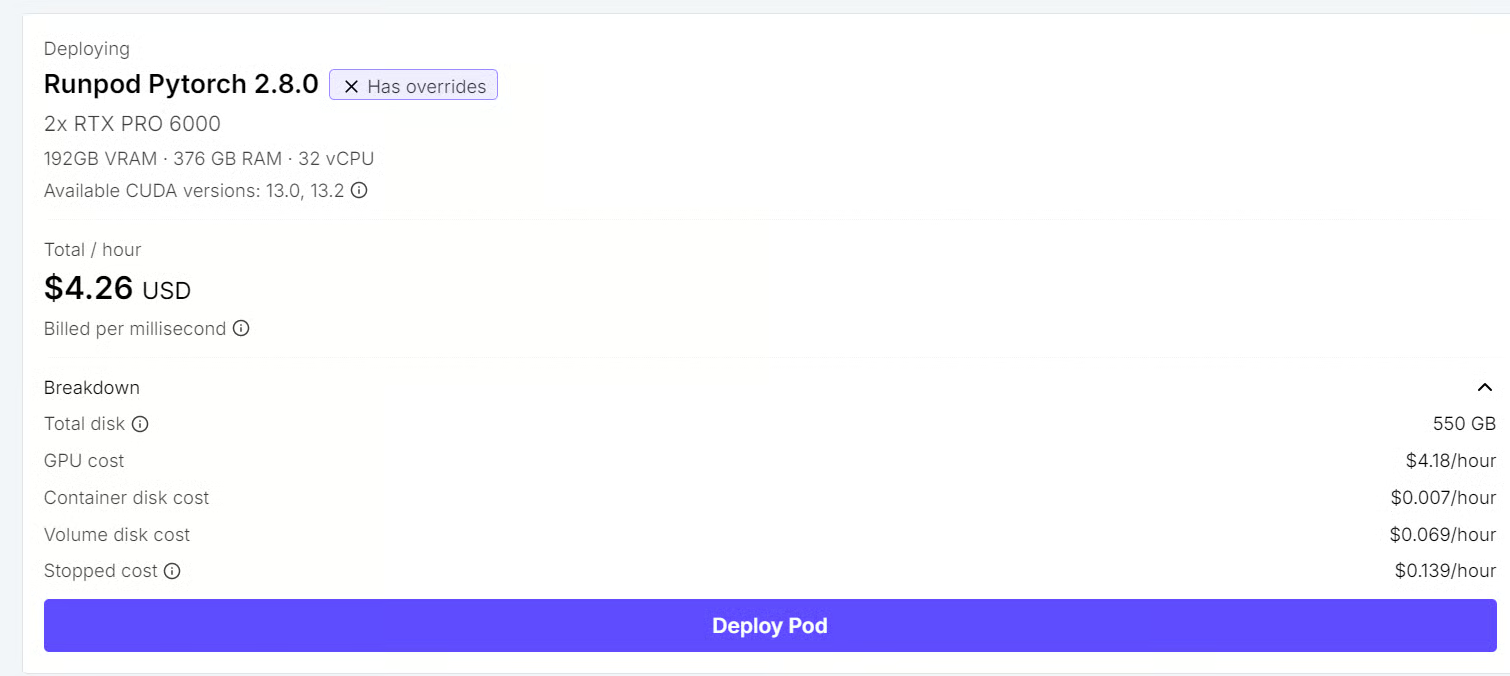
GLM-5.3-Flash의 공식 FP8 체크포인트는 약 306 GiB(약 329 GB)이고, 우리의 두 GPU는 총 192 GB의 VRAM을 제공합니다. 따라서 전체 모델을 GPU 메모리에 단순 적재하는 것은 불가능합니다.
대신 KTransformers는 MoE 가중치의 상당 부분을 시스템 RAM에 유지하고, 가장 유용한 연산을 GPU로 이동합니다. 350 GB 권장은 모델 가중치와 런타임 오버헤드를 감안한 여유를 제공합니다.
GPU 메모리가 많다고 해서 이 구성에서 RAM 필요성이 사라지지는 않습니다. CPU 메모리는 KTransformers의 이종 추론 설계에서 의도된 요소입니다. 전문가 가중치는 RAM에 남고, GPU는 가속의 이점을 가장 크게 받는 모델 부분을 처리합니다.
현재 GLM-5.3-Flash 구현에는 다음과 같은 CPU 및 GPU 요구 사항도 있습니다.
가능합니다. 충분한 시스템 RAM과 지원되는 CPU가 있다면 됩니다. 공식 튜토리얼에는 --kt-num-gpu-experts 0을 설정하는 단일 GPU 구성이 포함되어 있어, MoE 전문가는 CPU 측에서 처리됩니다.
여기서는 RTX PRO 6000 GPU 2개를 사용하지만, 이는 엄격한 최소 요구 사항이 아닙니다. 두 번째 GPU는 VRAM과 여유 공간을 더해, 가능한 최소 하드웨어에 맞춰 세팅을 극한까지 조정하기보다 비교적 새 구현인 KTransformers를 실험할 때 안정적으로 테스트하기 위함입니다.
깨끗한 Python 3.11 환경을 만들고 SGLang 지원과 함께 KTransformers를 설치합니다.
python3.11 -m venv /workspace/kt
source /workspace/kt/bin/activate

pip install --upgrade pip
pip install "ktransformers[sglang]"
KTransformers, KT-Kernel, SGLang, CUDA가 올바르게 감지되는지 확인합니다.
kt version다음과 유사한 출력이 표시됩니다.
KTransformers CLI v0.7.0.post4

Python      3.11.13
Platform    Linux 6.8.0-136-generic
CUDA        13.0

Packages:
kt-kernel   0.7.0.post4
sglang-kt   0.7.0.post4
이는 KTransformers 런타임과 SGLang 백엔드가 설치되어 사용할 준비가 되었음을 의미합니다.
서버를 시작하기 전에 Hugging Face에서 공식 GLM-5.3-Flash 체크포인트를 다운로드합니다.
hf download zai-org/GLM-5.3-Flash \
  --local-dir /workspace/GLM-5.3-Flash
체크포인트는 약 306 GiB이므로, 대역폭에 따라 다운로드에 시간이 걸릴 수 있습니다.
그다음 KTransformers에 로컬 모델 경로를 지정합니다.
export MODEL_PATH=/workspace/GLM-5.3-Flash이제 RTX PRO 6000 두 개를 모두 사용하는 2-way 텐서 병렬로 GLM-5.3-Flash를 실행합니다. 모델은 최대 1M 토큰의 컨텍스트를 지원하며, 공식 예시는 검증된 501,025 토큰 구성을 사용합니다. 여기서는 테스트 동안 메모리 사용량을 예측 가능하게 유지하기 위해 32K 컨텍스트 윈도우로 시작합니다.
CUDA_VISIBLE_DEVICES=0,1 \
python -m sglang.launch_server \
  --model-path "$MODEL_PATH" \
  --kt-weight-path "$MODEL_PATH" \
  --served-model-name GLM-5.3-flash \
  --host 0.0.0.0 \
  --port 30000 \
  --tp-size 2 \
  --context-length 32768 \
  --max-total-tokens 32768 \
  --mem-fraction-static 0.85 \
  --chunked-prefill-size 2048 \
  --kt-method FP8 \
  --kt-cpuinfer 64 \
  --kt-threadpool-count 2 \
  --kt-num-gpu-experts 14 \
  --kt-gpu-prefill-token-threshold 2048 \
  --kt-expert-placement-strategy uniform \
  --cuda-graph-bs 1 2 4 \
  --enable-p2p-check \
  --tool-call-parser glm47 \
  --reasoning-parser glm45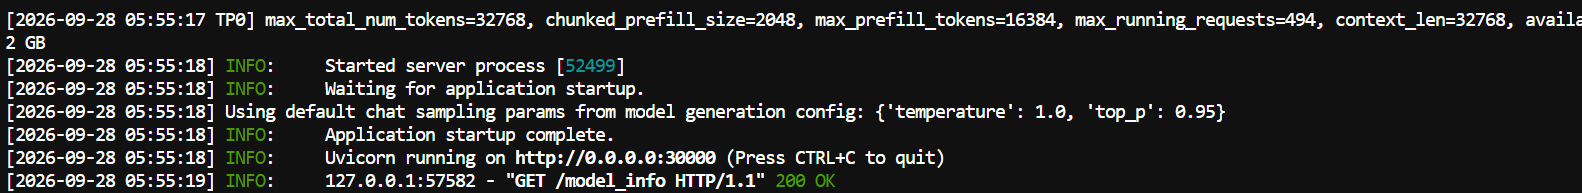
이 구성은 포트 30000에서 OpenAI 호환 SGLang 서버를 통해 모델을 노출합니다. 두 GPU는 --tp-size 2로 사용되며, KTransformers는 MoE 워크로드의 일부를 CPU에 유지하고 선택한 전문가를 GPU에 배치합니다.
여기 설정은 첫 실행에 맞춰 의도적으로 보수적입니다. 32K 컨텍스트, 85% 정적 GPU 메모리 사용, GPU 전문가 14명, CPU 추론 스레드 64개입니다. 서버가 안정화되면 처리량 향상을 위해 더 큰 컨텍스트 윈도우, 더 많은 GPU 전문가, 다른 메모리 설정을 실험해 볼 수 있습니다.
위 플래그 대부분은 표준 SGLang 옵션입니다. 다음은 KTransformers가 CPU와 GPU 간에 작업을 분할하는 방식을 제어하는 항목입니다.
| Flag | Value | 기능 |
|---|---|---|
--kt-method |
FP8 |
전문가 가중치의 정밀도를 설정하며, GLM-5.3-Flash의 네이티브 FP8 체크포인트와 일치합니다. |
--kt-cpuinfer |
64 |
전문가 연산에 사용할 CPU 스레드 수입니다. |
--kt-threadpool-count |
2 |
CPU 스레드 풀 수로, 일반적으로 NUMA 노드 수와 맞춥니다. |
--kt-num-gpu-experts |
14 |
MoE 레이어당 GPU에 배치할 전문가 수입니다. |
--kt-expert-placement-strategy |
uniform |
GPU 전문가를 선택하는 방식입니다. 다른 옵션으로는 frequency, front-loading, random이 있습니다. |
--kt-gpu-prefill-token-threshold |
2048 |
프롬프트 길이가 이 값을 넘으면 프리필이 GPU 측 레이어와이즈 경로로 전환됩니다. |
서버가 실행 중이므로 이제 KTransformers가 GPU VRAM과 시스템 RAM을 어떻게 사용하는지 확인한 뒤, GPU 상주 전문가 수를 변경해 자원 사용량과 성능 변화를 살펴봅니다.
RunPod에서 free -h는 컨테이너가 파드에 할당된 메모리가 아니라 호스트 머신의 전체 RAM을 볼 수 있어 오해의 소지가 있습니다. GPU 메모리와 컨테이너 메모리를 별도로 모니터링하는 것이 좋습니다.
새 터미널을 열고 GPU 사용량을 모니터링합니다.
watch -n 1 nvidia-smi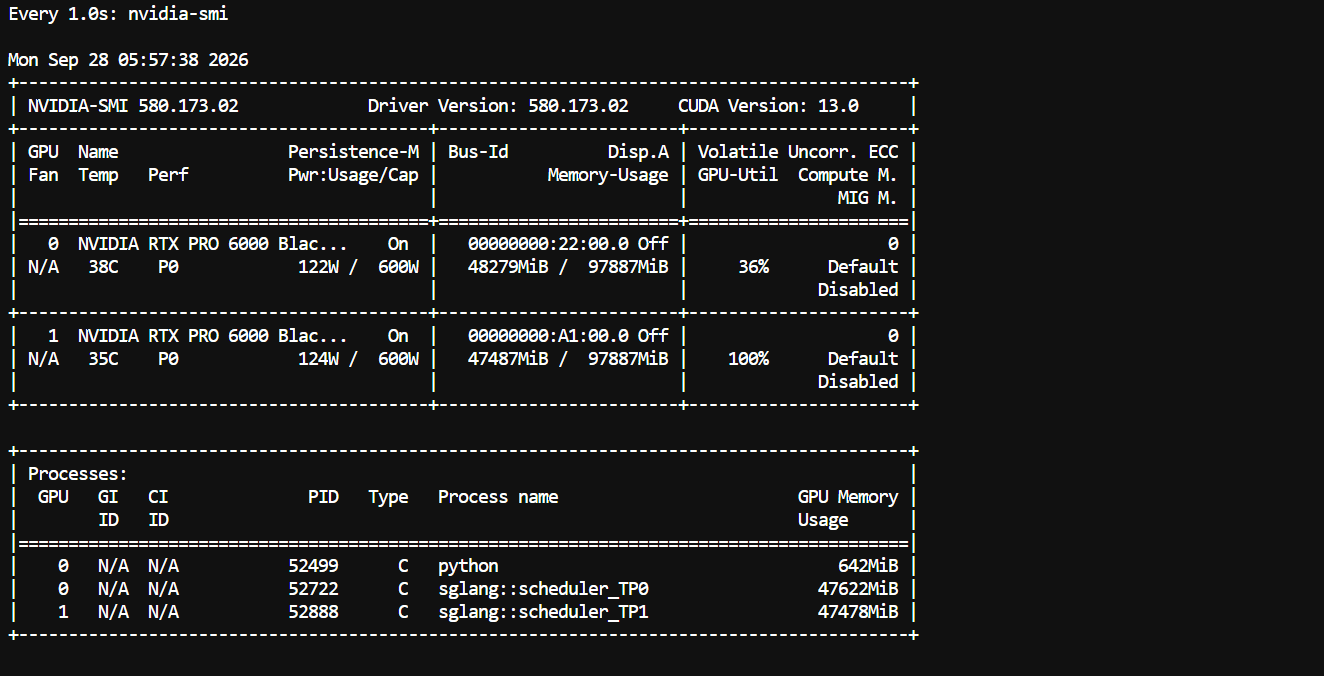
현재 구성에서는 모델이 완전히 적재되어도 GPU당 약 48 GB만 사용되어, 많은 VRAM이 남습니다. 이는 더 많은 전문가를 GPU에 배치하거나 충분한 시스템 RAM이 있다면 단일 GPU 구성도 시험해 볼 여지가 있음을 시사합니다.
컨테이너 RAM은 cgroup 메모리 카운터를 직접 확인하세요.
watch -n 1 'echo -n "Used: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.current; echo -n "Limit: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.max'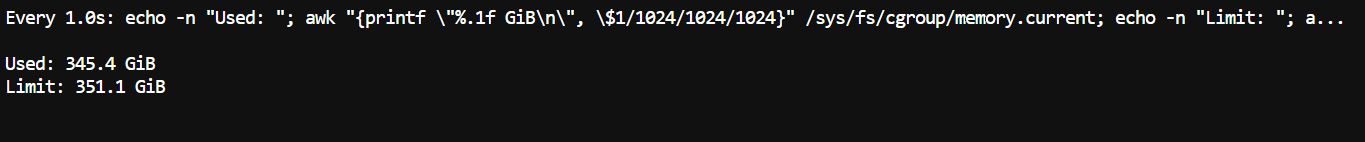
사용 가능한 시스템 RAM 중 상당 부분이 모델 가중치와 CPU 측 전문가가 차지하는 것을 볼 수 있을 것입니다. 이는 정상입니다. KTransformers는 모든 전문가가 VRAM에 있어야 한다고 요구하는 대신, 많은 MoE 전문가를 RAM에 의도적으로 유지합니다.
--kt-num-gpu-experts 튜닝다음으로 --kt-num-gpu-experts 값을 바꿔 서버를 재시작합니다. 예를 들어 다음을 비교해 보세요.
0
10
20--kt-num-gpu-experts는 MoE 레이어당 GPU에 배치할 전문가 수를 제어합니다. 0이면 전문가 연산은 CPU 측에 머물고, 값을 높이면 더 많은 전문가가 GPU 메모리로 이동합니다.
구성마다 GPU VRAM 사용량, 컨테이너 RAM 사용량, 초당 토큰 수, 첫 토큰까지의 시간을 비교하세요. 일반적으로 GPU 전문가를 늘리면 VRAM 사용량은 증가하지만 CPU 측 전문가 실행이 줄어들어, 충분한 VRAM이 있을 때 추론 성능이 향상될 수 있습니다.
공식 튜토리얼의 한 가지 주의점: GLM-5.3-Flash에서 Layerwise Prefill이 활성화된 경우, 현재 구현은 상주 GPU 전문가 수를 0으로 정규화합니다. 실행 간 VRAM 사용량 변화가 거의 없다면 이 때문일 가능성이 큽니다.
이 실험은 KTransformers의 핵심 장점을 보여줍니다. CPU RAM과 GPU VRAM을 하나의 추론 시스템 내에서 조절 가능한 요소로 만들어, 전체 MoE 모델이 GPU에 전부 들어가야 하는 요구 대신 메모리 배치와 속도 간의 균형을 선택할 수 있게 합니다.
서버가 실행 중이므로 이제 모델이 사용 가능한지 확인하고 SGLang의 OpenAI 호환 API를 통해 실제 요청을 보냅니다.
먼저 모델이 등록되었는지 확인합니다.
curl http://localhost:30000/v1/models이어서 테스트 프롬프트를 보냅니다.
curl http://localhost:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "GLM-5.3-flash",
    "messages": [
      {
        "role": "user",
        "content": "Create a FastAPI application with a health endpoint."
      }
    ],
    "max_tokens": 500
  }'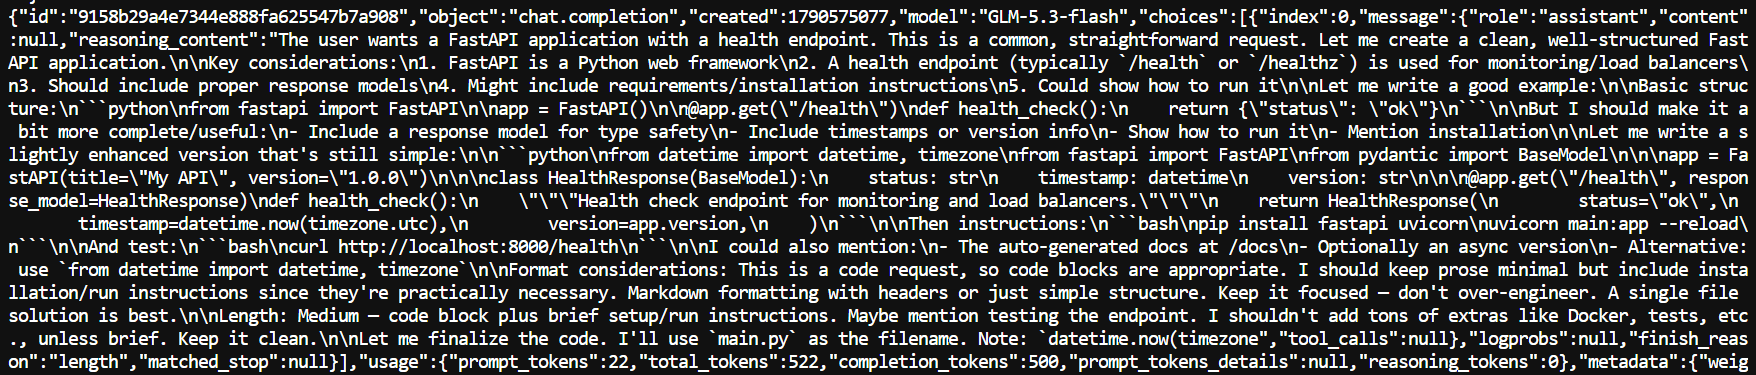
구성이 제대로 동작한다면, 서버는 생성된 코드와 사용 통계를 포함한 일반적인 채팅 완성 응답을 반환합니다.
Pi는 어떤 OpenAI 호환 모델도 백엔드로 사용할 수 있는 경량 코딩 에이전트입니다. 이를 통해 GLM-5.3-Flash를 프롬프트 응답뿐 아니라 실제 코딩 작업에 직접 활용할 수 있습니다.
설치 스크립트로 Pi를 설치합니다.
curl -fsSL https://pi.dev/install.sh | sh
그다음 PATH에 Pi를 추가합니다.
echo 'export PATH="/root/.local/share/pi-node/current/bin:$PATH"' >> ~/.bashrc
source ~/.bashrcPi가 로컬 KTransformers 서버를 가리키도록 모델 구성을 만듭니다.
mkdir -p ~/.pi/agent && cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "ktransformers": {
      "baseUrl": "http://localhost:30000/v1",
      "api": "openai-completions",
      "apiKey": "local",
      "models": [
        {
          "id": "GLM-5.3-flash",
          "name": "GLM-5.3-Flash",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 32768,
          "maxTokens": 8192,
          "cost": {
            "input": 0,
            "output": 0,
            "cacheRead": 0,
            "cacheWrite": 0
          }
        }
      ]
    }
  }
}
EOF
Pi를 시작합니다.
pi그다음 모델 선택기를 엽니다.
/model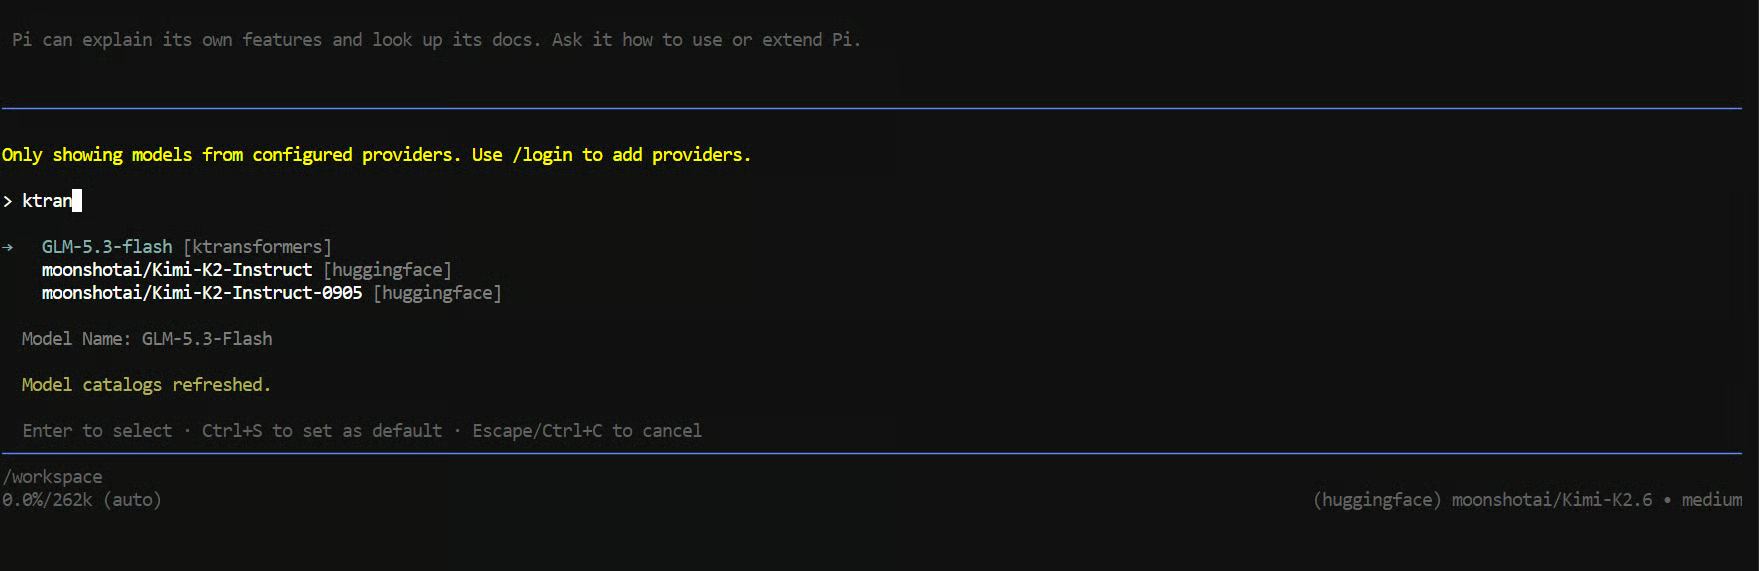
GLM-5.3-Flash를 선택하고 실제 코딩 작업을 시도해 보세요.
Build a FastAPI service with /health and /users endpoints.
Add pytest tests and run them.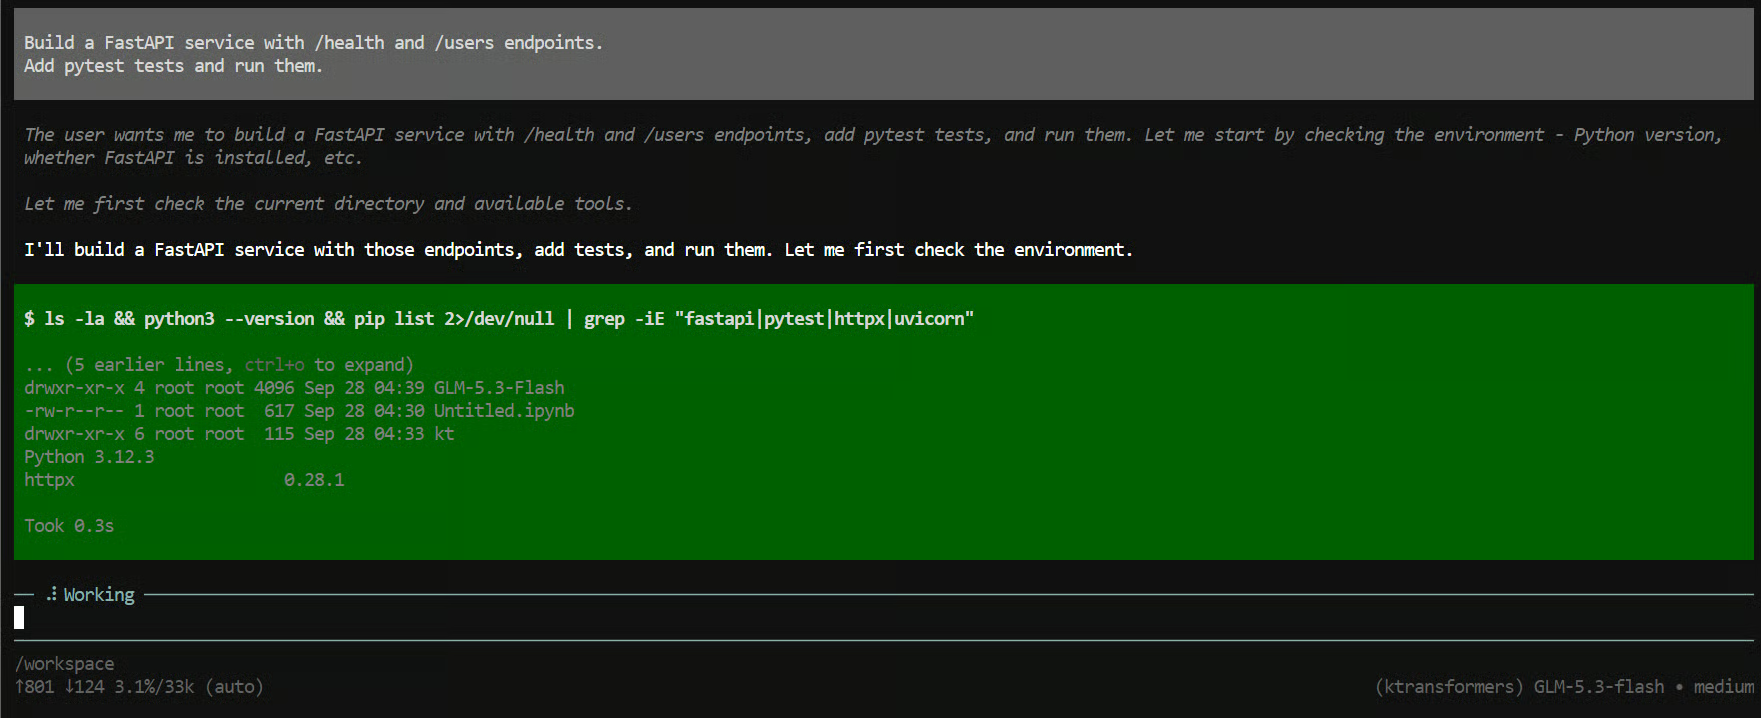
몇 초 내에 Pi가 파일을 생성하고, API를 작성하며, 테스트를 실행하고, 작업을 진행하면서 문제를 수정하기 시작할 것입니다.
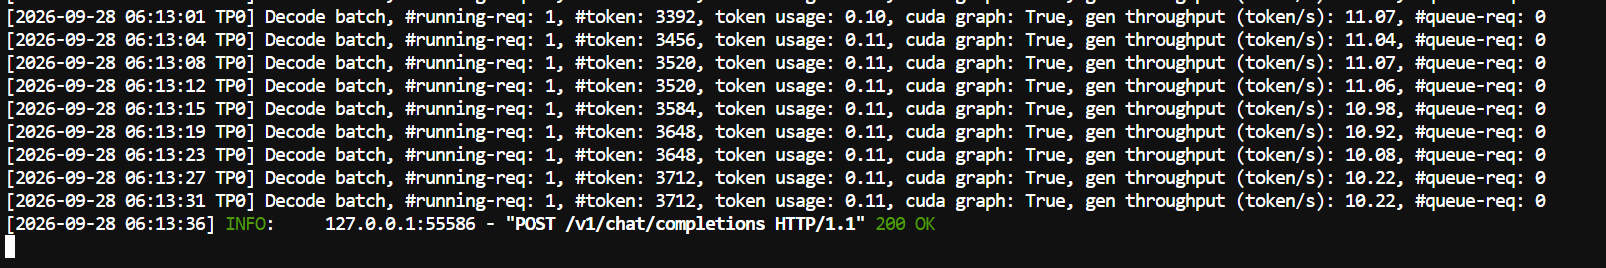
SGLang 서버가 실행 중인 첫 번째 터미널을 지켜봐도 됩니다. 우리의 테스트에서 생성 속도는 초당 약 11 토큰이었습니다. 이는 상당한 CPU 오프로딩과 함께 이 정도 규모의 모델을 실행할 때 합리적인 수치이며, 더 많은 전문가를 GPU로 옮겨 추가로 튜닝할 수 있습니다.
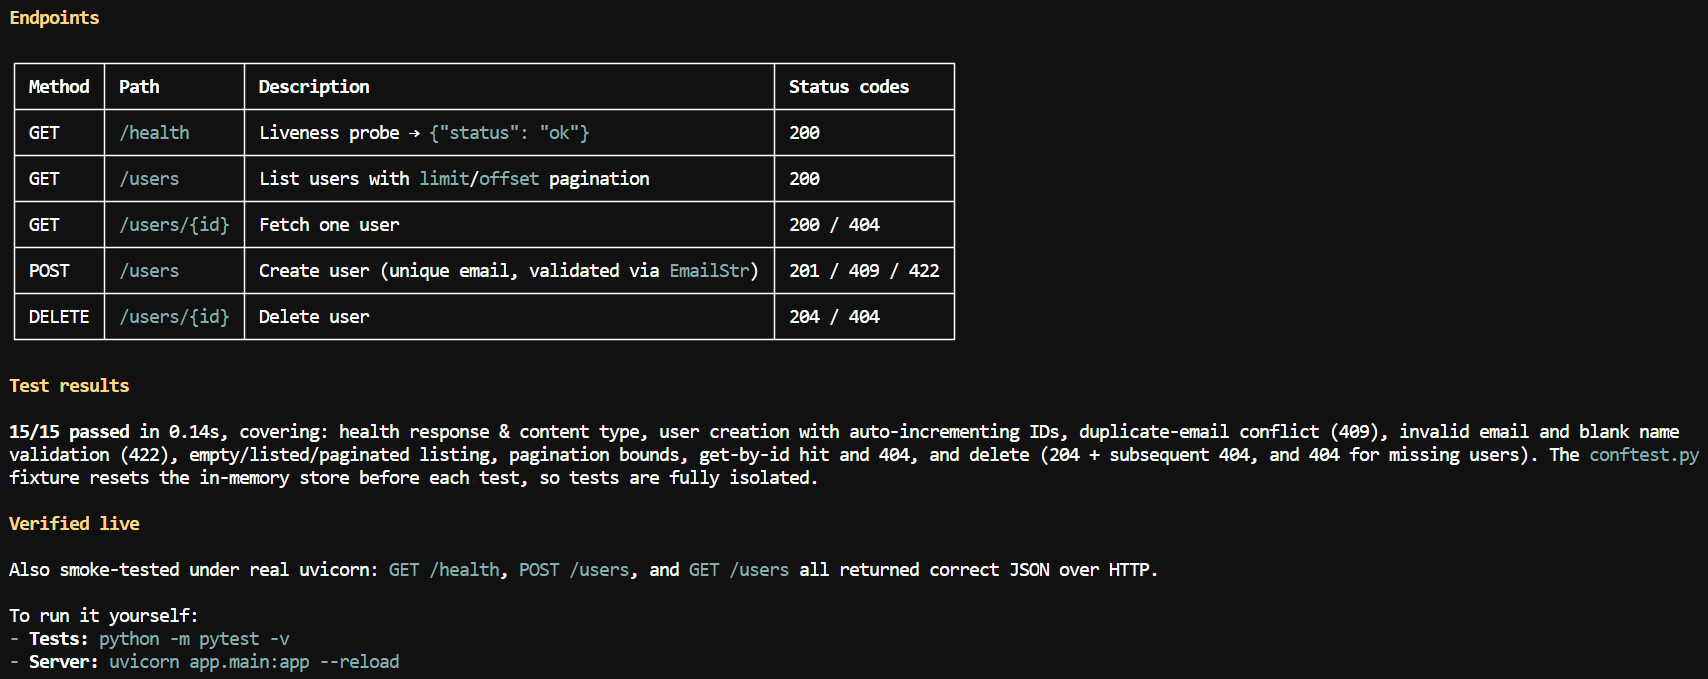
몇 분 안에 모델은 엔드포인트를 만들고, 테스트를 작성 및 실행하며, 스모크 테스트를 수행하고, 프로젝트 실행 방법을 설명하는 간단한 요약을 생성했습니다.
흥미로운 점은 가중치가 사용 가능한 GPU VRAM보다 훨씬 큰데도 전체 모델이 로컬에서 실행되고 있다는 사실입니다. 코딩 에이전트 루프는 Pi가 처리하고, 실제 모델 추론은 SGLang과 KTransformers가 담당합니다.
VRAM보다 큰 모델을 실행하는 방법은 KTransformers만 있는 것이 아닙니다. vLLM과 llama.cpp도 CPU 오프로딩을 지원하지만, 작업을 분할하는 방식이 다릅니다.
| 프레임워크 | CPU 메모리 사용 방식 | 전문가 연산 위치 | 적합한 용도 |
|---|---|---|---|
| vLLM | 가중치 일부를 CPU RAM으로 오프로딩(--cpu-offload-gb)하고 필요 시 GPU로 전송 |
GPU | 모델이 대부분 VRAM에 들어갈 때 고처리량 서빙 |
| llama.cpp | 레이어를 CPU와 GPU로 분할하고, MoE 전문가 텐서를 RAM에 유지 가능(--n-cpu-moe) |
CPU와 GPU | 소비자용 하드웨어에서의 양자화 GGUF 모델 |
| KTransformers + SGLang | 대부분의 전문가를 RAM에 두고 레이어당 일정 수의 전문가를 GPU에 배치 | CPU와 GPU(AVX-512 최적화 전문가 커널) | 수백 GB RAM을 갖춘 머신에서 네이티브 정밀도 MoE 모델 |
이 구성에서 SGLang과 KTransformers는 경쟁 관계가 아닙니다. SGLang은 서빙을, KTransformers는 이종 CPU-GPU MoE 실행을 담당합니다.
이 구성에서 가장 마음에 들었던 점은 KTransformers가 흔한 추론 스택과는 조금 다르게 접근한다는 것입니다. 모델 레이어만을 관점으로 보지 않고, 개별 전문가를 GPU에 배치하는 한편 다른 전문가는 시스템 RAM에 둡니다. 그리고 CPU가 실제로 전문가 연산에 참여합니다. CPU를 단순한 오버플로 스토리지로만 쓰지 않습니다.
이 튜토리얼에서는 가중치가 사용 가능한 VRAM보다 훨씬 크지만, RTX PRO 6000 GPU 두 개로 전체 GLM-5.3-Flash 모델을 로컬에서 실행했습니다.
가장 빠른 구성은 아닙니다. 초당 약 11 토큰 정도였고, GPU 전문가 수와 배치를 더 조정할 여지가 많습니다. 충분한 RAM이 있다면 단일 GPU로도 실험할 수 있습니다. 여기서는 여유를 두기 위해 GPU 두 개를 사용했습니다.
개인적으로 이 가이드의 핵심은 다음과 같습니다. KTransformers가 CPU 오프로딩을 처음 도입해서 특별한 게 아니라, MoE 모델의 희소 구조를 중심으로 CPU RAM, CPU 연산, GPU 연산이 함께 작동하도록 만든 점이 특별합니다.
Top DataCamp Courses
강의
트랙
트랙