Kurs
Transformermodeller med PyTorch
2 tim
9.2K
KTransformers är ett open source-inferensramverk som låter CPU och GPU aktivt köra olika experter under inferens, så att du kan köra Mixture-of-Experts (MoE)-modeller som är betydligt större än ditt GPU-minne. Ramverk som vLLM kan också lasta över vikter till CPU-minne, men KTransformers är byggt specifikt kring MoE-modellers glesa struktur.
I den här handledningen använder vi KTransformers och SGLang för att köra GLM-5.3-Flash, en modell med 320 miljarder parametrar vars vikter inte ryms i 192 GB VRAM. Vi ska övervaka CPU- och GPU-minnesanvändning, experimentera med expertplacering, testa det OpenAI-kompatibla API:et och koppla modellen till Pi som en lokal kodagent.
Huvudidén är enkel: i stället för att behandla CPU-minne som överflödeslagring använder KTransformers både CPU- och GPU-beräkning under inferens.
KTransformers är ett open source-inferensramverk för att köra mycket stora språkmodeller med en kombination av GPU-VRAM och CPU-RAM. Normalt kräver servering av en stor modell att de flesta vikter lastas in i GPU-minnet, vilket snabbt blir dyrt för en modell i storleken GLM-5.3-Flash.
KTransformers tar ett annat grepp: det behåller många MoE-expertvikter i systemminnet och reserverar GPU-minnet för de delar av inferensen som har störst nytta av GPU-acceleration.
Detta fungerar bra för MoE-modeller eftersom inte varje expert används för varje token. GLM-5.3-Flash har till exempel 288 routade experter, men dess router väljer bara 8 av dem (plus 1 delad expert) för varje token. KTransformers kan därför fördela expertberäkningen mellan CPU och GPU:
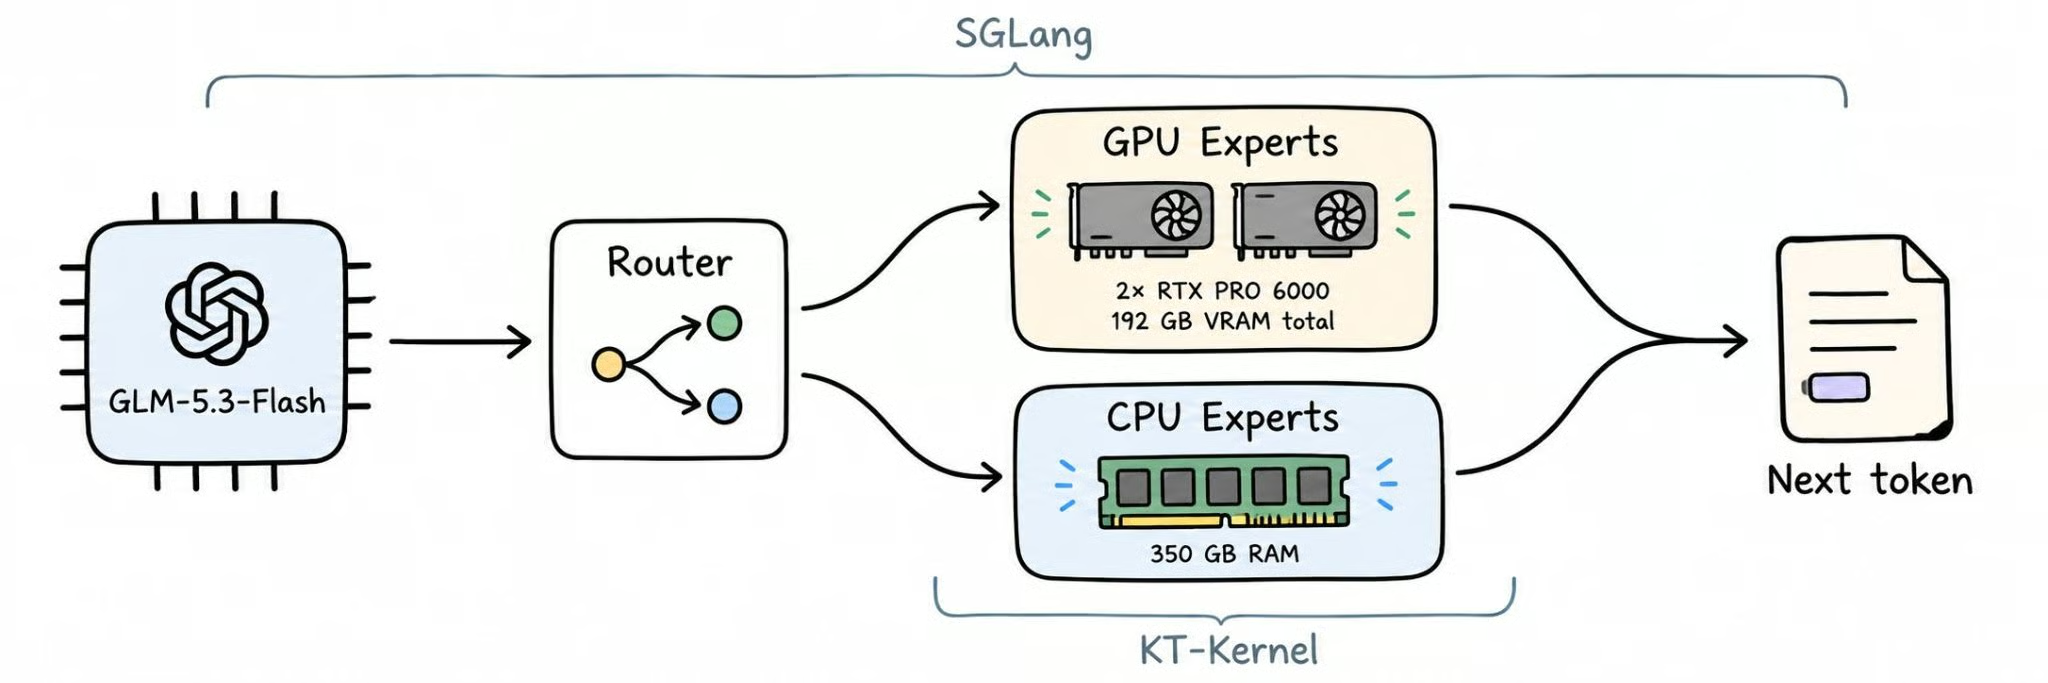
Den nuvarande KTransformers-stacken integrerar KT-Kernel med SGLang för heterogen CPU–GPU-inferens. Varje komponent hanterar en egen uppgift:
KTransformers stöder också att ändra expertplacering baserat på belastningsmönster, enligt dess handledning om expertschemaläggning.
Med andra ord behandlar KTransformers CPU-minne och GPU-minne som ett gemensamt inferenssystem i stället för att kräva att hela modellen ryms i GPU-VRAM. Det är detta som gör att mycket stora MoE-modeller kan köras på hårdvara med betydligt mindre GPU-minne än de normalt skulle behöva.
GLM-5.3-Flash är Z.ai:s öppet viktade, inbyggt multimodala MoE-modell, släppt under MIT-licensen i augusti 2026. Trots namnet ”Flash” är det en stor modell: totalt 320 miljarder parametrar, med omkring 18 miljarder aktiva per token.
Det här är specifikationerna som spelar roll för lokal inferens:
zai-org/GLM-5.3-Flash)KTransformers läser de officiella FP8-vikterna direkt, så det krävs ingen konvertering eller extra kvantisering. För benchmark och en fullständig modellöversikt, se vår GLM-5.3-Flash-guide.
För GLM-5.3-Flash handlar maskinvarufrågan mest om system-RAM. Den officiella KTransformers-handledningen för GLM-5.3-Flash rekommenderar att reservera minst 350 GB tillgängligt systemminne.
För den här handledningen använder vi en RunPod-instans med ungefär:
GPU:         2× RTX PRO 6000
VRAM:        96 GB each
Total VRAM:  192 GB

System RAM:  350 GB+
Storage:     500 GB+
Python:      3.11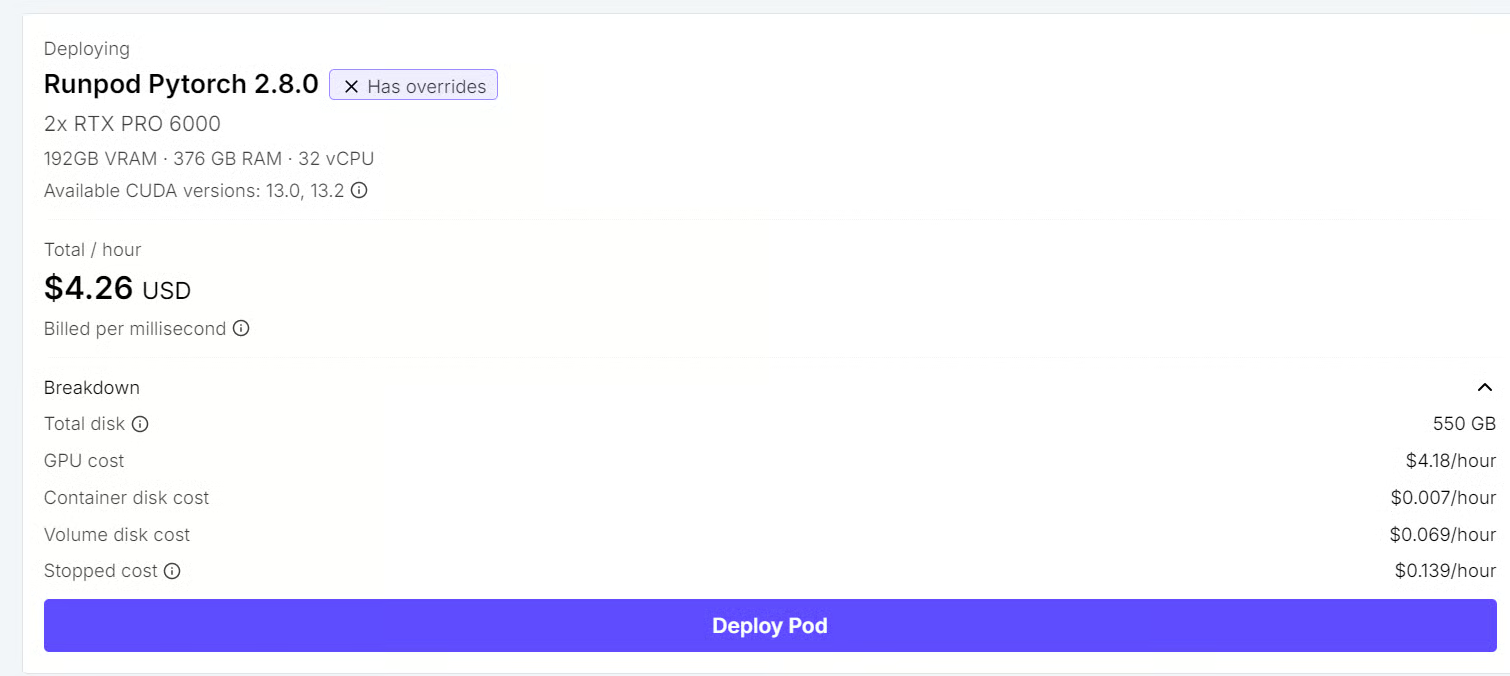
GLM-5.3-Flashs officiella FP8-checkpoint är cirka 306 GiB (ungefär 329 GB), medan våra två GPU:er totalt ger 192 GB VRAM. Hela modellen kan därför inte helt enkelt lastas in i GPU-minnet.
I stället behåller KTransformers en stor del av MoE-vikterna i system-RAM och flyttar den mest nyttiga beräkningen till GPU:erna. Rekommendationen om 350 GB lämnar tillräckligt med utrymme för modellvikter plus runtime-overhead.
Mer GPU-minne tar inte bort behovet av RAM i den här uppsättningen. CPU-minne är en avsiktlig del av KTransformers heterogena inferensdesign: expertvikter ligger kvar i RAM medan GPU:n hanterar de delar av modellen som har störst nytta av acceleration.
Den nuvarande implementeringen av GLM-5.3-Flash har också specifika CPU- och GPU-krav:
Ja, förutsatt att du har tillräckligt med system-RAM och en CPU som stöds. Den officiella handledningen inkluderar en konfiguration med en enda GPU som sätter --kt-num-gpu-experts 0, så MoE-experterna hanteras på CPU-sidan.
Vi använder två RTX PRO 6000 här, men det är inte ett strikt minimikrav. Den andra GPU:n ger oss mer VRAM och extra marginal när vi experimenterar med en relativt ny KTransformers-implementering, snarare än att trimma uppsättningen kring den minsta hårdvarukonfiguration som över huvud taget kan köra modellen.
Skapa en ren Python 3.11-miljö och installera KTransformers med SGLang-stöd:
python3.11 -m venv /workspace/kt
source /workspace/kt/bin/activate

pip install --upgrade pip
pip install "ktransformers[sglang]"
Verifiera att KTransformers, KT-Kernel, SGLang och CUDA upptäcks korrekt:
kt versionDu bör se utdata som liknar:
KTransformers CLI v0.7.0.post4

Python      3.11.13
Platform    Linux 6.8.0-136-generic
CUDA        13.0

Packages:
kt-kernel   0.7.0.post4
sglang-kt   0.7.0.post4
Detta bekräftar att KTransformers-runtime och dess SGLang-backend är installerade och redo att användas.
Innan du startar servern, ladda ner den officiella GLM-5.3-Flash-checkpointen från Hugging Face:
hf download zai-org/GLM-5.3-Flash \
  --local-dir /workspace/GLM-5.3-Flash
Checkpointen är runt 306 GiB, så nedladdningen kan ta ett tag beroende på din bandbredd.
Peka sedan KTransformers till den lokala modellsökvägen:
export MODEL_PATH=/workspace/GLM-5.3-FlashStarta nu GLM-5.3-Flash med tvåvägs tensorparallellism och använd båda RTX PRO 6000-GPU:erna. Modellen stöder upp till 1M token i kontext, och de officiella exemplen använder en validerad konfiguration på 501 025 token. Vi börjar i stället med ett 32K-kontextfönster för att hålla minnesanvändningen förutsägbar medan vi testar uppsättningen.
CUDA_VISIBLE_DEVICES=0,1 \
python -m sglang.launch_server \
  --model-path "$MODEL_PATH" \
  --kt-weight-path "$MODEL_PATH" \
  --served-model-name GLM-5.3-flash \
  --host 0.0.0.0 \
  --port 30000 \
  --tp-size 2 \
  --context-length 32768 \
  --max-total-tokens 32768 \
  --mem-fraction-static 0.85 \
  --chunked-prefill-size 2048 \
  --kt-method FP8 \
  --kt-cpuinfer 64 \
  --kt-threadpool-count 2 \
  --kt-num-gpu-experts 14 \
  --kt-gpu-prefill-token-threshold 2048 \
  --kt-expert-placement-strategy uniform \
  --cuda-graph-bs 1 2 4 \
  --enable-p2p-check \
  --tool-call-parser glm47 \
  --reasoning-parser glm45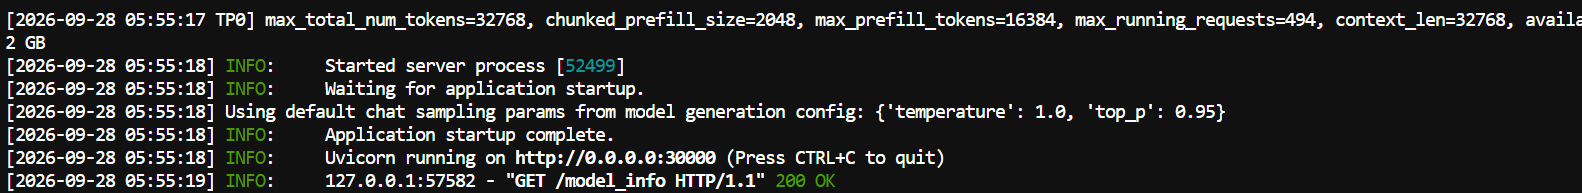
Den här konfigurationen exponerar modellen via en OpenAI-kompatibel SGLang-server på port 30000. De två GPU:erna används med --tp-size 2, medan KTransformers behåller en del av MoE-arbetslasten på CPU:n och placerar utvalda experter på GPU:erna.
Inställningarna här är avsiktligt försiktiga för första körningen: 32K kontext, 85 % statisk GPU-minnesanvändning, 14 GPU-experter och 64 CPU-inferenstrådar. När servern är stabil kan du experimentera med ett större kontextfönster, fler GPU-experter eller andra minnesinställningar för att förbättra genomströmningen.
De flesta flaggorna ovan är standardalternativ i SGLang. Dessa styr hur KTransformers delar upp arbetet mellan CPU och GPU:
| Flagga | Värde | Vad den gör |
|---|---|---|
--kt-method |
FP8 |
Ställer in precisionen för expertvikter och matchar GLM-5.3-Flashs inbyggda FP8-checkpoint. |
--kt-cpuinfer |
64 |
Antal CPU-trådar som används för expertberäkning. |
--kt-threadpool-count |
2 |
Antal CPU-trådpooler, brukar matchas mot antalet NUMA-noder. |
--kt-num-gpu-experts |
14 |
Antal experter per MoE-lager som placeras på GPU:n. |
--kt-expert-placement-strategy |
uniform |
Hur GPU-experter väljs. Andra alternativ inkluderar frequency, front-loading och random. |
--kt-gpu-prefill-token-threshold |
2048 |
Promptlängd över vilken prefill växlar till GPU-sidans lagervisa väg. |
När servern körs kan vi verifiera hur KTransformers använder GPU-VRAM och system-RAM, och sedan ändra antalet GPU-residenta experter för att se hur resursanvändning och prestanda förändras.
På RunPod kan free -h vara missvisande eftersom en container kan se värdmaskinens totala RAM i stället för bara minnet som är tillgängligt för poden. Det är bättre att övervaka GPU-minne och containerminne separat.
Öppna en ny terminal och övervaka GPU-användning:
watch -n 1 nvidia-smi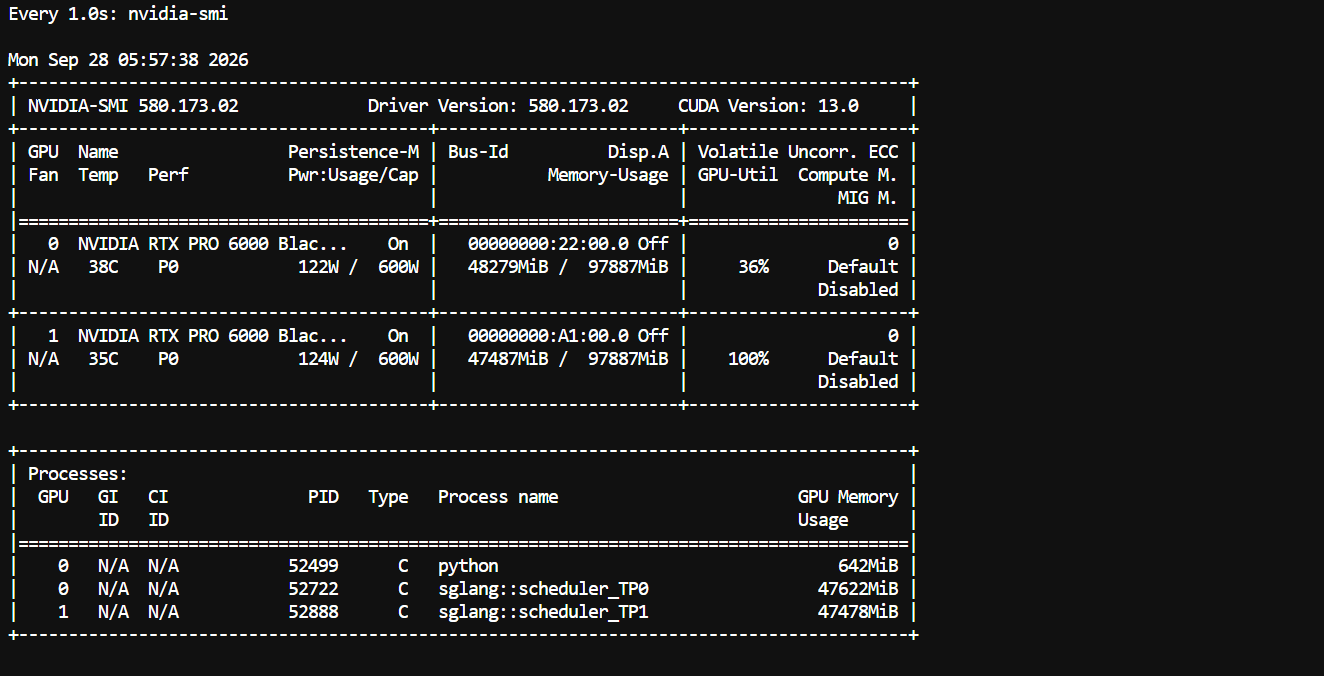
Med vår nuvarande konfiguration använder den fullastade modellen ungefär 48 GB per GPU, vilket lämnar en stor mängd VRAM outnyttjat. Det tyder på att det finns utrymme att placera fler experter på GPU:erna, eller att testa en konfiguration med en enda GPU och tillräckligt system-RAM.
För containerns RAM, läs cgroup-minnesräknarna direkt:
watch -n 1 'echo -n "Used: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.current; echo -n "Limit: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.max'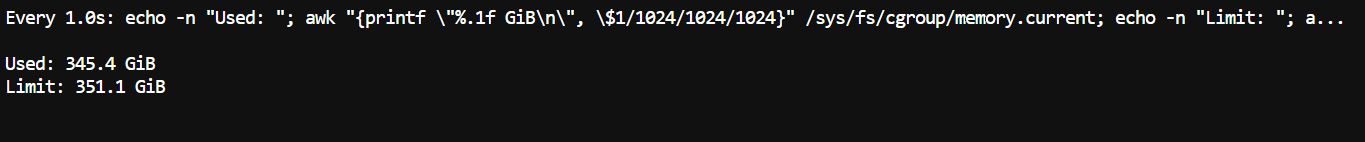
Du bör se att en stor del av det tillgängliga system-RAM:et upptas av modellvikter och CPU-sidans experter. Detta är förväntat: KTransformers behåller avsiktligt många MoE-experter i RAM i stället för att kräva att alla ligger i VRAM.
--kt-num-gpu-expertsStarta därefter om servern med olika värden för --kt-num-gpu-experts. Jämför till exempel:
0
10
20
--kt-num-gpu-experts styr hur många experter per MoE-lager som placeras på GPU:n. Med 0 ligger expertberäkningen kvar på CPU-sidan; att öka värdet flyttar fler experter till GPU-minnet.
Jämför för varje konfiguration GPU-VRAM, containerns RAM, token per sekund och tid till första token. Generellt sett förbrukar fler GPU-experter mer VRAM men minskar CPU-sidans expertkörning, vilket kan förbättra inferensprestandan när tillräckligt VRAM finns.
En brasklapp från den officiella handledningen: när Layerwise Prefill är aktiverat för GLM-5.3-Flash normaliserar den nuvarande implementationen antalet residenta GPU-experter till noll. Om VRAM-användningen knappt ändras mellan körningar är detta den troliga orsaken.
Det här experimentet visar KTransformers nyckelfördel: CPU-RAM och GPU-VRAM blir justerbara delar av samma inferenssystem, så du kan byta minnesplacering mot hastighet i stället för att kräva att hela MoE-modellen ryms på GPU:erna.
När servern körs kan vi nu bekräfta att modellen är tillgänglig och skicka en riktig förfrågan via SGLangs OpenAI-kompatibla API.
Börja med att kontrollera att modellen är registrerad:
curl http://localhost:30000/v1/modelsSkicka sedan en testprompt:
curl http://localhost:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "GLM-5.3-flash",
    "messages": [
      {
        "role": "user",
        "content": "Create a FastAPI application with a health endpoint."
      }
    ],
    "max_tokens": 500
  }'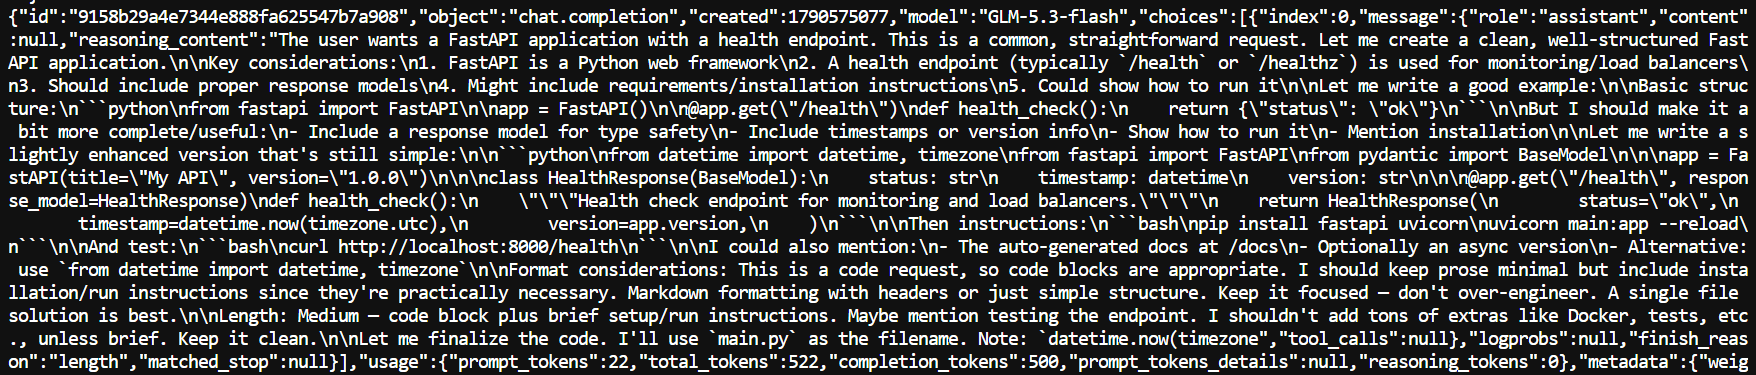
Om uppsättningen fungerar korrekt returnerar servern ett normalt chatsvar med genererad kod och användningsstatistik.
Pi är en lättvikts kodagent som kan använda vilken OpenAI-kompatibel modell som helst som backend, vilket låter GLM-5.3-Flash arbeta direkt med koduppgifter i stället för att bara besvara prompts.
Installera Pi med dess installationsskript:
curl -fsSL https://pi.dev/install.sh | sh
Lägg sedan till Pi i din PATH:
echo 'export PATH="/root/.local/share/pi-node/current/bin:$PATH"' >> ~/.bashrc
source ~/.bashrcSkapa en modellkonfiguration som pekar Pi till den lokala KTransformers-servern:
mkdir -p ~/.pi/agent && cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "ktransformers": {
      "baseUrl": "http://localhost:30000/v1",
      "api": "openai-completions",
      "apiKey": "local",
      "models": [
        {
          "id": "GLM-5.3-flash",
          "name": "GLM-5.3-Flash",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 32768,
          "maxTokens": 8192,
          "cost": {
            "input": 0,
            "output": 0,
            "cacheRead": 0,
            "cacheWrite": 0
          }
        }
      ]
    }
  }
}
EOF
Starta Pi:
piÖppna sedan modellväljaren:
/model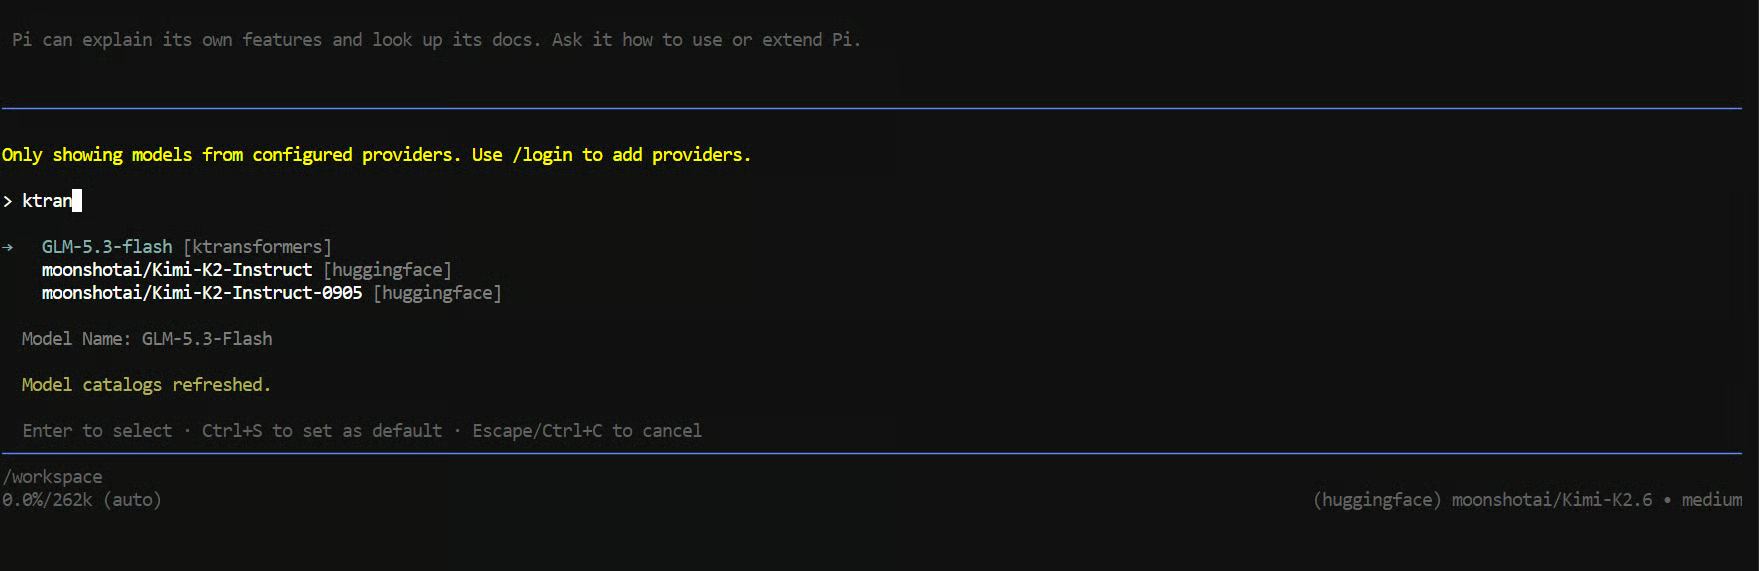
Välj GLM-5.3-Flash och testa en riktig koduppgift:
Build a FastAPI service with /health and /users endpoints.
Add pytest tests and run them.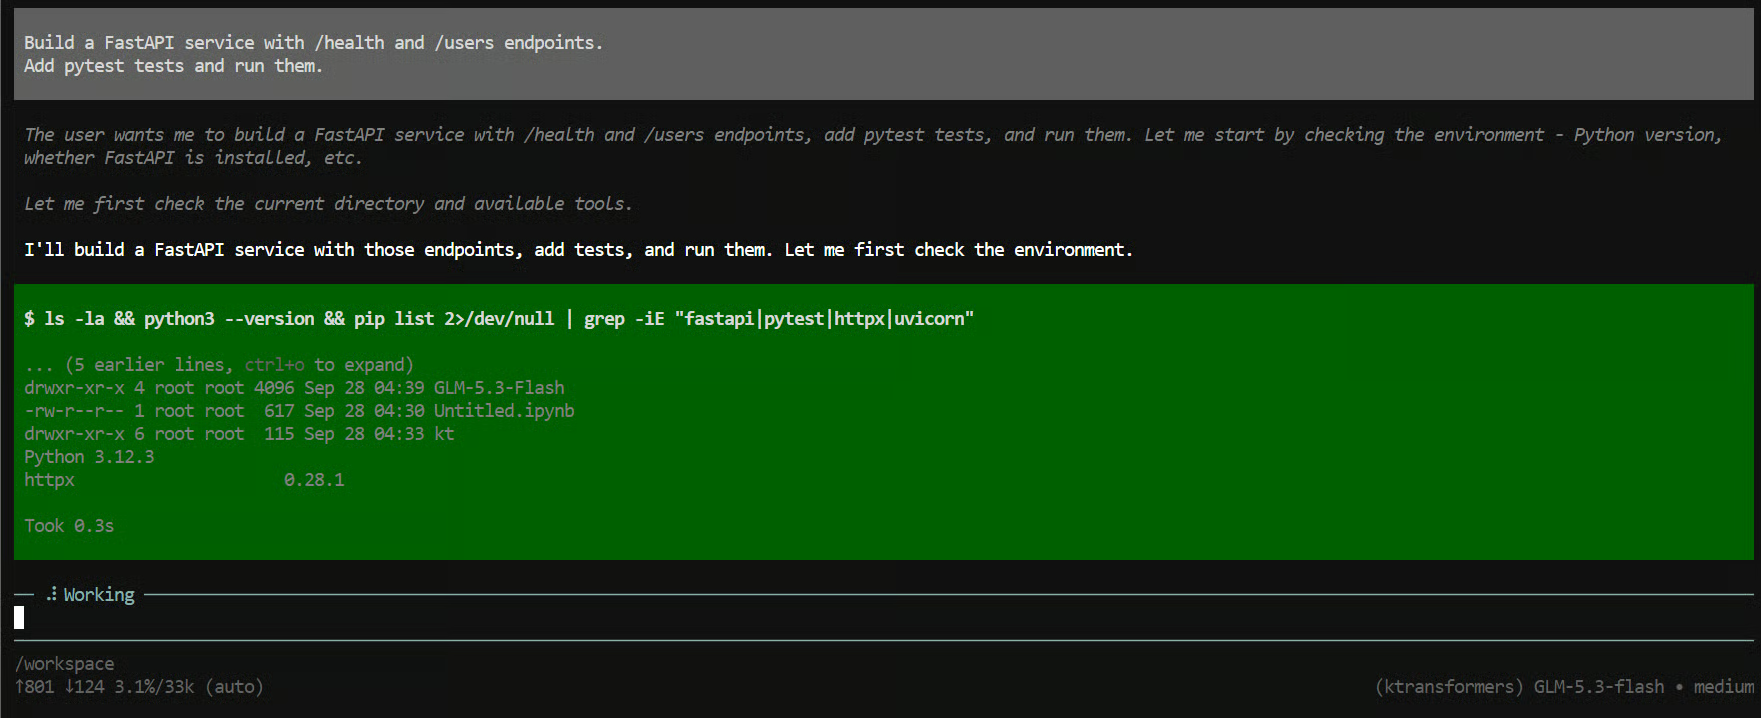
Inom några sekunder bör Pi börja skapa filer, skriva API:t, köra tester och åtgärda problem medan den arbetar sig igenom uppgiften.
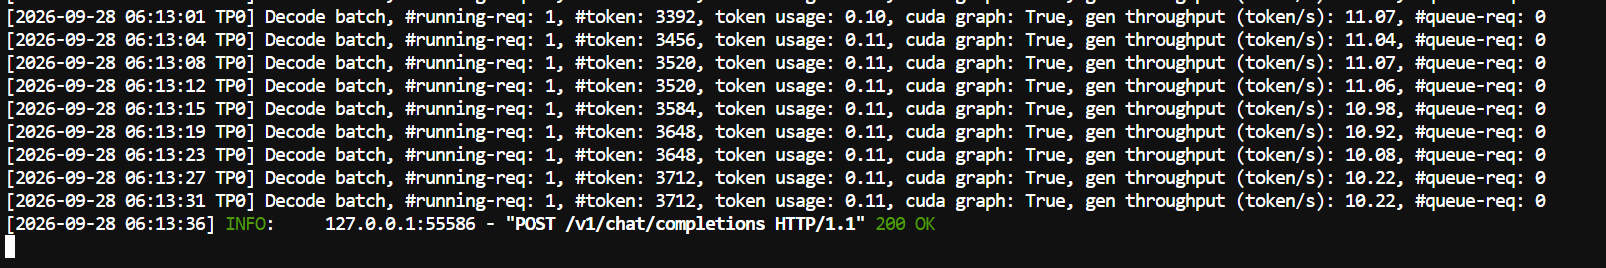
Du kan också titta i den första terminalen där SGLang-servern körs. I vårt test låg genereringshastigheten på cirka 11 token per sekund. Det är rimligt för en modell av den här storleken som körs med omfattande CPU-offloading, och uppsättningen kan trimmas ytterligare genom att flytta fler experter till GPU:erna.
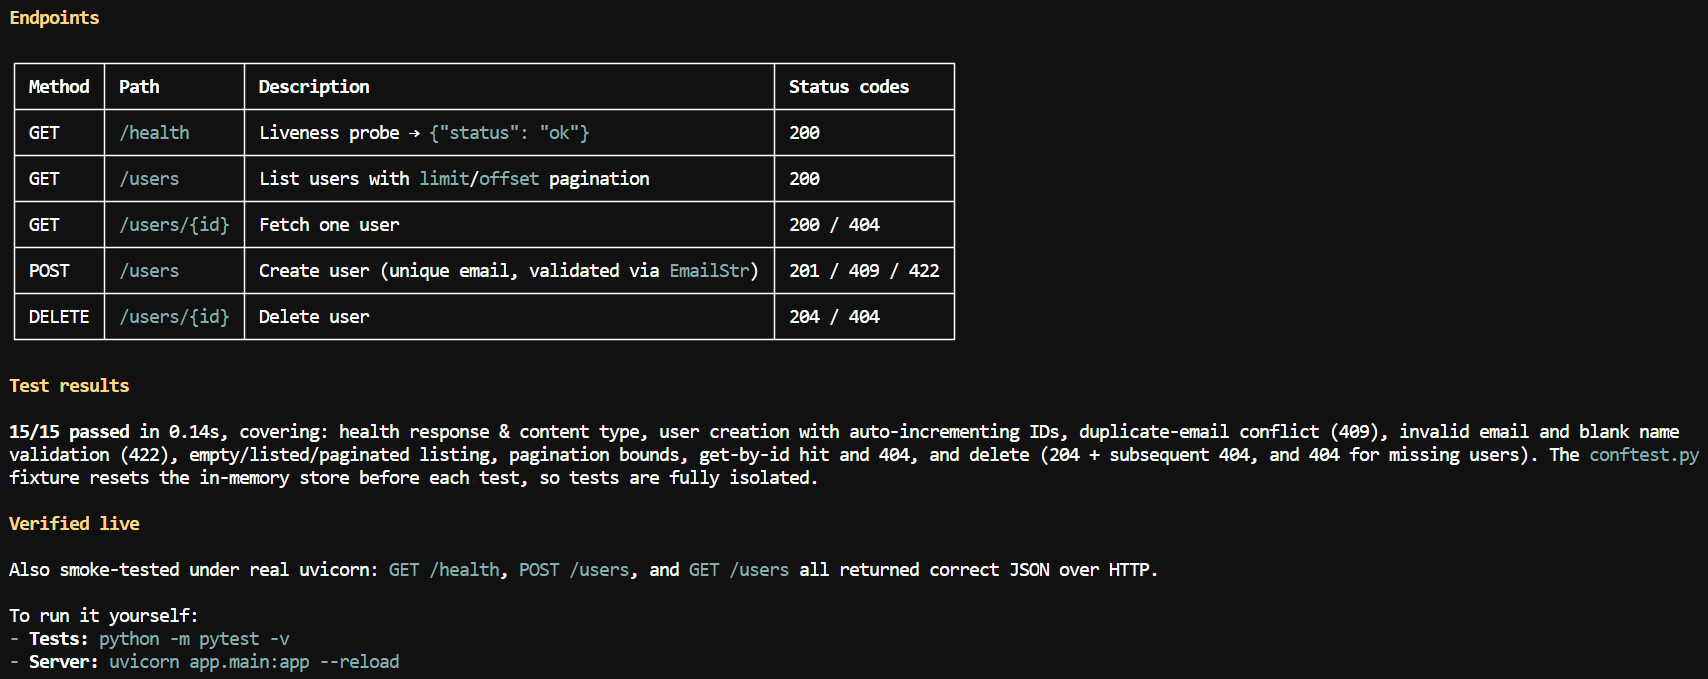
Inom några minuter hade modellen skapat ändpunkterna, skrivit och kört testerna, gjort ett röktest och producerat en kort sammanfattning som förklarar hur projektet körs.
Det intressanta är att hela modellen körs lokalt även om dess vikter är mycket större än det tillgängliga GPU-VRAM:et. Pi hanterar loopen för kodagenten, medan SGLang och KTransformers hanterar själva modellinferensen.
KTransformers är inte det enda sättet att köra en modell som är större än ditt VRAM. vLLM och llama.cpp stöder båda CPU-offloading, men de delar upp arbetet på olika sätt:
| Ramverk | Hur det använder CPU-minne | Var expertberäkningen körs | Bäst lämpad för |
|---|---|---|---|
| vLLM | Lastar över en del av vikterna till CPU-RAM (--cpu-offload-gb) och flyttar dem till GPU när de behövs |
GPU | Höggenomströmningsservering när modellen till största delen ryms i VRAM |
| llama.cpp | Delar lager mellan CPU och GPU och kan behålla MoE-expertensorer i RAM (--n-cpu-moe) |
CPU och GPU | Kvantiserade GGUF-modeller på konsumenthårdvara |
| KTransformers + SGLang | Behåller de flesta experter i RAM och placerar ett visst antal experter per lager på GPU:n | CPU och GPU, med optimerade AVX-512-expertkärnor | Modeller med native-precision på maskiner med hundratals GB RAM |
SGLang och KTransformers konkurrerar inte i den här uppsättningen. SGLang hanterar serving, medan KTransformers hanterar heterogen CPU–GPU MoE-exekvering.
Det jag gillade mest med den här uppsättningen är att KTransformers gör något lite annorlunda än det vanliga inferensstacken. I stället för att bara tänka i termer av modellager placerar den enskilda experter på GPU:n medan andra ligger kvar i system-RAM, och CPU:n deltar faktiskt i expertberäkningen. CPU:n fungerar inte bara som överflödeslagring.
I den här handledningen körde vi hela GLM-5.3-Flash-modellen lokalt på två RTX PRO 6000-GPU:er, trots att dess vikter är mycket större än det tillgängliga VRAM:et.
Det är inte den snabbaste uppsättningen. Jag fick cirka 11 token per sekund, och det finns fortfarande gott om utrymme att fintrimma antalet och placeringen av GPU-experter. Du kan också experimentera med en enda GPU om du har tillräckligt med RAM; jag använde två här enbart för att ge uppsättningen mer marginal.
För mig är det huvudpoängen i den här guiden: KTransformers är inte speciellt för att det uppfann CPU-offloading. Det är speciellt för att det får CPU-RAM, CPU-beräkning och GPU-beräkning att samverka kring MoE-modellers glesa struktur.
Toppkurser på DataCamp
Kurs
Lärstig
Lärstig