
课程
使用 PyTorch 的 Transformer 模型
2 小时
9.2K
KTransformers 是一个开源推理框架,它让CPU 和 GPU 在推理过程中分别执行不同的专家(experts),从而可以运行参数规模远超您 GPU 显存容量的混合专家模型(MoE)。像 vLLM 这样的框架也能将权重卸载到 CPU 内存,但 KTransformers 专为 MoE 模型的稀疏结构而构建。
在本教程中,我们将使用 KTransformers 和 SGLang 来运行 GLM-5.3-Flash,这是一个拥有 3200 亿参数的模型,其权重无法装入 192 GB 显存。我们会监控 CPU 和 GPU 的内存占用,尝试调整专家放置策略,测试与 OpenAI 兼容的 API,并将模型连接到 Pi 作为本地编码智能体。
核心思想很简单:KTransformers 不把 CPU 内存当作溢出存储,而是在推理过程中同时使用CPU 计算与 GPU 计算。
KTransformers 是一个用于以GPU 显存与 CPU 内存组合运行超大语言模型的开源推理框架。通常,在线服务需要将大部分权重加载到 GPU 内存中,这对于 GLM-5.3-Flash 这种规模的模型来说成本很快就会变高。
KTransformers 采取了不同方案:它将大量 MoE 专家权重保存在系统内存中,将更适合加速的推理部分留给 GPU 内存。
这对 MoE 模型尤其有效,因为并非每个 token 都会用到所有专家。以 GLM-5.3-Flash 为例,它有 288 个路由专家,但每个 token 的路由器只会选择其中 8 个(外加 1 个共享专家)。因此 KTransformers 可以把专家计算分配到 CPU 和 GPU:
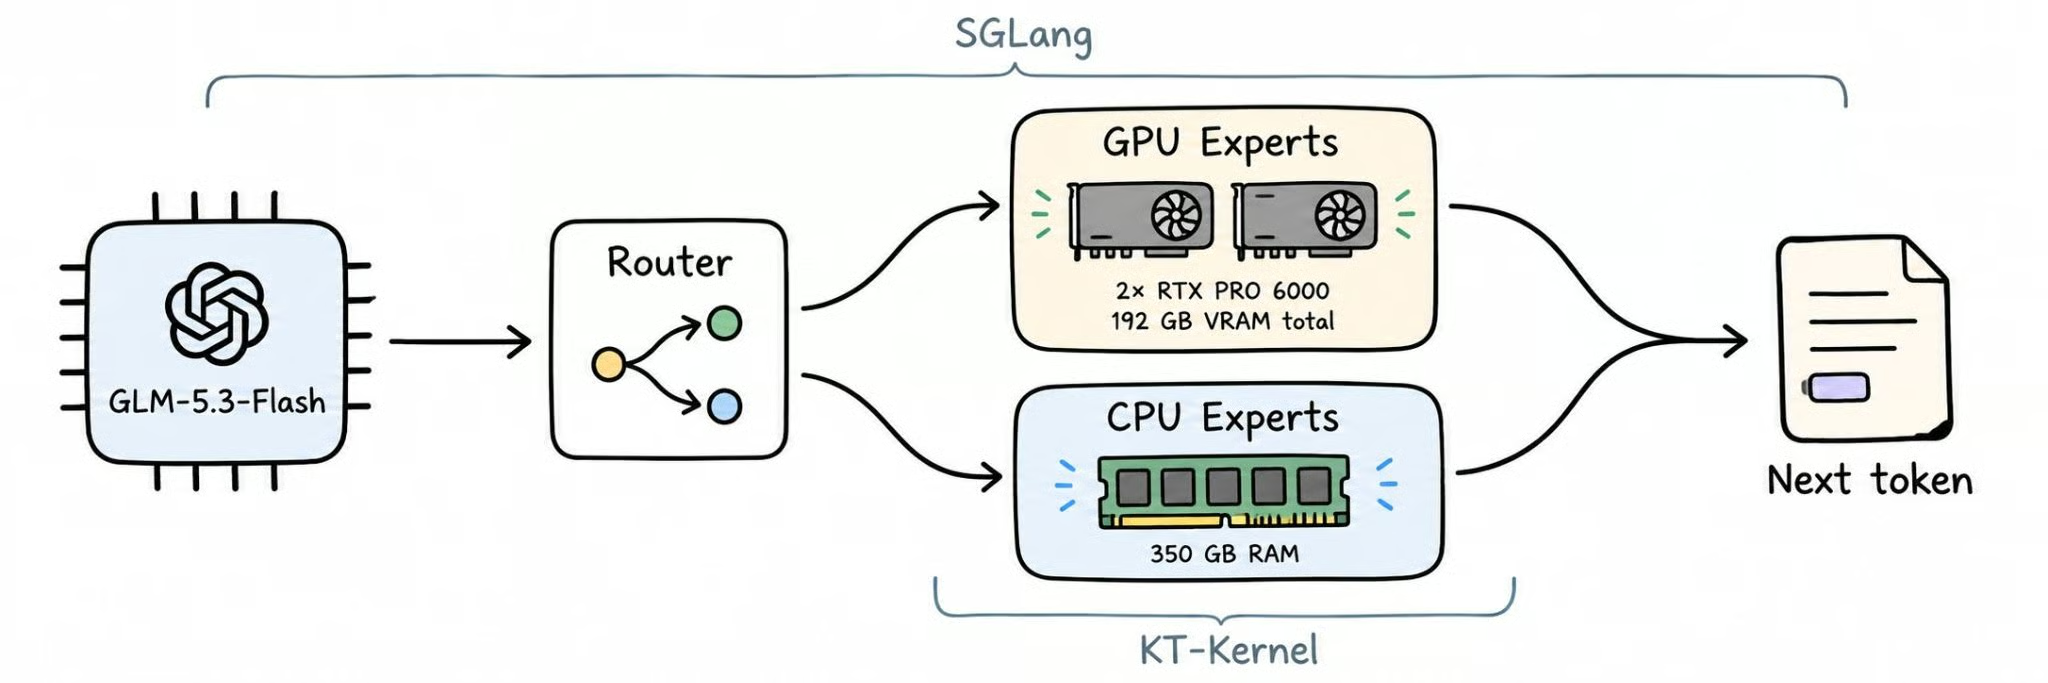
当前的 KTransformers 技术栈集成了用于异构 CPU-GPU 推理的KT-Kernel 与 SGLang。两者分工如下:
KTransformers 还支持根据负载模式调整专家放置策略,详见其专家调度教程。
换句话说,KTransformers 将CPU 内存与 GPU 内存视为一个共享的推理系统,而不是要求整个模型都装进 GPU 显存。这正是让超大 MoE 模型能在远小于其规模所需的 GPU 内存条件下运行的关键。
GLM-5.3-Flash 是 Z.ai 在 2026 年 8 月以 MIT 许可发布的开放权重、原生多模态 MoE 模型。尽管名为 “Flash”,它依然是一个大模型:总参数 3200 亿,每个 token 激活约 180 亿参数。
这几点与本地推理最相关:
zai-org/GLM-5.3-Flash)约 306 GiBKTransformers 可直接读取官方 FP8 权重,无需转换或额外量化。基准测试与完整模型综述,请参阅我们的GLM-5.3-Flash 指南。
对 GLM-5.3-Flash 来说,硬件的关键主要在系统内存。KTransformers 官方 GLM-5.3-Flash 教程建议至少预留 350 GB 可用系统内存。
本教程中,我们使用一台 RunPod 实例,配置大致如下:
GPU:         2× RTX PRO 6000
VRAM:        96 GB each
Total VRAM:  192 GB

System RAM:  350 GB+
Storage:     500 GB+
Python:      3.11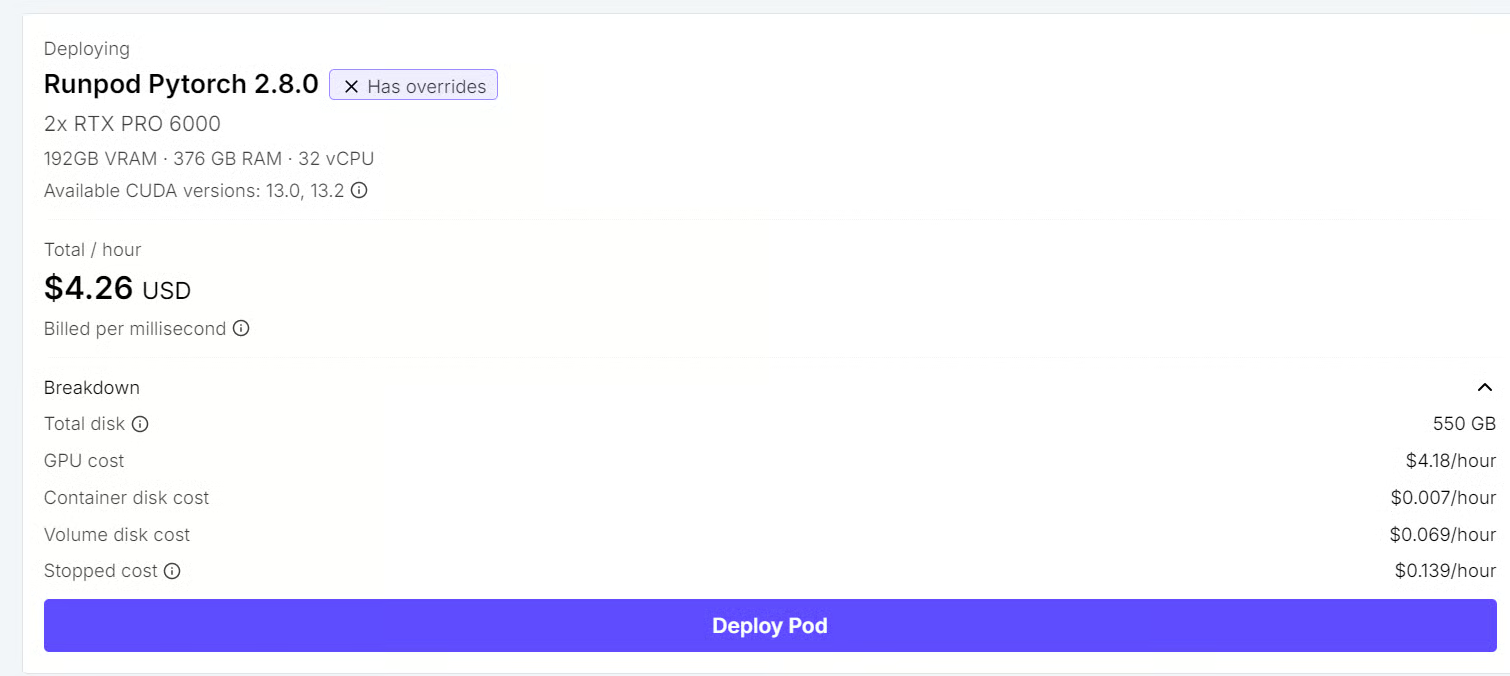
GLM-5.3-Flash 的官方 FP8 checkpoint 约 306 GiB(约 329 GB),而我们的两张 GPU 总计提供 192 GB 显存。因此无法将整个模型直接装入 GPU 内存。
相反,KTransformers 会将大量 MoE 权重保存在系统内存中,并把最有价值的计算转移到 GPU 上。建议的 350 GB 预留可以覆盖模型权重及运行时开销。
在此方案中,更多的 GPU 内存并不能消除对系统内存的需求。CPU 内存是 KTransformers 异构推理设计中的有意组成:专家权重保留在内存中,而 GPU 处理最受益于加速的模型部分。
当前 GLM-5.3-Flash 的实现还对 CPU 与 GPU 有特定要求:
可以,只要系统内存足够且 CPU 受支持。官方教程提供了单卡配置,通过设置 --kt-num-gpu-experts 0,将 MoE 专家计算放在 CPU 侧。
我们这里使用两张 RTX PRO 6000,并非最低硬件要求。选择双卡是为了在试验相对较新的 KTransformers 实现时获得更多显存与冗余空间,而非围绕“最低可运行配置”来精细调参。
创建一个干净的 Python 3.11 环境,并安装带 SGLang 支持的 KTransformers:
python3.11 -m venv /workspace/kt
source /workspace/kt/bin/activate

pip install --upgrade pip
pip install "ktransformers[sglang]"
验证 KTransformers、KT-Kernel、SGLang 与 CUDA 是否正确检测:
kt version您应能看到类似输出:
KTransformers CLI v0.7.0.post4

Python      3.11.13
Platform    Linux 6.8.0-136-generic
CUDA        13.0

Packages:
kt-kernel   0.7.0.post4
sglang-kt   0.7.0.post4
这表明 KTransformers 运行时及其 SGLang 后端已安装就绪。
启动服务器前,先从 Hugging Face 下载官方 GLM-5.3-Flash checkpoint:
hf download zai-org/GLM-5.3-Flash \
  --local-dir /workspace/GLM-5.3-Flash
该 checkpoint 约 306 GiB,下载耗时取决于您的带宽。
然后将 KTransformers 指向本地模型路径:
export MODEL_PATH=/workspace/GLM-5.3-Flash现在使用双向张量并行,在两张 RTX PRO 6000 上启动 GLM-5.3-Flash。该模型支持最高 100 万 token 上下文,官方示例使用了经验证的 501,025-token 配置。我们先从 32K 上下文窗口开始,以便在测试时保持可预期的内存占用。
CUDA_VISIBLE_DEVICES=0,1 \
python -m sglang.launch_server \
  --model-path "$MODEL_PATH" \
  --kt-weight-path "$MODEL_PATH" \
  --served-model-name GLM-5.3-flash \
  --host 0.0.0.0 \
  --port 30000 \
  --tp-size 2 \
  --context-length 32768 \
  --max-total-tokens 32768 \
  --mem-fraction-static 0.85 \
  --chunked-prefill-size 2048 \
  --kt-method FP8 \
  --kt-cpuinfer 64 \
  --kt-threadpool-count 2 \
  --kt-num-gpu-experts 14 \
  --kt-gpu-prefill-token-threshold 2048 \
  --kt-expert-placement-strategy uniform \
  --cuda-graph-bs 1 2 4 \
  --enable-p2p-check \
  --tool-call-parser glm47 \
  --reasoning-parser glm45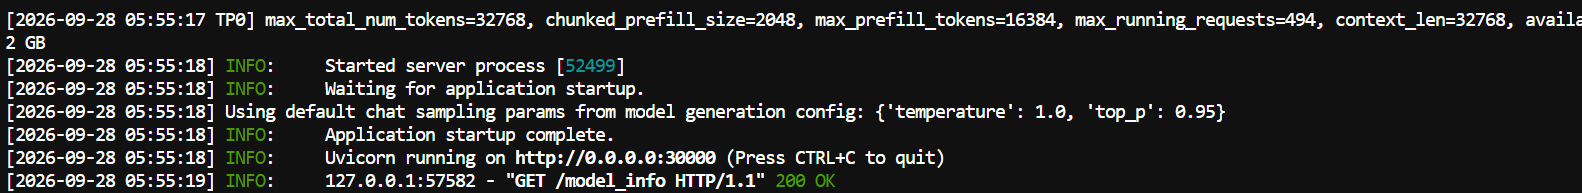
该配置会在端口 30000 上通过与 OpenAI 兼容的 SGLang 服务器暴露模型。两张 GPU 通过 --tp-size 2 使用,而 KTransformers 将部分 MoE 负载保留在 CPU,且将选定专家放置到 GPU。
这些设置在首轮运行时刻意保守:32K 上下文、85% 静态 GPU 内存占用、14 个 GPU 专家、64 个 CPU 推理线程。在服务稳定后,您可尝试更大的上下文窗口、更多 GPU 专家或不同内存设置来提升吞吐。
多数上述参数是标准的 SGLang 选项。以下参数决定 KTransformers 如何在 CPU 与 GPU 间分配工作:
| 参数 | 取值 | 作用 |
|---|---|---|
--kt-method |
FP8 |
设置专家权重精度,与 GLM-5.3-Flash 的原生 FP8 checkpoint 一致。 |
--kt-cpuinfer |
64 |
用于专家计算的 CPU 线程数。 |
--kt-threadpool-count |
2 |
CPU 线程池数量,通常与 NUMA 节点数匹配。 |
--kt-num-gpu-experts |
14 |
每个 MoE 层放在 GPU 上的专家数量。 |
--kt-expert-placement-strategy |
uniform |
GPU 专家的选择方式。其他选项包括 frequency、front-loading 和 random。 |
--kt-gpu-prefill-token-threshold |
2048 |
当提示长度超过该阈值时,预填充切换到 GPU 侧的逐层路径。 |
服务器运行后,我们可以验证 KTransformers 如何使用GPU 显存与系统内存,并通过改变驻留在 GPU 上的专家数量来观察资源使用与性能的变化。
在 RunPod 上,free -h 可能具有误导性,因为容器可能看到的是宿主机的总内存,而非分配给 pod 的可用内存。建议分别监控GPU 内存与容器内存。
打开新终端监控 GPU 使用:
watch -n 1 nvidia-smi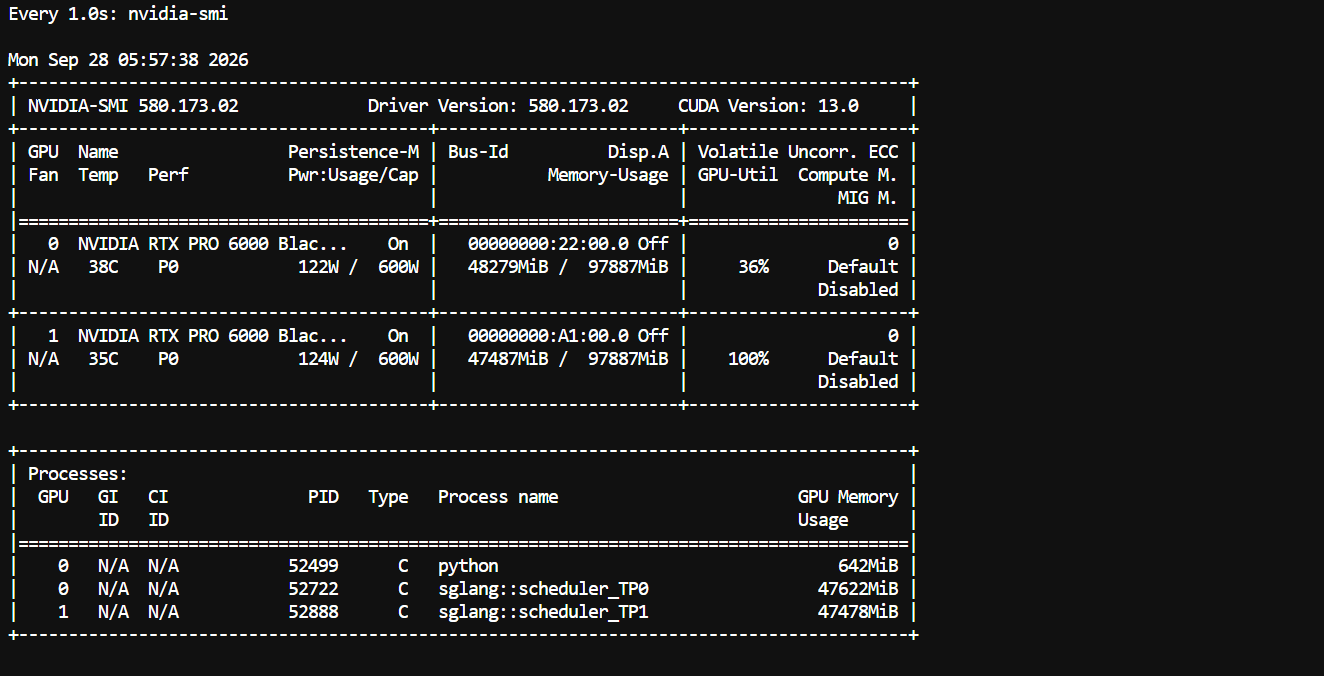
在当前配置下,模型完全加载时每张 GPU 大约使用 48 GB 显存,仍有大量剩余。这表明可以将更多专家放到 GPU 上,或在系统内存充足的前提下尝试单卡配置。
要查看容器内存,请直接读取 cgroup 内存计数器:
watch -n 1 'echo -n "Used: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.current; echo -n "Limit: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.max'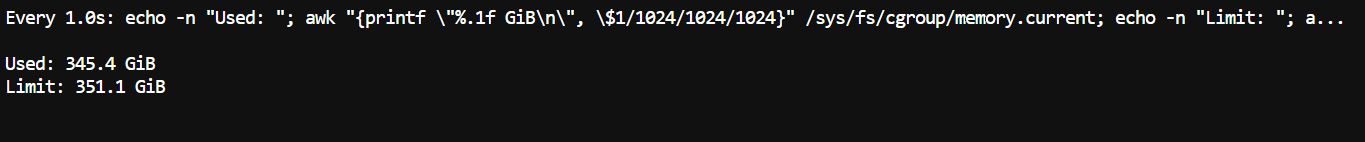
您应能看到可用系统内存中有很大一部分被模型权重与 CPU 侧专家占用。这是预期的:KTransformers 有意将大量 MoE 专家保留在内存中,而非全部迁入显存。
--kt-num-gpu-experts接下来,用不同的 --kt-num-gpu-experts 值重启服务器。例如,对比:
0
10
20
--kt-num-gpu-experts 控制每个MoE 层放在 GPU 上的专家数量。取值为 0 时,专家计算留在 CPU;增大该值会将更多专家迁移至 GPU 内存。
每种配置下,请比较GPU 显存占用、容器内存占用、token/s 速度与首 token 延迟。一般来说,GPU 专家越多,显存占用越高,但可减少 CPU 侧专家执行,从而在显存充足时提升推理性能。
需要注意官方教程中的一个点:当 GLM-5.3-Flash 启用 Layerwise Prefill 时,当前实现会将驻留的 GPU 专家数归一化为 0。如果不同运行间显存占用几乎不变,极可能是这个原因。
本实验揭示了 KTransformers 的关键优势:CPU 内存与 GPU 显存可作为同一推理系统的可调组件,您可以在内存放置与速度之间进行权衡,而不是强制让整个 MoE 模型完全装进 GPU。
服务器就绪后,我们可以确认模型已可用,并通过 SGLang 的 OpenAI 兼容 API 发送实际请求。
首先检查模型是否已注册:
curl http://localhost:30000/v1/models然后发送一个测试提示:
curl http://localhost:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "GLM-5.3-flash",
    "messages": [
      {
        "role": "user",
        "content": "Create a FastAPI application with a health endpoint."
      }
    ],
    "max_tokens": 500
  }'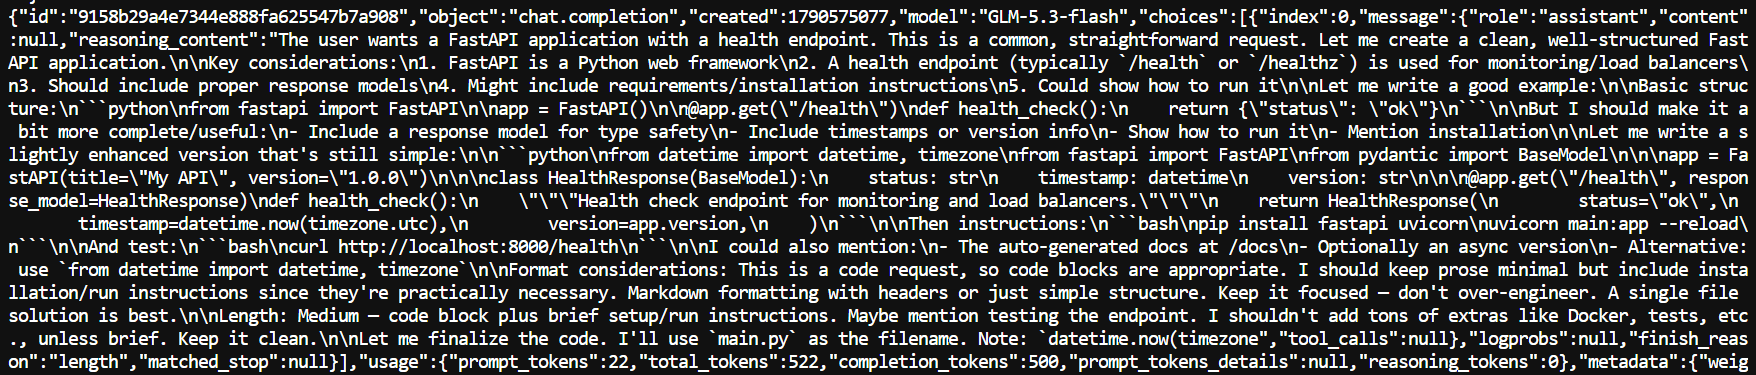
如果设置正确,服务器会返回常规的聊天补全响应,其中包含生成的代码与用量统计。
Pi 是一个轻量级编码智能体,可以使用任何与 OpenAI 兼容的模型作为后端,这让 GLM-5.3-Flash 不仅能回答提示,还能直接投入编码任务。
使用安装脚本安装 Pi:
curl -fsSL https://pi.dev/install.sh | sh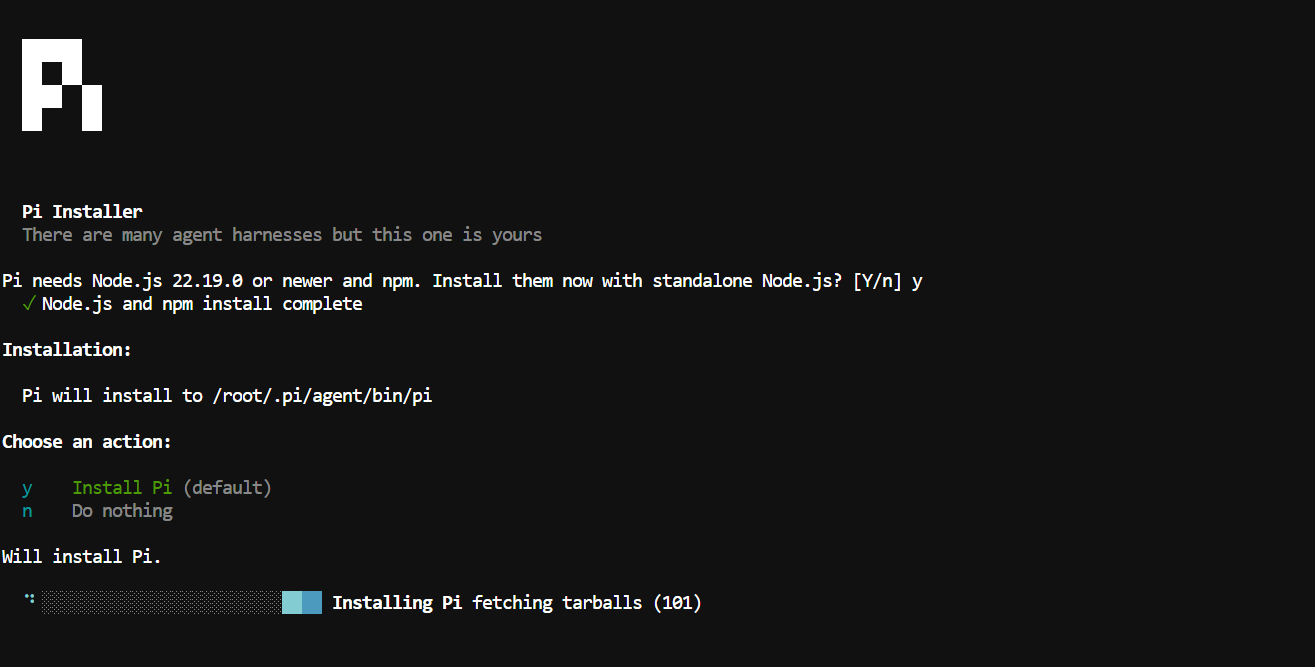
然后将 Pi 加入您的 PATH:
echo 'export PATH="/root/.local/share/pi-node/current/bin:$PATH"' >> ~/.bashrc
source ~/.bashrc创建一个模型配置,让 Pi 指向本地 KTransformers 服务器:
mkdir -p ~/.pi/agent && cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "ktransformers": {
      "baseUrl": "http://localhost:30000/v1",
      "api": "openai-completions",
      "apiKey": "local",
      "models": [
        {
          "id": "GLM-5.3-flash",
          "name": "GLM-5.3-Flash",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 32768,
          "maxTokens": 8192,
          "cost": {
            "input": 0,
            "output": 0,
            "cacheRead": 0,
            "cacheWrite": 0
          }
        }
      ]
    }
  }
}
EOF
启动 Pi:
pi然后打开模型选择器:
/model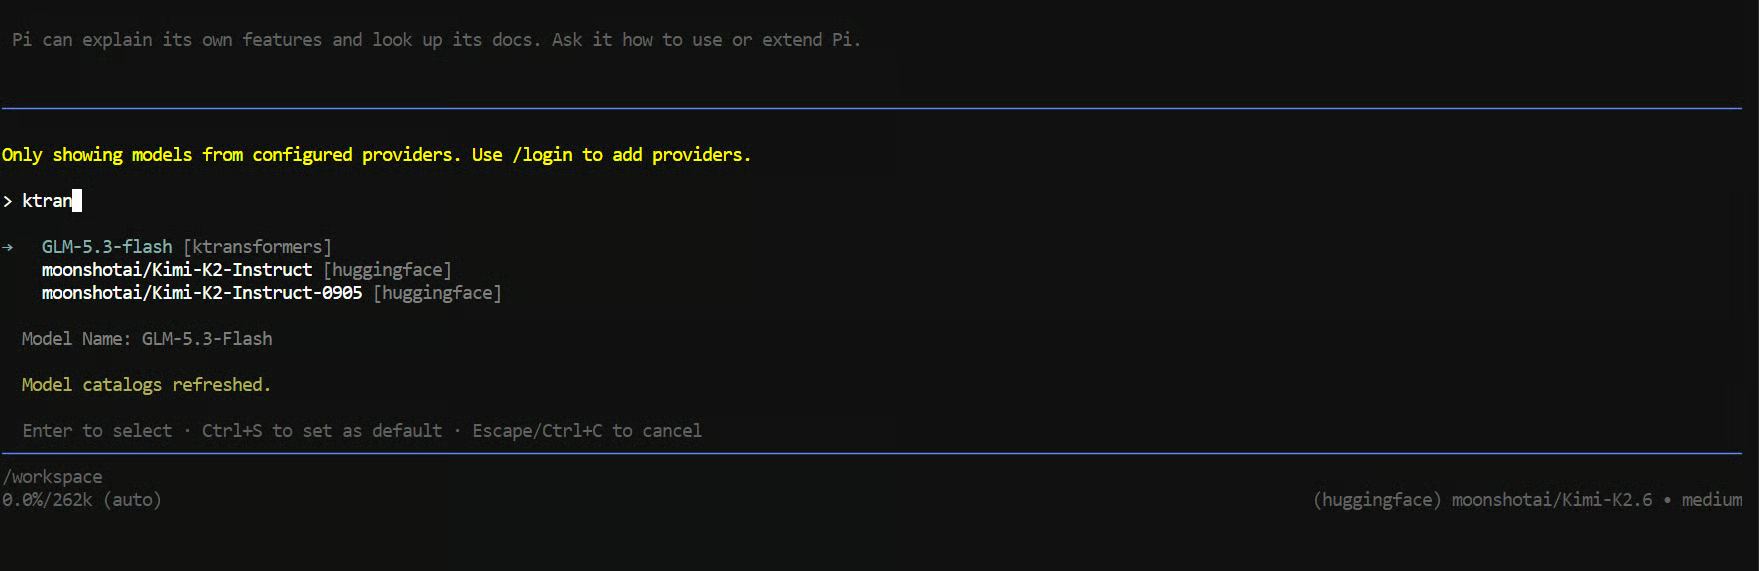
选择GLM-5.3-Flash,尝试一个真实的编码任务:
Build a FastAPI service with /health and /users endpoints.
Add pytest tests and run them.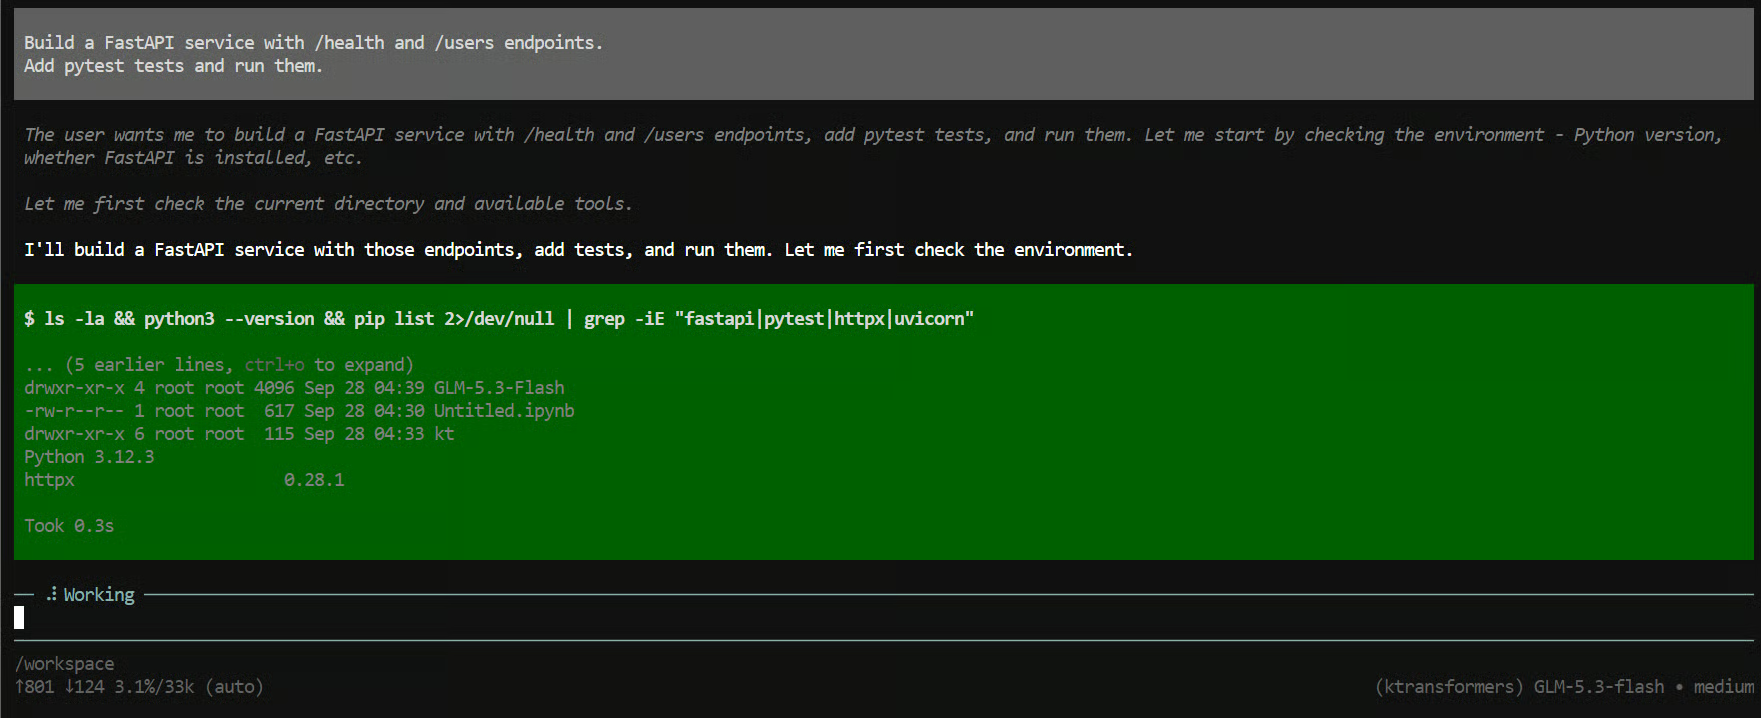
几秒钟内,Pi 就会开始创建文件、编写 API、运行测试并在推进任务时修复问题。
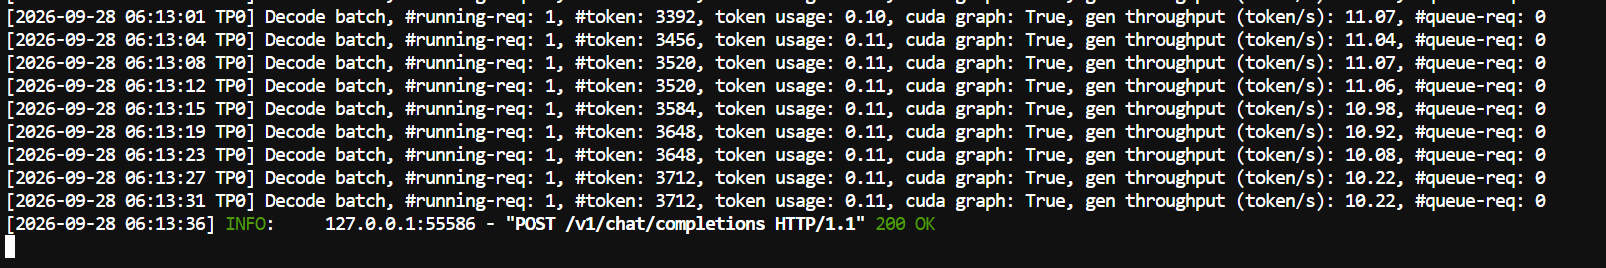
您也可以观察第一个终端(SGLang 服务器在运行)。在我们的测试中,生成速度约为11 token/s。对于这样规模且大量 CPU 卸载的模型,这是一个合理速度;通过将更多专家迁移到 GPU,还能进一步调优。
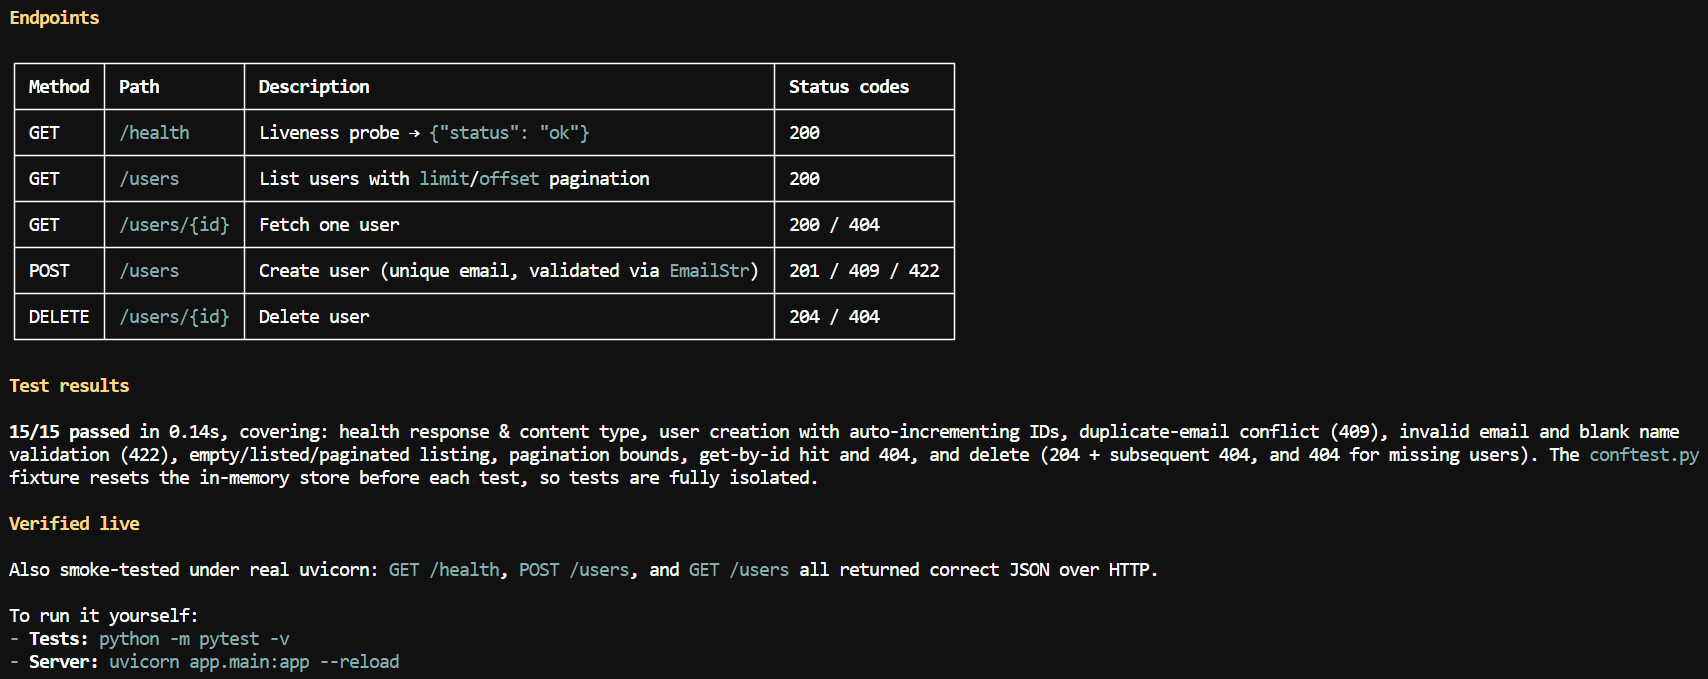
几分钟内,模型就创建了端点、编写并执行了测试、进行了冒烟测试,并生成了简短总结说明如何运行该项目。
有意思的是,尽管模型权重大于可用 GPU 显存,我们仍在本地完整运行了该模型。Pi 负责编码智能体循环,SGLang 与 KTransformers 负责实际的模型推理。
运行超出显存容量的模型并非只有 KTransformers 一种方案。vLLM 与 llama.cpp 也支持 CPU 卸载,但它们的分工方式不同:
| 框架 | 如何使用 CPU 内存 | 专家计算位置 | 最佳适用场景 |
|---|---|---|---|
| vLLM | 将部分权重卸载到 CPU 内存(--cpu-offload-gb),按需回传至 GPU |
GPU | 当模型大部分能装入显存时的高吞吐服务 |
| llama.cpp | 在 CPU 与 GPU 之间拆分层,并可将 MoE 专家张量保留在内存中(--n-cpu-moe) |
CPU 与 GPU | 消费级硬件上的量化 GGUF 模型 |
| KTransformers + SGLang | 将多数专家保存在内存中,并为每层在 GPU 上放置一定数量的专家 | CPU 与 GPU,配合优化的 AVX-512 专家内核 | 拥有数百 GB 内存、运行原生精度 MoE 模型的机器 |
在该组合中,SGLang 与 KTransformers 并非竞品。SGLang 负责服务侧,KTransformers 负责异构 CPU-GPU 的 MoE 执行。
我最喜欢这套方案的一点在于,KTransformers 与常见的推理栈有所不同。它不是只从模型“层”的角度思考,而是把单个专家放到 GPU,同时将其他专家保留在系统内存,并让 CPU 实际参与专家计算。CPU 不再只是溢出存储。
在本教程中,我们在两张 RTX PRO 6000 上本地运行了完整的 GLM-5.3-Flash,尽管其权重大于可用的 GPU 显存。
这套方案并非最快。我得到的速度约为11 token/s,在 GPU 专家的数量与放置方面仍有较大调优空间。如果内存足够,您也可以尝试单卡;我这里使用双卡只是为了提供更大的冗余空间。
对我而言,本指南的要点是:KTransformers 的特别之处不在于“发明了 CPU 卸载”,而在于它让CPU 内存、CPU 计算与 GPU 计算围绕 MoE 模型的稀疏结构协同工作。
热门 DataCamp 课程
课程
学习路径
学习路径