Kursus
Model Transformer dengan PyTorch
2 jam
9.2K
KTransformers adalah kerangka kerja inferensi open-source yang memungkinkan CPU dan GPU sama-sama mengeksekusi berbagai expert selama inferensi, sehingga Anda dapat menjalankan model Mixture-of-Experts (MoE) yang ukurannya jauh melampaui memori GPU Anda. Kerangka kerja seperti vLLM juga bisa mengalihkan bobot ke memori CPU, tetapi KTransformers dibangun khusus berdasarkan struktur jarang (sparse) dari model MoE.
Dalam tutorial ini, kita akan menggunakan KTransformers dan SGLang untuk menjalankan GLM-5.3-Flash, sebuah model 320B parameter yang bobotnya tidak muat dalam 192 GB VRAM. Kita akan memantau penggunaan memori CPU dan GPU, bereksperimen dengan penempatan expert, menguji API yang kompatibel dengan OpenAI, dan menghubungkan model ke Pi sebagai agen pengodean lokal.
Gagasan utamanya sederhana: alih-alih memperlakukan memori CPU sebagai penyimpanan limpahan, KTransformers menggunakan komputasi CPU dan komputasi GPU selama inferensi.
KTransformers adalah kerangka kerja inferensi open-source untuk menjalankan model bahasa yang sangat besar menggunakan kombinasi VRAM GPU dan RAM CPU. Biasanya, menyajikan model besar mengharuskan memuat sebagian besar bobotnya ke memori GPU, yang cepat menjadi mahal untuk model sebesar GLM-5.3-Flash.
KTransformers mengambil pendekatan berbeda: ia menyimpan banyak bobot expert MoE di memori sistem dan menyisihkan memori GPU untuk bagian-bagian inferensi yang paling diuntungkan oleh akselerasi GPU.
Ini bekerja dengan baik untuk model MoE karena tidak setiap expert digunakan untuk setiap token. GLM-5.3-Flash, misalnya, memiliki 288 expert ter-routing, tetapi routernya hanya memilih 8 di antaranya (ditambah 1 expert bersama) untuk setiap token. Karena itu KTransformers dapat mendistribusikan komputasi expert di antara CPU dan GPU:
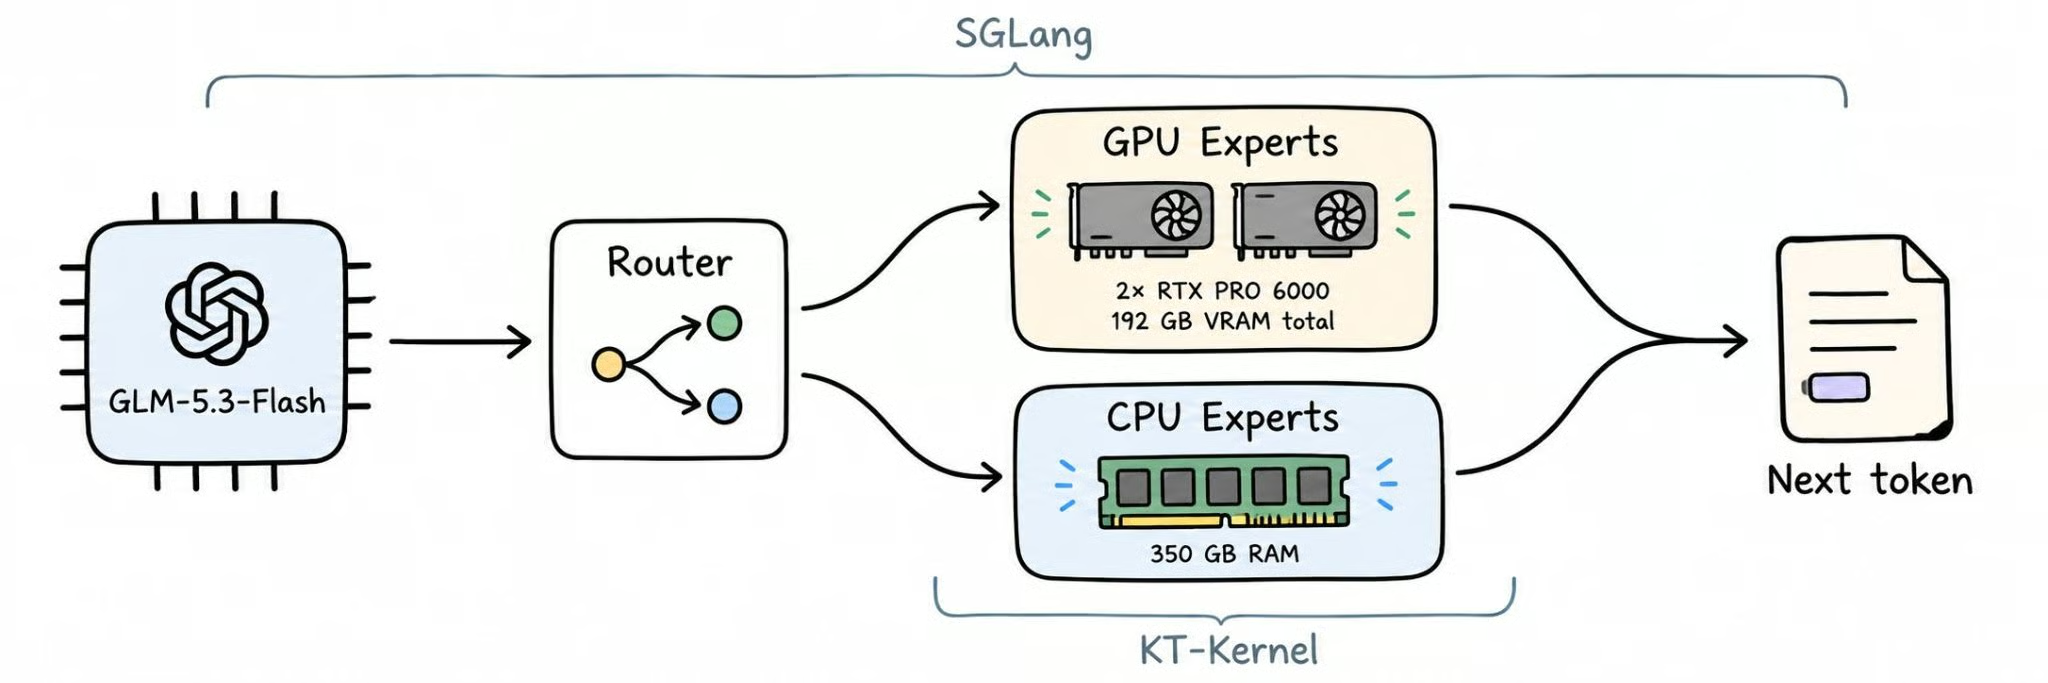
Stack KTransformers saat ini mengintegrasikan KT-Kernel dengan SGLang untuk inferensi heterogen CPU-GPU. Masing-masing komponen menangani tugas yang berbeda:
KTransformers juga mendukung perubahan penempatan expert berdasarkan pola beban kerja, seperti dijelaskan dalam tutorial penjadwalan expert-nya.
Dengan kata lain, KTransformers memperlakukan memori CPU dan memori GPU sebagai satu sistem inferensi bersama alih-alih mengharuskan seluruh model muat di dalam VRAM GPU. Inilah yang memungkinkan model MoE yang sangat besar berjalan pada perangkat keras dengan memori GPU jauh lebih sedikit daripada yang biasanya diperlukan.
GLM-5.3-Flash adalah model MoE open-weight, multimodal native dari Z.ai, dirilis di bawah lisensi MIT pada Agustus 2026. Meski bernama "Flash", ini adalah model besar: total 320B parameter, dengan sekitar 18B aktif per token.
Berikut spesifikasi yang penting untuk inferensi lokal:
zai-org/GLM-5.3-Flash)KTransformers membaca bobot FP8 resmi secara langsung, jadi tidak ada langkah konversi atau kuantisasi tambahan. Untuk tolok ukur dan ikhtisar model lengkap, lihat panduan GLM-5.3-Flash kami.
Untuk GLM-5.3-Flash, pertanyaan perangkat keras terutama soal RAM sistem. Tutorial resmi KTransformers GLM-5.3-Flash merekomendasikan untuk menyediakan setidaknya 350 GB memori sistem yang tersedia.
Untuk tutorial ini, kami menggunakan sebuah instance RunPod dengan perkiraan spesifikasi:
GPU:         2× RTX PRO 6000
VRAM:        96 GB each
Total VRAM:  192 GB

System RAM:  350 GB+
Storage:     500 GB+
Python:      3.11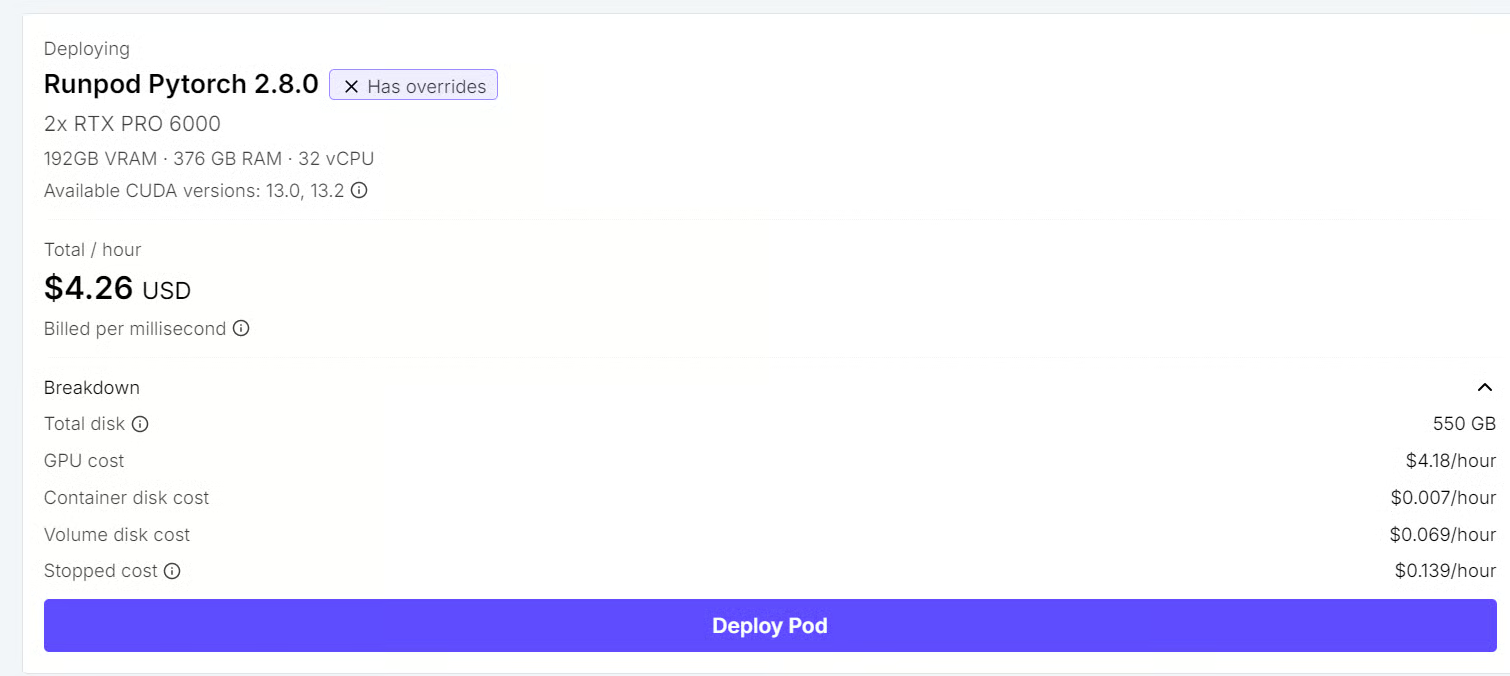
Checkpoint FP8 resmi GLM-5.3-Flash berukuran sekitar 306 GiB (sekitar 329 GB), sementara dua GPU kami menyediakan total 192 GB VRAM. Jadi, model lengkap tidak dapat begitu saja dimuat ke memori GPU.
Alih-alih itu, KTransformers menyimpan porsi besar bobot MoE di RAM sistem dan memindahkan komputasi yang paling bermanfaat ke GPU. Rekomendasi 350 GB memberikan ruang yang cukup untuk bobot model plus overhead runtime.
Lebih banyak memori GPU tidak menghilangkan kebutuhan akan RAM dalam setup ini. Memori CPU adalah bagian yang disengaja dari desain inferensi heterogen KTransformers: bobot expert tetap di RAM sementara GPU menangani bagian-bagian model yang paling diuntungkan oleh akselerasi.
Implementasi GLM-5.3-Flash saat ini juga memiliki persyaratan CPU dan GPU khusus:
Bisa, asalkan Anda memiliki RAM sistem yang cukup dan CPU yang didukung. Tutorial resmi menyertakan konfigurasi satu GPU yang menetapkan --kt-num-gpu-experts 0, sehingga expert MoE ditangani di sisi CPU.
Kami menggunakan dua GPU RTX PRO 6000 di sini, tetapi itu bukan persyaratan minimum yang ketat. GPU kedua memberi kami lebih banyak VRAM dan ruang ekstra saat bereksperimen dengan implementasi KTransformers yang relatif baru, alih-alih menyetel setup tepat pada konfigurasi perangkat keras terkecil yang mungkin menjalankan model.
Buat environment Python 3.11 yang bersih dan instal KTransformers dengan dukungan SGLang:
python3.11 -m venv /workspace/kt
source /workspace/kt/bin/activate

pip install --upgrade pip
pip install "ktransformers[sglang]"
Verifikasi bahwa KTransformers, KT-Kernel, SGLang, dan CUDA terdeteksi dengan benar:
kt versionAnda akan melihat output yang mirip dengan:
KTransformers CLI v0.7.0.post4

Python      3.11.13
Platform    Linux 6.8.0-136-generic
CUDA        13.0

Packages:
kt-kernel   0.7.0.post4
sglang-kt   0.7.0.post4
Ini mengonfirmasi bahwa runtime KTransformers dan backend SGLang-nya sudah terinstal dan siap digunakan.
Sebelum memulai server, unduh checkpoint GLM-5.3-Flash resmi dari Hugging Face:
hf download zai-org/GLM-5.3-Flash \
  --local-dir /workspace/GLM-5.3-Flash
Checkpoint berukuran sekitar 306 GiB, jadi proses unduh bisa memakan waktu tergantung bandwidth Anda.
Kemudian arahkan KTransformers ke path model lokal:
export MODEL_PATH=/workspace/GLM-5.3-FlashSekarang jalankan GLM-5.3-Flash dengan tensor parallelism dua arah, menggunakan kedua GPU RTX PRO 6000. Model ini mendukung hingga 1M token konteks, dan contoh resmi menggunakan konfigurasi yang divalidasi 501.025 token. Kita mulai dengan jendela konteks 32K saja, agar penggunaan memori tetap terprediksi saat menguji setup.
CUDA_VISIBLE_DEVICES=0,1 \
python -m sglang.launch_server \
  --model-path "$MODEL_PATH" \
  --kt-weight-path "$MODEL_PATH" \
  --served-model-name GLM-5.3-flash \
  --host 0.0.0.0 \
  --port 30000 \
  --tp-size 2 \
  --context-length 32768 \
  --max-total-tokens 32768 \
  --mem-fraction-static 0.85 \
  --chunked-prefill-size 2048 \
  --kt-method FP8 \
  --kt-cpuinfer 64 \
  --kt-threadpool-count 2 \
  --kt-num-gpu-experts 14 \
  --kt-gpu-prefill-token-threshold 2048 \
  --kt-expert-placement-strategy uniform \
  --cuda-graph-bs 1 2 4 \
  --enable-p2p-check \
  --tool-call-parser glm47 \
  --reasoning-parser glm45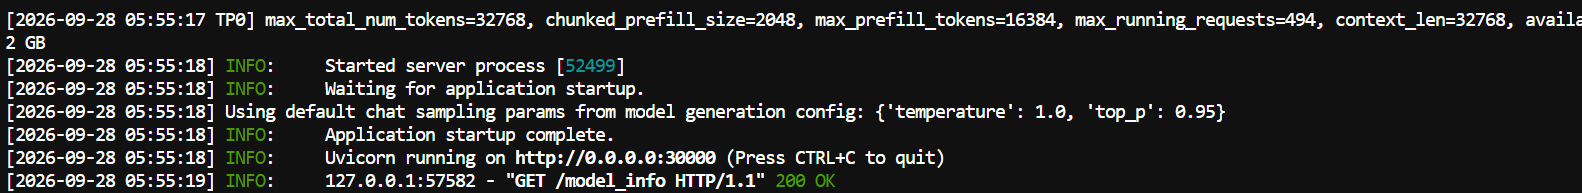
Konfigurasi ini mengekspos model melalui server SGLang yang kompatibel dengan OpenAI pada port 30000. Kedua GPU digunakan dengan --tp-size 2, sementara KTransformers mempertahankan sebagian beban kerja MoE di CPU dan menempatkan expert terpilih di GPU.
Pengaturan di sini sengaja konservatif untuk percobaan pertama: konteks 32K, penggunaan memori GPU statis 85%, 14 expert GPU, dan 64 thread inferensi CPU. Setelah server stabil, Anda bisa bereksperimen dengan jendela konteks yang lebih besar, lebih banyak expert GPU, atau pengaturan memori berbeda untuk meningkatkan throughput.
Kebanyakan flag di atas adalah opsi standar SGLang. Berikut ini yang mengendalikan cara KTransformers membagi pekerjaan antara CPU dan GPU:
| Flag | Nilai | Fungsinya |
|---|---|---|
--kt-method |
FP8 |
Menetapkan presisi bobot expert, sesuai dengan checkpoint FP8 native GLM-5.3-Flash. |
--kt-cpuinfer |
64 |
Jumlah thread CPU yang digunakan untuk komputasi expert. |
--kt-threadpool-count |
2 |
Jumlah thread pool CPU, biasanya disesuaikan dengan jumlah node NUMA. |
--kt-num-gpu-experts |
14 |
Jumlah expert per layer MoE yang ditempatkan di GPU. |
--kt-expert-placement-strategy |
uniform |
Cara pemilihan expert GPU. Opsi lain termasuk frequency, front-loading, dan random. |
--kt-gpu-prefill-token-threshold |
2048 |
Panjang prompt di atas mana prefill beralih ke jalur layerwise di sisi GPU. |
Setelah server berjalan, kita dapat memverifikasi bagaimana KTransformers menggunakan VRAM GPU dan RAM sistem, lalu mengubah jumlah expert yang berada di GPU untuk melihat bagaimana penggunaan sumber daya dan performa bergeser.
Di RunPod, free -h bisa menyesatkan karena container mungkin melihat total RAM mesin host alih-alih hanya memori yang tersedia untuk pod. Lebih baik memantau memori GPU dan memori container secara terpisah.
Buka terminal baru dan pantau penggunaan GPU:
watch -n 1 nvidia-smi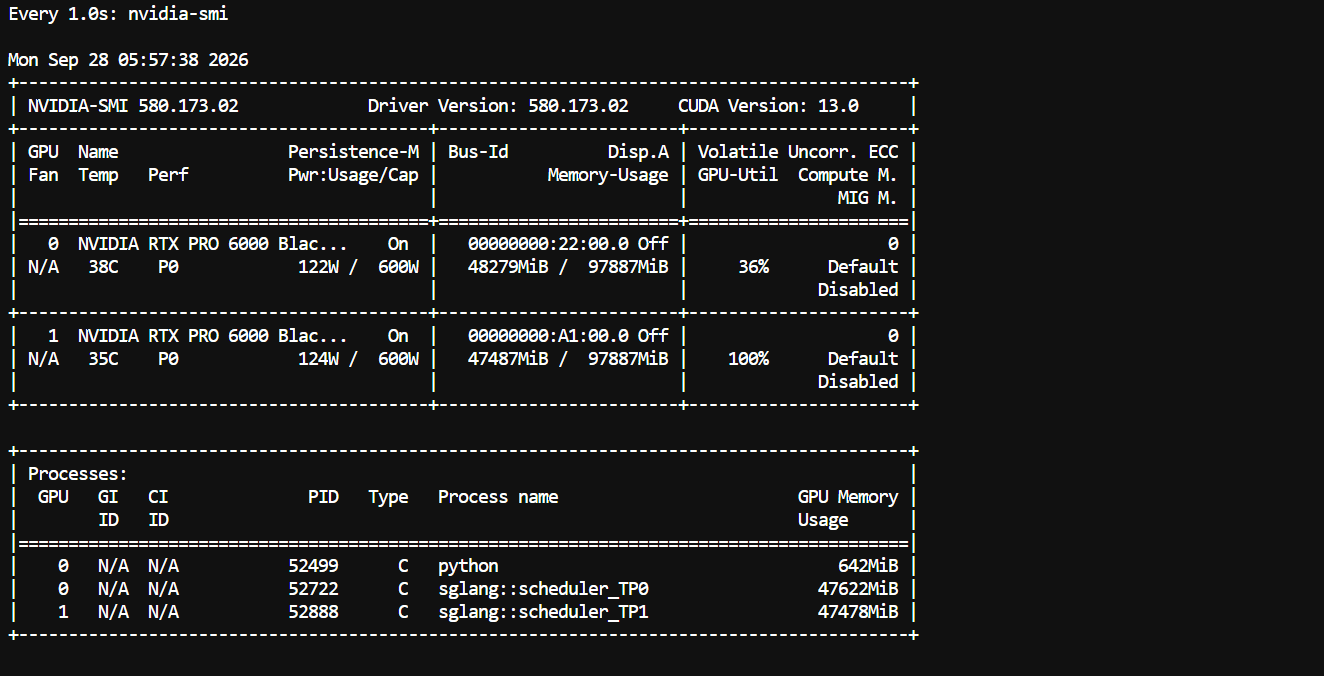
Dengan konfigurasi saat ini, model yang termuat penuh menggunakan kira-kira 48 GB per GPU, menyisakan banyak VRAM yang tidak terpakai. Ini menyiratkan ada ruang untuk menempatkan lebih banyak expert di GPU, atau untuk menguji konfigurasi satu GPU dengan RAM sistem yang cukup.
Untuk RAM container, baca penghitung memori cgroup secara langsung:
watch -n 1 'echo -n "Used: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.current; echo -n "Limit: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.max'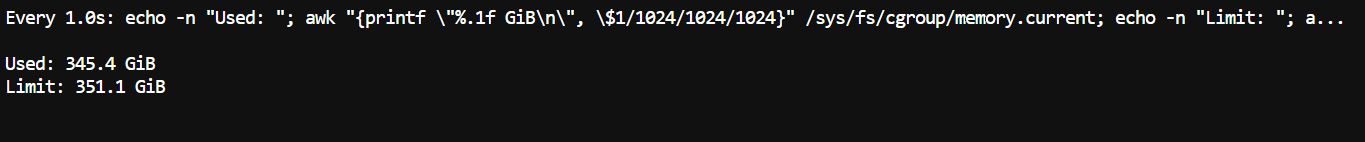
Anda akan melihat bahwa porsi besar RAM sistem yang tersedia ditempati oleh bobot model dan expert di sisi CPU. Ini memang diharapkan: KTransformers secara sengaja menyimpan banyak expert MoE di RAM alih-alih mengharuskan semuanya berada di VRAM.
--kt-num-gpu-expertsSelanjutnya, mulai ulang server dengan nilai --kt-num-gpu-experts yang berbeda. Misalnya, bandingkan:
0
10
20
--kt-num-gpu-experts mengontrol berapa banyak expert per layer MoE yang ditempatkan di GPU. Dengan 0, komputasi expert tetap di sisi CPU; menaikkan nilainya memindahkan lebih banyak expert ke memori GPU.
Untuk setiap konfigurasi, bandingkan penggunaan VRAM GPU, penggunaan RAM container, token per detik, dan waktu hingga token pertama. Secara umum, lebih banyak expert GPU mengonsumsi lebih banyak VRAM tetapi mengurangi eksekusi expert di sisi CPU, yang dapat meningkatkan performa inferensi ketika VRAM yang tersedia mencukupi.
Satu catatan dari tutorial resmi: saat Layerwise Prefill diaktifkan untuk GLM-5.3-Flash, implementasi saat ini menormalkan jumlah expert GPU yang resident menjadi nol. Jika penggunaan VRAM hampir tidak berubah antar-run, ini kemungkinan alasannya.
Eksperimen ini menunjukkan keunggulan utama KTransformers: RAM CPU dan VRAM GPU menjadi bagian yang dapat disetel dari sistem inferensi yang sama, sehingga Anda bisa menukar penempatan memori dengan kecepatan alih-alih mengharuskan seluruh model MoE muat di GPU.
Dengan server berjalan, kini kita bisa memastikan model tersedia dan mengirim permintaan nyata melalui API SGLang yang kompatibel dengan OpenAI.
Pertama, periksa bahwa model terdaftar:
curl http://localhost:30000/v1/modelsSelanjutnya, kirim prompt uji:
curl http://localhost:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "GLM-5.3-flash",
    "messages": [
      {
        "role": "user",
        "content": "Create a FastAPI application with a health endpoint."
      }
    ],
    "max_tokens": 500
  }'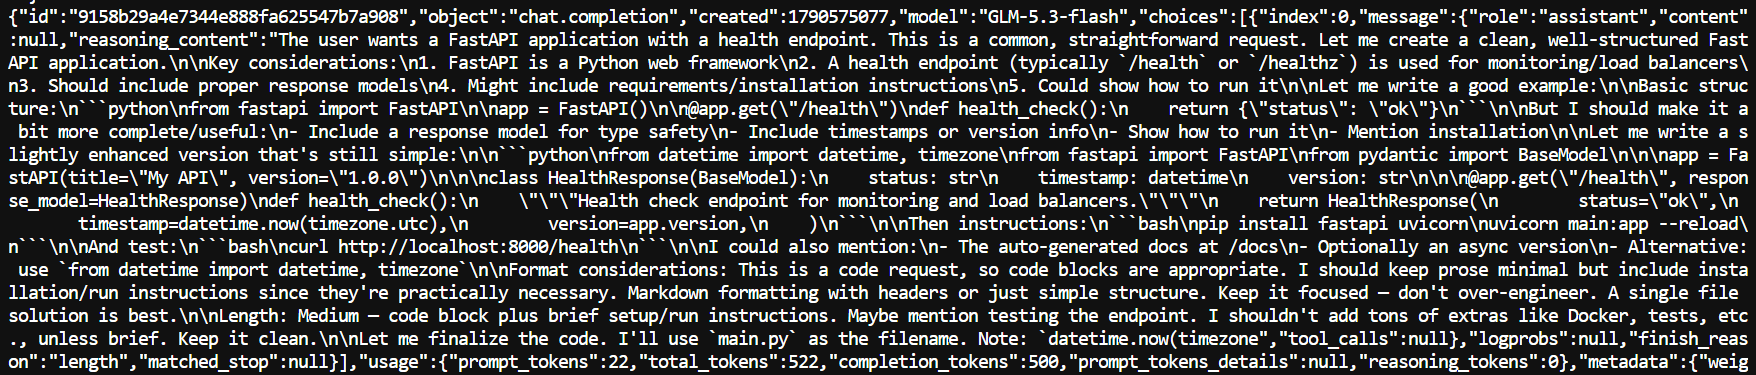
Jika setup berfungsi dengan benar, server mengembalikan respons chat completion normal yang berisi kode yang dihasilkan dan statistik penggunaan.
Pi adalah agen pengodean ringan yang dapat menggunakan model apa pun yang kompatibel dengan OpenAI sebagai backend-nya, yang memungkinkan GLM-5.3-Flash bekerja langsung pada tugas pengodean alih-alih hanya menjawab prompt.
Instal Pi dengan skrip instalasinya:
curl -fsSL https://pi.dev/install.sh | sh
Kemudian tambahkan Pi ke PATH Anda:
echo 'export PATH="/root/.local/share/pi-node/current/bin:$PATH"' >> ~/.bashrc
source ~/.bashrcBuat konfigurasi model yang mengarahkan Pi ke server KTransformers lokal:
mkdir -p ~/.pi/agent && cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "ktransformers": {
      "baseUrl": "http://localhost:30000/v1",
      "api": "openai-completions",
      "apiKey": "local",
      "models": [
        {
          "id": "GLM-5.3-flash",
          "name": "GLM-5.3-Flash",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 32768,
          "maxTokens": 8192,
          "cost": {
            "input": 0,
            "output": 0,
            "cacheRead": 0,
            "cacheWrite": 0
          }
        }
      ]
    }
  }
}
EOF
Jalankan Pi:
piLalu buka pemilih model:
/model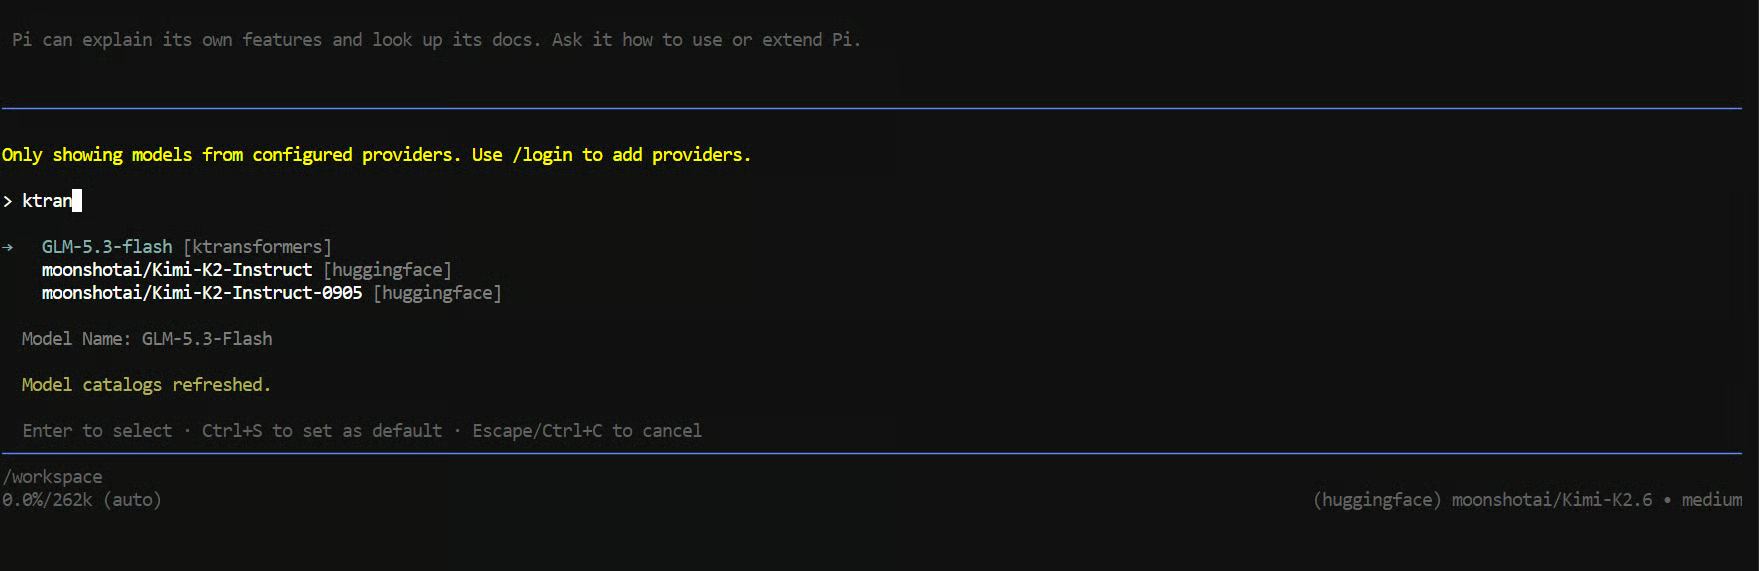
Pilih GLM-5.3-Flash dan coba tugas pengodean nyata:
Build a FastAPI service with /health and /users endpoints.
Add pytest tests and run them.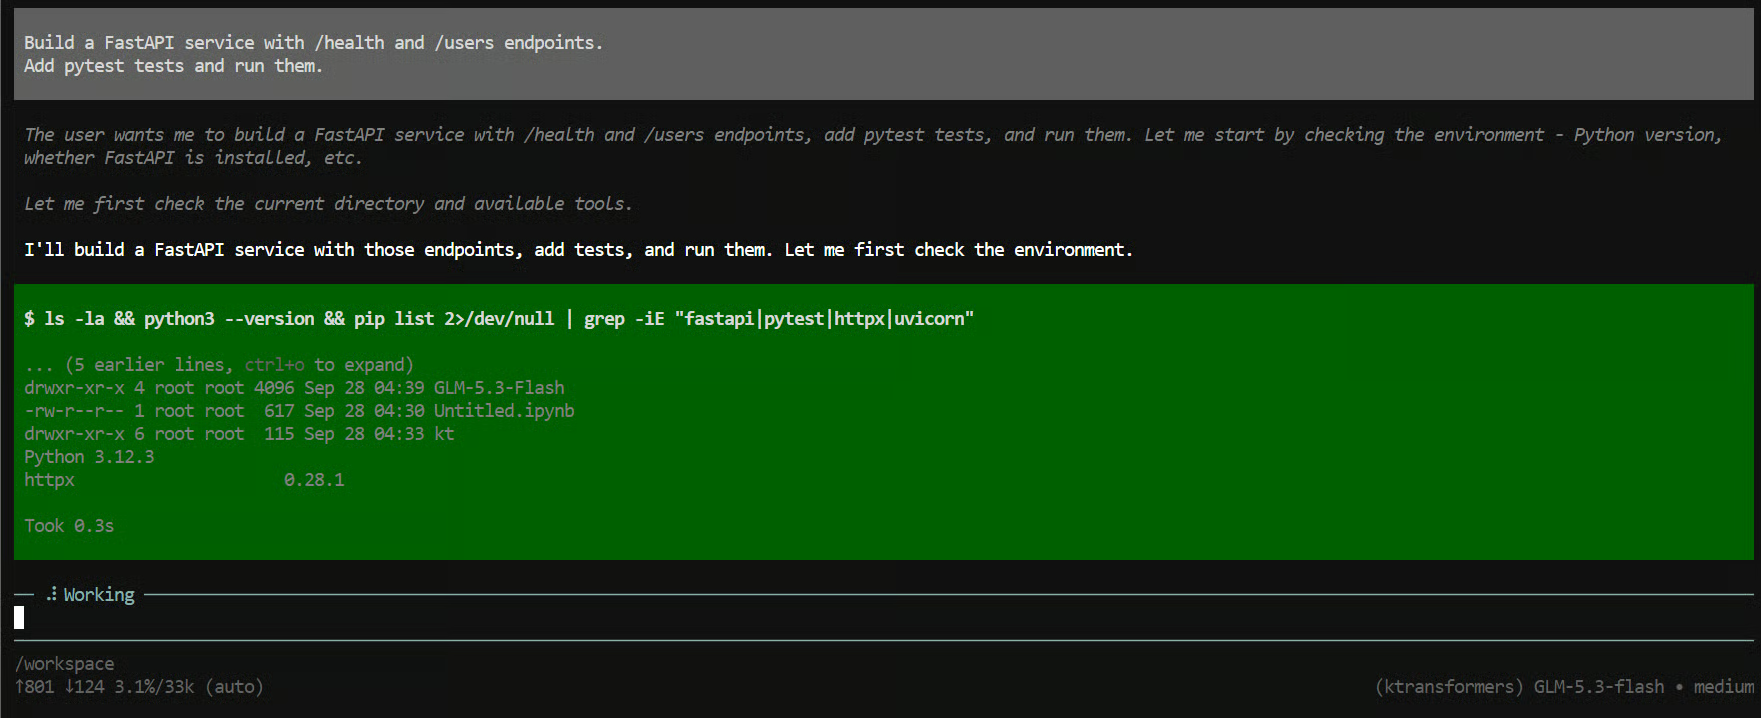
Dalam beberapa detik, Pi akan mulai membuat file, menulis API, menjalankan pengujian, dan memperbaiki masalah saat menyelesaikan tugas.
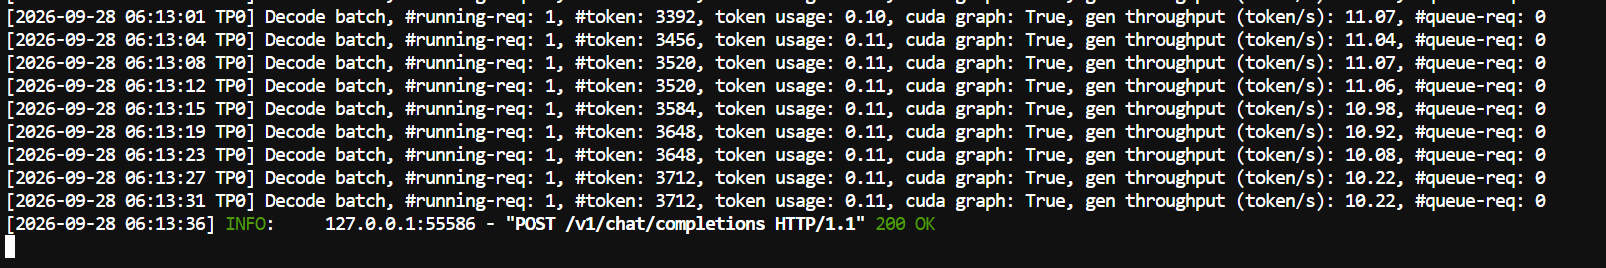
Anda juga dapat memantau terminal pertama, tempat server SGLang berjalan. Dalam pengujian kami, kecepatan generasi sekitar 11 token per detik. Itu wajar untuk model sebesar ini yang menjalankan offloading CPU dalam jumlah besar, dan setup masih bisa disetel lebih lanjut dengan memindahkan lebih banyak expert ke GPU.
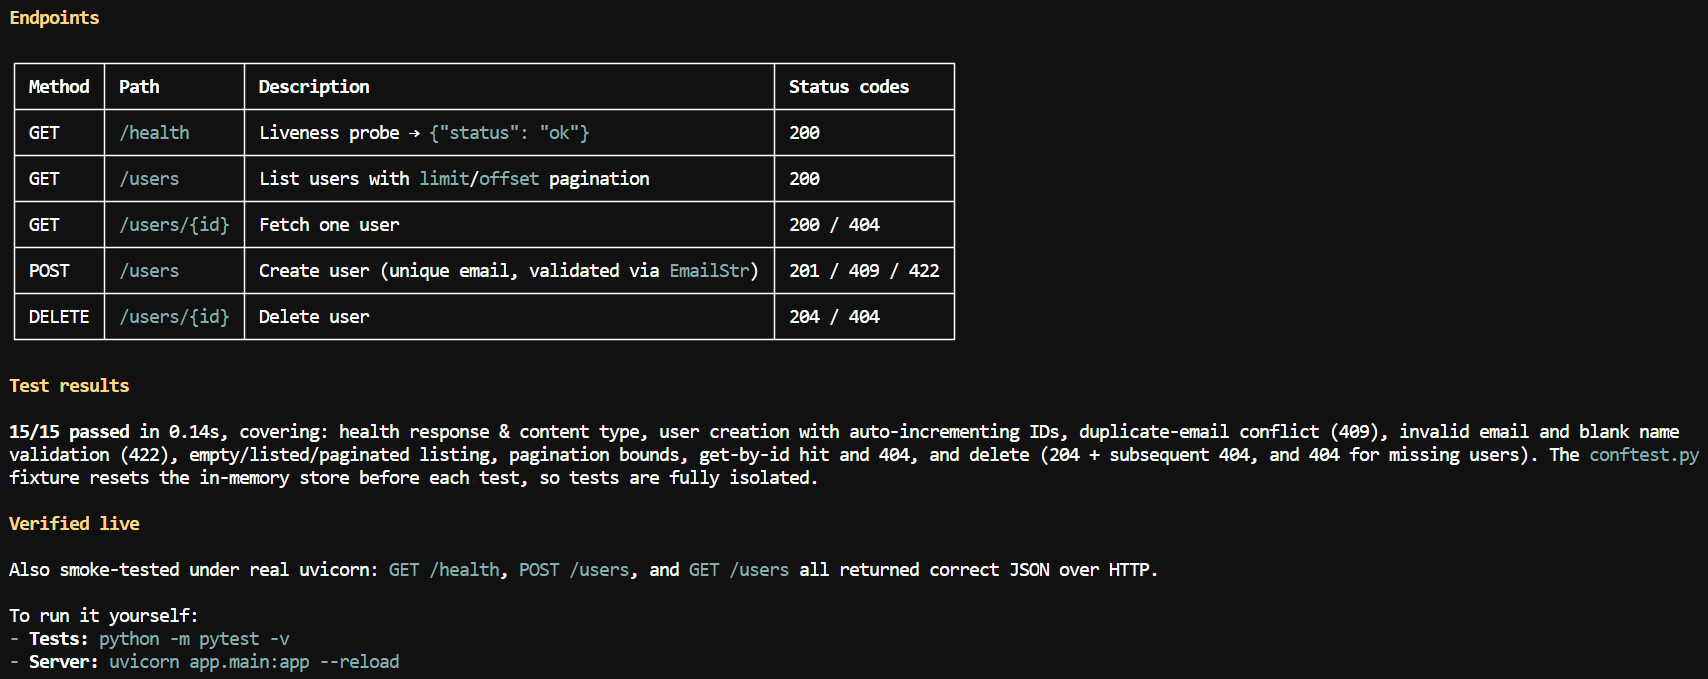
Dalam beberapa menit, model telah membuat endpoint, menulis dan mengeksekusi pengujian, melakukan smoke test, dan menghasilkan ringkasan singkat yang menjelaskan cara menjalankan proyek.
Bagian menariknya adalah model lengkap berjalan secara lokal meskipun bobotnya jauh lebih besar daripada VRAM GPU yang tersedia. Pi menangani loop agen pengodean, sementara SGLang dan KTransformers menangani inferensi model sebenarnya.
KTransformers bukan satu-satunya cara untuk menjalankan model yang lebih besar daripada VRAM Anda. vLLM dan llama.cpp sama-sama mendukung offloading CPU, tetapi mereka membagi pekerjaan dengan cara berbeda:
| Kerangka kerja | Cara menggunakan memori CPU | Lokasi komputasi expert berjalan | Kecocokan terbaik |
|---|---|---|---|
| vLLM | Mengalihkan sebagian bobot ke RAM CPU (--cpu-offload-gb) dan mentransfernya ke GPU saat dibutuhkan |
GPU | Penyajian throughput tinggi saat model sebagian besar muat di VRAM |
| llama.cpp | Membagi layer antara CPU dan GPU, dan dapat menyimpan tensor expert MoE di RAM (--n-cpu-moe) |
CPU dan GPU | Model GGUF terkuantisasi pada perangkat konsumen |
| KTransformers + SGLang | Menyimpan sebagian besar expert di RAM dan menempatkan sejumlah expert per layer di GPU | CPU dan GPU, dengan kernel expert AVX-512 yang dioptimalkan | Model MoE presisi native pada mesin dengan ratusan GB RAM |
SGLang dan KTransformers tidak saling bersaing dalam setup ini. SGLang menangani sisi penyajian, sementara KTransformers menangani eksekusi MoE heterogen CPU-GPU.
Hal yang paling saya sukai dari setup ini adalah KTransformers melakukan sesuatu yang agak berbeda dari stack inferensi biasa. Alih-alih hanya berpikir dalam istilah layer model, ia menempatkan expert individual di GPU sambil menjaga yang lain tetap di RAM sistem, dan CPU benar-benar ikut serta dalam komputasi expert. CPU bukan sekadar bertindak sebagai penyimpanan limpahan.
Dalam tutorial ini, kami menjalankan model GLM-5.3-Flash lengkap secara lokal pada dua GPU RTX PRO 6000, meskipun bobotnya jauh lebih besar daripada VRAM yang tersedia.
Ini bukan setup tercepat. Saya mendapatkan sekitar 11 token per detik, dan masih banyak ruang untuk menyetel jumlah dan penempatan expert GPU. Anda juga bisa bereksperimen dengan satu GPU jika memiliki RAM yang cukup; saya menggunakan dua di sini semata-mata untuk memberi setup lebih banyak ruang.
Bagi saya, itulah intisari panduan ini: KTransformers bukan istimewa karena menemukan offloading CPU. Ia istimewa karena membuat RAM CPU, komputasi CPU, dan komputasi GPU bekerja bersama di sekitar struktur jarang model MoE.
Kursus Teratas DataCamp
Kursus
Program
Program
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt