
Kurs
Transformer-Modelle mit PyTorch
2 Std.
9.2K
KTransformers ist ein Open-Source-Inferenz-Framework, bei dem CPU und GPU während der Inferenz aktiv unterschiedliche Experten ausführen. So kannst du Mixture-of-Experts-Modelle (MoE) betreiben, die deutlich größer sind als dein GPU-Speicher. Frameworks wie vLLM können zwar ebenfalls Gewichte in den CPU-Speicher auslagern, aber KTransformers ist speziell auf die spärliche Struktur von MoE-Modellen ausgelegt.
In diesem Tutorial verwenden wir KTransformers und SGLang, um GLM-5.3-Flash auszuführen – ein Modell mit 320 Milliarden Parametern, dessen Gewichte nicht in 192 GB VRAM passen. Wir überwachen die CPU- und GPU-Speicherauslastung, probieren unterschiedliche Expertenplatzierungen aus, testen die OpenAI-kompatible API und binden das Modell als lokalen Coding-Agent in Pi ein.
Die Grundidee ist einfach: Anstatt den CPU-Speicher nur als Überlauf zu behandeln, nutzt KTransformers sowohl CPU-Rechenleistung als auch GPU-Rechenleistung während der Inferenz.
KTransformers ist ein Open-Source-Inferenz-Framework zum Ausführen sehr großer Sprachmodelle mithilfe einer Kombination aus GPU-VRAM und CPU-RAM. Normalerweise müssen beim Serven großer Modelle die meisten Gewichte in den GPU-Speicher geladen werden – das wird bei einem Modell wie GLM-5.3-Flash schnell teuer.
KTransformers wählt einen anderen Ansatz: Viele MoE-Expertengewichte verbleiben im Systemspeicher, während der GPU-Speicher für die Teile der Inferenz reserviert wird, die am meisten von GPU-Beschleunigung profitieren.
Das passt gut zu MoE-Modellen, weil nicht für jedes Token alle Experten genutzt werden. GLM-5.3-Flash hat zum Beispiel 288 geroutete Experten, aber der Router wählt pro Token nur 8 davon (plus 1 Shared-Experte) aus. KTransformers kann die Expertenberechnung daher zwischen CPU und GPU aufteilen:
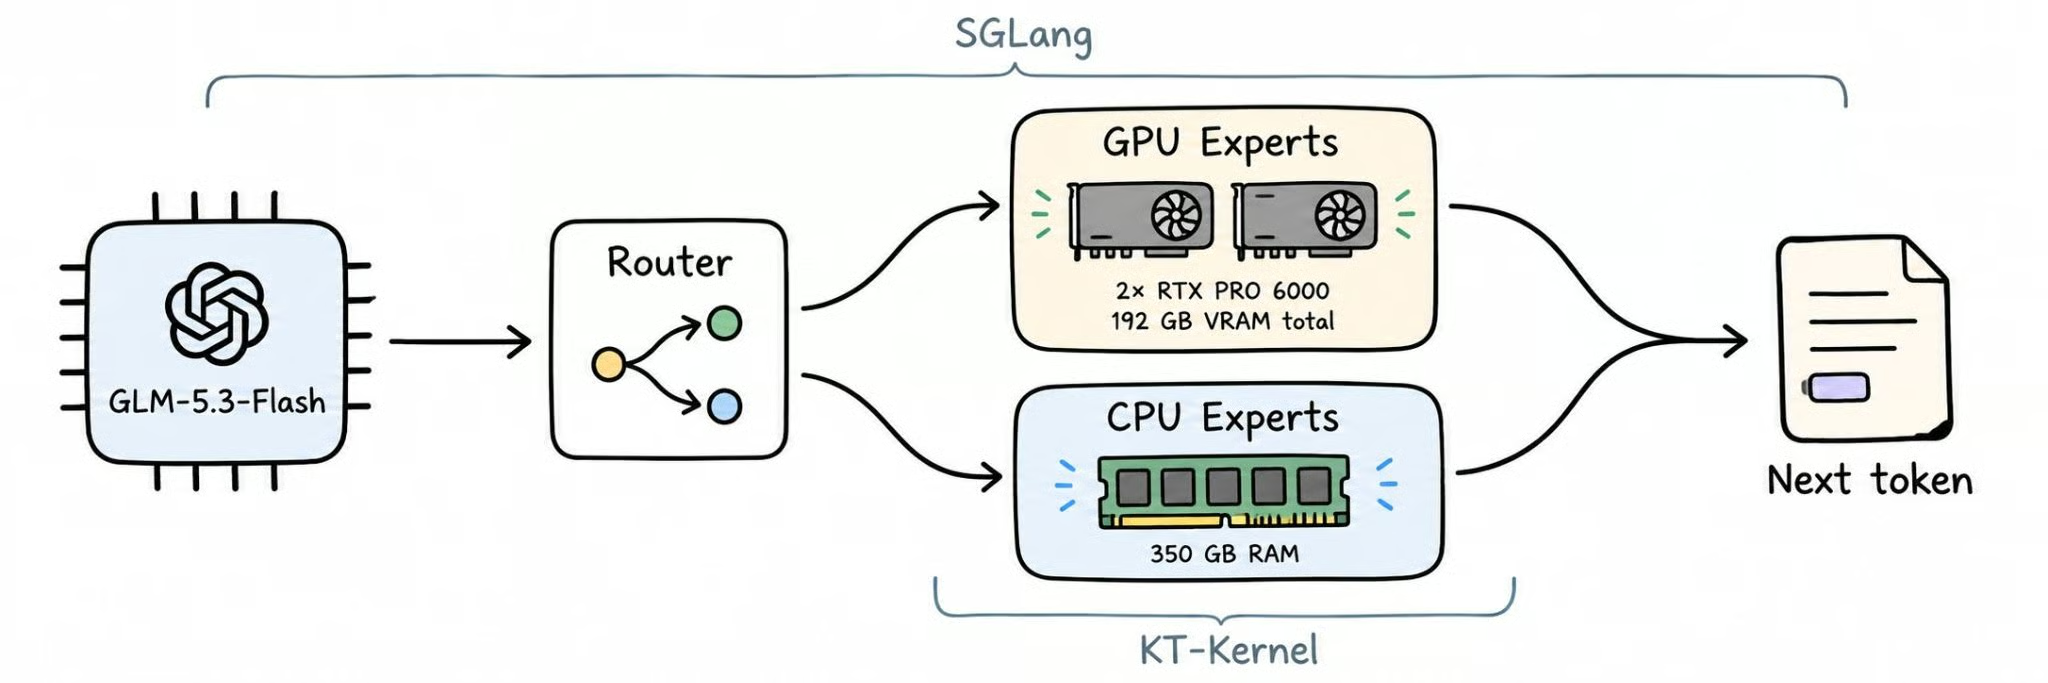
Der aktuelle KTransformers-Stack integriert KT-Kernel mit SGLang für heterogene CPU-GPU-Inferenz. Die Komponenten übernehmen unterschiedliche Aufgaben:
KTransformers unterstützt außerdem eine dynamische Expertenplatzierung basierend auf Workload-Mustern, wie im Tutorial zur Expertenschedulierung beschrieben.
Anders ausgedrückt, KTransformers behandelt CPU- und GPU-Speicher als gemeinsames Inferenzsystem, statt zu verlangen, dass das gesamte Modell in den GPU-VRAM passt. Dadurch lassen sich sehr große MoE-Modelle auf Hardware mit deutlich weniger GPU-Speicher betreiben, als normalerweise nötig wäre.
GLM-5.3-Flash ist Z.ais Open-Weight-, nativ multimodales MoE-Modell, veröffentlicht unter der MIT-Lizenz im August 2026. Trotz des Namens "Flash" ist es ein großes Modell: insgesamt 320 Milliarden Parameter, davon etwa 18 Milliarden aktiv pro Token.
Diese Spezifikationen sind für lokale Inferenz entscheidend:
zai-org/GLM-5.3-Flash)KTransformers liest die offiziellen FP8-Gewichte direkt, es ist also keine Konvertierung oder zusätzliche Quantisierung nötig. Benchmarks und eine vollständige Modellübersicht findest du in unserem GLM-5.3-Flash-Guide.
Bei GLM-5.3-Flash dreht sich die Hardwarefrage vor allem um den System-RAM. Das offizielle KTransformers-Tutorial empfiehlt, mindestens 350 GB verfügbaren Systemspeicher zu reservieren.
Für dieses Tutorial verwenden wir eine RunPod-Instanz mit ungefähr:
GPU:         2× RTX PRO 6000
VRAM:        96 GB each
Total VRAM:  192 GB

System RAM:  350 GB+
Storage:     500 GB+
Python:      3.11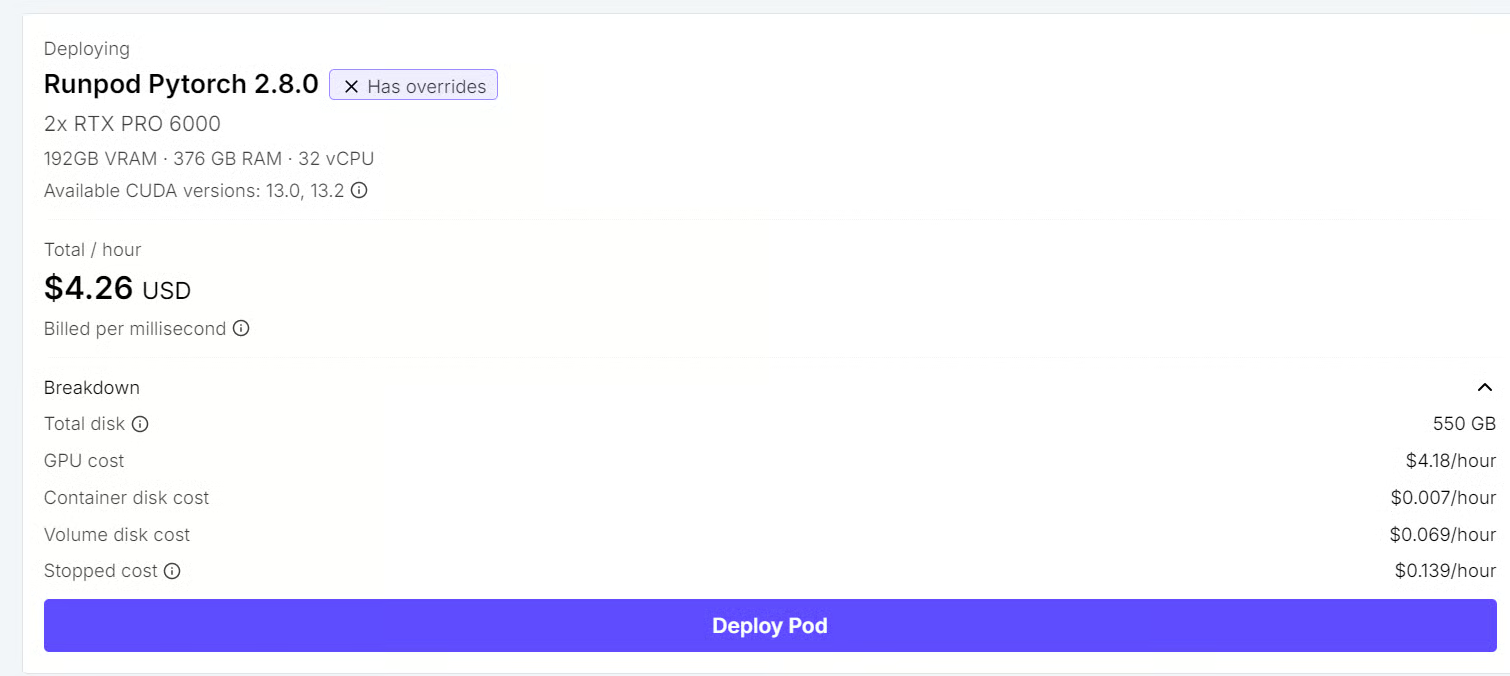
Der offizielle FP8-Checkpoint von GLM-5.3-Flash ist etwa 306 GiB groß (circa 329 GB), während unsere zwei GPUs zusammen 192 GB VRAM bieten. Das vollständige Modell kann daher nicht einfach in den GPU-Speicher geladen werden.
Stattdessen hält KTransformers einen großen Teil der MoE-Gewichte im System-RAM und verlagert die rechenintensivsten Teile auf die GPUs. Die Empfehlung von 350 GB lässt genügend Spielraum für Modellgewichte plus Laufzeit-Overhead.
Mehr GPU-Speicher hebt in diesem Setup den Bedarf an RAM nicht auf. CPU-Speicher ist ein bewusst integrierter Bestandteil des heterogenen Inferenzdesigns von KTransformers: Expertengewichte bleiben im RAM, während die GPU die Teile des Modells übernimmt, die am meisten von Beschleunigung profitieren.
Die aktuelle GLM-5.3-Flash-Implementierung hat außerdem spezifische Anforderungen an CPU und GPU:
Ja, vorausgesetzt, du hast genug System-RAM und eine unterstützte CPU. Das offizielle Tutorial enthält eine Single-GPU-Konfiguration mit --kt-num-gpu-experts 0, bei der die MoE-Experten auf der CPU-Seite berechnet werden.
Wir verwenden hier zwei RTX PRO 6000, aber das ist keine harte Mindestanforderung. Die zweite GPU verschafft uns mehr VRAM und zusätzlichen Spielraum beim Experimentieren mit einer relativ neuen KTransformers-Implementierung, anstatt das Setup auf die kleinstmögliche Hardware zu trimmen.
Erstelle eine saubere Python-3.11-Umgebung und installiere KTransformers mit SGLang-Unterstützung:
python3.11 -m venv /workspace/kt
source /workspace/kt/bin/activate

pip install --upgrade pip
pip install "ktransformers[sglang]"
Prüfe, ob KTransformers, KT-Kernel, SGLang und CUDA korrekt erkannt werden:
kt versionDu solltest eine Ausgabe in dieser Art sehen:
KTransformers CLI v0.7.0.post4

Python      3.11.13
Platform    Linux 6.8.0-136-generic
CUDA        13.0

Packages:
kt-kernel   0.7.0.post4
sglang-kt   0.7.0.post4
Damit ist bestätigt, dass die KTransformers-Runtime und das SGLang-Backend installiert und einsatzbereit sind.
Lade vor dem Start des Servers den offiziellen GLM-5.3-Flash-Checkpoint von Hugging Face herunter:
hf download zai-org/GLM-5.3-Flash \
  --local-dir /workspace/GLM-5.3-Flash
Der Checkpoint ist rund 306 GiB groß. Der Download kann je nach Bandbreite eine Weile dauern.
Weise KTransformers anschließend den lokalen Modellpfad zu:
export MODEL_PATH=/workspace/GLM-5.3-FlashStarte GLM-5.3-Flash nun mit zweifacher Tensor-Parallelität auf beiden RTX PRO 6000. Das Modell unterstützt bis zu 1 Million Token Kontext, und die offiziellen Beispiele nutzen eine validierte Konfiguration mit 501.025 Token. Wir beginnen stattdessen mit einem 32K-Kontextfenster, um die Speichernutzung beim Testen planbar zu halten.
CUDA_VISIBLE_DEVICES=0,1 \
python -m sglang.launch_server \
  --model-path "$MODEL_PATH" \
  --kt-weight-path "$MODEL_PATH" \
  --served-model-name GLM-5.3-flash \
  --host 0.0.0.0 \
  --port 30000 \
  --tp-size 2 \
  --context-length 32768 \
  --max-total-tokens 32768 \
  --mem-fraction-static 0.85 \
  --chunked-prefill-size 2048 \
  --kt-method FP8 \
  --kt-cpuinfer 64 \
  --kt-threadpool-count 2 \
  --kt-num-gpu-experts 14 \
  --kt-gpu-prefill-token-threshold 2048 \
  --kt-expert-placement-strategy uniform \
  --cuda-graph-bs 1 2 4 \
  --enable-p2p-check \
  --tool-call-parser glm47 \
  --reasoning-parser glm45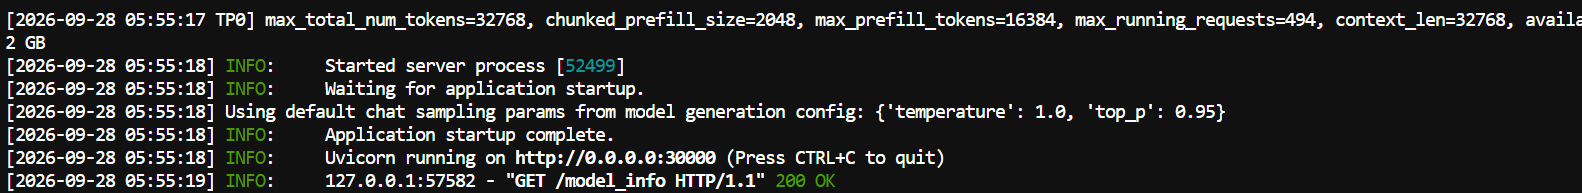
Diese Konfiguration stellt das Modell über einen OpenAI-kompatiblen SGLang-Server auf Port 30000 bereit. Die beiden GPUs werden mit --tp-size 2 genutzt, während KTransformers einen Teil der MoE-Last auf der CPU belässt und ausgewählte Experten auf die GPUs legt.
Die Einstellungen sind für den ersten Lauf bewusst konservativ: 32K Kontext, 85% statische GPU-Speichernutzung, 14 GPU-Experten und 64 CPU-Inferenz-Threads. Sobald der Server stabil läuft, kannst du mit einem größeren Kontextfenster, mehr GPU-Experten oder anderen Speichereinstellungen experimentieren, um den Durchsatz zu erhöhen.
Die meisten Flags sind Standardoptionen von SGLang. Diese steuern, wie KTransformers die Arbeit zwischen CPU und GPU aufteilt:
| Flag | Wert | Funktion |
|---|---|---|
--kt-method |
FP8 |
Legt die Präzision der Expertengewichte fest und entspricht dem nativen FP8-Checkpoint von GLM-5.3-Flash. |
--kt-cpuinfer |
64 |
Anzahl der CPU-Threads für die Expertenberechnung. |
--kt-threadpool-count |
2 |
Anzahl der CPU-Threadpools, meist entsprechend der Anzahl der NUMA-Knoten. |
--kt-num-gpu-experts |
14 |
Anzahl der pro MoE-Schicht auf der GPU platzierten Experten. |
--kt-expert-placement-strategy |
uniform |
Strategie zur Auswahl der GPU-Experten. Weitere Optionen sind frequency, front-loading und random. |
--kt-gpu-prefill-token-threshold |
2048 |
Promptlänge, ab der Prefill auf den GPU-seitigen layerweisen Pfad umschaltet. |
Da der Server läuft, können wir prüfen, wie KTransformers GPU-VRAM und System-RAM nutzt, und anschließend die Anzahl der GPU-ansässigen Experten verändern, um die Verschiebungen bei Ressourcenbedarf und Performance zu beobachten.
Auf RunPod kann free -h in die Irre führen, da ein Container ggf. den gesamten RAM des Hosts sieht und nicht nur den für das Pod verfügbaren Speicher. Es ist besser, GPU-Speicher und Container-Speicher separat zu überwachen.
Öffne ein neues Terminal und überwache die GPU-Auslastung:
watch -n 1 nvidia-smi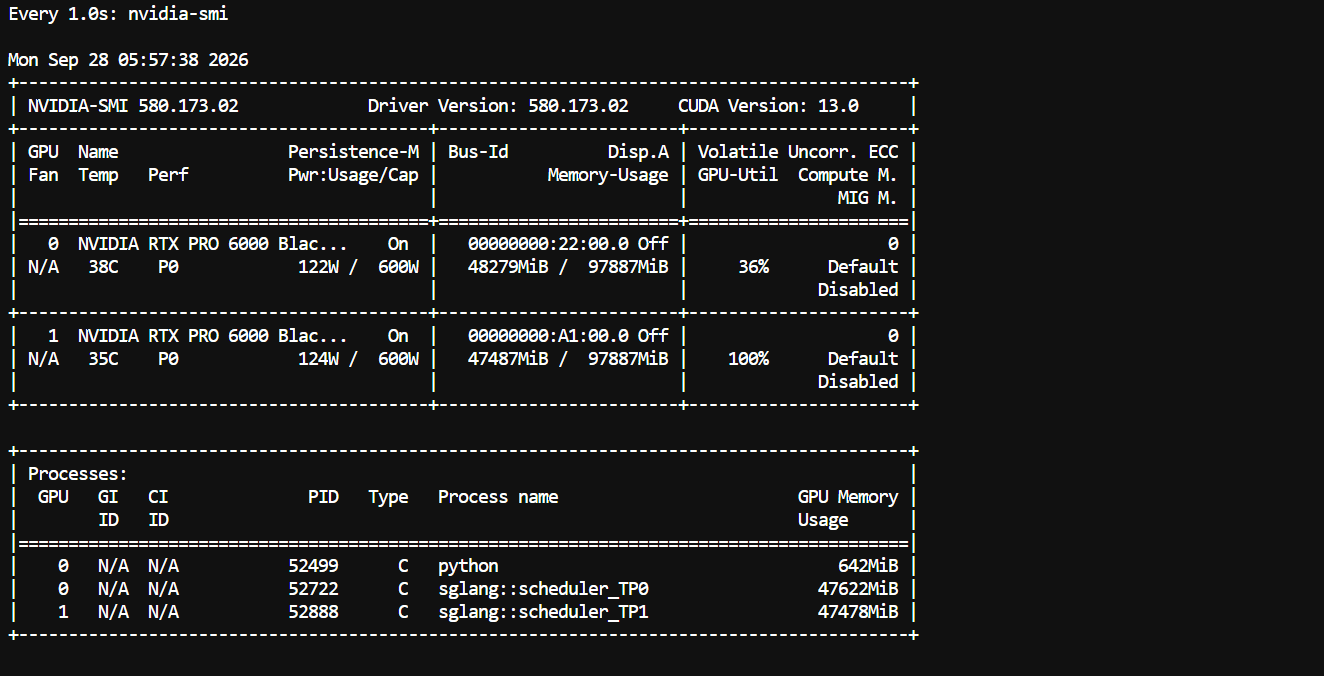
Mit unserer aktuellen Konfiguration belegt das vollständig geladene Modell etwa 48 GB pro GPU und lässt damit viel VRAM ungenutzt. Das deutet darauf hin, dass Platz für zusätzliche GPU-Experten ist – oder dass eine Single-GPU-Konfiguration mit ausreichend System-RAM testbar wäre.
Für den Container-RAM lies die cgroup-Speichercounter direkt aus:
watch -n 1 'echo -n "Used: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.current; echo -n "Limit: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.max'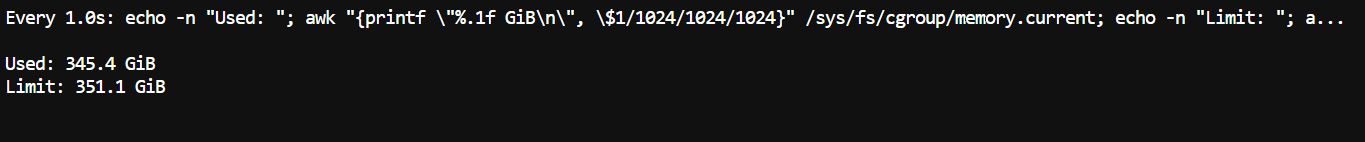
Du solltest sehen, dass ein großer Teil des verfügbaren System-RAMs durch Modellgewichte und CPU-seitige Experten belegt ist. Das ist erwartbar: KTransformers hält bewusst viele MoE-Experten im RAM, statt sie alle im VRAM zu benötigen.
--kt-num-gpu-experts feinjustierenStarte den Server als Nächstes mit unterschiedlichen Werten für --kt-num-gpu-experts neu. Vergleiche zum Beispiel:
0
10
20
--kt-num-gpu-experts steuert, wie viele Experten pro MoE-Schicht auf die GPU gelegt werden. Bei 0 bleibt die Expertenberechnung auf der CPU-Seite; höhere Werte verlagern mehr Experten in den GPU-Speicher.
Vergleiche für jede Konfiguration GPU-VRAM-Nutzung, Container-RAM-Nutzung, Token pro Sekunde und Time-to-First-Token. Im Allgemeinen verbrauchen mehr GPU-Experten mehr VRAM, reduzieren aber die CPU-seitige Expertenausführung – was die Inferenzleistung verbessern kann, sofern genügend VRAM vorhanden ist.
Ein Hinweis aus dem offiziellen Tutorial: Ist Layerwise Prefill für GLM-5.3-Flash aktiviert, normalisiert die aktuelle Implementierung die Zahl der residenten GPU-Experten ggf. auf null. Wenn sich die VRAM-Nutzung zwischen Läufen kaum ändert, ist das wahrscheinlich der Grund.
Dieses Experiment zeigt den entscheidenden Vorteil von KTransformers: CPU-RAM und GPU-VRAM werden zu justierbaren Teilen desselben Inferenzsystems. Du kannst Speicherplatzierung gegen Geschwindigkeit tauschen, statt das gesamte MoE-Modell auf die GPUs quetschen zu müssen.
Mit laufendem Server können wir nun prüfen, ob das Modell verfügbar ist, und eine echte Anfrage über SGLangs OpenAI-kompatible API senden.
Prüfe zuerst, ob das Modell registriert ist:
curl http://localhost:30000/v1/modelsSende als Nächstes einen Test-Prompt:
curl http://localhost:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "GLM-5.3-flash",
    "messages": [
      {
        "role": "user",
        "content": "Create a FastAPI application with a health endpoint."
      }
    ],
    "max_tokens": 500
  }'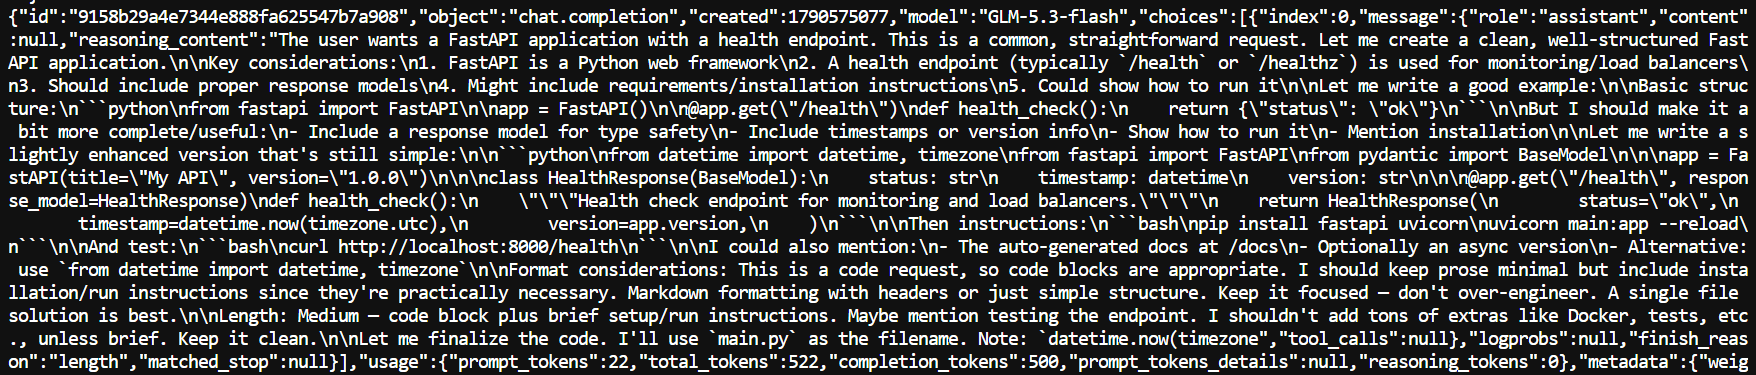
Wenn alles korrekt eingerichtet ist, liefert der Server eine normale Chat-Completion-Antwort mit generiertem Code und Nutzungsstatistiken.
Pi ist ein schlanker Coding-Agent, der jedes OpenAI-kompatible Modell als Backend verwenden kann. So kann GLM-5.3-Flash direkt an Coding-Aufgaben arbeiten, statt nur Prompts zu beantworten.
Installiere Pi mit dem Installationsskript:
curl -fsSL https://pi.dev/install.sh | sh
Füge Pi anschließend zu deinem PATH hinzu:
echo 'export PATH="/root/.local/share/pi-node/current/bin:$PATH"' >> ~/.bashrc
source ~/.bashrcErstelle eine Modellkonfiguration, die Pi auf den lokalen KTransformers-Server verweist:
mkdir -p ~/.pi/agent && cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "ktransformers": {
      "baseUrl": "http://localhost:30000/v1",
      "api": "openai-completions",
      "apiKey": "local",
      "models": [
        {
          "id": "GLM-5.3-flash",
          "name": "GLM-5.3-Flash",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 32768,
          "maxTokens": 8192,
          "cost": {
            "input": 0,
            "output": 0,
            "cacheRead": 0,
            "cacheWrite": 0
          }
        }
      ]
    }
  }
}
EOF
Starte Pi:
piÖffne dann die Modellauswahl:
/model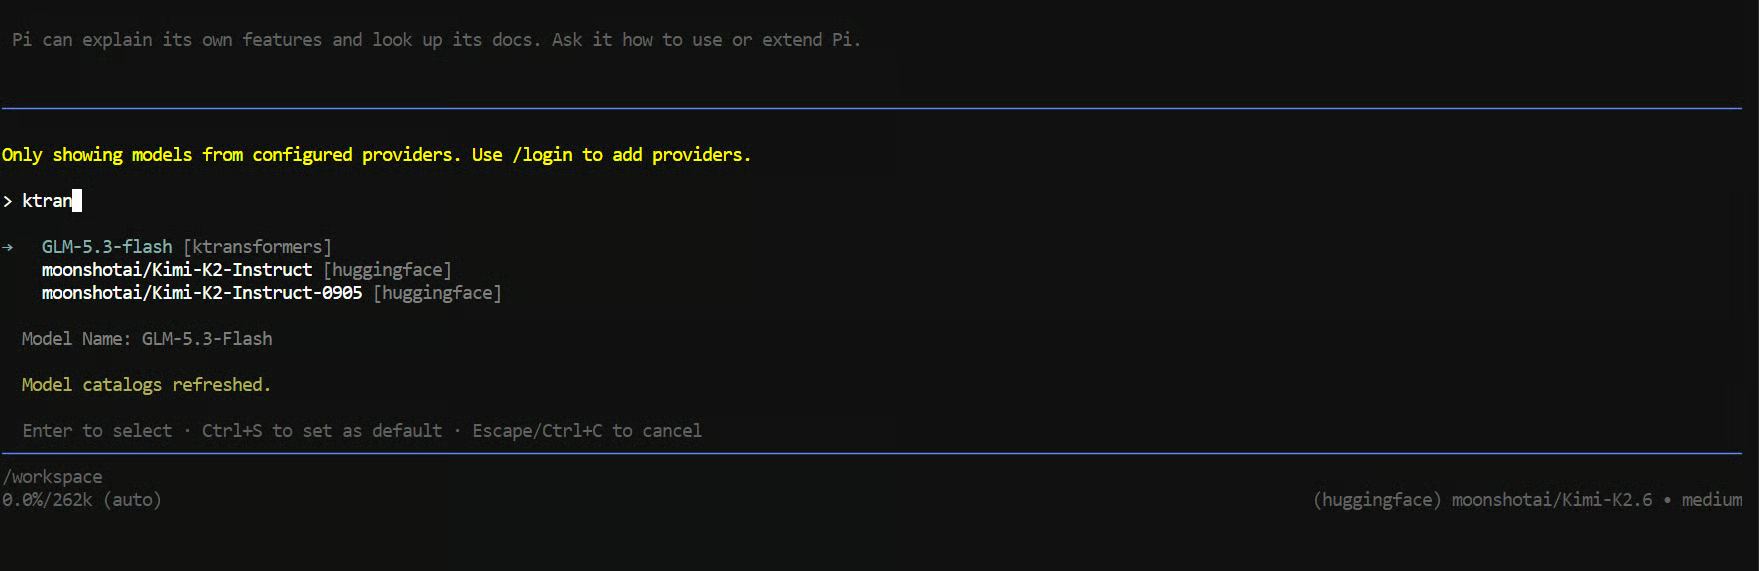
Wähle GLM-5.3-Flash und starte eine echte Coding-Aufgabe:
Build a FastAPI service with /health and /users endpoints.
Add pytest tests and run them.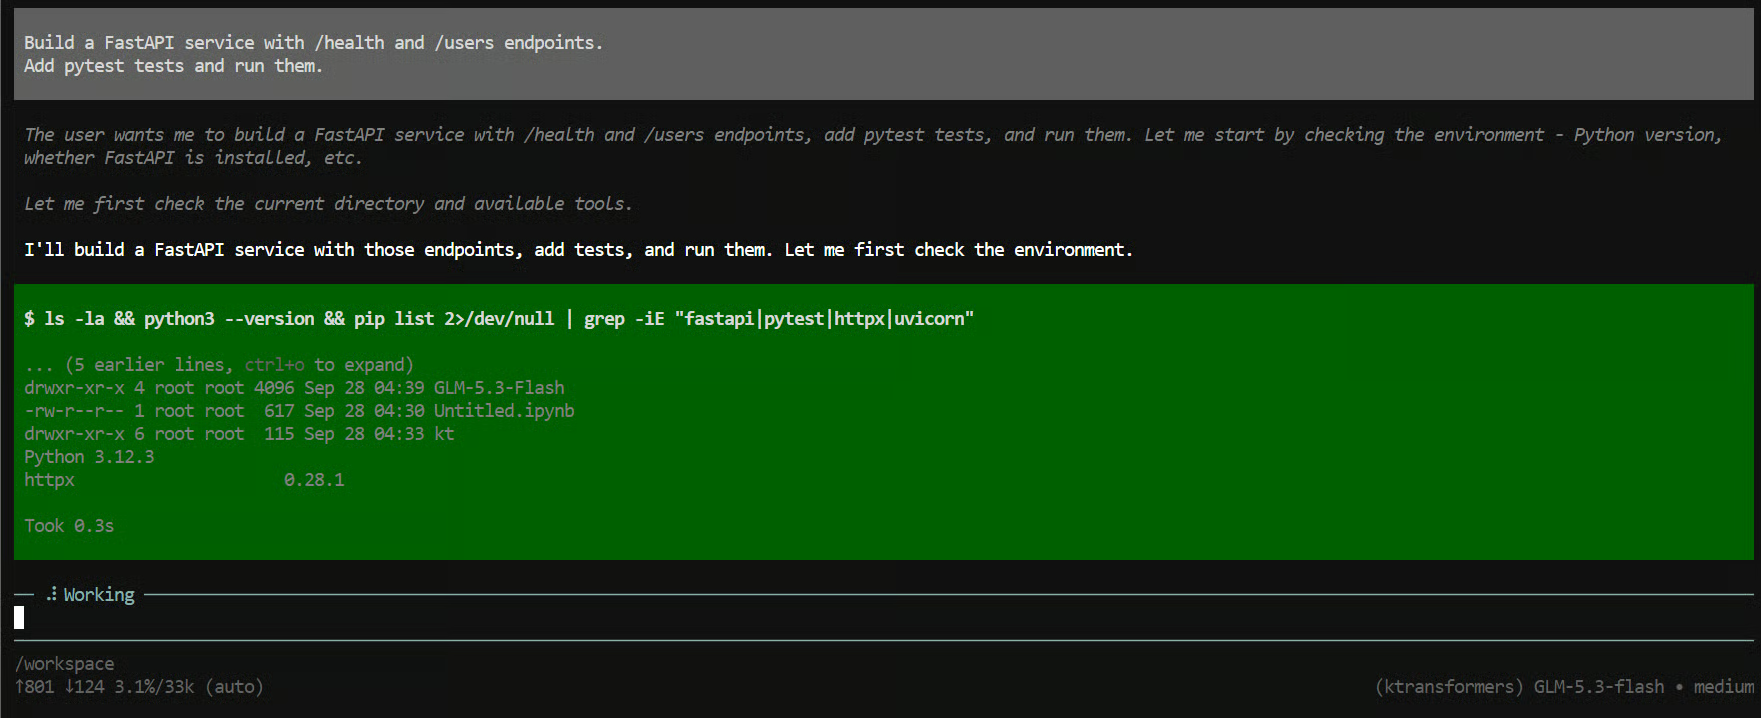
Nach wenigen Sekunden sollte Pi damit beginnen, Dateien zu erstellen, die API zu schreiben, Tests auszuführen und Probleme zu beheben, während die Aufgabe abgearbeitet wird.
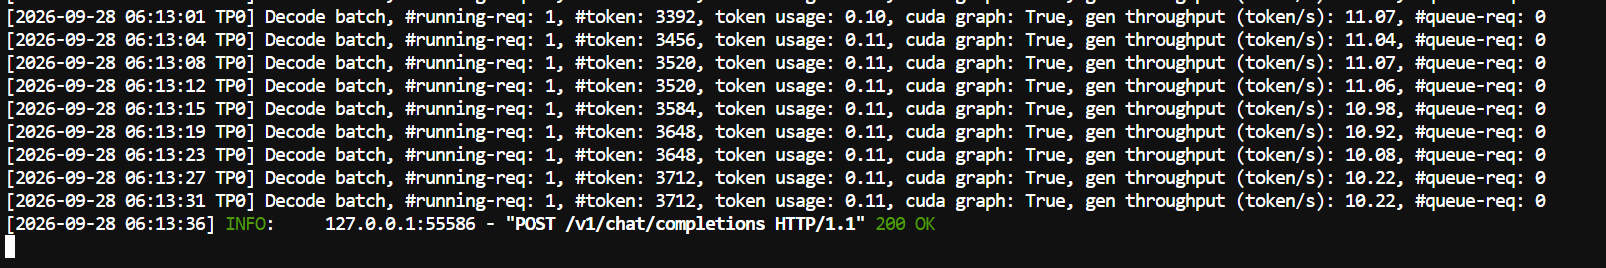
Du kannst auch im ersten Terminal zusehen, in dem der SGLang-Server läuft. In unserem Test lag die Generierungsgeschwindigkeit bei rund 11 Token pro Sekunde. Das ist für ein Modell dieser Größe mit erheblichem CPU-Offloading plausibel, und das Setup lässt sich weiter tunen, indem mehr Experten auf die GPUs verschoben werden.
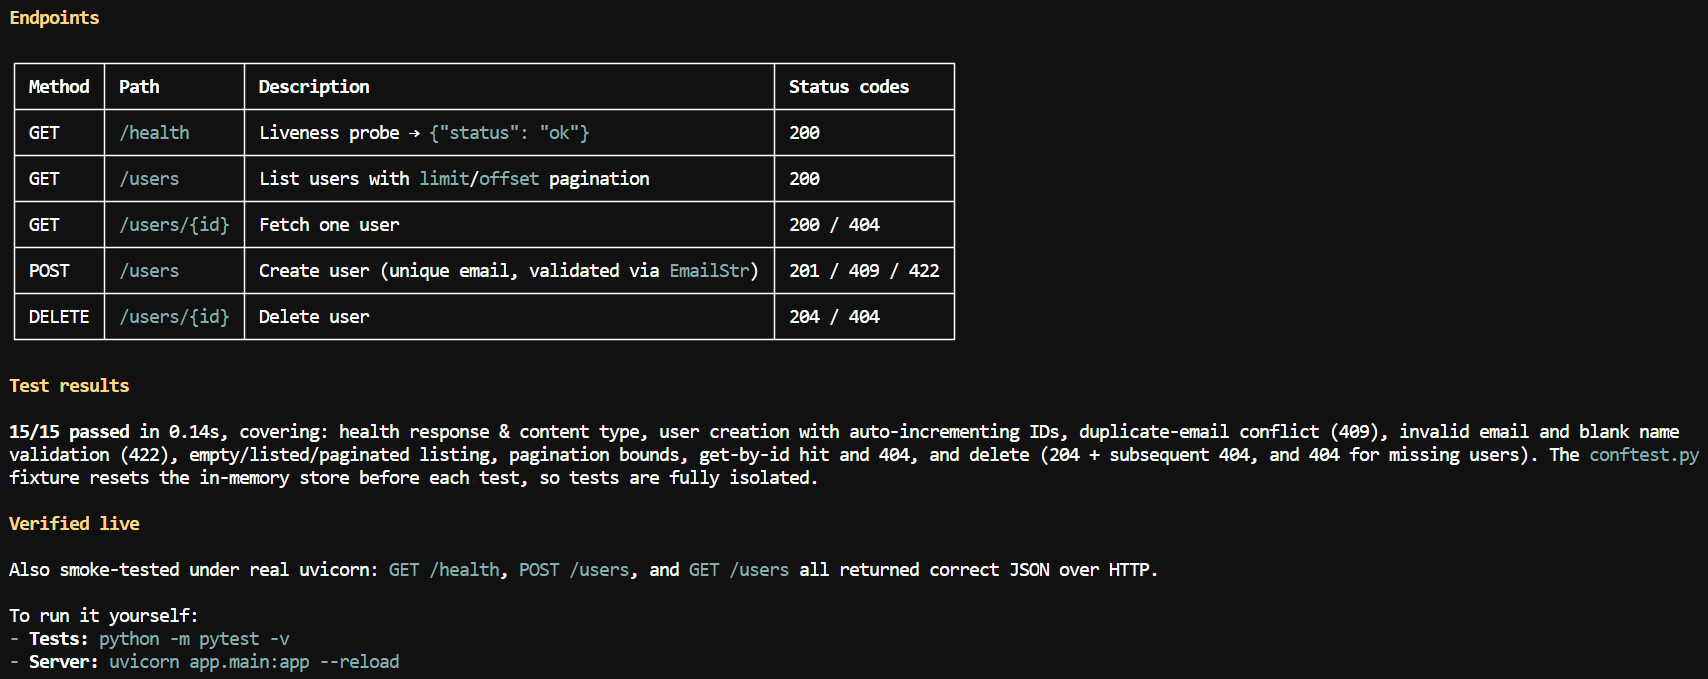
Nach wenigen Minuten hatte das Modell die Endpunkte erstellt, die Tests geschrieben und ausgeführt, einen Smoke-Test durchgeführt und eine kurze Anleitung zum Starten des Projekts geliefert.
Spannend ist, dass das vollständige Modell lokal läuft, obwohl seine Gewichte deutlich größer sind als der verfügbare GPU-VRAM. Pi übernimmt die Coding-Agent-Schleife, während SGLang und KTransformers die eigentliche Modellausführung übernehmen.
KTransformers ist nicht der einzige Weg, ein Modell zu betreiben, das größer ist als dein VRAM. vLLM und llama.cpp unterstützen beide CPU-Offloading, aber sie teilen die Arbeit anders auf:
| Framework | Verwendung des CPU-Speichers | Ort der Expertenberechnung | Optimaler Einsatz |
|---|---|---|---|
| vLLM | Lagert einen Teil der Gewichte in den CPU-RAM aus (--cpu-offload-gb) und überträgt sie bei Bedarf auf die GPU |
GPU | High-Throughput-Serving, wenn das Modell größtenteils in VRAM passt |
| llama.cpp | Teilt Schichten zwischen CPU und GPU auf und kann MoE-Expertentensoren im RAM halten (--n-cpu-moe) |
CPU und GPU | Quantisierte GGUF-Modelle auf Consumer-Hardware |
| KTransformers + SGLang | Belässt die meisten Experten im RAM und platziert pro Schicht eine feste Anzahl von Experten auf der GPU | CPU und GPU, mit optimierten AVX-512-Expertenkernen | Modelle in nativer Präzision auf Maschinen mit hunderten GB RAM |
SGLang und KTransformers konkurrieren in diesem Setup nicht. SGLang übernimmt das Serving, während KTransformers die heterogene CPU-GPU-MoE-Ausführung steuert.
Was mir an diesem Setup am besten gefällt, ist, dass KTransformers etwas anders denkt als der übliche Inferenz-Stack. Statt nur in Schichten zu denken, platziert es einzelne Experten auf der GPU, während andere im Systemspeicher bleiben – und die CPU wirkt aktiv an der Expertenberechnung mit. Die CPU ist nicht nur Überlaufspeicher.
In diesem Tutorial haben wir das vollständige GLM-5.3-Flash-Modell lokal auf zwei RTX PRO 6000 betrieben, obwohl seine Gewichte deutlich größer sind als der verfügbare VRAM.
Es ist nicht das schnellste Setup. Ich kam auf rund 11 Token pro Sekunde, und es gibt viel Spielraum, die Zahl und Platzierung der GPU-Experten zu optimieren. Du könntest auch mit einer einzelnen GPU experimentieren, wenn du genug RAM hast; ich habe hier zwei genutzt, um mehr Luft nach oben zu haben.
Für mich ist das die Kernaussage dieses Guides: KTransformers ist nicht besonders, weil es CPU-Offloading erfunden hätte. Es ist besonders, weil es CPU-RAM, CPU-Rechenleistung und GPU-Rechenleistung um die spärliche Struktur von MoE-Modellen herum zusammenführt.
Top-DataCamp-Kurse
Kurs
Lernpfad
Lernpfad
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Blog
Nisha Arya Ahmed
15 Min.
Tutorial
Josef Waples
8 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Sejal Jaiswal
9 Min.


